そもそもなぜGPT-6 Solの先を見るのか
まずはSolに公平でいよう。それだけの価値がある。Solは2026年9月23日に、GPT-6ファミリーの中間層として、GPT-6 LunaとフラッグシップのGPT-6 Astraの間に位置する形でローンチした。OpenAIの訴求はシンプルで正直だ。GPT-5.6 Solと同じ一般知性を、事実誤りをおよそ半分に抑えて、APIの価格も半額で提供するというものだ。105万トークンのコンテキストウィンドウ、Web検索、コードインタープリター、ホスト型シェル、コンピュータ操作、そしてMCPサポートが組み込まれている。日常的なチャット、抽出、下書きの大半において、妥当な価格で非常に良い回答を得られる。
では、なぜ人々は他を探すのか。いくつかの具体的な理由が繰り返し出てくる。
第一に、大量利用時の価格だ。Solの100万トークンあたり入力2ドル/出力10ドルは中位であり、安くはない。1日に何千回も呼び出されるエージェントループの中でモデルを動かす場合、出力価格が請求額を決める数字になる。以下の複数のモデルはSolの10ドルのほんの一部しか請求しない。
第二に、OpenAIに縛られていることだ。Solはクローズドウェイトであり、APIでは無料枠がまったくないため、Tier 1が最低ラインになる。コンプライアンス上の事情で自前ホストが必要な場合や、単に単一ベンダーへのリスクを避けたい場合、Solはそこでは助けにならない。
第三に、これはバリューリリースであり、能力の飛躍ではないことだ。一般知性の面では、置き換える対象のモデルとほぼ同水準にとどまる。難しいコーディングや長時間にわたるエージェント作業のために本当に賢いモデルが必要なら、横ではなくラインナップの上を見る必要がある。
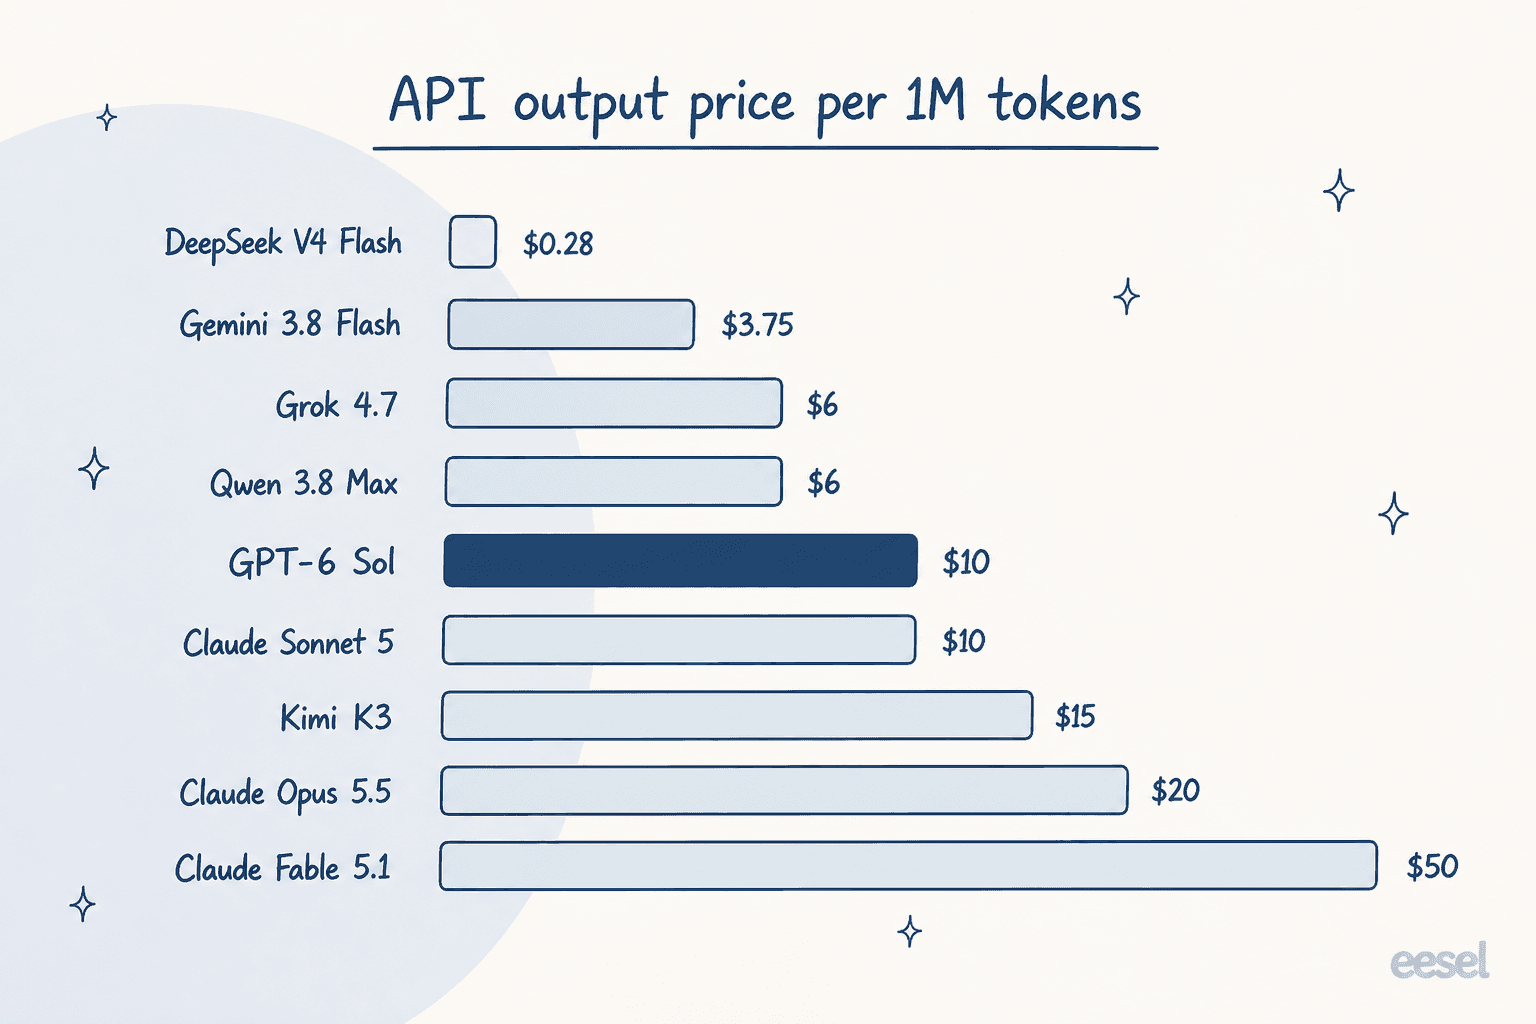
この出力価格の差が、一枚の絵にすべてを物語っている。Solの10ドルはちょうど真ん中に位置し、片側には桁違いに安い予算モデルが、もう片側には5倍高いフロンティアモデルがある。どちらの方向に動くかは、完全に用途次第だ。
これらの代替をどう選んだか
リストは、実在し、一般提供されていて、チームが今日実際に本番投入できるモデルに絞った。次の4点を検討した。
- 価格、正直に。 100万トークンあたりの実際の入力・出力料金に加え、落とし穴(長コンテキストの追加料金、キャッシュ価格、期限切れになるプロモ料金)。
- 費用対性能。 ベンダー自身のグラフだけでなく、公開ベンチマークやArtificial Analysisのような独立した測定でモデルがどこに位置するか。
- オープン性。 クローズドAPIのみか、ダウンロードしてホストできるオープンウェイトか。
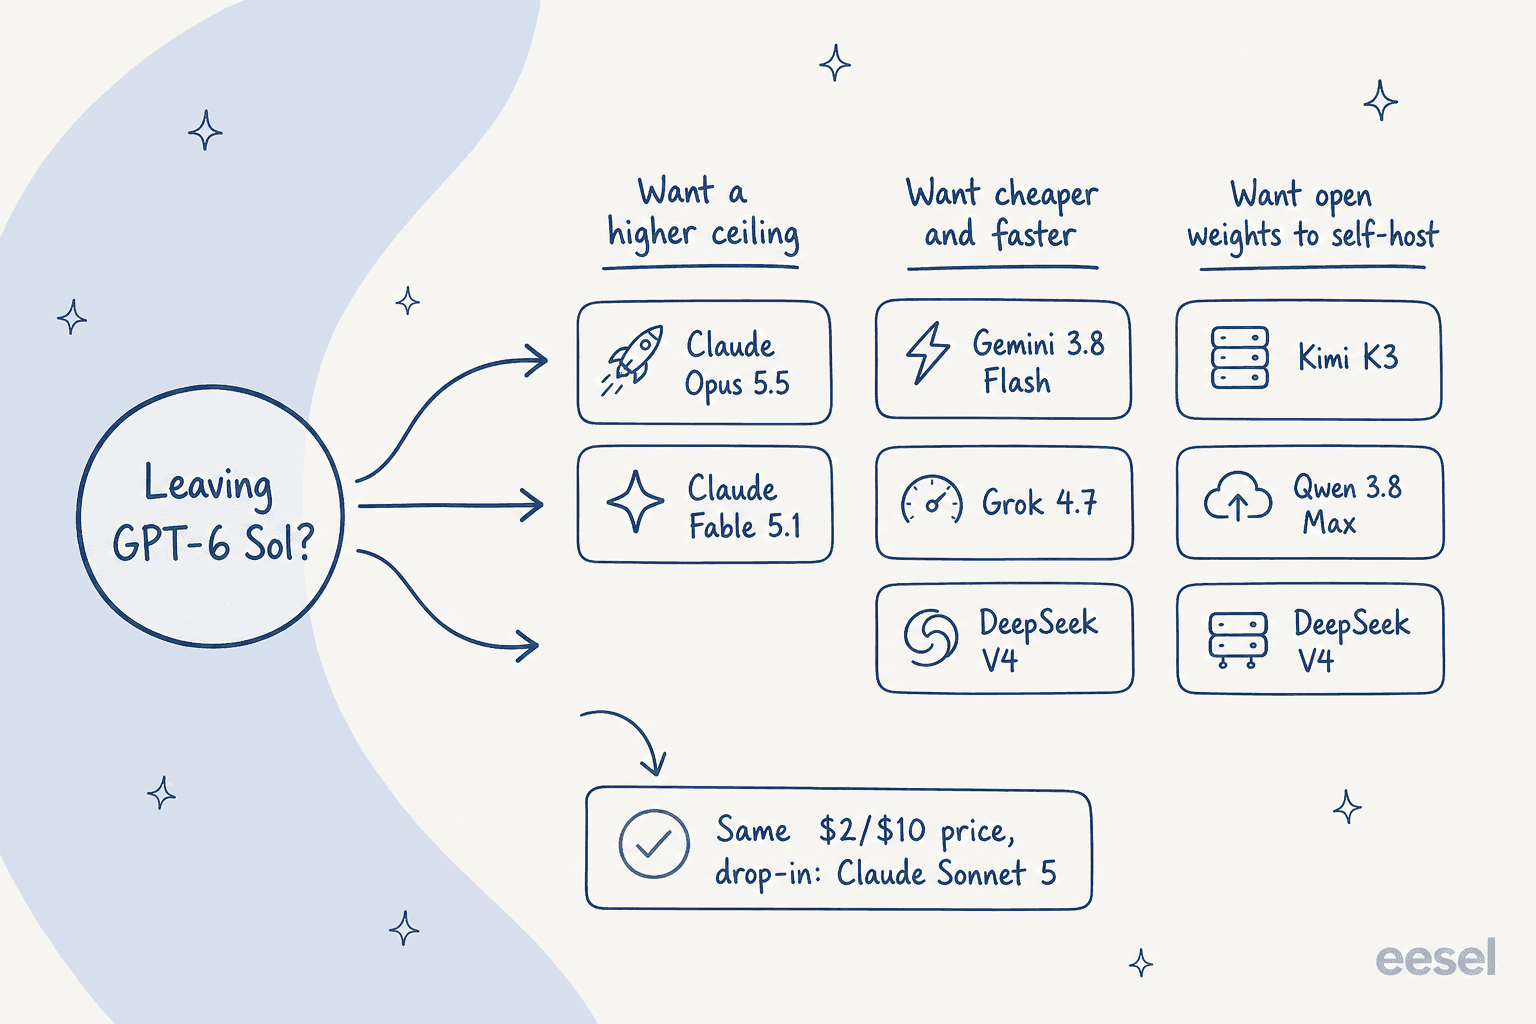
- 用途への適合。 バランス型主力、フロンティア上限、予算重視+速度、または自前ホスト。8つのモデルすべてを必要とする人などいない。自分の状況に合った1つが必要なだけだ。
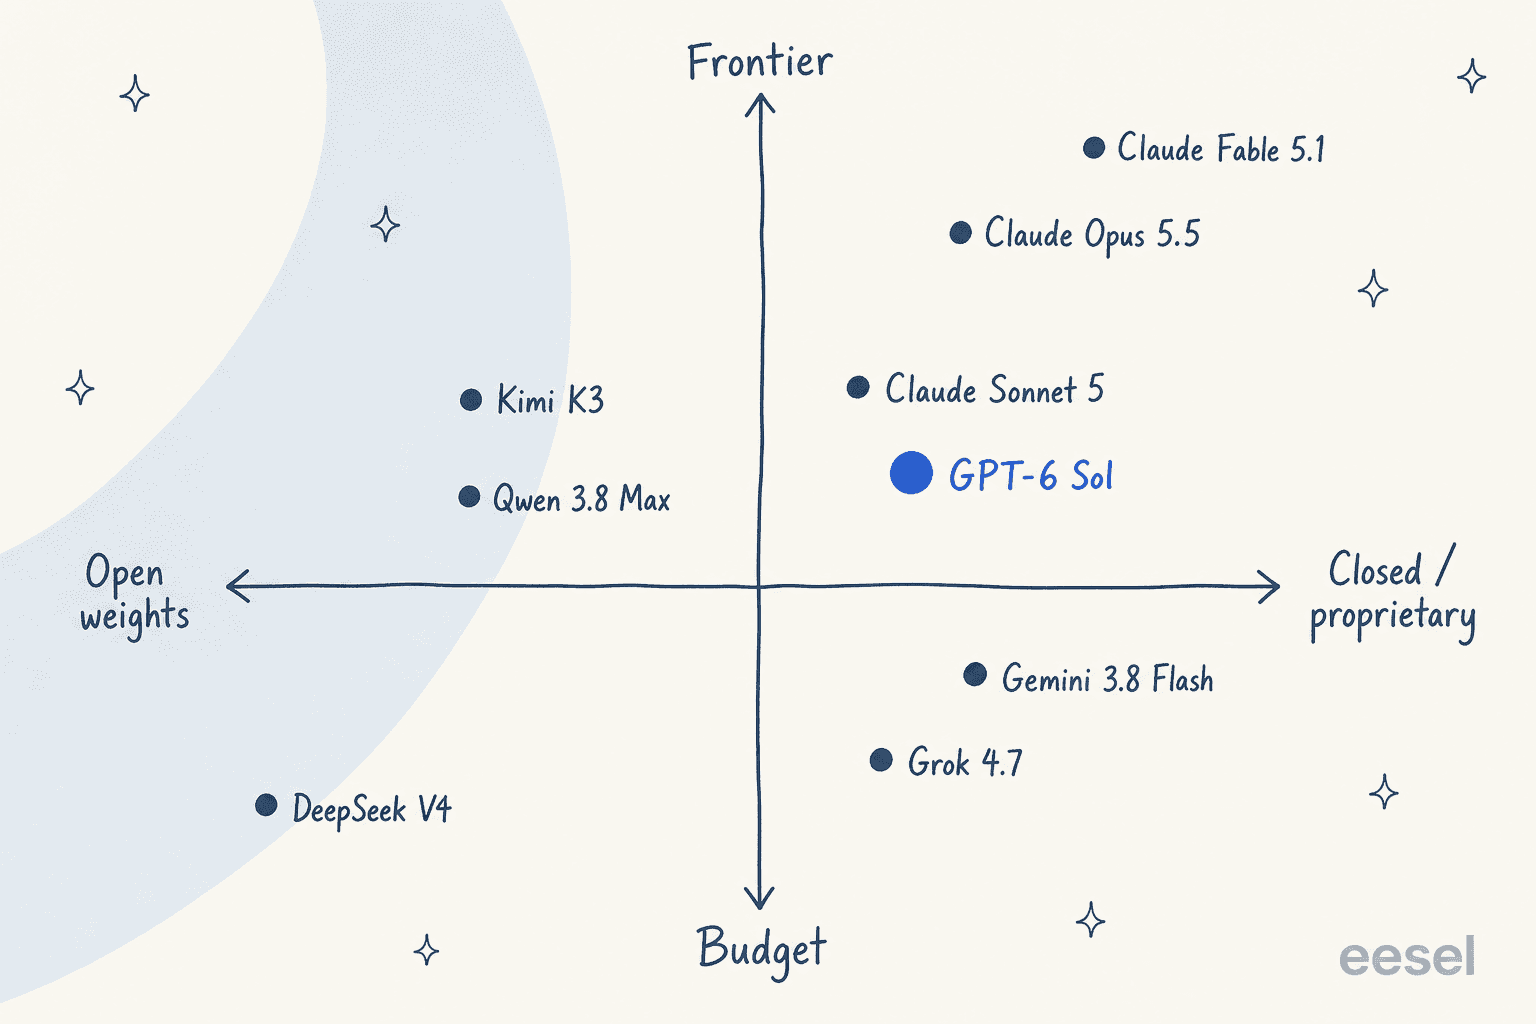
1つずつ見ていく前に、全体像をざっと見てみよう。
| モデル | 最適な用途 | API価格(100万あたり入力/出力) | コンテキスト | ウェイト |
|---|---|---|---|---|
| Claude Sonnet 5 | 同価格でそのまま乗り換え | $2 / $10 | 1M | クローズド |
| Claude Opus 5.5 | エフォートで調整できるより高い上限 | $4 / $20 | 1M | クローズド |
| Google Gemini 3.8 Flash | 大規模利用で最安の高速オプション | $0.75 / $3.75 | 1M | クローズド |
| Grok 4.7 | エージェントループで安い出力 | $2 / $6 | 500K | クローズド |
| Kimi K3 | オープンウェイトのフラッグシップ | $3 / $15 | 1M | オープン |
| DeepSeek V4 | 最安値の予算+自前ホスト | $0.14 / $0.28 (Flash) | ~1M | オープン |
| Qwen 3.8 Max | オープンエコシステム、多言語 | $2 / $6 | 1M | オープン(ベース) |
| Claude Fable 5.1 | 難しい作業向けのフロンティア上限 | $10 / $50 | 1M | クローズド |
「最も賢いのはどれか」という問いについて、すぐに出てくる話なので一言。SolとOpus 5.5が両方ローンチした日に取得されたArtificial Analysis Intelligence Indexのスナップショットでは、Opus 5.5が58(212モデル中1位)だったのに対しSolは48だった。これは実質的な差だ。しかしAAは定期的に指数を再スケーリングするため、ここでは各モデルの横に単一の指数の数字を貼り付けることを避けた。ある週のスナップショットのスコアを別の週のものと比較することは、まさに人々がうっかりナンセンスを公開してしまう原因になる。以下でベンチマークを引用する場合は、私が信頼できる基準に基づいている。
1. Claude Sonnet 5 – 同価格のそのまま乗り換え先
最適な用途: OpenAIにロックインされずに、Solとまったく同じ価格でバランス型の主力モデルを求めるチーム。
Solがバランス型の日常モデルなら、Claude Sonnet 5はもう一方の大手ラボから出た同じポジションのモデルだ。そして価格は近いどころか、まったく同一だ。100万トークンあたり入力2ドル、出力10ドルで、キャッシュ読み取りは0.20ドルだ。この2ドル/10ドルは一時的な導入価格で3ドル/15ドルへの値上げが予定されていたが、Anthropicは2026年8月にその値上げを撤回したため、今では期限切れになるプロモではなく、恒久的な標準価格となっている。
同じ金額で得られるのは、異なる強みのセットだ。Sonnet 5は100万トークンのコンテキストウィンドウを持ち、より洗練された長文と、より安定した長時間のコーディングセッションで定評がある。遅れを取るのは知識の鮮度だ。学習データのカットオフは2026年1月で、Solより古く、AnthropicはOpenAIほど平文でのヘッドツーヘッドのベンチマーク数値を公開していない。
長所: 2ドル/10ドルの同一価格、強力な文章力とコーディング力、100万トークンのコンテキスト、OpenAIのみへの依存リスクに対する第2ベンダーとしてのヘッジ。
短所: より古い知識カットオフ、確認できる公開ベンチマークが少ない、APIに組み込みの無料枠がない。
私の見解: Solを使い続けている唯一の理由が「妥当なデフォルトだったから」なら、Sonnet 5が最初に試すべき代替だ。価格面で乗り換えのコストはゼロで、選択肢の広さを買えるからだ。文章の質を重視するか、単一ベンダーへのロックインを避けたいなら選ぶとよい。OpenAIのツールエコシステムに強く依存しているならSolにとどまるべきだ。
2. Claude Opus 5.5 – 上限の本物の底上げ
最適な用途: Solより生の能力が必要で、コストを抑えるためにエフォートを調整する意思があるチーム。
Opus 5.5は興味深い存在だ。なぜなら素朴な読み方では間違えるからだ。表面上はSolより高い。100万あたり入力4ドル、出力20ドルで、Solのトークン単価の2倍だ。またローンチ当日のArtificial Analysisの指数でも58を記録し、Solの48を上回って首位に立った。つまりより賢くより高価であり、タスクごとのコスト計算も値札に従うと想定してしまいがちだ。
だが実際はそうならない。ここが内面化しておく価値のある、自明ではない部分だ。Opus 5.5は推論エフォートによって調整できるため、エフォートを揃えたコストを見ると比較が逆転することがある。直接対決では、Opus 5.5は中エフォートでタスクあたり約1.34ドルで51点を取り、Solの最大エフォートの48点(1.06ドル)を大きな品質差で上回った。これはわずかなコスト増で得られる結果だ。一番上のレンジでは、Solはタスクあたりずっと安い(最大エフォートで1.06ドル対Opusの5.98ドル)。Opusがはるかに多くの出力トークンを消費するからだ。決め手になるのはタスクの長さとエフォートであり、モデル名ではない。
Opus 5.5はまた、Anthropicにとって前身モデルより安くなった初めてのOpusでもあり、20%の値下げとなった。Anthropicは今ではほとんどの作業においてOpus 5.5から始めることを推奨している。冗長さについてのコミュニティの評価はもう少し賛否が分かれる。
writes like gemini, a drastic improvement over the opus 5.1 claudeisms

長所: Solに対する明確な能力の飛躍、エフォートのダイヤルにより短いタスクで安く品質を買える、Opus 5に対して20%の値下げ、2026年6月のカットオフ。
短所: 最大エフォートではタスクあたり高価、依然として冗長になりうる、単純な抽出やチャットにはオーバースペック。
私の見解: Solの回答がやや物足りず、実際にエフォート設定を調整するつもりならOpus 5.5を選ぼう。どうせ常に最大出力で動かしてダイヤルを一切触らないつもりなら、使わない能力にお金を払うことになる。
3. Google Gemini 3.8 Flash – 安くて速いモデル
最適な用途: コストとスループットが何よりも優先される大量ワークロード。
予算がボトルネックなら、Gemini 3.8 Flashが明白な選択だ。2026年12月31日までは100万あたり入力0.75ドル、出力3.75ドルで、2027年1月1日からはちょうど倍額になる(1.50ドル/7.50ドル)。2027年の料金でも、Solの出力価格を下回る。100万トークンの入力ウィンドウと無料枠を備え、Artificial Analysisでは196モデル中、生の出力速度で3位にランクされている。
正直な注意点が2つある。第一に、新しいベースモデルではない。Google自身のモデルカードは「Gemini 3.7 Flashをベースにしている」と4回も繰り返し記載しており、Googleは効率重視の開発者に対して文字通り3.7に留まるよう勧めている。第二に、スループットは応答性と同じではない。AAは初回トークンまでの時間を13.3秒と計測しており、クラス中央値の3秒に対してかなり遅い。これは夜間バッチジョブには問題ないが、ライブチャットの返信のように人間が待っているものには実際の問題になる。
長所: ここでは最安の高速オプション、巨大なコンテキスト、無料枠、優れたスループット。
短所: 初回トークンまでのレイテンシが遅い、真に新しいモデルではない、冗長になり余分なトークンを消費しうる。
私の見解: トークン単価のコストが支配的な大規模バッチ処理やバックグラウンドジョブにはGemini 3.8 Flashを使おう。レイテンシに敏感な用途では、遅い初回トークンが失格要因になるので、代わりにGrokやSonnetを検討するとよい。
4. Grok 4.7 – エージェントループ向けの安い出力
最適な用途: モデルを絶えず呼び出し、出力価格を気にするエージェント型ワークロード。
xAIのGrok 4.7は2026年9月21日に登場し、入力(2ドル)ではSolと並び、出力では下回る。100万あたり6ドル対Solの10ドルで、これは200Kトークンのプロンプト以下の場合に適用される。Grok 4.6より大きな新しいベースモデルの上に構築されており、数時間にわたるエージェント型タスクに重点を置いたより長い強化学習の実行を経ている。エージェントベンチマークでも本物の飛躍を示しており、Terminal-Bench 4.0のスコアは4.6と比べてほぼ倍増した。
注意すべき点が2つある。長コンテキストの価格設定は2回読む価値のある罠だ。200Kのプロンプトトークンを超えると料金は4ドル/12ドルに跳ね上がり、超過分だけでなくリクエスト内のすべてのトークンに適用される。また一部の評価ではGrok 4.7が実際にSolに負けている。HealthBench ProfessionalではSolの60.5に対して56.7で、あらゆる面でのクリーンな勝利ではない。
長所: Solより安い出力、4.6からの大きなエージェント面での改善、堅牢な安全性スタック、500Kのコンテキスト。
短所: 長コンテキストで容赦ない価格の崖、一部の領域ではSolに負ける、「Fast」バリアントはCursorとGrok Build専用で、公開APIでは使えない。
私の見解: Grok 4.7はエージェントループで大量に動かすことを前提に価格設定されており、まさにそこで使いたいモデルだ。ただしリクエストは200Kトークンの線を下回るように保つこと。さもないと長コンテキストの料金が節約分を消してしまう。
5. Kimi K3 – オープンウェイトのフラッグシップ
最適な用途: 実際にダウンロードできるフロンティア級のモデルを求めるチーム。
Moonshot AIのKimi K3は、オープン性が重要な場合に際立つ存在だ。2.8兆パラメータのMixture-of-Expertsモデル(アクティブ1040億)で、100万トークンのコンテキストを持ち、何より重要なのはウェイトが予定通りにHugging Faceで公開されたことだ。そこではsafetensorsのインデックスがプレスリリース以外の情報源から2.8兆というフルの数値を確認している。自分自身でこれを動かすことができる。
ホスト版APIでは100万あたり入力3ドル、出力15ドルで、Claude Sonnetと同じ価格帯だ。つまりK2のような破格ではなく、価値はオープンウェイトにあり、API料金にあるわけではない。ベンチマークでは前世代のフロンティアモデルを上回り、Fable 5.1やGPT-5.6 Solのような現行のトップクラスには一歩及ばない。知っておくべき癖が一つある。推論はどのレベルでもオフにできないため、最も安い設定はレイテンシの制御であって、本当のコスト階層ではない。
長所: Hugging Faceで検証済みの本当にオープンなウェイト、フロンティアに近い品質、100万のコンテキスト、ネイティブのビジョン対応。
短所: API価格は中位で安くはない、推論が常時オン、公開画像URLは受け付けない(base64のみ)。
私の見解: Solを離れる理由がクローズドだからなら、Kimi K3は自前ホストに最も強いオープンウェイトのフラッグシップだ。単に安いホスト版APIが欲しいだけなら、3ドル/15ドルは答えにならないので、代わりにDeepSeekを検討するとよい。
6. DeepSeek V4 – 自前でホストできる予算の王者
最適な用途: オープンウェイトのおまけ付きで、トークンあたり絶対的に最安のオプション。
DeepSeek V4は、価格チャートが崖から落ちる場所だ。Flash階層は100万あたり入力0.14ドル、出力0.28ドルで、Solの出力価格のおよそ35分の1に相当し、その上オープンウェイトも付いてくる。知っておく価値のある、実に奇妙なひねりがある。7月下旬の再学習の後、安価なFlash階層は現在、より高価なPro階層を上回っている。DeepSeekが公開する9つのエージェント型ベンチマークすべてにおいてだ。そしてArtificial Analysisでも、自身の指数でFlashがProより上に位置している。高価な階層は、今のところ単に古いビルドにすぎない。
Proが依然として存在価値を発揮するのは、SimpleQA-Verifiedや100万トークンの検索のような、長コンテキストでのリコールと針の発見だ。そして公平な注意点として、LMArenaの人間による選好ランキングではProは依然としてFlashより上にあり、自動化された指数と人間の投票者では意見が分かれる。決める前に両方を読むこと。
長所: ここでは圧倒的に最安、オープンウェイト、Flashは価格以上の性能を発揮する。
短所: 階層の命名が今のところ本当に紛らわしい、Proの推論を安く抑えることはできない、大手ラボと比べてエコシステムが小さい。
私の見解: コストに敏感な大量作業には、DeepSeek V4 Flashは価格面で無敵であり、驚くほど有能だ。名前に反して、ProではなくFlashから始めよう。そして安価な階層が劣ると決めつける前に、自分のタスクでベンチマークすること。
7. Qwen 3.8 Max – オープンエコシステムという選択
最適な用途: オープンなベース、強力な多言語性能、そして大きなクラウドの後ろ盾を求めるチーム。
AlibabaのQwen 3.8 Maxは2026年8月2日に一般提供を開始した。2.4兆パラメータのMixture-of-Expertsモデル(アクティブ950億)で、100万のコンテキストを持ち、価格は100万あたり入力2ドル、出力6ドルだ。これはSolと入力で並び、出力では上回る。LMArenaでは強く、確認時点でテキスト部門5位、ビジョン部門2位だった。
オープン性の話には注釈が付く。ベースウェイトはQwen3.8-2.4T-A95Bとして実際に公開されたが、Apache 2.0ではなく独自のqwen3.8-maxライセンスの下であり、オープンなベースはホスト版Maxと機能的に同等ではない(ホスト版はビジョン、非思考モード、組み込みツールを追加している)。寛容なライセンスのQwenが欲しいなら、より小型のQwen3.8-27BがApache 2.0版だ。構築する前にライセンスを読むこと。
長所: Solより安い出力、LMArenaで強い特にビジョンと多言語、オープンなベースウェイトが利用可能。
短所: Maxのライセンスは独自でApacheではない、オープンなベースはホスト版の機能を欠く、自動化されたランキングと人間のランキングが異なる方向を示す。
私の見解: Qwen 3.8 Maxは、オープンエコシステムで暮らしたく、多言語やビジョン作業を重視するなら良い選択だ。ただし「オープン」が「ホスト版MaxのApacheライセンスによるそのまま乗り換え」を意味すると思い込まないこと。そうではないからだ。
8. Claude Fable 5.1 – フロンティアの上限
最適な用途: 品質がコストを完全に上回る、最も難しいコーディングと長時間のエージェント作業。
Solでは賢さが足りず、Opus 5.5のエフォートダイヤルでもまだ不十分なとき、Fable 5.1がAnthropicのClaude 5ファミリーの頂点だ。高価で、100万あたり入力10ドル、出力50ドル、Solの出力価格の5倍であり、それを隠すそぶりもない。買うものは上限そのものだ。Terminal-Bench-Science(52.6%)、CursorBench(73.4%)、HLE-with-tools(65%)で首位を独走し、Grokチーム自身のGDPval Eloテーブルでも、彼らが挙げたすべてのライバルの上に立った。
記憶に残るのは実世界での稼働実績だ。Anthropicは、Rampでの38時間にわたる無人エージェントセッションや、何年も未解決だった問題を解いた研究チームの事例を挙げている。価格をやわらげる唯一の変更点は、キャッシュ読み取りが100万あたり0.25ドルに引き下げられたことで、キャッシュされたトークンあたりの価格はOpus 5.5より安い。構築する前に知っておく価値があるのは、Fable 5.1が強制的なツール使用を廃止したこと(tool_choiceのany/toolは今では400エラーになる)、そしてEU AI法への準拠のため、すべての出力に統計的なテキストの電子透かしを追加していることだ。
長所: 本物のフロンティア品質、大規模な実世界でのエージェント稼働実績、安価なキャッシュ読み取り、100万のコンテキスト。
短所: ここでは圧倒的に最も高価なモデル、電子透かしと拒否の誤検知が一部の開発者を苛立たせる、日常的なタスクにはオーバースペック。
私の見解: Fable 5.1はほとんどのワークロードにとってSolの代わりではなく、本当に難しい5%の仕事のためにエスカレーションするモデルだ。簡単なトラフィックは安いものに回し、Fableは本当にそれを必要とする作業のために取っておこう。
モデルを乗り換える人が実は誰も聞かない問い
私が繰り返し突き当たるのはこの点であり、だからこそリストより先に結論を書いた。実際の製品、特にカスタマーサポート向けにGPT-6 Solの代替を比較している人の大半は、間違った問いを立てている。彼らはエンジンを最適化しているが、実際にうまくいくかどうかを決めるのは、エンジンを取り巻くすべてのものだ。
私はここ数年、何千もの企業のライブサポートキューにAIエージェントを導入することに費やしてきたが、パターンは決して変わらない。モデルがボトルネックになることは稀だ。ボトルネックは、自社の実際のコンテキストを持っているか、ヘルプデスクで実際のアクションを取れるか、実際の顧客に触れる前にそれを信頼できるか、という点にある。私たちはそれを苦労して学んだ。だからこそ、eeselのすべてのロールアウトは今、まず過去のチケットに対してシミュレーションを行い、何かが本番稼働する前に、実際の過去のチケットでの解決率と正確な回答を確認できるようにしている。生のモデルAPIはそのどれも与えてくれない。与えてくれるのは非常に賢いテキスト補完エンドポイントと請求書だけだ。
SolをSonnet 5やGemini Flashに切り替えれば、トークンのコストは変わる。しかしそれ自体では、サポートエージェントは手に入らない。それは別の層であり、実際に判断を集中させるべき部分はそこにある。
eeselを試す

私はこう考えている。モデルはインフラであり、eeselはその上で動かすために雇う従業員だ。GPT-6 SolやClaude、Geminiの代わりにeeselを選ぶのではない。チームメイトを選び、その裏側で仕事に適したモデルをどれでも使うのだ。今日、そのラインナップは、既存のサポートキューに参加し、すでにヘルプセンターと過去のチケットを把握している、すぐに働けるAIヘルプデスクチームメイトと、コンテンツ向けのAIブログライターだ。それぞれが、その役割のためのスキル、統合、企業コンテキストを携えて登場し、トークンではなく解決件数で課金されるため、おしゃべりなモデルが請求額を爆発させることはない。
そもそもモデルのAPIを比較するタイプの人なら、eesel CLIがそれを確認する最速の方法かもしれない。これは同じチームメイトとワークスペースの上に構築された、エージェントフレンドリーなインターフェースだ。ターミナルから操作したり、スクリプトで自動化したり、Claude Code、Codex、CursorのようなコーディングエージェントにMCPサーバー、Webhook、ネットワークアクセス制御とともに直接操作させたりできる。ダッシュボードと同じエージェントで、ヘッドレスなだけだ。eeselを無料で試すことができ、何かにコミットする前に自分のチケットでシミュレーションできる。
よくある質問
2026年のGPT-6 Solの最良の代替は何か?
GPT-6 Solより安い代替はあるか?
GPT-6 Solの良いオープンウェイト代替は何か?
GPT-6 SolはClaude Sonnet 5より優れているか?
GPT-6 Solの代替はカスタマーサポートの自動化に使えるか?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.