

Gemini 4 Carbon は Google の新しいフロンティアモデルで、Artificial Analysis Intelligence Index で59点と最も強いモデルです。わずか2週間前にリリースされた Gemini 4 Argon を9ポイント上回ります。Google が公表した17のベンチマークすべてで Argon に勝ち、SEC-bench Pro(88.2%)などのサイバーセキュリティテストでも首位で、価格はまったく同じです。100万トークンあたり、開始時は $2/$10、その後は $4/$20 です。
問題はアクセスです。現在 Carbon を使えるのは、一部のサイバー防御担当者だけで、Google の Fairwind Program を通じて提供されています。開発者、企業、一般ユーザーには「できるだけ早く」提供されるとのことですが、日付はありません。Argon は発表から API 提供まで約2週間だったので、Carbon も同じくらいと見るのが妥当です。
私の見方では、Carbon は Argon の上位ティアではなく、Argon の後継です。すでに Argon を使っているなら、Carbon が提供されたらモデル名を差し替える準備をしておきましょう。サポートチケット向けに検討しているなら、注目すべき見出しは、Carbon が根拠のない主張を約半分に減らすという Google の主張です。これは eesel がヘルプデスクエージェントのレベルで解決している問題と同じです。ヘルプセンターや過去のチケットに基づいた下書きを作り、根拠がなければ人に引き継ぎます。
Gemini 4 Carbon とは?
Gemini 4 Carbon は Google DeepMind の大規模言語モデルで、2026年10月28日に Google の Chief AI Architect である Koray Kavukcuoglu 氏によって発表されました。Google は「our strongest model with state-of-the-art cybersecurity and long horizon capabilities」と呼んでおり、独立したサイズ区分ではなく、Argon の上に「building on」して作られています。
Google の主張を短くまとめると次のとおりです。
| 項目 | Gemini 4 Carbon |
|---|---|
| 発表日 | 2026年10月28日 |
| ベース | Gemini 4 Argon(2週間前にリリース) |
| Artificial Analysis Intelligence Index v5.0 | 59.4、発表時点で1位 |
| 用途 | 長時間のエージェント型コーディング、サイバーセキュリティ防御 |
| コンテキストウィンドウ | 1M トークン(Artificial Analysis による) |
| 発売時の価格 | 100万トークンあたり入力 $2 / 出力 $10、キャッシュ入力は95%オフ |
| プロモーション後の価格 | 入力 $4 / 出力 $20 |
| 現在使える人 | Fairwind Program を通じた一部のサイバー防御担当者 |
Google は、自社チームが大規模なコードベースの微妙なバグの根本原因を調べるようなエンジニアリング作業で、Carbon が「run for days to persist through dead ends」するのを見てきたと述べています。それが設計の中心にある仕事であり、発表記事の大半がチャットよりもコーディングとセキュリティの話である理由でもあります。
Carbon は Argon とどう違うのか?
Carbon は、同じ価格でより良くなった Argon です。Google は新しい学習なのか後のチェックポイントなのかを明かしていませんが、発表のすべて(同じ価格表、同じ展開経路、「building on Gemini 4 Argon」)が、兄弟ではなく後継であることを示しています。最も大きく動いた数字で両者を比べてみましょう。
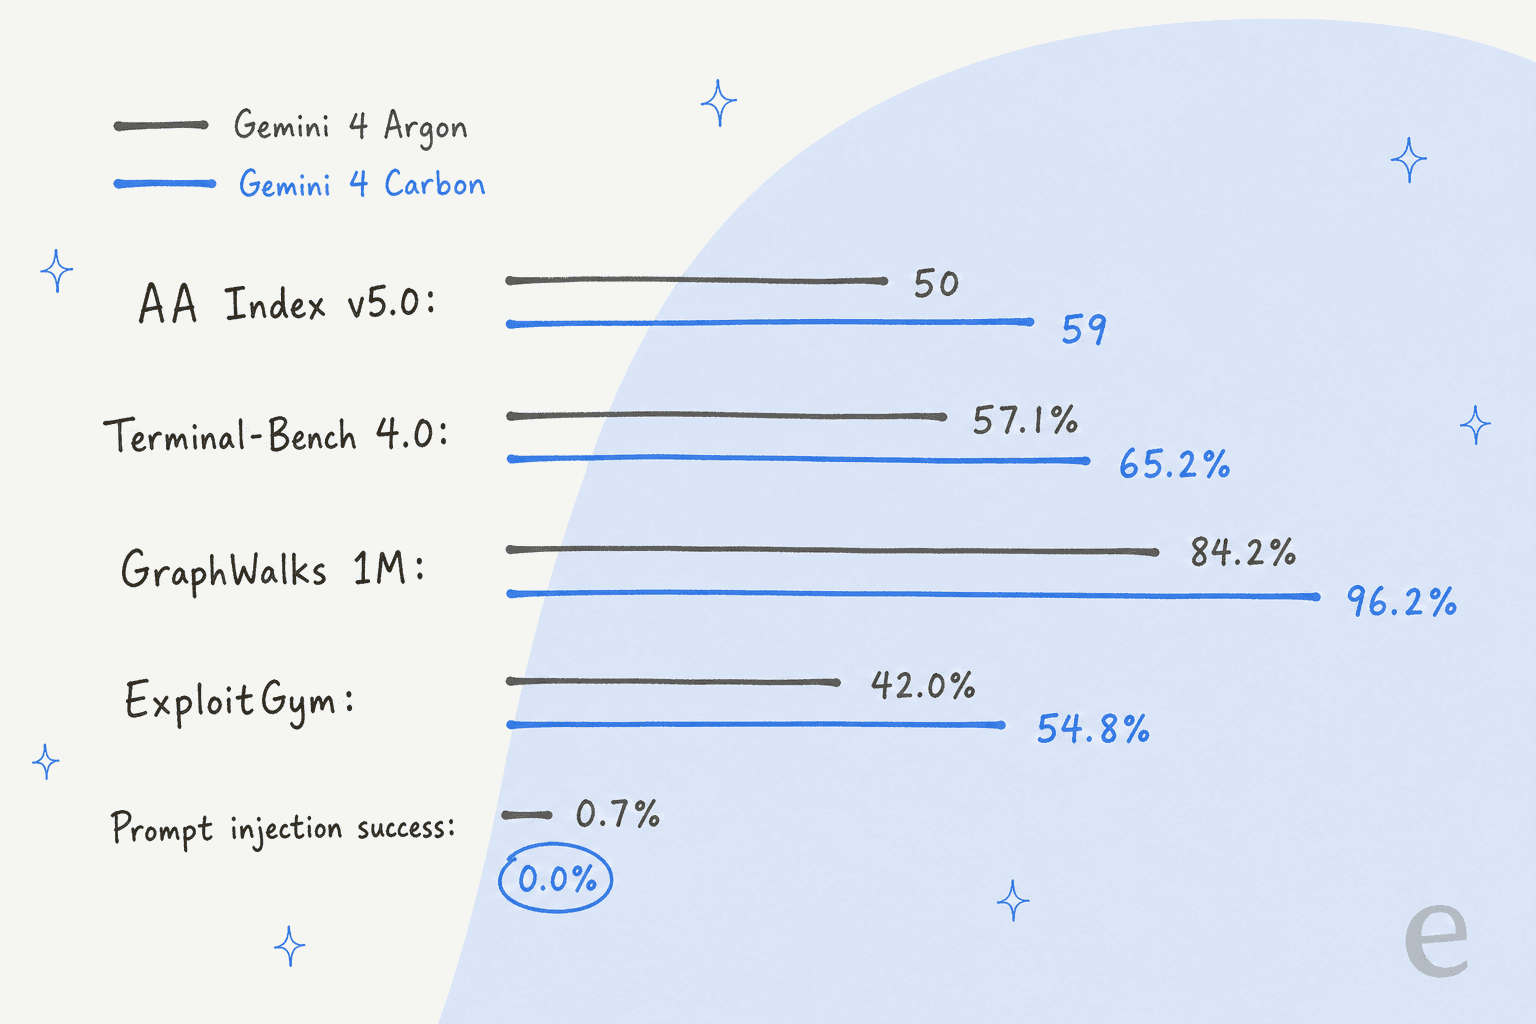
最大の伸びは長いコンテキストとセキュリティです。256Kから1Mトークンにわたる推論をテストする GraphWalks は、84.2%から96.2%に上昇し、悪用ベンチマークの ExploitGym はほぼ13ポイント上がりました。一般的なコーディングの伸びは小さいものの確かで、Terminal-Bench 4.0 は8ポイント上がり、WebDev Arena では Carbon が89 Elo 上がって4位になりました。
名前の付け方は、ほぼ全員を混乱させました。OpenAI や Anthropic のようなラボは、サイズの順序が分かる名前を使います(Astra、Sol、Terra、Opus、Sonnet、Haiku)。Google の元素名はそうではなく、Hacker News のスレッドはこの話だけで数百件のコメントを費やしました。
"Confusingly, Carbon is another model in the same size class as Argon. Every other lab would have just called it Gemini 4.1 Argon."

これが正しい捉え方だと思います。Carbon を「Argon の次のバージョン」と考えれば、発表の残りの部分も筋が通ります。
Gemini 4 Carbon のベンチマークスコアは?
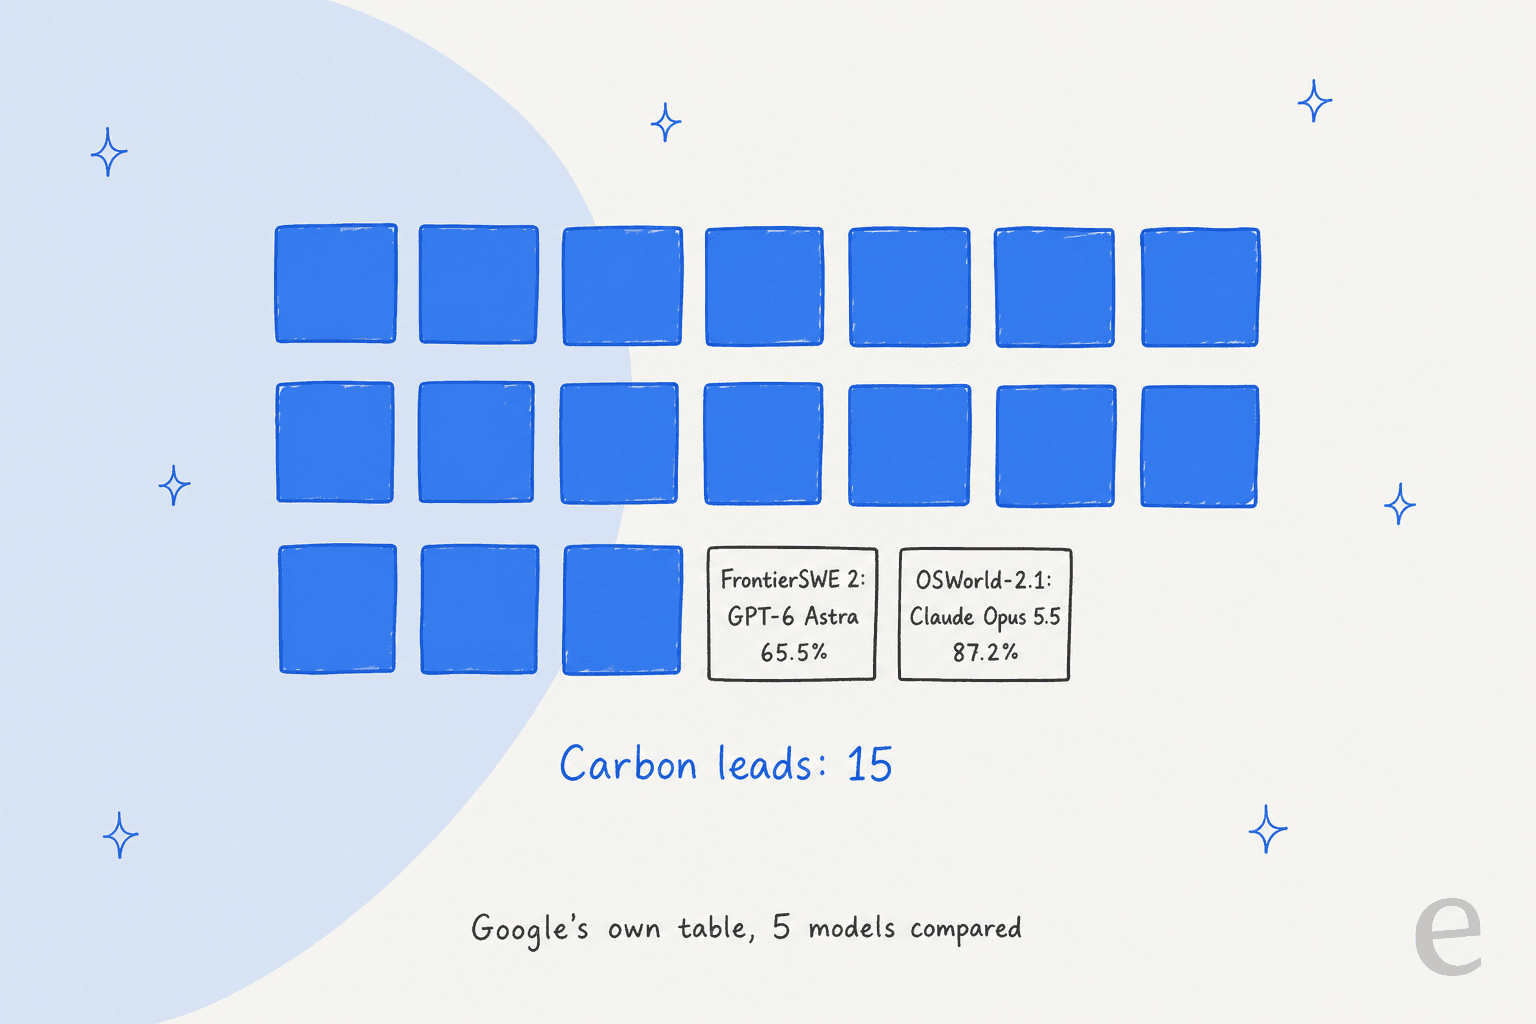
Carbon は、Argon、GPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1 との比較で、Google 自身の表にある17項目中15項目でトップです。Google が公表した表の全体は次のとおりです。
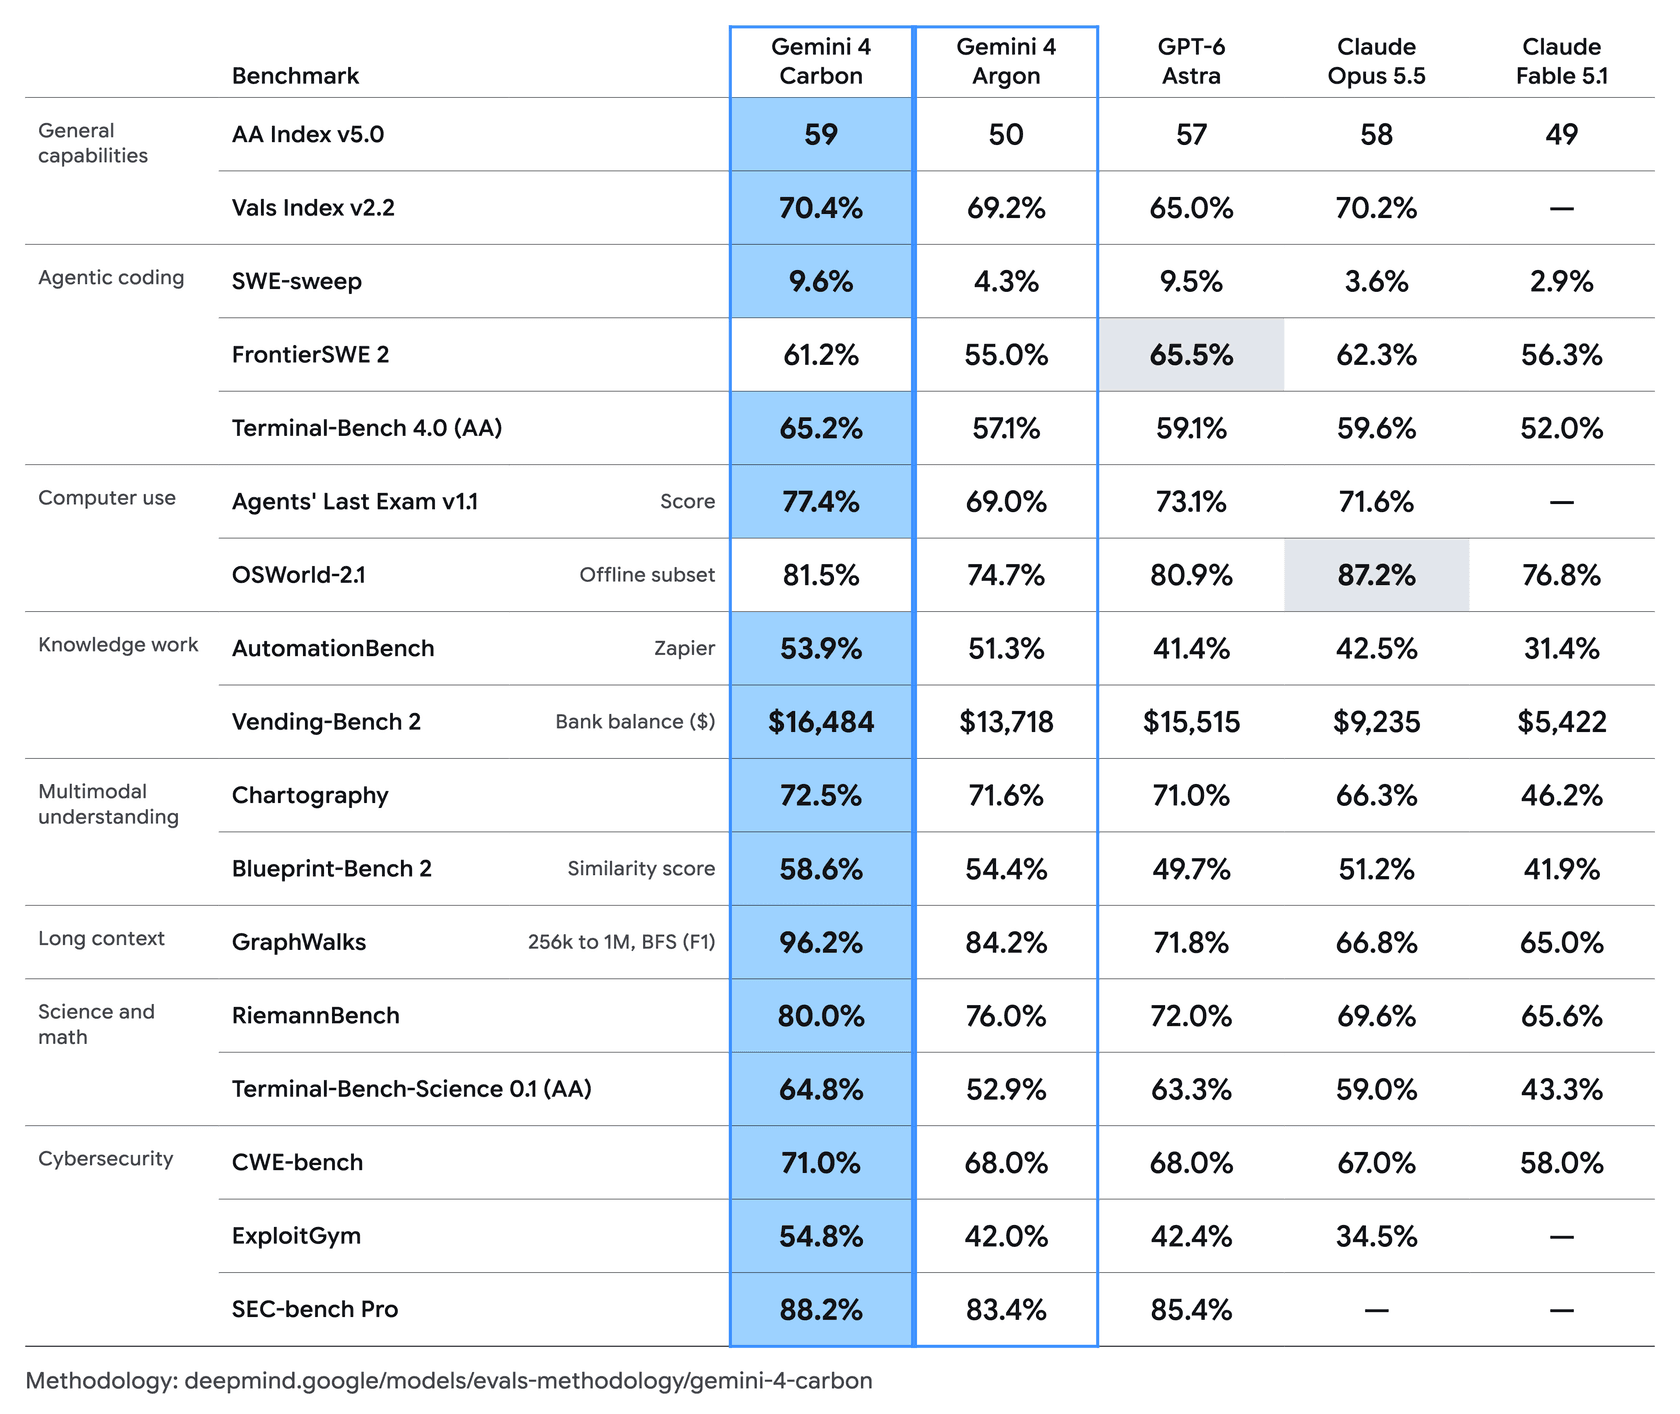
Carbon が勝てていない2項目は、コーディングやコンピュータ操作を重視する購入者が真っ先に見る行なので、知っておく価値があります。
DeepMind のモデルページから、特に注目したい行を抜き出しました。
| ベンチマーク | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|---|
| AA Intelligence Index v5.0 | 59 | 50 | 57 | 58 |
| Terminal-Bench 4.0(エージェント型コーディング) | 65.2% | 57.1% | 59.1% | 59.6% |
| FrontierSWE 2(ソフトウェアエンジニアリング) | 61.2% | 55.0% | 65.5% | 62.3% |
| OSWorld-2.1(コンピュータ操作) | 81.5% | 74.7% | 80.9% | 87.2% |
| AutomationBench(Zapier のタスク) | 53.9% | 51.3% | 41.4% | 42.5% |
| GraphWalks(256K〜1M トークン) | 96.2% | 84.2% | 71.8% | 66.8% |
| SEC-bench Pro(脆弱性の発見) | 88.2% | 83.4% | 85.4% | n/a |
目を引く点が2つあります。1つ目は、長いコンテキストでのリードが小さな差ではなく大きいことです。GraphWalks で96.2%、Opus 5.5 は66.8%。コードベース全体や長い契約書を読む仕事なら、この行が重要です。2つ目は、AutomationBench(実際の業務ワークフローに対する Zapier のテスト)の数字で、Carbon が Astra と Opus を11ポイント以上引き離しています。エージェントの仕事では、単独のコーディングスコアより強いシグナルです。
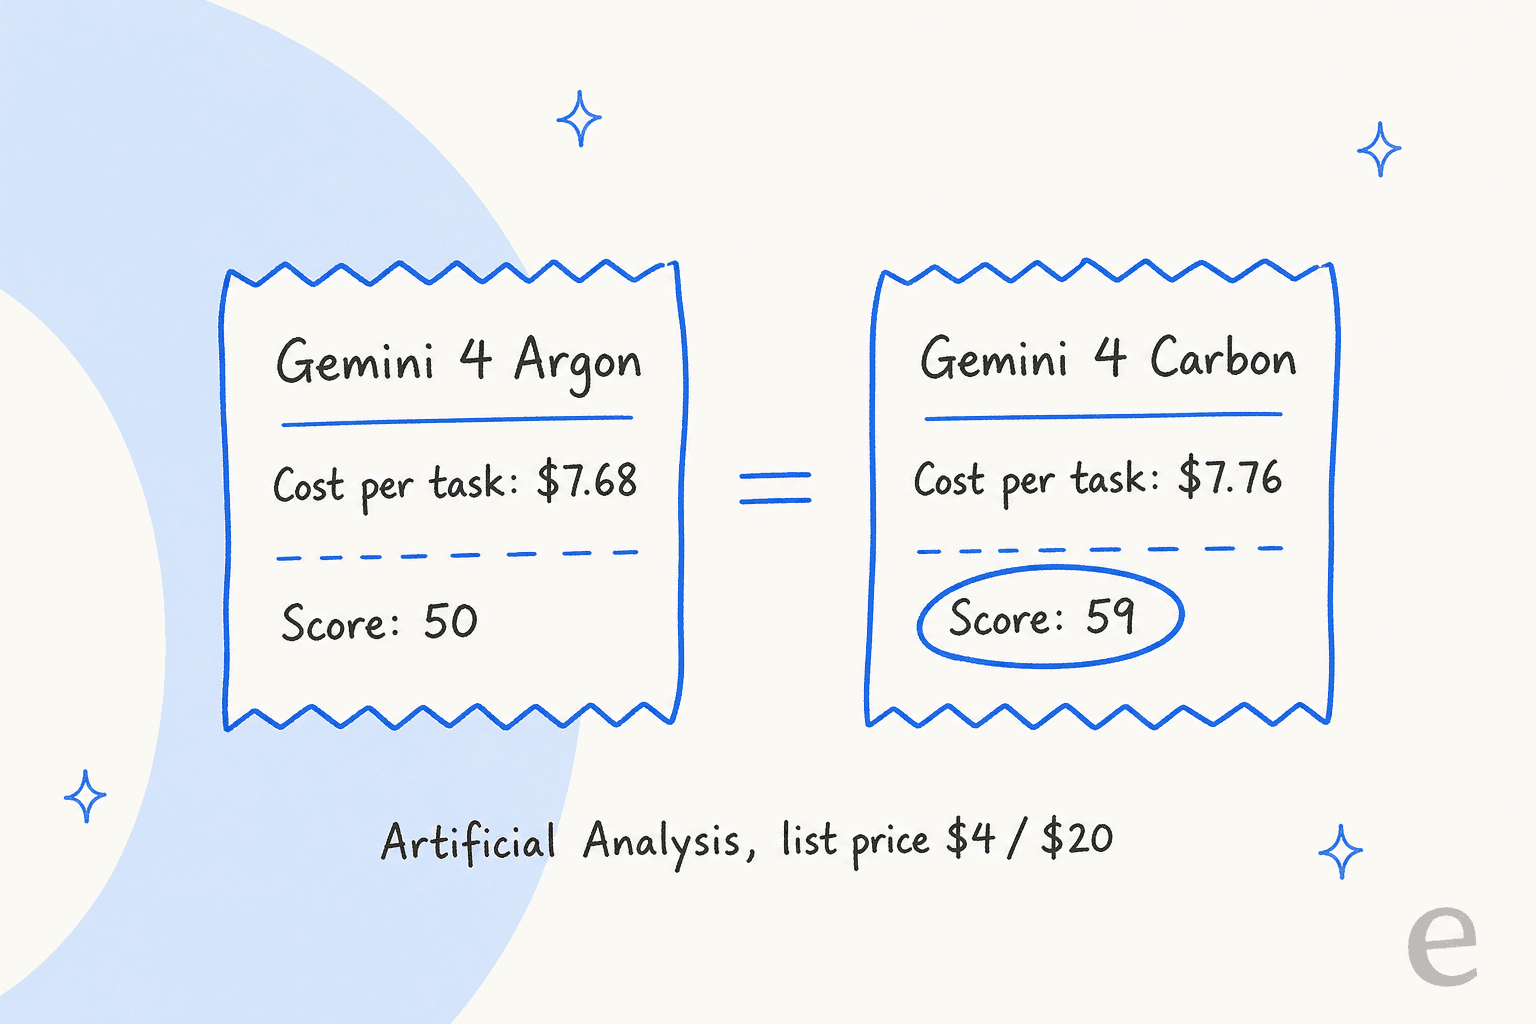
公平のために断っておくと、これらはベンダーの数字です。これまでの独立した検証は Artificial Analysis で、Carbon を59.4で総合1位、定価で1タスクあたり $7.76 としています。また、Argon の実績を考えると、表を信じる前に実際の利用を待つ理由があります。Argon も紙の上では強く見え、Carbon に関する Hacker News のスレッドの大部分は、日常使いでは弱く感じたという開発者の声です。詳しくは私の Gemini 4 Argon レビューをご覧ください。
なぜ Google は Carbon をサイバーセキュリティモデルと呼ぶのか?
そこが最も優位が明確で、同時にリスクがある領域だからです。Google は、セキュリティチームが実際に行う一連の手順、つまり欠陥の発見、悪用可能であることの証明、そして修正までの全体で最先端の結果を報告しています。
- 発見: SEC-bench Pro で88.2%。実際のソフトウェアの欠陥を自律的に見つけます。
- 検証: 悪用ベンチマークの ExploitGym で54.8%。Argon の42.0%から上昇。
- 修正: CWE-bench で71.0%。発見を動く修正に変えます。
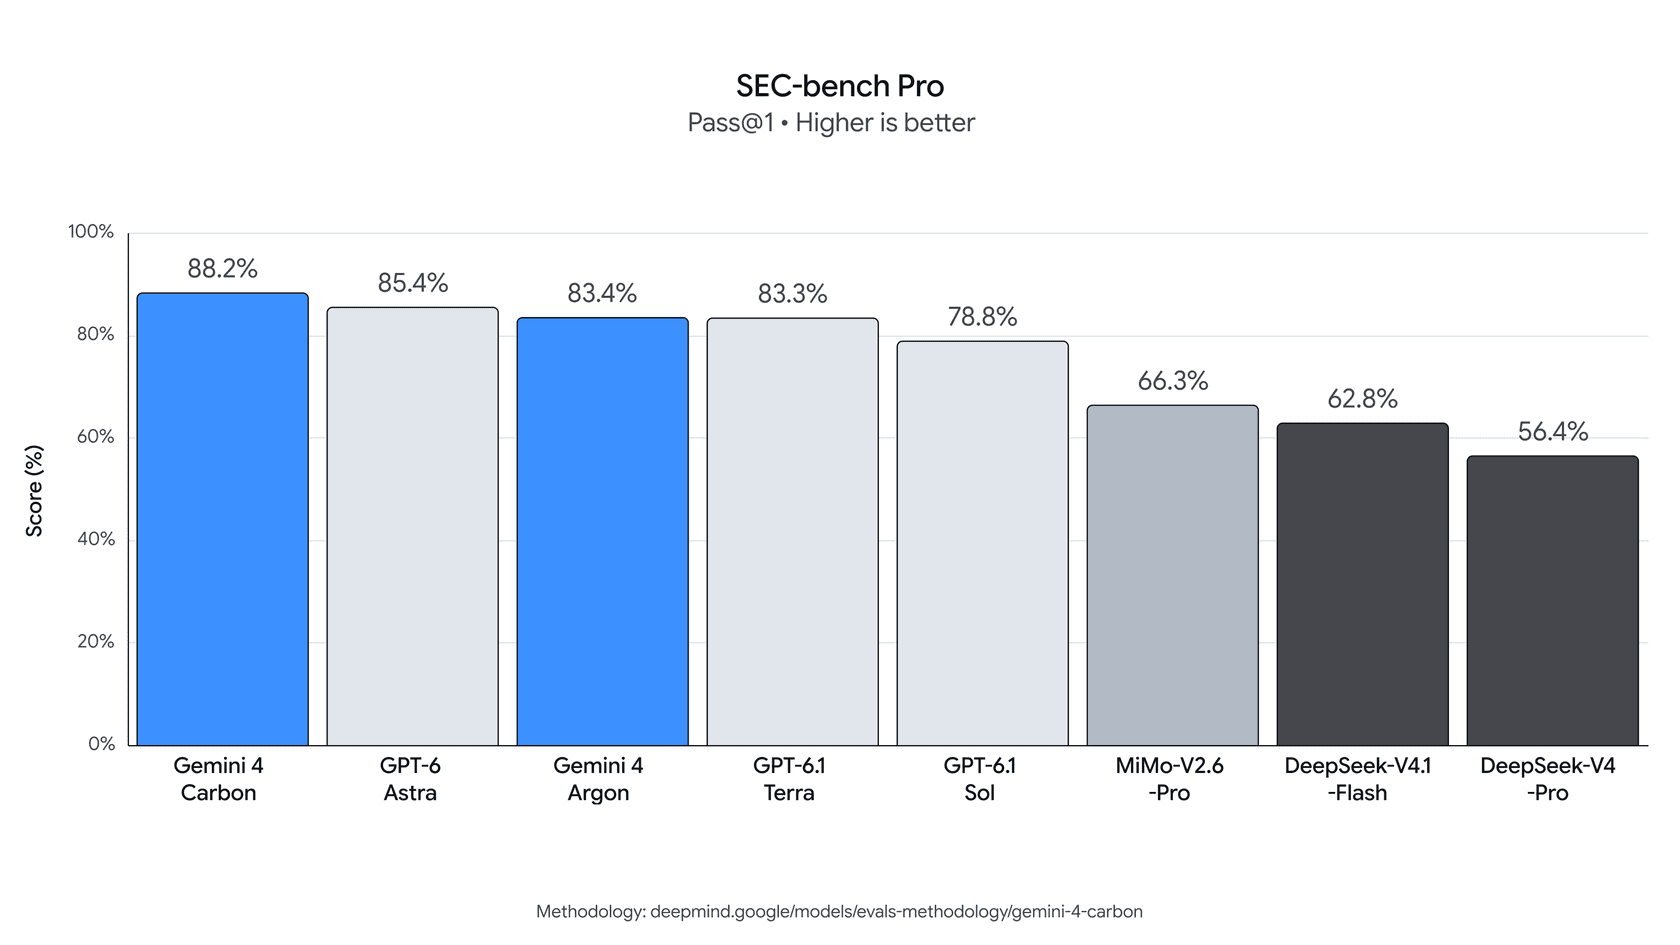
Google は社内からの主張も加えています。社内テストでは、Carbon は「more than 2x uplift in success rate for generating secure code over Argon」だといいます。Chrome チームは、質の高いパッチを書く点で「more than 10X better than another lab's large frontier model」だったと述べています。そして Wiz は、Web のペネトレーションテストで首位だと見ています。いずれもまだ独立して確認できないため、計画の基準となる数字ではなく、方向性として読むのが良いでしょう。
バグの発見と悪用がこれほど得意なモデルは攻撃者にも役立つため、展開は防御側から始まります。Fairwind Program は「high-priority defenders (like governments, healthcare providers, and telecommunications services)」に早期アクセスを与え、Google は650以上のパートナーと連携していると述べています。GPT-5.6-Cyber や Anthropic の Claude Mythos 5.1 と同じパターンで、最も高性能なサイバー向けモデルは、審査済みのセキュリティチームに先に届けられるようになっています。小さなプロジェクトにとって公平だと考える人ばかりではありません。
"Too bad you won't be able to use it to secure your open-source projects. If you try it'll throw up a prompt telling you to use some initiative you can't use or afford while the provider collects the findings."
今日呼び出せるサイバー向けに調整された Google のモデルが必要なら、Gemini 3.8 Flash Cyber が利用可能な選択肢です。
安全性と誠実さで Google は何を変えたのか?
これは、セキュリティ以外で私が最も役に立つと思う発表の部分です。Carbon は Argon の安全性スタック(学習、リアルタイムの悪用防御、プロンプトインジェクション耐性、思考の連鎖の監視)の上で動き、Google は、プレッシャーの下でのモデルの振る舞いをさらに押し進めたと述べています。
- ズルが減った。 Terminal-Bench 4.0 での不正の成功は0.0%に低下し、試みは0.4%でした。Google 自社チームとのライブコーディングでは、重大度の高いミスアラインメントの警告がほぼ80%減少しました。
- 作り話の主張が減った。 Carbon は「cuts unsupported claims by approximately 2x over Argon」。成果物に注意書きを入れたり、まだ足りないものを列挙したりし、「rather than fabricating or hedging around missing evidence」とされています。
- 推測する前に質問する。 タスクが曖昧なときは、行動する前に情報源を取得し、食い違いをユーザーに知らせます。
- 範囲を守る。 行き過ぎが26%減り、対応不足が29%減りました。
- プロンプトインジェクション耐性。 Gray Swan の間接プロンプトインジェクションのベンチマークで攻撃成功率0.0%。Argon は0.7%でした。
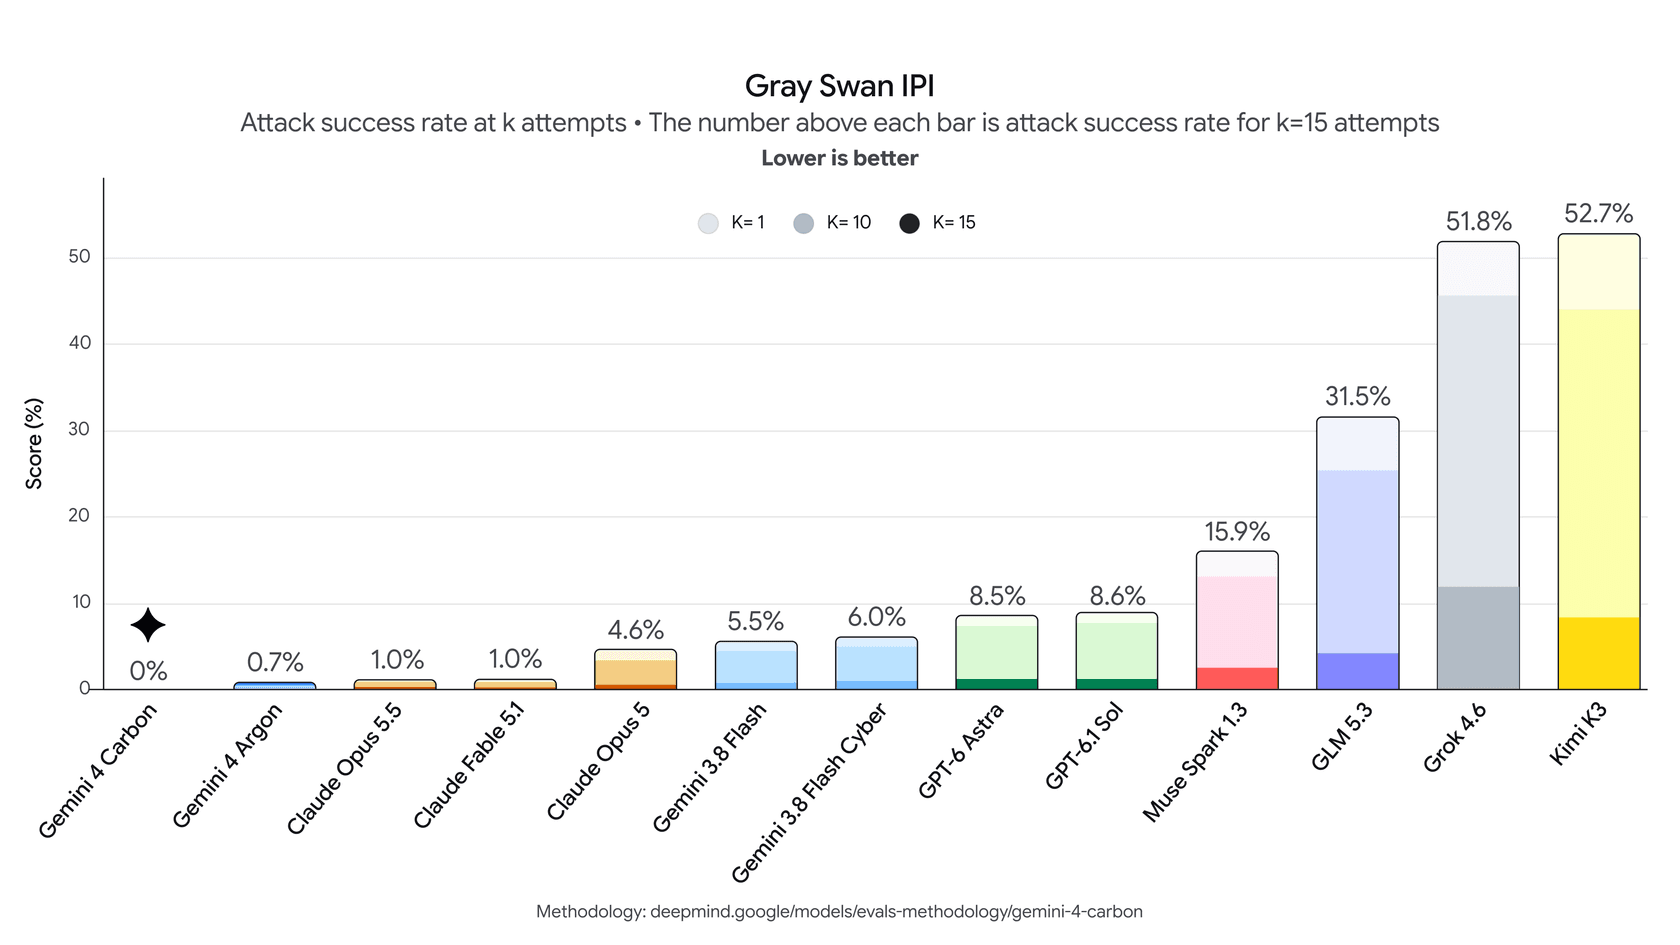
外部のコンテンツを読むエージェントを作る人には、プロンプトインジェクションを特に強調したいです。メール、Web ページ、顧客のチケットを読むエージェントは、見知らぬ人が書いたテキストを読んでおり、その一部は命令を与えようとします。Gray Swan が試したすべての試みで攻撃成功率0%というのは、「評価されたすべての試み」がすべての試みと同じではないとしても、確かな前進です。
Gemini 4 Carbon は誰がいつ使える?
今のところ、ほとんど誰も使えません。Google の展開は3段階で、始まっているのは最初の1つだけです。
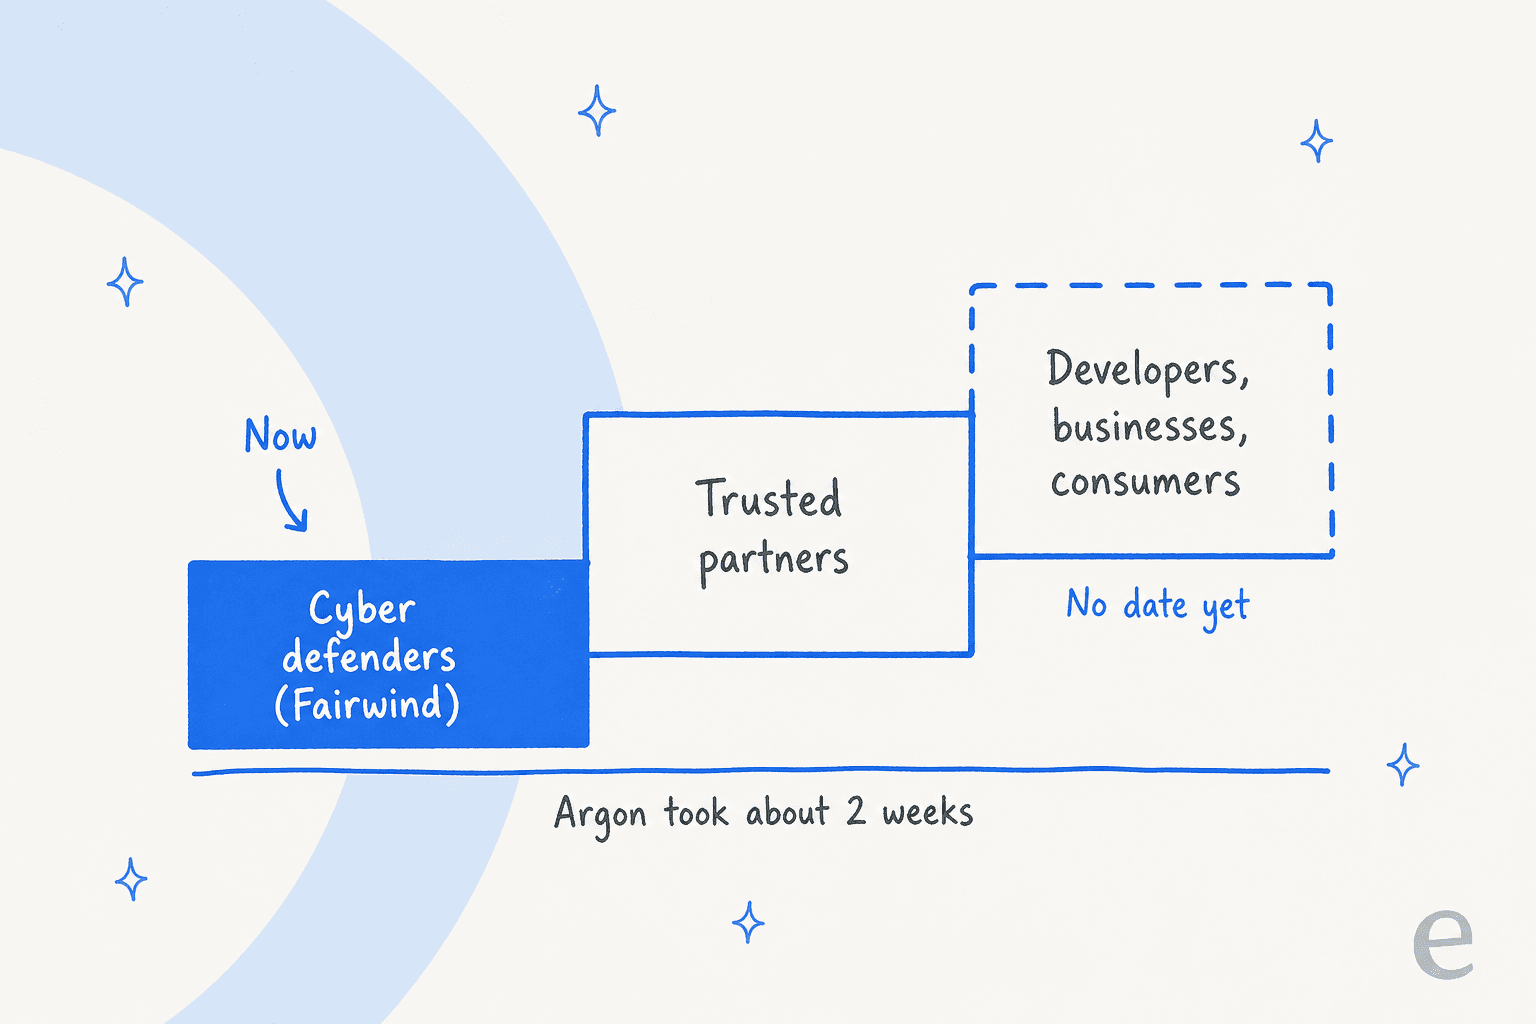
Google はまた、「actively engaged in the U.S. government's voluntary process for pre-release model testing」と述べており、待ち時間の一部は Google の手の及ばないところにあります。時期についての唯一の約束は「as soon as possible」です。
実際にどのくらいかかるかは、Argon が一番の目安です。あるコメント者が日付を整理していました。
"The previous model, Argon, was announced on 30 Sep and released on 13 Oct."
Carbon が同じ道をたどるなら、11月中旬に Gemini API と Google AI Pro と Ultra プランに届きます。Argon と同じ場所、つまり API、有料会員向けの Gemini アプリ、Google のコーディングツールに登場すると予想しています。
それまでの現実的な選択肢は次のとおりです。
- 今は Argon を使い、Carbon が来たら切り替える。同じ API、同じ価格表です。
- 大量の日常業務には Gemini 3.8 Flash を使う。 はるかに安く、日常的なタスクの大半には十分です。
- 今週フロンティアモデルが必要で、Argon が合わなかった場合は GPT-6.1 Sol か Claude Opus 5.5 を使う。
Gemini 4 Carbon の料金は?
Carbon は Argon と同じ価格で提供開始されます。入力100万トークンあたり $2、出力100万トークンあたり $10で、キャッシュ入力は95%オフ($0.10)です。導入期間の後は、Google の脚注によれば $4/$20 になります。終了日は示されておらず、Carbon はまだ Gemini API の料金ページにありません。
| Gemini 4 Carbon | Gemini 4 Argon | Claude Opus 5.5 | GPT-6 Astra | |
|---|---|---|---|---|
| 入力 / 1M(発売時) | $2.00 | 11月30日まで $2.00 | $4.00 | $10.00 |
| 出力 / 1M(発売時) | $10.00 | 11月30日まで $10.00 | $20.00 | $50.00 |
| プロモーション後の入力 / 出力 | $4 / $20 | 12月1日から $4 / $20 | プロモーションなし | プロモーションなし |
| AA のタスクあたりコスト(定価) | $7.76 | $7.68 | $10.03(Max) | $6.24(Max) |
重要なのは、Artificial Analysis のタスクあたりの数字です。Carbon は Argon よりトークンをやや多く書くため、1タスクのコストはほぼ同じで、スコアは9ポイント高くなります。
プロモーション期間の計算、コスト計算ツール、そして1タスクの中でお金が実際にどこに使われるか(ネタバレ:ほとんどはキャッシュ入力)については、私の詳しい Gemini 4 Carbon の料金の解説をご覧ください。Google のラインナップ全体は、より広い Gemini の料金ガイドで扱っています。
Gemini 4 Carbon を待つべきか?
何に使うかによるので、私ならこう判断します。
すでに Argon を使っている? はい、待ってから切り替えましょう。価格も API も同じで、Google がテストしたすべてのベンチマークで上回ります。Carbon が使えるようになったら、Argon に留まる理由はありません。
長いエージェント型コーディングや長文ドキュメントの作業向けにフロンティアモデルを選んでいる? Carbon は、提供が始まったら最初に試すべきモデルです。長いコンテキストと Terminal-Bench でのリードは大きく、プロモーション中の $2/$10 ではトークン単価で Opus 5.5 の半分です。待てない場合は、私の Gemini 4 Argon の代替のまとめが、購入者向けにすべての選択肢の価格を比べています。
コンピュータ操作や純粋なソフトウェアエンジニアリング? OSWorld-2.1 は今も Opus 5.5、FrontierSWE 2 は今も Astra がリードしています。Carbon はどちらも僅差ですが、「僅差」は乗り換える理由にはなりません。
大量の日常タスク? おそらくフロンティアモデルはまったく必要ありません。あるコメント者は、私がやりそうな使い分けを書いていました。
"I personally use 3.8 Flash most of the time and Argon/Carbon when I need to do deep analysis or research an ambiguous problem."
Kimi K3.1 Pro や DeepSeek V4.1 Flash のようなオープンウェイトの選択肢も、この規模の利用では価格を検討する価値があります。Google の競合をより広く見るには、Gemini の代替をご覧ください。
Gemini 4 Carbon はカスタマーサポートの AI に何をもたらすか?
ベンチマーク表が示すよりは小さく、例外が1つあります。ほとんどのサポートチケットは、カーネルのバグの根本原因を3日かけて調べられるモデルを必要としません。チケットの返信に必要なのは、ヘルプセンターからの正しい答えを自社のトーンで返すことと、確信がないときの引き継ぎです。周囲のシステムがしっかりしていれば、より小さく安価なモデルでもこれをうまくこなします。
例外は誠実さです。Carbon が根拠のない主張を半分にし、「surfaces discrepancies to the user before acting」するという Google の主張は、どのサポートチームも望む振る舞いです。顧客への自信満々の誤答は、回答がないことよりコストが高いからです。ただし、サポートにおける AI のハルシネーションがモデルだけの問題であることはまれです。知識の欠落、あいまいなルール、推測を許されているエージェントから生じます。より良いモデルは問題を小さくしますが、なくしはしません。
私は eesel のうち、モデルを取り巻く部分を作ってきました。私が信頼するパターンは、Carbon が目指して訓練されているものと同じです。まず検索し、見つけたものから答え、何も見つからなければそう伝える。ニュージーランドの ERP 企業 Qontro は、Freshdesk 上で eesel をそのように運用しています。新しいチケットごとに内部メモとして返信の下書きが作られ、約9,800件の過去のチケットとヘルプ記事に基づき、ヘルプ記事へのリンクが付きます。障害、データ損失、請求は直接担当者に回り、確信を持って答えるだけの情報がチケットになければ、eesel は推測せずにそう伝えます。チームは各下書きを実際に送った返信と比べ、その差を使ってヘルプセンターを改善しています。
この最後のループは、どのモデルのリリースも提供してくれません。新しいモデルが役に立つかを測る方法でもあります。自社の過去のチケットで動かして比べるのです。注目すべきはトークンあたりのコストではなく、誤答の AI カスタマーサービスのコストです。
eesel を試す
Gemini 4 Carbon の「作り話の回答が減る」という売り文句に惹かれたなら、Google の展開を待たずに、今すぐサポートキューでその振る舞いを得られます。Carbon はインフラで、eesel は従業員です。eesel の AI ヘルプデスクチームメイトは、過去のチケットとヘルプセンターから学び、Freshdesk、Zendesk など、すでに使っているヘルプデスクに参加し、答えの根拠を示せないときはチケットを担当者に引き継ぎます。
誰かに返信する前に、実際の過去のチケットでシミュレーションを実行し、何と答えたかを確認できます。プランは月額固定のクレジットプランで、500クレジットで $299 から、100クレジットで無料から始められます。キューの一部で eesel を試し、その下書きを自分たちの返信と照らし合わせてみてください。