

EmbeddingGemma 2 とは?
EmbeddingGemma 2 は、2026年10月6日に発表された Google DeepMind のオープンな埋め込みモデルです。
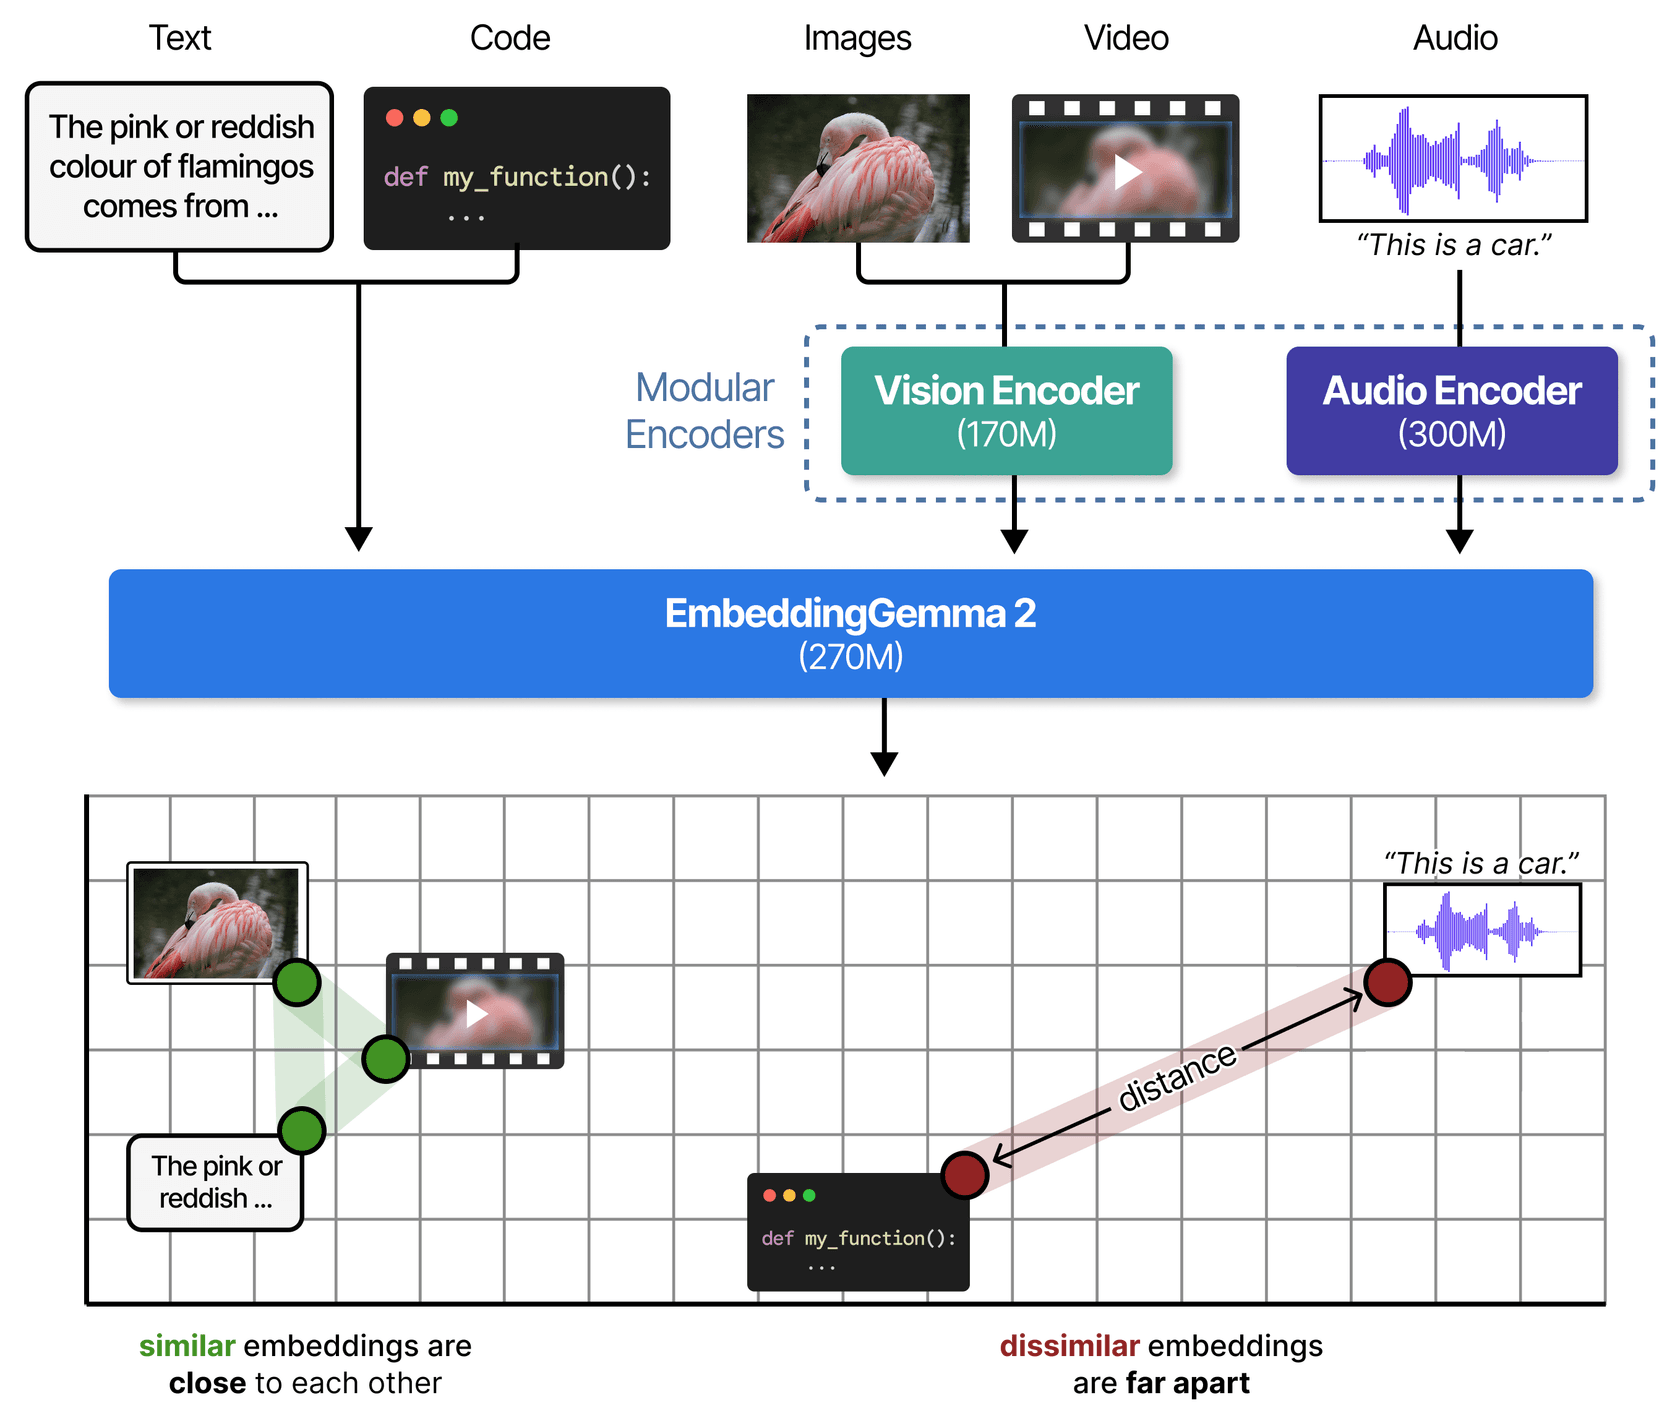
埋め込みモデルの仕事は1つだけです。入力を数値のリスト(ベクトル)に変換し、似たものが近くに来るようにします。これがセマンティック検索、クラスタリング、そして RAG の検索側を支えるエンジンです。
最初の EmbeddingGemma は308Mのテキスト専用モデルで、2025年に登場し、Google によれば2,000万ダウンロードを超えました。バージョン2は、小さくてどこでも動くという考え方を保ちつつ、さらに4種類の入力に対応してマルチモーダルになりました。モデルカードによれば、テキスト(コードを含む)、画像、動画、音声、あるいはそれらの任意の組み合わせを、1つの768次元空間に写像します。
私の立場について簡単に触れておきます。私は eesel のソフトウェアエンジニアで、チケットに返信する前に顧客のヘルプセンターを検索する AI エージェントを作っています。そのため、埋め込みモデルの発表を読むときは、リーダーボードよりも3つの問いに関心があります。前のモデルが見逃したものを何が見つけるのか、動かすのにいくらかかるのか、何が壊れるのか。私はこのモデルを本番で動かしたことはありません。判断は、Google のモデルカードとドキュメント、開発者ガイド、そして Hacker News に寄せられた最初の3日間の実機レポートに基づいています。
EmbeddingGemma 2 の概要
| 項目 | EmbeddingGemma 2 | 出典 |
|---|---|---|
| 公開日 | 2026年10月6日 | Google blog |
| パラメータ | 合計 740M:テキスト 270M、ビジョン 170M、音声 300M | Model card |
| 入力 | テキスト、コード、画像、動画、音声、およびそれらの混在 | Model card |
| 出力 | 768 次元、512、256、128 に切り詰め可能 | Developer guide |
| コンテキストウィンドウ | 8,192 トークン(v1:2,048) | Model card |
| 対応言語 | 100以上 | Gemma docs |
| RAM、量子化、Pixel 11 Pro | テキストのみ ~191MB、フル ~567MB | Google AI Edge |
| ライセンス | Apache 2.0 | Gemma docs |
| 価格 | 重みは無料。計算資源は自己負担 | n/a |
| ベース | Gemma 4 デコーダーアーキテクチャ | Gemma docs |
EmbeddingGemma 2 はどう動く?
中身は、小さなテキストモデルの前に2つの任意のアドオンを付けた構造です。コアは270Mパラメータのモデル(130Mのトランスフォーマーと140Mのエンベッダー)で、Gemma 4 のデコーダーから調整されています。170Mのビジョンエンコーダーが画像、動画フレーム、PDF やスライドなどの視覚的ドキュメントを扱います。300Mの音声エンコーダーが生の音声や音を受け取ります。すべて同じバックボーンを通り、768個の数値からなる1つのベクトルとして出てきます。
巧みなのは、アドオンが読み込み時に任意である点です。vision_config や audio_config を None に設定すると、そのエンコーダーは読み込まれず、ディスクとメモリを節約できます。Google の開発者ガイドによれば、4つの構成はすべて同じチェックポイントから読み込まれ、1つのベクトル空間を共有します。270Mのテキスト専用構成で埋め込んだクエリが、フルモデルで埋め込んだドキュメントと一致します。
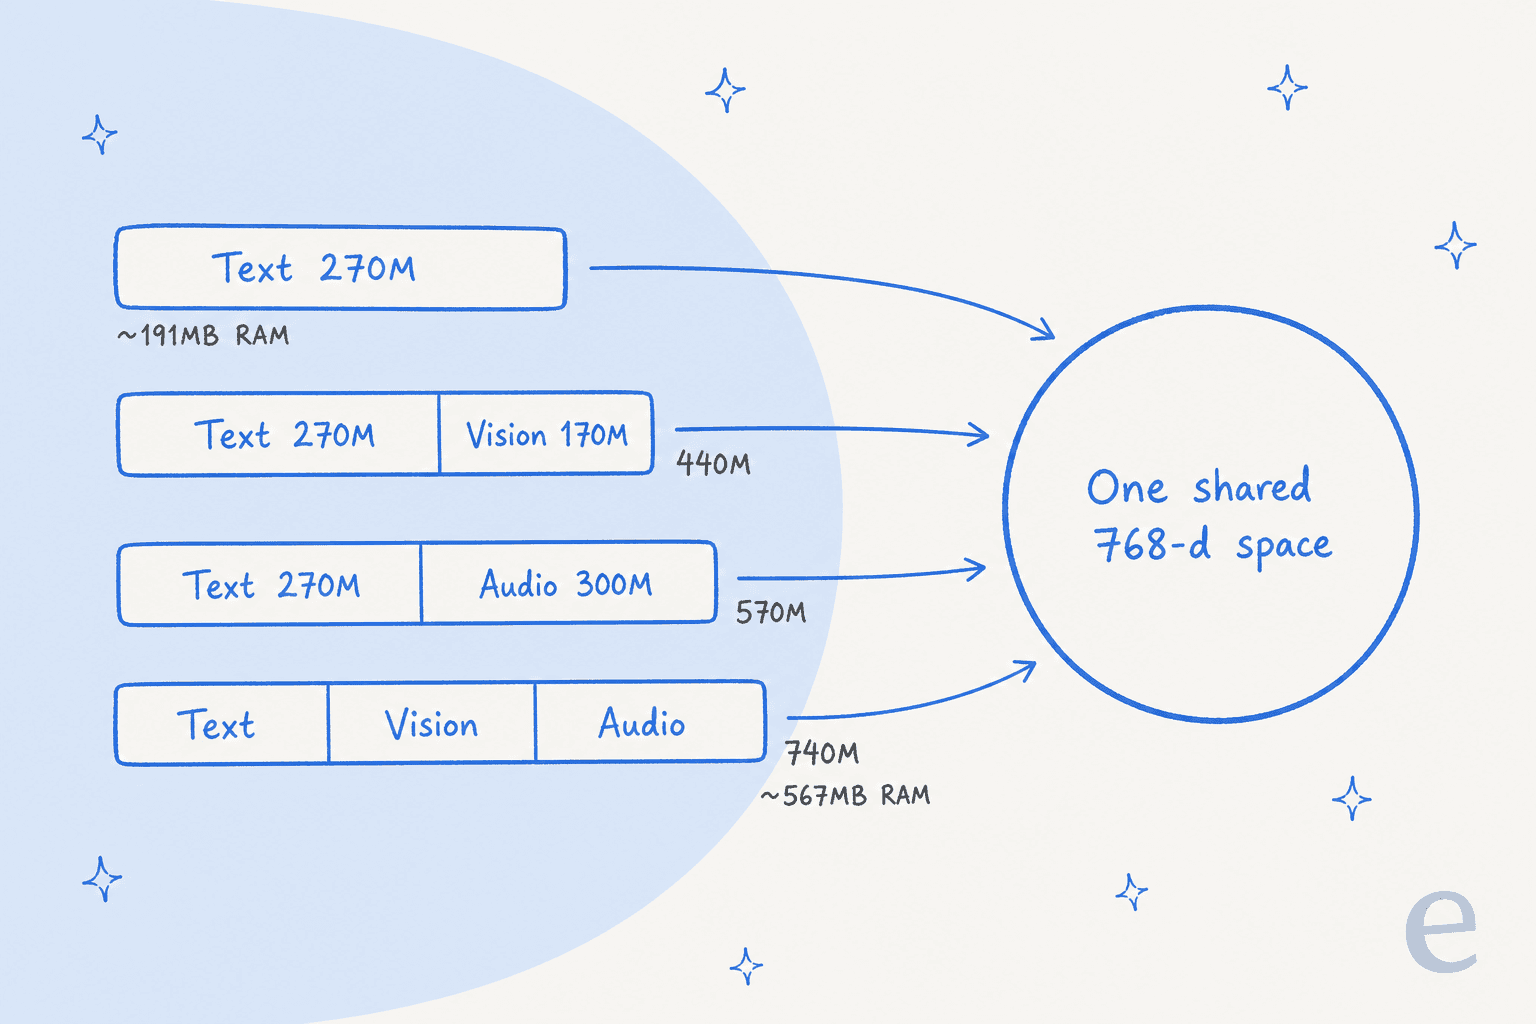
これには、私がとても気に入っている実用上の利点があります。テキストのみで始めて、後から画像を追加しても、すでにあるベクトルを1つも再計算する必要がありませんとガイドは述べています。モデルを変えたために100万件のドキュメントを再埋め込みした経験があれば、その価値がよくわかるはずです。
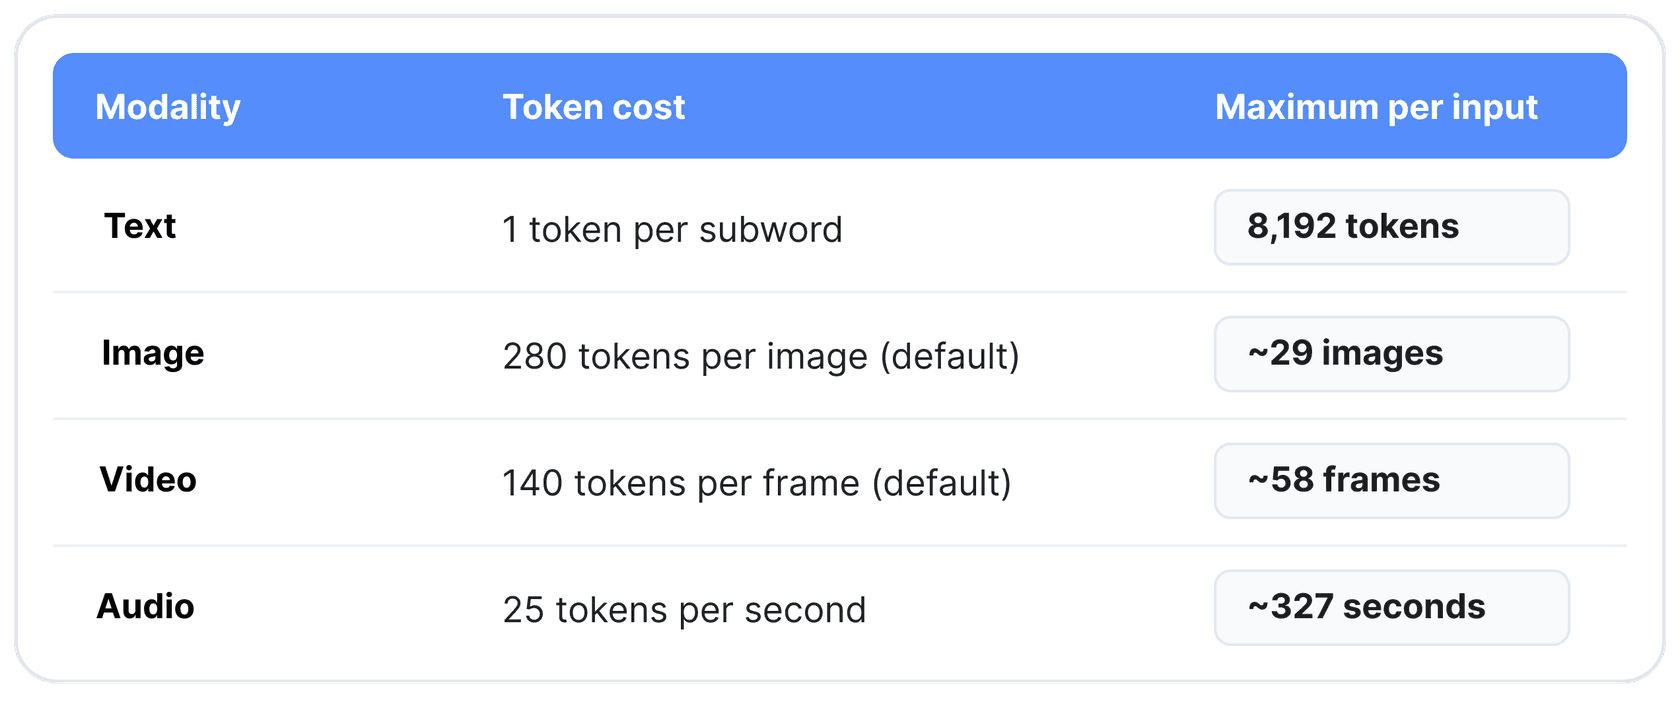
入力は8,192トークンのコンテキストウィンドウを固定レートで共有し、トークンで数えます。画像1枚はデフォルトで280トークン、動画フレーム1枚は140トークン、音声1秒は25トークンです。そのため、モデルカードによれば、1回の呼び出しに約29枚の画像、58フレームの動画、または327秒の音声を収められます。
コードを書く前に知っておきたい仕組みがいくつかあります。
- 動画はデフォルトで毎秒1フレームでサンプリングされ、音声は16 kHz モノラルである必要があります。
- 画像の詳細度は調整できます。マルチモーダルのドキュメントには、画像あたり5つの予算(70、140、280、560、1,120トークン)が載っています。トークンが多いほど細部が細かくなり、処理は遅くなります。
- **混在させられます。**1つの入力に、
<|image|>、<|video|>、<|audio|>のプレースホルダーでテキストを混ぜられます。写真とデモクリップ付きの商品ページのようなものでも、1つのベクトルとして出てきます。 - **テキストにはタスク用のプレフィックスが付き、メディアには付きません。**クエリは
task: search result | query: ...、ドキュメントはtitle: ... | text: ...のようになります。プレフィックスを省いても動きますが、精度が落ちます。
EmbeddingGemma 1 から何が変わった?
ここは慎重に見たいところです。発表の見せ方と数値は、少し違うことを語っているからです。Google の発表では、v2 は v1 の多言語テキスト性能と同等で、コードで大きく伸びたとしています。これは事実です。ただしモデルカードには MTEB 英語も載っており、そこでは v2 が少し下回ります。
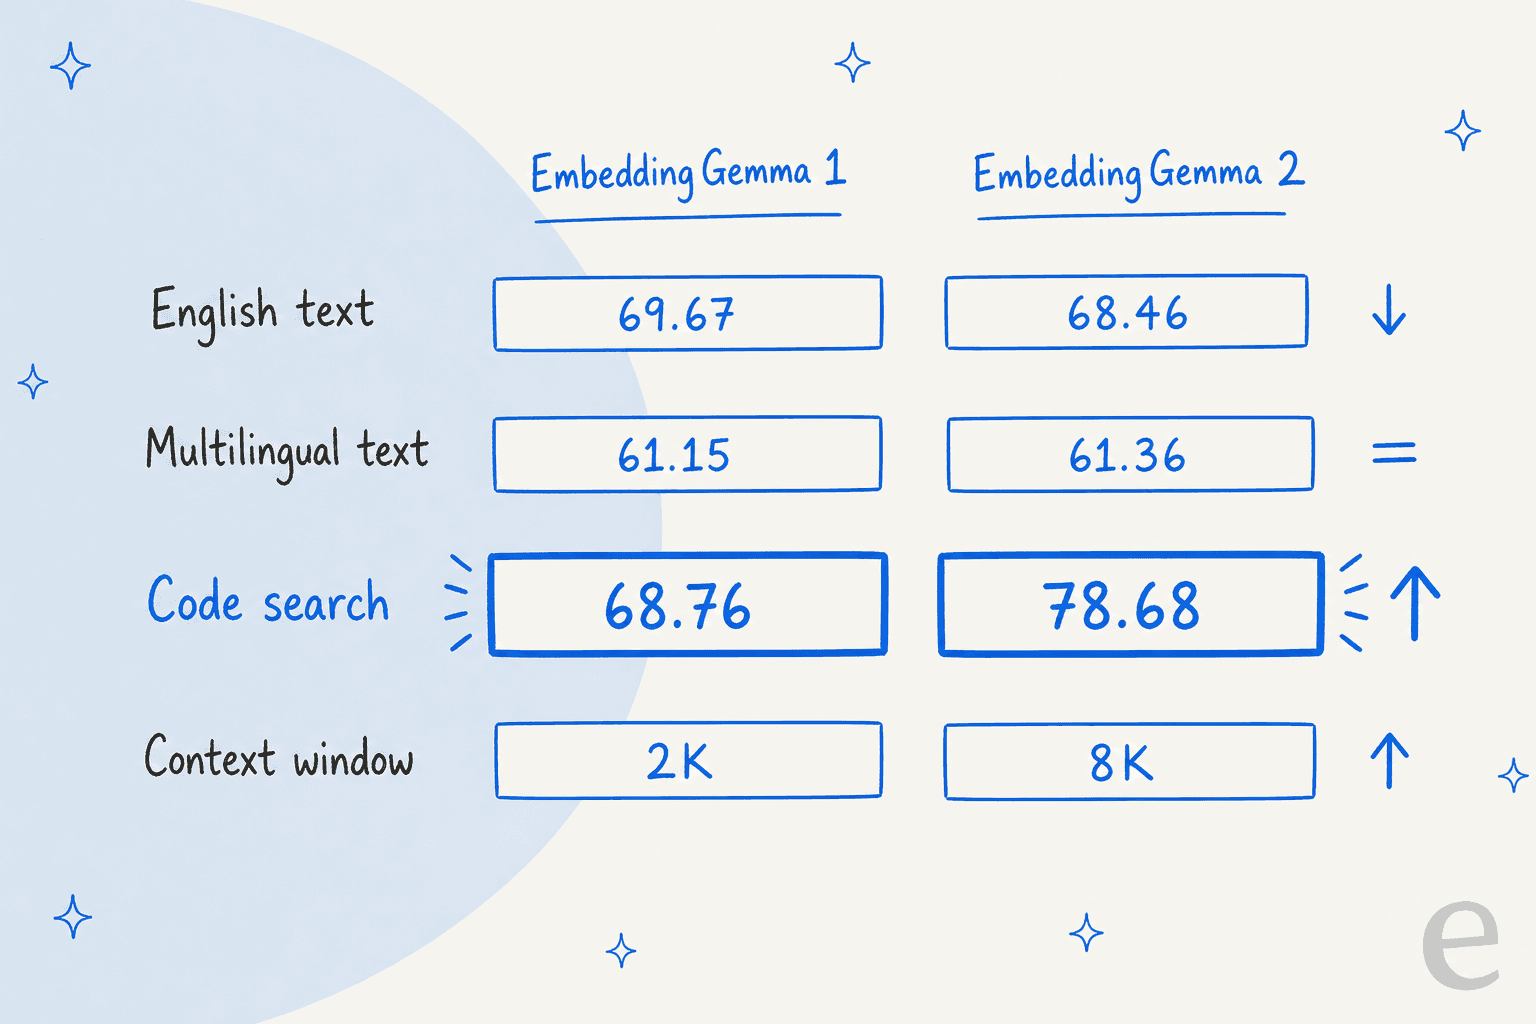
| ベンチマーク(768次元) | EmbeddingGemma 1 | EmbeddingGemma 2 | 変化 |
|---|---|---|---|
| MTEB English v2 | 69.67 | 68.46 | -1.21 |
| MTEB Multilingual v2 | 61.15 | 61.36 | +0.21 |
| MTEB Code v1 | 68.76 | 78.68 | +9.92 |
| コンテキストウィンドウ | 2,048トークン | 8,192トークン | 4x |
| 入力 | テキスト | テキスト、コード、画像、動画、音声 | +4 |
| ライセンス | Gemma の利用条件、ゲート付きダウンロード | Apache 2.0 | オープン |
v1 の数値は EmbeddingGemma 300M のカード、v2 の数値は v2 のカードによるものです。初期に実際に試した人たちも同じ結論でした。
"for text, benchmarks are identical to the first EmbeddingGemma. but you can use this new one and enable/disable what you don't need. can keep only text for ex."

私の見方は単純です。英語テキストだけを検索するなら、v2 は横ばいの移行です。アップグレードする価値があるのは、4倍長いコンテキストが役に立つ場合(チャンクを減らして大きくできる)か、Apache ライセンスがプロダクトの障害を取り除く場合だけです。コード、またはテキスト以外を検索するなら大きな前進です。ほとんどが記事で構成されるヘルプセンターなら、このアップグレードよりも RAG とファインチューニングについての私の考えのほうが重要です。
新しいベンチマークが示すこと
新しい入力タイプには比較対象の v1 がないため、モデルカードのスコアが単独で並びます。Google は、MTEB Code と音声ベンチマークの MAEB において、1B未満のマルチモーダル埋め込みモデルの中で「best-in-class」だとしています。これはカードに直接比較の表がないベンダーの主張なので、出発点として扱ってください。
| 入力 | ベンチマーク | スコア |
|---|---|---|
| 画像 | MIEB lite | 64.64 |
| 画像 | MMEB v2 Image (Hit@1) | 57.28 |
| 視覚的ドキュメント | MMEB v2 VisDoc (NDCG@5) | 67.84 |
| 動画 | MMEB v2 Video (Hit@1) | 50.67 |
| 音声 | MSEB Retrieval (MRR@10) | 69.54 |
| 音声 | MAEB | 49.39 |
HN のスレッドから気になる点を2つ挙げます。1人のコメント投稿者は、Google 自身の画像テキストモデルである SigLIP 2 と比較されていない理由を尋ねました。別の人はローカルで動かし、Google 自身のデモにあるゼロショット分類の例が外れることを見つけました。
"I got this running locally, and funnily enough the exact example they have for classifying "Cancel my flight and refund my credit card immediately." failed. It said the request does not involve a payment, charge, or refund, with a p(true) of 0.22 (where true means it is financial)."
チケットの振り分けに使おうと考えている人には少し痛い話です。「返金かどうか」は、まさにサポートチームが欲しいラベルだからです。1つの事例は結論ではありませんが、何かに接続する前に自社のチケットで試すには十分な理由です。
マルチモーダルのドキュメントには、目立たない落とし穴もあります。類似度スコアはモダリティ間で較正されていません。無関係な絵画がゴールデンゲートの写真に対して0.585を記録し、無関係なテキストプロンプトより高くなりました。比較するのは1回の検索内での順位であり、画像とテキストの間の生のスコアではありません。
実際の速さと小ささは?
ここで EmbeddingGemma 2 は「オンデバイス」の名にふさわしくなります。Google の AI Edge チームは、70トークンの予算で画像1枚を埋め込む場合のデバイス別の数値を公開しました。
| デバイス | チップ | 画像あたりのレイテンシ | 画像/秒 |
|---|---|---|---|
| iPhone 18 Pro | CPU | 191 ms | 5.2 |
| iPhone 18 Pro | GPU | 69.8 ms | 14.3 |
| Pixel 11 Pro XL | NPU | 48.9 ms | 20.6 |
| MacBook M5 Pro | GPU | 37.3 ms | 26.9 |
| Dell XPS 16 | NPU | 49.8 ms | 20.1 |
| Raspberry Pi 5 | CPU | 1,761 ms | 0.6 |
ノート PC での実測値も似ています。ある HN のコメント投稿者が M3 Pro でのスループットを共有しています。
"Text: 78 embeddings/second on small texts - Image: 4 embeddings/second - Audio: 6 embeddings/second for 30 second chunks (which is how the encoder works) - Video: 0.2 embeddings/second per minute of video"
差に注目してください。動画は映像1分あたり0.2なので、このノート PC では1時間の動画のインデックス作成に約5分かかります。製品デモのライブラリなら問題ありません。大量のライブ動画には遅すぎます。
もう1つの調整手段はストレージです。このモデルは Matryoshka 学習を使っているため、ベクトルを768個から512、256、128個に切り詰めても、品質の大半を保てます。開発者ガイドによれば、768次元のベクトル100万件は bfloat16 で約1.5GB、128次元なら約250MBです。
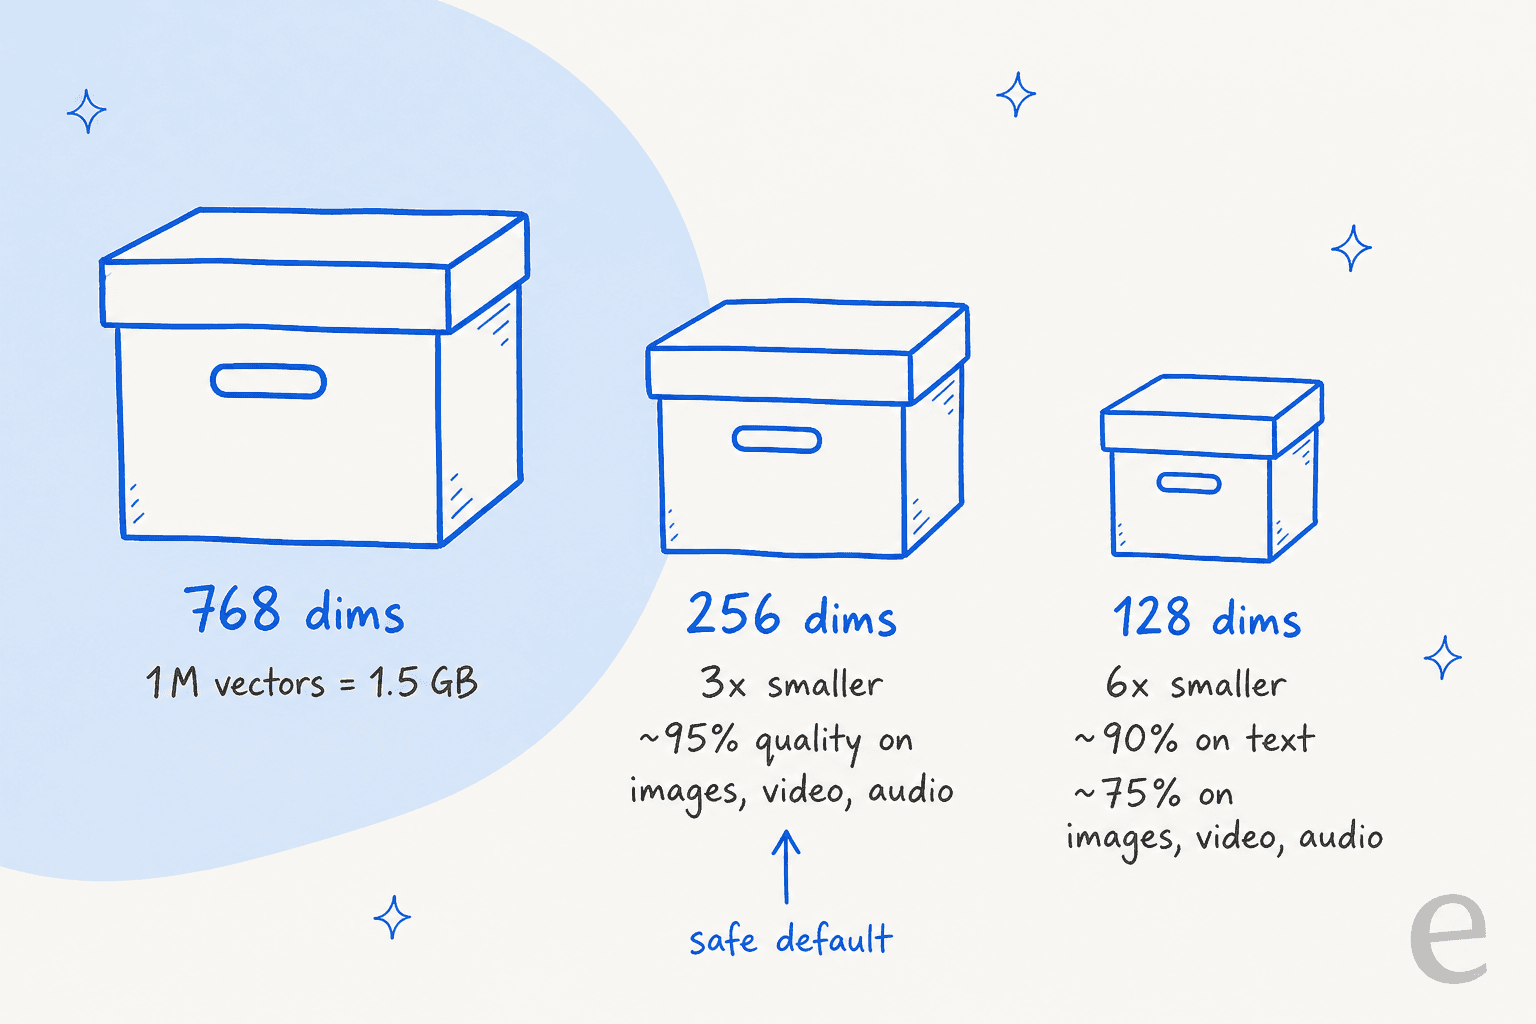
注意点は、切り詰めるとメディアはテキストより早く劣化することです。モデルカードでは、MMEB v2 は768次元の59.01から128次元の45.65に下がります。混在インデックスなら256次元で止めるのがよく、128次元は後で再ランキングするテキストのみの候補絞り込みに限りましょう。カードにある2つのルールは、守らないと痛い目に遭います。切り詰めた後にベクトルを再正規化すること、そして float16 では決して実行しないことです。活性化値がオーバーフローし、エラーなしで NaN や静かに質の落ちたベクトルが出ます。
どの EmbeddingGemma 2 の構成を読み込むべき?
メモリは読み込んだエンコーダーの分だけで済むので、最初に決めるのはインデックスに実際に何が入るかです。最も近いものを選んでください。
検索インデックスに何を入れますか?
選択肢をタップすると、私が最初に選ぶ構成が表示されます。
vision_config=None, audio_config=None で読み込みます。正直な注意点:英語のみの検索では v1 のほうがわずかに高スコアでした(69.67対68.46)。乗り換えるのは 8K コンテキストや Apache 2.0 が必要なときで、精度のためではありません。256次元は安全なストレージ削減です。CodeRetrieval プロンプトを使い、ドキュメントのタイトルにファイル名を入れます。512または768次元のままにしてください。コードは切り詰めで最も早く品質が落ちます。audio_config=None で読み込みます。ビジョンは画像、PDF、スライド、チャートを扱えます(MMEB v2 VisDoc 67.84)。スクリーンショットに小さな文字がある場合は、画像の予算を560または1,120トークンに上げます。256次元以上を保ちましょう。vision_config=None で読み込みます。音声を16 kHz モノラルにリサンプリングし、分割します。1回の呼び出しで約327秒入ります。単に「これは音声」ではなく話の内容に一致しますが、まず自社の通話で試してください。EmbeddingGemma 2 はどう動かす?
重みは Hugging Face と Kaggle にあり(初めてなら、私の Hugging Face 解説から始めてください)、初日から幅広くサポートされています。sentence-transformers(v6.1.0以降)、Transformers、vLLM、SGLang、MLX、llama.cpp GGUF、Ollama、LM Studio、そしてスマートフォン向けの Google 自身の LiteRT です。モデルカードから引いた最短の手順はこちらです。
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

query_emb = model.encode("What causes the northern lights?", prompt_name="SearchQuery")
doc_emb = model.encode("The northern lights are caused by charged particles from the sun.", prompt_name="Document")
print(model.similarity(query_emb, doc_emb))
Python に触れたくなければ、Ollama 版がほとんどのローカル RAG スタックに組み込め、LangChain や LlamaIndex などのフレームワークでも他の埋め込みモデルと同じように扱えます。
サポート向けの実例は、私のサポート RAG パイプラインの解説か、この Zendesk のセマンティック検索ガイドを参照してください。ベクトルの保存先は引き続き必要です。Qdrant は発表当日にガイドを公開しており、選び方は私の RAG とベクトルデータベースの記事で解説しています。
スマートフォンでは、Google が「今後数週間のうちに」、NPU アクセラレーション付きのマネージド ML Kit サービスとして Android に提供する予定です。それまでは AI Edge Gallery アプリが体感する最も簡単な方法です。Instant Media Search のデモは、入力しながらオフラインでカメラロールを検索し、Video Moments Finder は「フリスビーをキャッチする犬」のようなクエリで、文字起こしなしに該当のタイムスタンプへジャンプします。
セルフホストか Gemini Embedding 2 か?
これが私の提案する2つ目の捉え直しです。EmbeddingGemma 2 は無料でダウンロードできるため、安い選択肢だと思われがちです。しかしほとんどのチームにとって、大きく安いわけではありません。Google のホスト型の兄弟モデルがすでに非常に安いからです。
Gemini Embedding 2 は Google の有料マルチモーダル埋め込み API で、現在の Gemini API 料金表にある唯一の埋め込みモデルです。(Google の API をより広く比較するなら、OpenAI API と Gemini APIを参照してください。)残りは私の Gemini の料金の記事で扱っています。ここでは埋め込みの料金だけ載せます。
| 入力 | 標準(100万トークンあたり) | バッチ | 単位あたり(標準) |
|---|---|---|---|
| テキスト | $0.20 | $0.10 | n/a |
| 画像 | $0.45 | $0.225 | 1枚あたり $0.00012 |
| 音声 | $6.50 | $3.25 | 1秒あたり $0.00016 |
| 動画 | $12.00 | $6.00 | 1フレームあたり $0.00079 |
中規模のサポートチームを例に計算してみましょう。ヘルプ記事2,000本(1本約800トークン、合計160万トークン)、製品スクリーンショット10,000枚、通話録音100時間とします。
- 記事:160万トークン x $0.20 = $0.32
- スクリーンショット:10,000 x $0.00012 = $1.20
- 通話:360,000秒 x $0.00016 = $57.60
標準料金でライブラリ全体を一度埋め込んでも$60未満で、バッチならその半分です。HN のあるコメント投稿者が挙げた1時間あたり$1~$2のレンタル GPU は、立ち上げだけでそれ以上の時間動きます。そこで、選択は次のように整理します。
- Gemini Embedding 2 を使うのは、データを Google の API に送れて、セットアップをゼロにしたい場合です。ただし、無料プランのデータは Google の製品改善に使われる場合があり、有料プランでは使われない点に注意してください。
- EmbeddingGemma 2 を使うのは、データをデバイスや自社サーバーの外に出せない場合(医療、法務、社内サポート)、オフラインで必要な場合、またはスマートフォンでクエリを埋め込み、往復通信を避けたい場合です。これらは本物の理由です。コストだけではたいてい理由になりません。
Simon Willison は、オープンな埋め込みモデルを支持する論点をうまくまとめています。
"I really appreciate that EmbeddingGemma 2 is under the Apache 2.0 license. For embedding models in particular, I don't think it makes sense to use a closed, proprietary, hosted-only model."
彼の論点は、価格よりもロックインにあります。インデックスのベクトルはすべて、それを作ったモデルに結びついています。ホスト型モデルが廃止されれば、すべてを再埋め込みする必要があります。オープンな重みなら、コピーを持っている限り、インデックス作成に使ったモデルを使い続けられます。
サポートチームがマルチモーダルに注目すべき理由
これは、発表の報道では見かけなかった視点です。カスタマーサービス向け RAG についての記事の多くは、知識がテキストであると前提しています。実際にはそうでないものが多く、eesel のセールスコールでも頻繁に話題になります。
月に約7,000件のチケットを扱う DTC サプリメントブランドは、答えが ClickUp の SOP、文字起こしされていない Loom 動画、古いマクロの中にあると話しました。月に約3,000件の複雑なチケットを扱う公共セクターの IT 企業は、画像の多い技術ドキュメントとともに Freshdesk で運用しています。技術系製品のチームは、PDF 内の図や、顧客がチケットに添付した写真を読める AI を繰り返し求めています。テキスト専用の埋め込みモデルは、誰かが文字起こしやキャプション付けをしない限りそれらを見られません。だから多くのサポート向けナレッジベースツールが、いまもメディアを答えではなく添付ファイルとして扱っているのです。
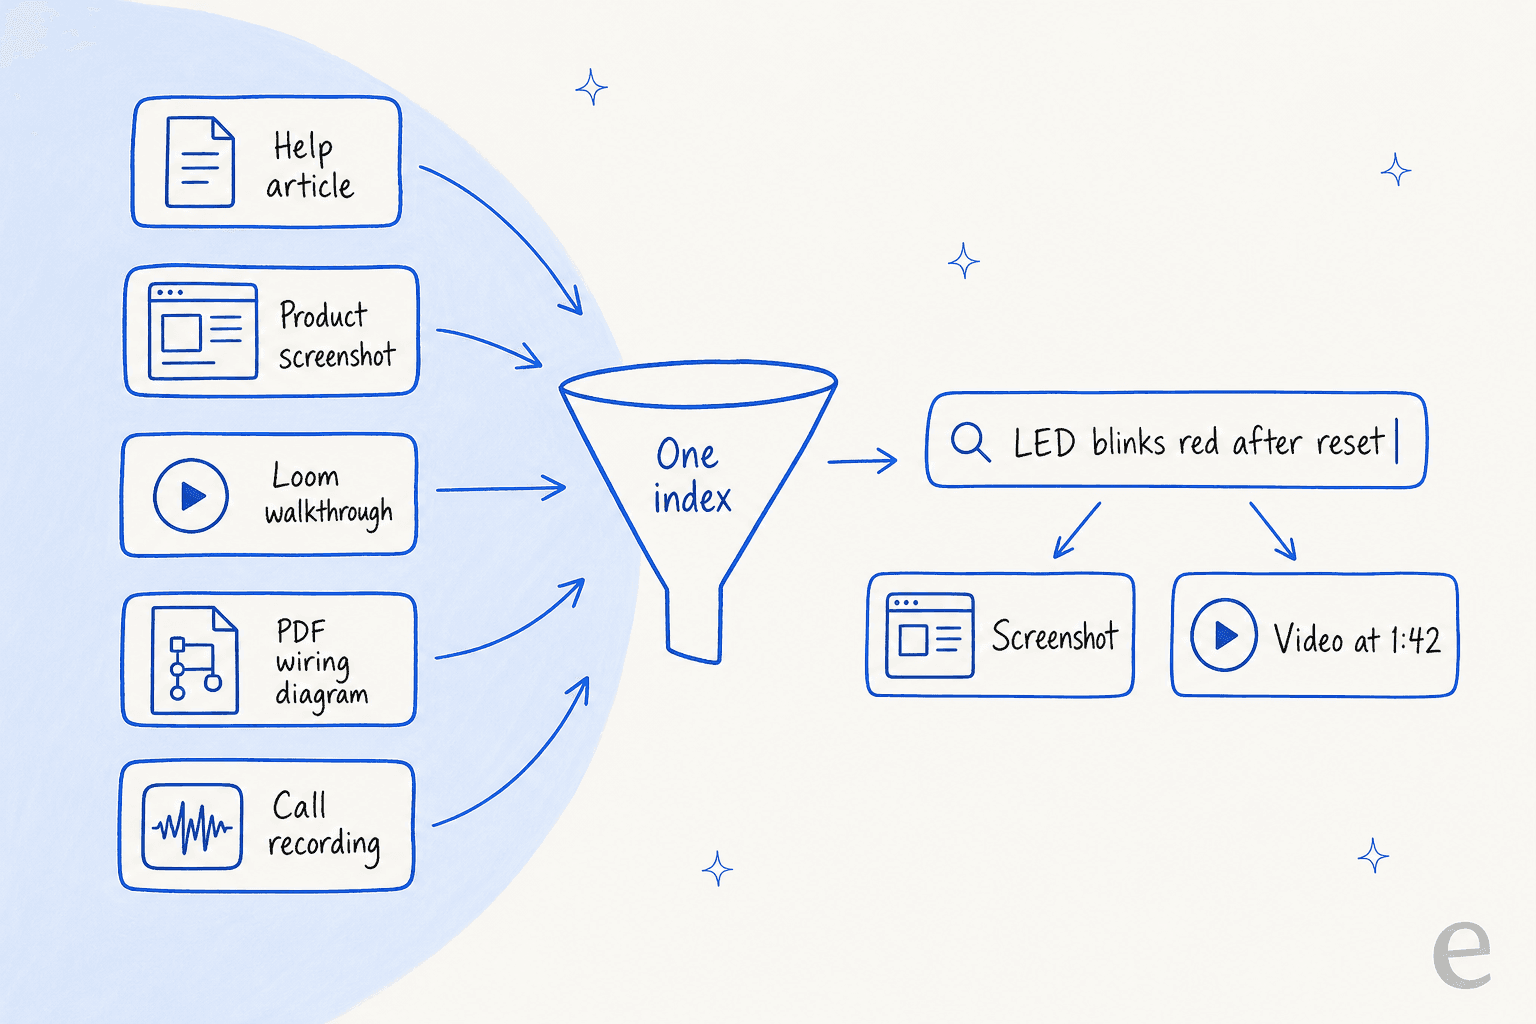
1つの共有空間がその解決策です。スクリーンショット、解説動画、記事を一緒にインデックスすれば、「リセット後に LED が赤く点滅する」のようなテキストクエリで、正しい動画の正しいフレームを呼び出せます。HN の読者である弁護士が、訴訟記録で同じ発想を述べていました。
"I could imagine using it to search a case file for "undamaged roof before Hurricane Katrina" and "damaged roof after Hurricane Katrina" and being able to locate both deposition testimony and pertinent photographs in the body of evidence."
ただし、検索はサポートボットの半分にすぎず、私の経験では痛みを生むのはその半分ではありません。今年の初め、デンマークの太陽光エネルギー会社を含む数社の eesel の有料顧客で、ナレッジベースの検索結果が空だったときにボットが答えをでっち上げました。モデルの学習データで空白を埋めてしまい、典型的な AI のハルシネーションとして、実際の顧客に作り話の契約内容を送ってしまったのです。
より良い埋め込みモデルでも防げませんでした。解決したのは「一致なし、人間に引き継ぐ」という厳格なルールと、公開前に過去のチケットでボットをシミュレーションすることでした。EmbeddingGemma 2 を使って構築するなら、最初からこの層を計画してください。パターンは私の AI のハルシネーションを防ぐガイドにまとめています。
EmbeddingGemma 2 は誰が使うべき?
| あなたの状況 | 私の見解 |
|---|---|
| コードベースやコーディングエージェントのメモリに対する検索を構築している | 使いましょう。MTEB Code の+9.92ポイントは、このリリースで最も明確な成果です。 |
| 写真、スクリーンショット、PDF、音声、動画を検索している | 256次元以上で使い、自社のファイルで試してください。 |
| アプリにオンデバイスまたはオフライン検索を載せる | 使いましょう。テキストで191MBならスマートフォンに十分小さく、Android ML Kit のサポートも近く来ます。 |
| すでに英語テキストだけで EmbeddingGemma 1 を使っている | 8K コンテキストか Apache ライセンスが必要でない限り、そのままで構いません。 |
| データ制限なしでクラウドでサポート検索を動かしている | Gemini Embedding 2 のほうが、ほぼ同じ費用で手間が少なくなります。 |
| パイプラインではなく、動くサポートボットが欲しい | 構築は省きましょう。このモデルは5つの部品のうちの1つです。 |
他の選択肢との比較には、主なホスト型の代替を扱った Cohere Embed 5 と OpenAI の埋め込み API の記事があり、このモデルが属するオンデバイスの流れについては小規模言語モデルでさらに掘り下げています。
より広い分野については、ナレッジ検索ツールのまとめで完成品を比較しています。
結論
EmbeddingGemma 2 は、良質で誠実なリリースです。モジュール式の設計は賢く、Apache ライセンスは現実の障害を取り除き、コード検索とマルチモーダル検索はスマートフォンに収まるほど小さなパッケージで明確に前進しました。データがテキストだけではないなら、最初に試すオープンモデルです。
ただ、見出しの先まで読んでください。英語テキストでは置き換え前のモデルと同等で、「best-in-class」という主張は Google 自身のものであり、多くのクラウド型チームにとってはホスト型 API のほうが自前運用とほぼ同じ費用です。プライバシー、オフライン利用、コード、メディアのために選べば満足できます。プレーンテキスト検索の大幅な向上を期待して選ぶと、それは得られません。
eesel を試す
新しい埋め込みモデルでサポートボットを作ろうと考えてここに来たなら、近道があります。埋め込みモデルは文章の断片を見つけますが、それを読み、返信を書き、黙るべきときを判断するのは別の仕事です。eesel の AI ヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgias の中でその仕事を行います。ヘルプセンター、Confluence や Google Docs などにあるドキュメント、過去のチケットから学習し、実際のチケット数百件でシミュレーションを実行するので、顧客より先に回答を確認できます。検索結果が空のときは、推測せずに担当者へチケットを引き継ぎます。

100クレジットのフリープランがあり、カードは不要です。有料プランは料金ページにあります。何かを構築する前に、eesel を試して先月のチケットを再生してみてください。