

Inkling 2 Miniの目玉はタスクあたりのコストだ。Artificial AnalysisはQwen3.8-27Bと同じ20点を付け、タスクあたり0.59ドル(3.53ドルに対して)、タスクあたり9.0分(34.5分に対して)で動く。Apache 2.0の264億パラメータのループモデルで、約20GBに収まる。引き換えになるのは知識で、ラボ自身がInkling 2 Smallよりほとんどの評価で劣ると認め、誤った事実をより自信満々に述べる。
サポートチームにとっては、速くて安いエンジンだが、それでもヘルプセンターへの接続と過去チケットでのテストが必要になる。それこそが、どのモデルを選んでもeeselが周りで行う仕事だ。
Inkling 2 Miniとは何か?
Inkling 2 MiniはThinking Machines Labの第2世代のうち、Inkling 2 Smallより小さい方のモデルで、2026年11月20日に発表された。総パラメータ264億を持ち、テキストと画像を入力として受け取り、テキストを出力し、オープンウェイトとして公開されている。Hugging FaceのモデルカードにはApache 2.0と1Mトークンのコンテキストが記載されている。
私はeeselで機能とAIエージェントを作っているので、新しいモデルが出るとベンチマーク表を読む前にまずどう作られているかを読む。Miniはその点で異例で、以下で取り上げる。これはeeselがコマンドラインツールを持つ理由でもある。eesel CLIを使えば、AIコーディングエージェントがエクスポートされたヘルプ記事や保存済みの返信といった承認済みの知識をアップロードし、サポートエージェントの指示を変更し、何かが本番に出る前にテスト質問を行える。どのモデルが裏にあっても同じだ。ヘルプデスク自体の接続は、依然として管理者権限を持つ人の承認が必要になる。
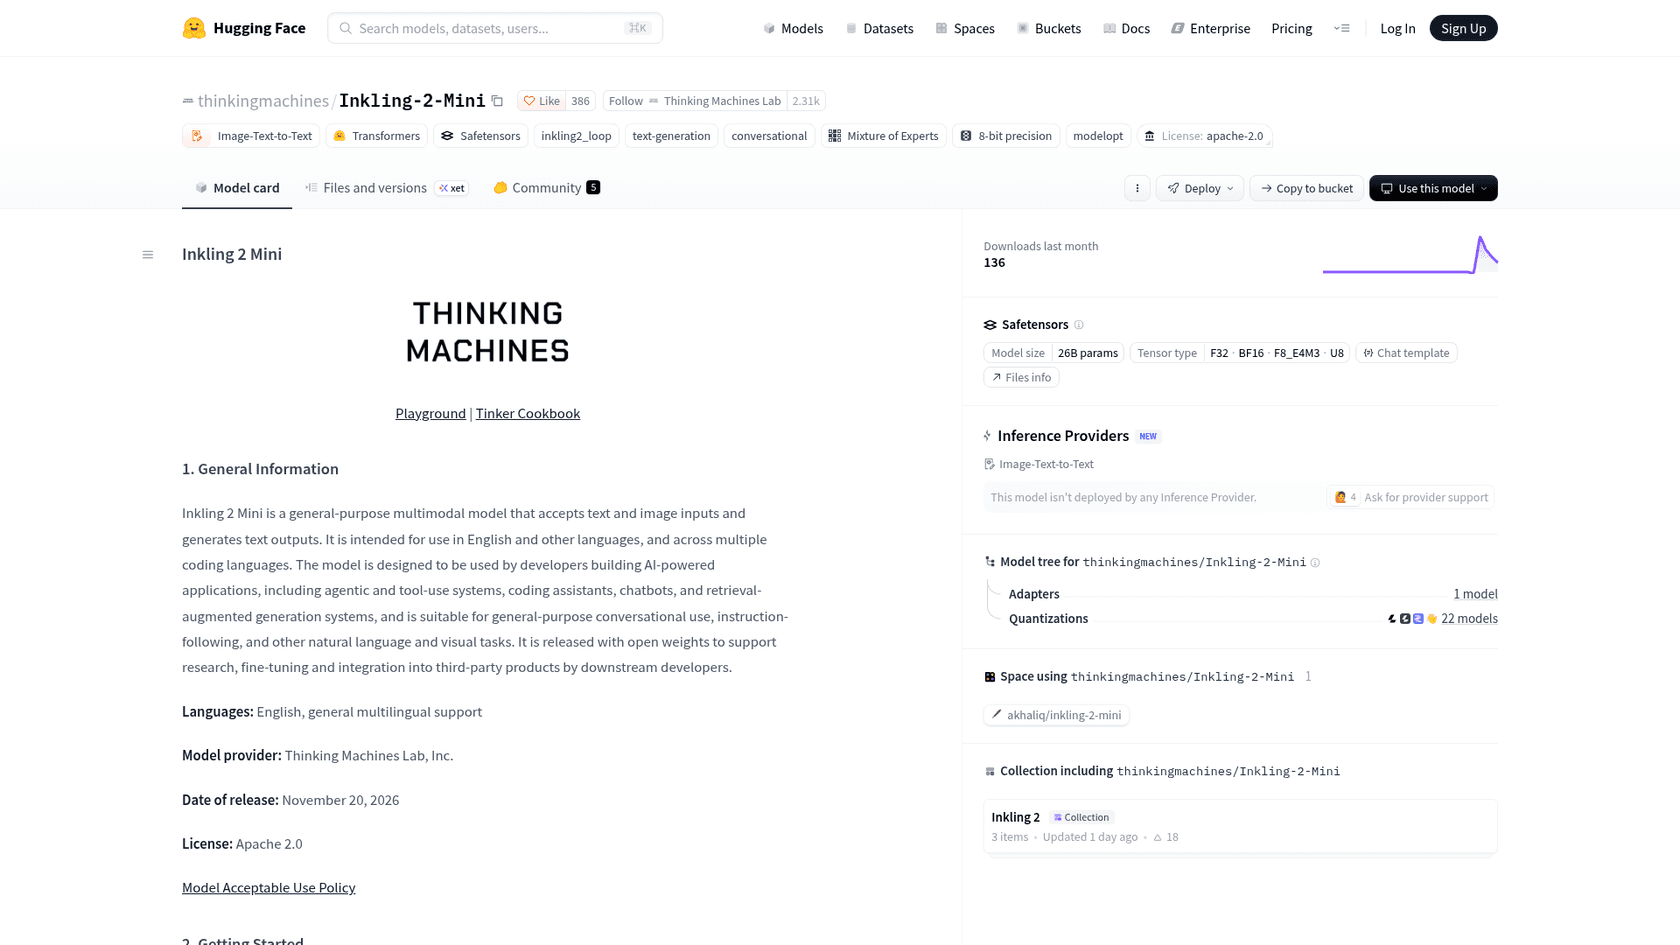
カードで重要な数字はこうだ。トークンあたりアクティブなパラメータ3.4B、チェックポイントは約20GB、そしてループの回数を選べるTML-d24-varloop-researchという研究用バリアント。カードはターゲットハードウェアとしてNVIDIA DGX Spark 1台、またはメモリ32GBのApple Siliconを挙げている。
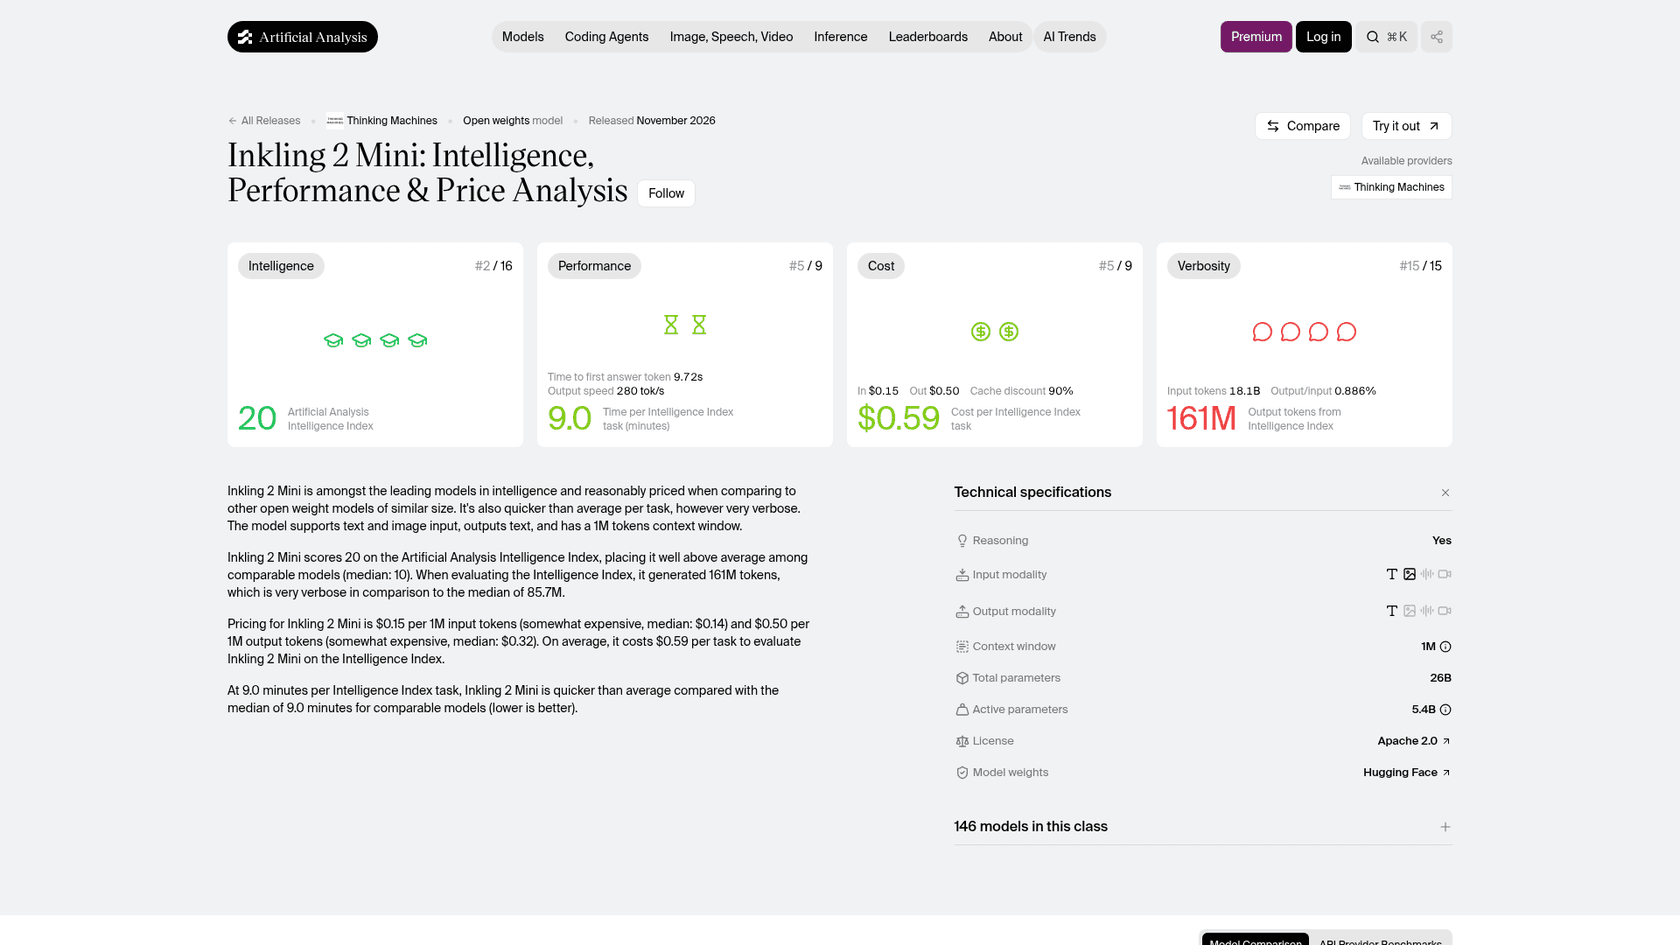
ここで早めに指摘しておきたい点がある。発表文は3.4Bのアクティブパラメータとしているが、スペック表とArtificial Analysisは5.4Bとしている。どちらもそれぞれの意味で正しい。3.4Bは保存されアクティブな分であり、5.4Bは3回走る層を足した数だ。
Inkling 2 MiniはInkling 2 Smallと比べてどうか?
Miniは小さく、タスクあたり安く、速いが、ほとんどのテストで弱い。スペックは各モデルカードから、価格はTinkerの料金ページから、スコアと速度はArtificial AnalysisのSmallとQwen3.8-27Bのページ、それに下に示すMiniのページから取っている。
| Inkling 2 Mini | Inkling 2 Small | Qwen3.8-27B | |
|---|---|---|---|
| リリース | 2026年11月20日 | 2026年11月5日 | 2026年8月 |
| 総パラメータ / アクティブ | 26.4B / 3.4B(ループで5.4B) | 594B / 17B | 27B |
| 入力 | テキスト、画像 | テキスト、画像 | n/a |
| コンテキスト(カード) | 1M | 1M | n/a |
| ライセンス | Apache 2.0 | Apache 2.0 | n/a |
| 入力 / キャッシュ / 出力(1Mあたり) | $0.15 / $0.015 / $0.50 | $0.30 / $0.03 / $1.00 | $0.50 / n/a / $3.00 |
| AA Intelligence Index v5.0.1 | 20 | 31 | 20 |
| 出力速度(AA) | 280トークン/秒 | 118トークン/秒 | 53トークン/秒 |
| 最初の応答トークンまでの時間(AA) | 9.7秒 | 39.7秒 | 144.1秒 |
| AAインデックスタスクあたりの分数 | 9.0 | 21.2 | 34.5 |
| AAインデックスタスクあたりのコスト | $0.59 | $1.18 | $3.53 |
| インデックス実行での出力トークン数 | 161M | 154M | 未比較 |
Qwen列はArtificial Analysis自身の掲載値で、「n/a」はそのセルを検証していないことを意味する。Mini列には2つの留意点がある。まず、MiniはTinkerのserverless inferenceのリストにまだ載っておらず、Artificial AnalysisもMiniの公開APIを示していない。そのためタスクあたりのコストは、計測されたトークンにTinkerのサンプリング料率を適用した値であり、今日買える価格ではない。次に、Miniはインデックス実行で161Mトークンを書き、Smallの154Mより多く、Artificial Analysisが比較可能なモデルで挙げる中央値85.7Mのほぼ2倍に達する。これはこのモデルが非常に冗長であることをはっきり示している。
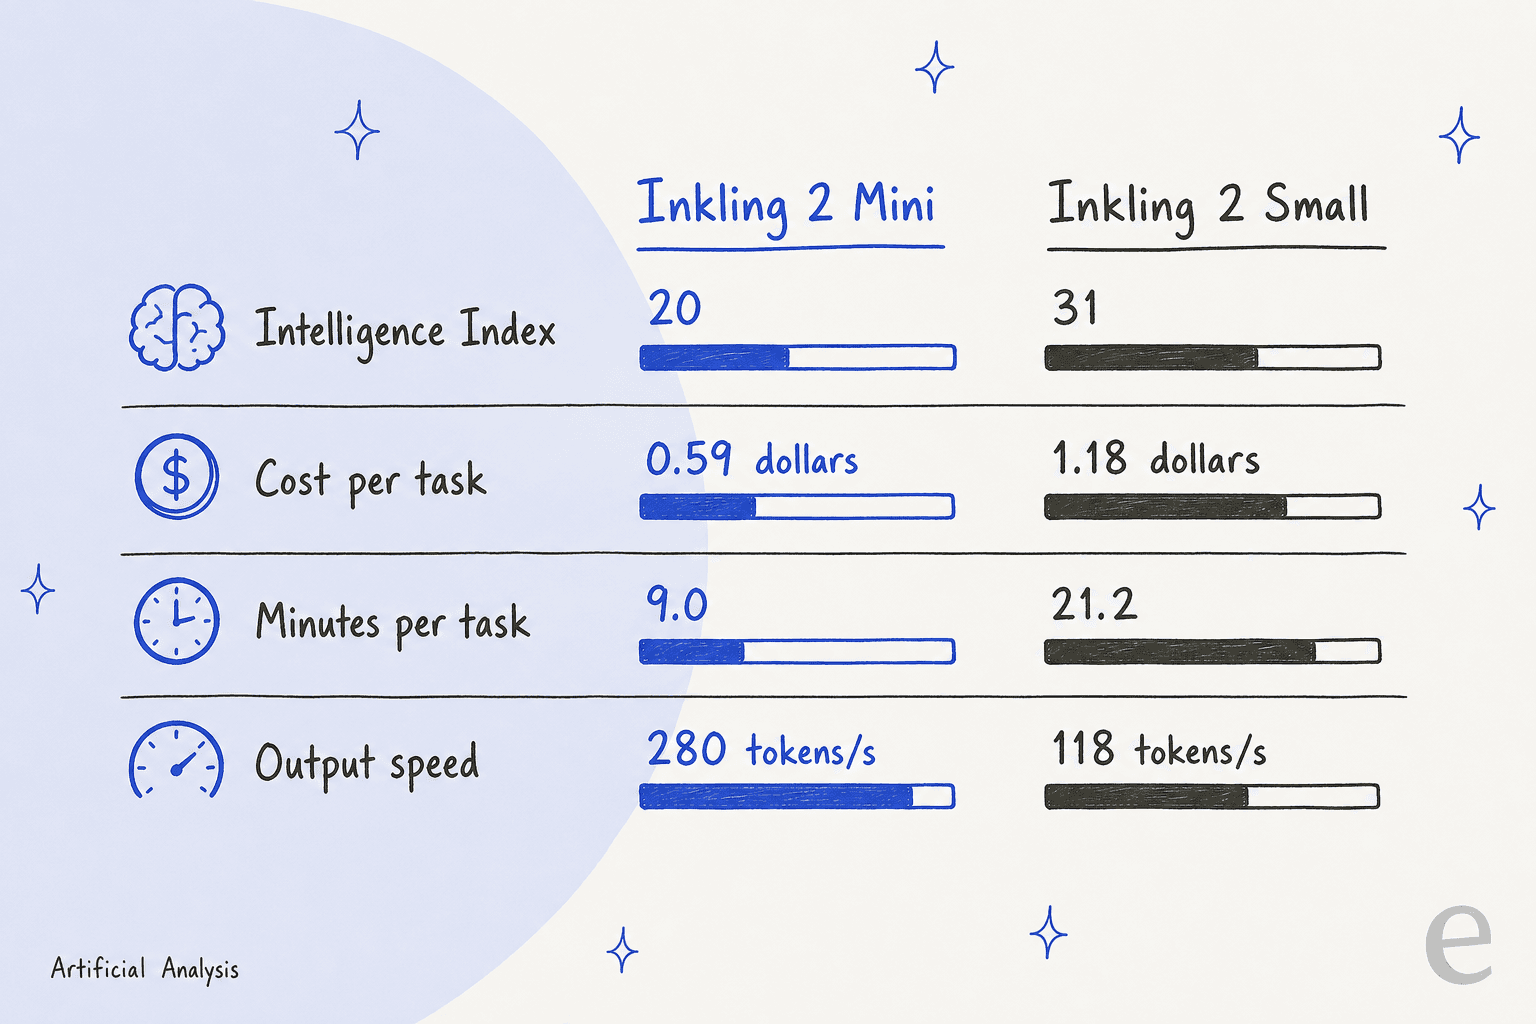
MiniはSmallより11点低く、タスクあたりのコストは半分だ。ラボ自身のカードはもっとはっきりと、このモデルは「ほとんどの評価においてInkling 2 Smallより能力が低い」とし、最大の差は事実の記憶力にあるとしている。例外は長い自律的な作業で、ラボはPMPP-HardテストでMiniがSmallに「近づく」としている。ファミリーの古いモデルはInkling、Inkling-Small、Inkling 2 Smallの各記事で扱っている。
以前書いたSmallについての説明に1つ訂正がある。ローンチ時、Smallの重みは非公開だった。その後Hugging Face上でApache 2.0として公開され、Artificial AnalysisはDeepInfra、Nebius、Togetherをホストとして挙げており、それに伴い速度とコストの数字も変わった。上の数字は最新のものを使っている。
ループモデルはどう動くのか?
ループするトランスフォーマーは、同じ層をトークンごとに1回以上再利用する。Inkling 2 Miniは24層を6層ずつ4つのブロックに分けて保存し、中央の2ブロックが3回走るため、トークンごとに48回の層適用を通過する。モデルカードによると、中央の層をループさせる方が最後の層をループさせるより、28件の評価中27件で優れていた。
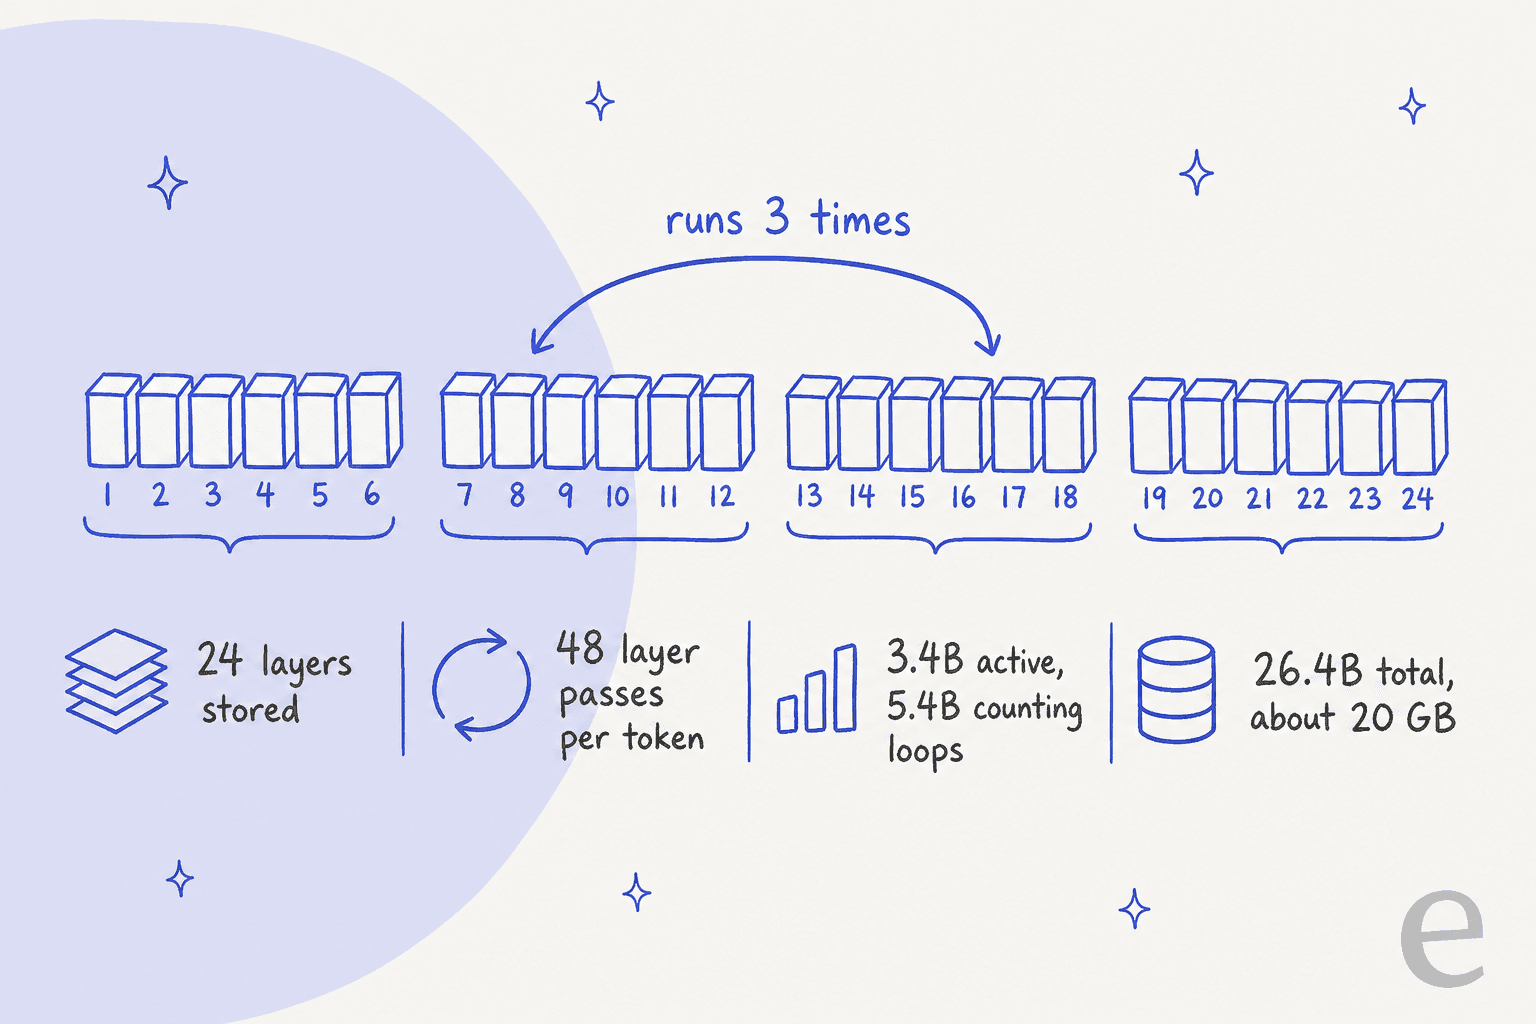
ポイントはメモリだ。スマートフォン、ノートPC、小型サーバーは、どれだけの計算ができるかではなく、どれだけの重みを保持できるかで制限される。層を再利用することで、ファイルを大きくせずにトークンあたりの思考を増やせる。カードからさらに3点。
- トレーニング。 エキスパート層は事前学習から強化学習まで一貫してNVFP4(4ビット)で訓練され、最後の4層は8ビットで訓練されたため、出荷される重みは変換ステップなしで訓練時のものと一致する。
- 縮小。 ラボは訓練の途中でモデルを層あたり384エキスパートから128エキスパートへ刈り込み、その後、より大きな内部のInklingモデルからの1兆トークンの蒸留で修復した。
- 落とし穴。 ループは知識を追加しない。ラボは、知識はほぼ総パラメータ数の関数であり、パスを増やしても事実は改善しないと書いている。
この最後の一文が、この記事の残りで覚えておくべき点だ。
Inkling 2 Miniの料金はいくらか?
Tinker上でInkling 2 Miniは入力トークン1Mあたり0.15ドル、キャッシュ入力トークン1Mあたり0.015ドル、出力トークン1Mあたり0.50ドルでサンプリングされる。ファインチューニング(「train」)は64Kコンテキストで1Mトークンあたり0.75ドル、256Kで1.50ドルだ。Inkling 2 Smallはサンプリング側で正確に2倍の価格になる。価格はベンダーのTinker料金ページからのもので、サードパーティの価格は使っていない。
実際の料金を変える要因は3つある。
- Miniにはserverlessが開放されていない。 料金ページはserverless inferenceをInkling 2 Small、Inkling、Inkling-Smallに限定しており、OpenRouterのページには価格が表示されていない。今日の現実的な選択肢はTinkerのサンプリングか自前のハードウェアだ。
- 冗長な出力が節約分を食い尽くす。 トークンあたりの価格はSmallの半分だが、Miniはタスクあたりほぼ同じ数のトークンを書くため、Smallとのタスクあたりの差は約2倍で、トークンあたりの価格と同じ比率になる。出力トークンが料金を決める単位だ。
- ローカルは別の料金だ。 自分のマシン上ではコストはハードウェアと時間であり、トークンではない。これはラボがMiniを作った想定のケースだ。
サポートの予算面の見方については、カスタマーサービスにおけるAIのコストガイドが、モデルの価格が座席数、解決数、導入コストと並んでどこに位置するかを示している。
Inkling 2 Miniはどこで劣るのか?
知識、複数ターンのチャット、ターミナルセッションだ。ラボは自らの弱点を報告しており、それは評価に値する。カード自体で、MiniのAA-Omniscience非幻覚率は63.4%で、そのテストで答えを知らないとき、3分の1強の確率で正直に言う代わりに推測する。カードはまた、MultiChallenge(50.0%)とComplexConstraints(33.4%)でMiniをQwen3.8-27Bより下に置き、Terminal Bench 4.0では低い5.6%で同率としている。
早期の利用者も同じパターンに気づいた。あるHacker Newsのテスターはツールをオフにしてコーディングのプロンプトを実行した。
"The model burned through 19200 thinking tokens on this task (which was the hard limit I had set) and didn't finish."

同じユーザーは、検索を許可すると解決策には到達したが、それでも間違ったフック名を使ったと述べている。別のコメンターはエージェントのベンチマークについてもっと率直だった。
"Big fan of open weights but those Terminal Bench numbers are pretty abysmal."
ローンチスレッドはHacker Newsで473ポイント、72コメントに達し、称賛の大半はサイズと速度に関するもので、正確性についてではなかった。ラボの見解では、Miniは検索とツールを使うことで「知識のギャップを克服する」としており、それはあのテスターが見たもの、つまり調べられるようになってから良くなったという点と一致する。
Miniが実際に先行しているのは、主に検索とツール呼び出しからなる自律的な作業だ。ラボはSWE-bench Verified(bashのみ)で79.2%を報告し、Qwen3.8-27Bの77.8%に対して優位に立ち、さらにBrowseCompで79.0%、MCP Atlasで82.7%としている。これらはラボ自身のハーネスで実行されたラボの数字なので、確定した事実として扱う前に外部での実行結果を待ちたい。ローカルの重みが不要なら、Gemini 3.8 Flash、DeepSeek V4 Flash、Kimi K3がより大きなホスト型の選択肢だ。
Inkling 2 Miniはノートパソコンで動かせるか?
動かせる。これはほとんどの開発者にとって本当の見出しだ。モデルカードは、DGX Spark 1台、または32GB以上のユニファイドメモリを持つAppleのマシンで十分だとしており、llama.cpp、Ollama、類似アプリ向けの量子化されたGGUFビルドも存在する。ラボはまた、DGX Sparkでのスタンフォードの効率性研究も引用しており、そこでMiniはワットあたりの知能の指標で0.703を記録し、Qwen3.6-35B-A3Bの0.430を上回った。
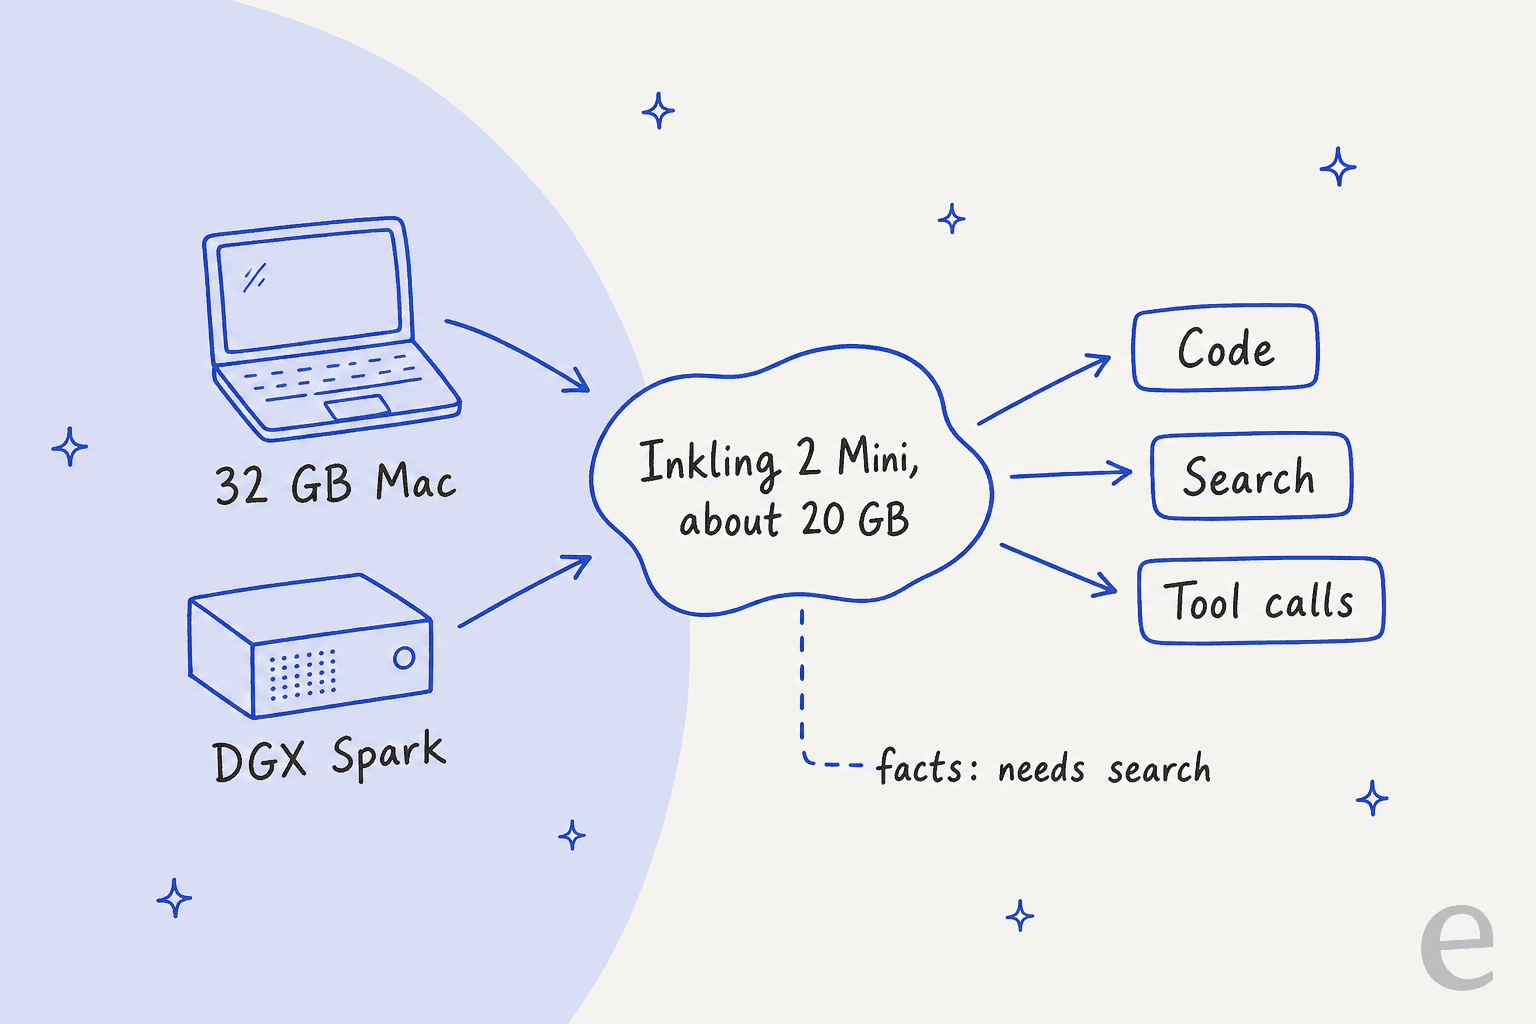
実際の速度はあまり明確ではない。ラボはノートパソコンデモのトークン毎秒の数値を公開していない。より古いマシンを使うHacker Newsのユーザーはこう報告している。
"I'm getting 20 tokens/s running the 4-bit version on my 2021 M1 Max MacBook pro with 64Gb."
別のコメンターは、llama.cppがループサポートを追加するために別のプルリクエストを必要としたため、古いランタイムではモデルが読み込めない可能性があると指摘した。他のランタイムについてはllama.cppの代替を参照してほしい。Artificial Analysisが挙げる280トークン/秒はホスト型の計測値であり、ノートパソコンでの実力ではない。
Inkling 2 Miniはサポート用途に使う価値があるか?
エンジンとして試す価値はあるが、エージェントとしてではない。サポートエージェントとは、モデルに加えてドキュメント、ツール、引き渡しルール、そして顧客に見せる前に確認する手段を組み合わせたものだ。Miniの訴求点(安い、速い、ツールに強い)は、ツールを多用する部分には合うが、その弱点(自信満々な間違った事実)は監督なしに放置できない部分だ。返金の回答での幻覚は、節約したトークンよりもはるかに高くつく。
だからこそeeselはモデルを交換可能なものとして扱う。AIヘルプデスクチームメイトは既存のキューに加わり、ヘルプセンターと過去のチケットから学び、本番に出る前に過去のチケットに対してシミュレーションされる。そのため新しいエンジンは、ラボの表ではなく、あなた自身の質問で判断される。SamCartはこの構成の良い例だ。Freshdeskのチケットに1つのエージェント、ウェブサイトチャットに別のエージェントを走らせており、どちらも約280件のヘルプセンター記事から回答している。チケットではエージェントはチームメイトが引き継ぐまでしか返信せず、人への依頼があればそのターンを終える。そのいずれも、裏にあるモデルには依存しない。
Mini自身を試したいなら、まず範囲を限定した仕事を与えてみてほしい。
- 狭いタスクを選ぶ。 固定された記事セットから返信を作成するなど。
- 出力とターンを制限する。 モデルカードが推奨するとおり、最小の推論設定でも推論が完全にオフにはならないためだ。
- 過去のチケットを再生する。 AIサポートシミュレーションテストやAIサポートエージェントテストのように、人間の回答と比較する。
- できることを制限する。 AIサポートエージェントの権限の考え方を使う。
- ローンチ後も監視する。 AIサポートエージェントのオブザーバビリティで説明されているトレースを使う。
より幅広い候補については、サポートチケット向けモデルの選び方と最高のAIカスタマーサポートエージェントがサポート特化のテストでモデルと製品を比較しており、FreshdeskのAIエージェントガイドはヘルプデスクネイティブな選択肢がどのようなものかを示している。
サポートの仕組みを作り直さずに交換できるモデルが欲しいか? eeselを試す。数分でヘルプデスクに組み込まれ、すでにヘルプセンターを把握しており、顧客と話す前に過去のチケットでテストされる、新しく入ったスタッフのように機能する。
ほかに読むべき記事は?
Inklingファミリーを追っているなら、次が最も近い関連記事だ。
- この記事に最も近い比較であるInkling 2 Smallレビュー。
- 第1世代についてはInkling-SmallレビューとInklingレビュー。
- 小型のオープンモデルの中で選ぶならInkling-Smallの代替。
- 大規模言語モデル、ファインチューニング、AIエージェント、RAGに関するグロッサリー記事。