

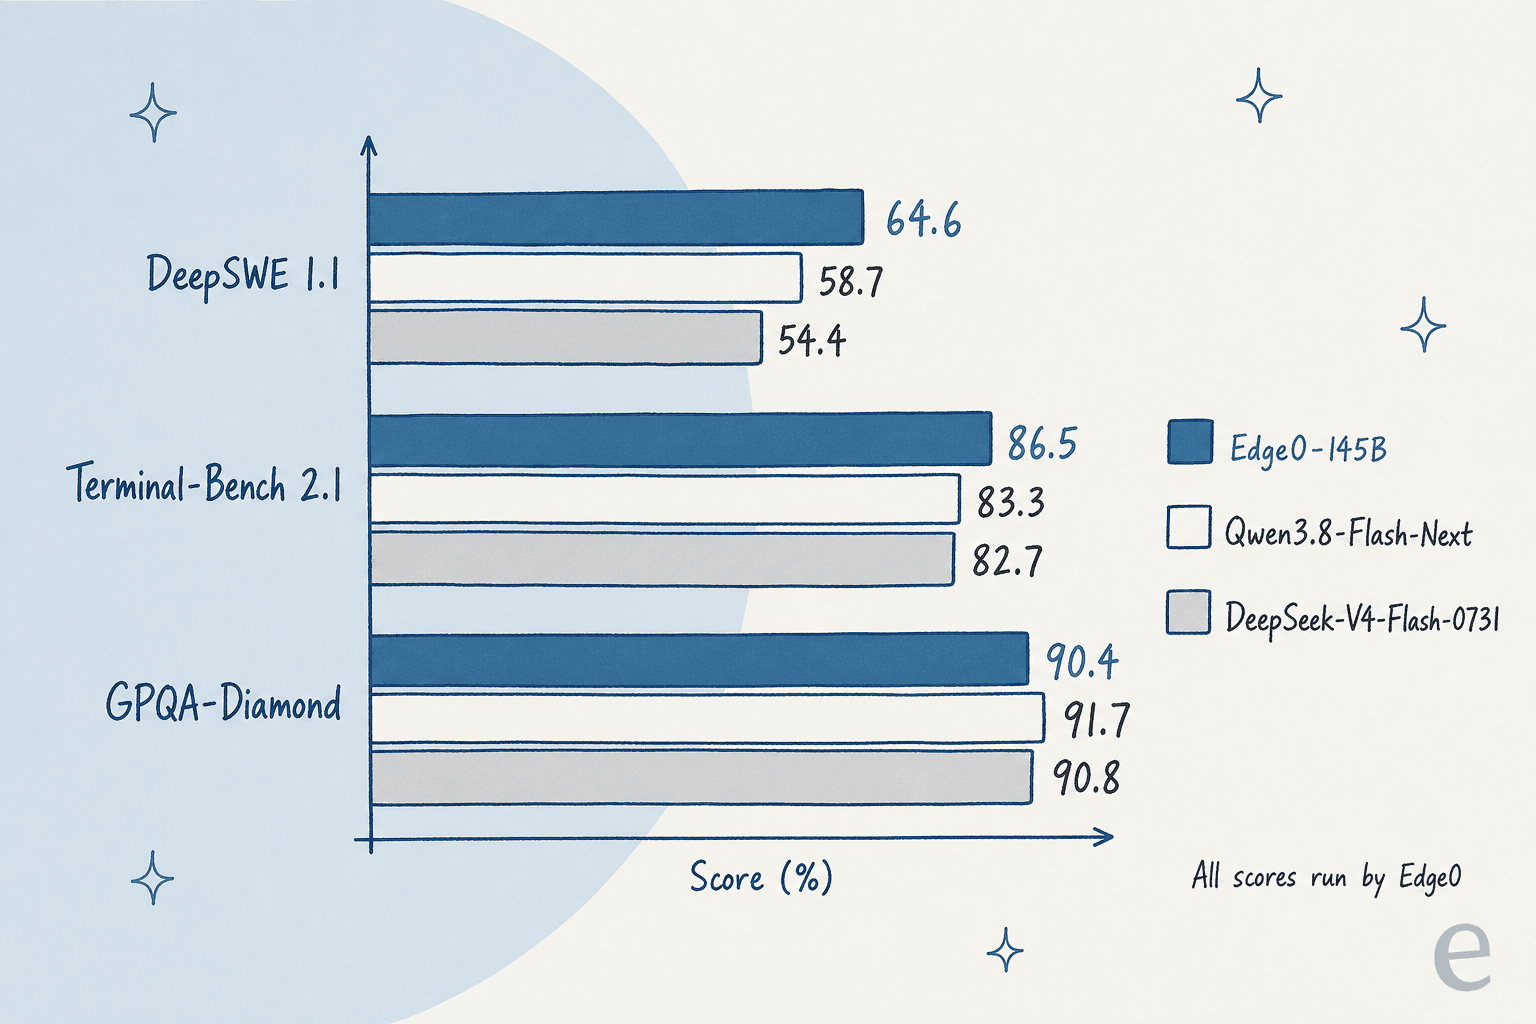
Edge0-145Bは、1枚のコンシューマー向けグラフィックカードで動くように作られた1,450億パラメータのモデルで、その裏にあるエンジニアリングは本物だ。Edge0自身のテストではTerminal-Bench 2.1で86.5、DeepSWE 1.1で64.6を記録し、ベースモデルであるQwen3.8-Flash-Nextを上回る。
ただしローンチの主張には注釈が必要だ。「29GB」という数字はシステムRAMの約31GiBを含んでいないし、macOS対応はリリースに含まれておらず、重みには商用サービスを制限するライセンスが付いている。私の評価は5点中3点: NVIDIA搭載マシンで試す価値はあるが、まだそれを中心に組み直すほどの価値はない。
プライバシーを重視するサポートチームにとっては、モデルがどこで動くかより、ボットが何を読めるかの方が重要だ。eeselは承認済みのナレッジだけから答え、eesel CLIを使えば、どのコーディングエージェントでもそのナレッジをアップロードし、公開前にテストの質問をすることができる。
Edge0-145Bをどのようにレビューしたか
Edge0は11月13日にリリースを発表したので、このレビューはその2日後のものだ。私はeeselでインテグレーションとAPIを作っているので、こうしたリリースはどのベンダーのドキュメントを読むときとも同じように読む。ローンチ記事は信じさせたいことを伝え、READMEは実際に何が出荷されたかを伝える。信頼の順に、3つの情報源から取り組んだ。
- Edge0自身のリリースファイル。 GitHubのREADME、Hugging Faceのモデルカード、そしてリポジトリ内のライセンス出自ファイル。ここに測定された数値がある。
- Edge0のローンチ記事。 意図やデモを知るには有用だが、READMEと矛盾する場合はREADMEを優先する。
- 初期ユーザー。 Hacker Newsのローンチスレッドは330ポイント、100件のコメントを超え、自分のハードウェアで試した人もいた。
私自身のベンチマークスイートは実行しておらず、Artificial Analysisのような独立した研究機関も11月14日の時点ではEdge0-145Bのページを持っていなかった。以下のスコアはすべてEdge0のものとして扱ってほしい。先に幅広いモデルの状況を知りたければ、同僚によるDeepSeek V4 FlashとQwen 4 Maxの記事が、Edge0が自らを比較する2つのファミリーを扱っている。
Edge0-145Bとは何か?
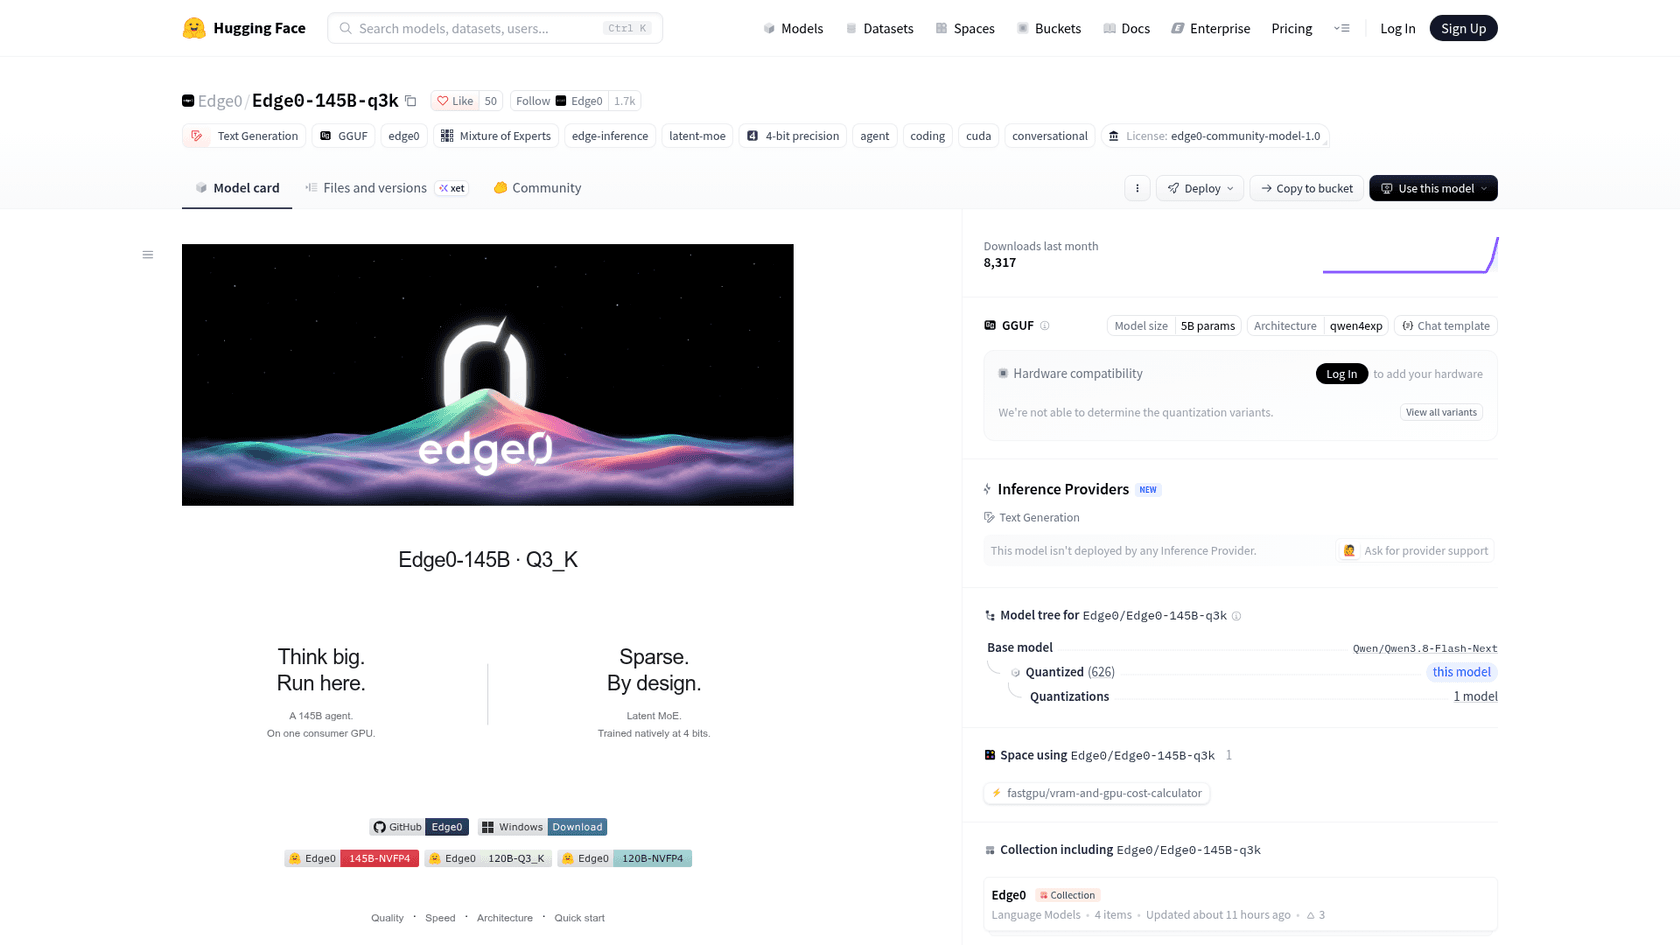
Edge0-145Bは、9月に電話向けモデルEdge0-35Bと音声モデルAudio8を出したチームであるEdge0による潜在的なmixture-of-expertsモデルだ。総パラメータは145Bだが、トークンごとにアクティブになるのは約10.12Bのみで、これが密な145Bモデルを決して収められないハードウェアに収まる理由だ。
モデルカードが語る内容は次のとおりだ。
| 仕様 | Edge0-145B | Edge0-120B |
|---|---|---|
| 総パラメータ数 / アクティブ数 | 145B / 10.12B | 120B / 非公開 |
| レイヤーとエキスパート | 48レイヤー、512エキスパート、トークンごとに10ルーティング+1共有 | 同じ |
| エキスパートの潜在幅 | 1,792 | 1,280 |
| コンテキストウィンドウ | 256K(KV int8、常駐32K) | 256K |
| Hugging Faceでのビルド | Q3_K(40.81GiB)、NVFP4(47.79GiB) | Q3_K(27.98GiB)、NVFP4(32.96GiB) |
| ベースモデル | Qwen3.8-Flash-Next | Qwen3.8-Flash-Next |
| エンジン | edge0-strata(Strataのフォーク) | edge0-strata |
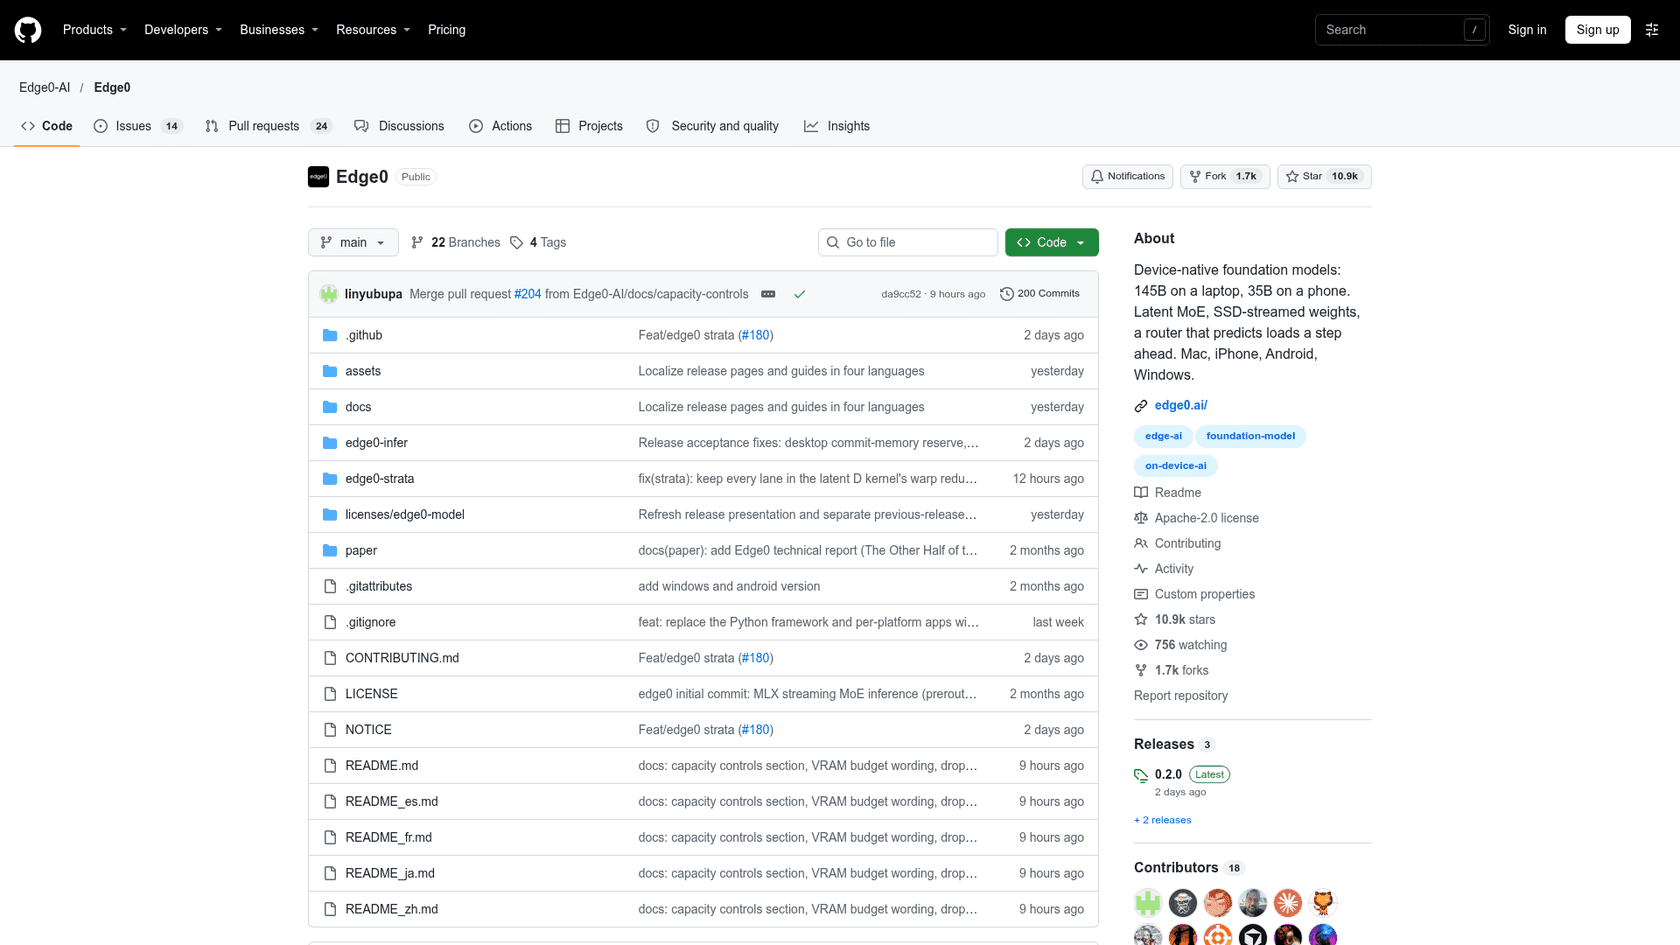
この表の2行がストーリーの大部分を物語っている。ベースモデルはQwenであり、エンジンはオープンソースのStrataプロジェクトのフォークだ。Edge0はREADMEでそれを明確に述べているが、ローンチ記事はQwenについて一切触れていない。初期のコメンテーターの多くが注目したのはこのギャップだった。
"Based on Qwen3.8-Flash-Next and Strata. They made some interesting tweaks and did some fine tuning on the model, but it's interesting how much marketing speak was layered on their website to hide this fact."

派生モデルであること自体は欠陥ではない。今日の優れたオープンモデルの大半は他者のベースから出発しており、本当の問題はEdge0の変更が何かをもたらしているかどうかだ。その点では、答えはイエスのようだ。
Edge0-145Bが優れている点
3つの点が目立ったが、いずれも生の知能ではなくエンジニアリングに関するものだ。
エキスパート設計が巧妙
Edge0は64エキスパートごとのグループで2つの大きな行列を共有し、各エキスパートは自身のパラメータのうち小さな一部だけを保持する。モデルカードはその結果を詳しく示している。各エキスパートは1,630,720バイトの固定レコードであり、そのためエンジンは最も使われる数千のエキスパートをグラフィックカード上に保持し、残りをシステムメモリからストリーミングできる。そのストリーミングのコストは、モデルの大きさではなく、常駐しているエキスパートの数に応じて変わる。
Edge0はまた、このモデルを最初からこの形でネイティブに4ビットで学習させており、クラウドモデルを後から縮小したわけではない。1.26Bのドラフトヘッドを使った投機的デコードは、重みの読み込み1回のコストを複数の出力トークンに分散させる。これらは魔法ではなく、丁寧な作業だ。だからこそ145Bモデルがそもそも24GBのカードで動くのだ。
コーディングとエージェントのスコアがベースモデルを上回る
Edge0のベンチマーク表は、ローカルエージェントにとって重要な部分で最大の伸びを示している。
| モデル | DeepSWE 1.1 | Terminal-Bench 2.1 | HLE | GPQA-Diamond | IFBench | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 35.4 | 90.4 | 80.6 | 79.3 |
| Edge0-120B | 51.3 | 75.3 | 31.0 | 87.4 | 79.3 | 81.0 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 35.9 | 91.7 | 81.3 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 33.8 | 90.8 | 79.2 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 30.8 | 89.2 | 79.5 | 82.0 |
| Claude Opus 4.6 (Max) | n/a | 78.2 | 40.0 | 91.3 | 62.5 | 78.0 |
このパターンは一つの意味で誠実だ。Edge0-145Bは2つのエージェントベンチマークでベースモデルを上回り、知識と推論(GPQA、HLE、IFBench)ではわずかに劣る。これはコーディングエージェント向けのファインチューニングから予想される結果だ。特にTerminal-Benchはモデルがシェルをどれだけうまく操れるかを反映する傾向があり、ある初期ユーザーはそれを次のように位置づけた。
"This score is roughly on par with 5.6 Terra max, which in my direct experience is perfectly capable of driving a cloud agent harness that can do pretty complex knowledge work."
現行のホスト型モデルと比較したい場合は、同僚によるGPT-6.1 TerraレビューとClaude Opus 5.5レビューに、Edge0の表に欠けている独立した数値がある。
適切なハードウェア上では速い
Edge0自身の24GBのRTX 5090 Dマシンでは、Q3_Kビルドがエージェントのデコードで121.2トークン/秒、16Kトークンのプレフィルで3,554.9トークン/秒を記録した。これはローカルのコーディングループが対話的に感じられるほどの速さだ。ローンチデモ(Blenderの都市シーン、ドローンのプログラム、KiCadの基板)は、その速度が何のためにあるかを示している。トークンごとの料金なしで、計画・実行・確認を何十回も回せるということだ。EdgeのGitHubページには完全な速度表と2分間のショーケース動画がある。
Edge0-145Bが見劣りする点
ここではローンチ記事とリリースファイルが異なる話をしている。以下の各項目はすべてEdge0自身の文書に基づく。
「29GBのピークメモリ」はすべてのフットプリントではない
ローンチ記事は29GBのピークメモリを前面に掲げ、モデルが48GBのラップトップで動くとしている。同じ記事は後段で、システムRAMに約40GBのエキスパートライブラリ、SSDに約48GBの語彙データがあると述べている。READMEの測定値がそれを明らかにする。
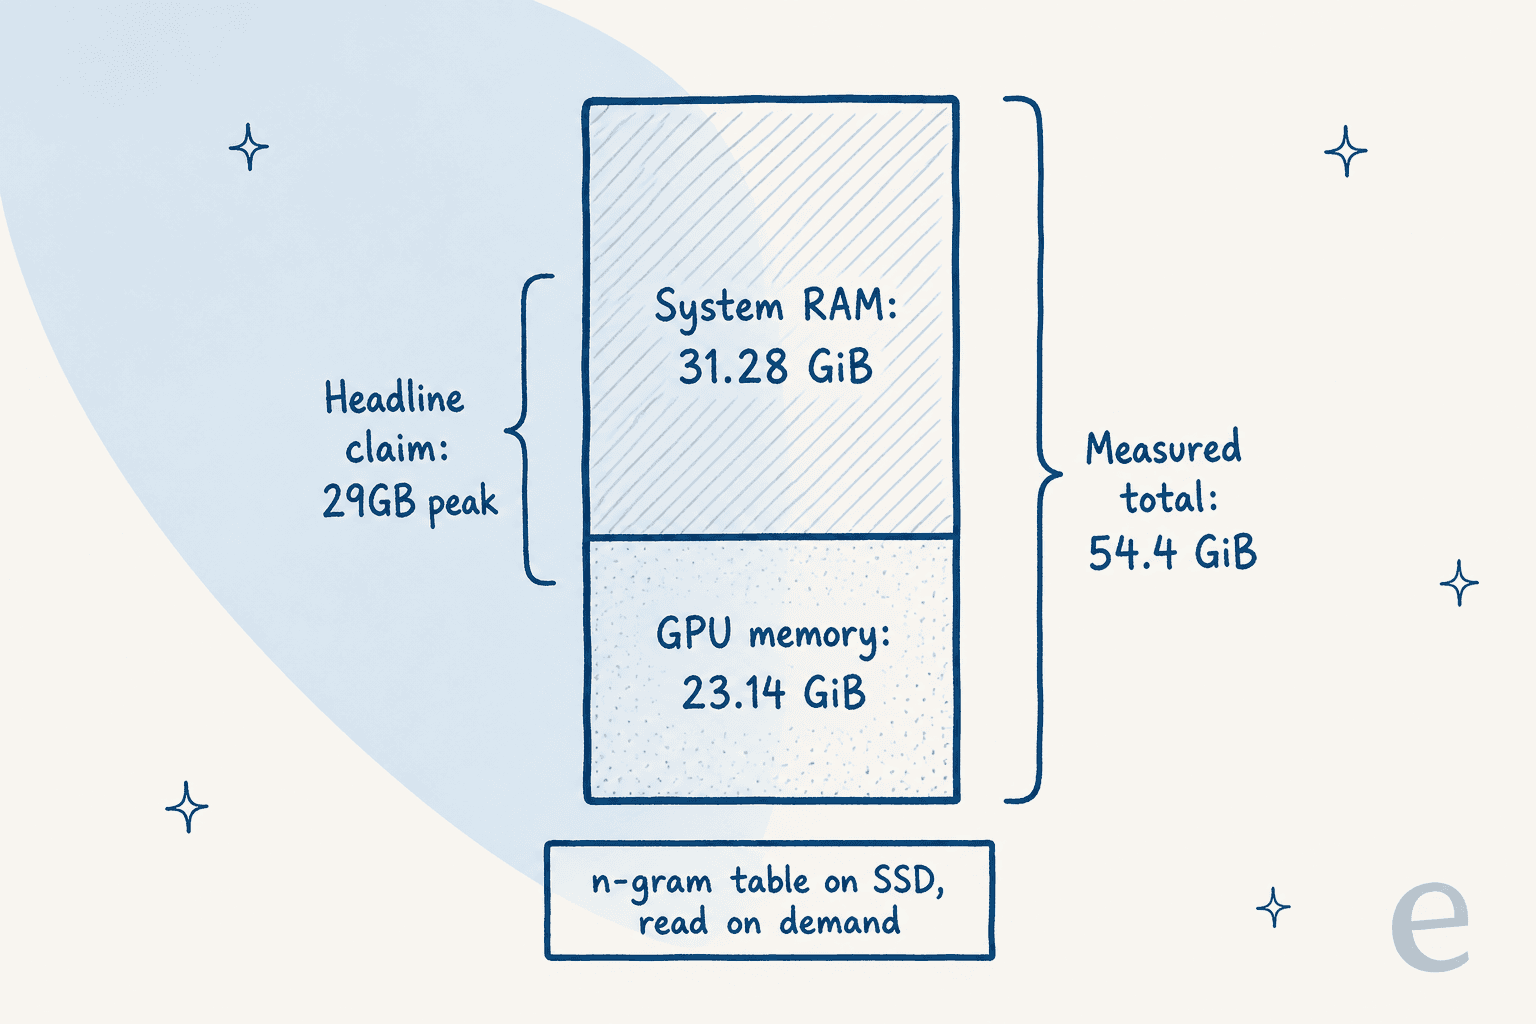
エキスパートの常駐を有効にした状態で、Q3_KビルドはGPUメモリ23.14GiBに加えてシステムRAM31.28GiBを使用した。NVFP4ビルドは23.25GiBに加えて38.27GiBを使用した。29GBという数字はそのうちの一部、おそらくGPU側に若干の余裕を加えたものを全体として示しているように見える。
Edge0を公平に見るなら、より厳しい予算、VRAM16GiBとRAM20GiBでもモデルを動かしており、キャッシュされていないエキスパートをSSDから読み込んでいた。それでも動作し、チャットで36.8トークン/秒、エージェントモードで44.9トークン/秒だった。つまり、より小さなマシンでも動かせるが、ずっと遅くなる。48GBのMacBookで動かせることを期待していたHacker Newsの読者は、その失望を次のように要約した。
"If we're talking about ~70GB combined RAM footprint then that's not going to cut it. Still very interesting though."
macOSはローンチ記事にはあるが、リリースにはない
ローンチ記事は、初日対応がmacOS、Windows、Linuxをカバーし、Apple Mシリーズのチップも含むとしている。READMEのプラットフォーム表はもっと狭いことを述べている。145Bと120BモデルはNVIDIA GPUとCUDA 13を備えたLinuxまたはWindowsで動き、macOS、iOS、Androidの列はこれらのモデルについて空欄だ。Edge0はApple M2 Ultraでの結果(エージェントのデコードで57.0トークン/秒)を公開しつつ、それは「macOSのリリース対応を確立するものではない」と付け加えている。Edge0 Chatのデスクトップアプリは今のところWindows専用だ。
実際にはこういうことになる。
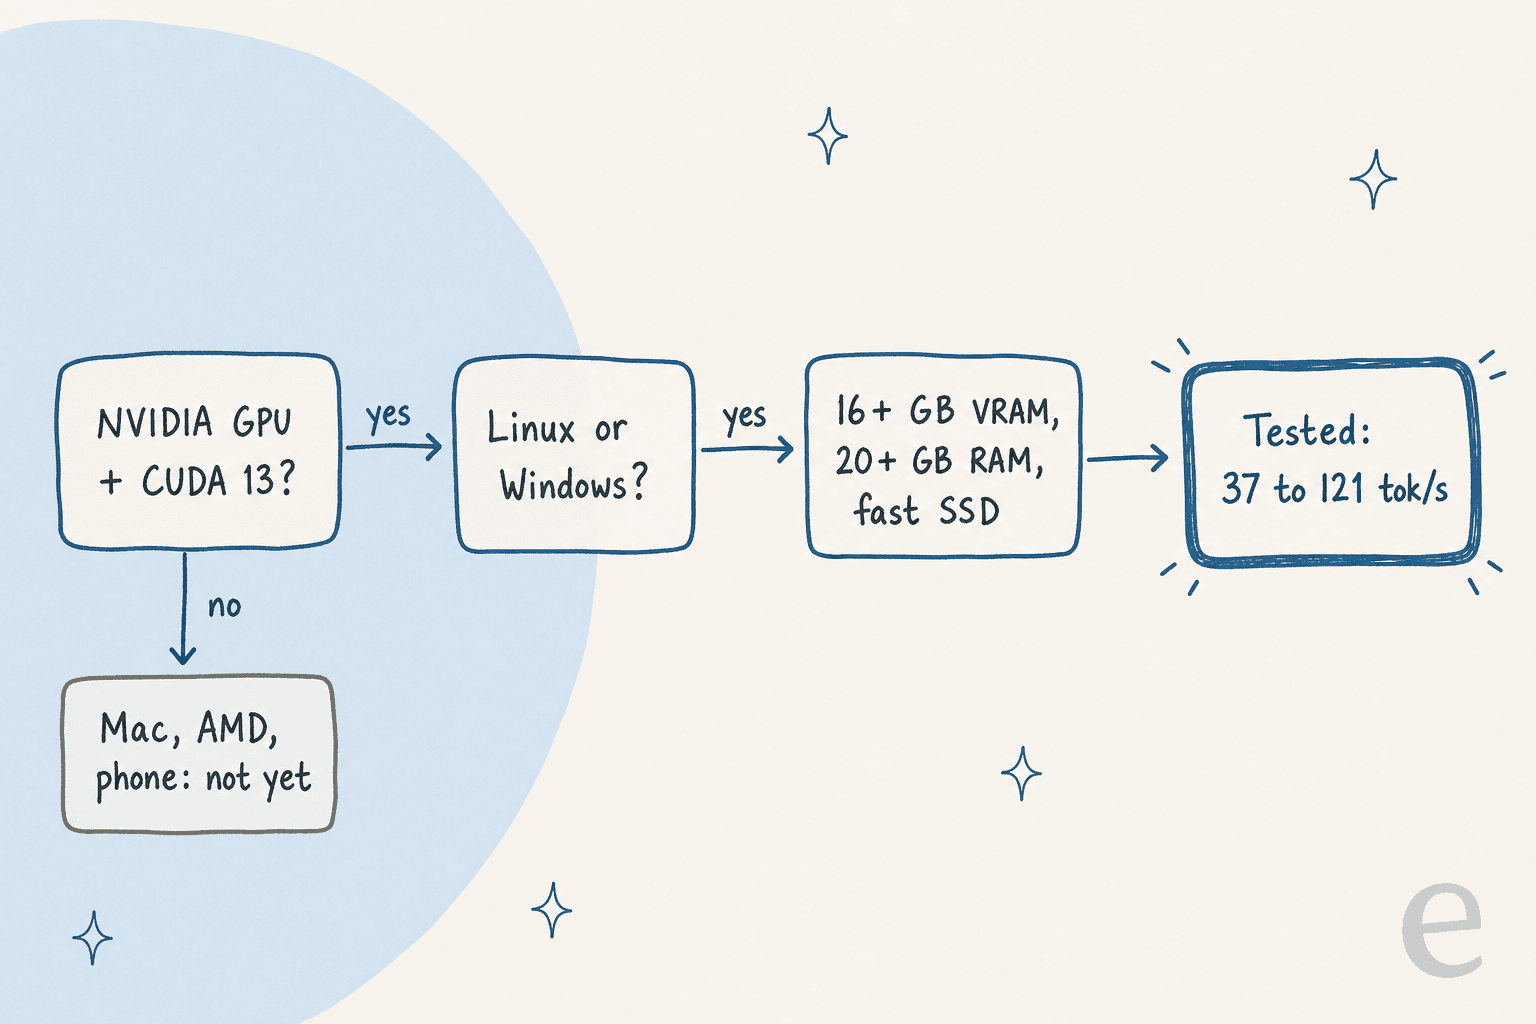
Macユーザーは今でも旧モデルのEdge0-35BをMetal上で動かせる。145Bについては、今日のところNVIDIAマシンが必要だ。
ベンチマークは自己報告で、完全には一致しない
表にあるEdge0、Qwen、DeepSeek、Claudeのすべてのスコアは、Edge0自身の内部評価から来ている。Edge0は、完全なセットアップと再現手順は「技術レポートとともに公開予定」としており、これまでに公開された唯一の技術レポートは35Bモデルを対象にしたものだ。数値は文書間でも変動している。ローンチ記事はEdge0-120BについてDeepSWEで53.6、Terminal-Benchで81.3としているが、READMEは51.3と75.3を示している。
初期の実際の使用レポートは賛否が分かれている。NVIDIA DGX Sparkで試したあるテスターは、使える答えを得られなかった。
"It spent 8,000+ tokens at default thinking and never produced a coherent answer."
1件のテストが結論になるわけではないが、表を信頼する前に独立したスコアカードを待つ理由にはなる。同僚によるDeepSeek V4.1 Flashレビューは、研究機関が実際に数値を計測したときにどうなるかを示している。
「オープンソース」には商用面での落とし穴がある
ローンチ記事はEdge0がモデルを「オープンソース化」していると述べている。フレームワークのコードはApache 2.0で、StrataもMITのままだ。重みは異なる。モデルカードはそれらをEdge0 Community Model License 1.0の下に置き、Qwenの素材は依然Qwen Community Licenseの下にある。個人利用、研究、改変、内部利用、出力の商用利用は許可されている。モデルの販売やバンドル、商用のモデルサービスの運営、あるいは商用のコーディングやオフィス向けアシスタントの提供には、別途の書面ライセンスが必要だ。
趣味での利用や社内ツールのチームにはそれで問題ない。それを基に製品を作る予定のある人は、READMEより先にライセンスを読むべきだ。弊社ブログのHugging Faceレビューは、こうしたカスタムライセンスがハブ全体でどのように現れるかを扱っている。
Edge0-145Bと代替案の比較
今週、開発者が実際に検討するであろうものと並べると、こう位置づけられる。
| こういう場合... | 選ぶべきもの | 理由 |
|---|---|---|
| 1枚のNVIDIAカードで最強のローカルコーディングエージェントが欲しい | Edge0-145B | 同クラスで最高の自己報告Terminal-BenchとDeepSWEスコア、24GBカードで91.7から121.2 tok/s |
| 同じファミリーでサプライズが少ないものがいい | Qwen3.8-Flash-Next | ベースモデル、より広いランタイム対応、推論で近いスコア |
| 今すぐMacでローカルモデルを動かしたい | Edge0-35Bか他のMetal対応オープンモデル | Edge0-145BにはまだmacOSランタイムがない |
| 独立したベンチマークがあり、ハードウェアが不要 | DeepSeek V4 FlashかKimi K3.1 Pro | ホスト型、第三者による測定、トークンあたりの低価格 |
| フロンティア級の品質にお金を払う気がある | Claude Opus 5.5かGPT-6 Sol | 最難の推論ではまだ先を行く |
コストが理由でローカルに惹かれているなら、まず計算してみてほしい。Anthropic APIの料金とOpenAI APIの料金のガイドは、トークンあたりの請求額を、動作中に約120Wを消費するGPUと比較するのに役立つ。
Edge0-145Bへの私の評価
| 項目 | 評価 | メモ |
|---|---|---|
| エンジニアリング | 4.5/5 | 共有行列のエキスパートとSSDストリーミングは、ローカル推論における本物の進歩 |
| コーディングとエージェントのスコア | 4/5 | 強いが、自己報告のみ |
| ローンチ時の主張の正直さ | 2/5 | 29GB、macOS、「オープンソース」はいずれも注釈が必要 |
| セットアップの容易さ | 2.5/5 | ソースからビルド、NVIDIAとCUDA 13限定、アプリはWindowsのみ |
| ライセンス | 2.5/5 | 内部利用には問題ないが、製品には制約が多い |
総合: 5点中3点。 RTX 4090か5090を持っていてローカルのコーディングエージェントが欲しいなら、半日試す価値がある。Macを使っている、製品を計画している、あるいは独立した証拠が必要なら、技術レポートと第三者のスコアカードを待ってほしい。すでにClaude Codeを使っている開発者は、Anthropic互換のローカルエンドポイント経由で試すことができるが、私自身はその組み合わせをテストしていない。
このレビューがサポートチームにとって意味すること
サポートのリーダーに響く売り文句はプライバシーだ。自社のハードウェアでモデルを動かせば、チケットのデータは建物の外に出ない。その魅力は理解できる。商談の場では、データに関する質問が最初に来ることが多い。ある半導体ハードウェア企業の技術評価者は、ボットが答えを知らないときに「何らかの別のChatGPT」に頼ることになるのか、それを無効にできるのかを私たちに尋ねた。あるデンマークのテレマティクス企業のバイヤーは、チケットの中にあるカード番号やパスワードを心配していた。
どちらの懸念も、実際にはモデルがどこで動くかについてのものではなかった。どちらも、AIが何を読み、何を言ってよいかについてのものだった。自身の汎用的な学習から答えるローカルモデルは、その評価者が心配していた「別のChatGPT」のままだ。彼らにとって解決策となったのは、承認済みのナレッジだけから答え、わからないときはそう言うエージェントに加えて、機密フィールドの秘匿化だった。
これがeeselの動き方であり、私がEdge0をインフラとして位置づけ、eeselを社員として位置づける理由だ。あなたはAIヘルプデスクチームメイトを雇い、それが既存のヘルプデスクに加わり、ヘルプセンター、マクロ、過去の返信から学び、顧客と話す前に過去のチケットに対してシミュレーションされる。Edge0のライセンスも、サポートベンダーがモデルで行うことの大半をブロックするだろう。商用のモデルサービスには別の契約が必要だからだ。
2社の顧客が、丁寧なセットアップがどのようなものかを示している。デンマークの法務文書サービスであるDokument 24は、約2,600のWebページとZendeskの項目から、eeselにデンマーク語の返信を内部メモとして起草させており、ナレッジが質問をカバーしていないときはそのメモがそう示す。規制された金融分野のドイツのローン比較企業であるsmavaは、月間約27,000件のZendeskチケットをeeselに通し、14,600件を分類し、アドバイザーの承認を待つ15,300件の返信ドラフトを用意した。
ボットを根拠に基づいて動かすことについては、サポートにおけるAIハルシネーションのガイド、カスタマーサポート向けMCPの解説、そしてセルフホストが必須要件の場合に向けたオープンソースのチャットボットプラットフォームのまとめも参照してほしい。
eeselを試す
サポートチームがブラックボックスにチケットを渡さずにAIを使いたいという理由でEdge0-145Bレビューを読んでいるなら、プライバシーと精度を実際に決める部分、つまりエージェントが何を読み、いつハンドオフするかから始めてほしい。eeselはZendesk、Freshdesk、その他の主要なヘルプデスクと連携し、承認済みのナレッジだけから答え、公開前に実際の過去のチケットにどう答えるかを確認できる。料金はシート単位ではなく、固定の月額クレジットプランだ。
開発者はeesel CLIから同じワークスペースを操作できる。ローカルモデルに向けたものを含むコーディングエージェントは、エクスポートしたヘルプ記事や保存済みの返信といった承認済みのナレッジをアップロードし、チームメイトの指示を調整し、テストの質問をして回答を確認できる。ヘルプデスク自体の接続は、依然として管理者アクセス権を持つ人が承認する必要がある。
eeselを試すのは無料、または自分のチケットでの動作を見るためにデモを予約できる。