

Ripple-65B Previewは、エージェント型コーディングで8〜15倍の大きさのオープンウェイトモデルに並ぶ、Apache 2.0の65B Dense型モデルで、ホスティング料金は100万トークンあたり$0.20 / $0.60です。ただし、リードはわずかです。Ricursive自身の表でも1位は22項目中2項目で、Terminal-Bench 2.1はReflection Beamに0.4ポイント差で勝っているだけです。注目すべき本当の理由は、DGX Spark 1台に収まることです。自前でホストできるコーディングモデルが欲しいなら試す価値があり、裏付けが必要なら第三者の検証を待ってください。サポートチームにとってモデルは簡単な部分で、その上に構築された頼れるチームメイトがeeselです。
Ripple-65Bとは?
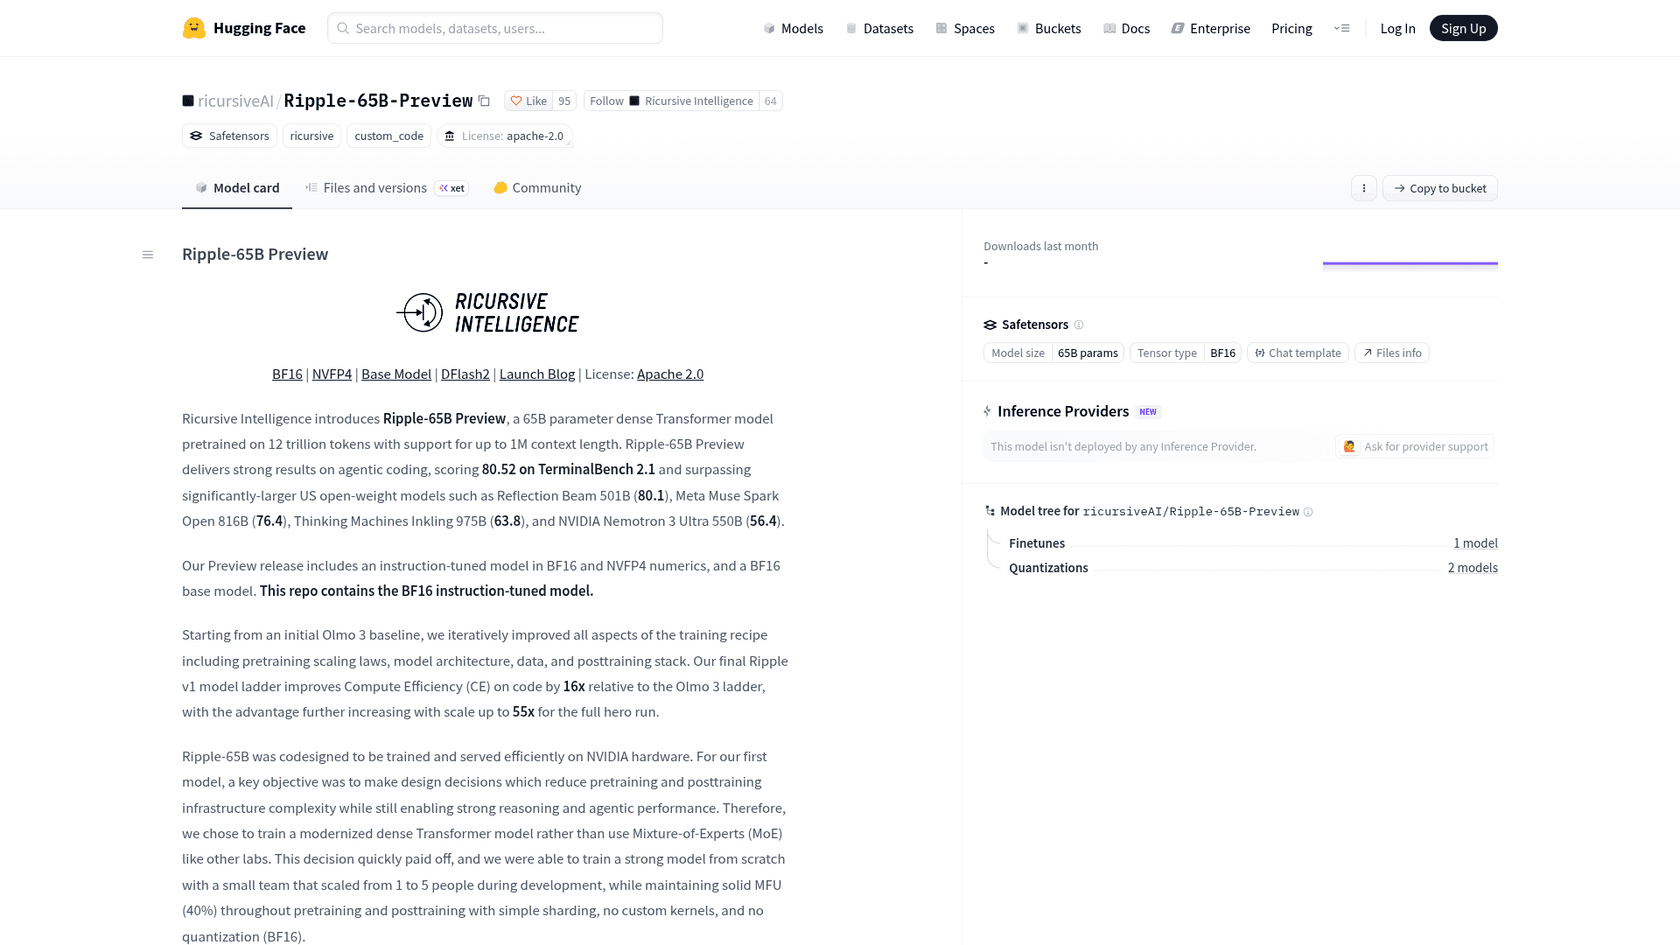
Ripple-65B Previewは、Ricursive Intelligenceの初の公開モデルです。同社はAnna GoldieとAzalia Mirhoseiniが共同創業したパロアルトのラボで、チップ設計向けのAIを開発しています。公開は2026年11月4日でした。Ricursiveはこれを"a general-purpose variant of the proprietary model that powers our AI chip design platform."と説明しています。
スペックの要点は次のとおりです。
- サイズ: 64.8Bパラメータで、トークンごとにすべてが有効です。つまりMixture of Expertsではなく、Dense型のTransformerモデルです。
- 学習: 主に英語のテキストとコード12兆トークンでゼロから事前学習。画像や音声は含みません。
- コンテキスト: 最大1Mトークンに対応し、設定では2M位置まで許可されています。
- ライセンス: すべてのチェックポイントがApache 2.0なので、商用利用が可能です。
- 重点: RicursiveはPreviewについて"relatively light posttraining, with a focus on agentic coding."と述べています。
Hugging Faceの4つのリポジトリとして公開されています。指示チューニング済みBF16モデル(約130 GB)、"Experimental"とラベルされたNVFP4版(約57 GB)、ポストトレーニングなしのベースモデル、そして投機的デコーディングで生成を高速化する4Bの"DFlash2"ドラフトモデルです。
私はeeselで連携機能とAPI機能を開発しているため、このようなモデルが出たときに最初に読むのは発表時のグラフではありません。設定ファイル、チャットテンプレート、サービング用スクリプトです。月曜日に実際に何が使えるかは、そこでわかるからです。以下はすべて、それらのファイル、モデルカード、プロバイダーのページに基づいており、2026年11月5日に確認しました。
Ripple-65Bの新しい点は?
今年の他の米国製オープンウェイトモデルとの違いは3つあります。
他社がMoEに進むなか、Denseを選んだ。 Reflection Beam、Meta Muse Spark Open、Inkling、Nemotron 3 UltraはいずれもMixture of Experts設計で、トークンごとにモデルの一部しか動きません。Rippleは毎回65B全体を動かします。モデルカードでのRicursiveの主張は、Denseモデルは"reduce[s] pretraining and posttraining infrastructure complexity"であり、1人から5人に増えたチームが"simple sharding, no custom kernels, and no quantization."で学習できた、というものです。形状も珍しく、隠れ層の幅は5,120と狭く、80層の深さに積み上げ、フルアテンション1層ごとに短いウィンドウのアテンション4層を置いています。
作るコストが安いと主張している。 Ricursiveはプロジェクト全体で$32Mを使ったとしており、ブログでは1回の学習だけでなく、"our full R&D cost starting from scratch, including pretraining ladder development, data mixing, evals, debugging"と最終実行までを含む費用だと明記しています。「10分の1のコスト」という比較は、聞こえほど確かではありません。脚注の根拠は、Reflectionが毎月$150Mの計算資源を確保したというTechCrunchの報道と、Beamに約8週間かかったというReflection自身の発言です。つまりこれは競合の支出に関するRicursive側の推定であり、Reflectionが公表した数字ではありません。
強化学習の実行回数が少なくて済んだ。 RicursiveはTerminal-Benchのスコアを140万ロールアウトで達成したと述べ、これは"roughly 70x fewer rollouts than Reflection Beam."だとしています。また、ポストトレーニング用のデータは購入せず、独自の合成データパイプラインを構築したとも述べています。
Ripple-65Bのベンチマークは何を示している?
Ripple-65Bは、目玉の数字であるTerminal-Bench 2.1で80.5を記録しました。これは、モデルがターミナル内で実際のタスクを完了できるかを測るものです。各ラボの自己申告スコアでは、Reflection Beamの80.1をわずかに上回り、Muse Spark Open(76.4)、Inkling(63.8)、Nemotron 3 Ultra(56.4)を上回ります。
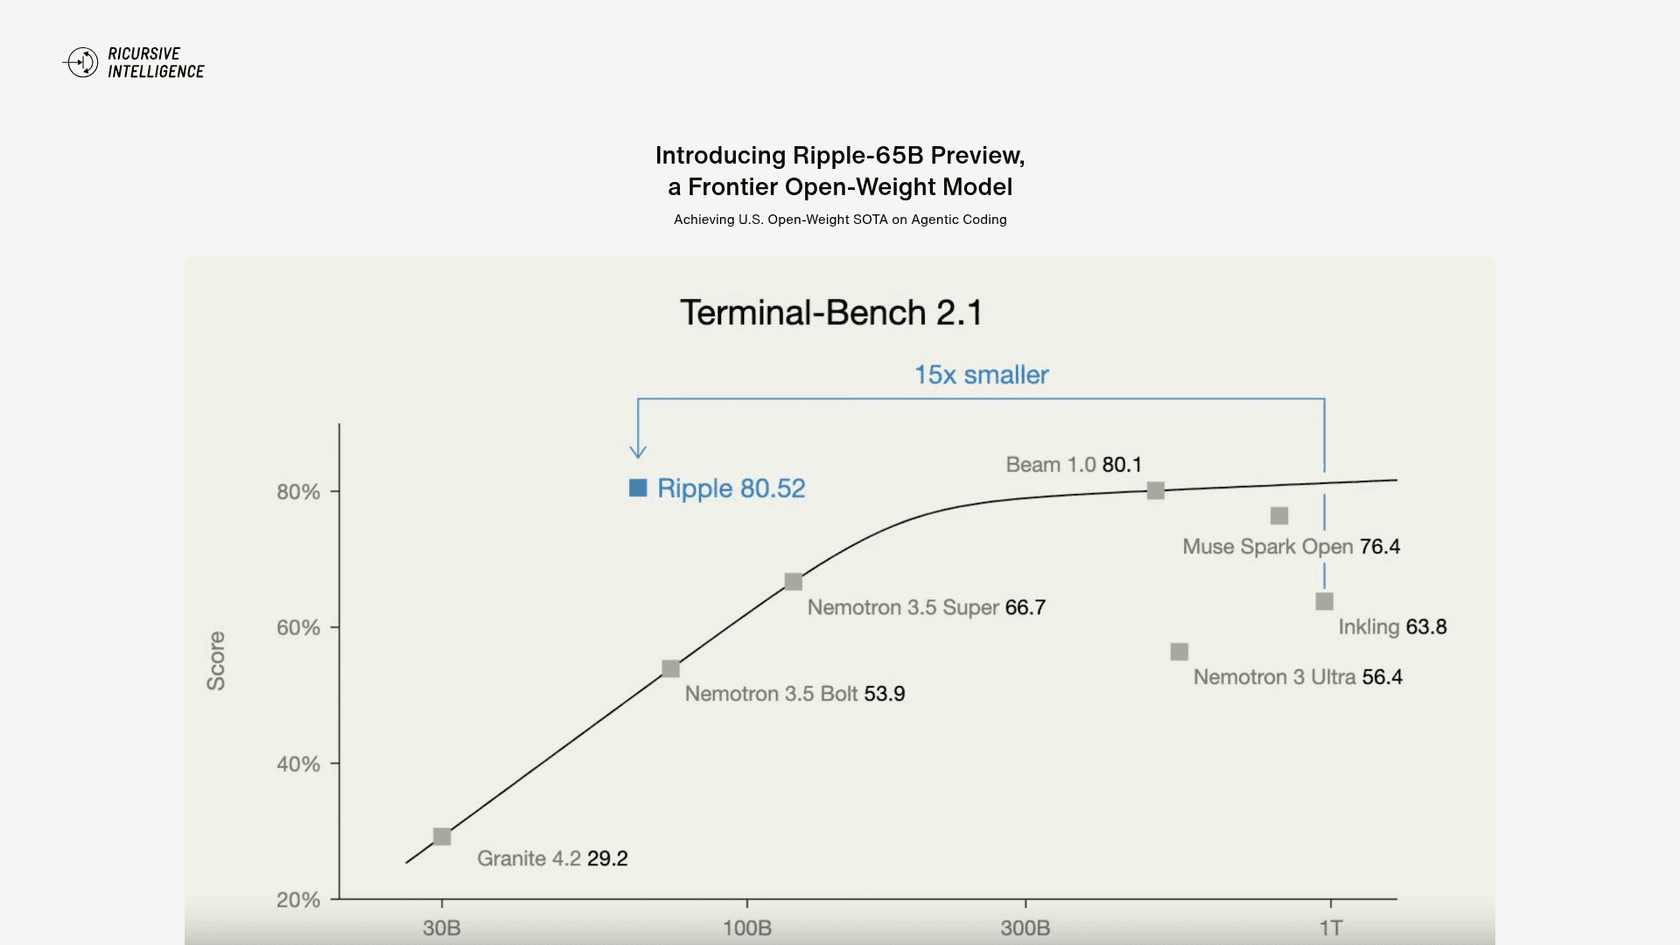
このチャートが売り込みのすべてです。スコアとサイズの関係で、Rippleは曲線のはるか左に位置します。Nemotron 3.5 Bolt(53.9)やNemotron 3.5 Super(66.7)といった小型の米国製モデルも同じ線上に並べています。サイズで調整したコーディング性能では、Rippleは明らかに優位です。
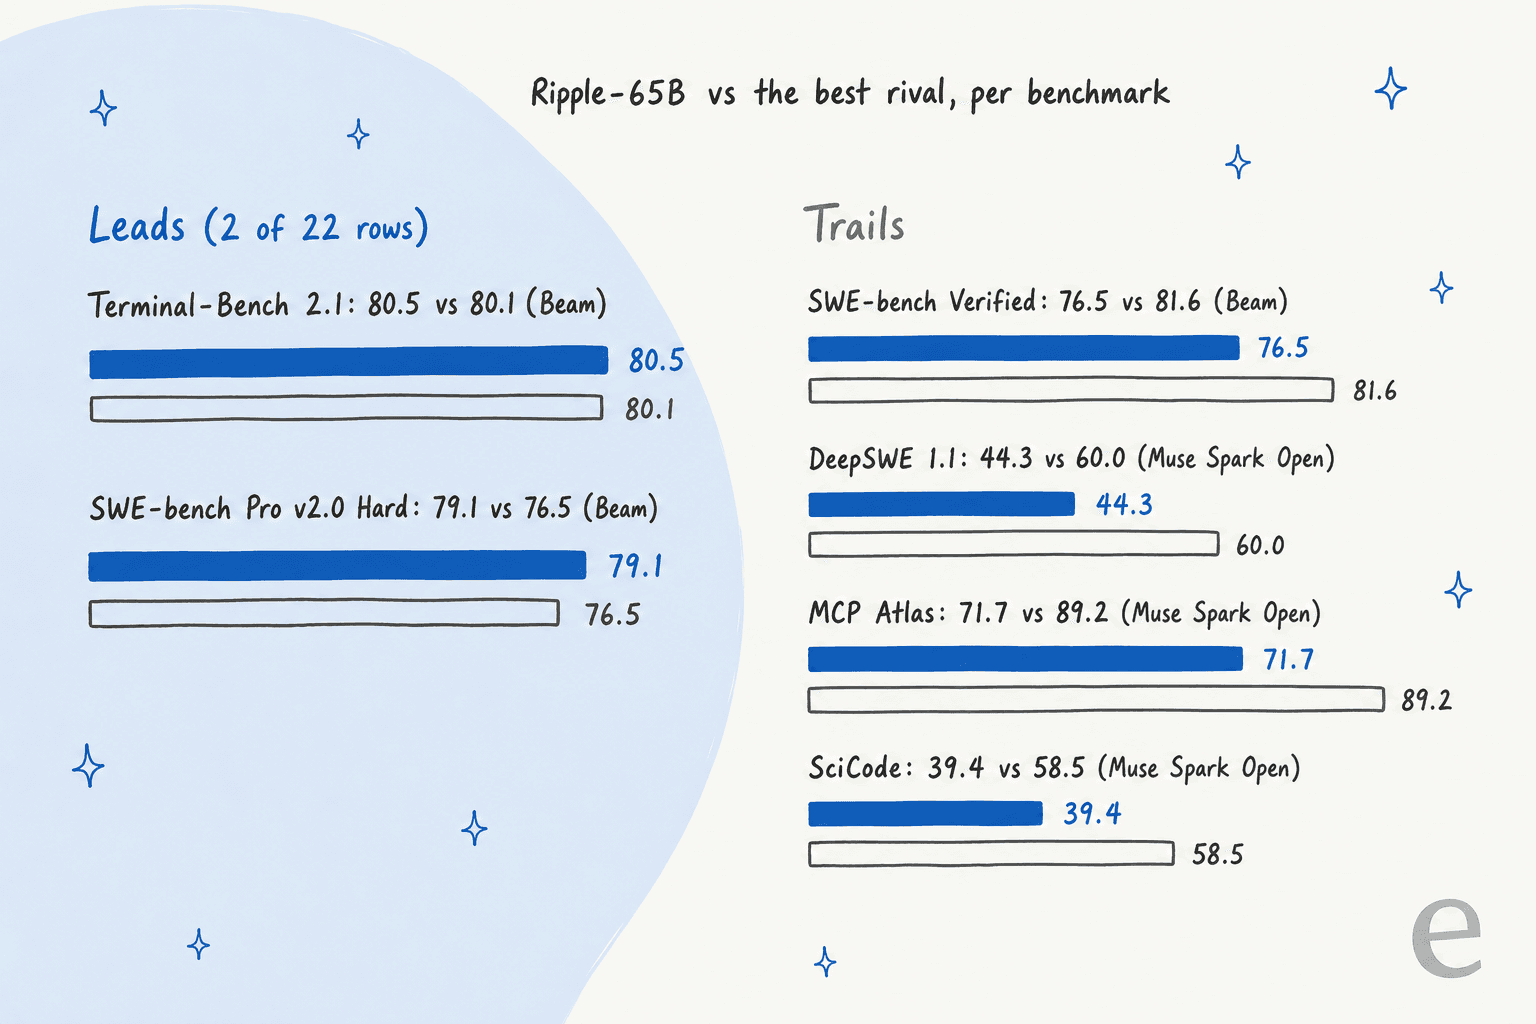
モデルカードの完全な表は、もう少し複雑な状況を示しています。コーディングエージェントに関わる行を、Ricursive自身の数字で示します。
| ベンチマーク | Ripple-65B | Reflection Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| アクティブパラメータ | 65B | 23B | 42B | 41B | 55B |
| Terminal-Bench 2.1(自己申告) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| Terminal-Bench 2.1(Ricursiveの再実行) | 80.5 | 70.8 | 78.7 | 56.2 | 55.1 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
| GPQA Diamond | 85.2 | 90.6 | 89.0 | 87.2 | 87.0 |
表を丁寧に読むと、4つのことが目に留まります。
- 22行中2行でリードしている。 Terminal-Bench 2.1とSWE-bench Pro v2.0 Hardです。SWE-bench VerifiedとPro v1.0ではReflection Beamが上で、DeepSWE、MCP Atlas、SciCodeではMuse Spark Openが上です。
- 再実行で最も得をするのはRipple。 Ricursiveが公式のTerminus 2ハーネスでTerminal-Bench 2.1を再実行したところ、Beamは80.1から70.8に下がり、Muse Spark Openは78.7に上がりました。カードは、Muse以外はそのハーネスでスコアが"universally lower"だったと述べ、結果を"a best-effort attempt at a fair comparison."としています。誠実な記述ですが、差が広がった分はRicursive自身のテスト実行に由来することも意味します。
- ライバルのスコアの多くはRicursiveが自分で回したもの。 カードでは社内実行の結果をイタリックで示しており、SWE-bench Pro v2.0 HardでのInklingの2.0のように、低い数字の大半がそれに当たります。Ricursiveの発表ブログでは、同じセルの一部が別の値(Inklingは39.6、Museは72.4)になっているため、技術レポートが出るまではそれらの行は慎重に扱ってください。
- 中国のオープンウェイトモデルは含まれていない。 比較は"U.S. open-weight"という枠組みなので、instructの表にDeepSeek、Qwen、Kimiはありません。DeepSeek V4.1 FlashやQwen 3.8 Flash Nextを候補にしているなら、自分で比較する必要があります。
これらのベンチマークは、まだ外部のラボによる検証を受けていません。誰かが再実行するまでは、「コーディングで米国製オープンウェイトの最上位モデルと競える65B Denseモデル」と読むのが安全で、「最高のオープンウェイト・コーディングモデル」とは言えません。
Ripple-65Bの料金は?
重みはApache 2.0で無料です。ホスティングでは、Ripple-65Bは入力が100万トークンあたり$0.20、出力が$0.60で、キャッシュ入力は$0.05です。これはGMI Cloudの直接利用でも、GMI Cloudが唯一のプロバイダーであるOpenRouterでも同じです。
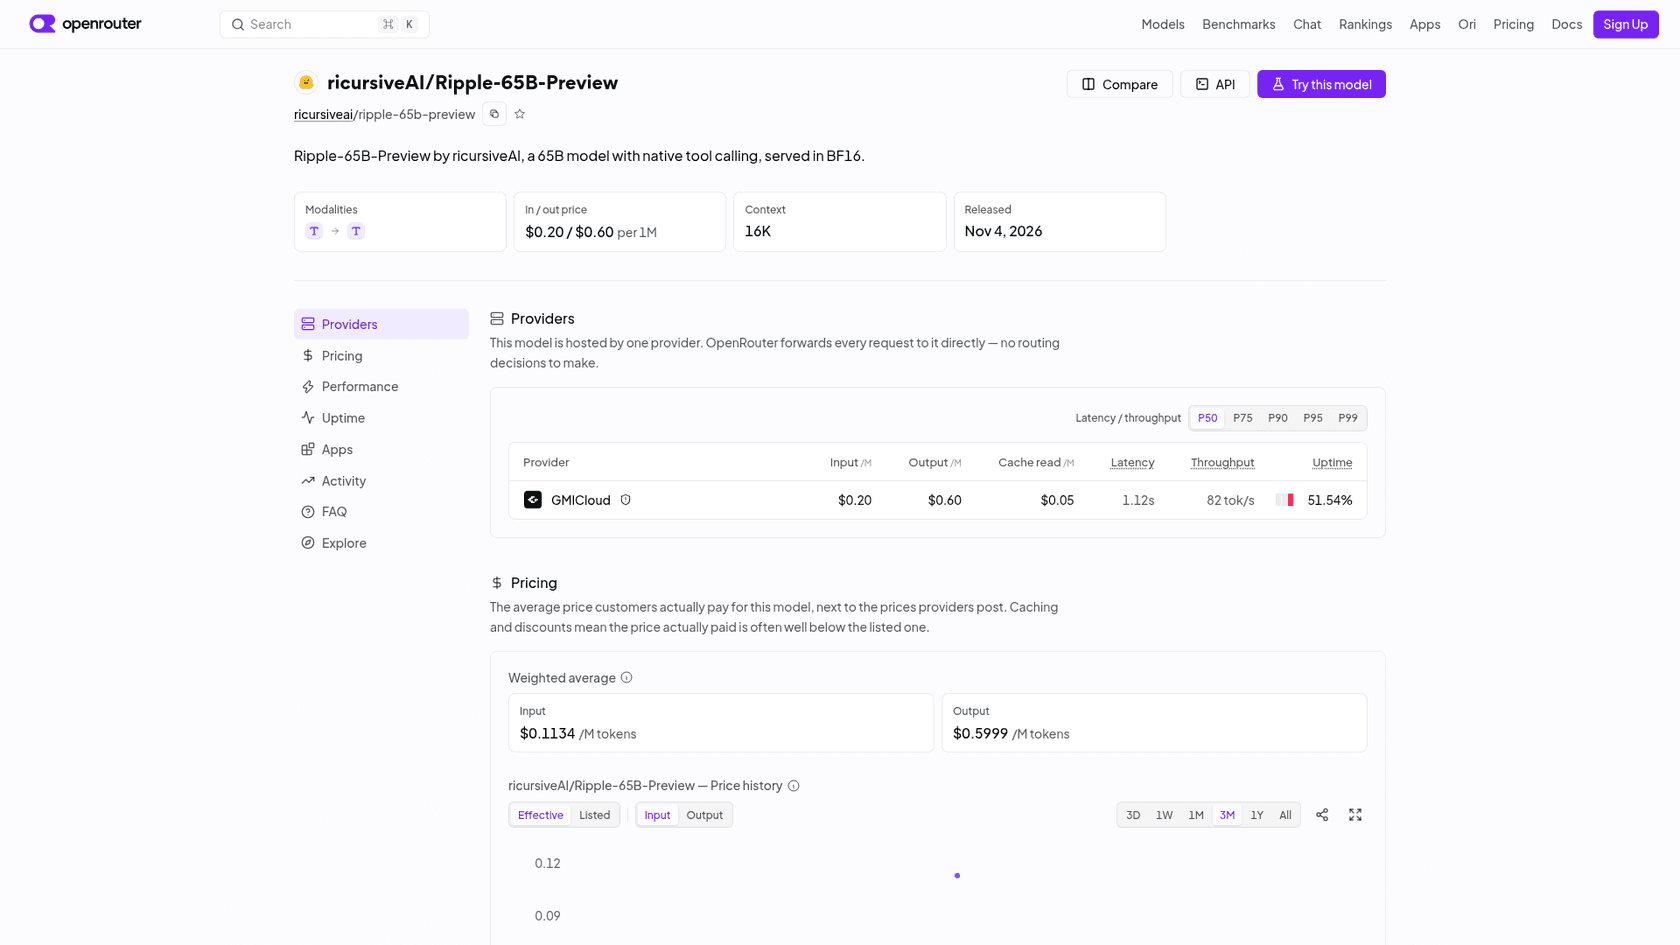
2026年11月5日時点のOpenRouterの定価で、近いモデルと比べるとこうなります。
| モデル | 入力 / 1M | 出力 / 1M | キャッシュ入力 / 1M | OpenRouterでのコンテキスト |
|---|---|---|---|---|
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | 16,384 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | 1,048,576 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | 1,048,576 |
| Inkling | $1.00 | $4.05 | $0.17 | 524,288 |
| Inkling Small | $0.45 | $1.20 | $0.10 | 524,288 |
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | 1,048,576 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | 1,050,000 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | 1,000,000 |
この表では、出力料金で米国製オープンウェイトの中でRippleが最安です。ただし、掲載内容では価格より重要な点が2つあります。
- ホスティング時のコンテキストは16K。 モデルカードやGMI自身のページは1Mとしているのに、OpenRouterは16,384トークン、出力上限14,745トークンに制限しています。実際のリポジトリで動くコーディングエージェントは16Kをすぐに使い切るので、Rippleを組み込む前に必ず確認してください。
- プロバイダーが1社だと容量が薄い。 GMI Cloudが唯一のホストのため、私が確認したとき、OpenRouterの稼働率パネルは直近1日で約51%でした。また、RicursiveはRippleがTogether AIとFireworksにも来ると述べていました。11月5日時点で、Togetherのページには"This model is coming soon to Together's Serverless API."と表示されたままでした。
Ripple-65Bはローカルで動かせる?
はい、NVIDIAハードウェア上であれば可能で、これがこのリリースで最も興味深い点です。Ricursiveは文書化された構成を2つ提供しており、得られるコンテキストウィンドウはどちらを選ぶかで変わります。
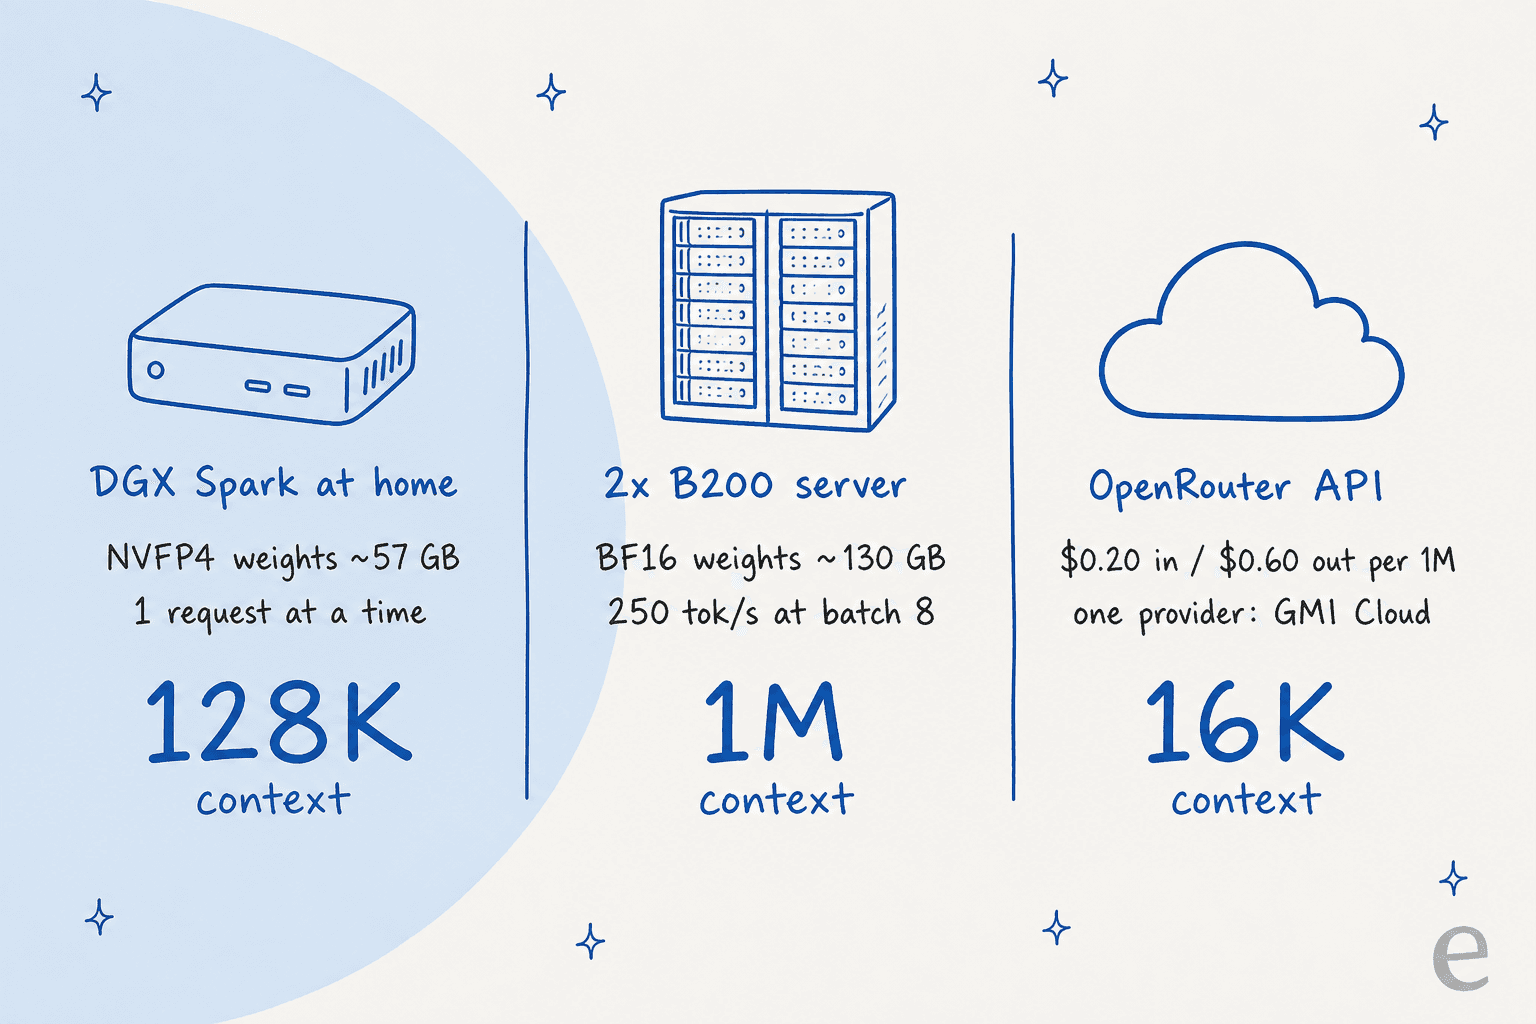
DGX Spark上で。 NVFP4リポジトリには、NVIDIAのデスクトップAIボックス向けのノートブックとspark.pyスクリプトが含まれています。NVFP4の重み(フィードフォワード層は4ビット、アテンションはBF16)とDFlash2ドラフトモデルを読み込み、128Kコンテキストで1回に1リクエストを処理します。スクリプトはGB10チップ以外では実行を拒否します。RicursiveはSparkでの毎秒トークン数を公表していません。
B200 GPU 2基で。 BF16リポジトリにはSGLang 0.5.19を使うサーバー構成があり、1Mのフルコンテキストを処理します。Ricursiveは"250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels."と記しています。GPUが4基あれば、独立した2つのコピーが動かせます。
Macやその他では。 公式な方法はありません。共同創業者の発表投稿には"You can run Ripple-65B locally and efficiently on a MacBook Pro"とありましたが、MacBook、MLX、llama.cppに関する手順は、ブログにも4つのモデルカードのいずれにも見当たりません。コミュニティ製のGGUF変換は1日以内にHugging Faceに現れましたが、Ricursiveは検証していません。
未解決なのは速度です。Denseモデルはトークンごとにすべての重みを読むため、メモリ帯域に強く依存し、そこがSparkの弱点です。この点は発表から数時間で指摘されました。
"What tok/s are you getting on the Spark? 65B dense on ~273GB/s of memory bandwidth has to crawl in an agent loop."
ドラフトモデルはこれに対するRicursiveの答えで、投機的デコーディングにより、小さなモデルが複数のトークンを予測し、大きなモデルが1回のパスで検証します。これでSpark上のエージェントループが実用的な速度になるかどうかは、11月5日時点で誰も公に測定していませんでした。
Ripple-65Bをコードから呼び出すには?
GMI CloudとOpenRouterはどちらもOpenAI互換のチャットエンドポイントを提供しているので、その形式に対応したSDKやエージェントフレームワークなら動きます。OpenRouterでのモデルIDはricursiveai/ripple-65b-previewです。
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ricursiveai/ripple-65b-preview",
    "messages": [{"role": "user", "content": "Write a bash one-liner that finds the 10 largest files in a repo."}],
    "temperature": 0
  }'
構築を始める前に知っておきたい、チャットテンプレートのポイントがいくつかあります。
- ツール呼び出しはネイティブ対応。 ツールはシステムプロンプトに置き、呼び出しは
<tool_call>タグ内のJSONとして返り、SGLangのrippleパーサーが標準のtool_callsに変換します。tool_choice: "required"で呼び出しを強制する場合はstrict: trueを設定してください。Ricursiveは"non-strict required calls produced extra argument fields."と確認しています。 - 推論は常にオン。 テンプレートは思考を
<think>タグで包み、"does not implement a thinking on/off switch or reasoning-effort levels."とされています。その思考の分の出力トークンは、毎回の呼び出しで課金されます。 - サンプリングのデフォルトなし。 Ricursiveは推奨温度を示しておらず、自社の例では0を使っています。
Claude Codeやエージェント型コーディングCLIのようなコーディングエージェントからRippleを動かすつもりなら、最初にぶつかる限界はホスティングの16Kコンテキストです。現状では、セルフホストがそれを回避する方法です。
開発者はRipple-65Bをどう見ている?
メインのHacker Newsスレッドは、発表当日に181ポイント、61コメントに達しました。話題の中心は2つで、ベンチマークの見せ方と、65B Denseモデルが自宅で現実的かどうかです。
見せ方については、比較が米国製モデルまでで止まっているという不満が最も多く見られました。
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"

リードの大きさそのものを指摘する声もありました。
"Still they score 0.42 percentage points higher than the second-best model on their chosen benchmark, so it's hardly a meaningful lead."
反論は、「米国製」がマーケティング上のラベルではなく実際の要件である人たちから出ました。
"US Gov won't let Chinese models be hosted on any internal infra ... So there is absolutely a market for US-made or non-Chinese models there."
自宅での実行については意見が割れました。あるコメントは"inference will be prohibitively slow on consumer grade hardware"と予想し、このリリースはRicursive自身の事業に合致する、エアギャップ環境のチップ設計チーム向けだと読み解いていました。大容量メモリのMac Studioを持つ人たちは、130 GBの重みが自分たちのクラスターの容量を大きく下回るため、より前向きでした。11月5日の朝の時点で、実測速度を投稿した人はいませんでした。
コストの主張が最も好意的に受け止められました。swyxはこのリリースを"the avengers of open model SOTA"と呼び、$32MがR&D全体を含むという脚注を引用しました。多くの人が最も印象的だと感じた点です。
カスタマーサポートにRipple-65Bを使うべき?
サポートボットの頭脳としては、おそらく向きません。理由は品質ではなく適合性です。Ripple-65Bはポストトレーニングが軽いコーディングモデルです。Ricursive自身の表でサポート業務に最も近い行は平凡で、顧客とのポリシー遵守の会話を測るτ³-bench bankingは31.27(Beamは36.1)、ツール利用を測るMCP Atlasは71.67(Muse Spark Openは89.2)です。唯一の強いケースはデータ管理で、顧客データがネットワーク外に絶対に出せない場合、自社ハードウェア上のApache 2.0モデルは現実的な選択肢であり、Rippleは強力なモデルの中でも最小クラスです。
それでも、モデルは簡単な部分です。チケットにうまく答えるには、ナレッジベースとの接続、エスカレーションルール、でたらめな回答を防ぐガードレール、顧客に届く前に返信を確認する仕組みも必要です。これがAIサポートにおける自作か購入かのトレードオフで、作業の大半を占めます。
そのギャップを埋めるのがeeselです。eeselはAIチームメイトのプラットフォームで、AIヘルプデスクチームメイトは既存のヘルプデスクに参加し、ヘルプセンターや過去のチケットから学び、キューの中で働きます。自信ありげなボットが実際のキューで誤った回答をするのを私は見てきました。だからこそeeselの導入では、まず過去のチケットで検証し、顧客に触れる前に、どう答えたかを確認できるようにしています。
Timengoは技術寄りの好例です。デンマークでセキュアメールとDigital Postのソフトウェアを販売しており、eeselは約5,300件の過去のチケットとヘルプセンター記事から、技術サポートの返信をデンマーク語で下書きし、1か月で約300件のFreshdeskチケットを準備しています。SE Rankingは3つの製品をZendeskで運用し、それぞれにeeselエージェントを1つずつ置き、1か月で4,650件の会話を処理しました。
ターミナルでの作業が好きでRippleに興味を持ったなら、eesel CLIはその習慣に合います。コーディングエージェントはこれを使って、エクスポートしたヘルプ記事やマクロといった承認済みの知識をアップロードし、チームメイトの指示を編集し、公開前にテスト質問で回答を確認できます。ヘルプデスク自体の接続には、管理者権限を持つ人の承認が引き続き必要です。このワークフローの詳細は、ターミナルからAIエージェントを管理するをご覧ください。
Ripple-65Bは誰が使うべき?
Ricursiveが公開したすべてのファイルを読んだうえでの私の見解です。
- 試すなら、完全に自分のものにできるコーディングモデルが欲しい場合です。Apache 2.0、1台で動くローカル実行方法、ホスティングで出力100万トークンあたり$0.60という条件は、自分のリポジトリで試すコストを抑えます。米国製モデルしか動かせないチームにも自然な候補です。
- セルフホストするなら、長いコンテキストが必要な場合です。ホスティングの16K制限は現状では本格的なエージェント作業を難しくし、1Mコンテキストは自前のGPUがあってはじめて使えます。
- 待つなら、裏付けが必要な場合です。技術レポートはまだなく、一部のセルでベンチマークの出典が食い違い、外部ラボによる数字の再実行もありません。数週間の第三者テストで多くのことがはっきりするでしょう。
- 他を探すなら、価格がすべてを決める場合です。DeepSeek V4.1 Flashは入力も出力も安く、Kimi K3.1 Proはより広くテストされています。より幅広い候補は、おすすめAIコーディングアシスタントツールをご覧ください。
公平にまとめると、Ripple-65B Previewは、65B Denseモデルを持つ小さなチームが、報告された$32Mで、コーディングにおいて8〜15倍大きい米国製オープンウェイトモデルと同じ水準に届きうることを示しました。これは本物の成果です。「最先端」が成り立つのは狭いカテゴリーの中だけで、自分の仕事で成り立つかどうかは、自分のタスクで動かして確かめるしかありません。
eeselを試す
オープンモデルがチームのチケットを肩代わりしてくれることを期待してRipple-65Bに辿り着いたなら、サポート層を自分で作る手間は省けます。eeselのAIヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgiasなどに数分で接続でき、過去のチケットから学び、公開前にどう答えたかを見せてくれます。料金は月額$299からで、試せる無料プランもあります。
