

GLM-5.3-FlashはZ.aiで最も安いGLM-5モデルで、見出しになるのは価格です。50%のローンチプロモーション中は、入力100万トークンあたり$0.075、出力100万トークンあたり$0.25で、キャッシュ入力は$0.015です。課金単位は単純なトークンなので、解決件数ごと、席ごとの思わぬ請求はありません。つまずきやすい点が2つあります。プロモーションは2026年9月9日に終了し、その後はすべてのレートが定価の$0.15/$0.50に倍増します。そしてGLM-5.3-Flashはフラッグシップではありません。テキスト専用のGLM-5.3フラッグシップは別のモデルで、$1.40/$4.40、約10倍の価格です。
トークンを計測するよりサブスクリプションがよければ、GLM Coding Planは月額$18(Lite)から、最大月額$168(Max)まで用意されており、Claude CodeやCursorなどのツールで使えます。
価格表には載っていない落とし穴もあります。Z.ai自身のAPIではこのモデルは遅く(約49トークン/秒)、Databricksなどのサードパーティ ホストでは同じ重みが273トークン/秒で提供されます。つまり、どこで動かすかはレートカードと同じくらい実際のコストを左右します。また、レートカードで買えるのはトークンであって、動くシステムではありません。自社のツール内で実際にチケットに回答したりブログ記事を書いたりするAIが欲しいなら、それがこうしたモデルの上に位置するeeselのチームメイト層です。
この記事の残りでは、完全なレートカード、プロモーションの崖、コーディングプラン、そして実際のワークロードのコストが分かる計算例をいくつか見ていきます。
GLM-5.3-Flashは2026年8月に、Z.ai(Zhipu AI)のGLM-5ラインで初のネイティブマルチモーダルモデルとして登場し、ネットの反応は主に1点、つまりコストへの驚きに集中しました。Artificial Analysisは1タスクあたり約$0.045と見積もり、Redditのスレッドでは数倍高価なモデルとの比較で好意的に語られ続けました。そこで、ローンチ記事が語らなかったことをやってみましょう。実際にいくら払うのか、落とし穴はどこか、その数字で本当に何が買えるのかを示します。
こちらがZ.aiの料金ドキュメントに載っている実際のレートカードです。
GLM-5.3-Flashの料金を一目で
このモデルは100万トークン単位の従量課金で、入力、キャッシュ入力、出力に分かれています。全体像は次のとおりで、プロモーションレートを先に、定価を併記します。
| 項目 | プロモーションレート | 定価 | 備考 |
|---|---|---|---|
| 入力 | $0.075 / M | $0.15 / M | 標準のプロンプトトークン |
| キャッシュ入力 | $0.015 / M | $0.03 / M | 標準入力より約80%安い |
| キャッシュ入力の保管 | 無料 | 無料 | 「Limited-time free」 |
| 出力 | $0.25 / M | $0.50 / M | 推論トークンを含む |
| ウェブ検索 | $0.01 / 回 | $0.01 / 回 | 組み込みツールのアドオン |
出典:Z.ai API料金ドキュメント。
注目すべき点がいくつかあります。出力トークンは入力の約3.3倍のコストで、GLM-5.3-Flashは思考専用モデル(推論をオフにできません)なので、どのリクエストも回答する前に内部の推論で出力トークンを消費します。推論モデルでは普通のことですが、請求額の中心は入力ではなく出力にあるということです。見出しの入力レートではなく、出力レートを基準に予算を組んでください。
もう1つの点は、GLM-5.3-Flashがどんなモデルかです。総パラメータ320B、アクティブ18Bのエキスパート混合モデルで、100万トークンのコンテキストウィンドウとネイティブな画像理解を備えています。画像を読み、100万トークンのコンテキストを保持できるモデルが、出力100万トークンあたり4分の1ドルというのは驚くほど低価格です。
Flashはフラッグシップではない(そして価格差は巨大)
これは最もよくある取り違えなので、はっきり言っておきます。GLM-5.3とGLM-5.3-Flashは、たまたま同じバージョン番号を共有している別々のモデルです。
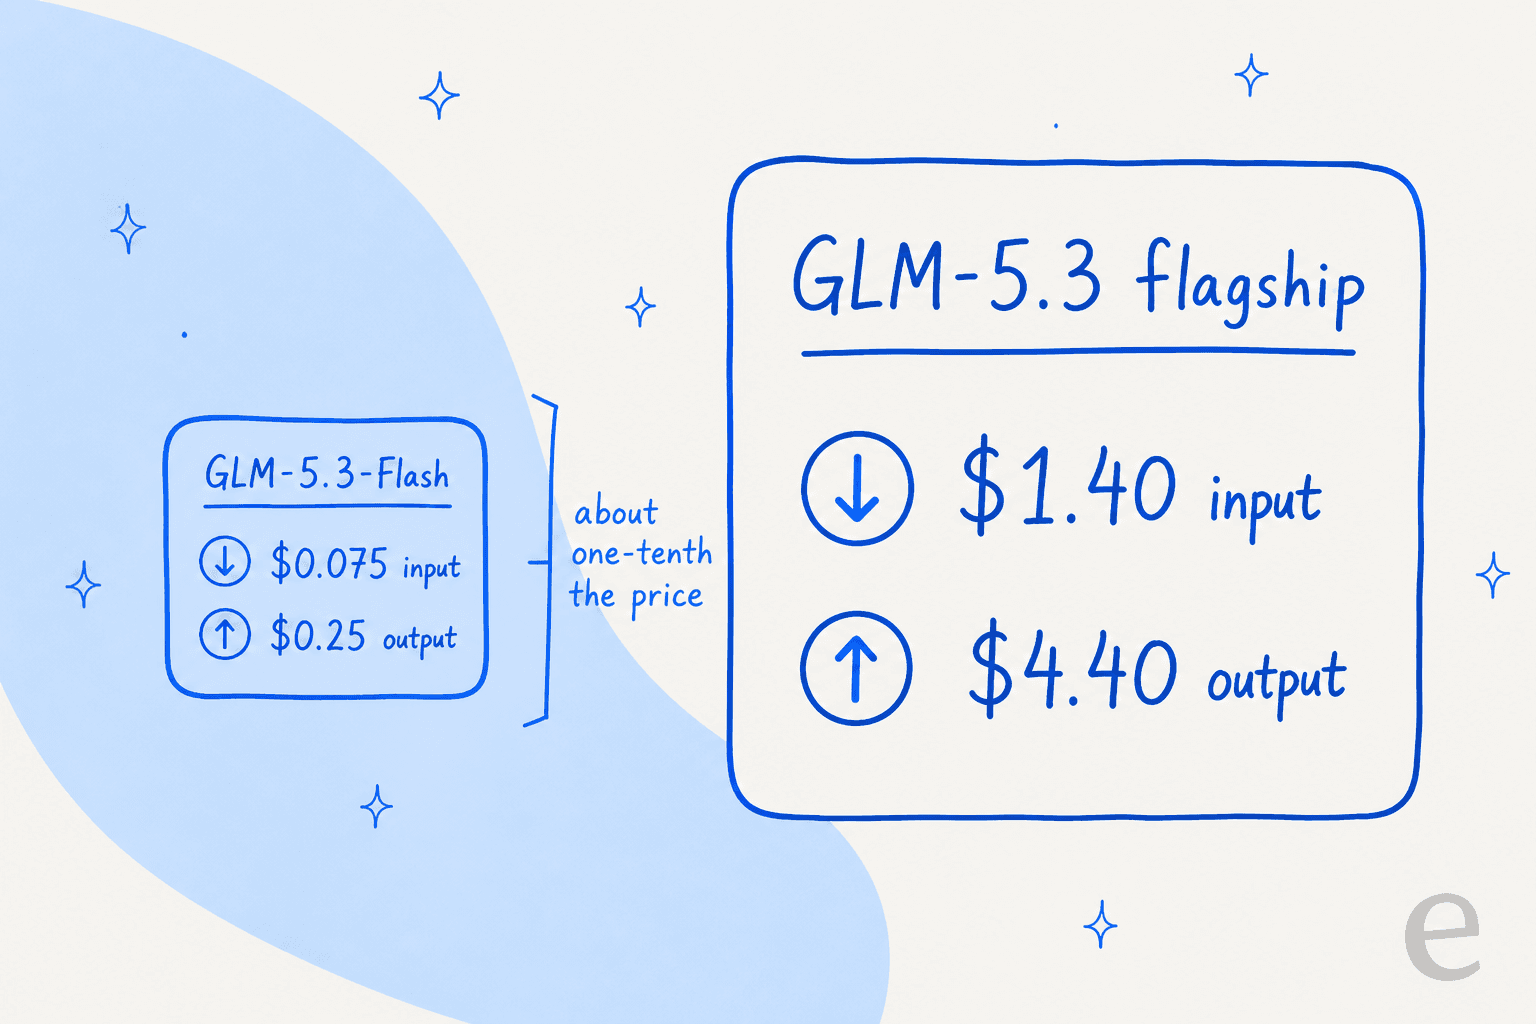
- GLM-5.3-Flashは、安価でマルチモーダル、高スループットの兄弟モデルです。$0.075/$0.25なのはこちらです。
- GLM-5.3(フラッグシップ)はテキスト専用のコーディング・サイバーモデルで、100万トークンあたり入力$1.40 / 出力$4.40です。
その差は約10倍です。ある場所から「GLM-5.3」の価格を、別の場所からトークン見積もりを持ってくると、桁違いにずれることがあります。CloudflareによるFlashの説明が簡潔なまとめです。"outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price."
ですから、ワークロードの価格を見積もるとき、最初の問いは「何トークンか」ではなく「実際にどのGLM-5.3を呼ぶのか」です。コーディング以外の大半の用途(チャット、抽出、画像理解、要約)では、Flashが選ぶべきモデルで、この記事の対象でもあります。最先端のコーディングやセキュリティ研究にはフラッグシップがありますが、フラッグシップ料金を払うことになります。
プロモーションの崖:9月9日に価格が倍になる
$0.075/$0.25という数字は50%のローンチ割引であり、恒常的な価格ではありません。Z.aiの料金ドキュメントによれば、プロモーションは2026年9月9日24:00(UTC+8、シンガポール時間)に終了します。その後、レートカードは入力$0.15 / 出力$0.50の定価に戻ります。
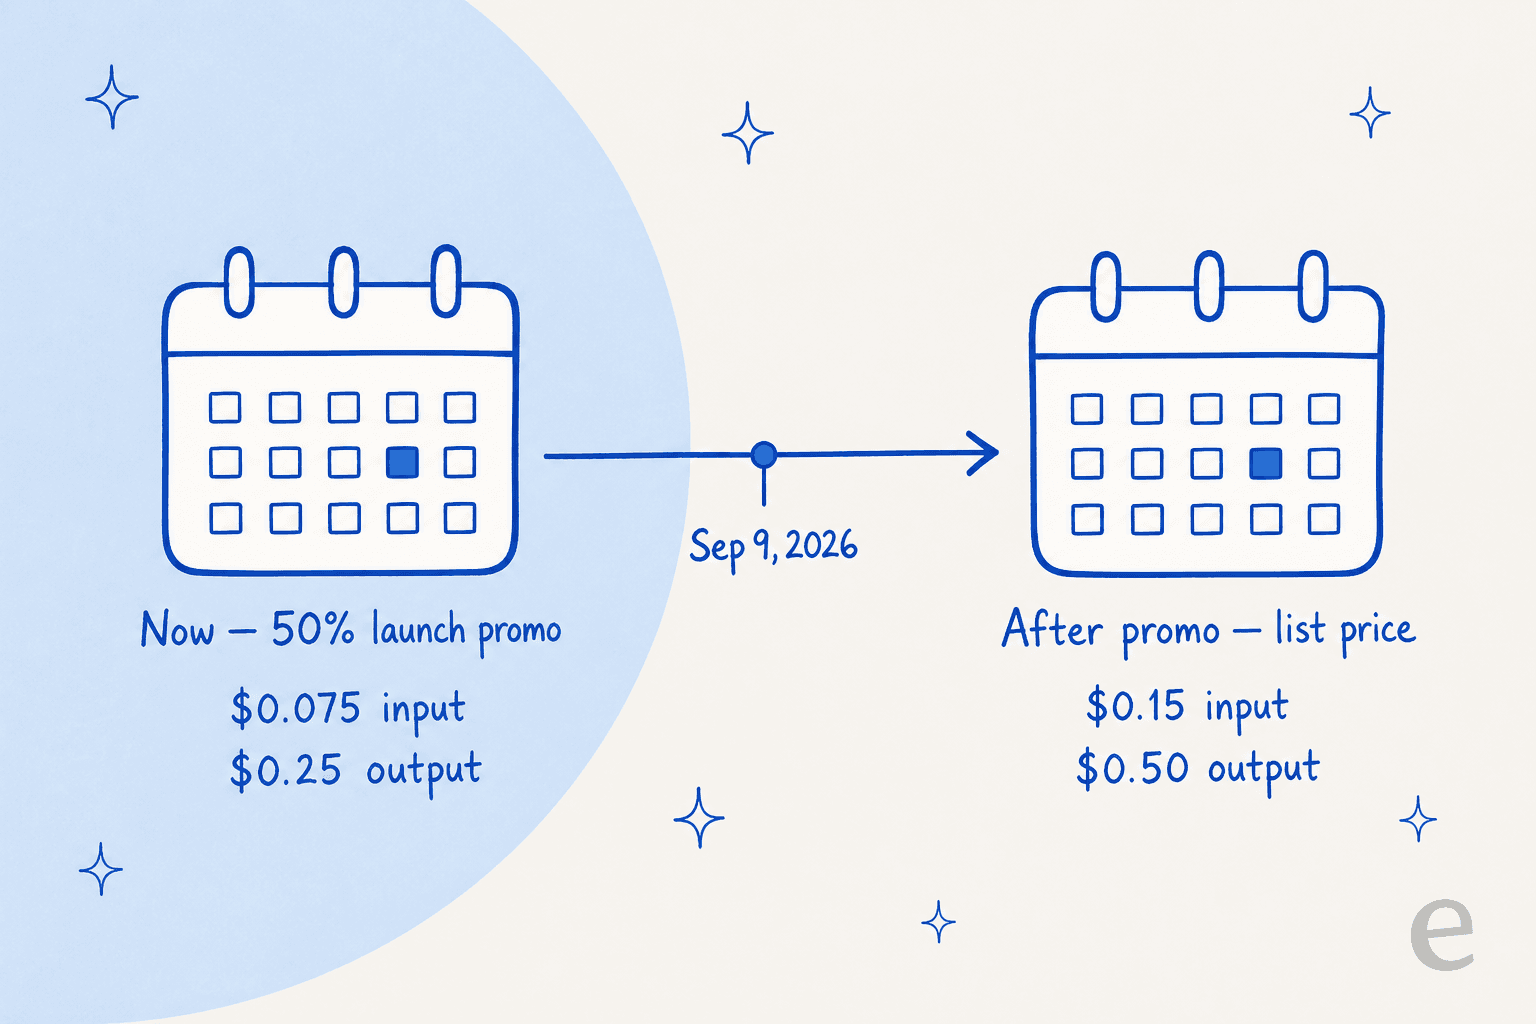
倍になってもGLM-5.3-Flashはどんな常識的な基準でも安いので、慌てる理由にはなりません。ただし、9月以降にリリースする製品のコストモデルを作るなら、プロモーション価格ではなく定価を使ってください。$0.075で組んだ予算が実は$0.15を必要としていた、というのは、表計算では問題なく見えて、プロモーション後の最初の請求書で痛い目を見るパターンです。
キャッシュ入力とウェブ検索アドオン
実効レートを変える小さな要素が2つあります。
キャッシュ入力が大きな要素です。プロンプトが大きく安定した接頭辞(システムプロンプト、ナレッジベース、何度も質問する長い文書など)を共有している場合、繰り返される部分はプロモーション中はキャッシュレートの$0.015/Mで課金され、標準入力レートより約80%安くなります。プロンプトの再利用が多いワークロードでは、良い請求額と素晴らしい請求額の差になります。キャッシュ入力の保管も当面は無料です。
ウェブ検索は組み込みツールで、1回$0.01が別途課金されます。安価ですが、呼び出しごとに計測されるため、毎ターン検索するエージェントはトークンレートには現れない形で積み上がります。ループに組み込むなら注意が必要です。
GLM Coding Plan:計測ではなくサブスクリプション
主にコーディングツールの中でGLMを使うなら、Z.aiはトークン計測そのものを回避できる定額サブスクリプションを販売しています。GLM Coding Planは、GLM-5.3とGLM-5.3-Flashを、Claude Code、Cline、OpenCode、Cursor、Roo Code、Kilo Codeなど20以上のエージェントツールで動かせます。
こちらが個人向けの各ティアで、年払いの場合の実質月額も示します。
| プラン | 月払い | 年払い(実質 /月) | 週ごとのクレジット | 相対的な利用量 |
|---|---|---|---|---|
| Lite | $18/月 | $12.60/月 | 10,000 | 1x |
| Pro | $80/月 | $56.00/月 | ~60,000 | Liteの6倍 |
| Max | $168/月 | $117.60/月 | ~140,000 | Liteの14倍 |
チーム向けにも2つのティアがあります。Standard Seatは$88/席/月(週66,000クレジット)、Premium Seatは$188/席/月(週155,000クレジットと、モデルへの早期アクセス付き)で、Z.aiの申込ページに記載されています。
仕組みは辛抱強い人に報いる設計です。クレジットはモデルごとの倍率で消費され(GLM-5.3-Flashはフラッグシップよりトークンあたりずっと安い)、オフピーク時間の利用は標準クレジットレートの50%で課金されます。ピークは月曜から金曜のシンガポール時間14:00〜18:00だけなので、週の大半はオフピークです。Z.aiは、オフピークを活用すれば従量課金のフラッグシップAPI呼び出しと比べて最大92%節約できると主張しています。これはベンダーの数字なので、約束ではなく上限として受け止めてください。ただ方向性は本物で、このサブスクリプションは、毎日の重いコーディング利用を明確に狙っています。
コーディングプランは、多くの人がGLMの活躍として思い浮かべるものです。エージェントの中でリファクタリングやマイグレーションをこなしていくモデルです。
見えないコスト:どのホストを選ぶか
ここがレートカードに載っていない部分です。GLM-5.3-Flashはオープンウェイトなので多くの場所で動かせ、スループットはホストごとに大きく異なります。Z.ai自身のファーストパーティAPIでは出力は約49トークン/秒で、あるRedditのスレッドは"one of the slowest models AA has ever"がベンチマークした、と評しました。サードパーティのホストは話が違います。
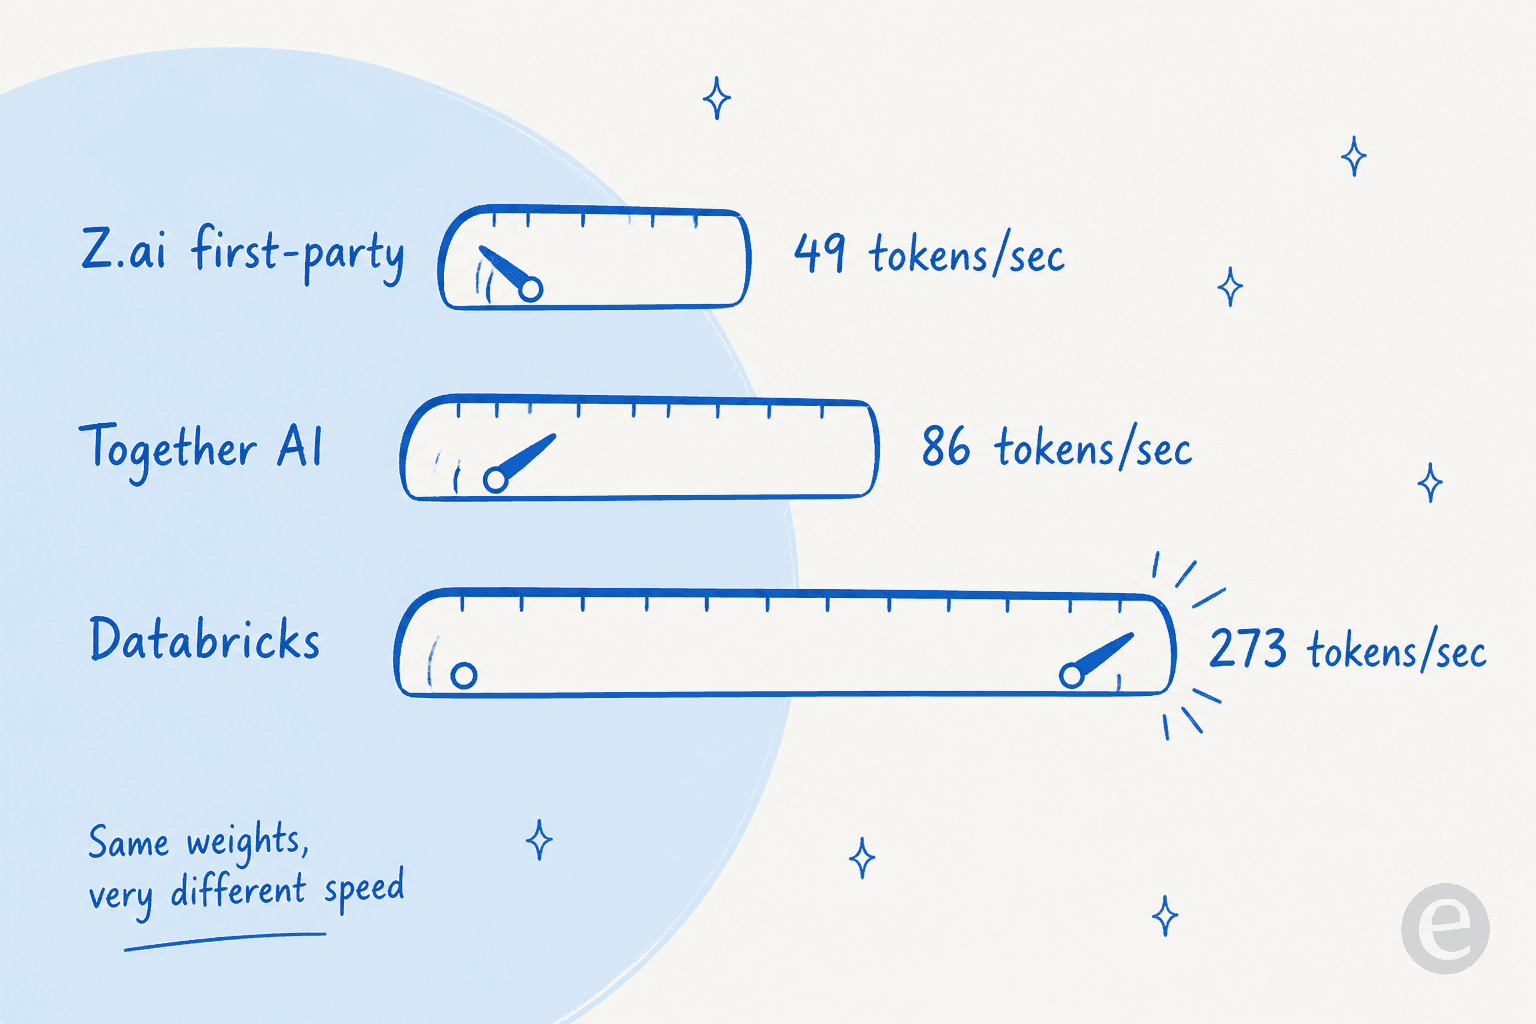
Artificial Analysisによると、11のAPIプロバイダーの中で、DatabricksはGLM-5.3-Flashを272.9トークン/秒、最低レイテンシ(最初のトークンまで8秒)で提供し、最も安い表示価格はGMIとBitdeerの約$0.05です。重要なのは、どれか1つのホストが最良ということではありません。「GLM-5.3-Flashの料金」は実際には価格と速度のマトリクスであり、ユーザーに見える用途ではスループットもコストだということです。価格が半分でも速度が5分の1のモデルは、ユーザー(やエージェント)が待つレイテンシを数えれば、かえって高くつくことがあります。
純粋な最安値が欲しいならファーストパーティかGMI。妥当なレートで速度が欲しいならDatabricksのようなホスト。ボトルネックがドルなのか秒なのかに合わせて、ホストを選んでください。
低価格で実際に何が買えるのか
安いことが良いのは、出力が使えるものである場合だけです。そこで、この数字をモデルの実力に結びつけてみましょう。Artificial Analysis Intelligence IndexでGLM-5.3-Flashは57を記録し、完全版のGLM-5.3の60に迫り、価格対知能のフロンティア上に位置します。テスターは具体的な場面でそれを裏付けました。
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
新しいビジョン機能については、あるテスターが1,500サンプルを実行して81%の精度を報告し、初のマルチモーダルリリースとしては妥当だと評しました。そして、競合との価格比較への反応が、何より大きな話題でした。
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

機能をより詳しく知りたい方には、アーキテクチャとベンチマークを掘り下げたGLM-5.3-Flashの概要があります。コストで候補を絞るなら、DeepSeekの料金やKimi K2.5の料金の解説とあわせてお読みください。ただ、価格の観点での結論は単純です。このモデルは性能が低いから安いのではありません。Z.aiがアクティブ18BのMoEを強気に値付けし、さらにローンチを補助しているから安いのです。
計算例:実際のワークロードはいくらか
100万トークンあたりのレートは実感しにくいので、ご自身の数字を入れてみてください。この計算機はプロモーションレート(入力$0.075、出力$0.25)を使っており、トグルを切り替えると9月以降の定価が見られます。
デフォルト値の目安として、月に入力5億トークン、出力1.5億トークンを処理する中規模のアシスタントは、プロモーションレートで約**$75/月**、定価が適用されると約**$150/月**になります。定価でも、席ごとに課金されるAIツールと比べれば誤差のようなもので、まさにそれがこのモデルが話題になった理由です。覚えておくべきは、思考専用の推論で膨らむ出力量こそが、数字を実際に動かすダイヤルだということです。生のトークンではなくコンテンツが目的なら、ブログ執筆に最適なLLMの記事が、品質とコストを同じ観点で比較しています。
eeselを試す:モデルはエンジン、eeselはチームメイト
率直な位置づけをお伝えします。GLM-5.3-Flashは素晴らしいインフラです。しかし、100万トークンあたり$0.075というレートカードは、サポートチケットへの回答でも完成したブログ記事でもありません。1樽の原油がドライブ旅行ではないのと同じです。モデルへの生のアクセスだけでは、検索、ガードレール、連携、テスト、そして「間違えたらどうなるか」という仕組みを自分で作ることになります。
eeselは1つ上の層にいます。トークンの代わりに、すぐ働けるAIチームメイトを採用できます。既存のZendesk、Freshdesk、Gorgiasのキューに参加して返信を下書きまたは送信するAIヘルプデスクのチームメイトと、SEO記事をリサーチから執筆まで一貫してこなすAIブログライターです。どちらも最初からヘルプセンターや過去のチケットを把握しており、つなぎ込みコードのスプリントではなく数分で稼働します。
チケットをAIに任せることに不安がある方にとって最も大事な違いは、eeselでは実際の過去チケットを使ってチームメイトをシミュレーションでき、ライブの顧客に触れる前に、解決率と回答内容を事前に確認できることです。スイッチを入れて祈る必要はありません。GLM-5.3-Flashのようなモデルがトークンを安くし、eeselはそれをキューで本当に信頼できるチームメイトに変えます。無料で試せます。クレジットカードも営業電話も不要です。