

GLM-5.3-Flashは、2026年8月26日に公開された、GLM-5ファミリー初のネイティブマルチモーダルモデルです。総パラメータ320Bのうちアクティブは18Bだけというエキスパート混合モデルで、1Mトークンのコンテキストウィンドウ、画像と動画の入力に対応し、HuggingFaceでオープンウェイトとして公開されています。
注目点は価格です。Artificial Analysis Intelligence Indexで57点を、1タスクあたり約$0.045で達成しています。API料金は入力100万トークンあたり$0.075から(2026年9月9日までのローンチキャンペーン価格で、定価は$0.15/$0.50)。GLM-5.2クラスの知能を、およそ10分の1のコストで使えます。
フラッグシップのGLM-5.3と混同しないでください。Flashは低価格でマルチモーダル、高スループットの兄弟モデルです。フラッグシップはテキスト専用のコーディング・サイバーセキュリティモデルで、100万トークンあたり$1.40/$4.40です。
サポートやコンテンツのチームにとって、このモデルはエンジンであって完成品ではありません。安くて高性能なモデルでも、顧客に安全に回答させるには、検索、連携、自社のナレッジ、テストが必要です。その最後の一歩を担うのがeeselです。
GLM-5.3-Flashとは何か
私はAIエージェントを仕事として作っていますが、毎週のように「フロンティア級の性能を何分の一かのコストで」というモデルが登場します。GLM-5.3-Flashは、数字を見てもその主張がおおむね成り立つ、最近では数少ないモデルのひとつです。
Z.ai(北京拠点で、以前はZhipu AIとして知られていた企業)は、2026年8月26日のGLM-5.3-Flashのローンチで、「Frontier Intelligence, Flash Cost」というキャッチコピーとともに公開しました。GLM-5シリーズで初めてのネイティブマルチモーダルモデルで、画像と動画がテキストと一緒に入力され、テキストが出力されます。内部は総パラメータ320Bのエキスパート混合モデルですが、1トークンあたりアクティブなのは18Bだけで、これが高速かつ低コストで提供できる仕組みです。
最初に押さえておきたい仕様を、すべてZ.aiのモデルドキュメントから挙げます。
- コンテキストウィンドウ: 1Mトークン、最大出力は128K。
- 入力: テキスト、画像、動画、ファイル。出力はテキストのみ。
- 推論: シンキングモードは常にオンで、以前のGLMモデルと違い無効にできません。
- ツール: 関数呼び出し、構造化JSON出力、ストリーミング、コンテキストキャッシュに対応。
- ウェイト: HuggingFaceで公開、SGLang、vLLM、TokenSpeedでセルフホスト可能。
このモデルが話題になる理由を一枚で示すのが、Artificial Analysisのコスト対知能のグラフです。GLM-5.3-Flashは、ほかのモデルがほとんどいない左上の「安くて賢い」領域に位置しています。
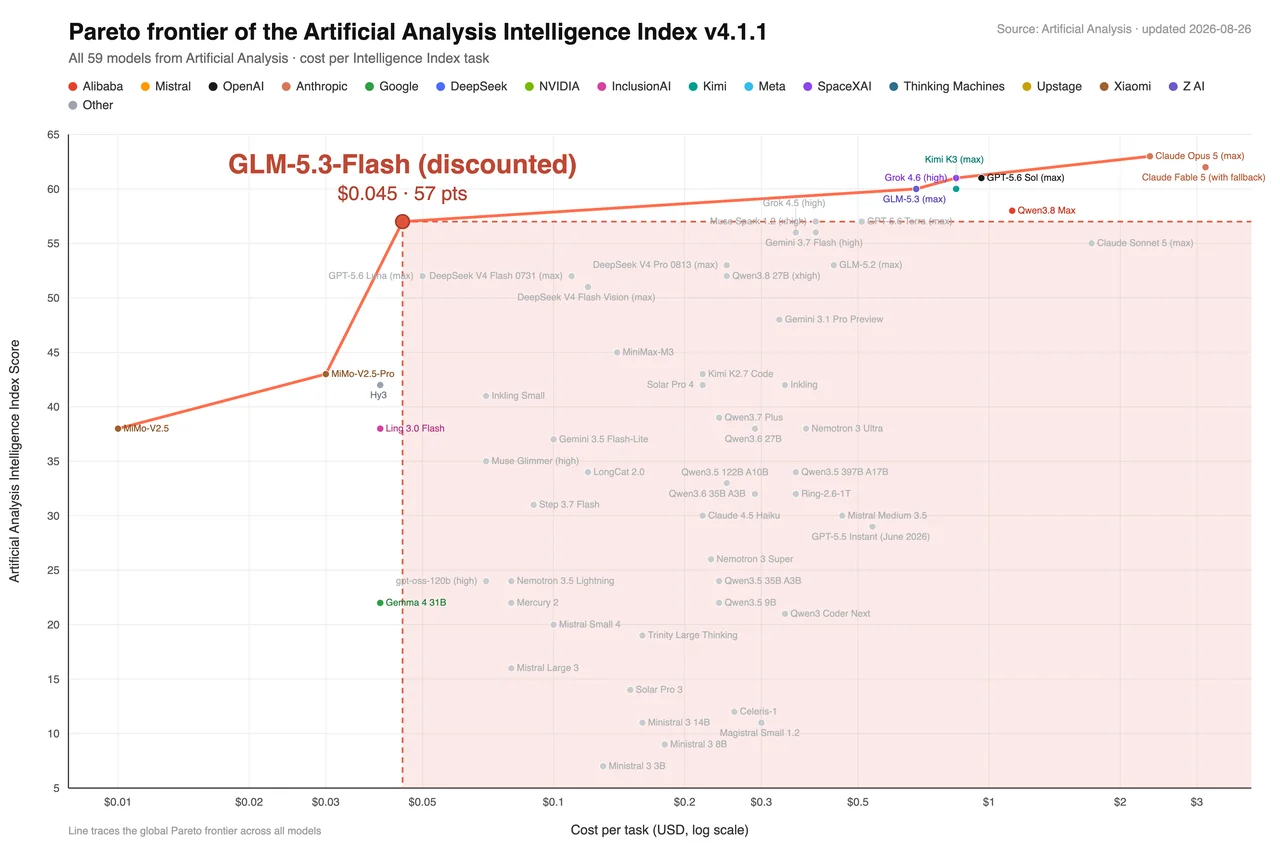
Z.ai自身の説明では、「これまで約10倍のコストでしか得られなかったレベルの知能」を提供するとしています。面白いのは、これが集計サイトのマーケティングではなく、第三者のベンチマーク集計サービスの数字だという点で、そのぶん偽装は格段に難しくなります。
「Ox Alpha」ステルスローンチ
私が最も示唆的だと思った点です。正式公開の前に、Z.aiは実際の利用フィードバックを集めるため、OpenCodeとOpenRouterで「ox-alpha」という名前で匿名運用しました。このモデルは静かにその週で最も使われたモデルになり、2位のモデルの2倍以上のトークンを処理しました。しかも、すべてNvidiaのハードウェアではなく中国製AIチップで提供されていました。
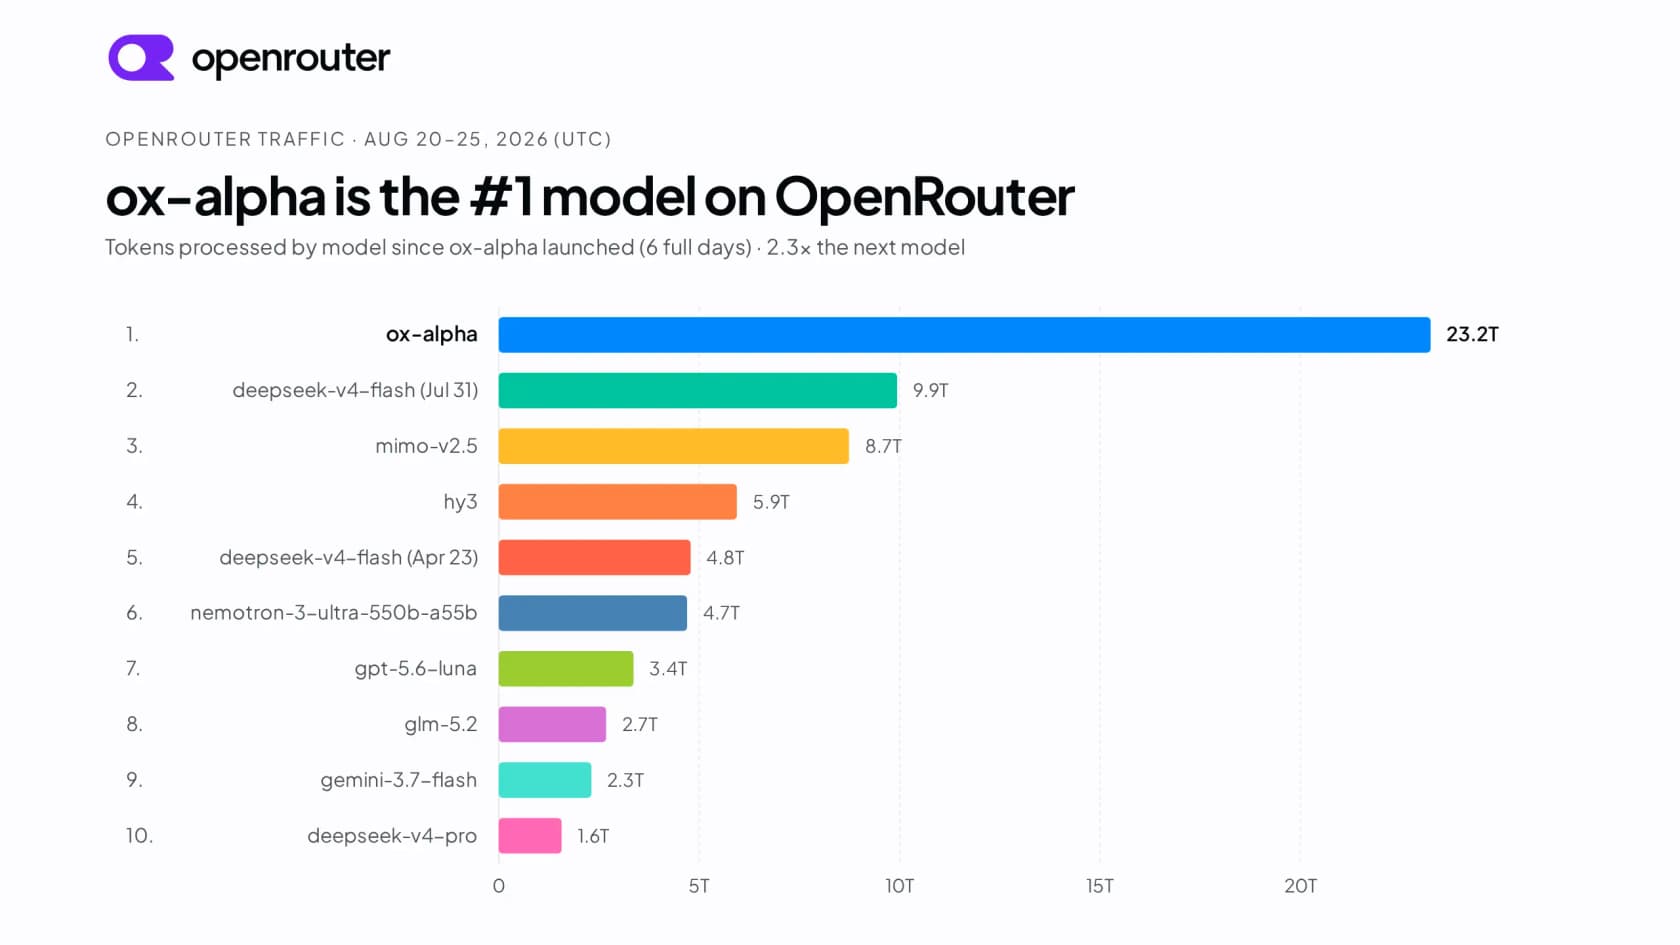
ここで重要なのは2点です。第一に、公開プラットフォームでのブラインドテストは、ラボが出せる最も正直なシグナルのひとつです。誰もブランドで選んでいないからです。第二に、中国製チップという切り口は本物のストーリーです。Z.aiは、これが「中国製チップがフロンティアモデルの推論を、大規模に、効率的かつ経済的に支えられることを示している」と主張しています。これが本当なら、フロンティア級の推論は特定ベンダーのGPUが前提だと考えていた市場の多くで、コストの計算が変わります。
GLM-5.3-Flashがコストを抑える仕組み
ここが私が本当に気にしている部分です。「安い」という話は、半年後に消える補助金ではなく、構造的な安さである場合にだけ意味があるからです。
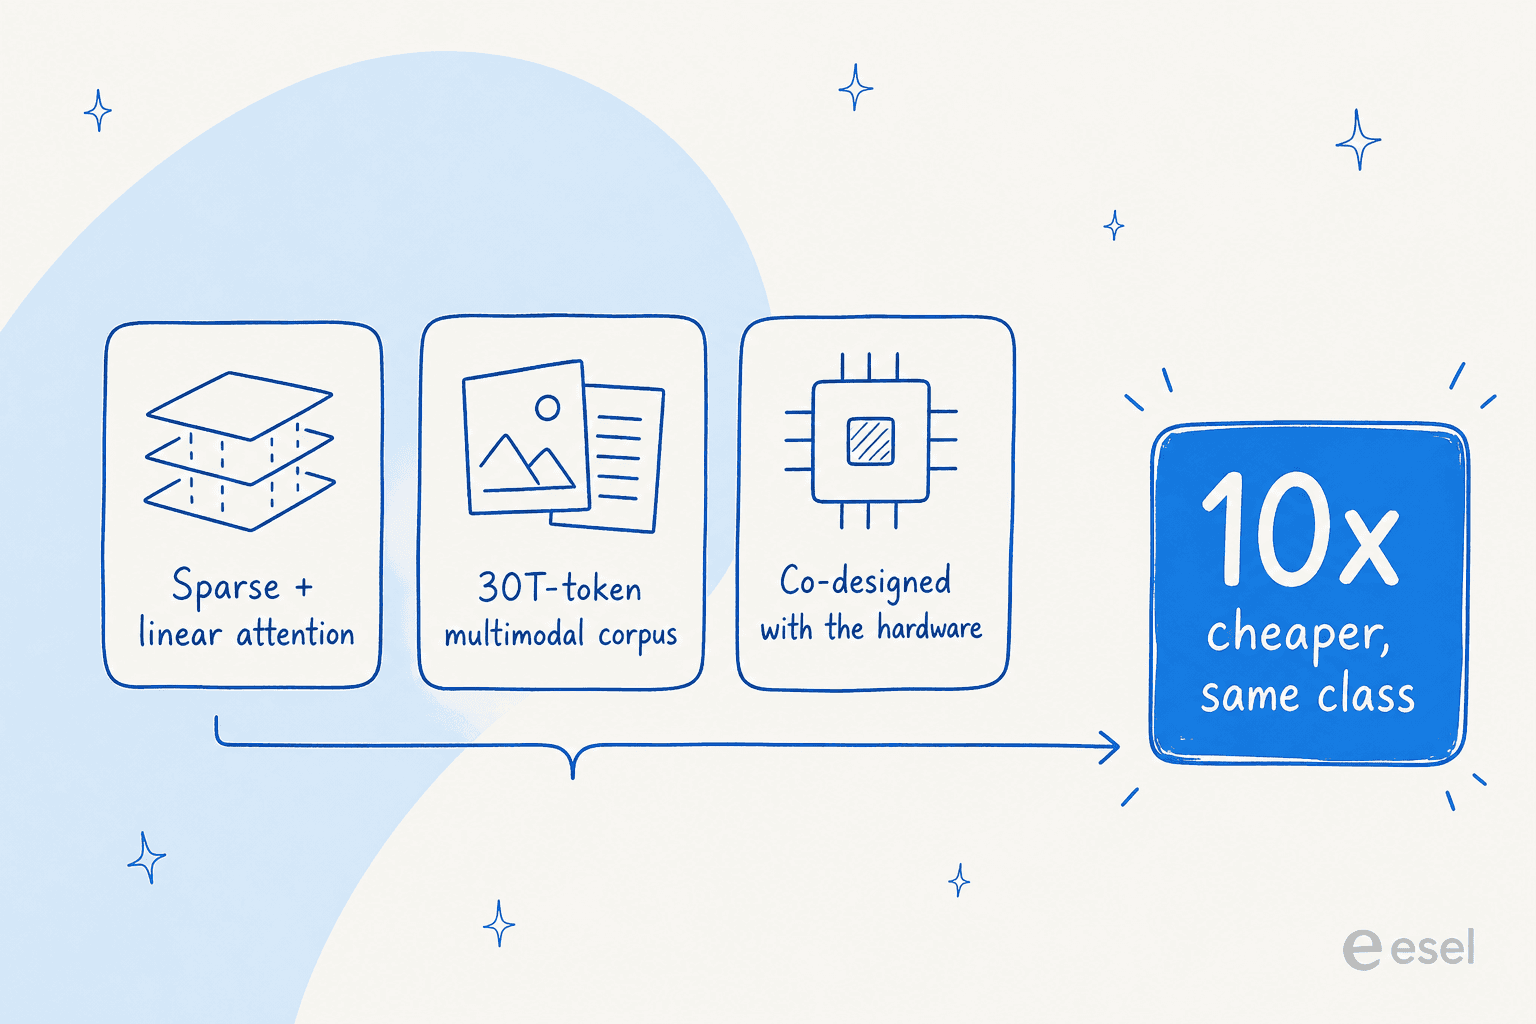
Z.aiはコスト削減を3つの層に分けており、アーキテクチャ図はじっくり見る価値があります。
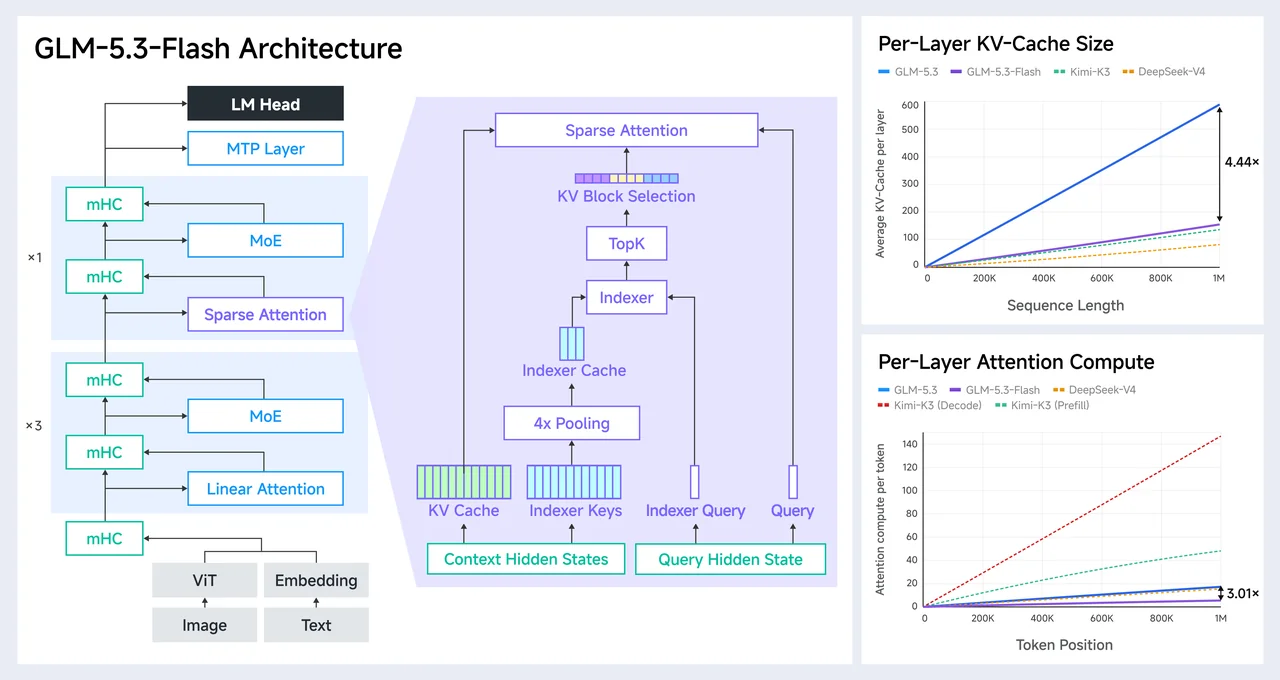
第1の層はアテンションの設計です。GLM-5.3-Flashはスパースアテンションとリニアアテンションを組み合わせています。リニアアテンションが状態モデリングでローカルな文脈を処理し、軽量なインデクサーが本当に必要なグローバルな文脈を取り出します。効果は具体的で、フラッグシップのGLM-5.3と比べて、アテンション計算を3.0倍、KVキャッシュのサイズを4.4倍削減します。長いコンテキストは提供コストが跳ね上がりやすい部分なので、KVキャッシュを小さくすることが、1Mトークンのウィンドウをデモ用機能で終わらせるか、手の届くものにするかの分かれ目になります。
第2の層は学習データで、30兆トークンのマルチモーダルコーパスです。後から視覚エンコーダーを付け足すのではなく、最初から画像と動画の理解を組み込んでいます。第3の層は、動かすハードウェアと一体で全体を設計することです。
比較として、GLM-5.3-Flashは、総サイズを同程度に保ちながら、旧GLM-4.5シリーズに比べてアクティブパラメータ数(18B対32B)と層数(45対92)をどちらもほぼ半分にしています。トークンあたりのアクティブパラメータが少ないことはコストに最も直接効くレバーで、320Bのモデルが小型モデルのような価格になる理由です。
GLM-5.3-Flashのベンチマーク
「安い」の化けの皮が剥がれやすいのがベンチマークなので、このセクションは2回読むことをおすすめします。Z.ai自身の比較では、GLM-5.3-Flashを、GLM-5.2、DeepSeek-V4-Vision-Exp、Claude Opus 4.8、GPT-5.6 Terra、Gemini 3.7 Flashと比べています。
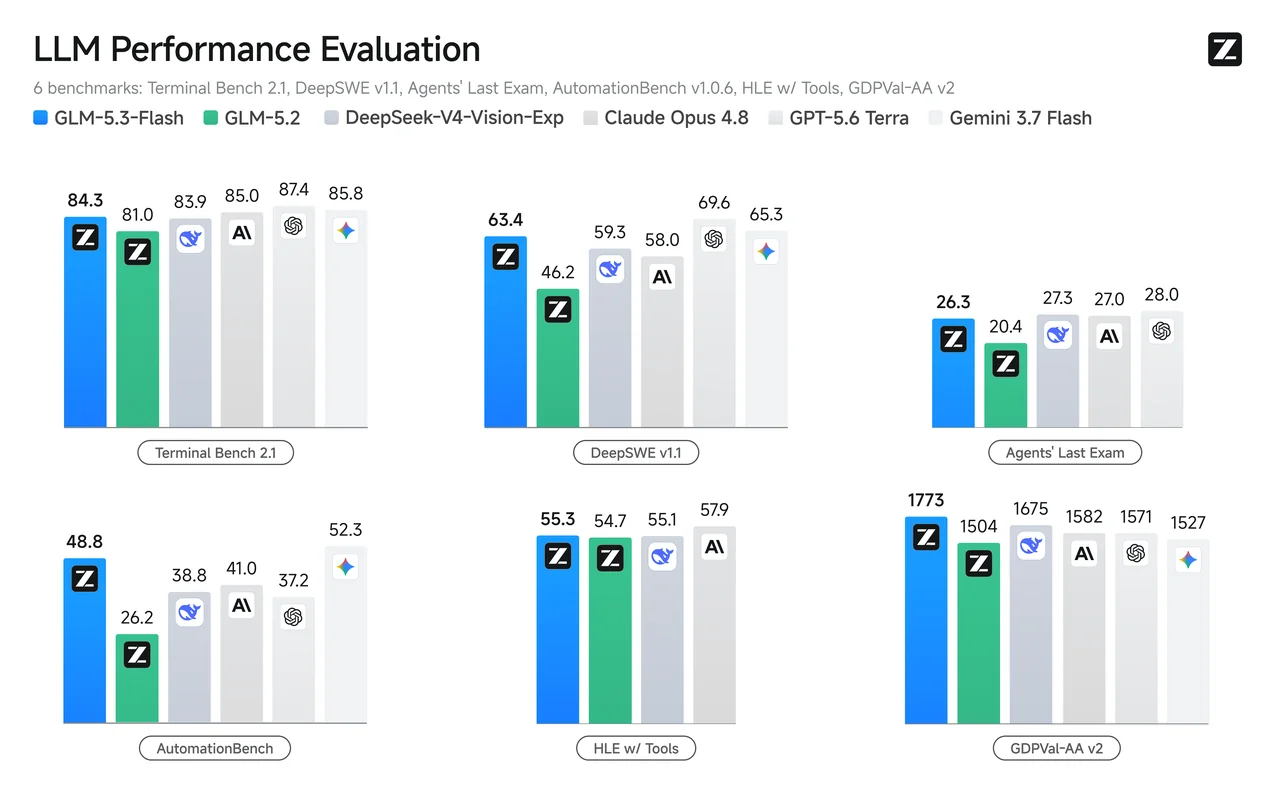
前世代からの伸びが本当の注目点です。
| ベンチマーク | GLM-5.3-Flash | GLM-5.2 | Opus 4.8 | GPT-5.6 Terra |
|---|---|---|---|---|
| DeepSWE v1.1(コーディング) | 63.4 | 46.2 | 58.0 | 69.6 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | 41.0 | 37.2 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 | 74.9 |
| Terminal Bench 2.1 | 84.3 | 81.0 | 85.0 | 87.4 |
| GDPval-AA v2 | 1773 | 1504 | 1582 | 1571 |
正直に読むと、2つのことが同時に成り立ちます。GLM-5.3-FlashはGLM-5.2をあらゆる項目で上回り、しばしば大差をつけています(AutomationBenchではほぼ2倍)。いくつかのエージェント系タスクではClaude Opus 4.8も上回ります。一方で、純粋なコーディングではGPT-5.6 Terraのようなトップのクローズドなフロンティアモデルにまだ及びません。Z.ai自身のCode Benchの最大エフォート設定では、Opus 4.8の29.5に対して29.0で、「Opus 4.8にほぼ並ぶ」という表現は誇張ではなく妥当です。価格が10分の1のモデルが前世代のフラッグシップに並ぶこと自体が、このモデルの狙いです。
マルチモーダル面では結果はまちまちです。チャートや文書の推論は高スコア(CharXivで89.4、Chartographyで78.0)ですが、MVbenchやMMVUといった純粋な動画ベンチマークではGemini 3.7 Flashに及びません。文書やインターフェースの理解が用途なら心強い結果ですが、動画分析が中心なら、まずGeminiと比較してテストしてください。
GLM-5.3-Flashの料金
Z.aiの料金ドキュメントから、料金表をそのまま紹介します。価格は100万トークンあたりです。
| モデル | 入力 | キャッシュ入力 | 出力 | 備考 |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075(定価$0.15) | $0.015 | $0.25(定価$0.50) | 2026年9月9日までローンチ50%オフ |
| GLM-5.3(フラッグシップ) | $1.40 | $0.26 | $4.40 | コーディングとサイバー |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | 1Mコンテキスト |
| GLM-4.7-FlashX | $0.07 | $0.01 | $0.40 | テキスト |
| GLM-4.7-Flash | 無料 | 無料 | 無料 | テキスト、完全無料 |
驚かないよう、いくつか注意点を挙げます。入力$0.075はローンチ記念価格で、2026年9月9日の深夜(シンガポール時間)に終了し、その後は$0.15に戻ります。定価でも、有料のGLM-5シリーズモデルとしては群を抜いて安い価格です。キャッシュ入力はさらに約80%オフで、毎ターン同じシステムプロンプトを送り直すエージェント系の処理では大きく効きます。組み込みのウェブ検索は別料金で、1回あたり$0.01です。
サブスクリプションという選択肢もあります。GLM Coding Planは月額$18(Lite)、$80(Pro)、$168(Max)からで、Claude Code、Cline、OpenCode、Cursorなど20以上のツールで使え、GLM-5.3-Flashにはフラッグシップの3倍のクォータが付きます。オフピーク時間(週末すべてを含む)は半分のクレジットレートで課金されます。
API側を具体的にするため、簡単な計算ツールを用意しました。1日のトークン量を入力すると、フラッグシップと比べた月額が分かります。
GLM-5.3-Flash対フラッグシップのGLM-5.3(と無料プラン)
名前がややこしいので、どれを選ぶべきかをはっきり書きます。
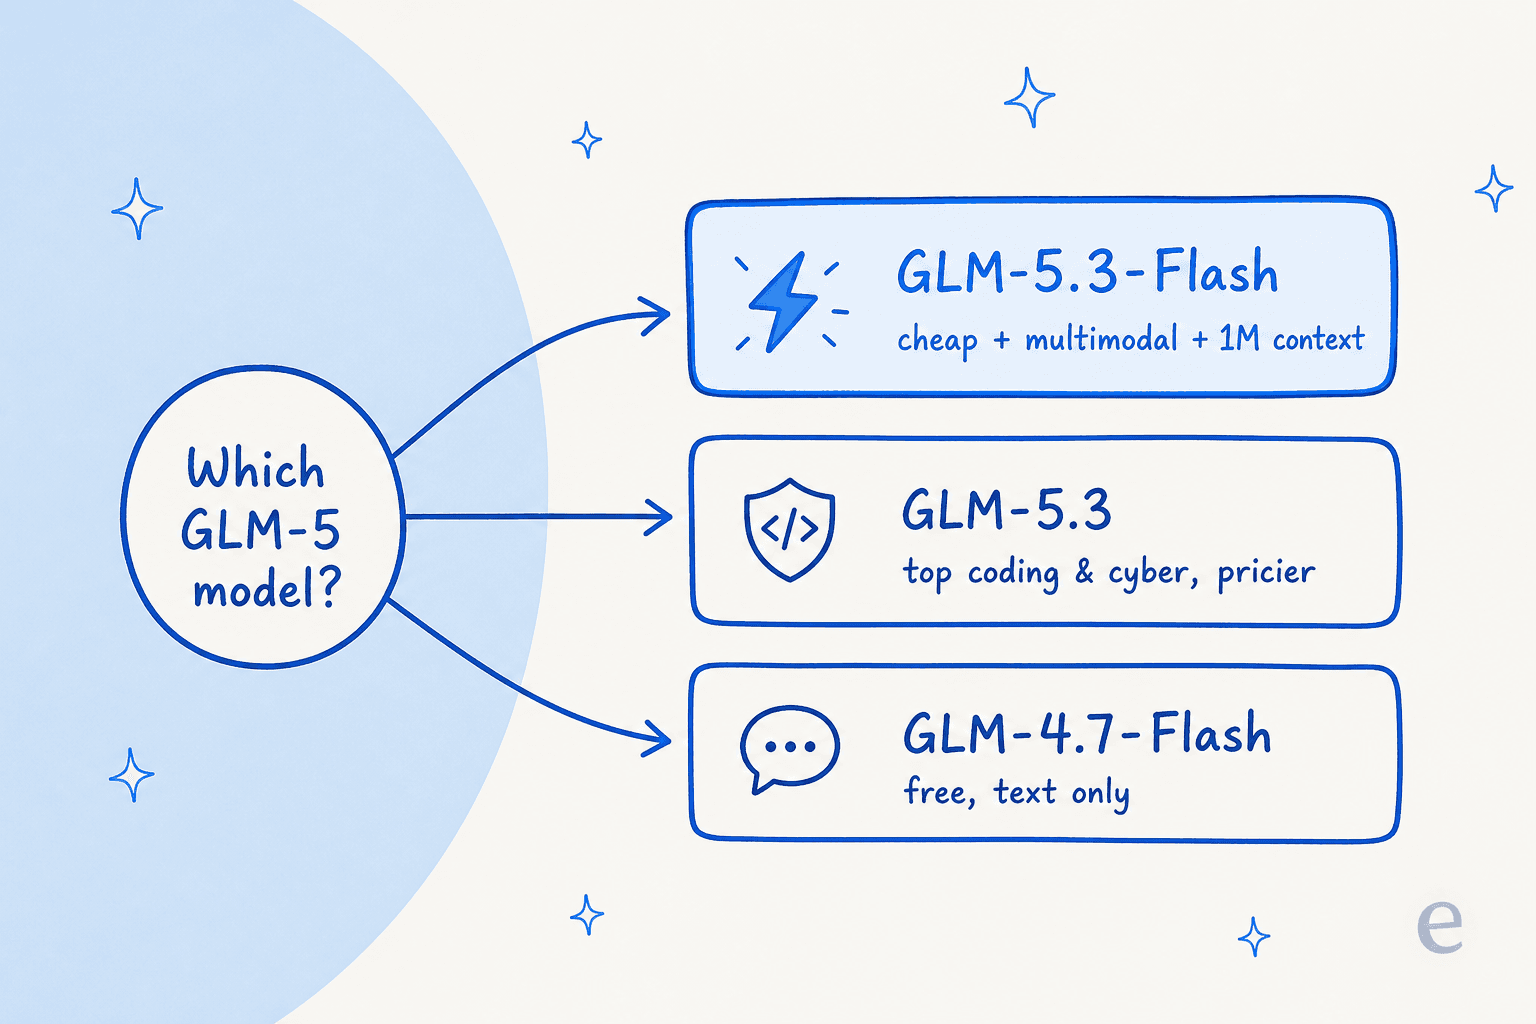
- GLM-5.3-Flashは、まず選ぶべきモデルです。安く、マルチモーダルで、1Mコンテキスト、サードパーティのホストでは高スループットです。大量処理、ビジョンや文書のタスク、トークン単価が決め手になる用途に最適です。
- GLM-5.3(フラッグシップ)は、コーディングとサイバーセキュリティ向けに作られた、まったく別のテキスト専用モデルです。CyberGymでクラス最高で、Z.aiのセキュリティ調査では、269のプロジェクトで2,436件の実在する脆弱性を指摘し、そのなかには数十年見過ごされていたものもありました。難しいSWE-bench系の作業やセキュリティレビューなら、プレミアムを払う価値があります。
- GLM-4.7-FlashとGLM-4.6V-Flashは完全無料(それぞれテキストとビジョン)ですが、古く性能も劣ります。試作には十分ですが、本番品質には向きません。
よく出る注意点がひとつあります。速度は動かす場所によって変わります。Z.ai自身のAPIではGLM-5.3-Flashは遅く(約49トークン/秒)、コミュニティの声も辛辣でした。サードパーティのホストでは話が別で、DatabricksはArtificial Analysisで272.9トークン/秒を記録しています。スループットが重要なら、プロバイダーは慎重に選んでください。
みんなの声
コミュニティの反応は大きく、価格への驚きと、公式提供元の速度への不満の2点に集まっています。
コスト面では、今や並び立つ他の低価格オープンウェイトモデル、たとえばQwenやKimi K2.5との比較がよく出ます。広く共有されたRedditのスレッドから引用します。
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

セキュリティ研究者は、いち早く実際のテストを行った人たちです。ある人は、コストと発見数の具体的な数字を投稿しており、雰囲気より信頼できる種類の具体的な結果です。
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
新しいビジョン機能については、独立したテスターが十分な数のサンプルで試しています。
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
正直な反対意見は速度です。r/opencodeのスレッドは、公式のエンドポイントを「one of the slowest models AA [has ever seen]」と呼んでおり、Z.ai自身の約49トークン/秒という数字と一致します。これは本当の制約ですが、ウェイトの性質ではなくプロバイダー固有のものです。
生のモデルが終わり、チームメイトが始まるところ
「安いフロンティアモデル」のローンチではどれも触れられない部分ですが、3年以上、本番のサポートキューにAIを投入してきて痛い思いをして学んだのは、モデルはソリューションではない、ということです。
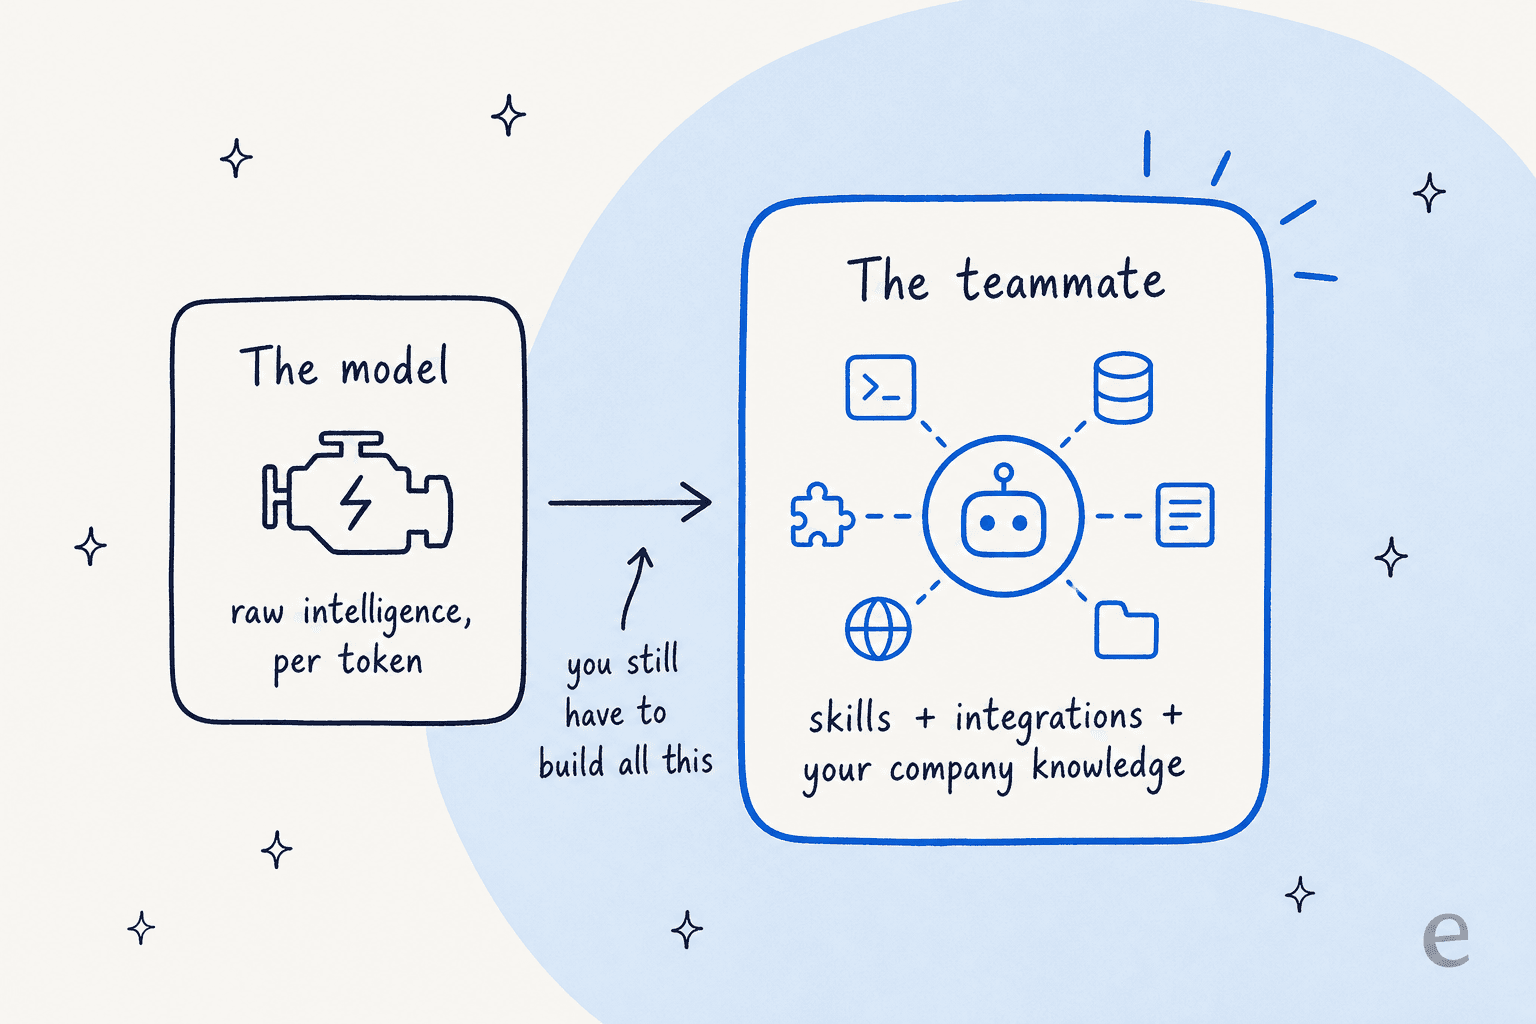
GLM-5.3-Flashは、トークンあたり安くて高性能な知能を提供します。返金ポリシーを知っていて、顧客のZendesk履歴を読み、RAGで適切なヘルプ記事を取り出し、ヘルプデスクで操作を実行し、実在の人と話す前にテストされている、というシステムは提供しません。そのどれもが一つのプロジェクトです。私たちはこのギャップを軸に製品全体を作り、そこで身についた最も大切な習慣はシンプルです。自社の過去履歴でシミュレーションするまで、ライブのチケットでモデルを信用しないこと。自信ありげに聞こえるのに実は間違っている回答は、遅い回答よりコストがかかります。
自分のスタックに組み込む生の知能がほしい開発者にとって、GLM-5.3-Flashは本当に優れた低価格の選択肢で、私も喜んで使います。成果だけがほしいサポートやコンテンツのチームにとっては、モデルは簡単な部分で、最後の一歩こそが作業です。そこでAIエージェントプラットフォームの出番になります。カスタマーサポート自動化のためのAIを評価するときに、生のモデルではなく完成したエージェント同士を比べるよう勧めているのも、同じ理由です。
eeselを試す
GLM-5.3-Flashが象徴するもの(フロンティア級の回答を、フロンティア級の請求なしで)が気に入っていて、それをAPIの裏に置いておくのではなく実際に仕事をさせたいなら、それがeeselです。AIのチームメイトを採用し、アプリに接続すれば、初日から働き始めます。Zendesk、Freshdesk、Gorgiasの既存キューに加わるAIヘルプデスクのチームメイトと、調査済みで公開可能な記事を仕上げるAIブログライターがいます。
生のモデルとの違いは、すでに終わっている配線です。ナレッジベースと過去のチケットを読み込み、役割に合った連携とスキルが付属し、そして私が最も重視する点として、ライブのチケットに1件も答える前に、過去の数千件のチケットでシミュレーションできます。生のAPIが渡してくれない安全網とともに、モデルの知能を手に入れられます。無料で試せます。営業電話は不要です。
よくある質問
GLM-5.3-Flashとは何ですか?
GLM-5.3-Flashは、Z.aiのGLM-5シリーズで初めてのネイティブマルチモーダルモデルです。総パラメータ320B、アクティブパラメータ18Bのエキスパート混合モデルで、1Mトークンのコンテキストウィンドウを備え、HuggingFaceでオープンウェイトとして公開されています。Z.aiは、GLM-5.2クラスの知能を約10分の1の価格で提供するモデルと位置づけています。
GLM-5.3-Flashの料金はいくらですか?
Z.aiの料金ドキュメントによると、GLM-5.3-FlashのAPI料金は2026年9月9日までのローンチキャンペーン価格で、入力100万トークンあたり$0.075、出力100万トークンあたり$0.25です。その後は定価の$0.15/$0.50になります。月額$18からのGLM Coding Planにも含まれています。サポート業務向けにモデルの費用を比較している場合は、サポートチケット向けAIモデルのガイドで計算方法を紹介しています。
GLM-5.3-Flashはオープンソースですか?
ウェイトはHuggingFaceで公開されており、SGLang、vLLM、TokenSpeedでセルフホストできるため、オープンウェイトのリリースです。商用利用の前に、ライセンスファイルで正確な条件を確認してください。オープンウェイトを重視する場合は、周辺ツールをまとめたオープンソースのチャットボットプラットフォームの一覧もご覧ください。
GLM-5.3-FlashとGLM-5.3の違いは何ですか?
これは別のモデルです。GLM-5.3-Flashは、低価格でマルチモーダル、高スループットの兄弟モデル(画像・動画入力、1Mコンテキスト)です。フラッグシップのGLM-5.3は、コーディングとサイバーセキュリティに強いテキスト専用モデルで、価格は100万トークンあたり$1.40/$4.40です。コストとビジョンならFlash、最も難しいコーディング作業ならフラッグシップを選んでください。