

Qwen 3.8 Flash Nextは優れたおもちゃですが、本番環境の依存先としては不安があります。これはAlibabaによるQwen4アーキテクチャのオープンウェイトのプレビューで、Qwen自身が意図的に学習を抑えたと説明しており、APIの提供元は1社のみ、しかも出力が冗長で請求額を膨らませがちです。価格と速度は気に入ったものの、もっと完成度の高いものが必要なら、次の候補を見てください。
- 完成したオープンウェイトの双子: GLM 5.3 Flash。コミュニティは本番利用に耐えると評価しており、プロモ価格は$0.075/$0.25です。
- 低予算の下限: DeepSeek V4 Flash(MITライセンス)、またはセルフホストのGranite 4.2 8B(ホスト型は$0.06/$0.25)。
- 同じファミリーにとどまる: Qwen 3.8 Max。安定したホスト型の上位モデルです。
- マネージドでマルチモーダル: 大手プロバイダーの信頼性が欲しいなら、Gemini 3.7 FlashまたはGPT-5.6 Luna。
そして、サポート向けに「安いAI」を探しているなら最も大事な点です。モデルは簡単な10%にすぎません。これらのどれかを実際にチケットを解決するものに仕上げるのが残りの90%で、それはモデル選びではなくプラットフォームの仕事です。
なぜQwen 3.8 Flash Nextから乗り換える人がいるのか
私はeeselでAIエージェントを作っているため、低価格モデル帯が数週間ごとに入れ替わるのを見ています。Qwen 3.8 Flash Nextは夏で最も話題になったリリースの1つでした。Hacker Newsのスレッドは698ポイントに達し、r/LocalLLaMAでは650件超のコメントがつく大型スレッドが立ちました。盛り上がりは本物です。スパースな活性化と、オフロード可能な51BのN-gramテーブルのおかげでRAM統合型のノートPCで125Bモデルが動かせます。
ただ、発表時のグラフの先まで読むと、乗り換えの理由がはっきり見えてきます。引き受けることになる内容の正直な姿は次のとおりです。
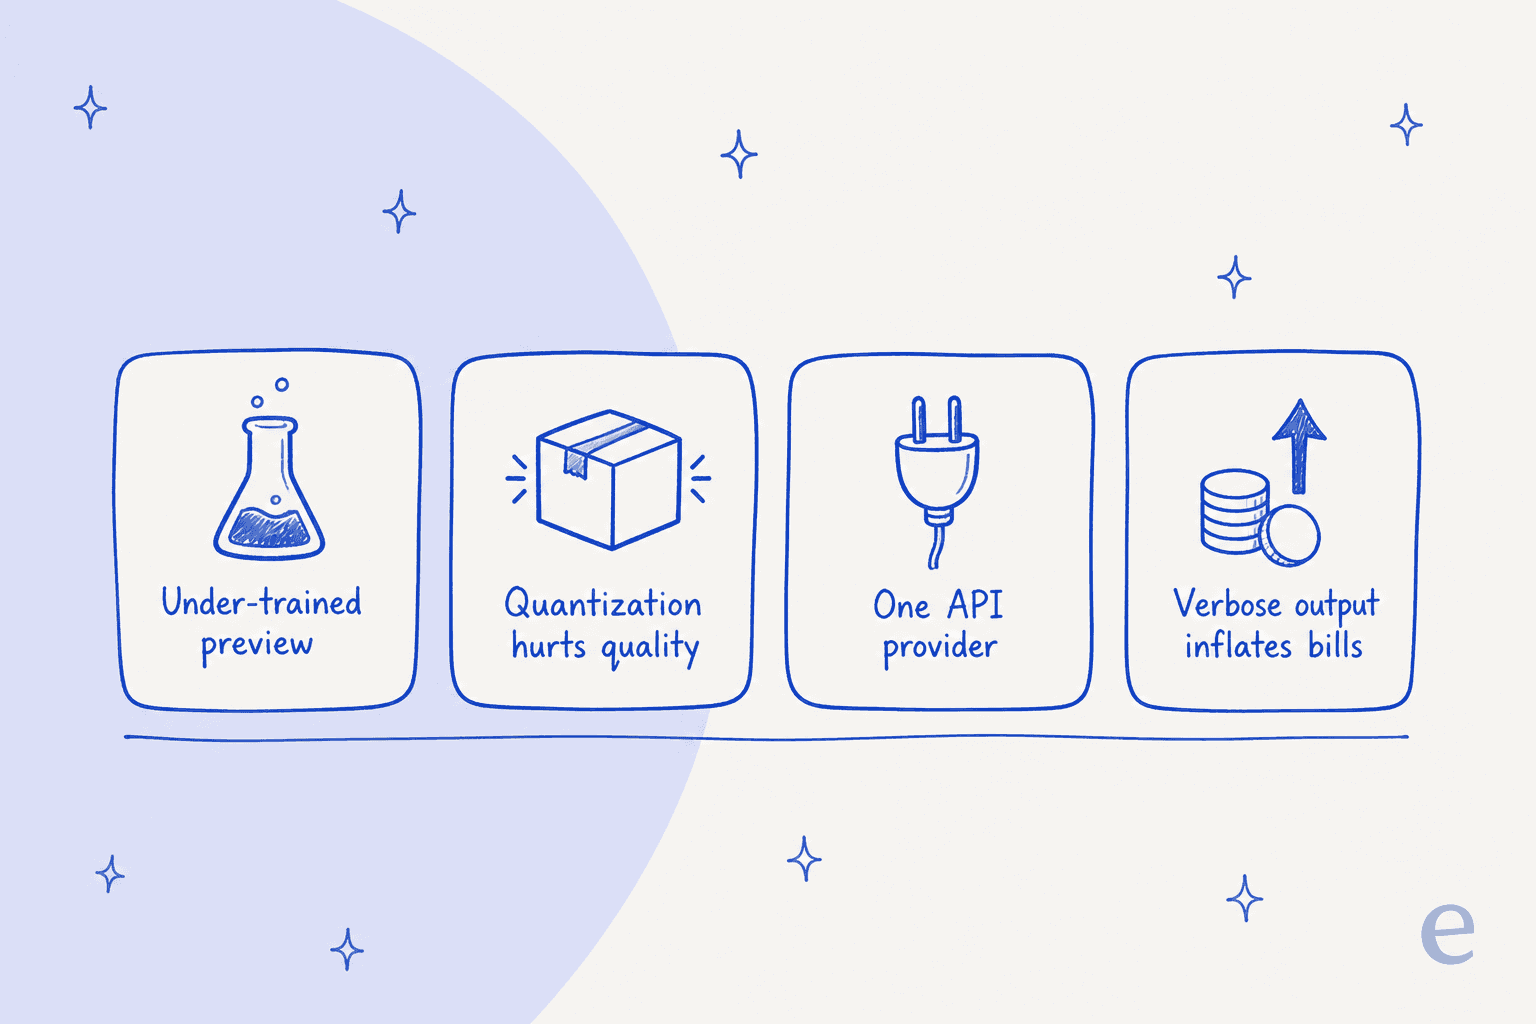
「Next」が本当は何を意味するのかについて最も明快だったのは、発表スレッドの声でした。
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

次に量子化の代償があります。Simon WillisonはDGX Sparkでいくつかの推論レベルで動かし、小さい密モデルのほうを好む結果になりました。収めるために必要な低ビット量子化が原因だと見ています。さらに、ホスト型のQwen3.8-Flash APIは現在提供元が1社、Alibaba Cloud Internationalのみなので、フェイルオーバーがありません。またArtificial Analysisの独立テストでは「very verbose」と指摘されており、Indexを完走するのに2億の出力トークンを使います。中央値は1.1億です。出力の多い請求額を、気づかないうちに押し上げます。
これで悪いモデルになるわけではありません。プレビューだということです。今四半期に頼れるものが欲しいなら、同じ層の人たちが向かっているのが次の8つです。
これらの代替を選んだ方法
候補は、上記のFlash Nextの4つの問題のうち少なくとも1つを解決するモデルに絞り、独立した数値がある場合はベンダーの表よりそちらを優先しました。具体的には、各候補が次の基準を満たす必要がありました。
- 実際に確認できる料金。 公開されたトークン単価か、無料のオープンウェイト。「営業に問い合わせ」は不可。
- 完成度の感じられるリリース、そうでない場合は正直な注記。
- 検証可能な独立スコア(主にArtificial AnalysisのIntelligence Index)がある場合はそれを使い、リリースブログの引用だけにしない。
- それぞれ異なる役割。 「同じだけど少し安い」というだけの2つはなく、どれも別の用途で勝つ。
ベンチマークをサポートエージェントと同一視することはしませんでした。これについては最後に触れます。
Qwen 3.8 Flash Nextの代替を一覧で
候補の全体像を1か所にまとめました。料金は100万トークンあたりのホスト型API料金(入力/出力)です。オープンウェイトのモデルは、ハードウェアがあればセルフホストも無料でできます。
| # | モデル | 向いている用途 | タイプ | コンテキスト | 料金 入力/出力(100万あたり) | ライセンス |
|---|---|---|---|---|---|---|
| 1 | GLM 5.3 Flash | 完成したオープンウェイトの双子 | オープン + ホスト型 | 1M | $0.075 / $0.25(プロモ) | オープンウェイト |
| 2 | DeepSeek V4 Flash | 低予算の下限、MIT | オープン + ホスト型 | 1M | $0.22 / $0.66(オフピーク) | MIT |
| 3 | Qwen 3.8 Max | Qwenファミリーにとどまる | オープン + ホスト型 | 1M | $2.00 / $6.00 | Qwenライセンス |
| 4 | Kimi K3 | 長期的なエージェント作業 | オープン + ホスト型 | 1M | $3.00 / $15.00 | オープンウェイト |
| 5 | Gemini 3.7 Flash | マネージドのマルチモーダル | ホスト型 | 約1M | $0.75 / $3.75(プロモ) | クローズド |
| 6 | GPT-5.6 Luna | クローズド環境での信頼性 | ホスト型 | 大 | $0.20 / $1.20 | クローズド |
| 7 | Granite 4.2 | エンタープライズ / オンプレミス | オープン + ホスト型 | 128K | $0.06 / $0.25(Replicate 8B) | Apache 2.0 |
| 8 | LongCat 2.0 | 大規模MIT MoEのワイルドカード | オープン + ホスト型 | 256K | $0.30 / $1.20(プロモ) | MIT |
実際の差は定価では見えにくいので、簡単な計算例を挙げます。月間のエージェント作業が入力5,000万、出力1,500万トークンだとします。GLM 5.3 Flashのプロモ価格なら約$7.50、ReplicateのGranite 4.2 8Bなら約$6.75、ホスト型のQwen3.8-Flash自体なら約$14.55、Gemini 3.7 Flashなら約$94、Kimi K3なら約$375です。同じ仕事で50倍の差です。推論モデルがコストをひっそり隠すのは、入力ではなく出力トークンです。
1. GLM 5.3 Flash、完成したオープンウェイトの双子
向いている人: Flash Nextの低価格オープンウェイト帯は気に入ったが、すでに完成している感触のものが欲しいチーム。
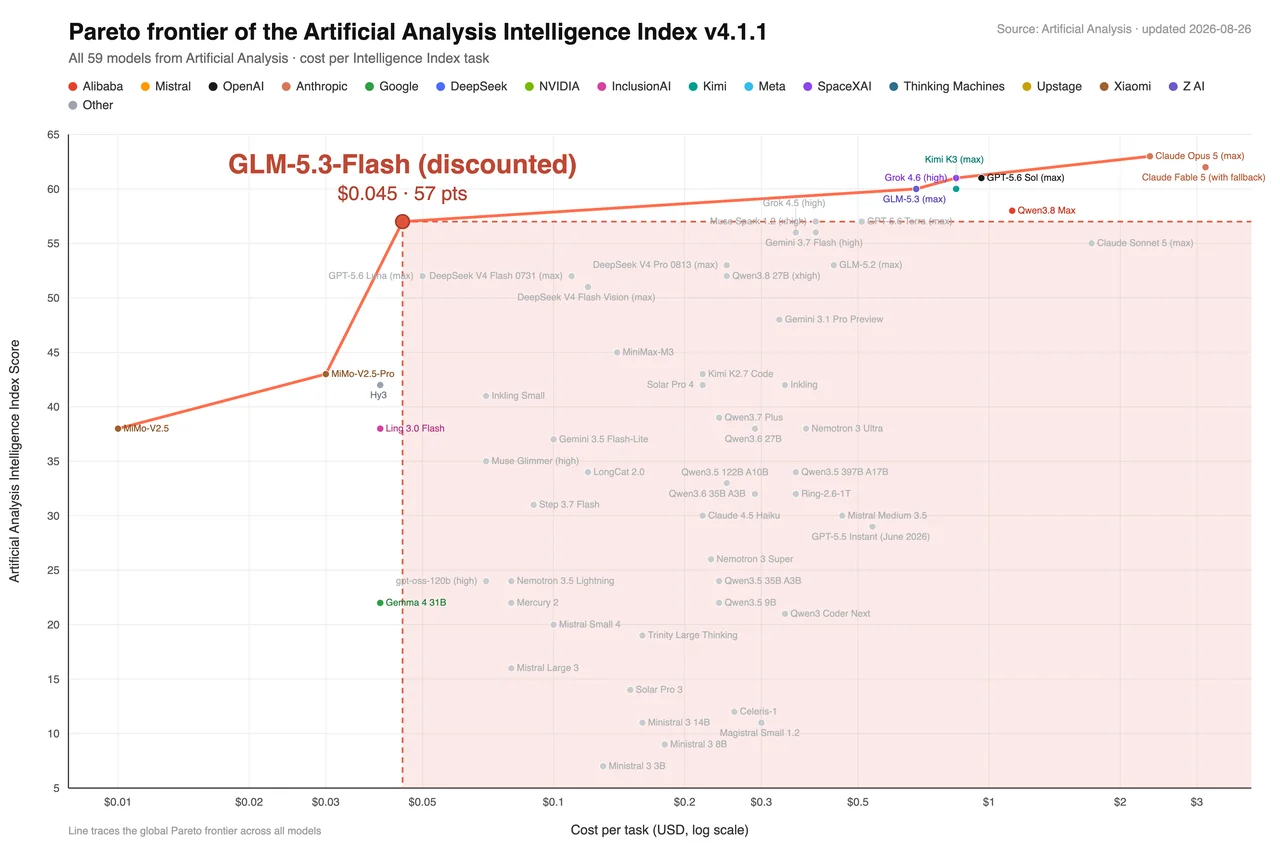
コミュニティがFlash Nextを試している人に繰り返し勧めるのがこれで、それには十分な理由があります。Z.ai(Zhipu)のGLM 5.3 Flashは同じ週の2026年8月26日に、初のネイティブマルチモーダルなGLM-5モデルとして登場しました。総パラメータ320Bのうち18Bがアクティブなエキスパート混合設計で、100万トークンのコンテキストを持ち、オープンウェイトはHugging Faceで公開されています。コードネーム「ox-alpha」の時期には、トークン量で一時OpenRouterの1位になりました。
重要なのは、完成したモデルらしいスコアを出していることです。Artificial AnalysisはIntelligence Indexを57、1タスクあたり約$0.045としており、初期のテスターは価値について率直でした。
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

長所: 低価格なのに本番グレード、真のマルチモーダル、オープンウェイト、IDE中心なら月$18/$80/$168の専用GLM Coding Planもあります。
短所: 思考専用なので、レイテンシを下げるために推論をオフにすることはできません。公式APIは遅く(約49トークン/秒)、ヘビーユーザーは速度のためにDatabricksなどのプロバイダー経由にします。
料金: プロモは入力$0.075 / 出力$0.25(100万あたり、定価$0.15/$0.50)、キャッシュ入力$0.015。プロモは2026年9月9日までです。
評価: 「プレビュー」という但し書きなしでFlash Nextの体験が欲しいなら、ここから始めてください。このリストで、同等条件のアップグレードに最も近いものです。
2. DeepSeek V4 Flash、低予算の下限
向いている人: 価格にこだわりつつ、寛容なライセンスも欲しい人。
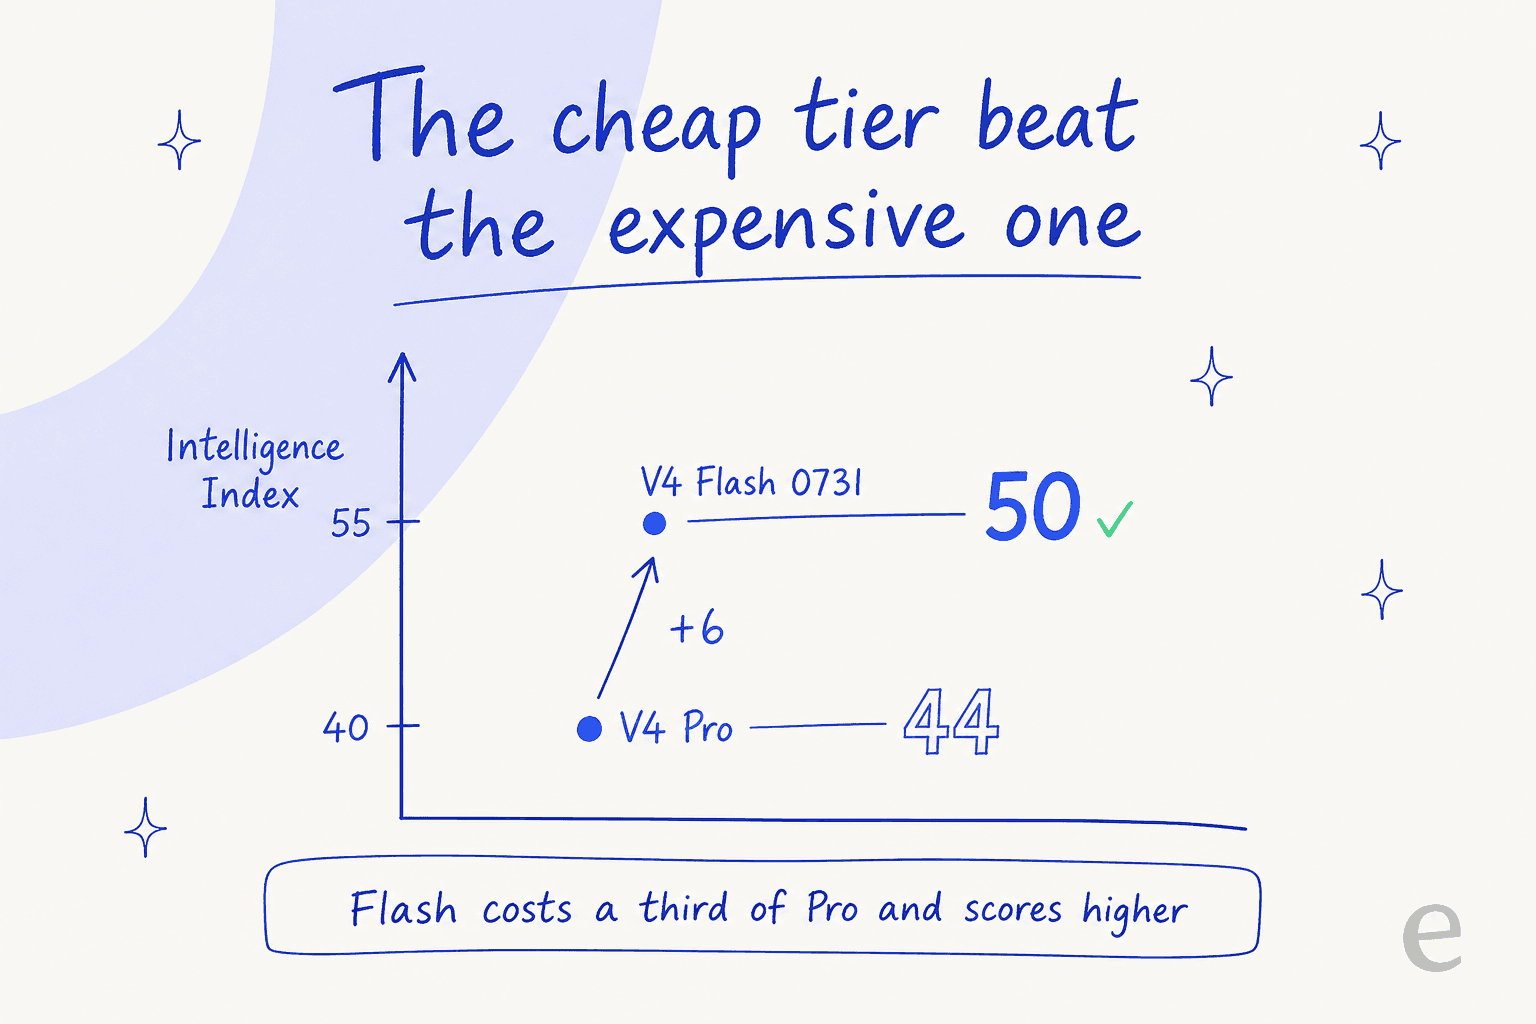
DeepSeek V4 Flashは総パラメータ284B、アクティブ13BのMoEで、コンテキストは1M、このクラスでは珍しく本物のMITオープンウェイト(約167GB、コミュニティ量子化は数十種)です。人気の理由は、独立テストで安いFlashティアが、高価なV4 Proを長期的なエージェントタスクで実際に上回ることです。リードエンジニアがこの点をうまくまとめています。
"DeepSeek V4 Flash is the most cost effective model we've tested... Pro is slower and smarter in one-shot reasoning problems, but less effective with tools and therefore less performant in long horizon agentic tasks."
正直な注意点が2つあります。DeepSeekは2026年8月に価格を改定し、ピーク/オフピークの割増を設けました。ピークはUTCの01:00-04:00と06:00-10:00なので、米国やEUのキューはほぼオフピーク料金ですが、中国の営業時間にスケジュールしたバッチは2倍かかります。そして、望ましい以上にハルシネーションが多く、あるユーザーははっきりこう言っています。
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
長所: ここにあるホスト型モデルで実質トークン単価が最も低く、MITウェイトで、ツール利用の評価も高い。
短所: 冗長(Indexの実行に約2.1億の出力トークン)、テキストのみ(画像入力の記載なし)、有料APIの規約は学習への利用について触れていないため、顧客データの差し替え先としては向きません。詳しい比較はDeepSeek vs Kimi K3の記事をご覧ください。
料金: オフピーク/ピーク、キャッシュミス入力$0.22/$0.44、出力$0.66/$1.32、キャッシュヒット入力は最安$0.007。
評価: 出力トークンを見積もり、顧客データを公式エンドポイントに置かないなら、コスパの王者です。
3. Qwen 3.8 Max、ファミリーにとどまる選択
向いている人: Qwenのエコシステムが好きだが、プレビューではなく完成したホスト型のフラッグシップが必要な人。
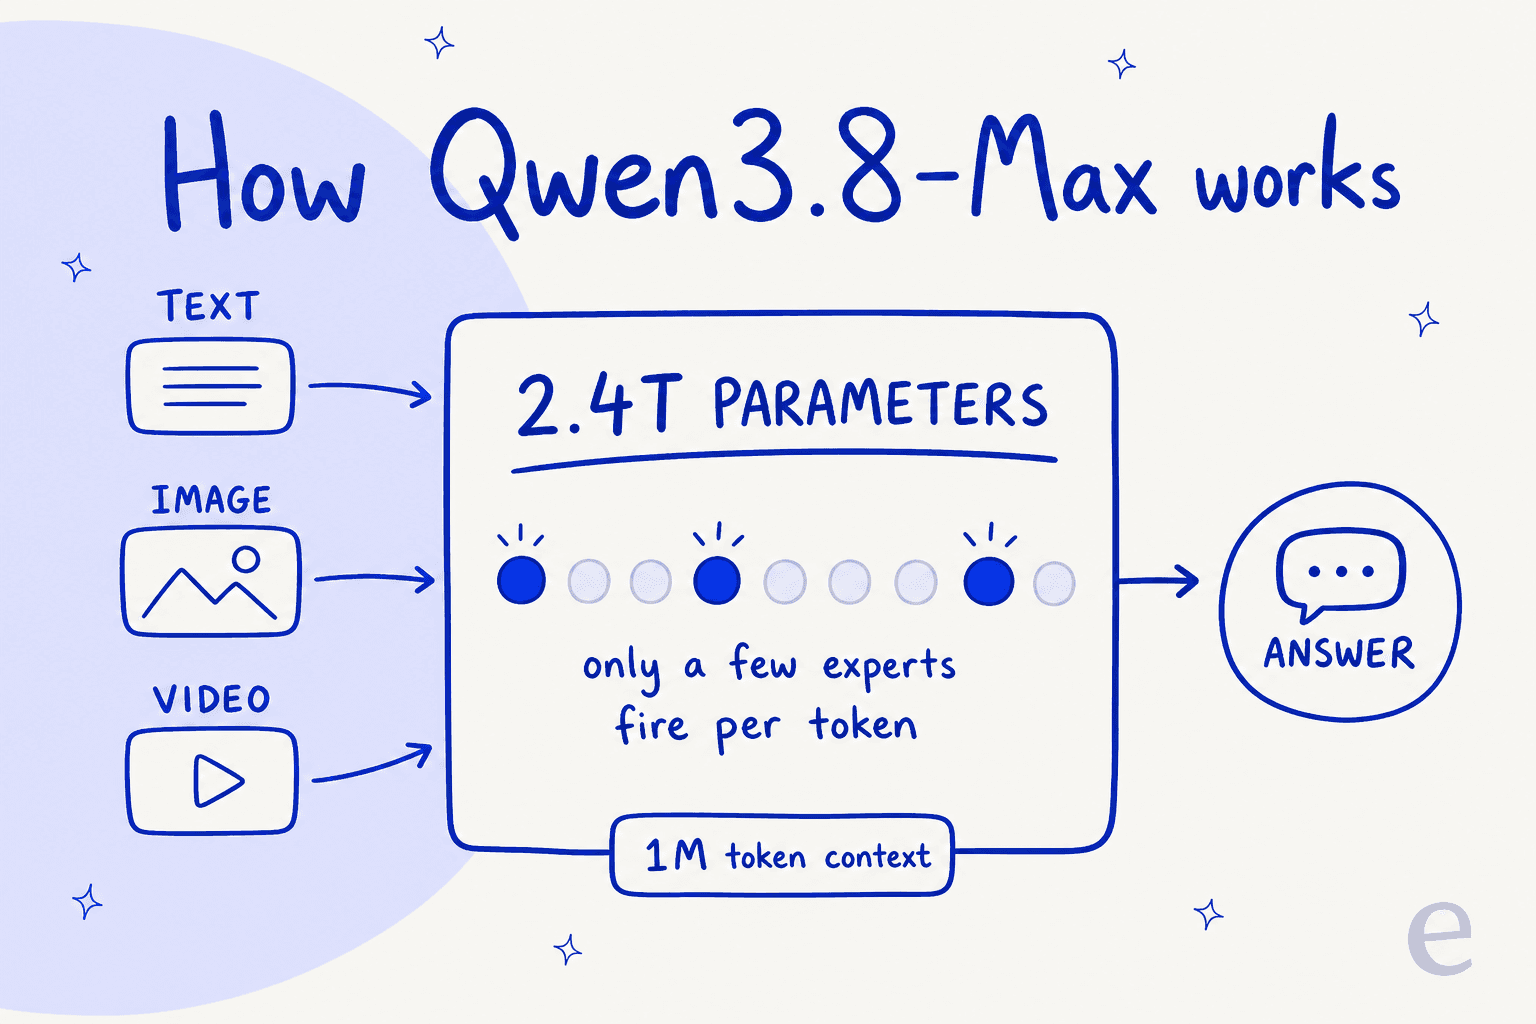
Flash Nextが研究プレビューなら、Qwen 3.8 Maxは出荷された製品です。2026年8月2日に一般提供となり、総パラメータ2.4T、アクティブ95BのMoEで、1Mコンテキスト、最大出力131,072、オープン版にはないホスト型の追加機能(視覚入力、非思考モード、内蔵ツール)を備えます。ウェイトも8月に公開されましたが、Apacheではなく独自のQwenライセンスです。
独立ランキングでも健闘しています。Artificial Analysisでは6位、Intelligence Indexは約58で1タスクあたり約$1.13、LMArenaではテキストでトップ5、視覚で2位です。単一の数字が欲しくても、やめておきましょう。自動化された総合スコアと人間の好みは少し違う方向を指しており、これ自体が1つのベンチマークを信用しすぎない良い教訓です。
長所: 安定、ホスト型、真のマルチモーダルで、Flash Nextですでに使っているツールの範囲にとどまれます。
短所: Flashティアより桁違いに高く、オープンウェイトはホスト版と機能が同等ではありません。
料金: 入力$2 / 出力$6(100万あたり)、暗黙的なキャッシュ読み取りは$0.25。
評価: Flashの最安価格より本番の安定性を重視するQwenファンに向く、波風の立たない選択です。迷うなら、アクセスガイドで入手経路を確認できます。
4. Kimi K3、長期的なエージェント向けの選択
向いている人: コストより能力が重要な、複雑で多段階のエージェント実行。
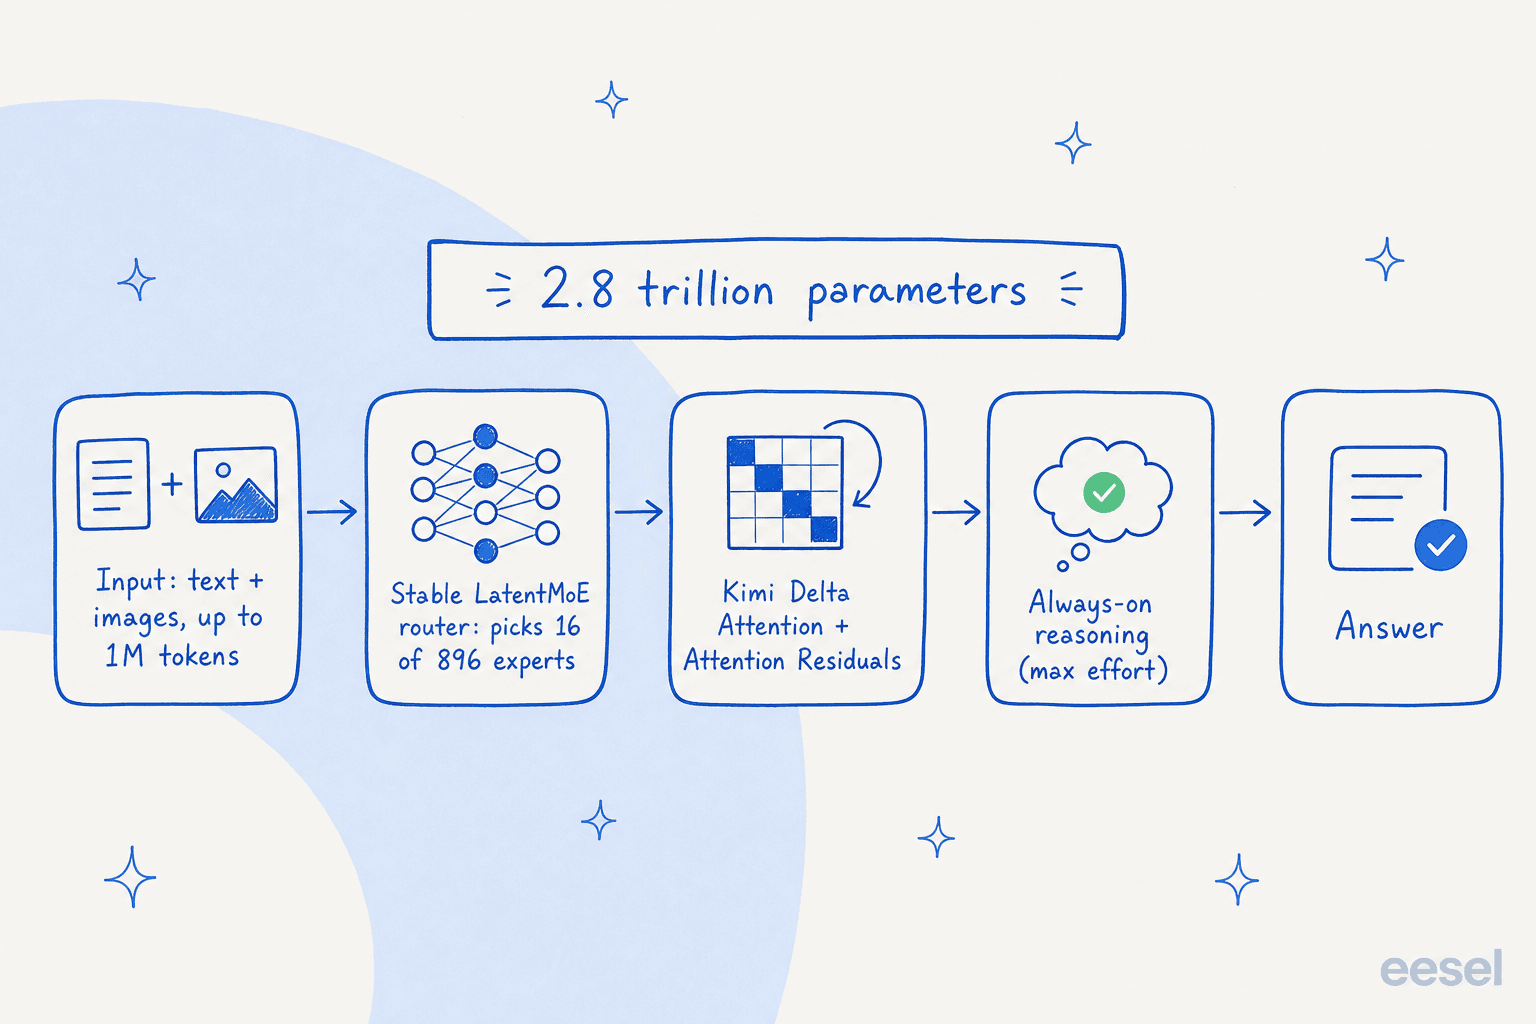
MoonshotのKimi K3はこのリストの重量級です。総パラメータ2.8T、アクティブ104B、1Mコンテキスト、ネイティブ視覚、そして2026年7月27日に予定どおり公開されたオープンウェイトを備えます。Artificial AnalysisのIntelligence Indexは57で総合4位、エージェントとコーディングの両面で本当に強いモデルです。
難点は価格です。K3は入力$3 / 出力$15(100万あたり)で、クローズドなフロンティアモデルと同じ帯、DeepSeek V4 Flashの出力単価の約50倍です。推論もオフにできないため、単純な呼び出しでも思考コストを払います。最低の努力レベルでもスコアはDeepSeekより低く、しかもタスクあたりのコストは高くなります。これはFlash Nextの低予算の代替ではなく、能力面の代替です。
長所: 最上位のエージェント性能、巨大なコンテキスト、オープンウェイト、ネイティブ視覚。
短所: フロンティア級の価格、常時有効の推論、視覚APIが公開画像URLを受け付けない(base64かファイルIDのみ)。
料金: 入力$3 / 出力$15(100万あたり)、キャッシュヒット入力$0.30。
評価: 請求額に見合うほど難しいタスクならK3を選んでください。日常の安く速い作業には不向きです。
5. Gemini 3.7 Flash、マネージドのマルチモーダル向け選択
向いている人: 大手プロバイダーの信頼性、強力なマルチモーダル入力が欲しく、セルフホストはしたくないチーム。
セルフホストの話全体が、時間のない趣味のように感じるなら、Gemini 3.7 Flashがマネージドの答えです。2026年8月13日に一般提供となり、Artificial Analysisが測定した中で最速の340トークン/秒(188モデル中1位)です。購入時に知っておくべき点は、選ぶ推論の努力レベルがコストと品質を大きく左右することです。lowではIndex 50.9で1タスク$0.16、highでは56.0に達しますが$0.40に跳ね上がります。デフォルトのmediumのままだと、たいてい払いすぎです。
2つの注意点があります。Googleは、旧FlashモデルをOCRや分類で最安の下限にしていたminimal思考レベルを廃止しました。そしてハルシネーション率は、精度が向上したにもかかわらず、3.6 Flashの55.6%から64.5%に悪化しています。まさに、出荷前に見つけたい類のものです。
長所: マネージドで信頼でき、同クラス最速のスループット、長いコンテキストとコンピュータ操作で強いスコア、そして現在3.6 Flashと同額のプロモ価格。
短所: クローズドウェイト、前世代よりも高いハルシネーション率、2027年1月に倍になる価格。
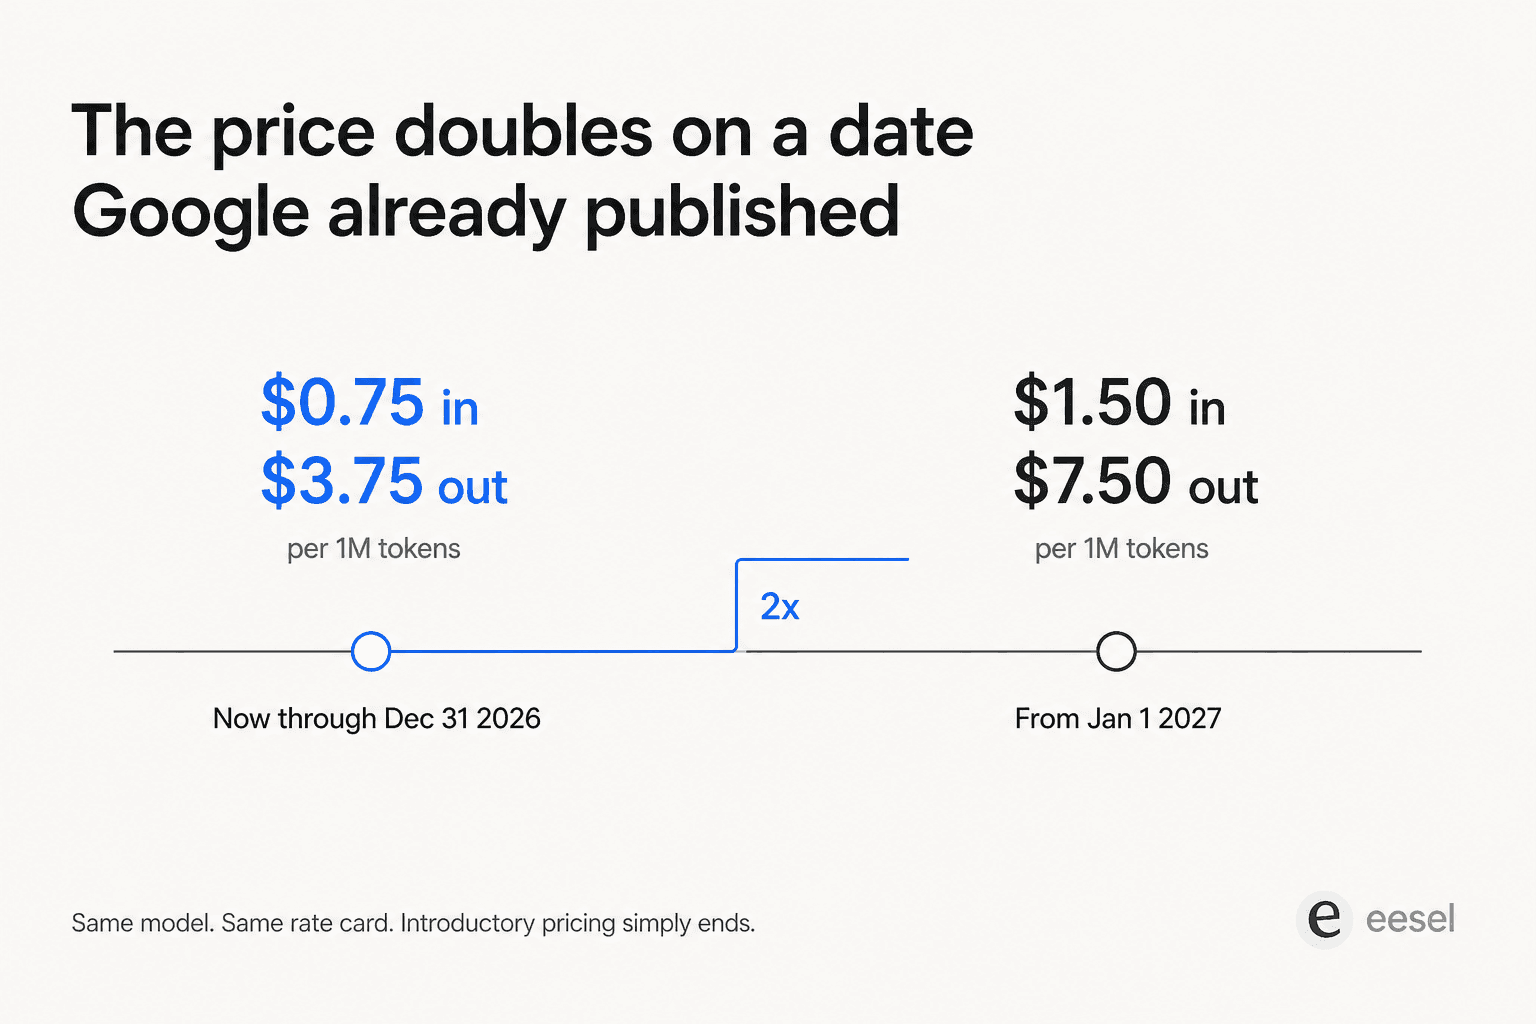
料金: 2026年12月31日まで導入価格で入力$0.75 / 出力$3.75(100万あたり)、その後は$1.50 / $7.50。
評価: GPUの面倒を見るよりプラットフォームに払いたいときの選択です。努力レベルのダイヤルをデフォルトのままにしないでください。
6. GPT-5.6 Luna、クローズドエコシステムの信頼性向け選択
向いている人: すでにOpenAIで標準化しており、スタックを離れずに安価なティアが欲しいチーム。
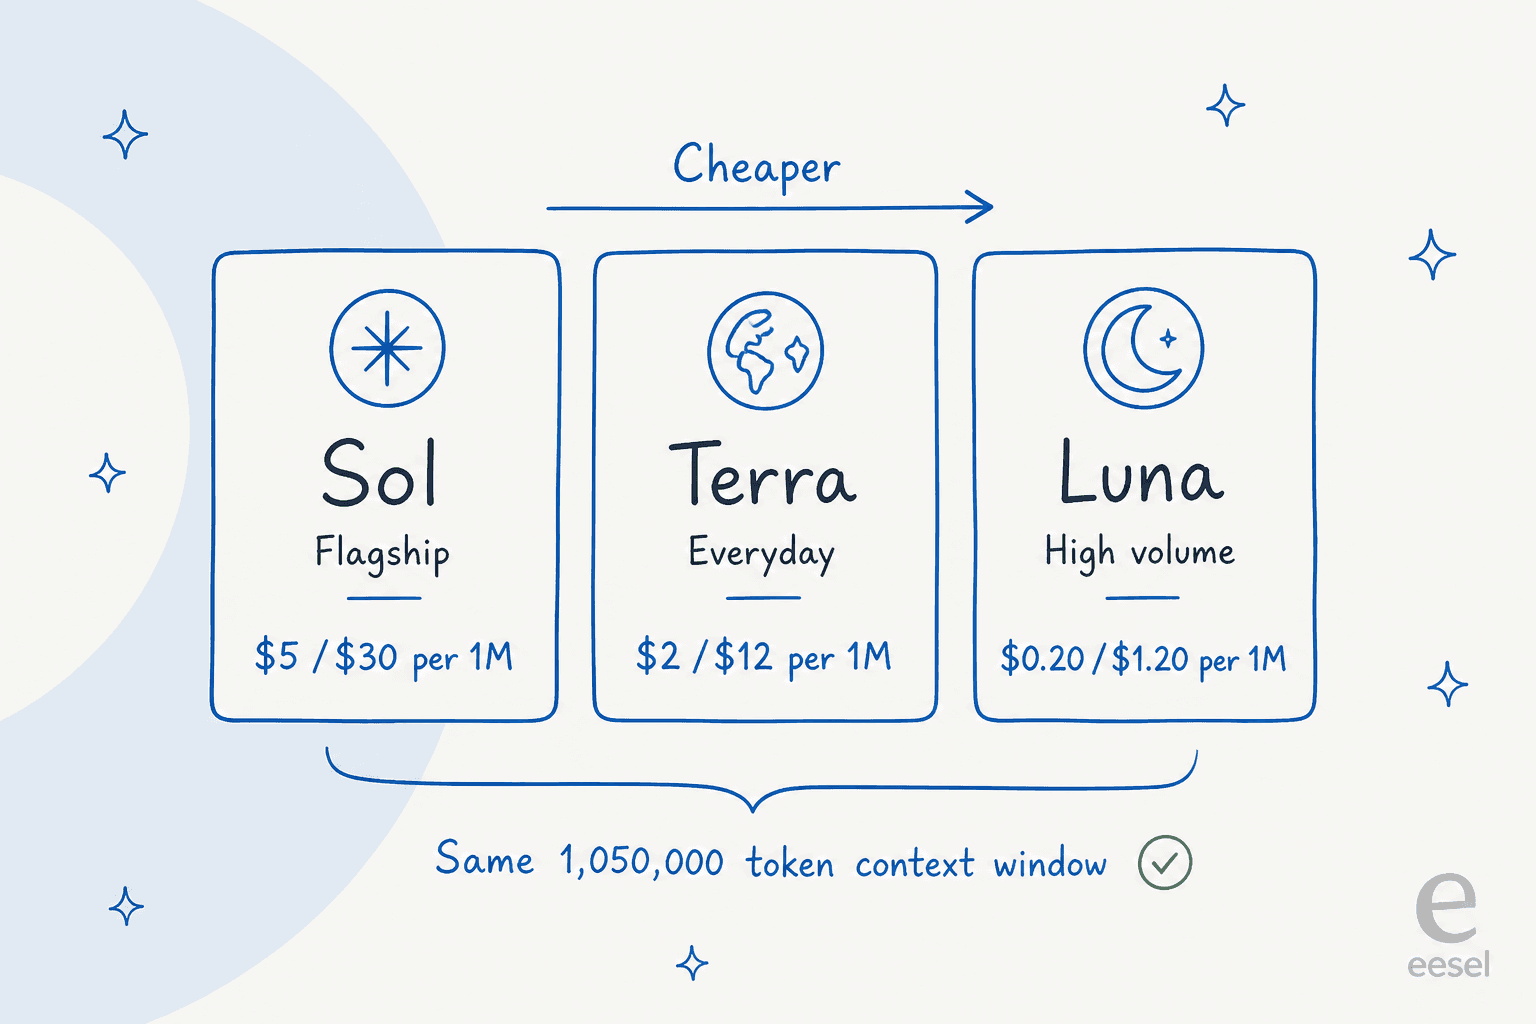
LunaはGPT-5.6ラインナップの低価格の段です(残りの2つはTerraとフラッグシップのSol)。入力$0.20 / 出力$1.20(100万あたり)で、中国系オープンウェイトモデルと価格面で競合しつつ、OpenAIのツール、SDK、信頼性が手に入ります。インフラがすでにOpenAI APIを前提としているチームにとって、省ける乗り換えコストは本物です。
トレードオフは、ここにあるクローズドモデル共通のものです。ウェイトなし、セルフホストなし、そしてOpenAIは短いコンテキストの枠を超えると料金が倍になる長文コンテキスト階層を設けています(Lunaは$0.40/$1.80)。AnthropicとGoogleはこの段差を設けていないので、自分のコンテキスト長がその線を超えるか確認する価値があります。
長所: 信頼できるプロバイダー、成熟したエコシステム、本当に安い入口のティア。
短所: クローズドウェイト、長文コンテキストの2倍の割増、価格で競合するモデルに比べて開放性が低い。
料金: 短いコンテキストで入力$0.20 / 出力$1.20(100万あたり)、長いコンテキストで$0.40 / $1.80、キャッシュ入力$0.02。
評価: すでにOpenAI中心で、オープンウェイトよりエコシステムを重視するなら、妥当な低価格のデフォルトです。
7. IBM Granite 4.2、エンタープライズ / オンプレミス向け選択
向いている人: 寛容なライセンス、汎用ハードウェア、根拠に基づくツール呼び出しが必要な企業。
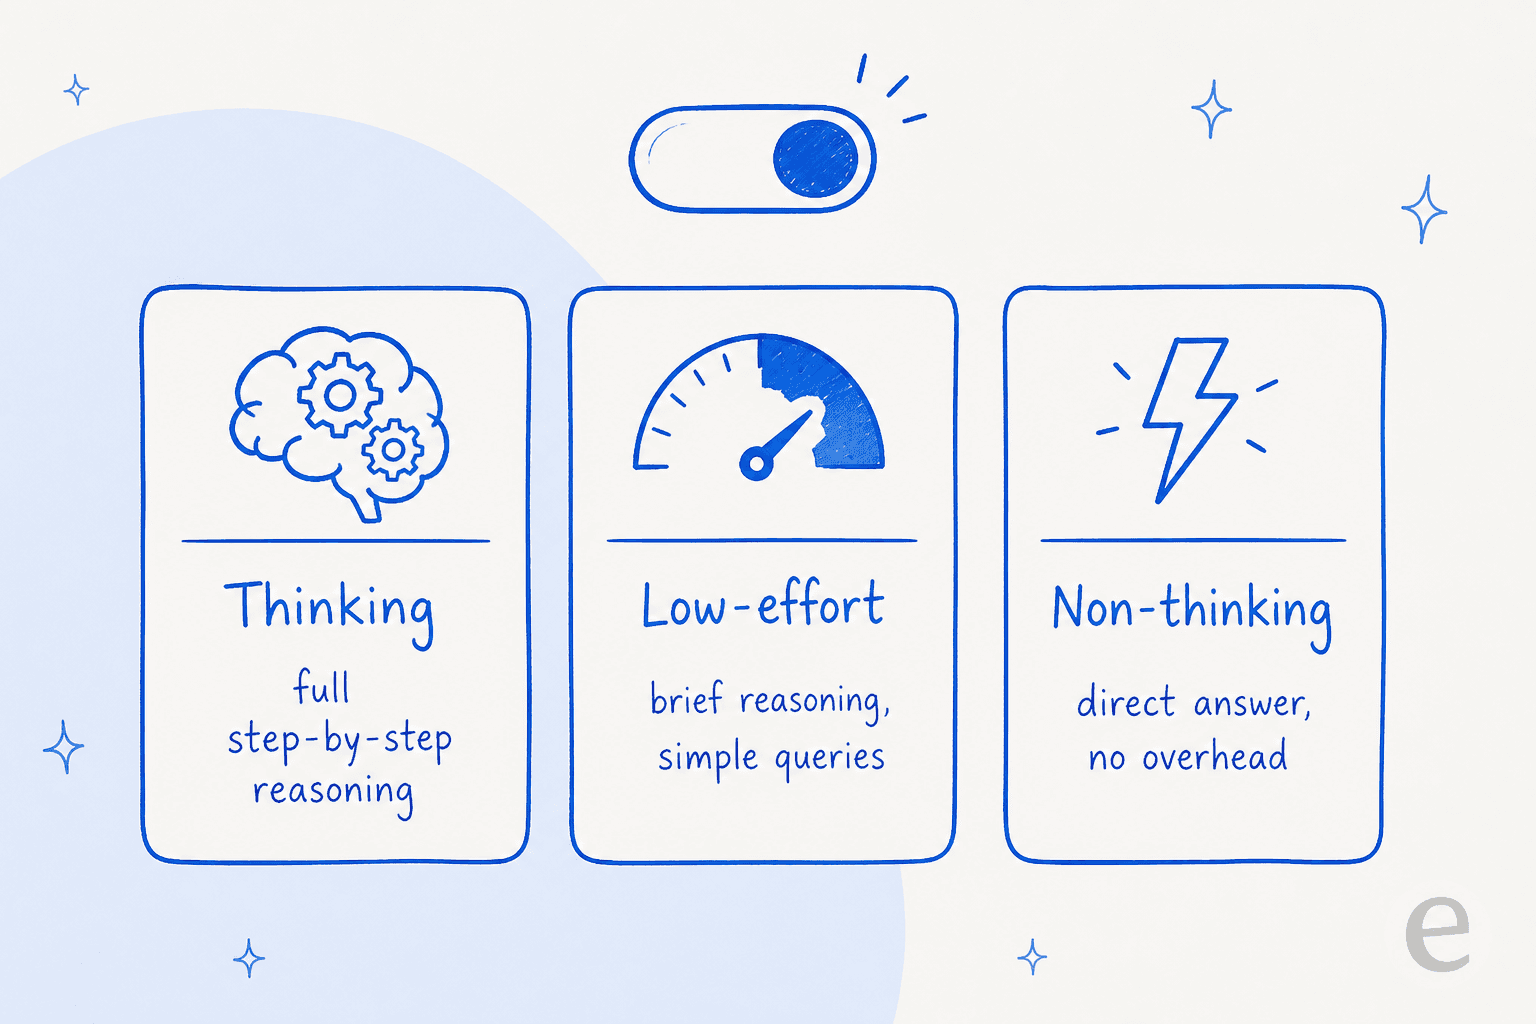
Granite 4.2は、法務やセキュリティのチームが実際に承認するモデルです。IBMは2026年8月25日に、Apache 2.0の密モデル3種(3B、8B、30Bのフラッグシップ)として出荷しました。128Kのコンテキストを持ち、Flash Nextと違って推論を切り替えられます。フル思考、低負荷、またはオフです。ベンチマークでの派手な勝利ではなく、根拠に基づく抽出とツール呼び出しにチューニングされており、テスターは実用性を評価しています。
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
何がそうでないかも冷静に見ておきましょう。コーディングの生のリーダーボードで首位ではなく、同じコミュニティもはっきり言っています。「Qwen still wins on raw capability, especially for coding.」また、8Bモデルの5.3GBのダウンロードが、KVキャッシュを読み込むと約27GBに膨らむというメモリの癖もあるので、GPUはそれに合わせて選んでください。
長所: 本物のApache 2.0(「ウェイトが利用可能」だけではない)、切り替え可能な推論、新しい学習データ、控えめなハードウェアでも高速。
短所: 生のコーディングではQwenに劣り、IBMのベンチマークは中国系の主要モデルではなく旧Graniteとの比較が中心で、読み込み時のメモリ膨張に驚く人もいます。
料金: セルフホストは無料(8Bは5.3GBのダウンロード)。確認できている最安のホスト型はReplicateの8Bで、入力$0.06 / 出力$0.25(100万あたり)。
評価: 企業にとって安全な選択です。ライセンスとオンプレミスでの制御が、最後の数ポイントのベンチマークより重要なら、Graniteは最強です。
8. LongCat 2.0、大規模MIT MoEのワイルドカード
向いている人: 非常に大きなMITライセンスのMoEが欲しく、ツール周りの粗さにも耐えられる冒険好きな人。
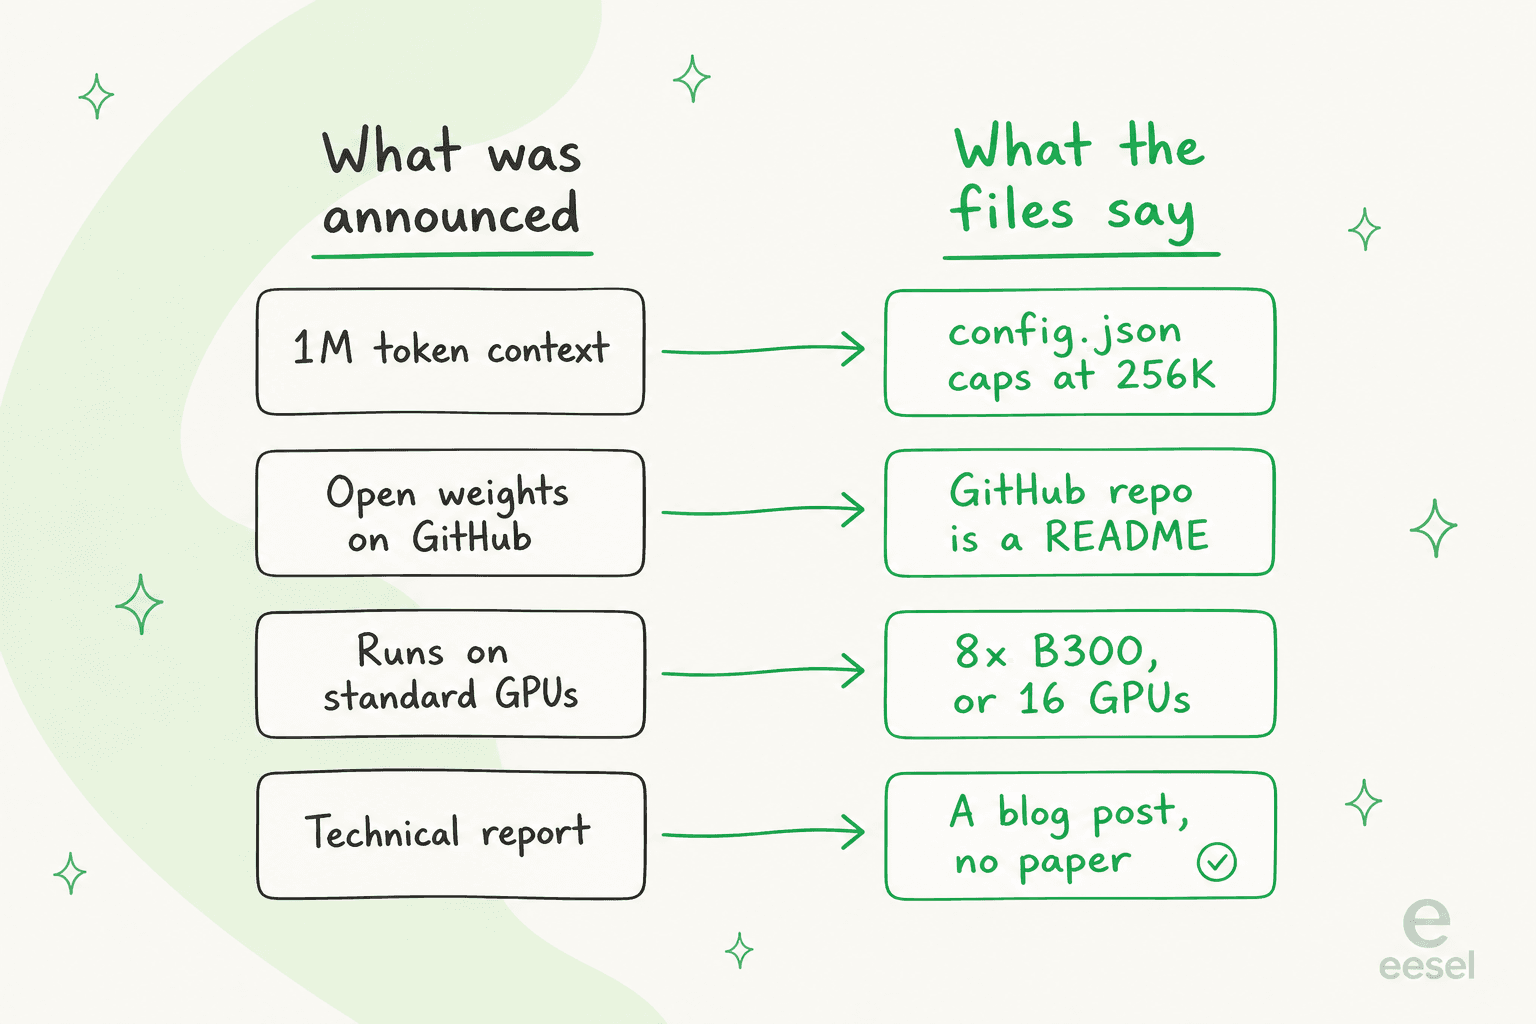
MeituanのLongCat 2.0はDeepSeekファミリーの構造上の親戚です。1.6TのMoEでトークンあたり約48Bがアクティブ、ごく普通のMITウェイトで、プロモ価格はこのリストの多くを下回ります。自己測定のSWE-bench Proが59.5でGPT-5.5をわずかに上回るなど、本当に高性能です。
しかし、ここにあるどれよりも注意書きが多く、そのすべてが確認可能です。宣伝されている「1Mコンテキスト」は学習上の主張で、出荷された設定では位置が256Kに制限されています。GitHubのリポジトリはREADMEのみで論文もなく、エンジンはSGLangだけ、OllamaやLM Studio向けのGGUFがないため、セルフホストには現実的に8x B300 GPUが必要です。中国本土以外での支払いはカードではなくAlipayかWeChat Payです。そしてサポート用途では、プラットフォームのFAQがデータ保持と学習への利用について何も述べておらず、価格ではなくこれが真の障害です。
長所: 実際に大規模で高性能、すっきりしたMITライセンス、積極的なプロモ価格。
短所: ツールが乏しい、実際のコンテキストは256K(1Mではない)、過酷なセルフホスト要件、扱いにくい支払い、データ取り扱いに関する約束がない。
料金: プロモは入力$0.30 / 出力$1.20(100万あたり、定価$0.75/$2.95)、コンテキスト長による段階料金なし。
評価: 研究者には魅力的なワイルドカードですが、ツールとデータ面の穴があるため、このリストで本番投入が最も難しいモデルです。
どの代替を選ぶべきか
Flash Nextから離れる決め手になった2つの点、「完成しているか」「自分で動かしたいか」に照らせば、候補はすぐ整理されます。
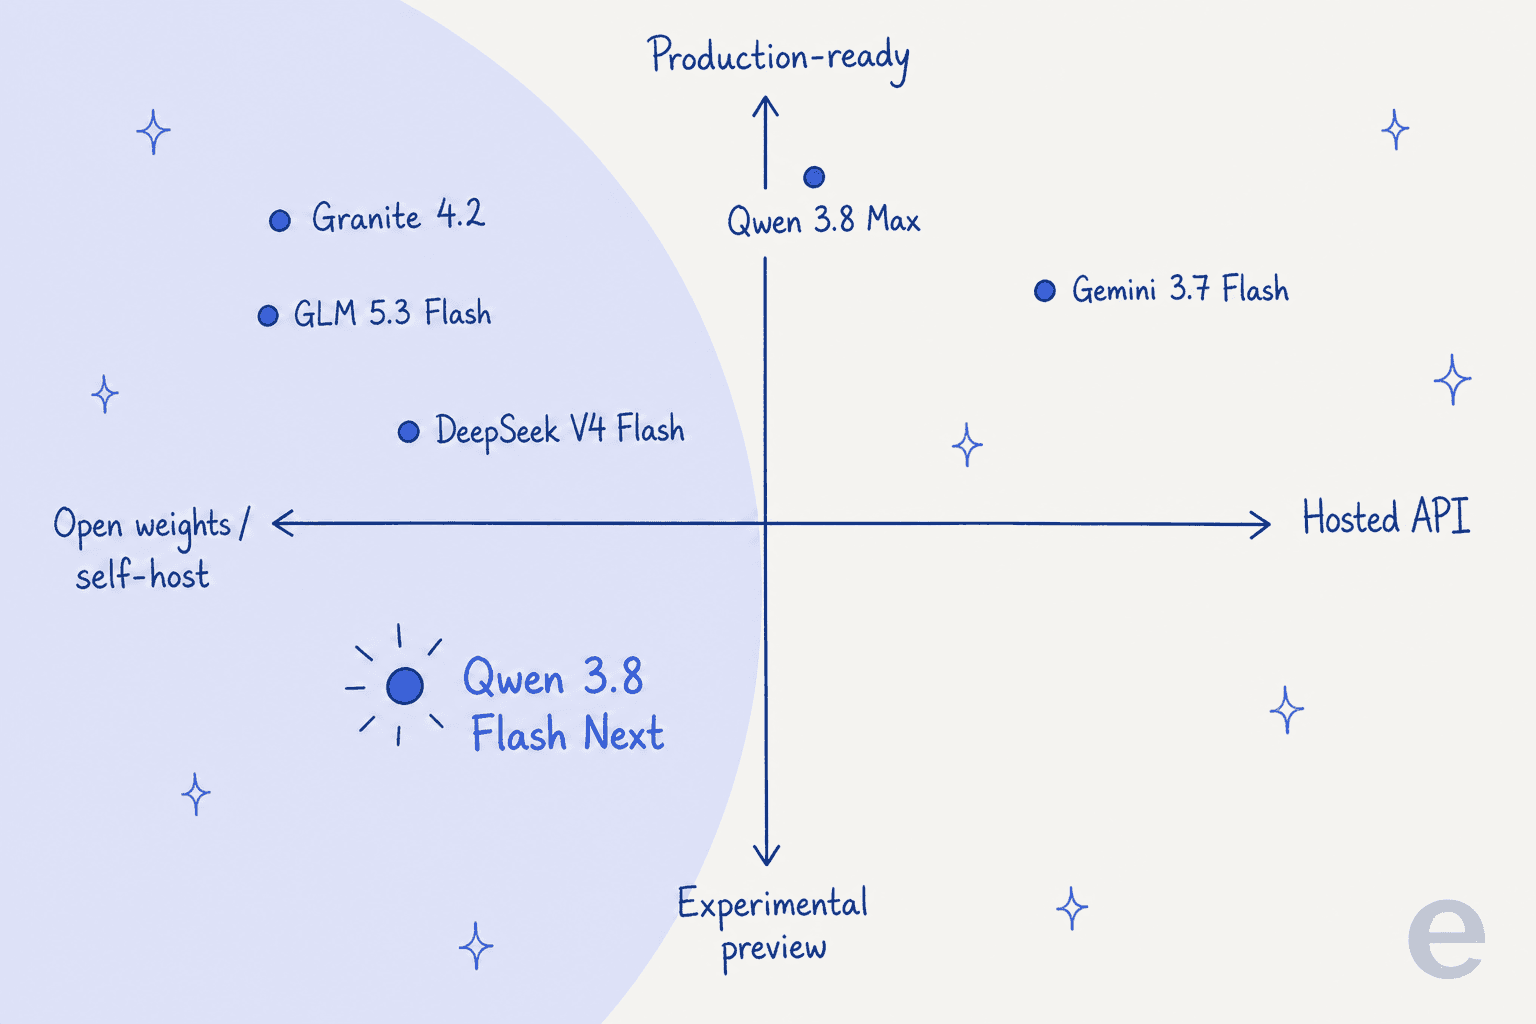
早見表:
- 同じものを、完成した形で欲しい? GLM 5.3 Flash。
- 実際の請求額を最安にしたい? DeepSeek V4 Flash、またはセルフホストのGranite 4.2。
- Qwenの世界にとどまりつつ安定が欲しい? Qwen 3.8 Max。
- GPUには触れたくない? Gemini 3.7 FlashまたはGPT-5.6 Luna。
- 企業向けライセンスとオンプレミスが必要? Granite 4.2。
これらすべての背後にあるパターン
こうした記事にたどり着いたチームに、私が何度も言っていることがあります。上のモデルはどれも部品です。生のモデルはトークンを受け取り、トークンを返します。返金ポリシーは知らず、顧客の注文履歴は読めず、ヘルプデスク内で返信を下書きすることもなく、自信満々の答えが正しいかどうかも分かりません。モデルはインフラであり、仕事をするのは従業員です。
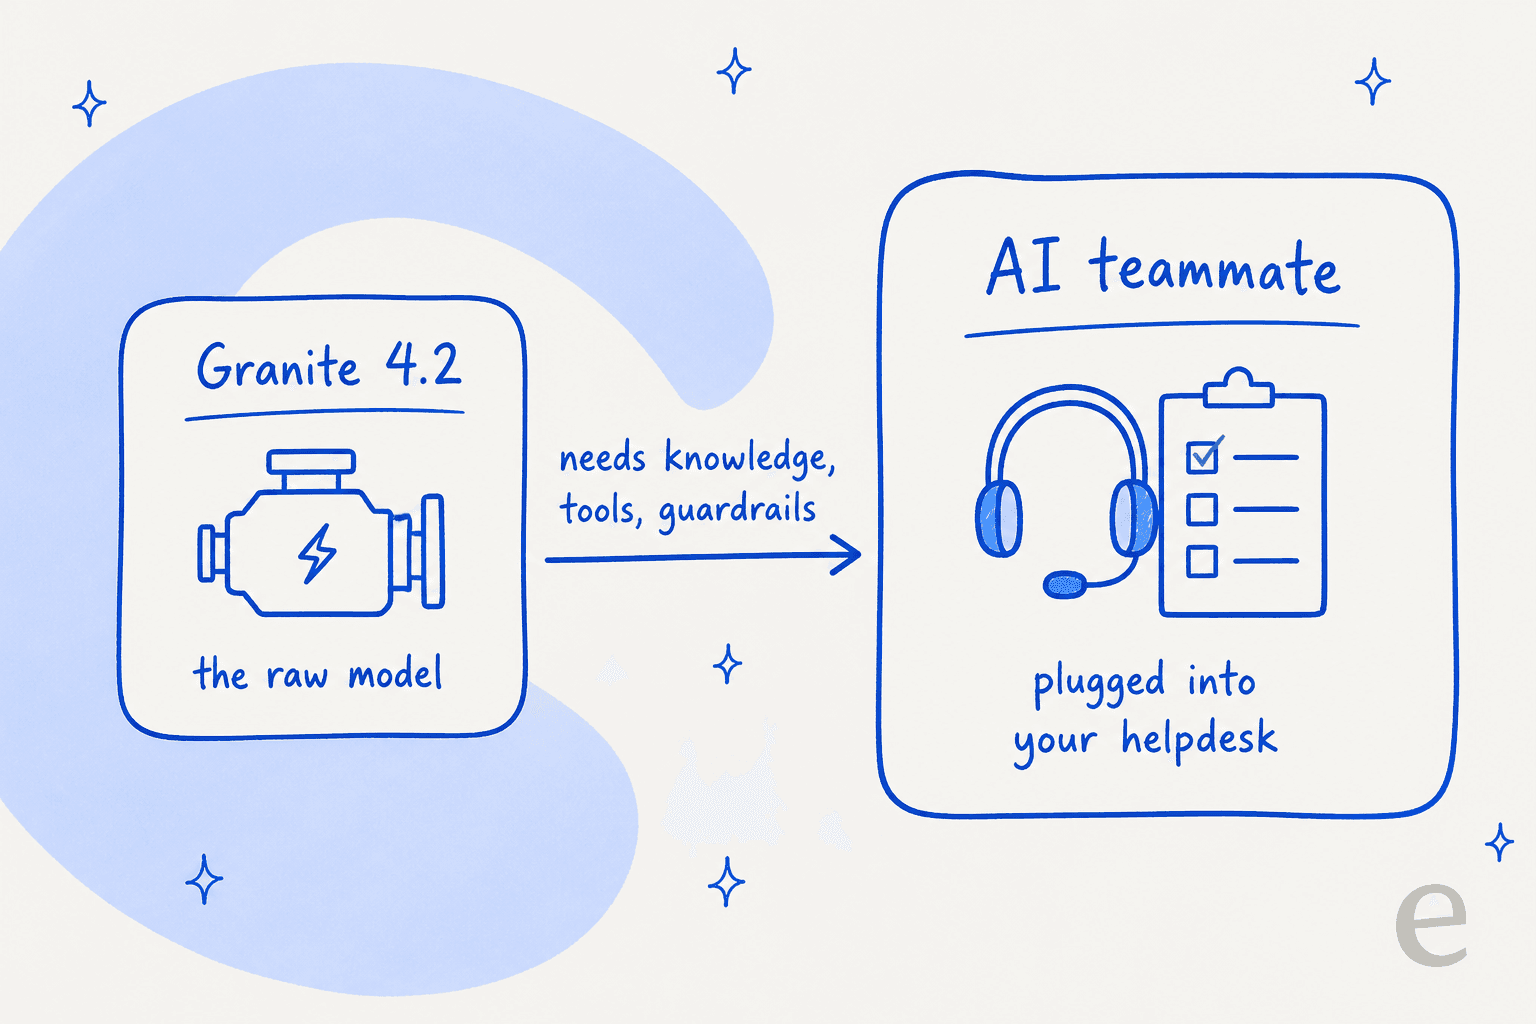
だから「サポートにはどの安いモデルを使うべきか」は、最初の問いとして間違っています。モデル選びは簡単な10%です。チケットが実際に解決されるかどうかを決める90%は、その周りの層です。ナレッジベースに対する検索、ヘルプデスク内でのアクション、ガードレール、顧客に届く前の実際の履歴でのテストです。これは、裏のモデルがFlash Nextでも、GLM 5.3 Flashでも、自社で構築するAI従業員でも変わりません。
eeselを試す
サポート業務向けに安価なモデルを検討してここに来たのなら、正直なアドバイスは、モデル探しをやめて、自分のチケットでテストを始めることです。その従業員の層こそ、私がeeselで作っているものです。特定の仕事のために、すぐ働けるチームメイトを採用できるAIチームメイトのプラットフォームで、現在はAIヘルプデスクのチームメイトとAIブログライターがいます。それぞれが役割に必要なスキル、連携、会社のコンテキストを備えて加わるので、裏でどのモデルが動くかはあなたの悩みではなく、実装の詳細になります。

最も強調したいのはテストです。Flash Nextのような出たばかりのプレビューモデルは、まさにゲートの背後に置きたい類のものだからです。eeselのヘルプデスクのチームメイトは、本番の顧客に触れる前に、過去のチケットに対してすべての導入をシミュレーションします。実際の過去の会話で、解決率と送ったはずの返信そのものを確認し、そのうえで何を自動化するか決められます。ベンチマークで勝ったモデルを選んでください。ただし、まず自分のチケットで証明を。無料でお試しいただけます。