

IBMは2026年8月25日にGranite 4.2を公開しました。3B、8B、30Bの3サイズからなるオープンウェイトの推論モデルファミリーで、すべてApache 2.0ライセンスです。最大の変更点はネイティブの「思考」です。段階的な推論がモデルに組み込まれ、フル、低負荷、オフの間で切り替えられるようになりました。
モデルは小さく、安価で、用途についても正直です。企業のエージェント業務、ツール呼び出し、自前のハードウェアで動かせる構造化タスク向けです。ウェイトが公開されているため最低ラインは無料で、確認できた中で最も安いホスト型の料金は、Replicateの8Bの100万トークンあたり0.06ドル/0.25ドルです。ベンチマークでは30Bが非常に優秀で(SWE-Bench Verifiedで57.0)、ただしコーディングの純粋な能力だけが重要な場面では、ローカルLLMの利用者は今もQwenを選びます。
最初に一つ言っておきたいのは、私がサポート向けAIを仕事にしているからです。モデルは製品ではありません。Granite 4.2は優れたエンジンです。もし本当に欲しいのがチケットを解決するAIエージェントなら、モデルは簡単な10%にすぎず、知識、連携、ガードレールが残りの90%です。詳しくは最後に触れます。
IBM Granite 4.2とは?
GraniteはIBMのビジネス向けオープンモデルファミリーで、4.2は推論に焦点を当てたリリースです。granite-4.2-3b、granite-4.2-8b、granite-4.2-30bの3つのチェックポイントとして登場し、それぞれ対応するGranite 4.1ベースモデルから追加学習されています。IBMは同時に、ごく小さなGranite Speech 5.0の文字起こしモデルも2つ公開しましたが、「4.2」という名前が指すのは実際にはこの3つの言語モデルです。
私はここ数年、実際のサポートキューにAIを載せてきました。新しいオープンモデルで最初に見るのは、トップのベンチマークではなく、ライセンスとデプロイの形です。この点でGraniteは優秀です。ウェイトはApache 2.0で、モデルは暗号署名され、ISO認証を受けており、ファミリーはスタンフォードのFoundation Model Transparency Indexで最高評価を得ました。自社内でモデルを動かす必要がある規制対象のチームにとって、この組み合わせはベンチマークの数ポイントよりも重要です。
IBMの売り文句は「より大きな思考モデルに匹敵し、コストはごくわずか」です。これは興味深い賭けであり、繰り返すよりも検証する価値があるので、実際のラインナップを見ていきましょう。
モデルラインナップ:3B、8B、30B
どこで動かせるかを左右するスペックで、3つのサイズを比較します。3つともデンスなデコーダ専用トランスフォーマーなので、表示されているパラメータ数がそのままモデル全体で、より小さなアクティブサイズを隠すMixture-of-Expertsの仕掛けはありません。
| モデル | パラメータ | 層数 | コンテキスト | ベースモデル | 最適な用途 |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B(デンス) | 40 | 128K | granite-4.1-3b-base | ノートPCやエッジ、素早い単純タスク |
| granite-4.2-8b | 8B(デンス) | 40 | 128K | granite-4.1-8b-base | 汎用的な企業業務 |
| granite-4.2-30b | 30B(デンス) | 64 | 128K(512Kまで拡張可) | granite-4.1-30b-base | 複雑な推論とエージェント |
どのサイズもネイティブで128Kトークンのコンテキストウィンドウに対応し、30Bは512Kまで拡張できます。IBMは各サイズの公式量子化ビルド(fp8、mxfp4、nvfp4)も提供しており、メモリ使用量を抑えられます。また、llama.cppやLM Studio向けのコミュニティ製GGUF変換版もあります。安全性の層が必要な場合は、モデルカードがリスク検出用に別モデルのGranite Guardian 4.1 8Bを案内しています。
多くの人にとって最も難しいのは、サイズを選ぶことです。何を重視するかに応じた簡単なガイドを用意しました。
本当に新しいもの:切り替えられるネイティブ推論
4.2の本当の目玉は、推論が組み込まれたことです。以前のGraniteモデルは直接答えを返していましたが、4.2は答えを出す前に<think>...</think>タグの中で問題を考え抜くことができ、数学、コーディング、複数ステップの論理で役立ちます。実用的なのは、IBMが推論を1つのモデルの中で切り替え可能にした点で、「推論用」と「チャット用」のチェックポイントを別々に管理する必要がありません。
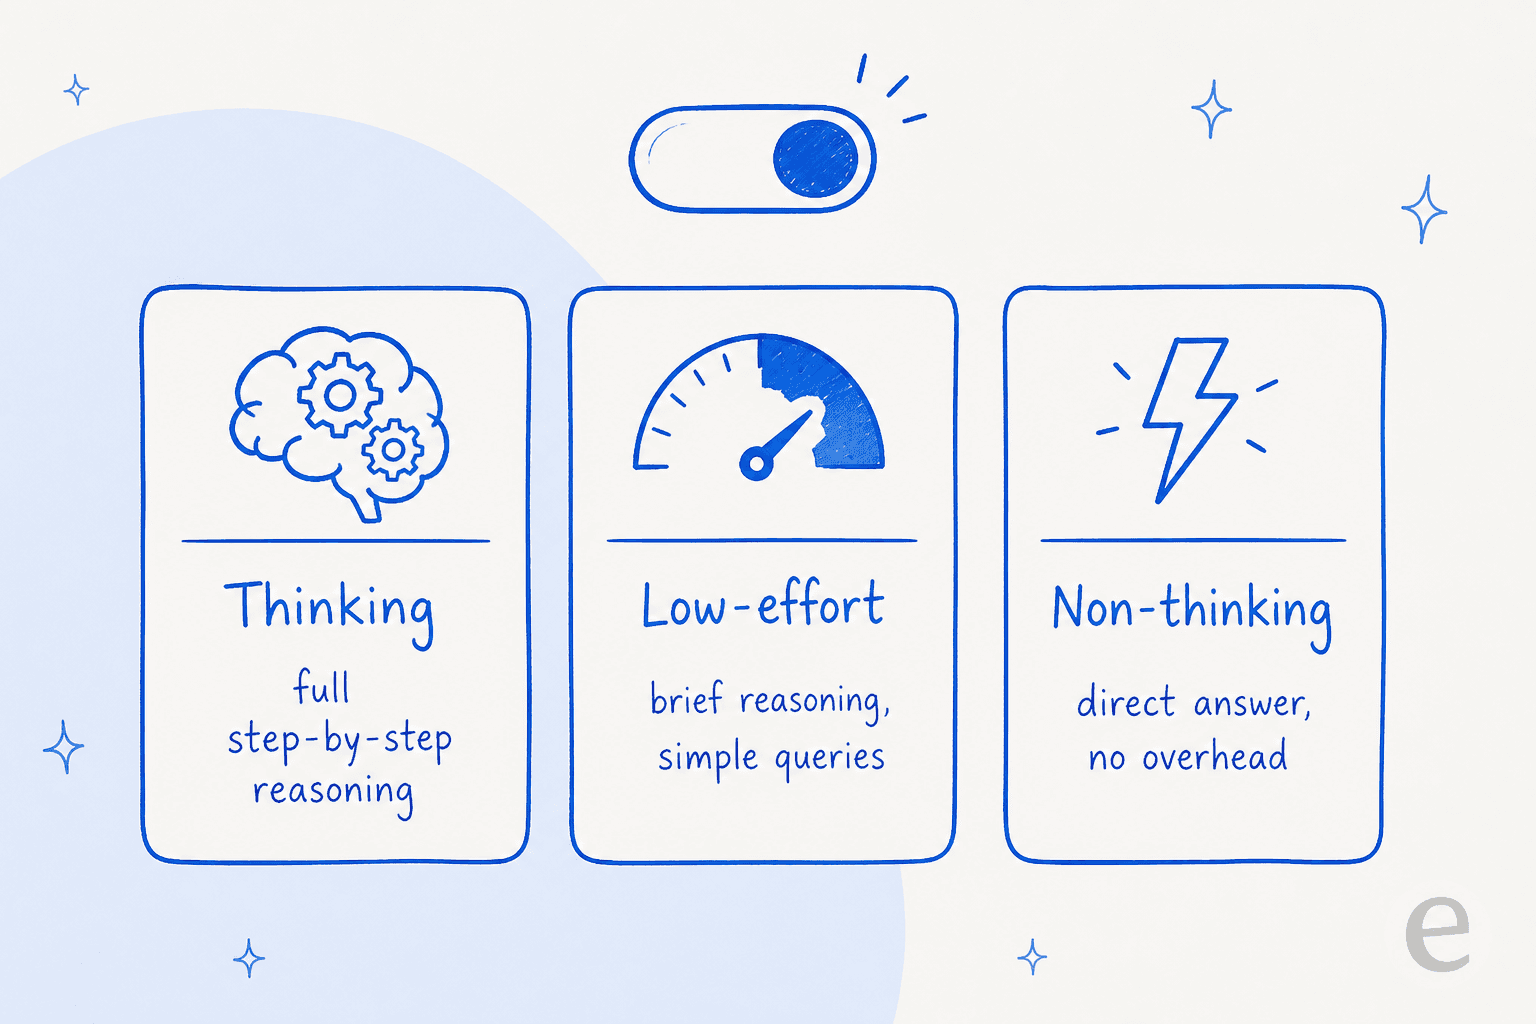
モードは3つあり、どれを選ぶかは主にコストの判断です。
- Thinking(デフォルト):完全な思考連鎖。難しい推論に最適ですが、レイテンシとトークン消費は最悪です。
- Low-effort:単純なクエリ向けの短い推論パスで、フルのオーバーヘッドなしに精度の一部を保つ中間的な選択肢です。
- Non-thinking:推論トークンを一切使わない直接回答で、速度だけが必要なときに使います。
Ollamaでは/set thinkと/set nothinkで切り替えられます。本番環境ではこれが本当に役立ちます。「常に推論する」はコストが高く、「まったく推論しない」は賢くないからで、実際のワークロードの多くはクエリに応じて両方を使い分けたいのです。サポートボットを調整したことがあるなら、エスカレーションするか自動回答するかを決めるのと同じトレードオフです。
推論を伴うツール呼び出し
もう1つのアップグレードで、IBMが明らかに最も重視しているのがツール呼び出しです。Granite 4.2は、関数名をパターンマッチするのではなく、呼び出しを行う前にどのツールをなぜ呼ぶのかを推論するよう訓練されています。実際には、モデルが計画を立て、ツールを呼び出し、結果を確認し、自己修正できるということです。
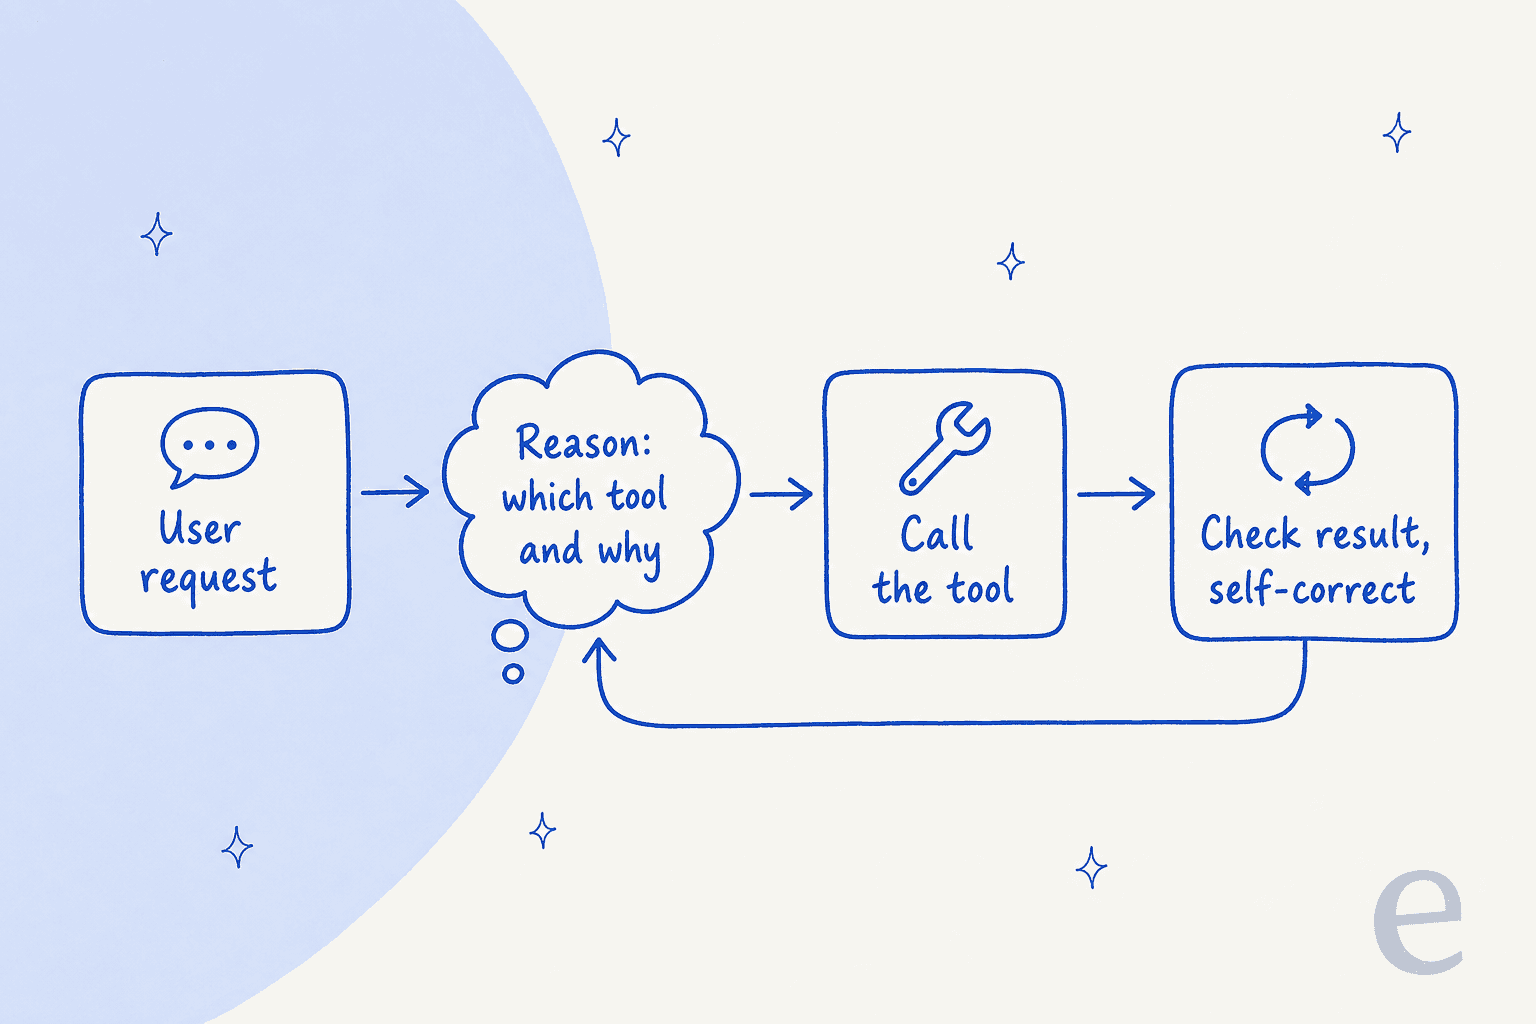
OpenAI互換のAPIを備え、OpenCode、Pi、OpenHandsといったエージェント型コーディングのハーネスでそのまま動作し、サービング用にはvLLM向けに最適化(v0.20以降)されており、SGLangにも対応しています。この部分が、4.2をチャットボットではなくAIエージェントを作る層に向けたものに感じさせます。冷静に見ておくべき点もあります。デモでのツール呼び出しの信頼性は、雑多な本番システムに対する信頼性とは別物で、だからこそ私たちは、ライブの顧客に触れる前に、実際の過去データですべての導入をシミュレーションしているのです。
ハイブリッドではなくデンス:Granite 4.0からの変更点
これは人が混乱しやすいニュアンスなので、1段落を割く価値があります。Granite 4.0は、Mixture-of-Experts(MoE)層を備えたMamba-2とトランスフォーマーのハイブリッドアーキテクチャを採用しており、IBMはメモリ使用量の低さと推論の速さを売りにしていました。Granite 4.2は逆の方向に進み、デンスなGranite 4.1ベースから追加学習した、素直なデンスのデコーダ専用トランスフォーマーです。
これがなぜ重要なのでしょうか。デンスモデルには「アクティブ対総」のパラメータ区分がないため、30Bのデンスモデルはトークンごとにおよそ30B分の計算を使います。同等のMoEよりトークンあたりは重くなりますが、理解しやすく、標準的なツールと幅広く互換性があり、デプロイも予測しやすいのです。IBM自身の表現は「its dense architecture supports broad compatibility」で、効率を少し犠牲にして、デプロイ時の摩擦を大きく減らすということを公平に言い表しています。
Granite 4.2のベンチマーク結果
ここに挙げるのは、IBMがモデルカードで公開した数値で、IBMの2つの公式表が一致している値を使っています。購入者が実際に気にするベンチマークに絞りました。
| ベンチマーク | 3B | 8B | 30B |
|---|---|---|---|
| SWE-Bench Verified(コーディング) | NA | 47.67 | 57.00 |
| Terminal-Bench 2.1 | NA | 20.56 | 29.24 |
| AIME25(数学の推論) | 78.33 | 86.67 | 89.17 |
| GPQA | 54.80 | 64.14 | 66.41 |
| MMLU-Pro | 67.84 | 74.04 | 77.60 |
| Arena-Hard-V2 | 34.96 | 65.19 | 67.93 |
| RULER 128K(長いコンテキスト) | 55.30 | 71.41 | 81.38 |
このサイズとしては強い結果で、特に30Bのコーディングと数学が優秀です。ただ、ここで率直にお伝えしたいことがあります。このセクションで最も有用な点だからです。IBMは主にGraniteを過去のGraniteバージョンと比較しており、新モデルの比較対象も、多くの人が実際にローカルで動かすモデルではなく、Nemotron 3 SuperとGemma 4です。これは、これらの表からわかることの限界として現実的です。
コミュニティの見方はより懐疑的で、それももっともです。4.1のリリース後にHacker Newsのコメント投稿者が述べたとおりです。
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."

したがって、ベンチマークは「Graniteは前のGraniteよりずっと良くなった」と受け取るべきです。これは真実で有用です。「Graniteは同サイズのあらゆるモデルに勝つ」とは受け取らないでください。表はそれを実際には示していません。
みんなの評価
4.2そのものに関する独立した実機レビューは、公開から数日しか経っていないためまだ少ないものの、Granite 4.xに対する評価は定着しており一貫しています。称賛は本物です。小型モデルは汎用ハードウェアでも高速に動き、根拠に基づく構造化された作業でひそかに優秀です。
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly ... Granite has recent training data which is nice."
批判も同じく一貫しており、2種類あります。1つ目は、生の能力では、ローカルLLMコミュニティが今もコーディングとエージェント推論でQwenを高く評価していることです。
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
2つ目は、8Bをpullする前に知っておくべき実用上の落とし穴です。長いコンテキストウィンドウのKVキャッシュのせいで、ロード後のメモリ使用量がダウンロードサイズをはるかに超えて膨らむことに、何人もが遭遇しています。
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"

対処法は通常、ロード時にコンテキスト長に上限を設けることですが、ダウンロードサイズがメモリサイズだと思い込むと本当に落とし穴になります。
料金と実行方法
ウェイトが公開されているため、Granite 4.2を動かす最も安い方法は無料です。OllamaやHugging Faceからpullして、自前の計算資源の分だけ支払います。各ルートの実際のコストは次のとおりです。
| ルート | 支払う金額 | 備考 |
|---|---|---|
| セルフホスト(Ollama / Hugging Face / vLLM) | ライセンス料0ドル | Apache 2.0。ハードウェアは自己負担。3Bはノートパソコン向けの2.2 GBのダウンロード |
| Replicate(granite-4.2-8b) | 入力100万あたり0.06ドル、出力100万あたり0.25ドル | 確認できた中で最も安いホスト型のトークン単価。一般的な1回の実行で約0.0014ドル |
| IBM watsonx.ai | 100万トークンあたりの従量課金+時間単位のホスティング | Standardプランは月額約1,050ドル。Resource Unit単位で課金(1 RU = 1,000トークン) |
watsonxについての補足です。確認した時点で、Granite 4.2の項目のライブ料金表がエラーを返していたため、4.2の正確なトークン単価を直接確認できませんでした。IBMのドキュメントで確認できる最も近いGranite-4ファミリーの料金は、入力100万あたり約0.06ドル、出力100万あたり約0.27ドルで、料金体系(100万トークンあたりの従量課金に時間単位のホスティングを加えたもの)は確認済みです。執筆時点では、OpenRouterにはGranite 4.0と4.1しか掲載されておらず、4.2はありませんでした。
実際のコスト比較として、すでに持っているハードウェアで3Bをセルフホストするのは、無料の推論に最も近い方法です。これが、データプライバシーを重視するチームがGraniteファミリーを好む大きな理由の1つです。ホスト型の製品と比較するなら、トークン単価そのものより、私たちのAI解決率の解説のほうが良い物差しになります。
Granite 4.2は誰が使うべき?
すべてを見たうえでの、私の率直な見解です。
Granite 4.2を選ぶべき人: オンプレミスで動かせる、オープンでライセンス可能なモデルが必要で、構造化された根拠のあるタスク(ツール呼び出し、要約、抽出、タグ付け)を重視し、2つのチェックポイントをやりくりせずに切り替え可能な推論を使いたい人です。8Bは企業の自動化に最適なデフォルトで、3Bは「ノートPCで動く」モデルとして本当に優秀です。また、これらのモデルは記憶から答えるのではなく自社のドキュメントに基づくときに力を発揮するため、検索層とも自然に組み合わせられます。
ほかを探すべき人: コストを問わず最高のコーディングやエージェント推論だけが最優先で、コミュニティの総意が今もQwenを指している場合、あるいは、土台にするモデルではなく、すぐ使えるマネージドな製品が欲しい場合です。Graniteは優れたモデルであって完成したアプリケーションではなく、その2つの差こそが、サポートAIプロジェクトの成否を実際に分けるところです。
モデルからチームメイトへ:eeselの位置づけ
ここが私にとって最も大切な部分です。チームが何度も繰り返す間違いだからです。Granite 4.2のような素のモデルはエンジンです。とても良いエンジンです。しかし、エンジンは採用した人材ではありません。
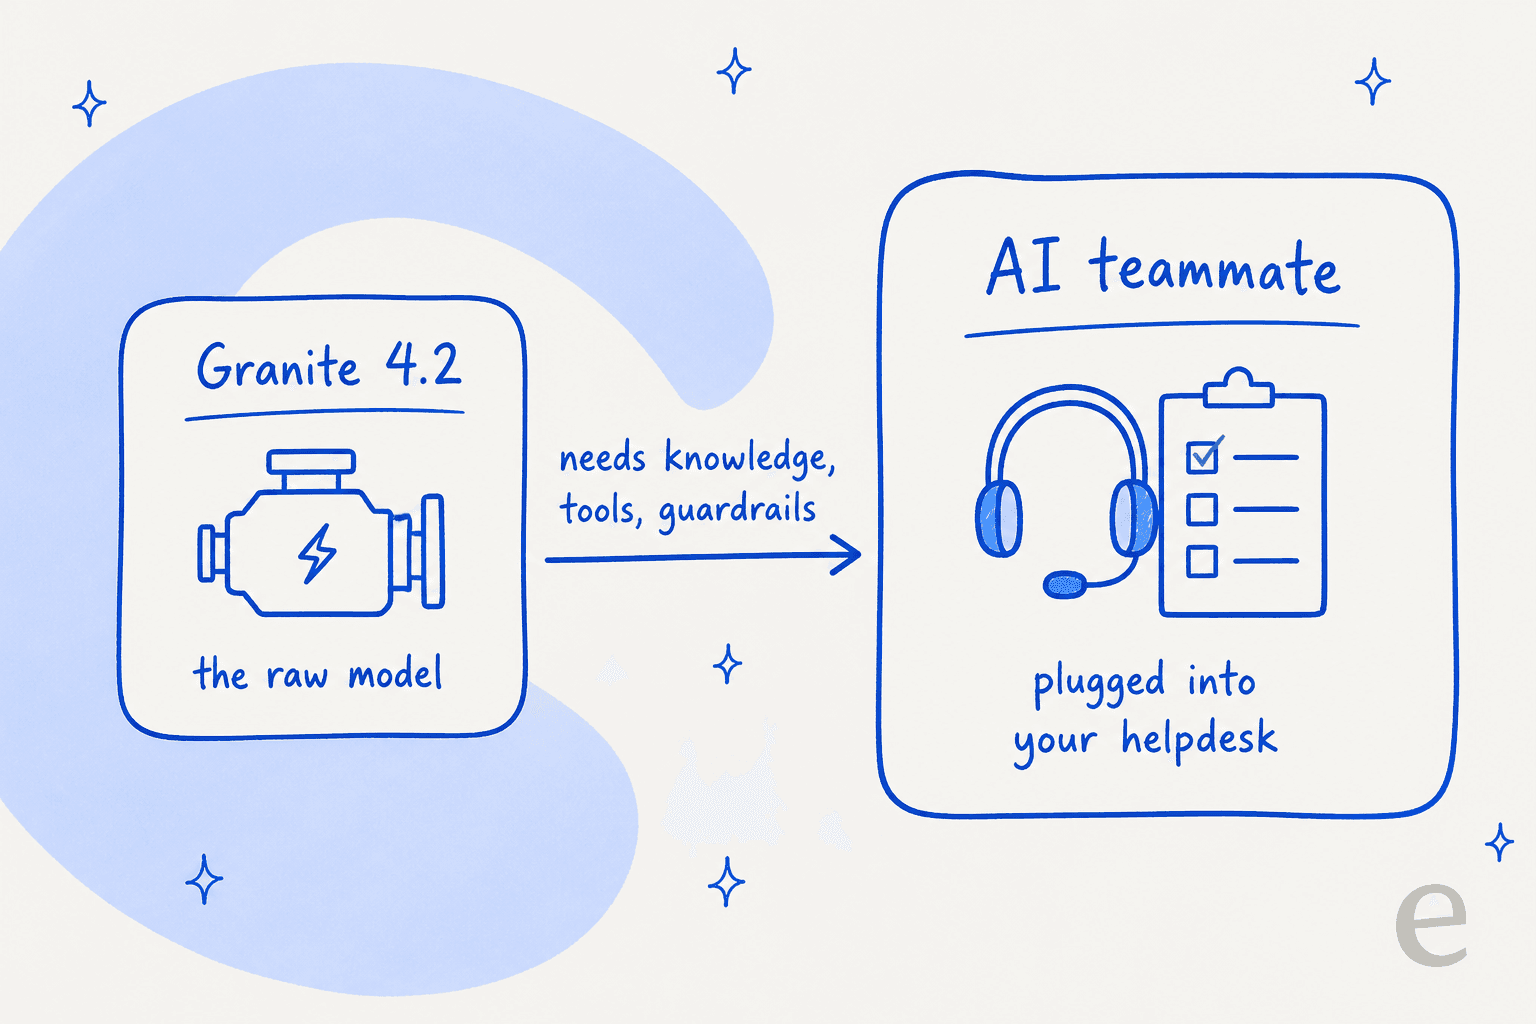
eeselが売るのはエンジンではなく、完成したチームメイトです。AIヘルプデスクのチームメイトは、すでに使っているヘルプデスク(Zendesk、Freshdesk、Gorgias、共有受信箱など)に接続し、過去のチケットとナレッジベースから学習し、既存のツールの中で返信を下書きまたは送信します。Granite 4.2が提供するネイティブ推論とツール呼び出しは、ここでは最低条件で、難しい90%は、会社の文脈、連携、そしてその周りのセーフティネットです。

そして、これなしではサポートボットを出荷しないという点があります。eeselでは、チームメイトが顧客と話す前に、実際の過去チケット数千件に対してチームメイトをシミュレーションできるので、スイッチを入れて祈るのではなく、稼働前に解決率と正確な回答を確認できます。自信ありげに聞こえるボットが静かに誤った回答をするのを私たちは見てきたので、これを作りました。自社のチケットでテストすることが、それを見つけられる唯一の方法です。
サポートを自動化したくてGranite 4.2を検討しているなら、知っておく価値のある近道があります。eeselを無料で試し、数分でヘルプデスクを接続し、すぐ働けるチームメイトが実際のチケットをどう処理するかを確認できます。自分でモデルを立ち上げて面倒を見る必要はありません。そして、文章を書くことが仕事なら、同じ考え方がAIブログライターのチームメイトも支えています。
よくある質問
IBM Granite 4.2とは何ですか?
IBM Granite 4.2は、2026年8月25日に3B、8B、30Bパラメータの3サイズで公開された、オープンウェイトの推論言語モデルファミリーです。3つともApache 2.0ライセンスで提供され、128Kのコンテキストウィンドウに対応し、オン・オフを切り替えられるネイティブの思考連鎖推論を備えています。カスタマーサービスでのAI、コーディング、エージェント型のツール利用向けに作られています。
Granite 4.2の実行にはいくらかかりますか?
最低ラインは無料です。ウェイトはApache 2.0なので、OllamaやHugging Face経由でセルフホストすれば、自前のハードウェア代だけで済みます。確認できた中で最も安いホスト型の料金は、Replicateのgranite-4.2-8bで、入力100万トークンあたり0.06ドル、出力100万トークンあたり0.25ドルです。IBM自身のwatsonx.aiは、100万トークンあたりの従量課金に時間単位のホスティング料金が加わり、Standardプランは月額約1,050ドルです。
Granite 4.2はGranite 4.0とどう違いますか?
Granite 4.0は、Mamba-2とトランスフォーマーのハイブリッド設計にMixture-of-Experts層を組み合わせたものでした。Granite 4.2は、Granite 4.1のベースから追加学習した、デンスなデコーダ専用トランスフォーマーで、最大の追加点は切り替え可能なネイティブ推論です。デンスとは、アクティブパラメータと総パラメータの区別がないという意味で、ダウンロードしたサイズがそのまま動くサイズになります。
Granite 4.2は商用でも無料で使えますか?
はい。Apache 2.0ライセンスにより、商用・研究目的での無制限の利用、ファインチューニング、セルフホスティングが、トークン単位のライセンス料なしで認められています。動かすための計算資源は自己負担です。サポートの運用では、eeselのようなAIヘルプデスクエージェントの層と組み合わせることで、素のモデルが実際に問い合わせキューをさばく存在になります。