

IBMのGranite 4.2は、本当に優れたオープンウェイトのモデルファミリーです。3つの小型推論モデル(3B、8B、30B)、Apache 2.0、切り替え可能な思考モード、そして低コストで動かせます。それでも代替を探す人の理由は、おおむね次の3つです。より高い素の性能がほしい(主にコーディング)、大規模運用でさらに安くしたい、あるいはより使いやすいライセンスやホスト型のマネージドAPIが必要。
誰を選ぶべきかを短くまとめると次のとおりです。
- Qwen 3.8:特にコーディングで最強の素の性能がほしい場合。オープンな27Bチェックポイント、Apache 2.0。
- DeepSeek V4 Flash:大規模運用のコストがすべてなら。MITライセンスで、ここでは最も安い本格派。
- GLM 5.3 Flash:オープンウェイトで、安価でマルチモーダル、ツール利用に強いエージェントがほしい場合。
- Kimi K3:長期的なエージェント型の作業を行い、そのために割高でも払える場合。
- Mistral(Large 3 + オープンモデル):欧州のベンダーと、クリーンなオンプレミス向けライセンスを重視する場合。
- Google Gemini 3.6 Flash:自己ホストするより、マネージドのホスト型APIがよい場合。
- NVIDIA Nemotron 3:NVIDIAのハードウェアを使っている、または重みに加えてオープンな学習レシピもほしい場合。
先にひとつ言っておくと、サポートAIの開発が私の本業なので:このリストのモデルはすべてエンジンであって、製品ではありません。本当にほしいのがチケットを解決するAIエージェントなら、モデルは簡単な10%にすぎず、ナレッジ、連携、ガードレールが残りの90%です。詳しくは最後に触れます。
なぜ Granite 4.2 の代替を探すのか
まずGraniteには公平でいたいと思います。それだけの価値があるからです(このファミリーは私のGranite 4.2 レビューで詳しく掘り下げました)。Granite 4.2は2026年8月25日に、3つの密な推論モデルとしてApache 2.0ライセンスで公開されました。小型モデルは一般的なハードウェアで高速に動き(3Bは2.2GBのダウンロード)、学習データも新しく、コミュニティの共通認識では、Graniteは構造化された、根拠のある作業で静かに優秀です。ツール呼び出し、要約、ドキュメントのタグ付けや抽出などです。エージェントループで行儀よく動く、オンプレミスでライセンス可能なモデルが必要なら、有力な第一候補です。
ではなぜ乗り換えるのか。いくつかの現実的な理由が繰り返し挙がり、どれもマーケティング上の言い分ではありません。
**素の性能、特にコーディング。**これが最も声の大きい理由です。Hacker Newsでは、繰り返し出てくる意見は率直です。
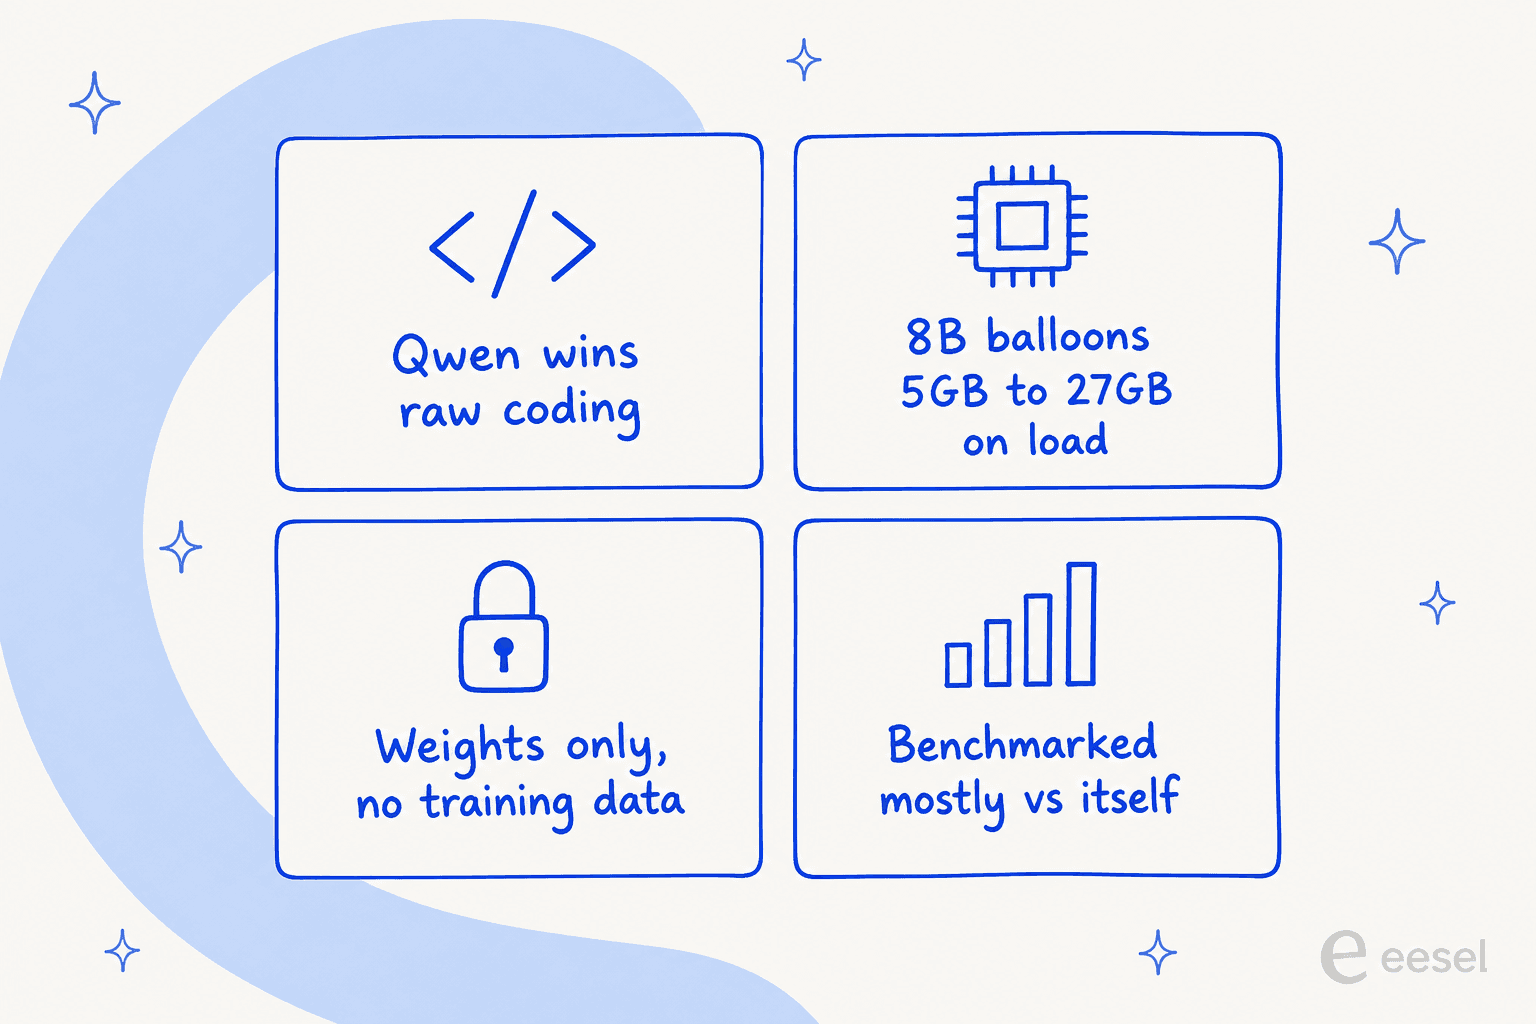
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."

Graniteを気に入った人でさえ、難しい作業には従来の本命を使い続けました。
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly. Qwen3.6 35b a3b is still my local champion but I may use this for auto complete and small tasks."
**IBMは主に自社内でベンチマークしている。**Graniteのモデルカードは、過去のGraniteバージョンや、NVIDIAのNemotronやGoogleのGemmaといった限られた競合とは比較していても、Qwenとは比較していません。これが特有の懐疑を生みます。
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models."
**実際の運用上の落とし穴。**8Bは5.3GBのダウンロードですが、広く共有されたr/LocalLLaMAのスレッドが指摘したところでは、KVキャッシュが確保されるとロード時にメモリ上で27GBまで膨らむことがあり、コンシューマー向けGPUでは動かなくなる可能性があります。導入を決める前に確認しておく価値があります。
**「重みだけではオープンソースとは言えない。」**GraniteはApache 2.0で重みを提供しますが、学習データやレシピは提供せず、「オープン」の定義についてより厳格な立場をとるコミュニティもあります。再現性が重要なら、このギャップはより多くを公開しているモデルを検討する理由になります。
コスト面の実用的な視点もあります。サポート用途で月に500万の出力トークンを使うとします。Granite 4.2の確認済みの最安ホスト型料金では約$1.25、Kimi K3では同じトークンで$75です。この60倍の差こそ、先週のリーダーボードの首位に飛びつくのではなく、「どの代替か」を慎重に検討する価値がある理由です。
これらの代替をどう選んだか
Graniteの実像に沿ってリストを組みました。つまり、安価に自己ホストできる、オープンで、小型から中型の、推論可能なモデルです。基準は次のとおりです。
- **まずオープンウェイト。**7つのうち6つがダウンロード可能な重みを公開しています。クローズドなAPIではなくGraniteを動かす理由がまさにそこだからです。Gemini 3.6 Flashだけがホスト型のみの選択肢で、オープン性を手放してもマネージドなエンドポイントがほしいチームが多いため含めています。
- **推論とツール利用。**Graniteの目玉は切り替え可能な思考と、推論で強化されたツール呼び出しなので、ここにあるモデルはすべてエージェントループで推論しツールを呼び出せます。
- 確認できる実際の価格。「営業に問い合わせ」はなしです。以下の価格はすべてベンダーのページにたどれます。(サポートボットの裏にどのエンジンを置くかが本題なら、別記事のサポートチケット向けのベストAIモデルで比較しています。)
- **一次情報のみ。**スペックはモデルカードと料金ページから、評判はHacker News、Reddit、Xから取っており、まとめサイトのリストは使っていません。
ツールごとに見ていく前に、全体を一覧で確認しましょう。
| モデル | 最適な用途 | オープンウェイト | ライセンス | コンテキスト | ホスト型 入力/出力(100万あたり) | 推論 |
|---|---|---|---|---|---|---|
| Granite 4.2(現行) | オンプレミスの企業向けエージェント | あり | Apache 2.0 | 128K–512K | $0.06 / $0.25 | 切り替え可 |
| Qwen 3.8 | 素のコーディング性能 | あり(27B Apache) | 混在 | 1M | $2 / $6(Max) | オン(xhigh) |
| DeepSeek V4 Flash | 大規模運用のコスト | あり | MIT | 1M | $0.22 / $0.66(オフピーク) | オン(high) |
| GLM 5.3 Flash | 安価なマルチモーダルエージェント | あり | オープン | 1M | $0.075 / $0.25(プロモ) | 思考のみ |
| Kimi K3 | 長期的なエージェント | あり | 修正版 | 1M | $3 / $15 | 常時オン |
| Mistral Large 3 | 欧州 / オンプレミス | 一部(小型モデルはApache) | 混在 | 128K+ | $0.50 / $1.50 | 任意 |
| Gemini 3.6 Flash | マネージドのホスト型API | なし | プロプライエタリ | 1M | $1.50 / $7.50 | 任意 |
| NVIDIA Nemotron 3 | NVIDIAスタック、オープンなレシピ | あり | オープン | 最大1M | 無料エンドポイント / 計算資源 | あり |
2026年のGranite 4.2のおすすめ代替7選
1. Qwen 3.8 - 素の性能とコーディングに最適
**こんな方に最適:**ライセンスを理由にGraniteを選んだものの、難しいコーディングや推論タスクでその限界に何度も突き当たるチーム。
ローカルLLMの人たちがGraniteの代わりに手を伸ばすモデルを一つ挙げるなら、それはQwenです。その比較は反射的で、Granite 4.2の公開時にXで最も多かった質問は、文字どおりQwenと比べてどうかというものでした。
"Anyone tested Granite 4.2 30B from IBM yet? How does it compare to Qwen-3.8-27B?"
Qwen 3.8には2つの形があります。フラッグシップのQwen 3.8 Maxは、2.4Tパラメータ(アクティブ95B)のMixture-of-Expertsモデルで、1Mトークンのコンテキストを持ち、ホスト型APIとして販売されています。その下に、本物のApache 2.0ライセンスのオープンな**Qwen3.8-27B**チェックポイントがあり、Graniteのオープンなサイズと直接比較できる相手です。知っておくべき点として、Maxのオープンなベース重みはApacheではなくAlibaba独自の制限的なライセンスなので、商用の自由度を求める「オープンなQwen」とは、巨大モデルではなく27Bのことです。
**Graniteに勝る点:**素の性能、これに尽きます。LMArenaでは、Qwen 3.8 Maxはテキストとウェブ開発で上位にあり、コーディングに関するコミュニティの評価は定まっています。1Mのコンテキストも、Graniteのネイティブ128Kを大きく上回ります。
**弱い点:**Apacheでクリーンな選択肢は看板のMaxではなく27Bなので、オープン性の話は見た目より狭くなります。またQwen自身のコーディング用ハーネスは出力上限64Kで設定されているため、「1Mコンテキスト」という数字は、ほとんどのワークロードが実際に使う範囲より理論的なものです。
**料金:**オープンな27Bは自己ホストなら無料です。AlibabaクラウドのQwen 3.8 Maxは、入力が100万トークンあたり$2、出力が$6で、キャッシュされた入力の読み取りは$0.25です。
**結論:**コーディングや難しい推論についていけなくなってGraniteを離れたなら、まず見るべきはQwenです。クリーンなライセンスが重要なら27B、最強のバージョンがほしくAlibabaの条件が気にならないならホスト型のMaxを選びましょう。
2. DeepSeek V4 Flash - 大規模運用のコストに最適
**こんな方に最適:**トークンあたりの請求額がアーキテクチャを実際に決める、大量処理のワークロード。
DeepSeek V4 Flashはこのリストの低予算の王者で、Qwenの看板モデルと違い、本当にMITライセンスです。最も寛容なライセンスの一つです。
284Bパラメータ(アクティブ13B)のMixture-of-Expertsモデルで、1Mトークンのコンテキストを持ち、約167GBのオープンウェイトとして公開されています。推論はデフォルトで「high」でオンになっており、ここが面白い点です。安い設定と良い設定は、文字どおり同じ重みの別々の実行です(RAGと素のLLMのトレードオフもここに現れます。考えるほど課金されるトークンが増えるからです)。DeepSeek自身の数値では、FlashのHLEスコアは思考オフで8.1、最大努力で34.8です。どこまで考えさせるかを選べて、推論トークンには出力料金が課されます。
**Graniteに勝る点:**価格と、よりクリーンなライセンス。Graniteの30Bよりはるかに大きなモデルでもあり、最大努力ではGraniteの小型サイズが届かない能力に達します。
**弱い点:**テキストのみ(画像入力は文書化されていません)で、冗長になりがちで、データガバナンス上の現実的な問題があります。DeepSeekの有料API規約は、入力を学習に使うかどうかについて何も述べておらず、サービスは中国の法律の下で運営されているため、規制対象の顧客データにそのまま使えるものではありません(サポートデータを扱うなら、ここではSOC 2とGDPRの観点が重要です)。料金の時間帯にも注意が必要です。ピーク時間帯(UTC 01:00〜04:00と06:00〜10:00)は料金が倍になりますが、これは欧米のほとんどのキューにとってたまたま時間外です。
**料金:**オフピークでは、キャッシュミスの入力が100万あたり$0.22、出力が$0.66で、ピーク料金はちょうど2倍です。MITの重みを自己ホストするのは無料です。
**結論:**ワークロードが大きく、データが規制対象でないなら、能力あたりのコストでDeepSeekに勝るものはここにありません。ただし、時差で驚かないようにコストモデルはピーク料金で組み、顧客の個人情報は公式APIに載せないでください。
3. GLM 5.3 Flash - 安価なマルチモーダルエージェントに最適
**こんな方に最適:**最先端の価格を払わずに、オープンウェイトでツール利用に強いマルチモーダルなエージェントがほしい開発者。
Z.ai(Zhipu)のGLM 5.3 Flashはここで最も新しいモデルで、Graniteが最も強いエージェント型・ツール呼び出しという領域にまさに踏み込み、そのうえで価格を下回ります。
320Bパラメータ(アクティブ18B)のMoEで、GLM-5ラインで初めてネイティブにマルチモーダルなモデルです。1Mのコンテキストを持ち、オープンウェイトがHugging Faceにあります。Artificial Analysis Intelligence Indexで57を記録し、はるかに高価なモデルに並びつつ、タスクあたりのコストはごく一部です。
**Graniteに勝る点:**ネイティブにマルチモーダルで(Granite 4.2にはビジョン版がありません)、コンテキストは8倍大きく、プロモ価格はほぼ無料に近いです。またOpenRouterの利用チャートで一時期首位に立ったので、大量処理での実績もあります。
**弱い点:**推論は常にオンで無効にできず、Graniteのような「高速・安価・思考なし」の本当のモードがありません。公式APIも遅く(約49トークン/秒)、レイテンシに敏感な用途ではDatabricksのようなより高速なホストが必要になります。
**料金:**プロモ料金は入力が100万あたり$0.075、出力が$0.25(定価は$0.15/$0.50)で、プロモは2026年9月9日まで、キャッシュ入力は$0.015です。別枠のGLM Coding Planは月額$18/$80/$168です。オープンウェイトは自己ホストなら無料です。
**結論:**画像を見てツールを呼び出す安価なエージェントなら、GLM 5.3 Flashはこのリストで最も直接的な「Graniteの、より大きくマルチモーダル版」への乗り換えです。常に思考することだけは予算に織り込んでください。
4. Kimi K3 - 長期的なエージェント作業に最適
**こんな方に最適:**弱いモデルのお守りをするより、多く払いたい複雑なマルチステップのエージェント実行。
Moonshot AIのKimi K3はプレミアムなオープンウェイトの選択肢で、より大きく、より高価で、安価なスループットよりも持続的なエージェント推論に調整されています。
2.8Tパラメータ(アクティブ104B)のMoEで、1Mトークンのコンテキストとネイティブなビジョンを備え、Moonshotは予定どおりオープンウェイトを公開しました。Artificial Analysis Intelligence Indexでは約57(総合4位)で、多くのタスクで一部の最先端モデルを上回ります。
**Graniteに勝る点:**難しく長時間かかるタスクではるかに強力なモデルで、Graniteの小型サイズでは手に余る場面で本格的なエージェント推論ができます。
**弱い点:**価格です。100万トークンあたり入力$3 / 出力$15は、Claude Sonnetと同じ価格帯で、DeepSeekの出力料金の約50倍なので、予算重視の選択とは正反対です。推論はどのレベルでもオフにできず(努力設定はレイテンシの制御であって、コスト帯ではありません)、オープンウェイトは1,561GBのダウンロードなので、ここでの「自己ホスト」は本格的なインフラを意味します。
**料金:**入力が100万あたり$3、キャッシュヒットは$0.30、出力が100万あたり$15です。コンシューマー向けアプリのプランは月額 Free / $19 / $39 / $99 / $199です。
**結論:**Kimi K3は、安いモデルでは失敗するほどタスクが難しく、失敗のコストがトークンのコストを上回るときに選ぶものです。日常的な大量処理では、GraniteやDeepSeekと比べてオーバースペックです。
5. Mistral(Large 3 + オープンモデル)- 欧州のチームとクリーンなオンプレミスに最適
**こんな方に最適:**米国以外のベンダー、EUのデータ所在地、小型モデルの本当に寛容なライセンスを求めるチーム。
Mistralは、そもそも人々をGraniteに引き寄せる「オープンでライセンス可能、オンプレミス」という訴求に対する欧州の答えで、小型モデルはApache 2.0で提供されます。
ラインナップははっきり分かれています。Mistral Large 3はホスト型のフラッグシップ、CodestralとDevstralはコーディングとエージェント作業をカバーし、より小さなオープンモデル群が自己ホストの用途をカバーします。かつてLe Chatと呼ばれたMistralのコンシューマー向けアシスタントは、現在Vibeというブランドです。
**Graniteに勝る点:**欧州の管轄と、成熟したエンタープライズ向けの体制(EUのデータ所在地、オンプレミス展開)。小型のオープンモデルは、西側ベンダーが後ろ盾のApacheライセンスの自己ホスト経路を提供し、これはライセンス文面だけでは捉えきれない形で調達に効きます。
**弱い点:**Mistralの最大かつ最良のモデルはホスト型の有料モデルなので、オープン層は最先端ではありません。純粋なベンチマーク性能では、現時点で中国のオープンモデル(Qwen、DeepSeek、GLM)が先行する傾向があります。
**料金:**Mistral Large 3は入力が100万あたり約$0.50、出力が約$1.50です。Codestralはおよそ$0.30/$0.90です。Vibeのコンシューマー向けプランは、ユーザー1人あたり月額 Free / $14.99 / $24.99です。小型のオープンモデルは自己ホストなら無料です。
**結論:**オープンを選んだ理由が、ベンチマークの最後の1セントを絞ることではなく、ガバナンスとベンダーの管轄だったなら、Mistralがここで最も快適な選択です。理由が素の性能だったなら、まずQwenかDeepSeekを見てください。
6. Google Gemini 3.6 Flash - マネージドのホスト型APIに最適
**こんな方に最適:**重みには一切触れず、高速で安価、信頼できるホスト型エンドポイントがほしいチーム。
Graniteユーザーの全員が自己ホストを望んでいるわけではありません。安価で、ある程度オープンな働き者がほしかっただけで、安かったからGraniteを選んだ人もいます。そうした人にとって、Gemini 3.6 Flashはクローズドだが手軽な代替です。
Googleの「働き者」Flash層で、2026年7月21日に公開され、約1Mトークンのコンテキスト、組み込みのコンピューター操作、2026年3月の知識カットオフを備えています。Googleによれば、同じタスクで前のFlashより出力トークンが約17%少なく、実際の請求額をひそかに下げます。
**Graniteに勝る点:**運用負荷がゼロです。GPUもvLLMの設定もKVキャッシュの驚きもありません。コンピューター操作と長いコンテキストのタスクに強く、本当に高速です。
**弱い点:**プロプライエタリでホスト型のみなので、自己ホストもオンプレミスもライセンスの自由もなく、これはほとんどの人がGraniteに求めたものそのものです。また出力価格もこのリストでは高めです。
**料金:**入力が100万あたり$1.50、出力が$7.50で、バッチリクエストは50%オフ($0.75/$3.75)です。
**結論:**オープンウェイトを気にしたことがなく、安価で高性能なAPIがほしかっただけなら、Gemini 3.6 FlashはGraniteを自分で動かすよりすっきりした選択です。オープン性やオンプレミスが目的だったなら、向かう方向が違います。
7. NVIDIA Nemotron 3 - NVIDIAスタックと真にオープンなレシピに最適
**こんな方に最適:**すでにNVIDIAのハードウェアを使っているチームと、Graniteが提供しない再現性を求める人。
NVIDIAのNemotronファミリーは、IBMが実際にGraniteと比較している競合の一つで、自然な直接対決の相手であり、「重みだけではオープンではない」という不満に正面から答えます。
Nemotronは、言語、推論、ビジョン、検索にわたるNVIDIAの専用設計の基盤モデル群です。現在の言語モデルは、長時間稼働する自律エージェント向けに調整された、総計30B / アクティブ3BのMoEであるnemotron-3.5-lightning-30b-a3bから、エージェント推論、コーディング、ツール呼び出し向けに作られた1MコンテキストのオープンなハイブリッドMamba-Transformer MoEであるnemotron-3-ultra-550b-a55bまでの範囲です。重要なのは、NVIDIAがこのファミリーは「open weights, open datasets, and reproducible training recipes.」付きで提供されると述べていることです。
**Graniteに勝る点:**その再現性の一行がすべての売りです。Graniteが重みを提供するところで、Nemotronは重み、データ、レシピを提供し、コミュニティの一部が求めるより厳格な意味でのオープンです。NVIDIAのシリコンに最適化されており、導入を決める前にbuild.nvidia.comでモデルを無料で呼び出せます。
**弱い点:**最強のNemotronモデルは大きく(ultraは550B)、Graniteの3Bを愛すべき存在にしている「ノートPCで動く」という話は、レンジの上位には当てはまりません。また、トークンあたりの小売価格はここにある他のモデルほど明快ではなく、本番運用のホスティングはNVIDIA NIMやクラウドパートナー経由で、計算資源に応じた価格になります。
**料金:**オープンウェイトは無料でダウンロードでき、NVIDIAはbuild.nvidia.comで無料のホスト型エンドポイントを提供しています。NVIDIA NIMやクラウドパートナー経由の本番ホスティングは、公開されたトークン単価ではなく、基盤となる計算資源で価格が決まります。
**結論:**すでにNVIDIAのインフラ上にいる、あるいは「本当にオープンなのか」という疑問がGraniteを離れる理由なら、Nemotronはリストの中で最も筋の通った乗り換えです。ハードウェアに合わせてサイズを選んでください。
このリストのすべてのモデルに共通すること
ベンチマークのスレッドで見落とされがちな点です。Granite、Qwen、DeepSeek、Nemotronのどれを選んでも、選んだのはエンジンです。モデル単体では、あなたの返金ポリシーを知らず、Zendeskのチケットを見ることもできず、いま生成した回答が実際の顧客に送って安全かどうかもわかりません。だからこそ、カスタマーサービス向けAIは単なるAPIキーではなく、製品カテゴリーなのです。
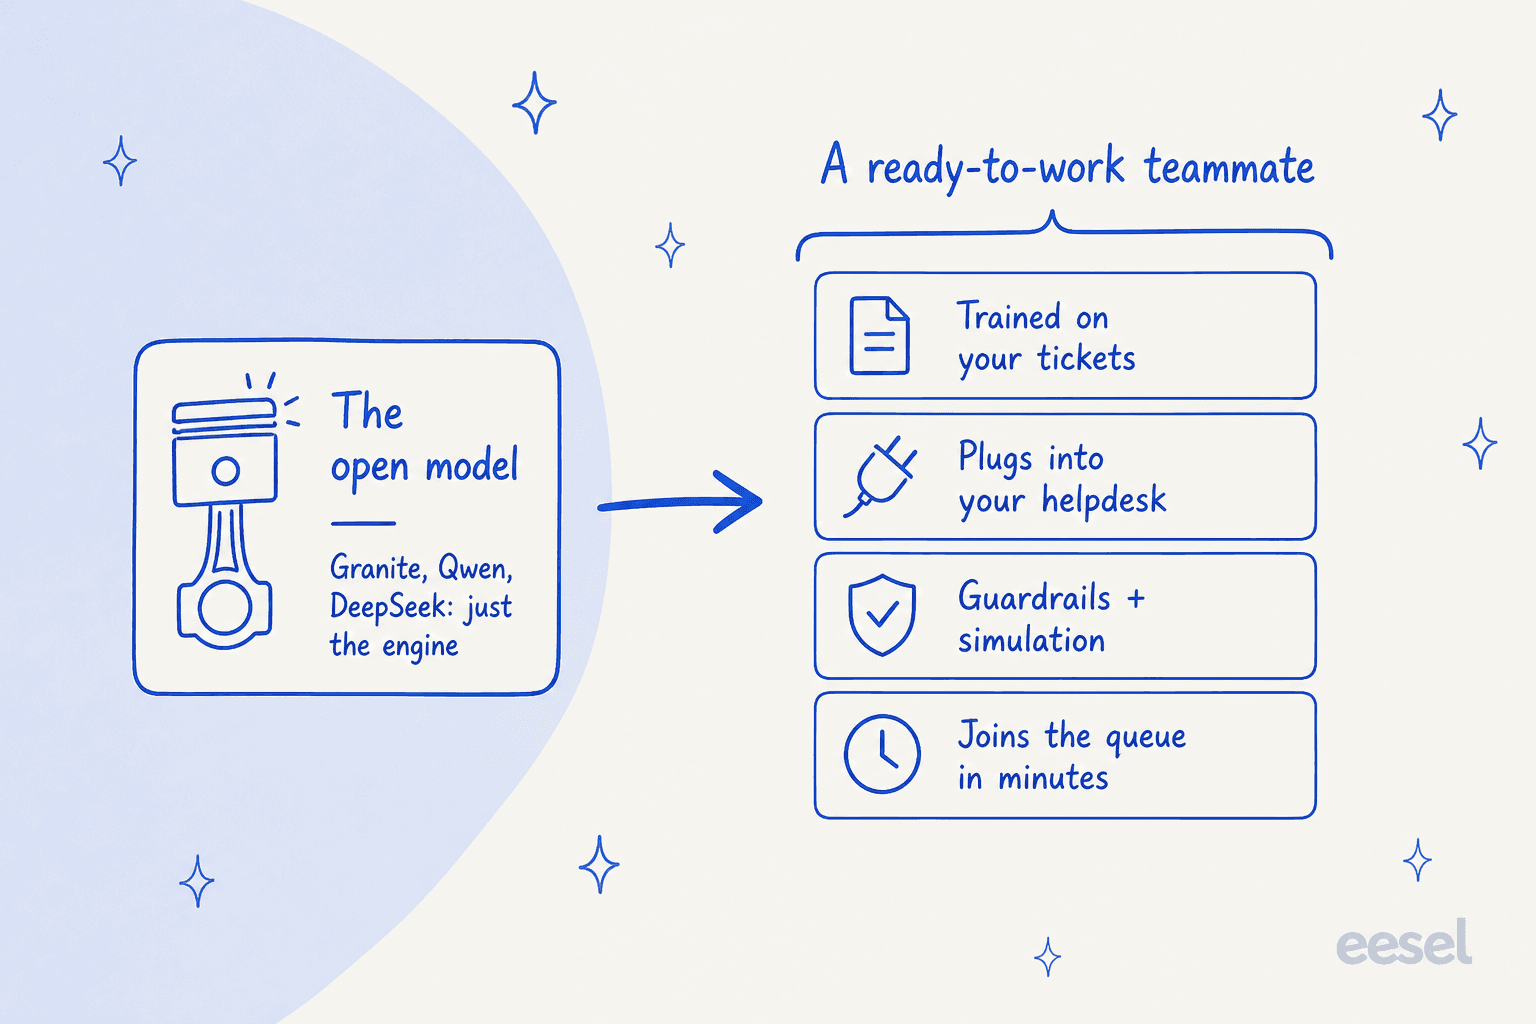
これらのモデルの中から何かを作るために選ぶなら、結構です。合うエンジンを選んで進めてください。ですが本当の目的がサポートチケットを解決する動くAIエージェントなら、GraniteをQwenに替えても変わるのは簡単な10%だけで、難しい90%は手つかずのままです。ナレッジベースへの接続、ヘルプデスクへの連携、ガードレールの作成、そして本番前に安全だと証明することです。これがAIエージェントとルールベースのチャットボットの違いであり、本当の作業はすべてそこにあります。
eeselを試す:このリストのどのモデルも提供しないレイヤー
目的がベースにするモデルを選ぶことではなく、チケットに回答することなら、eeselはまさにそのギャップを埋めます。上のどのモデルもエンジンを渡してくれるだけです。eeselはすでにエンジンを備え、さらにその周りのすべてを揃えた、すぐに働けるAIヘルプデスクのチームメイトです。過去のチケットとヘルプセンターで学習し、すでに使っているヘルプデスク(Zendesk、Freshdesk、Gorgias、そして1,000以上のその他の連携)に接続し、数四半期ではなく数分でキューに参加します。

違いは、Graniteなどの素のモデルには付いてこないセーフティネットです。eeselが実際の顧客に1件も回答する前に、何千件もの過去のチケットでシミュレーションして、どのように返信し、何を解決していたかを正確に確認できます。構築するなら、このリストのどのモデルでも使ってください。チケットに回答したいなら、AIヘルプデスクのチームメイトを使ってください。eeselは無料で試せます。クレジットカードも営業電話も不要で始められます。
よくある質問
IBM Granite 4.2 に代わる最良のオープンウェイトモデルは何ですか?
純粋な性能では、ローカルLLMコミュニティは一貫してQwenを挙げています。オープンな27BチェックポイントはApache 2.0で、コーディングではGraniteを上回ります。コストが決め手なら、DeepSeek V4 FlashはMITライセンスで、大規模運用ではより安く動かせます。どちらも上で詳しく取り上げており、関連記事のGranite 4.2 の概要もあわせてご覧ください。
Granite 4.2 より安い代替はありますか?
Graniteはすでに下限に近い価格です。重みはApache 2.0なので自己ホストは無料で、ReplicateのGranite 8Bは100万トークンあたり$0.06/$0.25です。ホスト型の料金では、GLM 5.3 Flashのプロモ価格($0.075/$0.25)が同水準で、DeepSeek V4 Flashのオフピーク出力は$0.66です。ただし、AIエージェントでコストがかかるのはモデルそのものではなく、ナレッジ、連携、ガードレールであることがほとんどです。
コーディングに最適な Granite 4.2 の代替はどれですか?
モデルをローカルで動かしている人の間では、コーディングならQwenが定番で、DeepSeek V4 Flashもスコアが良好です。Granite 4.2の30Bも信頼できる水準(SWE-Bench Verifiedで57.0)ですが、純粋なコード生成では多くのレビュアーが今もQwenを選びます。コーディングツールではなくサポート自動化向けのモデルを選ぶ場合は、サポートチケット向けのベストAIモデルのガイドをご覧ください。