

Gimlet Labsは、自ら「初のマルチシリコン推論クラウド」と呼ぶサービスを運営しています。かみ砕いて言うと、1つのAIワークロードを異なる種類のチップに分割するソフトウェアであり、モデルの各フェーズを最も得意なハードウェアで実行します。2026年9月4日、同社はAndreessen Horowitzが主導する3億ドルのシリーズBを評価額30億ドルで調達し、ArmとMicrosoftのベンチャー部門も参加しました。
30億ドルの値が付いた理由は、私がAIエージェントを作る立場として関心を持つ理由と同じです。エージェント型のワークロードは「1つのモデルに1つのGPU」という前提を崩します。エージェントは十数回のモデル呼び出しを順番につなぎ、呼び出しごとにハードウェアの異なる部分に負荷がかかります。Gimletの賭けは、各部分をそれが最も速いチップに振り分けるというものです。
主張は、同じ消費電力で推論が3〜10倍高速になるというものです。これはベンダーが報告した数値であり、後述するとおり健全な懐疑心を持つ価値があります。しかし根底にある問題は本物で、私たちがリリースするたびに実感しています。
Gimlet Labsとは?
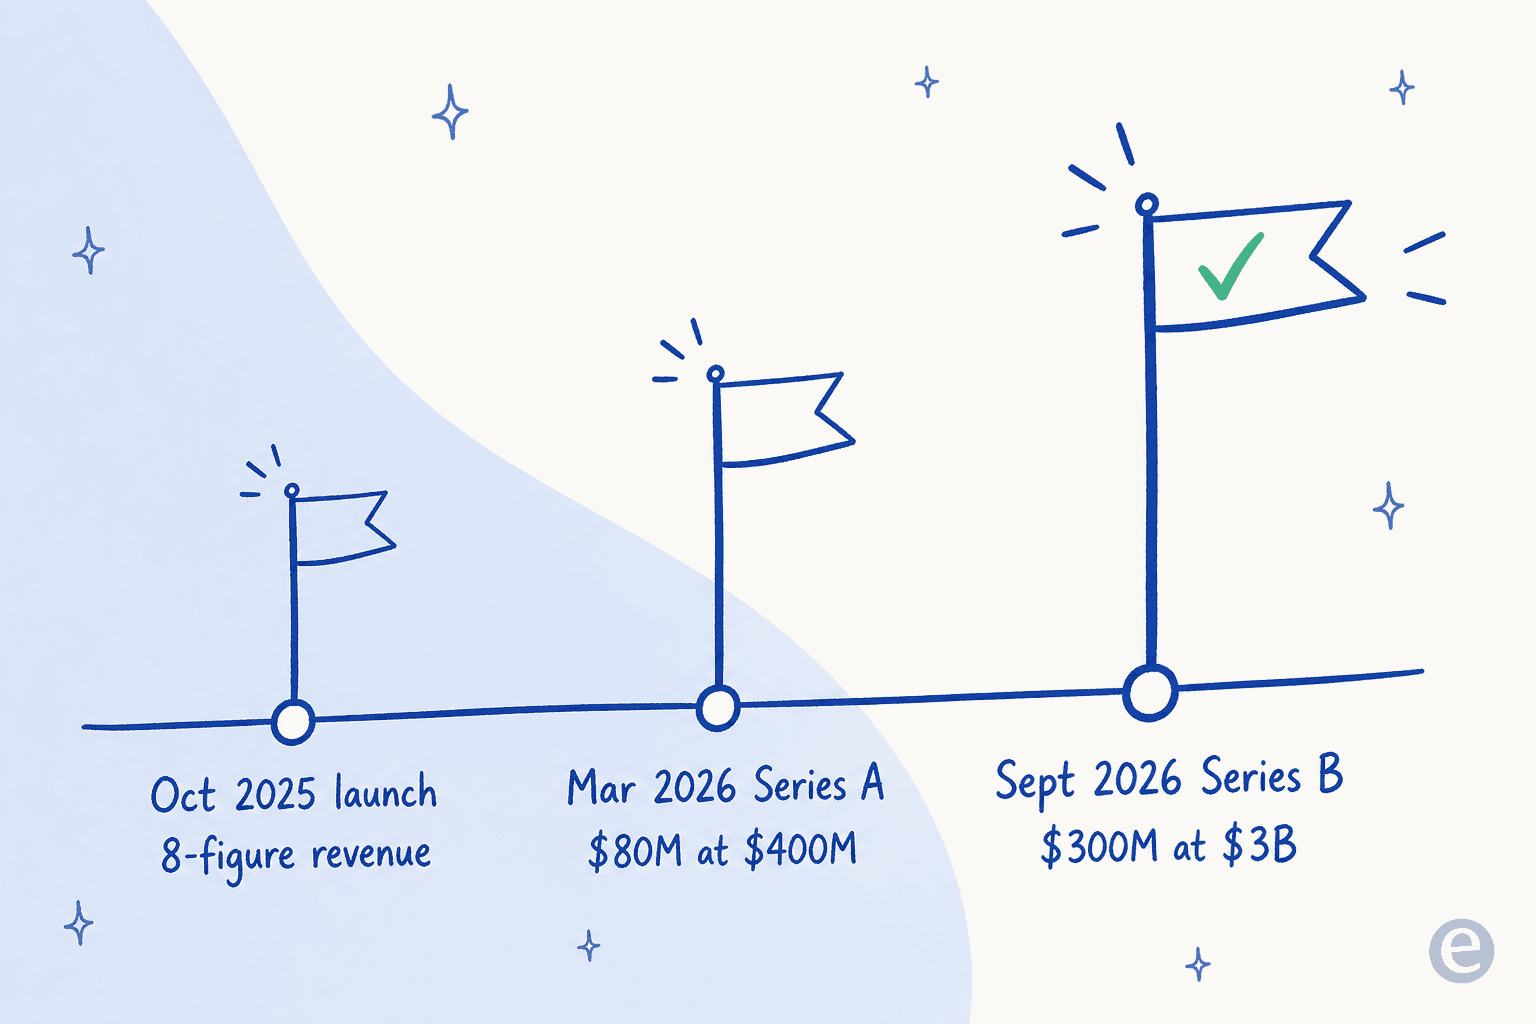
Gimlet Labsは、応用AI研究とプロダクトを手がける企業です。2025年10月に正式ローンチし、本人たちの説明では当初から8桁規模の売上があったとされ、これほど若い会社としては異例です。
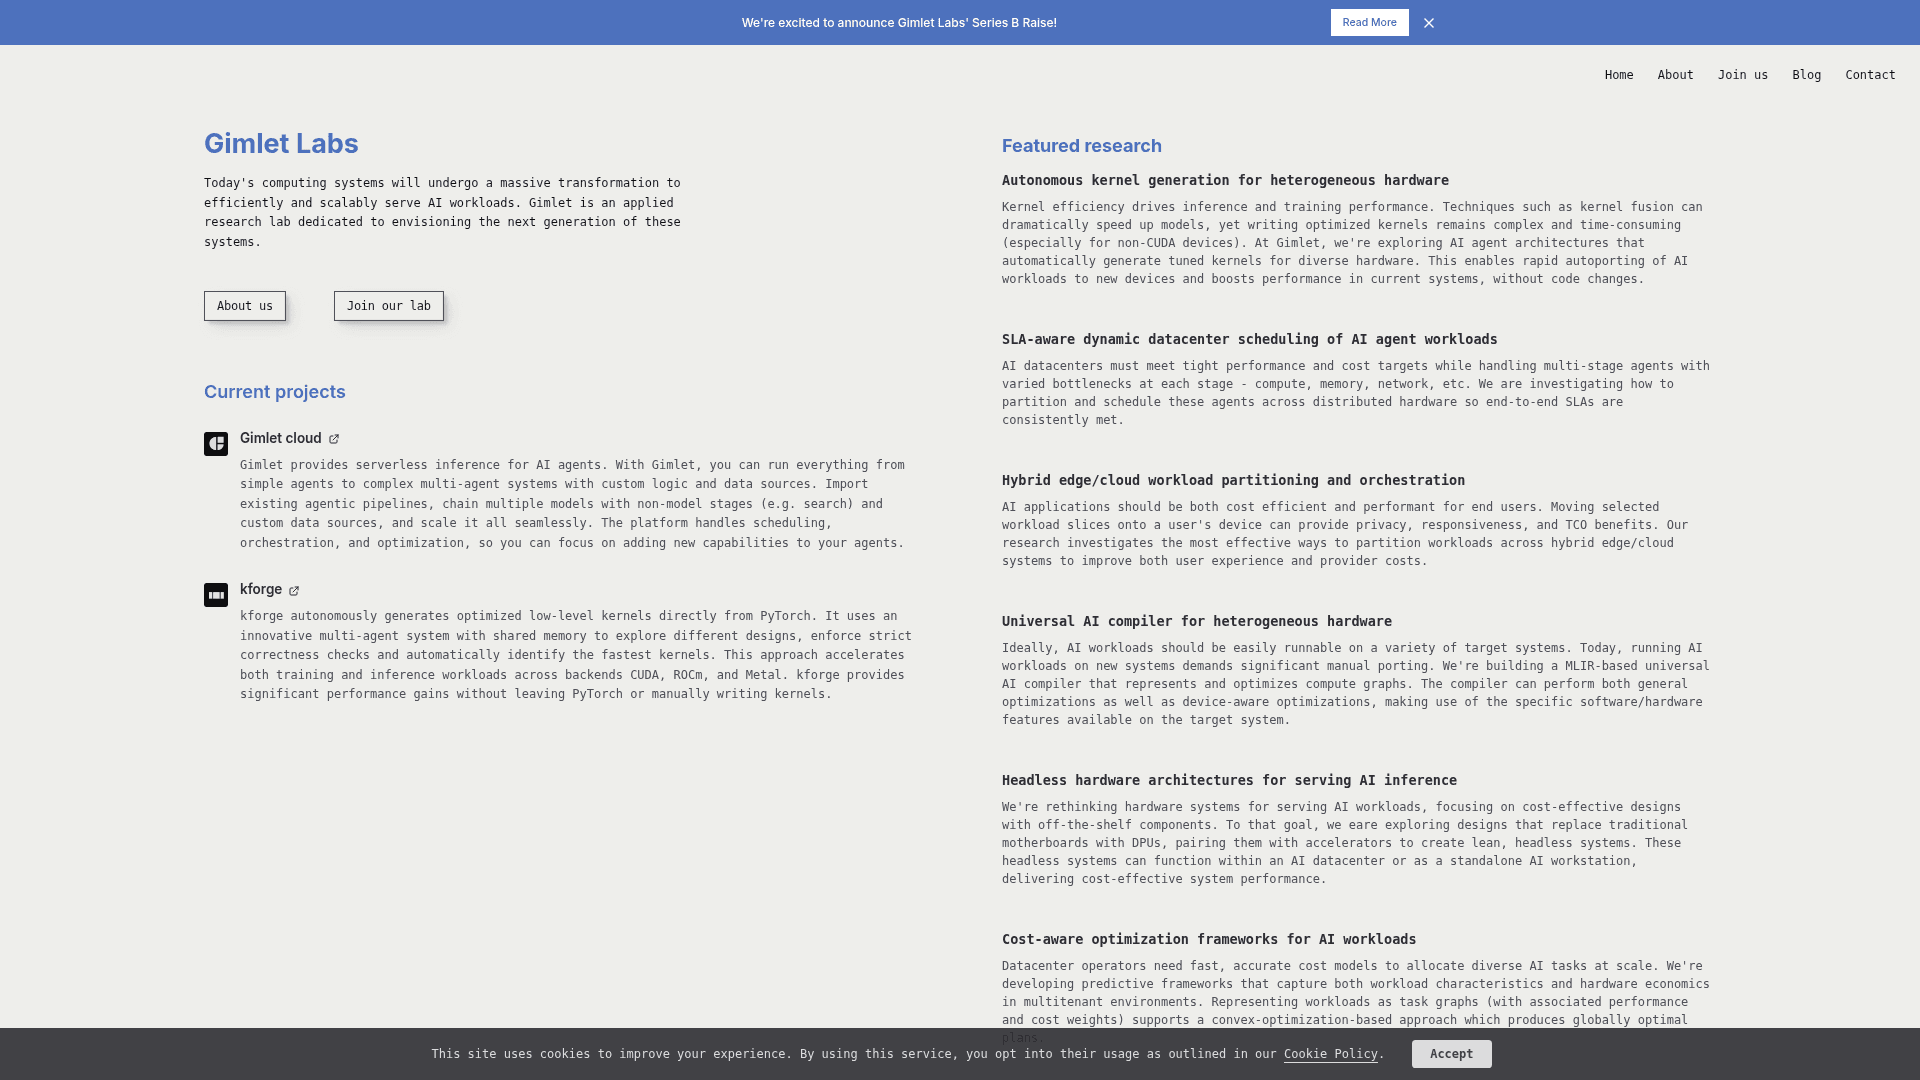
ホームページは、世界観を1文でまとめています。「Today's computing systems will undergo a massive transformation to efficiently and scalably serve AI workloads.」すべてはここから導かれます。借りたGPUの上でモデルが動くことを受け入れるのではなく、Gimletはモデルを多くの種類のチップに同時に分散させる層を構築します。
この構想を支える製品は2つあります。
- Gimlet Cloudは、AIエージェント向けのサーバーレス推論プラットフォームです。既存のエージェントパイプラインをインポートし、複数のモデルを検索などモデル以外のステップとつなぐと、スケジューリングとオーケストレーションはプラットフォームが処理します。
- kforgeは、より低レイヤーの部品です。PyTorchから直接、最適化されたカーネルを自動生成し、CUDA、ROCm、Metalの各バックエンドに対応します。カーネル設計を探索して正しさを検証するマルチエージェントシステムを使うため、エンジニアはカーネルを手書きせずに高速化の恩恵を得られます。
問題:エージェントが単一チップの推論を壊した
ここが全体を理解するカギであり、これが単なる資金調達の見出し以上の話だと考える理由です。
大規模言語モデルは、1種類の均一な作業をしているわけではありません。回答するとき、まずプロンプトを読み込みます(プリフィルフェーズ)。これは計算律速で、純粋な演算スループットを求めます。次にトークンを1つずつ生成します(デコードフェーズ)。これはメモリ帯域律速で、データをメモリに出し入れすることに時間を費やします。さらに現代のAIエージェントはそこで終わらず、ツールを呼び出し、APIを叩き、ドキュメントを取得します。これはネットワーク律速です。
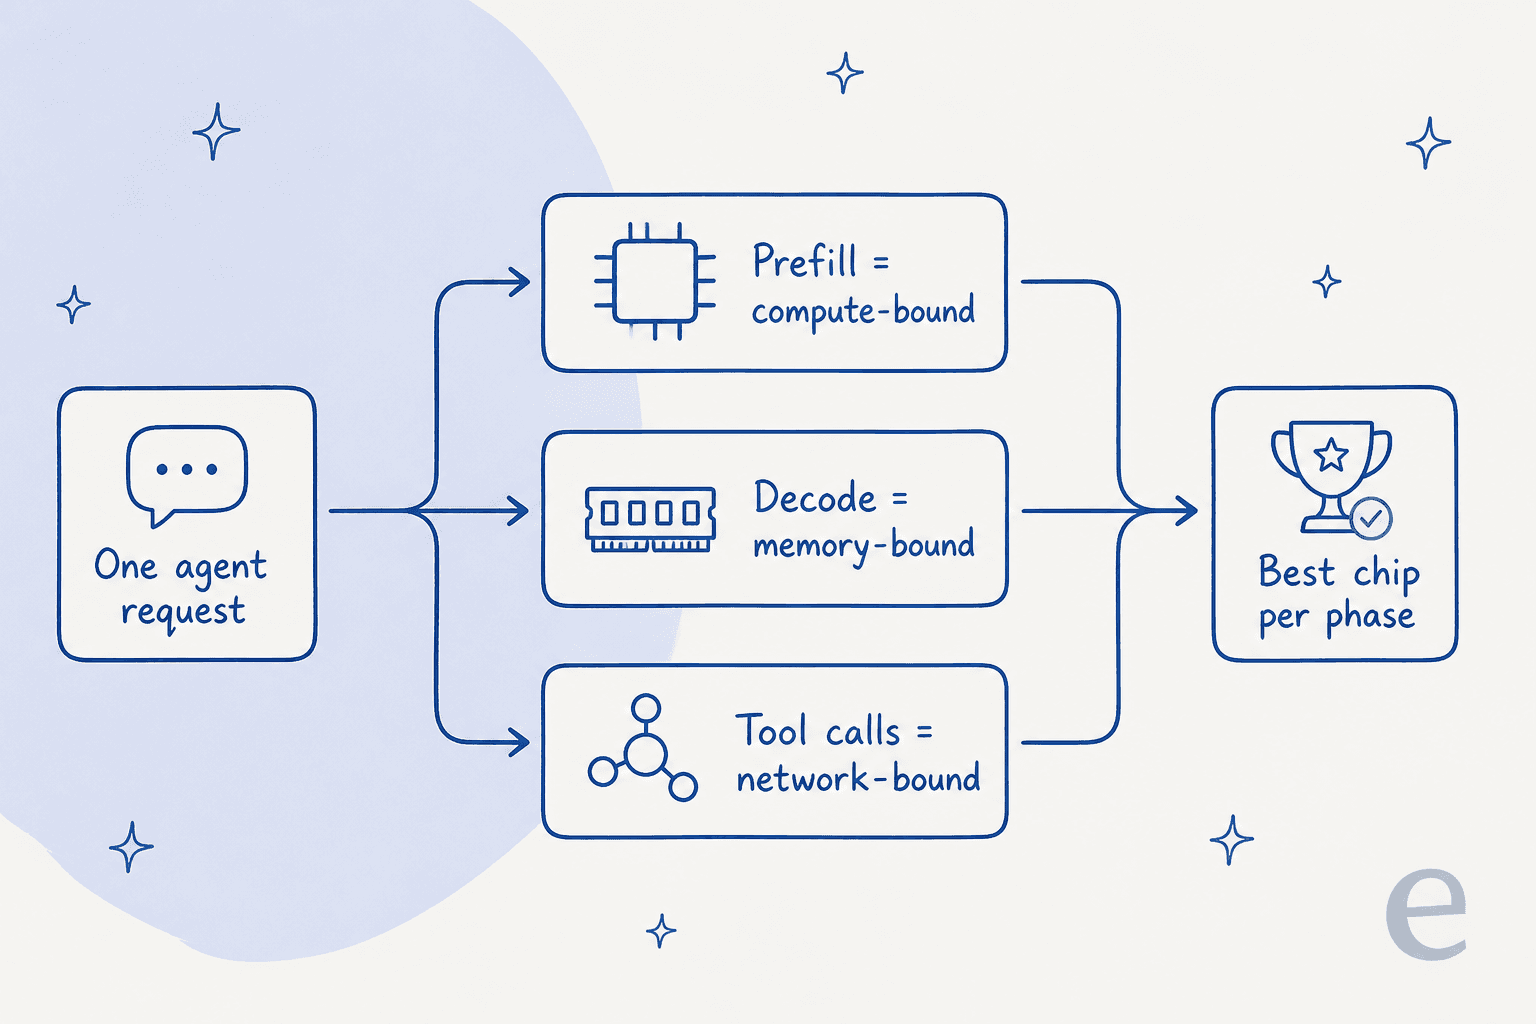
これらすべてを均質なGPUクラスタで動かすと、必ず何かが遊んでしまいます。デコード中は、高価な演算資源が半分しか使われません。ツール呼び出し中は、アクセラレータ全体がネットワークを待ちます。Gimletの主張は、シリーズBの発表にあるとおり、均質なハードウェアだけではエージェント型ワークロードの速度と効率の要求を満たせないというものです。エージェントがつなぐステップが増えるほど、その無駄は積み重なります。
これは私にとって抽象的な話ではありません。eeselでは、サポートチケットを解決するAIエージェントを作っていますが、1件の解決は連鎖です。チケットを読み、ナレッジベースを検索し、見つけた内容を踏まえて推論し、ときには注文照会APIを呼び、返信を書きます。各ステップでボトルネックが異なります。エージェント型プロダクトがなぜ遅く感じられることがあるのかと聞かれたら、これが大きな答えの1つです。
マルチシリコンクラウドの仕組み
Gimletの解決策は*ディスアグリゲーション(分離)*です。フェーズを切り離し、それぞれを最適なシリコンで実行します。プリフィルは計算向けに調整されたデバイス群で、デコードはメモリ帯域向けに調整された別の群で、というように。さらに投機的デコードとアテンション/フィードフォワードの分割を重ね、ハードウェアが空くのに合わせて動的に再配分します。
これを可能にするため、Gimletは一方に肩入れせず、チップ業界全体と提携しています。NVIDIAのチップに加え、AMD、Intel、Arm、Cerebras、d-Matrixとも連携しています。製品はソフトウェアであり、シリコンは交換可能です。「うちのアクセラレータを買ってください」という通常の話とは正反対で、だからこそArmはGimletを脅威とみなすのではなく、ラウンドに出資したのです。
Gimletが打ち出す効果は、同じ電力枠内での5〜10倍の高速化、または同じスループットでより低いレイテンシです。特に、1回のリクエストに数十回の連続したモデル呼び出しが必要になりうるエージェント型AIでは、各呼び出しでレイテンシを削ることで、複利が不利ではなく有利に働きます。
資金調達の経緯と、誰が賭けているのか
資金の出どころを見れば、誰がこれを信じているかが分かります。シリーズBはAndreessen Horowitzが主導し、シリーズAを主導したMenlo Ventures、Arm、M12、Samsung Ventures、Tiger Global、XTX Marketsなど多くの投資家が参加しました。Gimletは、3月以降に数十億ドル規模の契約済み売上を積み上げ、データセンターのパイプラインはギガワット単位だと述べています。
軌跡は急です。2026年3月に評価額約4億ドルで8,000万ドルのシリーズA、その6か月後に30億ドルへの跳躍です。どのラボもより安いLLM推論を追い求める市場で、より大きなモデルだけでなく効率こそが次の主戦場だという仮説は、投資家に明らかに響いています。
正直な留意点
評価額30億ドルや10倍という主張は、私が避けたいタイプの誇大宣伝を招きやすいので、公平を期したいと思います。
第一に、性能の数値はGimlet自身のものです。同社がAI生成のMetalカーネルについての記事を公開した際、Hacker NewsのあるPyTorchエンジニアが、的を射た妥当な異論を述べました。
「I work on PyTorch and there are many things that make me suspicious about these results. My TL;DR is unless we get a zip file of all the kernels with how they're benchmarked results like this are almost impossible to verify.」

これは酷評ではなく、Gimletのチームもスレッド内で応答しました。ただ、見方としては正しいものです。ベンチマークの高速化は、自分のワークロードで検証すべき主張であり、確定した結果ではありません。第二に、Gimletは顧客を公表しておらず、「a major model maker」「an extremely large cloud computing company」としか説明していません。第三に、これはラボやデータセンター向けのインフラです。プロダクトを作る立場なら、Gimletに直接触れることはおそらくなく、普段使うツールの裏側で、より速く安い推論として感じるだけでしょう。
AIで開発する人にとっての意味
では、最先端のラボを運営していない場合、これは何を意味するのでしょうか。
Gimletは、レイヤーケーキの良い例です。最下層にシリコン、中間にGimletが握ろうとしている推論層、その上にモデル、さらにその上に実際に採用する従業員がいます。Gimletはインフラです。エンジンの性能を高めますが、あなたの仕事をするものではありません。
この区別が、私のeeselに対する考え方そのものです。eeselはAIチームメイトのプラットフォームで、特定の仕事向けにすぐ働けるチームメイトを採用でき、現在のラインナップはAIヘルプデスクのチームメイトとAIブログライターです。ヘルプデスクのチームメイトは既存のサポートキューに加わり、過去のチケットとヘルプセンターから学び、Zendesk、Freshdesk、Gorgiasの中で会話を解決します。ブログライターはコンテンツで同じことをします。下にどの推論クラウドがあっても、仕事を最後までやり遂げるのはチームメイトです。

そしてGimletの世界は丸ごとエージェント型でプログラム可能なので、eeselもそうした読者のいる場所で応えていることも言っておく価値があります。eesel CLIは、同じヘルプデスクのチームメイトをターミナルから操作します。人が手で実行することも、スクリプトで自動化することも、Claude CodeやCursorのようなコーディングエージェントがCLIとMCPサーバー経由で操作することもできます。そのため、過去のチケットでロールアウトをシミュレートしたり実行をトリガーしたりする作業が、ダッシュボードのクリックではなく1つのコマンドで済みます。また、もう1つ仕様書を読むより実際のチケットを解決するところを見たいなら、eeselを無料で試し、数分で自社のヘルプセンターにつなげられます。
まだ検討の初期段階で選択肢を比べているだけなら、30億ドルの推論クラウドよりも、おすすめのAIエージェントやAIチケット分類のまとめ記事から始めるほうが適しています。
まとめ
Gimlet Labsは、本物で地味な問題を解決する興味深い会社です。AIの下にあるハードウェアは、エージェントが実際に動く方法とかみ合っておらず、それを直すソフトウェアを誰かが作る必要がありました。30億ドルの評価額は、推論効率が次の大きな戦いになるという賭けであり、エージェント型AIの成長の速さを考えれば、突飛な賭けではありません。
ただし、速度の主張は独立した検証が済むまで話半分に受け止め、自分が実際にどの層を買っているのかを忘れないでください。Gimletはエンジンを速くします。仕事を片付けるのは、その上にいるチームメイトです。