

要点
Qwen 3.8 Flash Nextは、Qwenチームが次世代のQwen4アーキテクチャをオープンウェイトで公開したプレビュー版です。1週間動かしてみた私の結論はこうです。いま手に入る中で最もコストあたりの知能が高いモデルの1つであり、同時にQwenがあえて学習不足にした研究用プレビューでもあります。この2つは同時に成り立ちます。
優れている点は本物です。1トークンあたり6Bパラメータしか有効化しない125BのMixture-of-Expertsモデルなので、同サイズの密なモデルでは到底載らないハードウェアでも高速に動きます。ホスト版の料金は100万トークンあたり入力$0.15 / 出力$0.47と非常に安価です。Artificial Analysisは、このクラスの知能で111モデル中5位と評価しています。
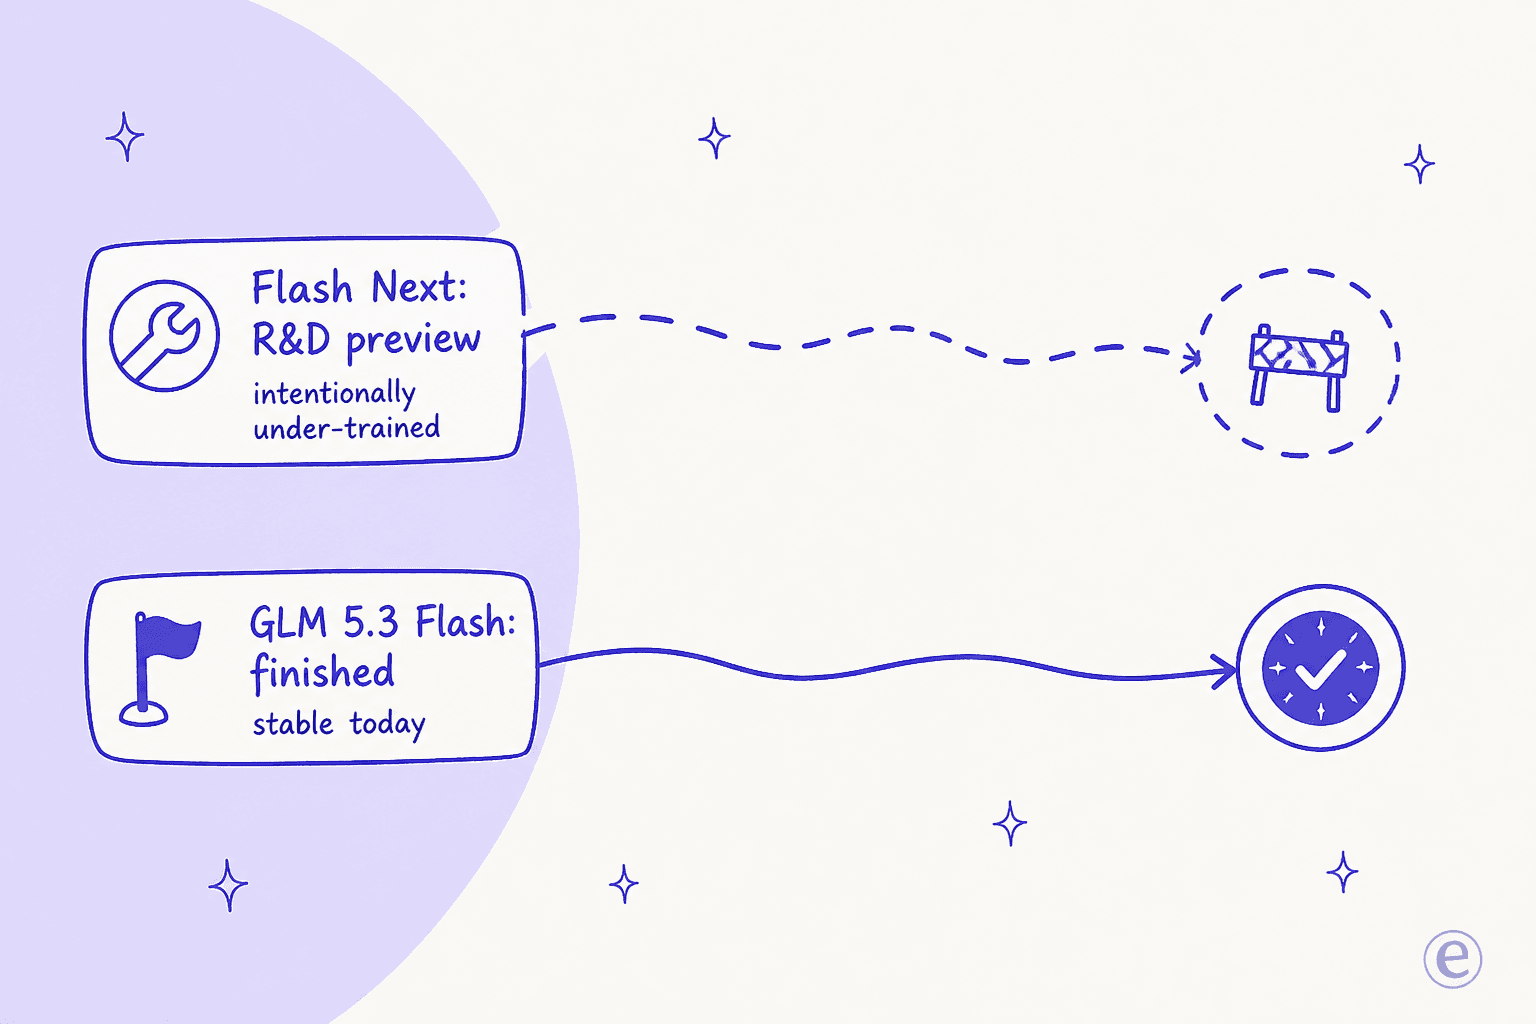
欠点も同じくらい本物です。Qwen自身が意図的に学習不足だと述べており、ローカルで動かすための低ビット量子化は目に見えて品質を損ない、さらに非常に冗長なので、出力トークンの請求額をじわじわ押し上げます。この重量級で今日完成したモデルが欲しいなら、GLM 5.3 Flashのほうが無難です。
そして、カスタマーサポート向けの安価なAIを探してここに来たのなら、モデルは簡単な部分です。生のモデルはチケットを読まず、返信も作成しません。それはプラットフォームの仕事であり、eeselがこうしたモデルの上で担う部分です。
実際に何をレビューしたのか
私はeeselでAIエージェントを作っているので、モデルの登場は傍観するものではなく仕事上の課題です。問いは常に「実際のワークロードの前に置けるか」です。Qwenチームが2026年8月26日にQwen 3.8 Flash Nextを公開したとき、最初の1時間は名前の整理に費やしました。紛らわしいからです。
整理するとこうです。Qwen3.8-Flash-Nextはセルフホストするオープンウェイトのプレビュー版で、Qwen3.8-Flashは近日公開予定のホスト型APIであり、100万トークンのコンテキストと組み込みツールを備えます。「Next」はより大きなFlashという意味ではありません。Qwenがアーキテクチャのプレビューにつけるラベルで、Qwen4ファミリー全体が築かれる前に、コミュニティが新しい仕組みを試せるよう公開されたものです。以下の評価はすべて、この一語にかかっています。
この前提が重要なのは、「学習不足のプレビュー版」という批判が私の作り話ではないからです。これはQwen自身の説明で、コミュニティが集まる場所ならどこでも繰り返されていました。最も明快な説明はHacker Newsのローンチスレッドにありました。
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

したがって、公平なレビューの仕方は「これは最高のモデルか」ではなく、「アーキテクチャへの賭けは報われているか、そしてこの特定のチェックポイントは動かす価値があるか」です。問いが違えば、答えも違います。
本当に優れている点
主要な数値は独立した検証にも耐えており、これは本来あるべき姿よりも珍しいことです。Artificial AnalysisはFlash NextにIntelligence Indexで56点、このクラスの111モデル中5位を付けており、中央値は29です。彼らの評価は「amongst the leading models in intelligence and reasonably priced」。Indexの1タスクあたり約$0.10なら、コスト面の魅力は誇張ではありません。
Qwen自身のベンチマーク表は、ベンダー報告値として読むべきですが、コーディングとエージェント系の作業で特に強い結果を示しています。
| ベンチマーク | Qwen3.8-Flash-Next | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 55.8 | 56.0 | 53.4 |
| LiveCodeBench v6 | 91.9 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 90.3 | 90.8 | 91.3 |
| IFBench(指示追従) | 81.3 | 79.1 | 79.2 | 62.5 |
| CoWorkBench(長時間のオフィス作業) | 73.9 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 34.7 | 33.8 | 40.0 |
出典:Qwenのベンチマーク表。率直な読み方は2つあります。まず、SWE-bench Proではるかに大きなモデルを上回っており、このサイズでは本物の成果です。ただし完勝ではありません。Humanity's Last ExamではClaude Opus 4.6が上で、リポジトリ規模の生成ではDeepSeek V4 Flashが上回ります。
2つ目の本物の強みはハードウェア効率で、コミュニティが実際に気にしているのはここです。1トークンあたりのアクティブパラメータが6Bだけで、51BのN-gramルックアップテーブルを通常のシステムRAMにオフロードできるため、約180Bクラスのモデルを控えめなマシンで動かしている人がいます。ツール系のコミュニティはすぐに反応しました。
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
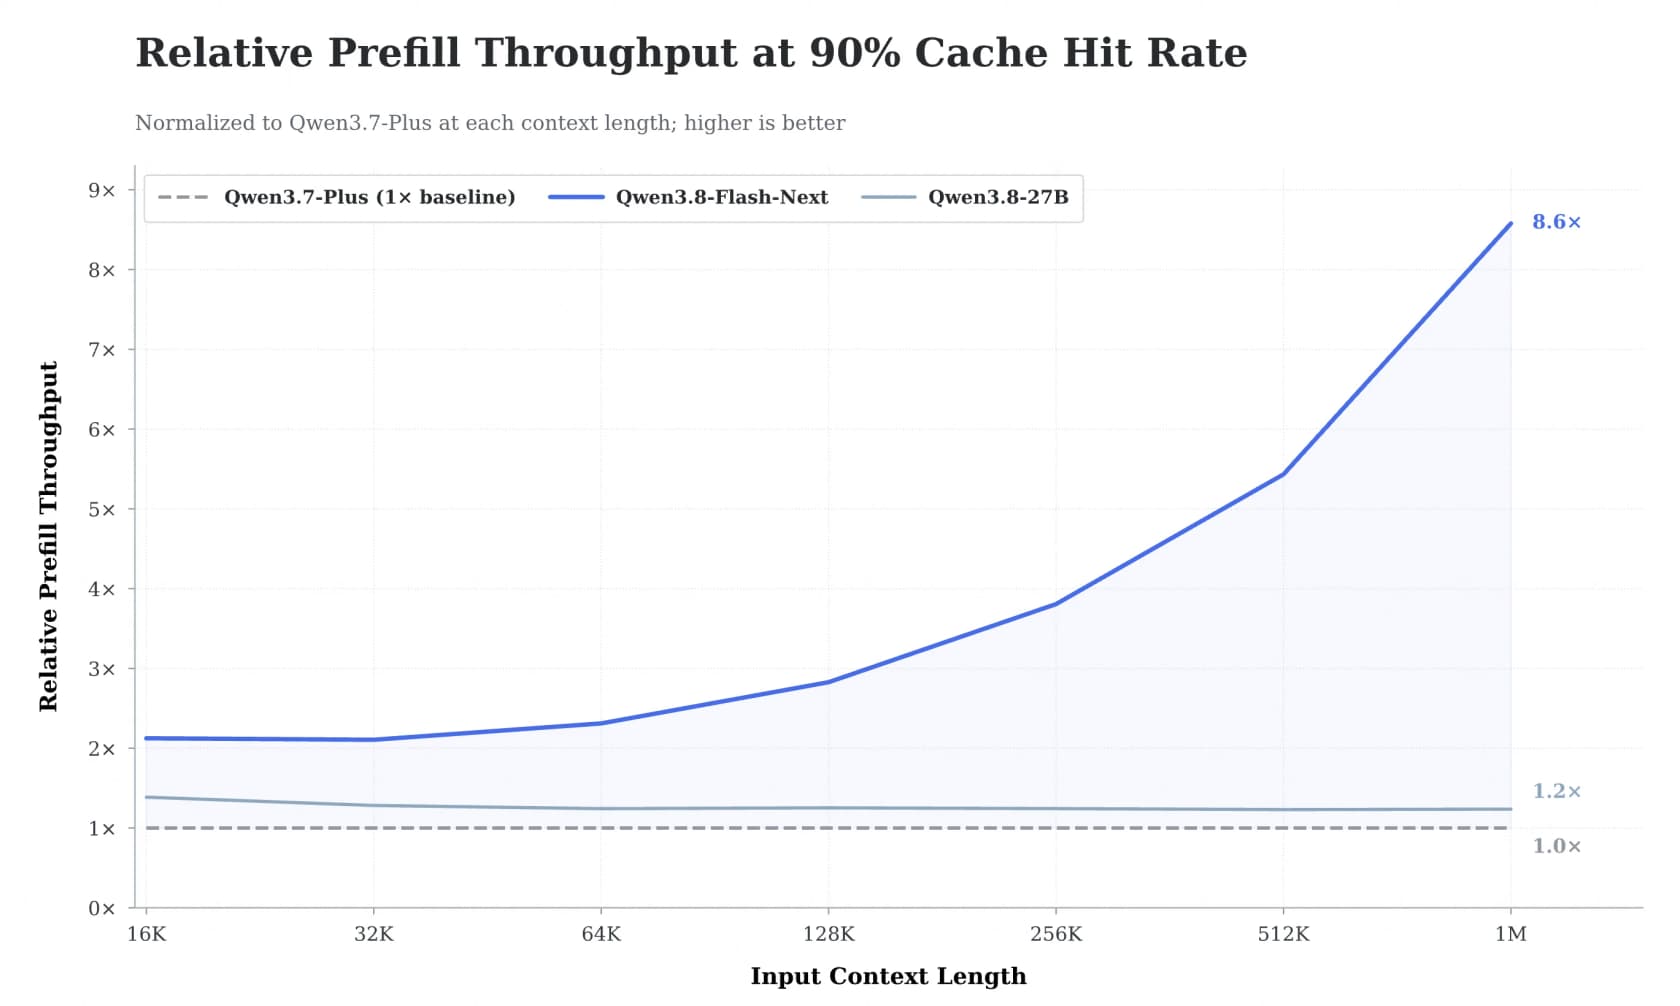
「Opus 4.6を上回る」という部分は、彼ら自身の未検証の主張なので、ベンチマークで裏付けられた事実ではなく熱量として受け止めてください。しかし、安価なハードウェアで高速に動くという主張は本物で、繰り返し報告されています。長いコンテキストでは効果が最も大きく、Qwenはスパースアテンションカーネルが100万トークンでプリフィル最大7.6倍、デコード最大4.9倍の高速化を達成したと報告しています。
プレビュー版らしさが出る部分
ここからは、本番投入を見送らせる点です。
量子化は目に見えて効いてきます。 約180Bクラスのモデルを民生用ハードウェアに収めるには強く量子化する必要があり、品質への影響は微妙ではありません。Simon WillisonはDGX Sparkで複数の推論レベルで試し、結局より小さな密なモデルのほうが好みだったと述べています。
"I ran some pelicans at the four different reasoning levels... Surprised I didn't get one I liked as much as the Qwen 3.8 27B one, maybe because of quantization."
これは私が読んだローカル実行のスレッドすべてに共通するテーマです。アーキテクチャのおかげで安く動かせるのであって、手元のマシンに詰め込んだチェックポイントがベンチマーク表どおりになる保証はありません。
考えすぎます。 多くのQwen推論モデルと同様に、Flash Nextもよく考え込み、それは思考トレースに表れます。
"It's definitely a heavy thinker, like most Qwens. I see strings like 'write, now.' in the thinking traces then it goes on to think for a lot longer, so it's kind of weird."
これは、このレビュー全体で最も鋭い実用上の警告につながります。
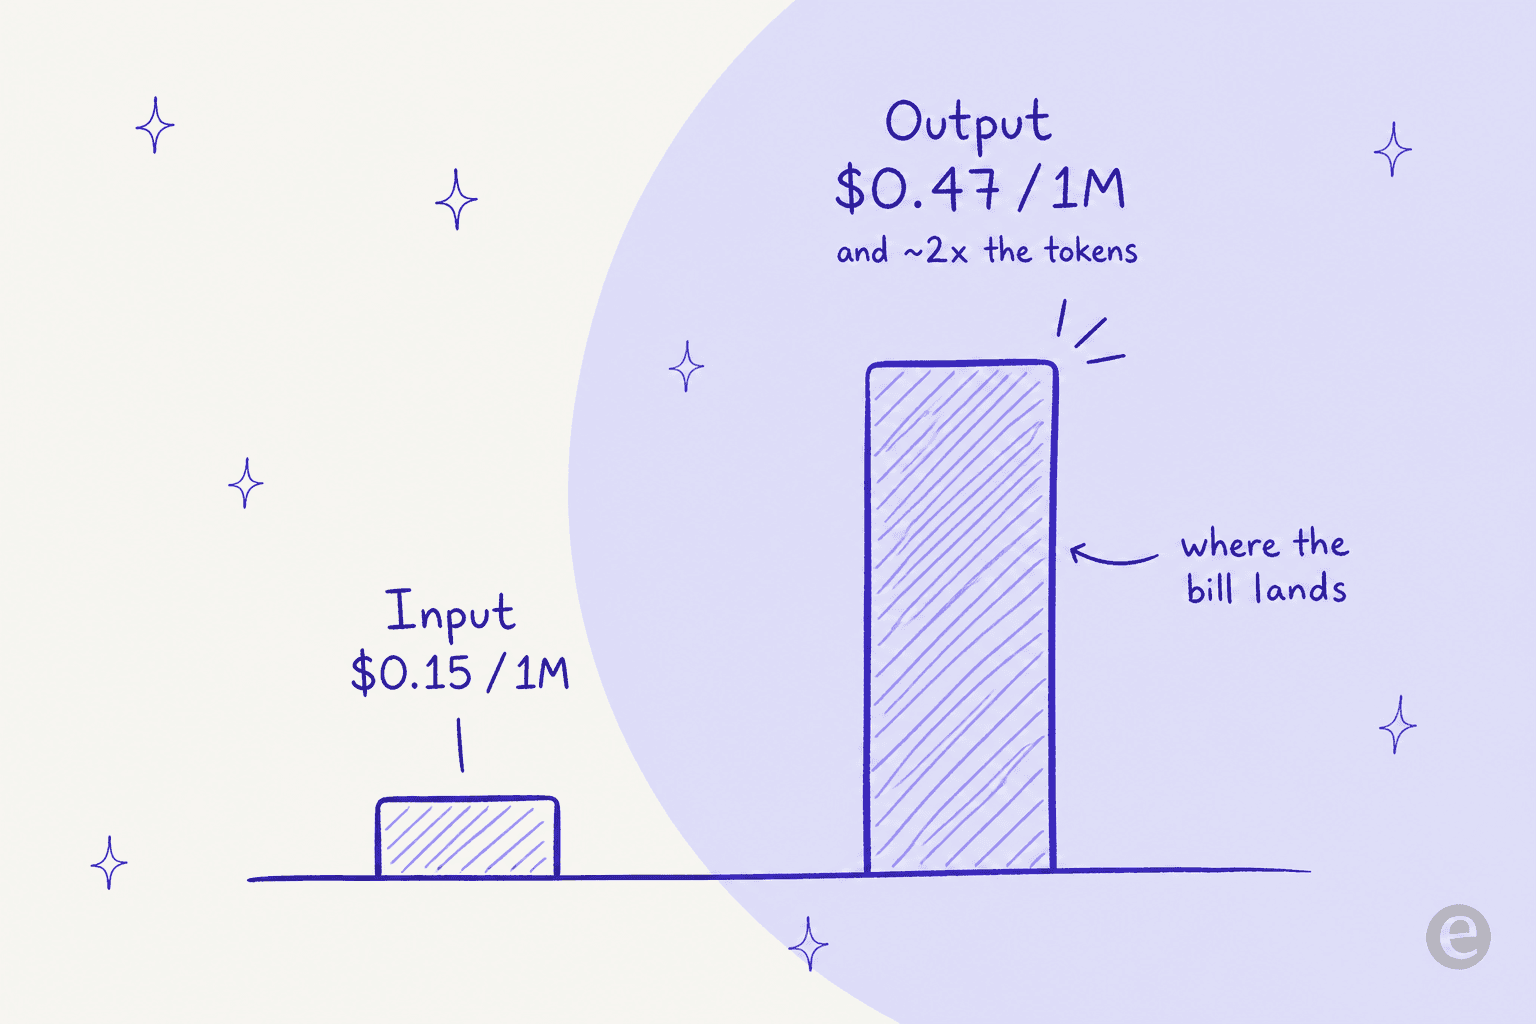
冗長な出力によるコストの落とし穴。 Artificial Analysisはこれを「very verbose」と指摘しており、Indexを完走するのに出力トークンを2億使い、中央値の1.1億の約2倍でした。ホスト型APIでは出力が100万トークンあたり$0.47で課金されるため、入力が安いという見出しの裏に、長いエージェント実行では本物の出力コストが隠れています。短いサポート返信なら誤差ですが、複数ステップのエージェントループでは、これが実際のコストを決める数字です。表示価格を信じる前に、出力トークンを見積もってください。
実際のコスト
オープンウェイトは無料です。ハードウェアがあれば、支払うのは計算コストだけで、セルフホスティング派にとってはこれが最大の魅力です。
ホスト型のQwen3.8-Flash APIは、Qwen 3.7 Flashにあったコンテキスト長ごとの区分がなく、料金は一律です。
| 項目 | 料金(USD / 100万トークン) |
|---|---|
| 入力 | $0.15 |
| 出力 | $0.47 |
| 入力(キャッシュ読み取り) | $0.016 |
| 明示的なキャッシュ作成 | $0.20 |
キャッシュ読み取りは新規の入力より約89%安く、これは理論上の話ではありません。OpenRouterは実トラフィックで91.1%のキャッシュヒット率を観測しており、実効入力単価は100万トークンあたり約$0.028まで下がります。冗長さのほかにもう1つ注意点があります。現時点でAPIプロバイダーはAlibaba Cloud Internationalの1社のみで、複数プロバイダーへのフェイルオーバーはまだありません。最後の1セントより耐障害性を重視するなら、Kimi K3やQwen 3.8 Maxと比べて検討してください。
で、使うべきか?
1週間使った上での私の結論です。下の2つの質問をたどれば、自然に整理されます。
自分のハードウェアでモデルを動かしたい
強くおすすめします。ユニファイドメモリのMac、DGX Spark、あるいはシステムRAMが豊富なマシンは、この設計が最も活きる環境です。VRAMに近い速度が期待できますが、量子化による品質低下は覚悟してください。考えすぎを抑えるには、推論予算のフラグを調整しましょう。
安くてコーディング中心のホスト型APIが欲しい
はい、ただし慎重に。SWE-benchの数値は本物で、キャッシュ入力の価格も優秀です。まず出力トークンを見積もってください。請求額が実際に膨らむのは冗長さのところで、現状プロバイダーが1社だけという点も忘れずに。
今すぐ本番で使える安定したモデルが必要
見送りましょう。Qwen自身が学習不足のプレビュー版と呼んでおり、実際そのように動作します。Qwen4の完全なラインナップが出るまでは、GLM 5.3 Flash、Claude Opus 5クラス、またはQwen 3.8 Maxを選びましょう。
おすすめなのは、ローカル推論を楽しむ人、Qwen4アーキテクチャをいち早く見たい人、低価格と強力なSWE-benchの数値が活きるキャッシュ向きのコーディング用途がある人です。見送るべきなのは、今日すぐ本番品質のモデルが必要な人です。Qwen自身が認めるとおり学習不足のプレビュー版であり、量子化は品質を損ない、ホスト型APIのプロバイダーも1社だけだからです。
どちらにしても、より重要なのはモデルとは結局何かという点です。それは部品にすぎません。「安いAI」を探しているチームに、私が何度も説明しなければならないことです。
このようなモデルは実際のサポート業務のどこに収まるか
こうしたリリースを読んで、「よし、サポート受信箱をQwen 3.8 Flash Nextに向ければAIの請求額を減らせる」と考える人は多いです。それはカテゴリの誤りです。生のモデルはトークンを受け取り、トークンを返すだけです。返金ポリシーを知らず、顧客の注文履歴を読めず、自信満々の回答が実際に正しいかどうかも分かりません。モデルはインフラであり、仕事をするのは従業員です。
そのギャップが最悪の形で表れるのを見てきました。あるお客様の初期、ナレッジベースに「全モデルに対応」と書かれていたせいで、ボットはデータベースにないブランドの購入者にも「はい、お客様の車種に対応しています」と得意げに答えていました。解決策は、より良いベースモデルではありませんでした。より良い検索、より厳密な根拠づけ、そして本番前の実際の履歴でのテストでした。この段階についてチーム自身がまとめた言葉は「最初は試行錯誤」で、生のまま信頼すると、まっさらで学習不足のモデルはまさにその段階へ引き戻します。
その従業員の層こそ、私たちがeeselで作っているものです。考え方は単純で、eeselはAIチームメイトのプラットフォームであり、特定の仕事のためにすぐ働けるチームメイトを採用します。現在はAIヘルプデスクのチームメイトとAIブログライターです。それぞれが役割に必要なスキル、連携、会社のコンテキストを備えて着任するため、裏でどのモデルが動くかはあなたの問題ではなく、実装の詳細になります。

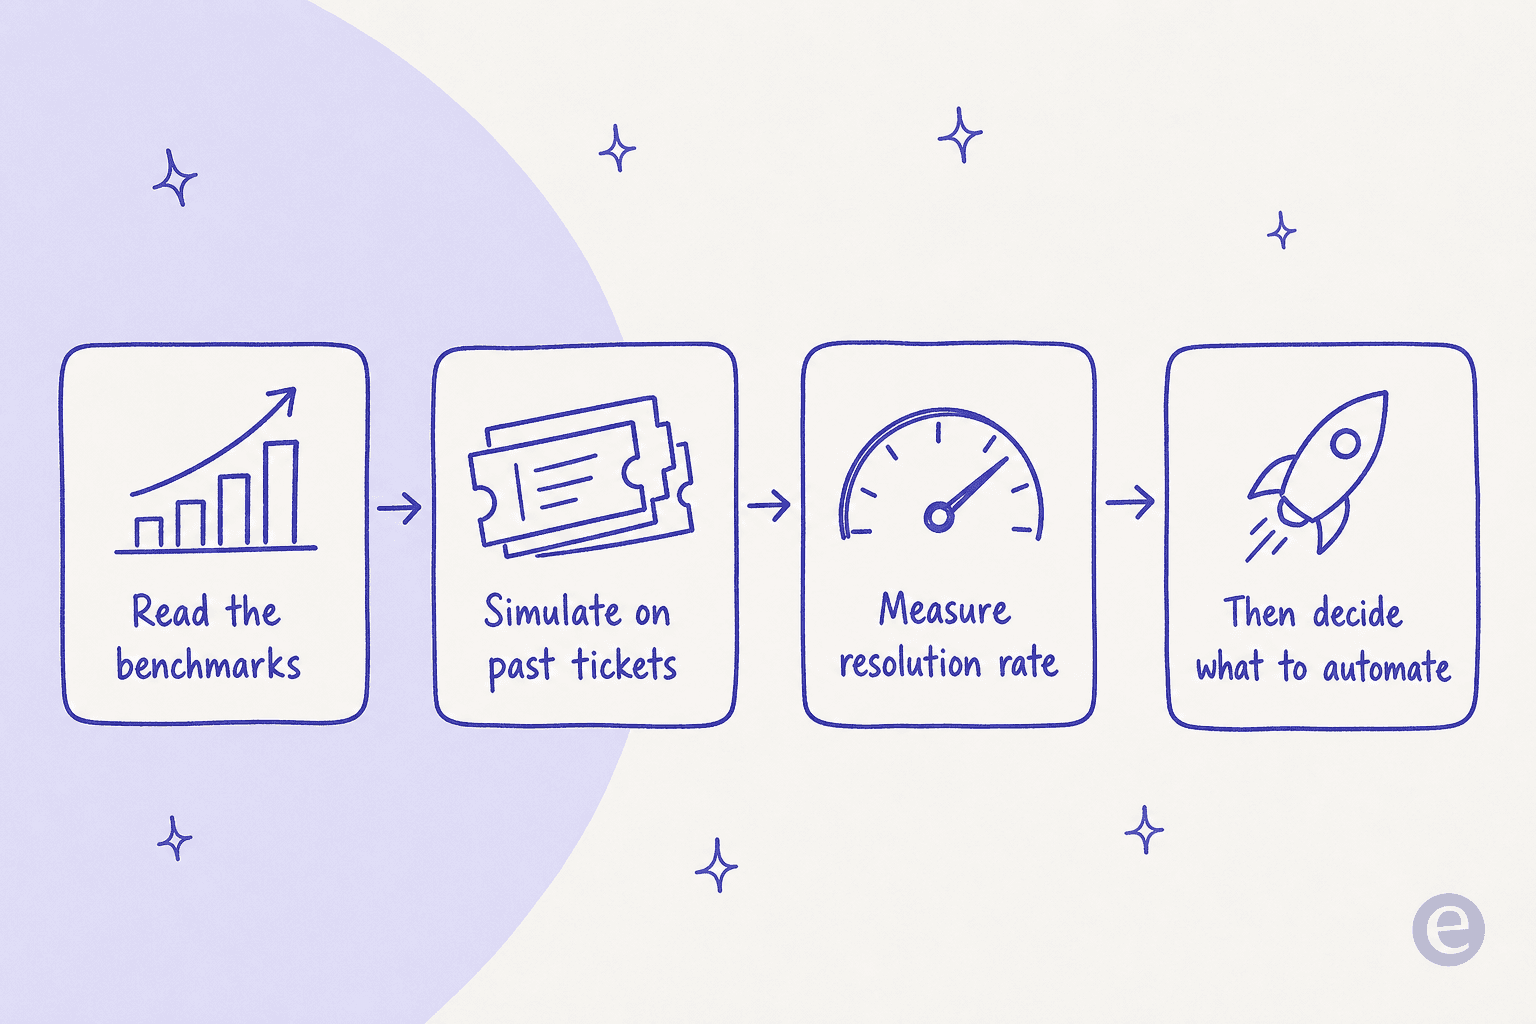
最も強調したいのはテストです。それが人を救うのを見てきたからです。eeselのヘルプデスクチームメイトは、実際の顧客に触れる前に、過去のチケットに対してすべてのロールアウトをシミュレーションします。実際の過去の会話で送っていたはずの正確な返信と解決率を確認してから、何を自動化するかを決められます。学習不足のプレビュー版モデルは、ベンチマーク表を信じるのではなく、まさにこの関門を通したいタイプのものです。さらに、eeselは既存のナレッジベースと過去のチケットから読み込むため、生のモデルが単独では決して解決できないコンテキストの問題にも対応できます。
要するに、Qwen 3.8 Flash Nextのようなモデルは急速に安く高性能になっていて、それは素晴らしいニュースですが、1つ選ぶのは仕事の簡単な10%にすぎません。残りの90%は、それをチケットを解決するチームメイトに仕立てることで、時間をかける価値があるのはその層です。
eeselを試す
サポート業務向けにQwen 3.8 Flash Nextを検討してここに来たなら、正直なアドバイスは、モデル探しをやめて自分のチケットでテストを始めることです。eeselは既存のヘルプデスクに接続し、ナレッジベースと過去の会話から学習し、本番前にすべてのロールアウトを過去のチケットでシミュレーションして、実際の解決率を確認できます。無料で試せて、裏のモデルはあなたではなく私たちの問題のままです。