

Qwen 3.8 Flash Nextは、Qwenチームが次世代Qwen4アーキテクチャのオープンウェイトプレビューとして2026年8月26日に公開したモデルです。名前が紛らわしいので、まずここから押さえてください。Flash Nextは自分でホストするオープンウェイトの研究プレビューで、Qwen3.8-Flashは近く登場するホスト型APIで、100万トークンのコンテキストウィンドウと組み込みツールを備えます。同じモデルの二つの顔です。
注目すべきはスペックです。125BのMixture-of-Expertsモデルで、トークンごとに有効化するのは6Bパラメータだけ。そこに、通常のシステムRAMへオフロードできる51BのN-gramルックアップテーブルが組み合わさっています。この設計のおかげで、同サイズの密なモデルでは到底載らないハードウェアでも高速に動き、ホスト版は100万トークンあたり入力$0.15 / 出力$0.47という価格を実現しています。
独立したテストも、ある程度まではその期待を裏付けています。Artificial Analysisは、価格あたりの知能で上位数モデルに入ると評価しています。ただし、どのコミュニティのスレッドでも繰り返されている注意点があります。これは意図的に学習を抑えたR&Dプレビューであり、完成した本番用モデルではないということです。今すぐ安定したものが必要なら、より磨かれたライバルはGLM 5.3 Flashです。
カスタマーサポート向けの安価なAIを探してここに来たのなら、モデル選びは簡単な部分です。素のモデルはチケットを読まず、返信を下書きせず、エスカレーションもしません。それはプラットフォームの仕事であり、まさにeeselがこうしたモデルの上で担っている役割です。
Qwen 3.8 Flash Nextとは実際に何か
私はeeselでAIエージェントを作っているので、モデル層が数週間ごとに入れ替わるのを見ていて、ローンチ時のグラフの向こう側を読む癖がつきました。そのため、Qwenチームが2026年8月26日にQwen 3.8 Flash Nextを公開したとき、まず名前を整理しました。本当に分かりにくいからです。
整理するとこうです。「Flash」はQwenの安価で高速なティアです。「Next」はより大きい、あるいはより新しいFlashという意味ではありません。QwenがQwen3.5の前にQwen3-Nextに与えたのと同じ役割で、アーキテクチャのプレビューに付けるラベルです。Flash Nextは、Qwen4ファミリー全体がその上に作られる前に、コミュニティが新しい仕組みを試せるように存在しています。
この実務上の区別は、できることが変わるので重要です。
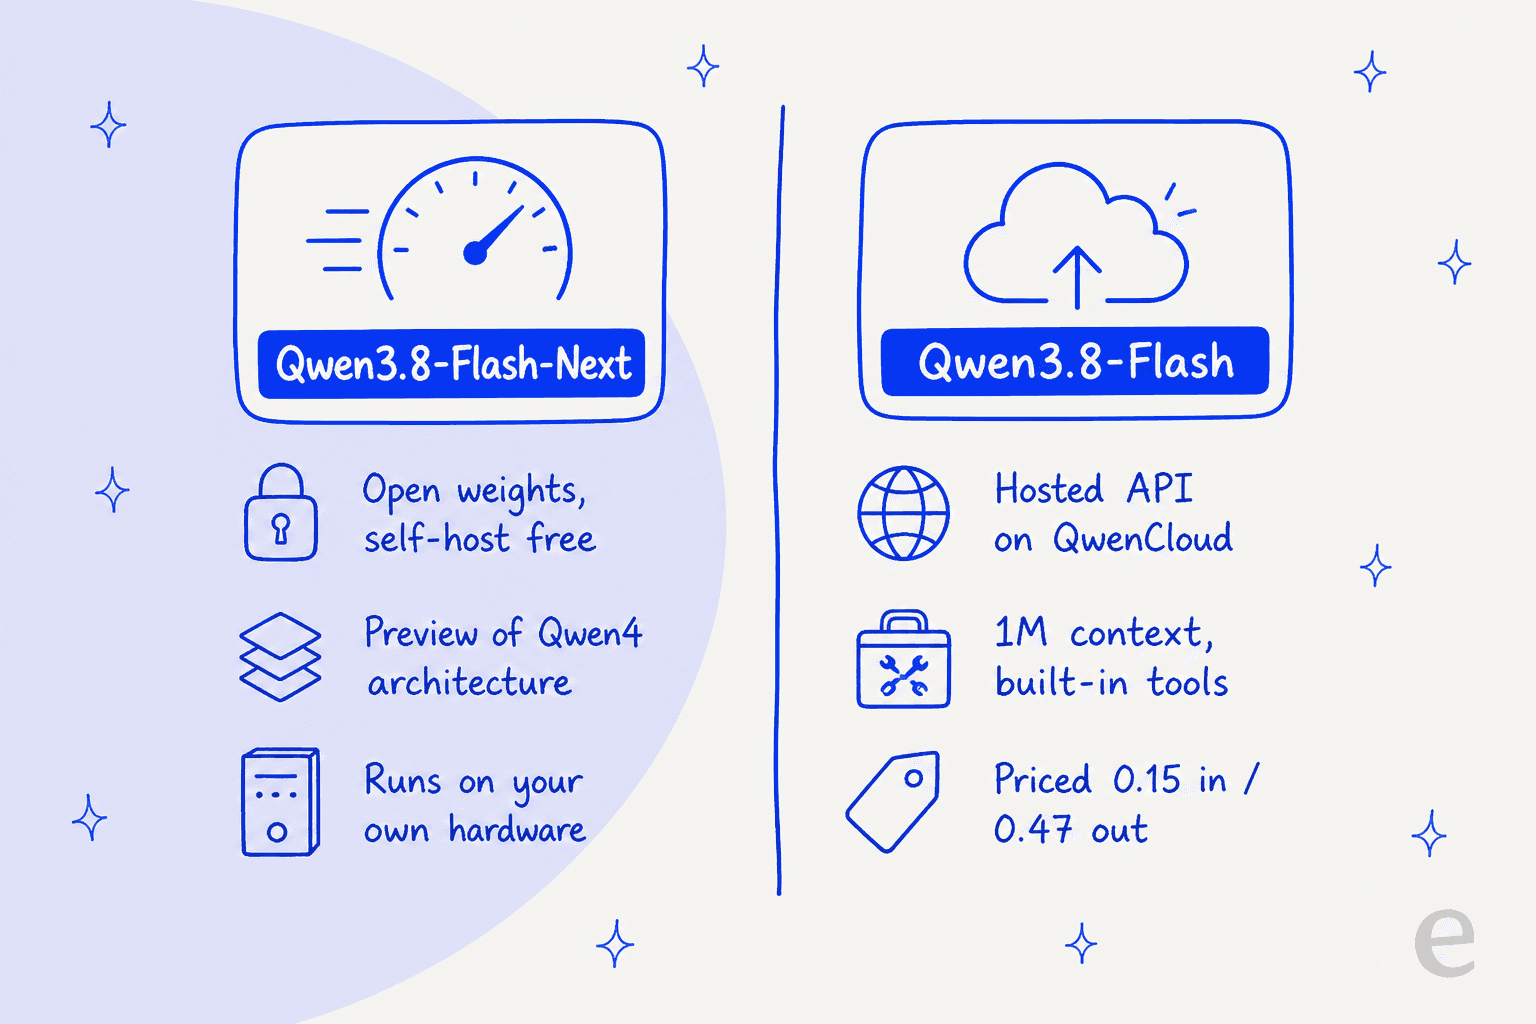
- Qwen3.8-Flash-Nextは、Hugging FaceとModelScopeで、Qwen Community License 1.0のもとに公開されたオープンウェイト版です。ダウンロードして自分で動かします。
- Qwen3.8-Flashは、QwenCloudで提供される本番版で、デフォルトで1Mコンテキストと公式の組み込みツールを備えます。APIで呼び出すのはこちらです。
これはすでに、ウェイトもベンチマークもなしでクローズドに出たQwen 3.7 Flashからの大きな変化です。今回は、初日からオープンウェイトと詳細なベンチマーク表が手に入ります。テキスト、画像、動画を入力でき、テキストを出力するマルチモーダル推論モデルで、思考モードはデフォルトでオンです。
「Next」にふさわしいアーキテクチャ
ここは私が本当に関心を持っている部分です。この価格が成り立つ理由はアーキテクチャにあるからです。Flash Nextは、Qwen3-Nextのハイブリッド設計を四つの軸で拡張しており、それぞれがメモリと計算を交換する賭けです。
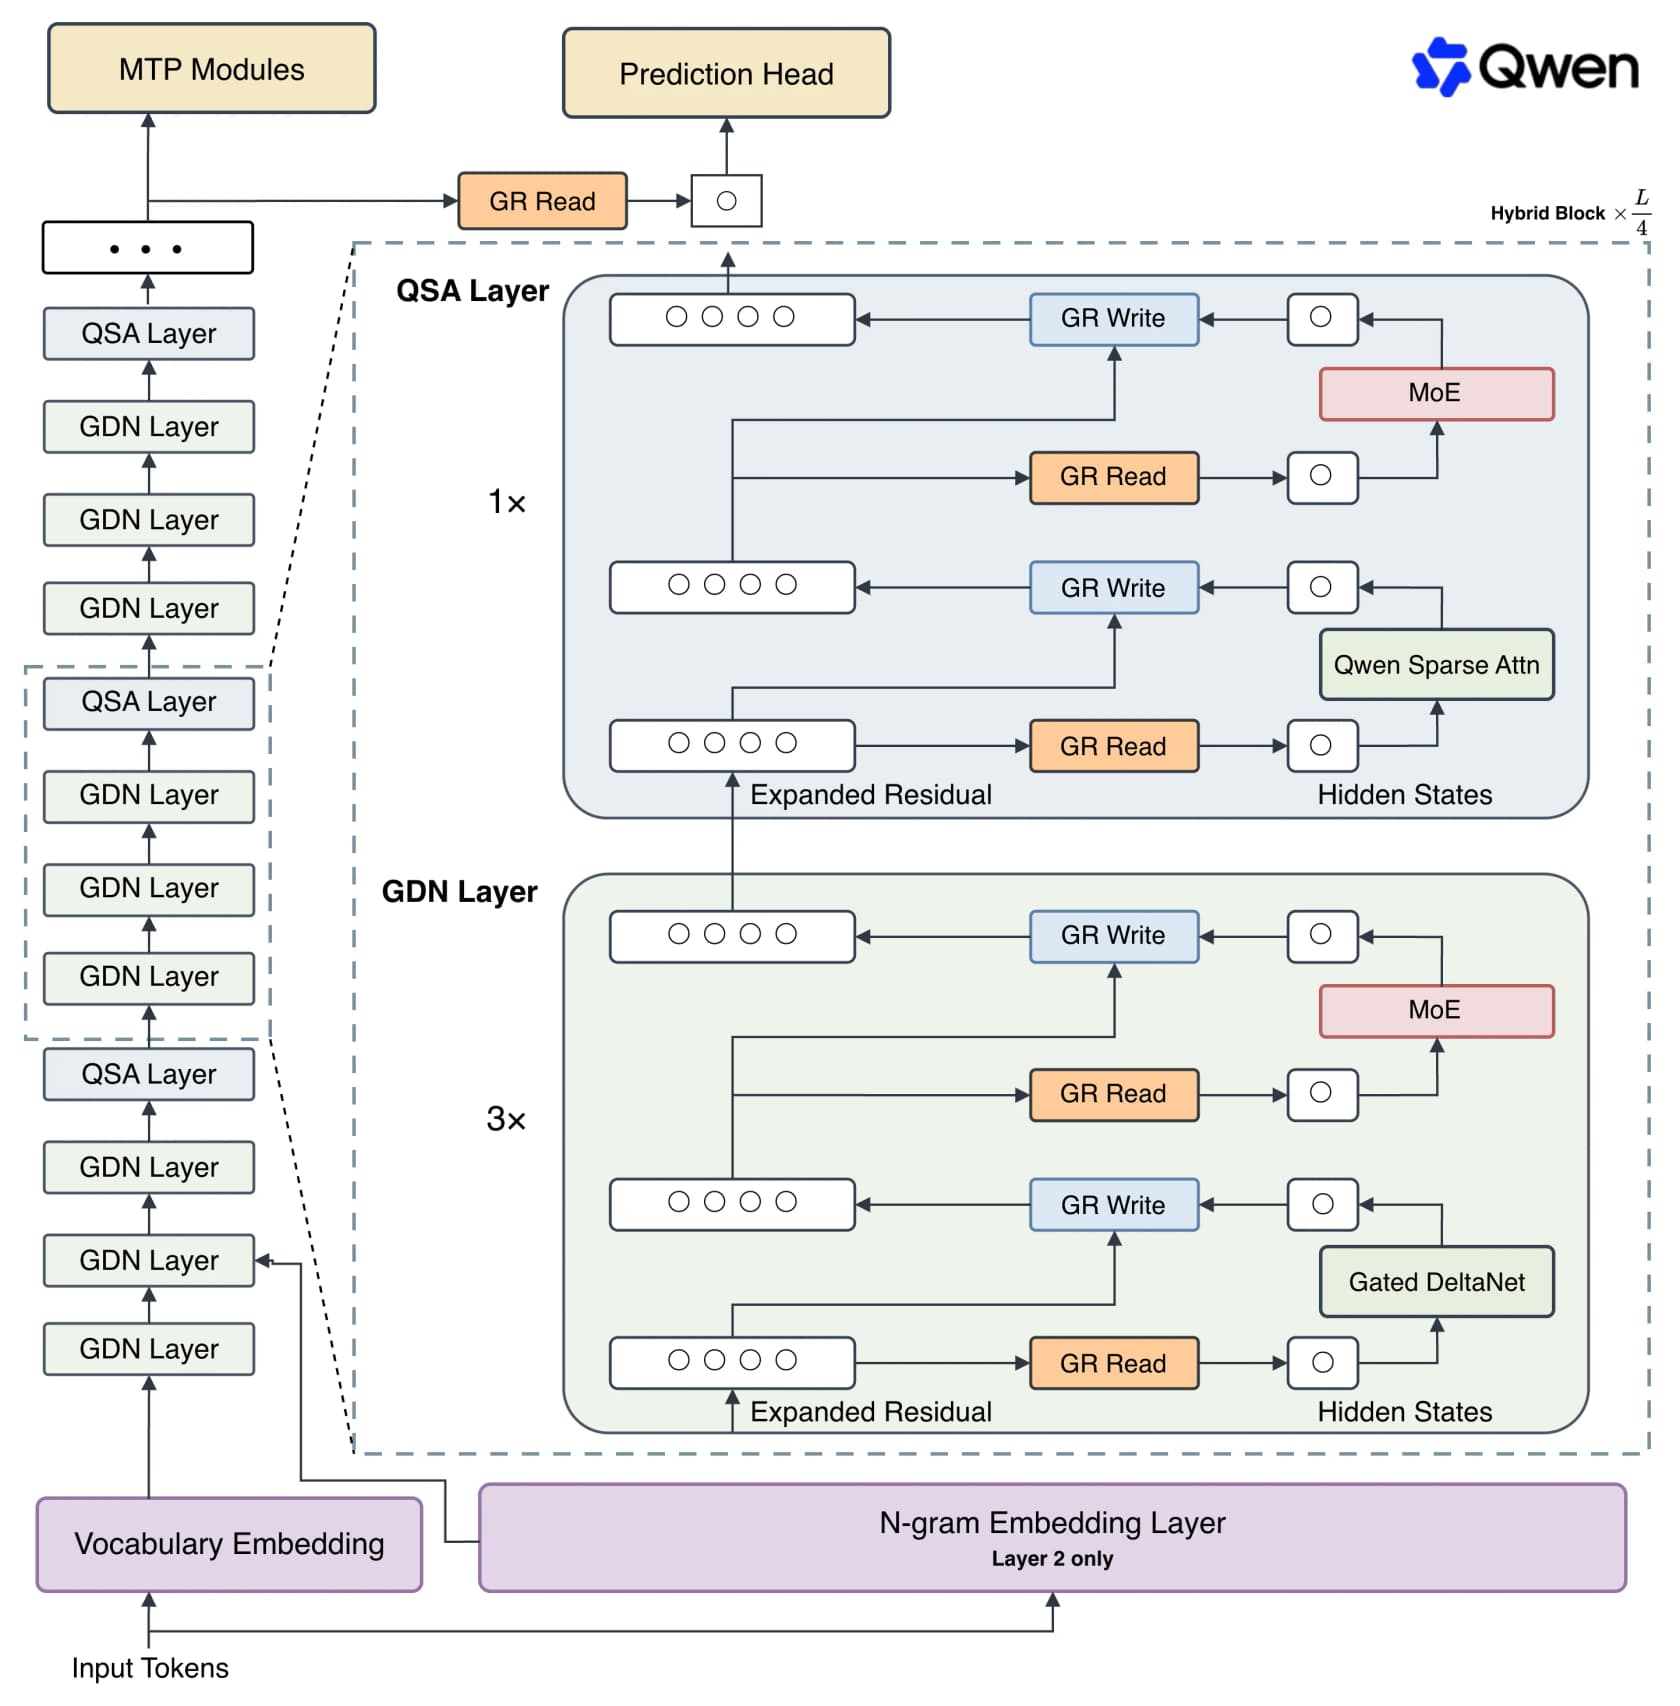
アテンション: GDNとQSAのハイブリッド。 4層のうち3層はGated DeltaNetを使い、履歴を固定サイズの状態に圧縮します。これは完全なキーバリューキャッシュを保存するよりはるかに安価です。4層目はグローバルアテンションを使いますが、これはQwen Sparse Attentionに置き換えられ、トークン単位ではなくマイクロブロック単位で重要なコンテキストを選びます。
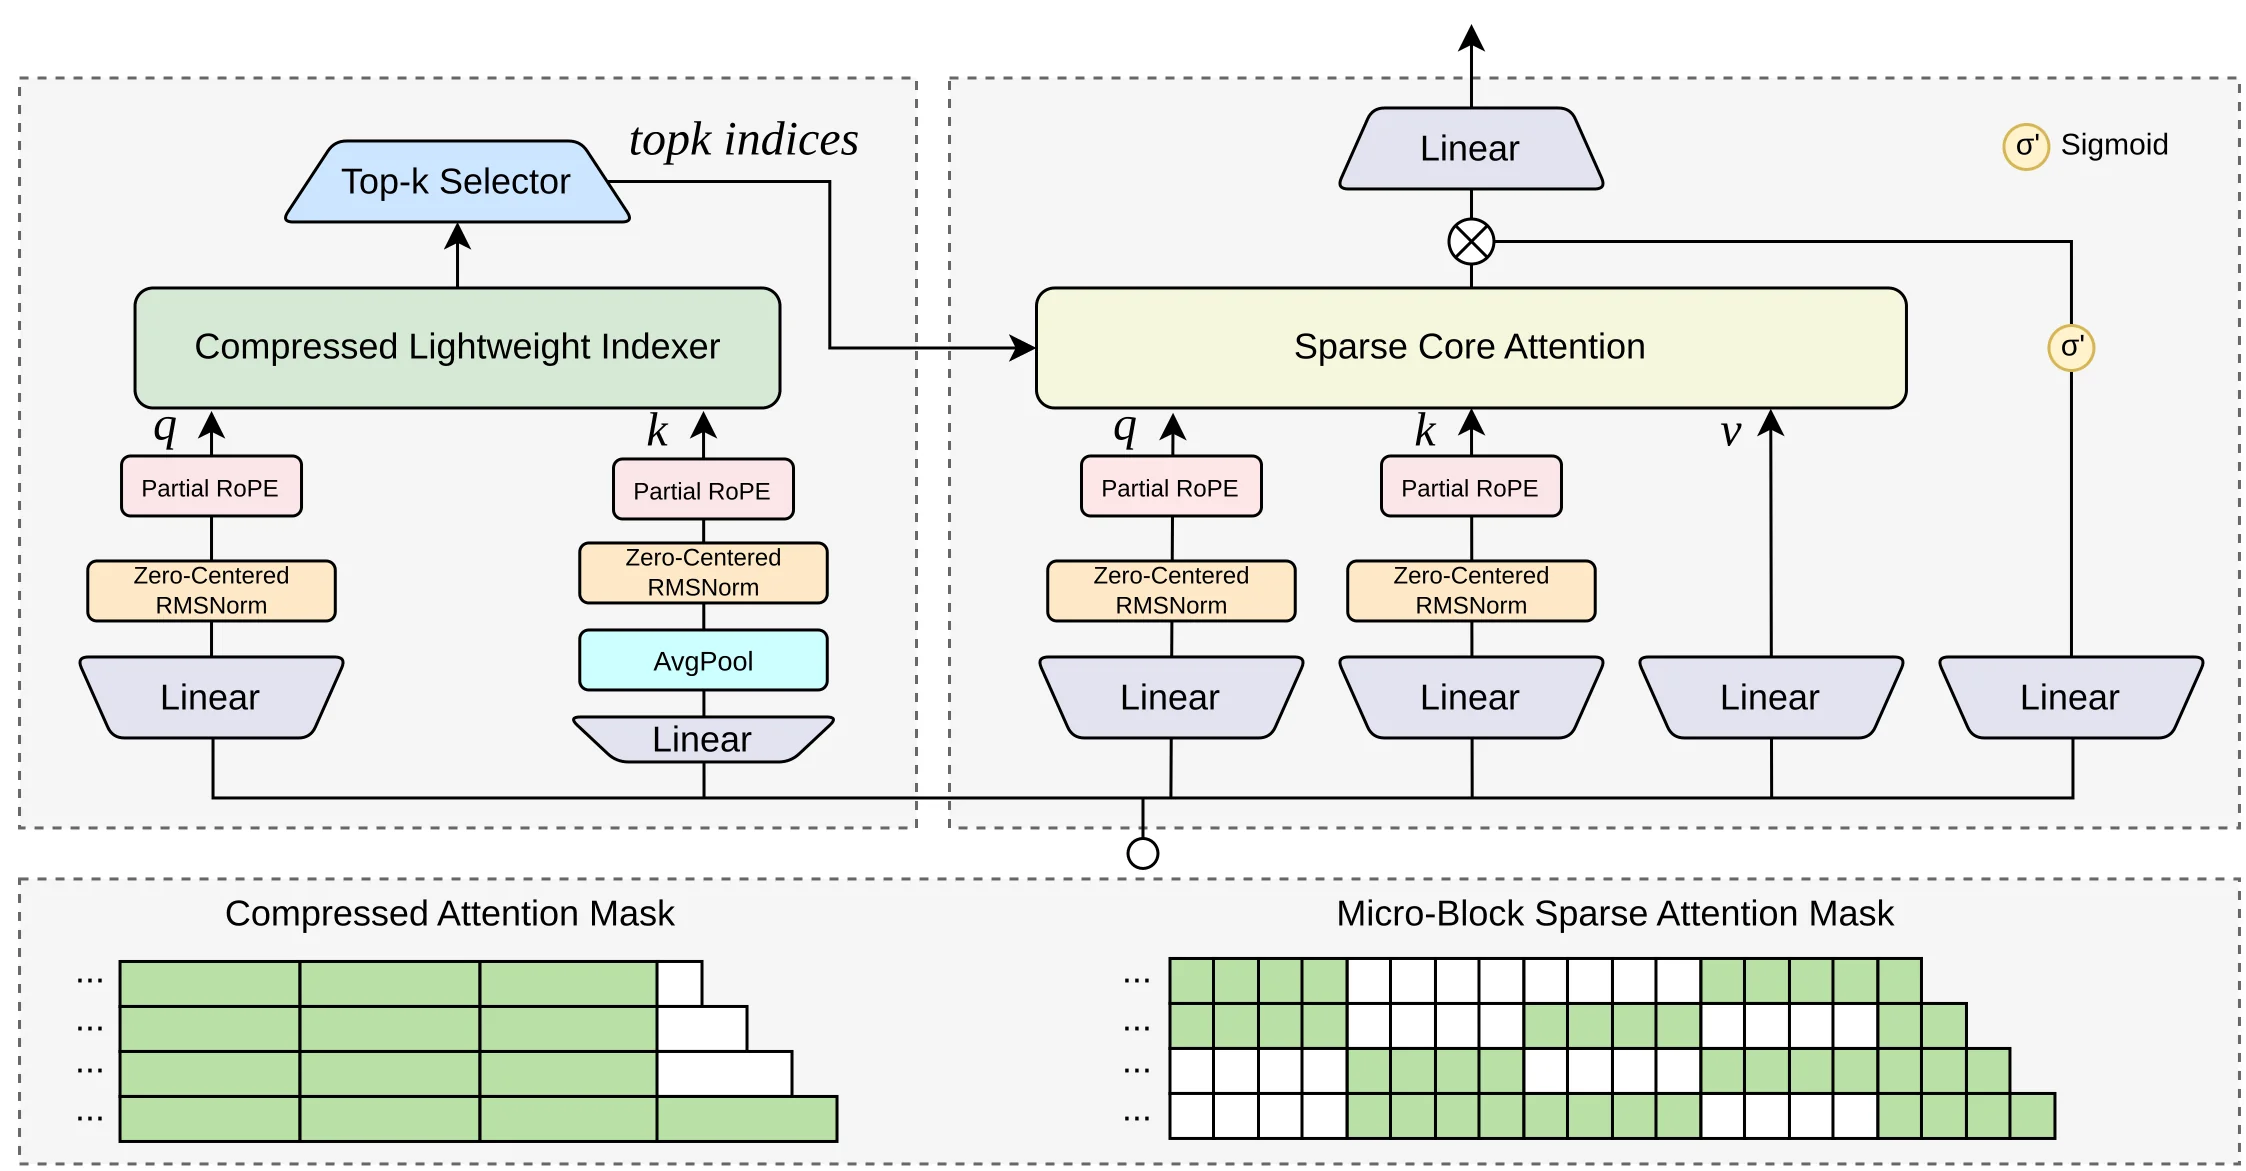
エンベディング: 51BのN-gramテーブル。 ここが巧妙なところです。Qwenは、文脈ベースのバイグラムとトライグラムのルックアップを510億パラメータ分追加し、これをホストメモリにオフロードして非同期にプリフェッチできるようにしました。トークンごとの追加計算はほぼゼロのまま、容量が大きく増えます。そのため、控えめなGPUのマシンで「180Bクラス」のモデルを動かす人が出ています。
残る二つの軸は、残差を4本の並列ブランチに広げてFP8で保存するGated Residualストリームと、2D線形マップに対するMuonオプティマイザへの切り替えです。Qwenによると、この組み合わせで学習コストはQwen3.7-Plusの約9分の1に下がり、コーディングとオフィス作業ではそれを上回りました。
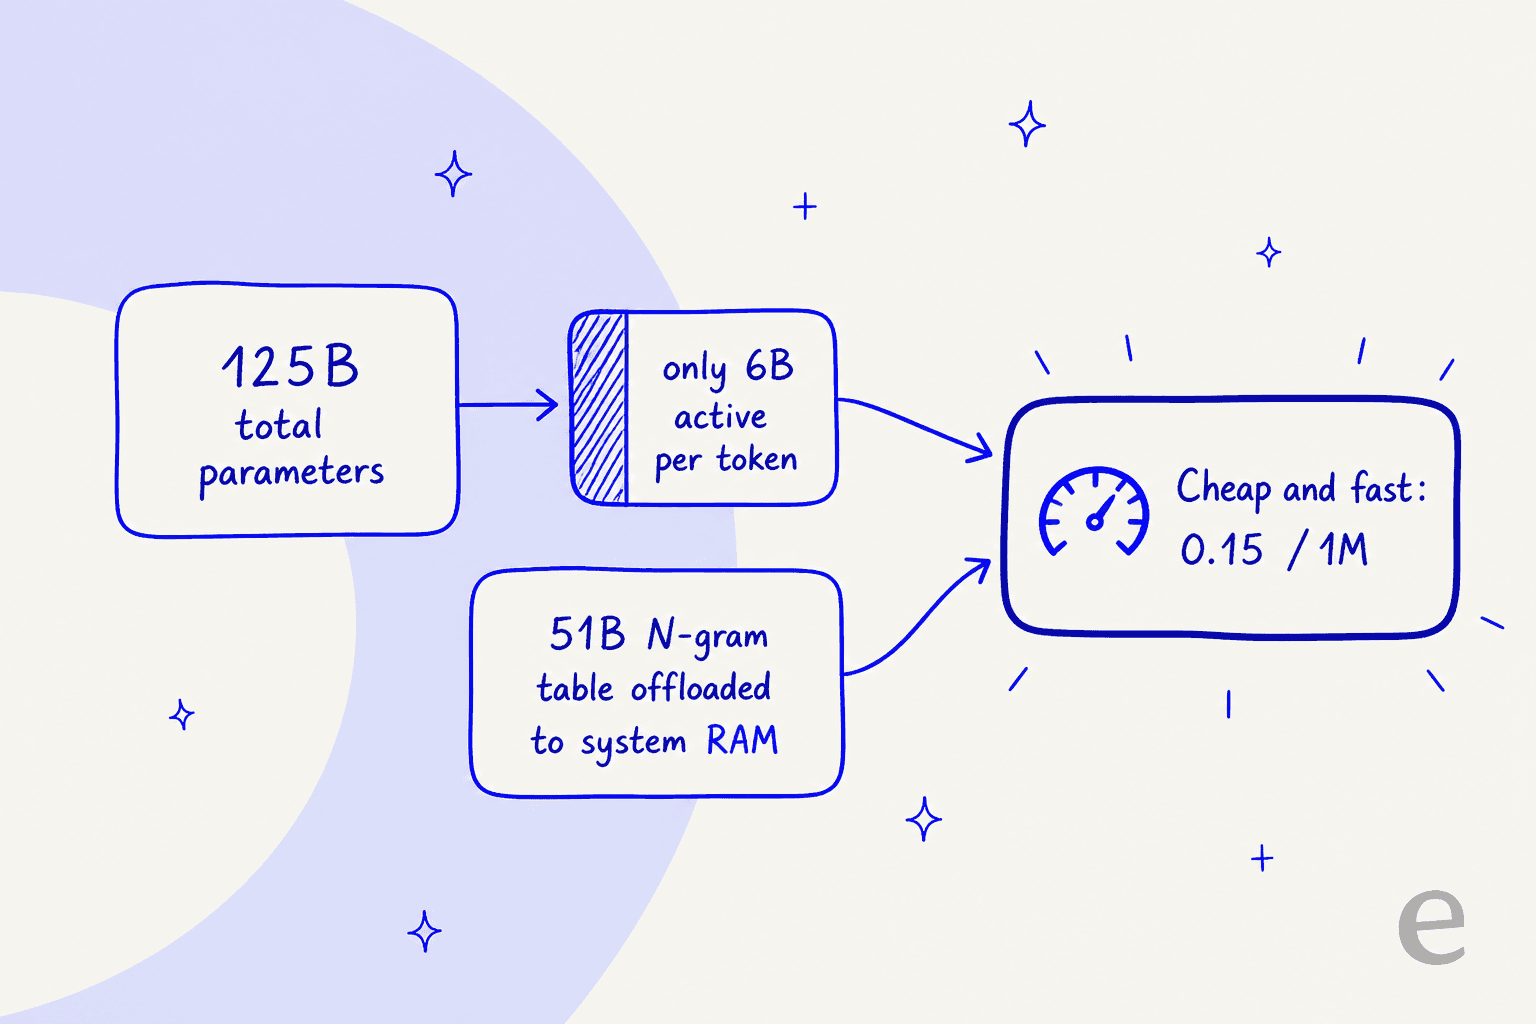
スペックを合わせると全体像は明確です。メインパラメータ125B、トークンごとの有効化は6B、これに51BのN-gramエンベディングと4Bのマルチトークン予測ヘッドが加わります(Artificial Analysisは合計を180Bに丸めています)。512のエキスパートのうち、ルーティングされる10と共有の1が有効で、ネイティブのコンテキストは262,144トークン、YaRNで1Mまで拡張できます。正直な注意点を一つ。コンテキストの数値は情報源ごとに食い違っています。モデルカードはネイティブ262K、QwenCloudはデフォルト1M、Artificial Analysisは256Kと記載しています。「非常に長いが、正確な上限は動かす場所による」と読んでください。
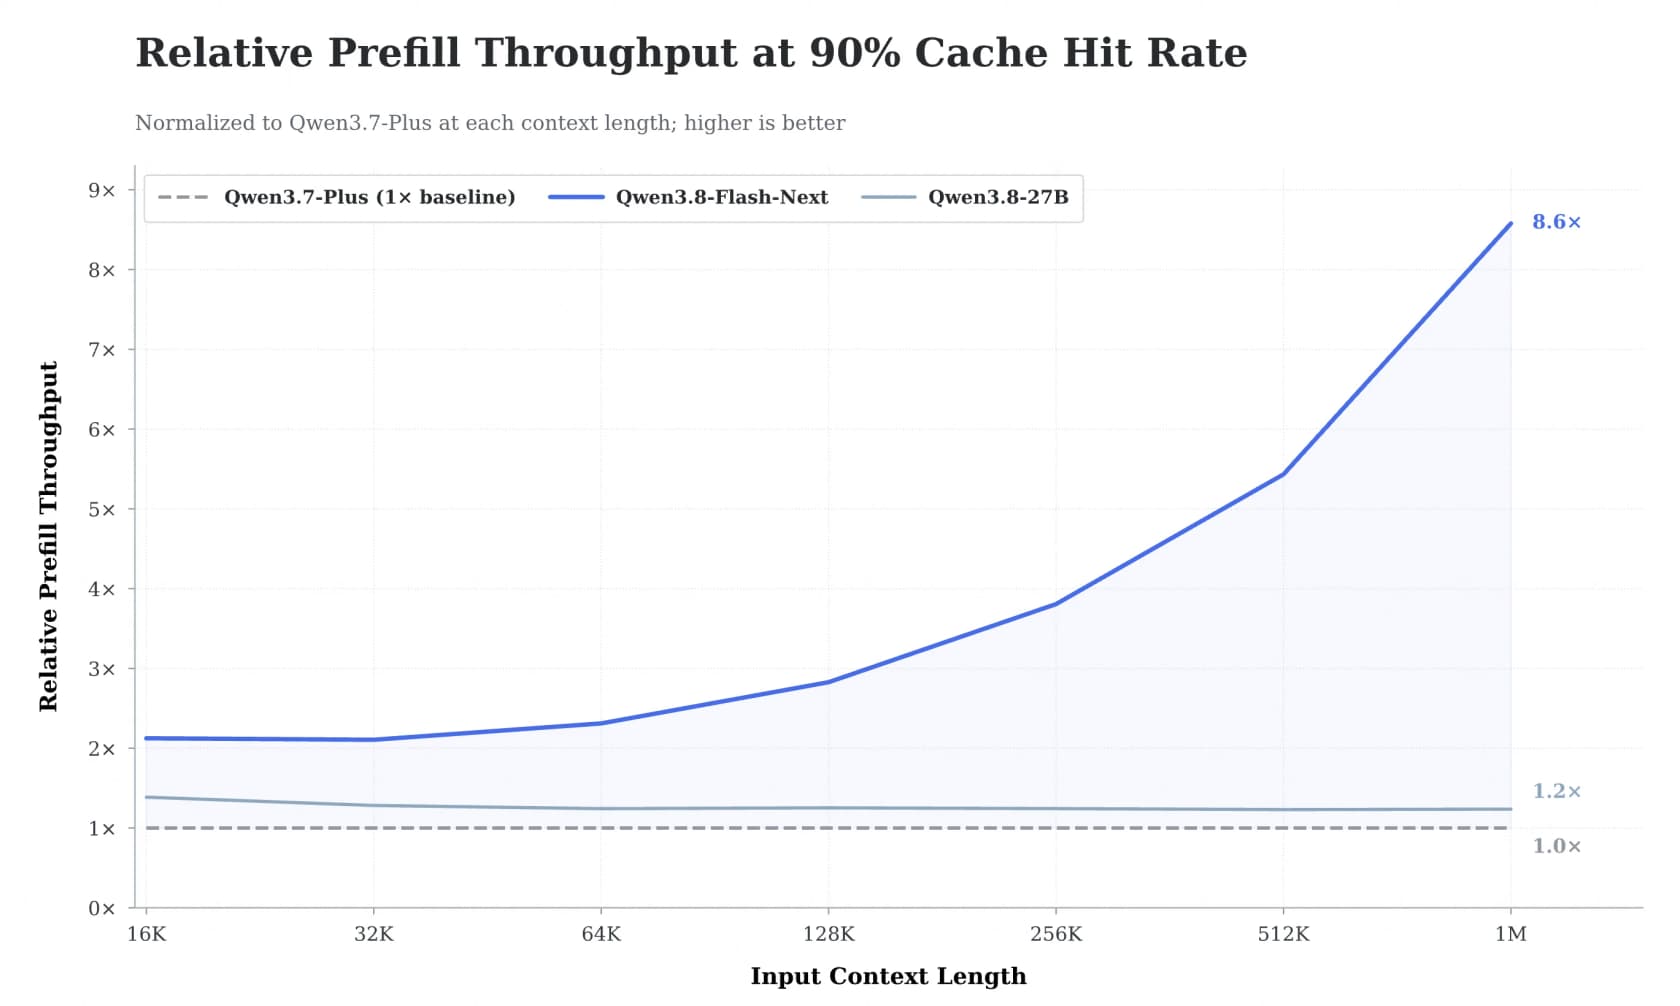
効率の効果が最も大きく出るのは長いコンテキストです。Qwenは、QSAカーネルが1Mトークンでプリフィル最大7.6倍、デコード最大4.9倍の高速化を達成し、キャッシュヒット率90%の1Mでは、Qwen3.7-Plusの8.6倍のプリフィルスループットが出ると報告しています。
Qwen 3.8 Flash Nextで実際に何ができるか
ここでのベンチマークには二種類あり、その違いは重要です。Qwen自身の表は印象的ですがベンダー報告であり、もう一つ、本当に独立した拠り所があります。
まず独立したほうから。Artificial Analysisは、Flash NextをIntelligence Indexで56、同クラス111モデル中5位と評価しており、中央値は29です。出力速度は毎秒77トークン、Indexタスク1件あたりのコストは約$0.10です。彼らの一行評は「知能で主要モデルの一角を占め、価格も妥当」でありつつ「非常に冗長」というもので、Indexを完了するのに出力トークン2億を使い、中央値の1.1億を上回ります。この冗長さは覚えておいてください。実際の請求額をじわじわ押し上げます。
Qwen自身の数値は、中立の事実ではなく「Qwenの報告」として読むべきですが、ほとんどの行で兄弟モデルを上回っています。
| ベンチマーク | Qwen3.8-Flash-Next | Qwen3.8-27B | Qwen3.7-Plus | DeepSeek-V4-Flash | Claude-Opus-4.6 |
|---|---|---|---|---|---|
| SWE-bench Pro | 62.5 | 61.7 | 55.8 | 56.0 | 53.4 |
| SWE-bench Multilingual | 81.0 | 73.8 | 75.8 | - | 77.5 |
| LiveCodeBench v6 | 91.9 | 90.3 | 89.6 | 90.6 | 88.8 |
| GPQA Diamond | 91.7 | 89.2 | 90.3 | 90.8 | 91.3 |
| IFBench (指示追従) | 81.3 | 79.5 | 79.1 | 79.2 | 62.5 |
| CoWorkBench (長時間のオフィス作業) | 73.9 | 70.7 | 65.1 | 45.1 | 68.2 |
| Humanity's Last Exam | 35.9 | 30.8 | 34.7 | 33.8 | 40.0 |
出典: Qwenのベンチマーク表。目を引くのは二点です。コーディングとエージェント系タスクで本当に強く、SWE-bench Proでははるかに大きなモデルをわずかに上回ります。そして完全な圧勝ではありません。Humanity's Last ExamではClaude Opus 4.6が依然として勝っており、リポジトリレベルの生成ではDeepSeek V4 Flashが上回ります。視覚面では、QwenはAndroidWorldで84.5、RealWorldQAで88.5を報告しており、どちらも比較対象の中でトップです。
Qwen 3.8 Flash Nextの料金
オープンウェイトは無料です。ハードウェアがあれば、支払うのは計算コストだけで、それがセルフホスト派にとっての最大の魅力です。
ホスト型のQwen3.8-Flash APIは、Qwen 3.7 Flashにあったようなコンテキスト長ごとの区分がない均一料金です。
| 項目 | 料金 (USD / 100万トークン) |
|---|---|
| 入力 | $0.15 |
| 出力 | $0.47 |
| 入力、キャッシュ読み取り | $0.016 |
| 明示的キャッシュ作成 | $0.20 |
| 明示的キャッシュ読み取り | $0.016 |
このキャッシュ読み取りは新規入力より約89%安く、理論上の話ではありません。OpenRouterは実トラフィックで91.1%のキャッシュヒット率を観測しており、実効入力価格は100万トークンあたり約$0.028まで下がります。つまり、繰り返しの多いキャッシュ向きのワークロードで実際に支払う額は、表示価格を大きく下回ります。
「安い」という見出しには但し書きが一つあります。モデルが非常に冗長なため、出力の多いワークロードでは、トークン単価の低さから想像するより高くつきます。思考トークンもすべて課金されるからです。会話調のサポート返信なら誤差ですが、長いエージェント実行では積み上がります。DeepSeek V4 FlashやKimi K3と価格で比べるなら、入力単価だけでなく出力トークンも試算してください。
また現時点では、APIプロバイダーはAlibaba Cloud Internationalの一社のみです。OpenRouterもそこへそのまま転送するため、複数プロバイダーへのルーティングやフェイルオーバーはまだありません。
実際に人々は何と言っているか
コミュニティの反応は大きく、それはほぼ全面的に、APIや企業利用ではなくローカル推論の話です。Hacker Newsのローンチスレッドは698ポイントに達し、r/LocalLLaMAでは650件超のコメントが付いたリリース用メガスレッドが立ちました。みんな自分のマシンで動かすことに夢中です。
ツール系の人々が口火を切りました。Unslothは素早く動かし、大きな主張をしました。
"Qwen3.8-Flash can now be run locally! The 125B MoE model outperforms Claude-Opus-4.6 (Max). Run on 75GB RAM via Unsloth GGUFs. Qwen3.8-Flash-Next enables CPU RAM / unified mem setups to deliver near VRAM speeds."
「Opus 4.6を上回る」という主張は彼ら自身のもので、独立したベンチマークはされていません。事実ではなく熱意として受け取ってください。より地に足のついた声は、繰り返し出てくる但し書きを付け加えました。「Next」が本当は何を意味するのかについて、HNスレッドからの最も明快な説明がこちらです。
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."

そして実用上の落とし穴を指摘したのがSimon Willisonです。彼はDGX Sparkでいくつかの推論レベルで動かし、結局、小さい密なモデルのほうを好みました。収めるために必要な低ビット量子化が原因だとしています。これが繰り返し出てくるテーマです。アーキテクチャは刺激的だが、この特定のチェックポイントはプレビューであり、コンシューマ向けハードウェアに詰め込むと品質が落ちるということです。この重量クラスで今すぐ完成度の高い選択肢が欲しいなら、多くのスレッドが代わりにGLM 5.3 Flashを挙げています。
では、使うべきか
一週間観察した上での、私の結論はこうです。
使うべき人: ユニファイドメモリのマシンや余ったGPUを持つローカル推論の愛好家、Qwen4アーキテクチャを早く見てみたい人、あるいはキャッシュ向きでコーディング中心のワークロードがあり、ホスト版の低価格と強いSWE-benchの数値が効く人です。スパース活性化の設計は、ハードウェアの規模以上の性能を実際に引き出してくれます。
見送るべき人: 今すぐ安定した本番グレードのモデルが必要な人です。Qwen自身が認める通り学習を抑えたプレビューで、量子化は品質を落とし、ホスト版のQwen3.8-Flash APIはプロバイダーが一社だけです。ミッションクリティカルな用途では、Qwen4ラインが出揃うまで、より完成度の高いモデルのほうが安全です。GLM 5.3 Flash、Claude Opus 5クラス、あるいはQwen 3.8 Maxなどです。
いずれにせよ、より重要なのはモデルとは何かという点です。それはコンポーネントです。そこで、「安いAI」を探しているチームにいつも説明しなければならないことの話になります。
このようなモデルは実際のサポート業務のどこに収まるか
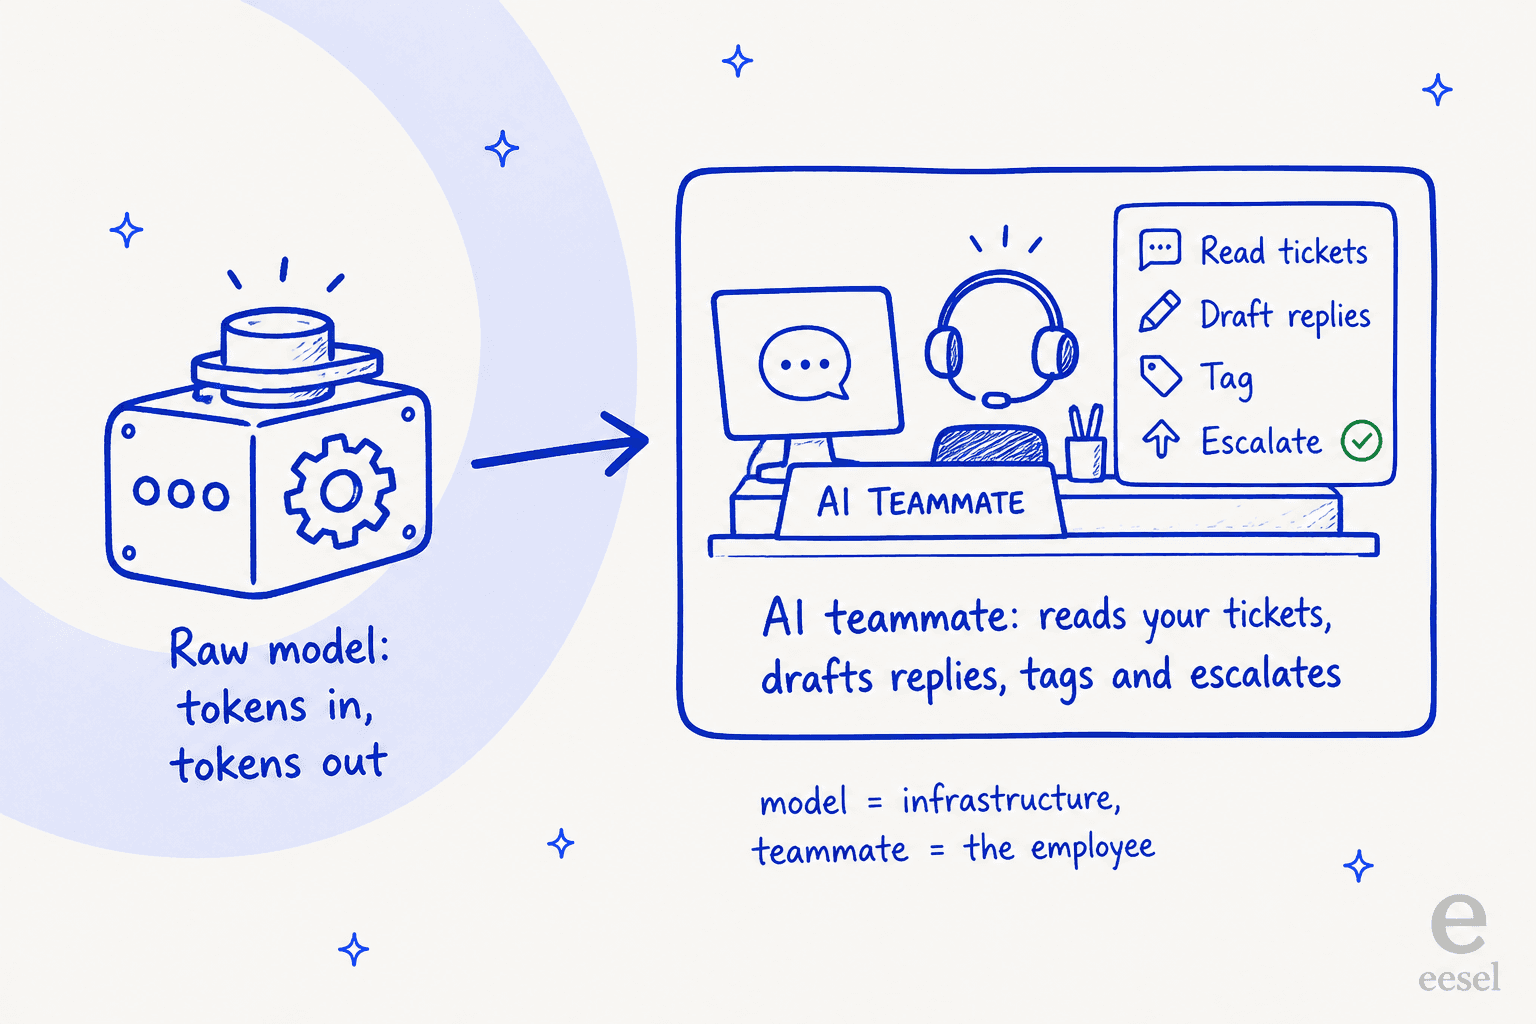
多くの人がこうしたローンチを見て、「よし、サポートの受信箱をQwen 3.8 Flash Nextにつないで、AIの請求額を減らそう」と考えます。それはカテゴリの間違いです。素のモデルはトークンを受け取ってトークンを返すだけです。あなたの返金ポリシーを知らず、顧客の注文履歴を読めず、ヘルプデスクで返信を下書きすることもなく、自信満々の回答が本当に正しいかどうかも分かりません。モデルはインフラであり、仕事をこなすのは従業員です。
その従業員の層を作っているのがeeselです。私たちの考え方はシンプルで、eeselはAIチームメイトのプラットフォームであり、特定の仕事のために、すぐ働けるチームメイトを採用します。現在はAIヘルプデスクのチームメイトとAIブログライターです。それぞれが役割に必要なスキル、連携、会社のコンテキストを備えて着任するため、裏でどのモデルが動いているかは実装の詳細となり、あなたの悩みではなくなります。

最も強調したいのはテストです。人が痛い目を見るのを見てきたからです。自信ありげなボットが黙って誤答を返すのは、誰もが見たことがあるでしょう。だからこそ、eeselのヘルプデスクチームメイトは、実際の顧客に触れる前に、過去のチケットに対してあらゆる展開をシミュレーションします。実際の過去の会話で送っていたはずの返信そのものと解決率を確認し、そのうえで何を自動化するかを決められます。できたての学習不足のモデルは、ベンチマーク表を信じるのではなく、まさにこのゲートを通したい種類のものです。さらに、eeselは既存のヘルプデスクに接続し、ナレッジベースと過去チケットから読み取るため、素のモデルが単独では決して解決できないコンテキストの問題も解消されます。
要約すると、Qwen 3.8 Flash Nextのようなモデルは急速に安く高性能になっており、それは素晴らしいことですが、1つ選ぶのは仕事の簡単な10%にすぎません。残りの90%は、それを実際にチケットを解決するチームメイトに仕立てることで、その層こそ時間をかける価値があります。