

10月12日にZ.aiが実際に公開したもの
Z.aiはGLM-Legalを「Advancing Agentic Legal Intelligence」というタイトルの研究記事として公開しました。上部には2つのボタンがあり、1つは相談フォーム、もう1つはデスクトップ向けエージェントアプリのAutoClawです。Xのローンチ投稿は7,000件以上のいいねを集め、Hacker Newsのスレッドは594ポイント、332コメントに達しました。
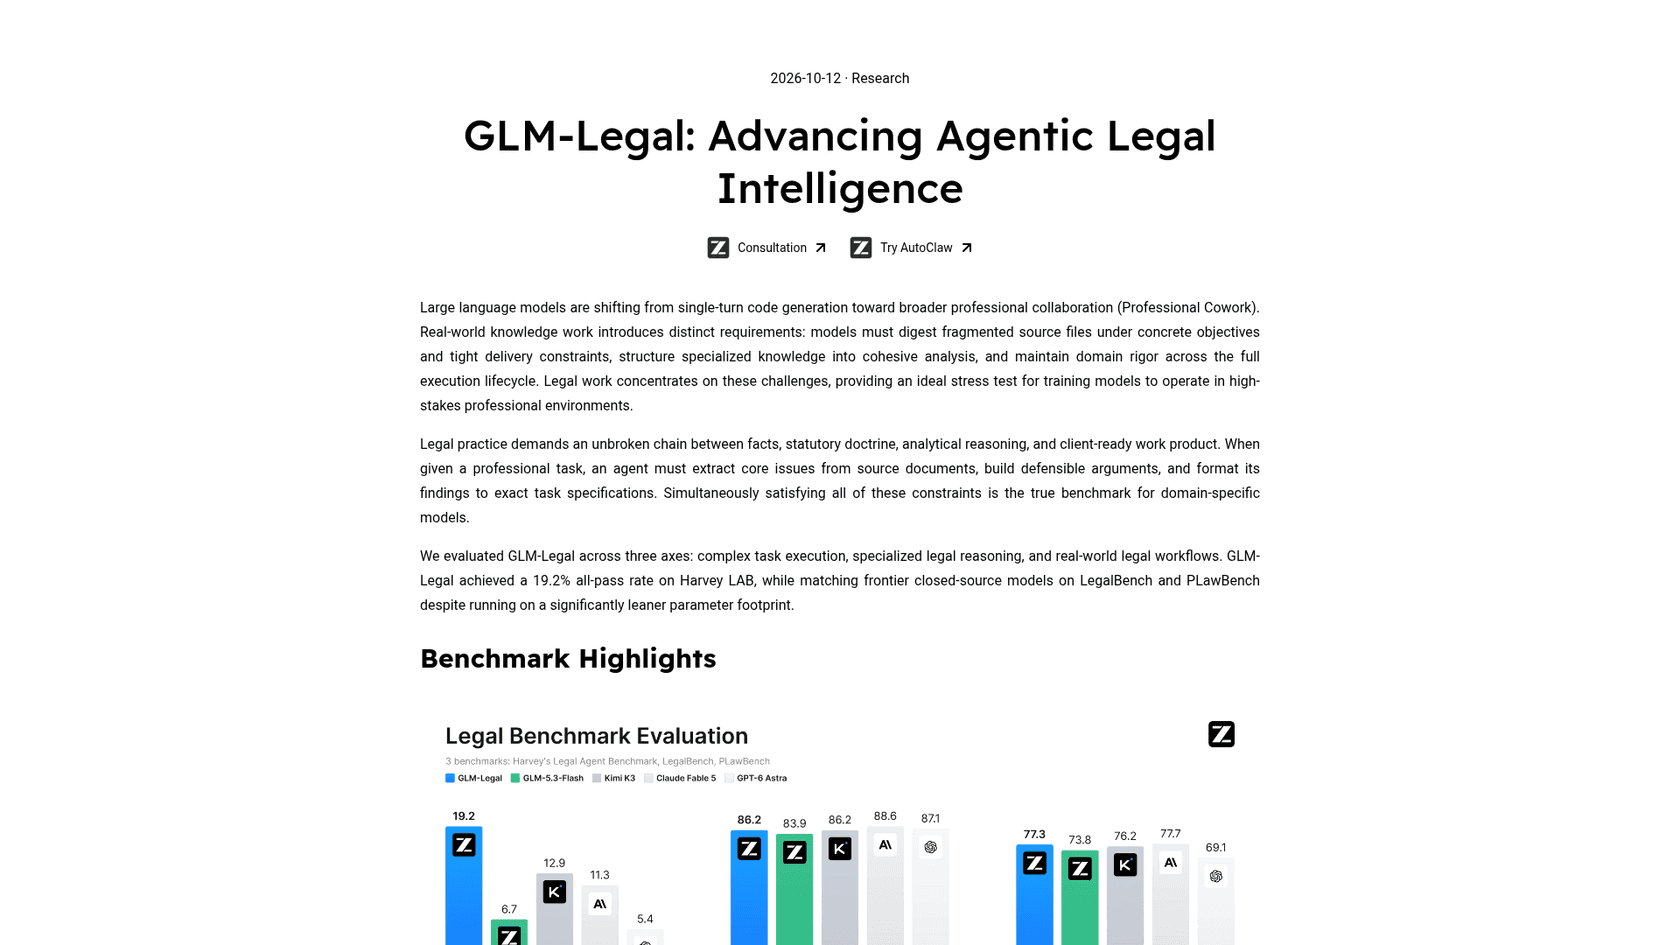
含まれるものと含まれないものは次のとおりです。
| Z.aiの説明・提示内容 | |
|---|---|
| ベースモデル | GLM-5.3-Flash。総パラメータ320B、アクティブ18BのMixture-of-Expertsモデル |
| コンテキストウィンドウ | 1Mトークン、最大出力128k(Valsのモデルカード) |
| 入力 | Valsのテストではテキストのみ(ベースモデルは画像に対応) |
| 想定業務 | 契約書レビュー、証拠分析、コンプライアンス調査 |
| 想定ユーザー | 法律事務所、リーガルテック企業、社内法務チーム、個人の実務家 |
| アクセス | 申請によるAPIトライアル。AutoClaw対応は「近日」 |
| 価格 | 未公表 |
| 重み | 10月14日時点でZ.aiのHugging Faceページにダウンロードなし |
GLM-5.2のローンチや8月のFlashのリリースを追っていた方には、見覚えのあるパターンでしょう。Z.aiは強力な汎用モデルを特定の仕事に向けます。今回新しいのは、その仕事が規制された専門職であり、リリースが限定公開であることです。
GLM-Legalの内部の仕組み
Z.aiは3つの学習段階を説明しており、3つ目が興味深い部分です。
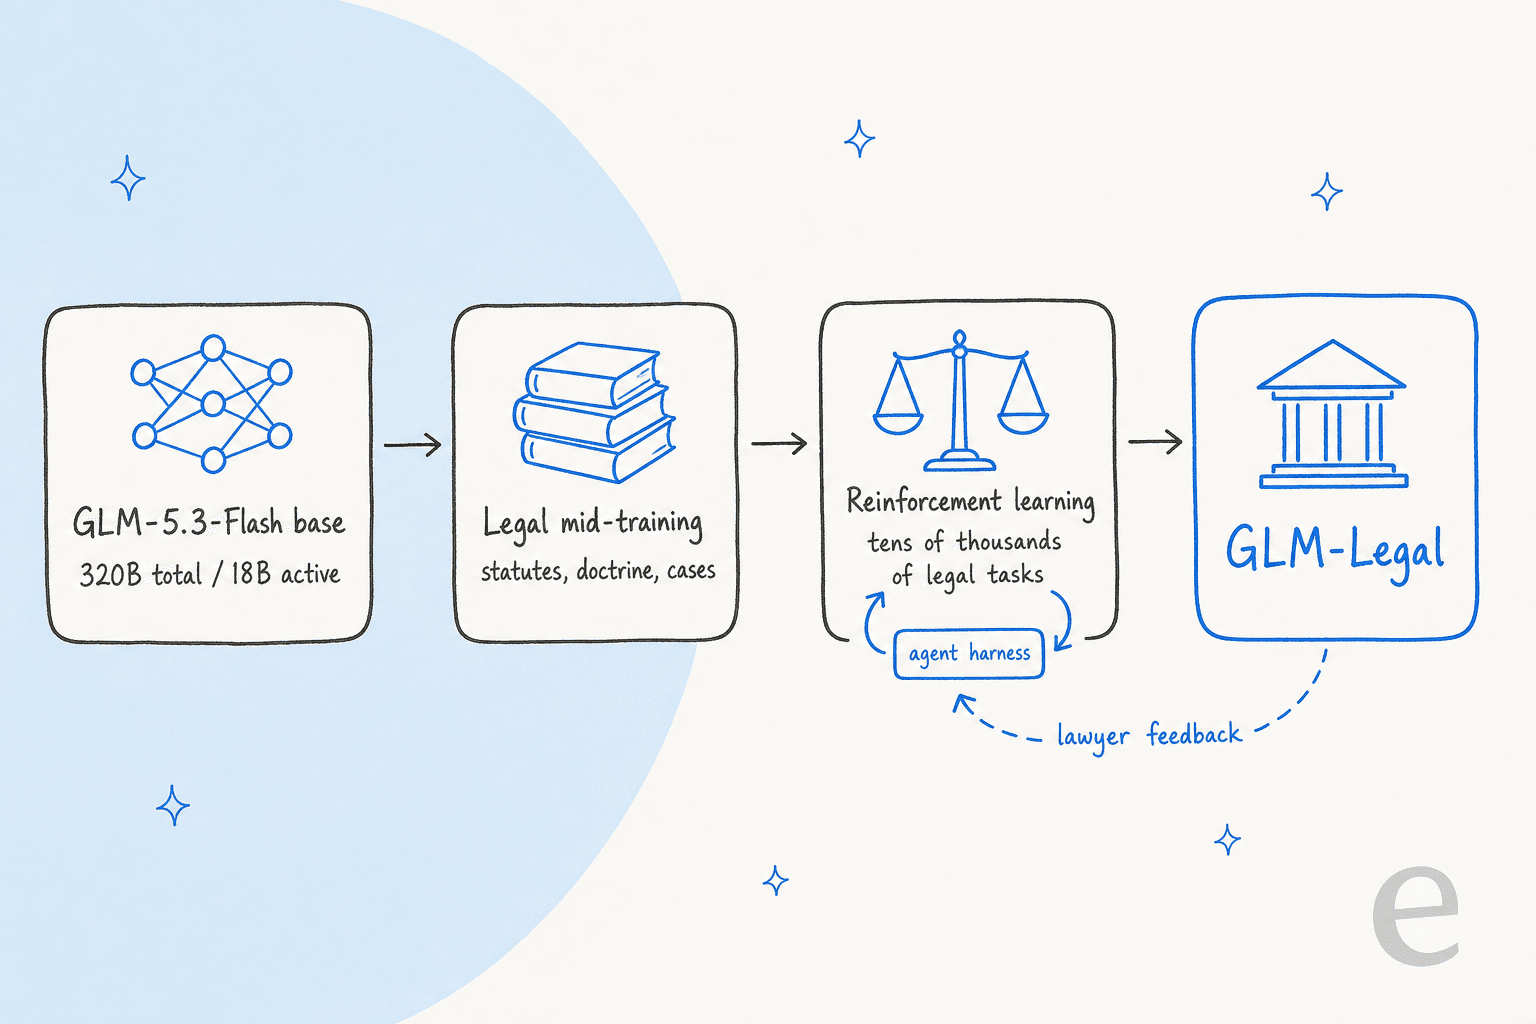
1. 法律文書でのミッドトレーニング。 Z.aiは「expanded the volume of high-quality legal corpora」とし、モデルが法令、学説、法律家による解釈を学べるようにしました。これはドメイン特化LLMの定番の手法で、単体では主に知識の想起に効きます。
2. エージェントハーネス内での強化学習。 私が注目するのはこの部分です。モデルは「across tens of thousands of realistic legal environments」で学習し、分析を計画し、ファイルを開き、成果物を作成し、採点されます。ハーネス(モデルにファイルやツールを渡すコード)も一緒に学習されました。モデルが失敗したときはハーネスも修正され、その逆も行われました。
私は長年、汎用モデルの上にエージェントを構築してきましたが、追いかけるバグの大半は「モデルが馬鹿だった」ではありません。「モデルが正しいファイルを読まなかった」「次のステップ向けに回答のフォーマットを間違えた」といったものです。モデルとハーネスを一緒に学習させるのは、まさにこの種の失敗に効きます。同時に、GLM-LegalはZ.ai自身のハーネスであるAutoClawの中で最もよく動き、皆さんのハーネスの中では挙動が読みにくくなる可能性が高いということでもあります。
3. 現役弁護士とのループ。 Z.aiによると、弁護士が「Are all critical issues and edge cases addressed?」や「Are arguments well-substantiated and citations legally sound?」といった問いで出力を採点し、その評価が次の学習ラウンドに反映されます。
これらはデータソースを示した論文としては公開されていません。HNのあるコメント投稿者は、学習データが分からない以上、テストによく似たタスクが含まれている可能性を排除できないと指摘しました。次のセクションではこの点を念頭に置いてください。
Z.aiが示す3つのデモ
ローンチ記事では、同じ3つのタスクでGLM-5.3-FlashとGLM-Legalを比較しています。違いは主に具体性です。ソフトウェアサービス契約で、ベースモデルは「consider shortening the notice period」と提案します。GLM-Legalは「from 60 to 30 days」に短縮し、IP、機密保持、データセキュリティの違反に対する是正期間を削除し、「up to 90 days of transition assistance」を追加するよう指示します。
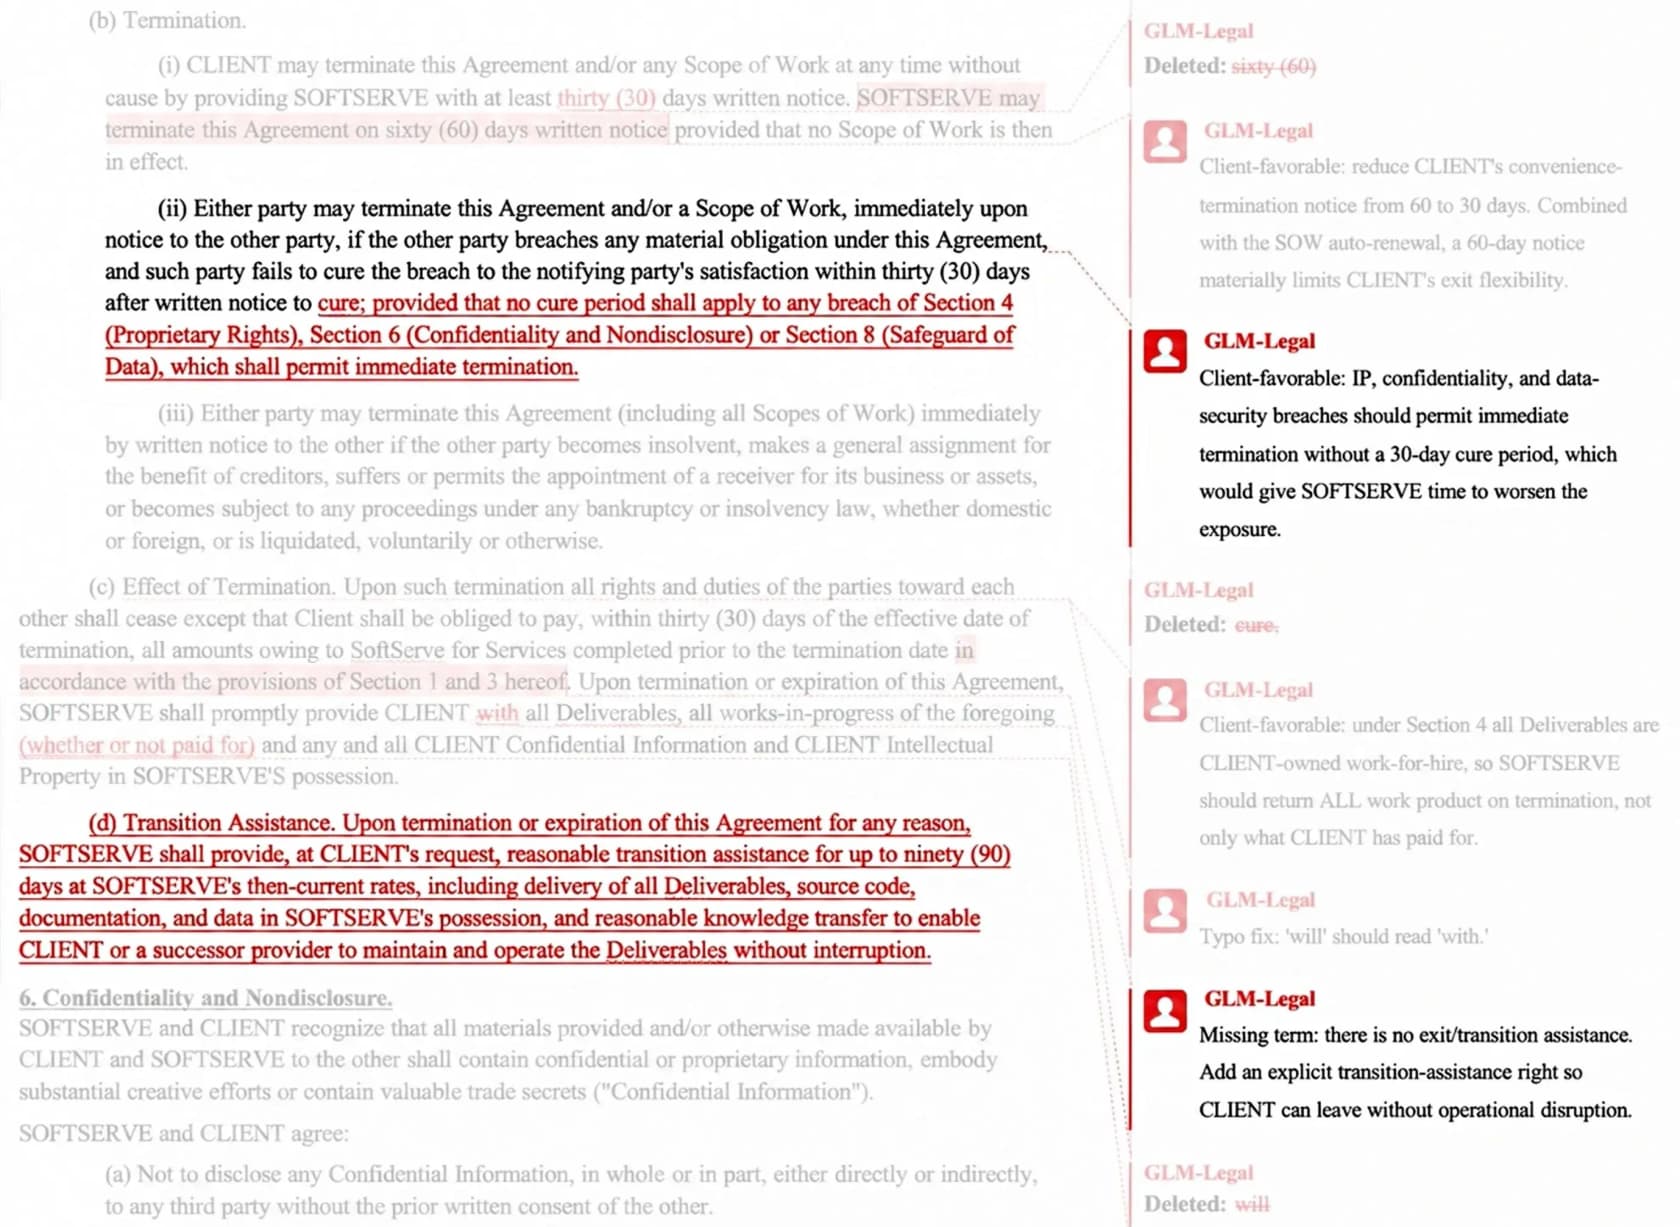
出力はWordファイルの変更履歴とコメントとして返されます。要約を信じるのではなく、弁護士が各編集を承認または却下する形なので、適切なやり方です。
2つ目のデモは、ソフトウェアプロジェクトの紛争に関する40件の文書を読み込み、すべての項目に文書番号の出典を付けた時系列を作ります。GLM-Legalは、顧客への「60% complete」という報告を、約41%を示す社内スナップショットや、スタッフに請求を続けるよう指示するメールと結び付けます。3つ目は、シンガポール、マレーシア、インドネシアでのローンチに向けたプライバシーコンプライアンスの計画で、各国のデータ保護法の条項を参照しています。
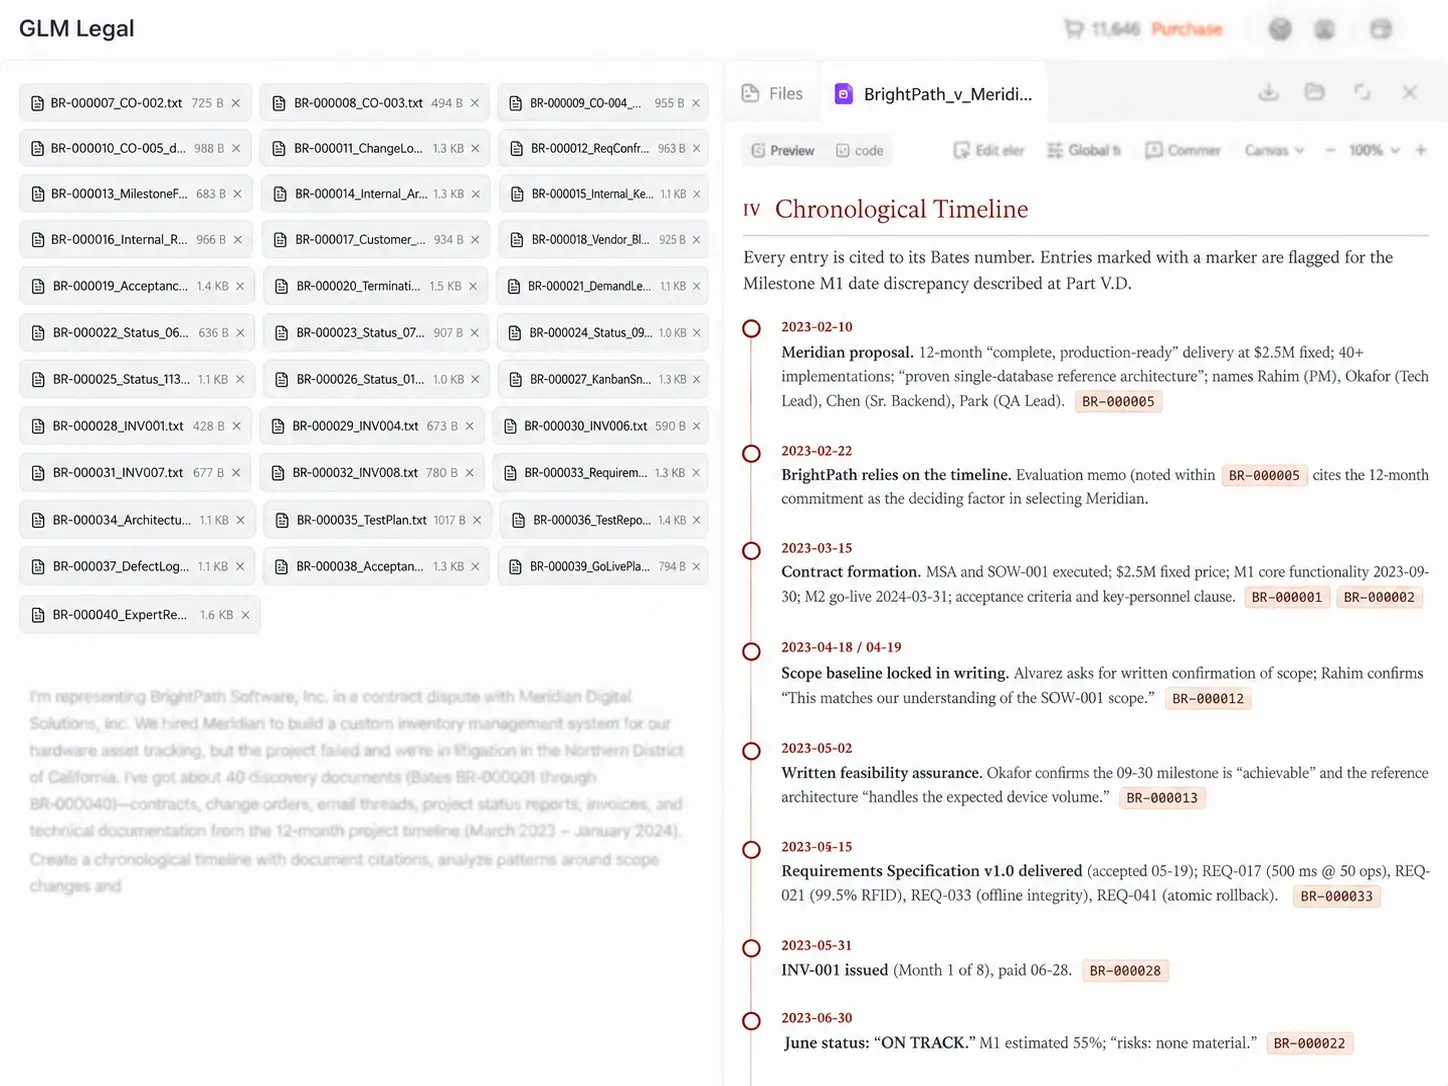
これらは定義上、選び抜かれた例です。それでも、すべての主張に出典文書を付けるという習慣は、AIの出力を検証可能にする習慣であり、法務では賢さより検証可能性のほうが重要です。
GLM-Legalのベンチマーク:19.2%の本当の意味
Z.aiのグラフは、GLM-Legalを自社のベースモデル、Kimi K3、Claude Fable 5、GPT-6 Astraと3つのテストで比較しています。
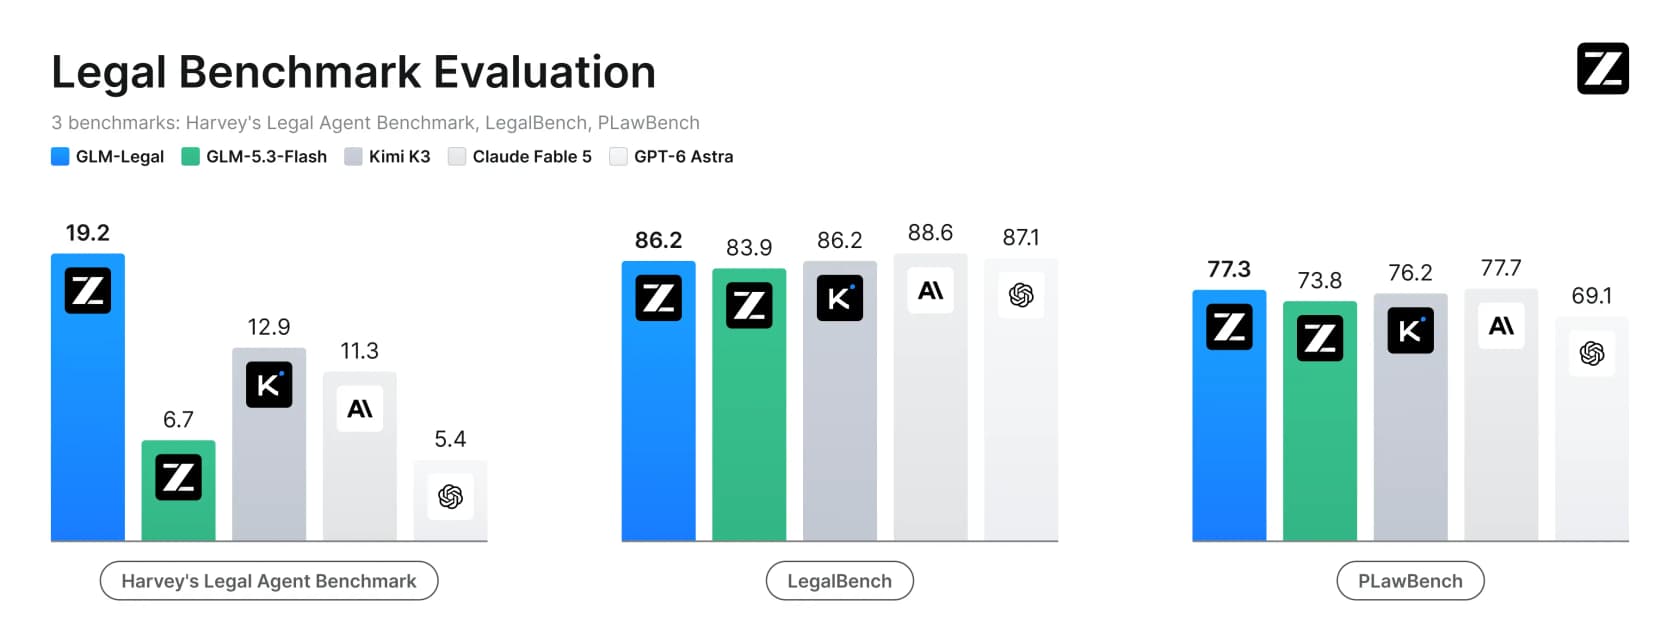
| ベンチマーク(Z.aiのグラフ) | GLM-Legal | GLM-5.3-Flash | Kimi K3 | Claude Fable 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Harvey Legal Agent Benchmark | 19.2 | 6.7 | 12.9 | 11.3 | 5.4 |
| LegalBench | 86.2 | 83.9 | 86.2 | 88.6 | 87.1 |
| PLawBench(中国法) | 77.3 | 73.8 | 76.2 | 77.7 | 69.1 |
よく見ると、「matches frontier models」は聞こえより狭い意味です。GLM-Legalが明確に勝つのは1列だけです。LegalBenchとPLawBenchでは、Claude Fable 5と並ぶか1〜2ポイント下回ります。アクティブパラメータ18Bのモデルとしては十分に強い結果ですが、古いテストでは同等、新しい1つのテストでリードという内容です。
スコアが低く見える理由
HarveyのLegal Agent Benchmarkは、エージェントにファイルのフォルダ、6つのツール(ファイルの読み取り、編集、書き込みに加え、検索とシェル)、Word、Excel、PowerPointのスキルを与えます。各タスクには評価基準のルーブリックがあり、主要な数字はオールパス率です。すべての基準を満たしたときだけそのタスクが成功として数えられます。
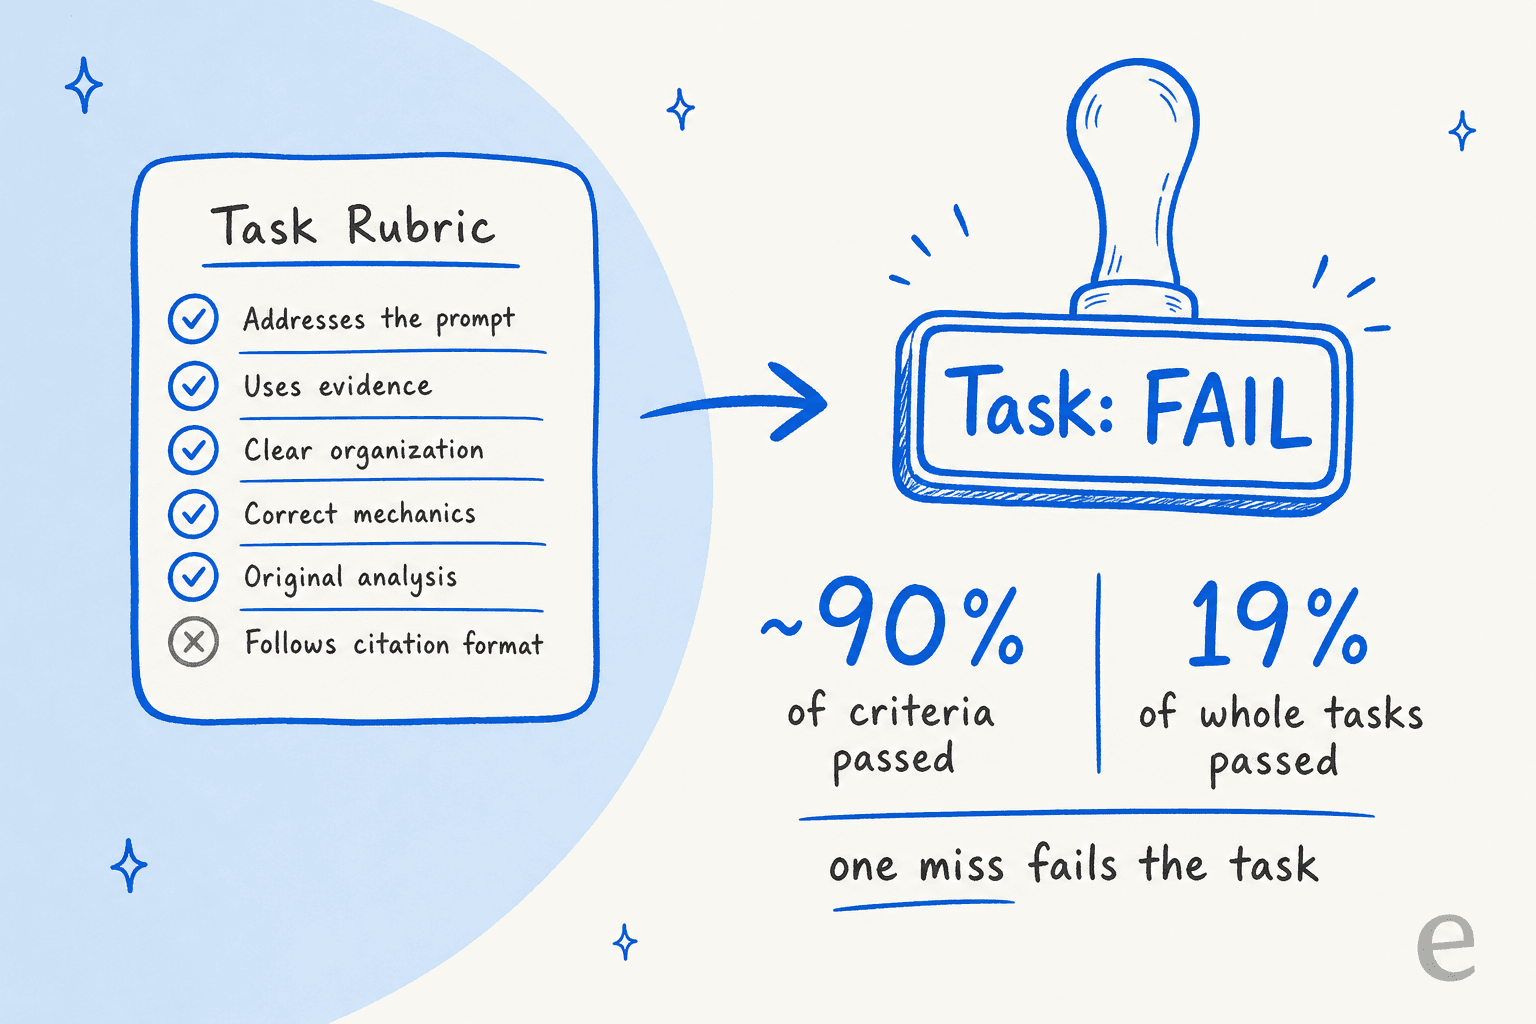
Valsによれば、トップモデルは個々の基準の約90%に合格しますが、タスク全体での最高スコアは25.42%です。つまり19%のモデルが5回中4回間違えるわけではありません。たいていは作業の大部分を正しくこなし、1つの要件を落とします。法務では、その1つの見落としが問題のすべてになりえるため、厳しい採点にも一理あります。
"This is why I severely dislike using all pass rate. A model could be at like 93%, meeting practically every requirement except the broken ones and all pass would give it like 20%."

独立したリーダーボードが示すもの
Z.aiはGLM-LegalをVals AIに送って独立テストを受けており、全モデルを含むValsのHLABリーダーボードのほうが有用です。
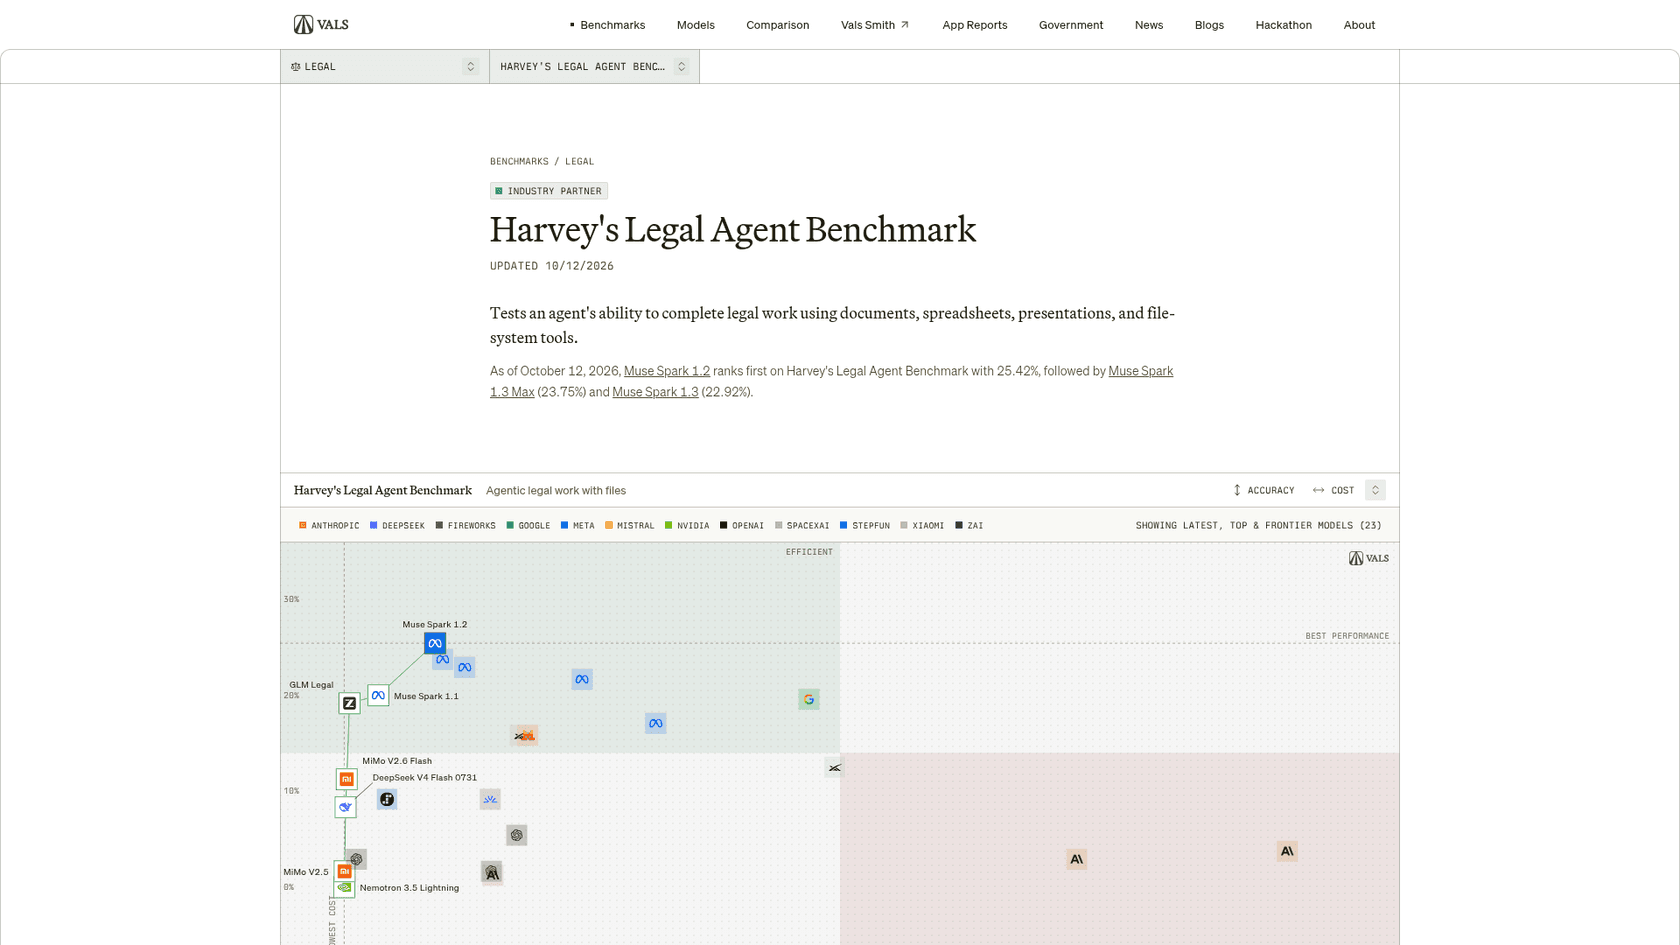
| 順位 | モデル | タスク合格率 | 1タスクあたりのコスト | 1タスクあたりの時間 |
|---|---|---|---|---|
| 1 | Muse Spark 1.2 | 25.42% | $2.09 | 24m16s |
| 2 | Muse Spark 1.3 Max | 23.75% | $2.26 | 14m43s |
| 3 | Muse Spark 1.3 | 22.92% | $2.76 | 17m04s |
| 4 | Muse Wonder Full | 21.67% | $5.41 | 53m21s |
| 6 | Gemini 4 Argon | 19.58% | $10.55 | 43m55s |
| 7 | GLM-Legal | 19.17% | $0.15 | 1h12m |
| 9 | Mistral Large 4 | 15.83% | $4.18 | 39m25s |
| 12 | Kimi K3 | 12.92% | $3.83 | 13m58s |
| 31 | GLM-5.3-Flash(ベース) | 6.67% | $0.57 | 52m17s |
| 41 | Claude Opus 5.5 | 3.75% | $21.38 | 52m55s |
目立つ点が2つあります。1つ目は、6.67%から19.17%への上昇がZ.aiの主張する12.5ポイントと一致しており、ベンダーの数字が裏付けられたことです。2つ目は、Metaの4モデルがGLM-Legalを上回っているのに、Z.aiのグラフには1つも載っていないことです。HNのコメント投稿者がローンチ当日に指摘しました。Valsのモデルページでは、GLM-LegalはLegalBenchで86.23%(150モデル中14位、GLMとして最高)、Legal Research Benchで41.83%(78モデル中24位)も記録しています。
Harveyのテスト自体にも批判があります。エージェントのトレースを調べたHNのコメント投稿者は「found multiple problematic tasks and rubrics」と述べ、Harveyのリポジトリにある未解決のissueを紹介しました。19%のスコアに対する±3.25ポイントの誤差は大きいものです。GLM-LegalとGemini 4 Argonは順位付けではなく同等として扱うのがよいでしょう。
本当の話:1タスクあたりのコストと待ち時間
GLM-Legalが1タスク10ドルで19%だったなら、誰も記事にしなかったでしょう。注目される理由は請求額です。
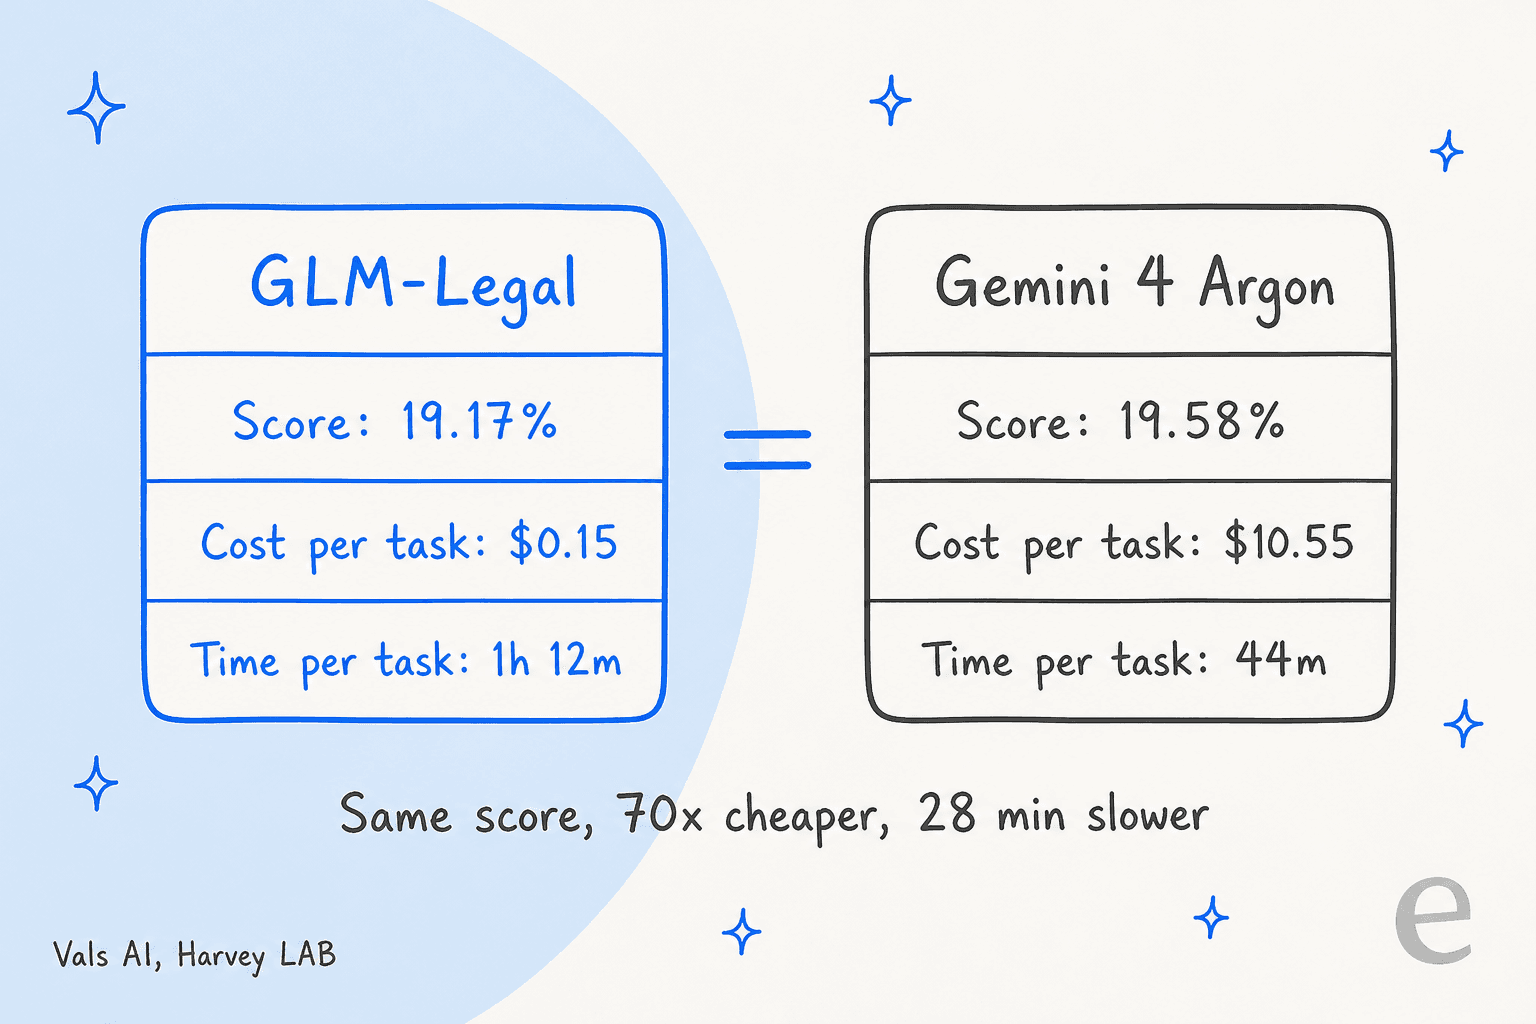
Valsの数字では、GLM-LegalはGemini 4 Argonと同じスコアを約70分の1のコストで達成しており、Valsはトップ10で最も安いモデルだと述べています。代償は時間です。1タスク72分で、Argonは44分、首位は24分です。夜間に回すデューデリジェンスのバッチなら問題になりません。通話前にレッドラインを待つ弁護士にとっては問題です。
月間のタスク数を入力して、このトレードオフがどうなるか確認してください。
月500タスクの場合、Valsの数字ではGLM-Legalが約75ドル、Gemini 4 Argonが5,275ドルで、エージェント時間はそれぞれ約600時間と366時間です。Muse Spark 1.2は約1,045ドルでその中間に入り、どちらよりも多くのタスクに合格します。ドルあたりのスコアだけを見ればGLM-Legalが圧勝します。1時間あたりの合格数で見ればMetaのモデルです。
GLM-Legalの価格とアクセス
ローンチのこの部分は、まだほとんど空白です。現時点で公開されている情報は次のとおりです。
| 質問 | 2026年10月14日時点の回答 |
|---|---|
| サインアップして使えますか? | いいえ。相談フォーム(会社、規模、役職、用途)に記入してAPIアクセスを申請します |
| GLM-Legalの価格はありますか? | Z.aiの料金ページにはありません |
| ベースモデルの価格は? | GLM-5.3-Flash:入力100万トークンあたり0.15ドル、キャッシュ0.03ドル、出力0.50ドル |
| Valsはどの料金でテストしましたか? | 入力0.075ドル、出力0.25ドル。9月9日に終了したFlashのローンチプロモーション価格 |
| AutoClawで使えますか? | ローンチ記事によれば「Soon」 |
| 重みをダウンロードできますか? | 現時点ではできません。Z.aiのHugging FaceページにGLM-Legalのリポジトリはありません |
重みの扱いは決着していません。ValsのモデルカードにはWeights: Openとありますが、Z.aiのローンチ記事にライセンスの記載はなく、HNの複数の読者はクローズドだと結論づけています。ベースモデルはオープンで、私のGLM-5.3-Flashレビューでも触れています。Z.aiが重みかライセンスを公開するまでは、GLM-LegalはAPI専用と考えて計画するのがよいでしょう。ベースモデルの料金表の詳細は、GLM-5.3-Flashの料金をご覧ください。
何より重要なのは、クライアントの文書がどこに送られるかです。米国のラボのAPIに契約書を送りたくない法律事務所が、中国のラボに送る可能性は低く、API専用のリリースは、これまでのGLMモデルがプライバシーに敏感なチームに支持されてきたセルフホストの道を閉ざします。
"Wait, so this not an open weight model, correct? Only available via z.ai?"
弁護士と開発者の反応
HNのスレッドはおおまかに3つの立場に分かれました。現役の弁護士は、絶対値には感心しませんでした。
"As an attorney, I am not particularly impressed about a 20% pass rate on a benchmark. The name of the game for litigation practice is about being prepared for novel situations, not relitigating past ones."
ベンチマークに詳しい人たちは、相対的な位置を指摘しました。
"To be fair to them, on this particular benchmark (Harvey's Legal Agent) 20% puts it almost top of the pack of any model, and certainly top for any remotely in its price class."
そして3つ目のグループは、法務AIの最も古い問題、つまり存在しない判例の捏造を心配しました。あるコメント投稿者は、ローンチが「tracked changes and human review」に頼っている一方で、「LLMs outright hallucinating cases or holdings」をどう検知するかには触れていないと指摘しました。別の弁護士は、レッドラインについてより微妙な点を挙げました。「I don't just see what's there but also what is missing.」と。存在しない条項に気づくことは、モデルにとって、ある条項を編集するより難しいのです。
Xでは、Z.aiの発表への最上位の返信は単に「We need glm illegal」で、1,200件を超えるいいねが付きました。インターネットはインターネットのままです。
GLM-Legalとフロンティアモデル、法務AIプロダクトの比較
区別しておきたい比較が3つあります。
汎用のフロンティアモデルとの比較では、GLM-LegalはHarveyのエージェントテストで勝ち、LegalBenchではほぼ並びます。Claude Opus 5.5はValsの実行で1タスクあたり約140倍のコストがかかり、スコアは3.75%です。法務業務が他の業務と混在している場合や、Valsのテストで非対応だった画像入力が必要な場合は、汎用モデルのほうが適しています。
MetaのMuse Sparkシリーズとの比較では、GLM-Legalはスコアと速度で負けます。Muse Spark 1.2は3分の1多くのタスクに合格し、3分の1の時間で、1タスク約2ドルです。1タスク2ドルで問題なければ、現時点ではMetaのモデルのほうが強い選択肢です。
Harvey AIのような法務プロダクトとの比較では、カテゴリーが違います。Harveyはモデルの周りにあるワークフロー、権限、監査証跡、事務所全体への展開を売っており、その料金もそれを反映しています。GLM-Legalは、リーガルテック企業が土台にできる部品です。これがHarveyの利益率と関係があるのかと疑問を呈したHNのコメント投稿者は、この点を指していました。安価な特化モデルは、製品レイヤーだけを課金対象として残します。そのレイヤーが実際に何をしているかは、私のHarvey AIレビューで説明しています。
では、誰がベータを申請すべきでしょうか。夜間に大量の一次レビュー(デューデリジェンス、契約のトリアージ、ディスカバリーの時系列)を回し、どのみち人がすべての出力を確認するリーガルテックのチームです。そこでは0.15ドルと72分は優れたトレードオフです。それ以外の方は、価格、重み、実際の案件で動かした人による独立レビューを待てば十分です。モデルではなく完成したツールを探しているなら、法律事務所向けのAIライティングツールの一覧のほうが出発点として適しています。
サポートチームを率いる人にとってのGLM-Legal
法務モデルの記事を読む人の多くは、法律事務所で働いていません。返金条件、保証の請求、データ削除の依頼、「can you send me a copy of my data under GDPR」のような、法的な側面を持つ問い合わせに対応するサポートや運用のチームを率いています。
そうした用途に法務モデルは不向きです。これらの質問は判例に関するものではありません。ヘルプセンターや社内ドキュメントに書かれた自社のポリシーに関するもので、より賢いモデルが別の議論を組み立てられるとしても、正しい答えは自社のポリシーが言うことです。これは推論の問題ではなく、検索の問題に人への引き継ぎを組み合わせたものです。
私はeeselで長年、実際のサポートキューに入るエージェントを作ってきました。GLM-Legalのベンチマークから得られる教訓は、私たちが何度も学び直しているものです。危険なのは、チェックの90%に合格する出力です。DTCサプリメントブランドのサポート責任者は、私たちとの通話でその要件をはっきりと述べました。
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
だからこそ、eeselはすべての導入で、実際の顧客に回答する前にチームの過去のチケットで検証を行い、返金、法的な脅し、データコンプライアンスに関わるものは直接人に回せるようにしています。設定方法はハルシネーション対策ガイドで説明しています。法務系のクライアントを自社で担当している場合は、法務向けのAIカスタマーサービスで、そのケースをさらに掘り下げています。
eeselを試す
GLM-Legalはインフラです。申請してハーネスに組み込み、プロンプトを書き、監視し、トークン単位で支払うモデルです。eeselは従業員です。AIヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgiasなどの既存のキューに参加し、ヘルプセンターと過去のチケットから返金、保証、データのポリシーを学び、自信のないものは要約を付けて人に引き継ぎます。誰かに返信する前に、過去の数百件のチケットにどう回答していたかを確認できます。

チームがターミナルから操作したい場合は、eesel CLIでチームメイトの常設ルールの閲覧と編集、承認待ちのアクションの確認、何をなぜ行ったかの確認ができ、コーディングエージェントがリポジトリを管理するのと同じようにサポートのチームメイトを管理できます。コンテンツを書く立場であれば、同じ顔ぶれにAIブログライターも含まれます。
自社のポリシーに基づいてポリシーの質問に答え、止まるべきときを知っているAIがほしいですか?先月のチケットでeeselを試して、どれを処理できたか確認してください。