

IBM Granite 4.2は、2026年8月25日に3B、8B、30Bの3サイズで公開されたIBMのオープン推論モデルファミリーで、すべて寛容なApache 2.0ライセンスです。Granite 4.0からの最大の変更点は、モデルに組み込まれたネイティブの「thinking」推論で、3つの切り替え可能なモード(フルthinking、非thinking、低負荷)と、大幅に強化されたツール呼び出しを備えています。
使う価値はあるのか。何を重視するかによります。
- **信頼でき、ライセンス面でも安心なオンプレAIがほしい場合:**はい。署名付きウェイト、スタンフォードの透明性評価での高評価、Apache 2.0により、Graniteは企業にとって安全な選択肢で、小型モデルは汎用ハードウェアでも高速に動きます。
- **コーディングやエージェントで最高の生スコアがほしい場合:**おそらく違います。純粋な能力では、ローカルLLMコミュニティは今もQwenを選び、IBMは主に自社モデル同士で比較しています。
- **完成したサポートエージェントがほしい場合:**層が違います。Graniteはエンジンであり、AIヘルプデスクのチームメイトではありません。検索、ガードレール、テストは自分で上に構築する必要があります。
最も安く試す方法:Apache 2.0なのでセルフホストは無料です(3BはOllama経由で2.2 GBのダウンロード)。ホスト型APIでは、Replicateが8Bを100万トークンあたり$0.06/$0.25で提供しています。
Granite 4.2のようなオープンモデルで私が見るポイント
私の立場を簡単に説明します。私はeeselでAIエージェントを開発しており、何年も実際のサポートキューにAIを投入してきました。そのため、ベンチマークを追う人とはモデルのリリースの読み方が違います。AIMEの高スコアは結構なことです。私が本当に気にするのは、モデルが気に入らない指示にも従えるか、存在しないツールをでっち上げずに正しいツールを呼べるか、ナレッジベースに根拠を置き続けられるか、4,000件目のチケットでもデモと同じように振る舞えるかです。自信ありげなモデルが静かに誤答する場面を私たちは見てきました。だからこそ、本番のお客様に触れる前に、あらゆる展開を過去のチケットでシミュレーションしています。
そこで本レビューでは、その視点でGranite 4.2を見ていきます。実際に何が変わったのか、ベンチマークは正直なところどこに位置するのか、運用にいくらかかるのか、誰に向いているのかです。
Granite 4.2で何が変わったか
一言で言えば、Granite 4.2はネイティブ推論を追加しました。Granite 4.0が高速で効率的なinstructモデルだったのに対し、4.2は回答の前に<think>...</think>タグの中で計画し、自己修正し、段階的に推論できます。数学、複数ステップの論理、そして私が特に重視する、どのツールをなぜ呼ぶかの判断で最も効果があります。
巧みなのは、推論が1つのモデルの中で切り替えられる点です。chain-of-thoughtが不要な質問にそのコストを払わずに済みます。
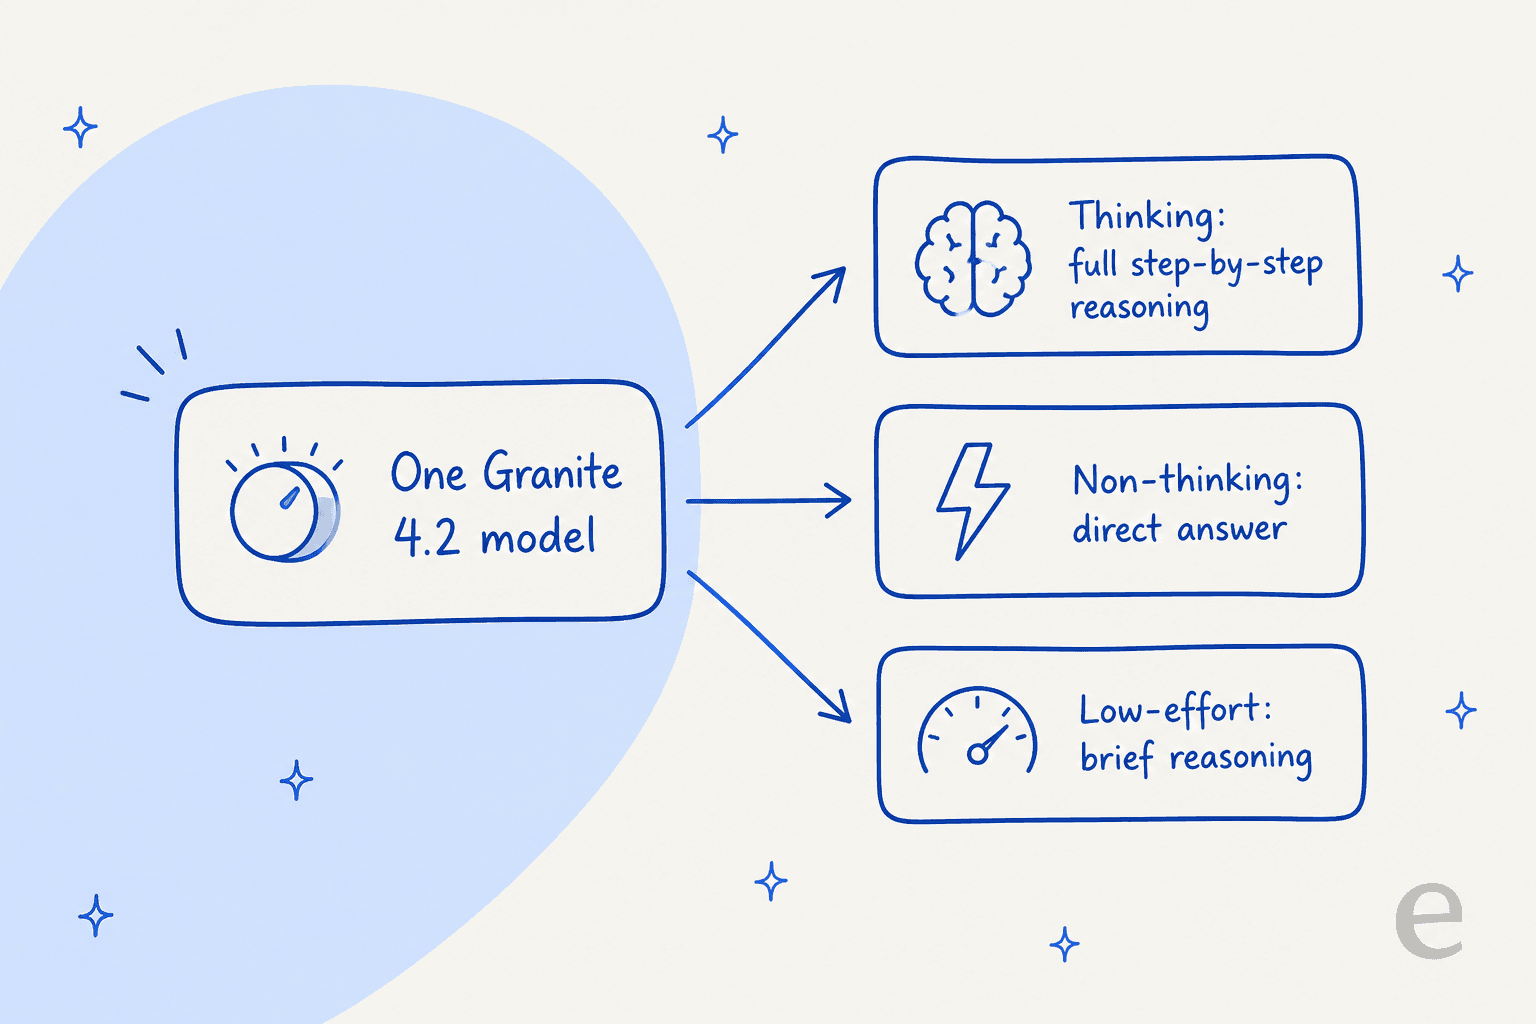
- Thinking(デフォルト)は完全なchain-of-thoughtを行います。
- 非thinkingは推論をまるごと省いて直接答えます。大量のリクエストをさばく際に、遅延やトークンコストを抑えたい場合に重要です。
- 低負荷は、より単純なクエリ向けに簡潔な推論を行う中間のギアです。
Ollamaでは/set thinkと/set nothinkで切り替えられ、ユースケースごとにコストと品質を調整したい人には嬉しい工夫です。
アーキテクチャにも話題があり、潮流に逆行している点は触れておく価値があります。Granite 4.0は、メモリ効率のためにmixture-of-expertsを備えたMamba-2とtransformerのハイブリッド設計でした。Granite 4.2は、素直なdecoder-only dense transformerです。IBMの説明は「its dense architecture supports broad compatibility」というもので、混在したハードウェアやサービング環境に展開するなら実際に意味のある点です。また、見出しのパラメータ数がモデル全体を指し、アクティブ対総数のごまかしがないということでもあります。
リリースの締めくくりとして、多言語対話は12言語でテストされており、IBMはエッジの音声処理向けに、LLMと並んで2つの小型のGranite Speech 5.0 Turbo文字起こしモデル(470Mパラメータ)も公開しました。
3つのモデル:3B、8B、30B
Granite 4.2はちょうど3つのdenseモデルで、それぞれ対応するGranite 4.1ベースからポストトレーニングされています。すべてネイティブで128Kトークンのコンテキストを扱い、30Bは512Kまで拡張されます。
| モデル | パラメータ | レイヤー数 | コンテキスト | Ollamaダウンロード | 最適な用途 |
|---|---|---|---|---|---|
| granite-4.2-3b | 3B dense | 40 | 128K / 512K | 2.2 GB | エッジ、ノートPC、低コストの大量処理 |
| granite-4.2-8b | 8B dense | 40 | 128K / 512K | 5.3 GB | バランスの取れた汎用の主力 |
| granite-4.2-30b | 30B dense | 64 | 128K / 512K | 18 GB | 推論とエージェント型タスクの旗艦 |
IBMは全サイズの公式量子化(fp8、mxfp4、nvfp4)に加え、llama.cppやLM Studio向けのコミュニティ製GGUFビルドも提供しています。知っておくべき点として、モデルカードはGraniteをリスク検出用の別の安全性モデルであるGranite Guardian 4.1 8Bと併用することを明示的に推奨しています。「4.2」の名称が指すのは3つの言語モデルだけで、Vision、Guardian、Speechはそれぞれ別のバージョン系列です。
ベンチマーク:Granite 4.2の実際の位置
こちらがIBM自身による主要な比較で、30BをNvidiaのNemotron 3 Super 120BおよびGoogleのGemma 4 31Bと比べたものです。
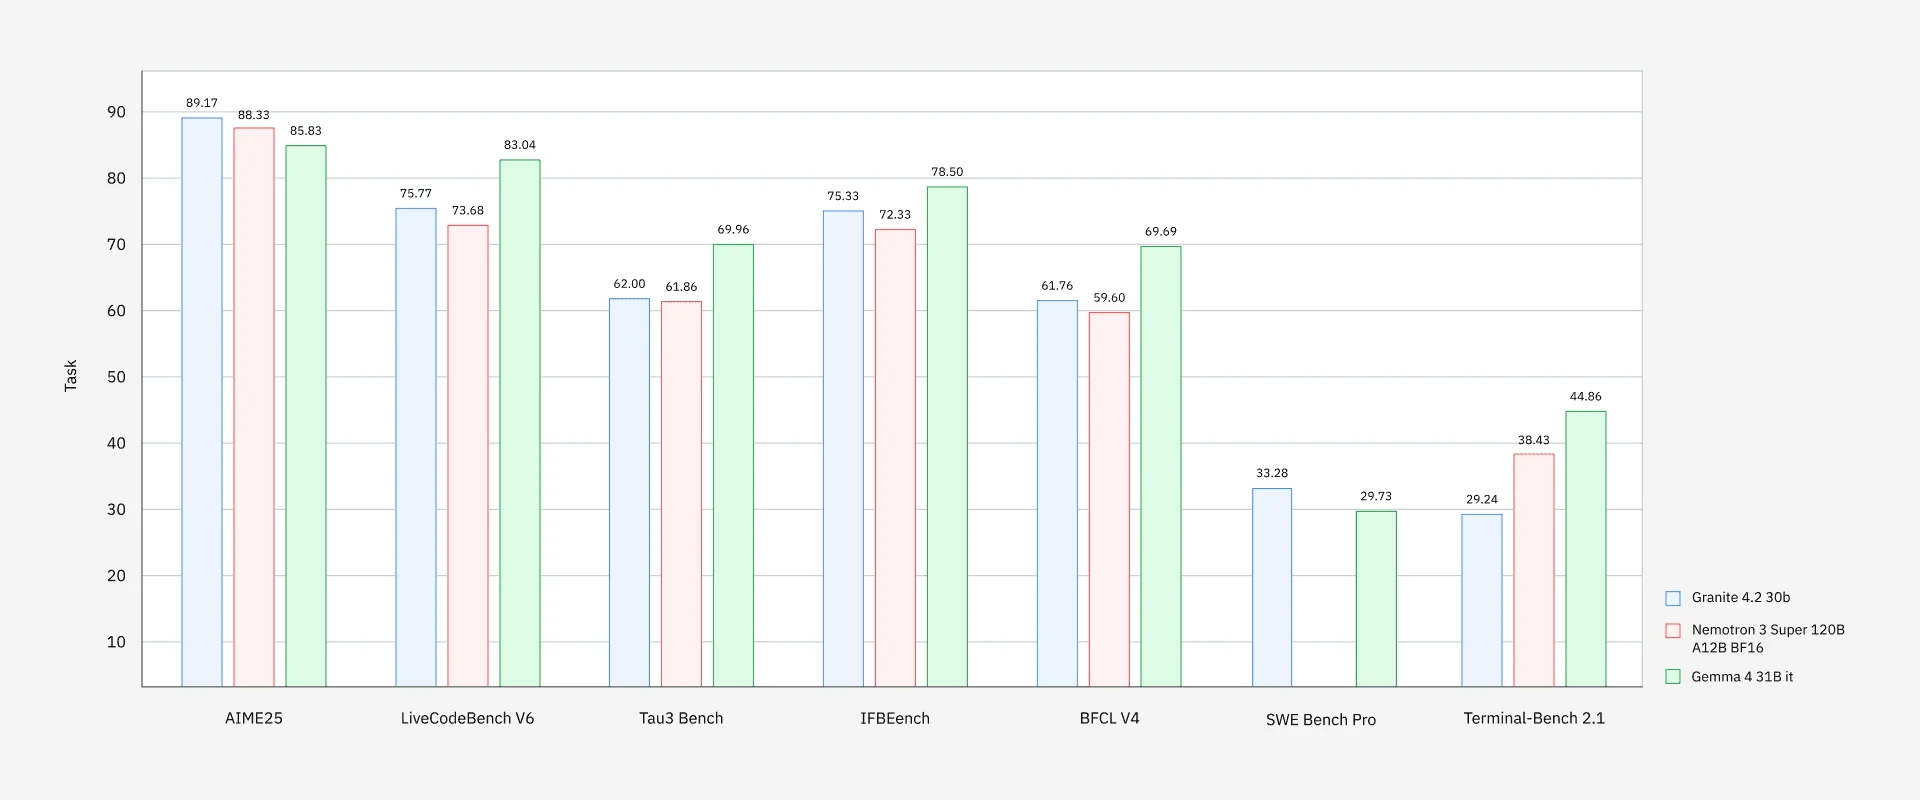
IBMが語りたいストーリーは本物です。AIME25で30Bは89.17を記録し、120Bパラメータ級のNemotronモデルをわずかに上回り、LiveCodeBench、IFBench、BFCLでもリードしています。「はるかに低いコストで、より大きなthinkingモデルに匹敵する」というのは、このグラフの公正な要約です。
正直な留保も同じくらい重要です。
- **最も難しいエージェント型コーディングでは形勢が逆転します。**Gemma 4 31Bは、SWE-Bench ProとTerminal-Bench 2.1の両方でGraniteを上回ります。Graniteのコーディングエージェントの生数値(SWE-Bench Proで33.29、Terminal-Benchで29.24)はこのサイズとしては悪くありませんが、カテゴリ首位ではありません。
- **IBMは慎重に選んだ比較対象と競っています。**それでも比較を選ぶのはIBMです。4.1のリリース時にHacker Newsのコメント投稿者が述べたとおりです。
"No comparison with competitor models other than the previous granite version strongly implies that it does not compete well with other comparable models. At least this is the most reasonable assumption until data comes out to the contrary."

サポート自動化で私が重視する数値については、前向きな内容です。30Bはtau3-benchで62.00(エージェント的なツール利用)、BFCL v4(関数呼び出し)で61.39、MMLU-Proで77.60に達しています。これらはサポートエージェントが実際に頼るツール呼び出しと指示追従の筋力であり、8Bも十分近く(BFCL 52.39、MMLU-Pro 74.04)、コストを重視する展開では興味深い選択肢です。
推論とツール呼び出しのループの仕組み
エージェントを作る人にとって最も有用なアップグレードは、Granite 4.2がツールを呼ぶ前にそれについて推論することです。関数名をパターンマッチするのではなく、モデルがどのツールが適切か、なぜかを考え抜いてから呼び出します。注文を確実に検索するエージェントと、存在しない関数をでっち上げるエージェントの違いは、まさにここにあります。
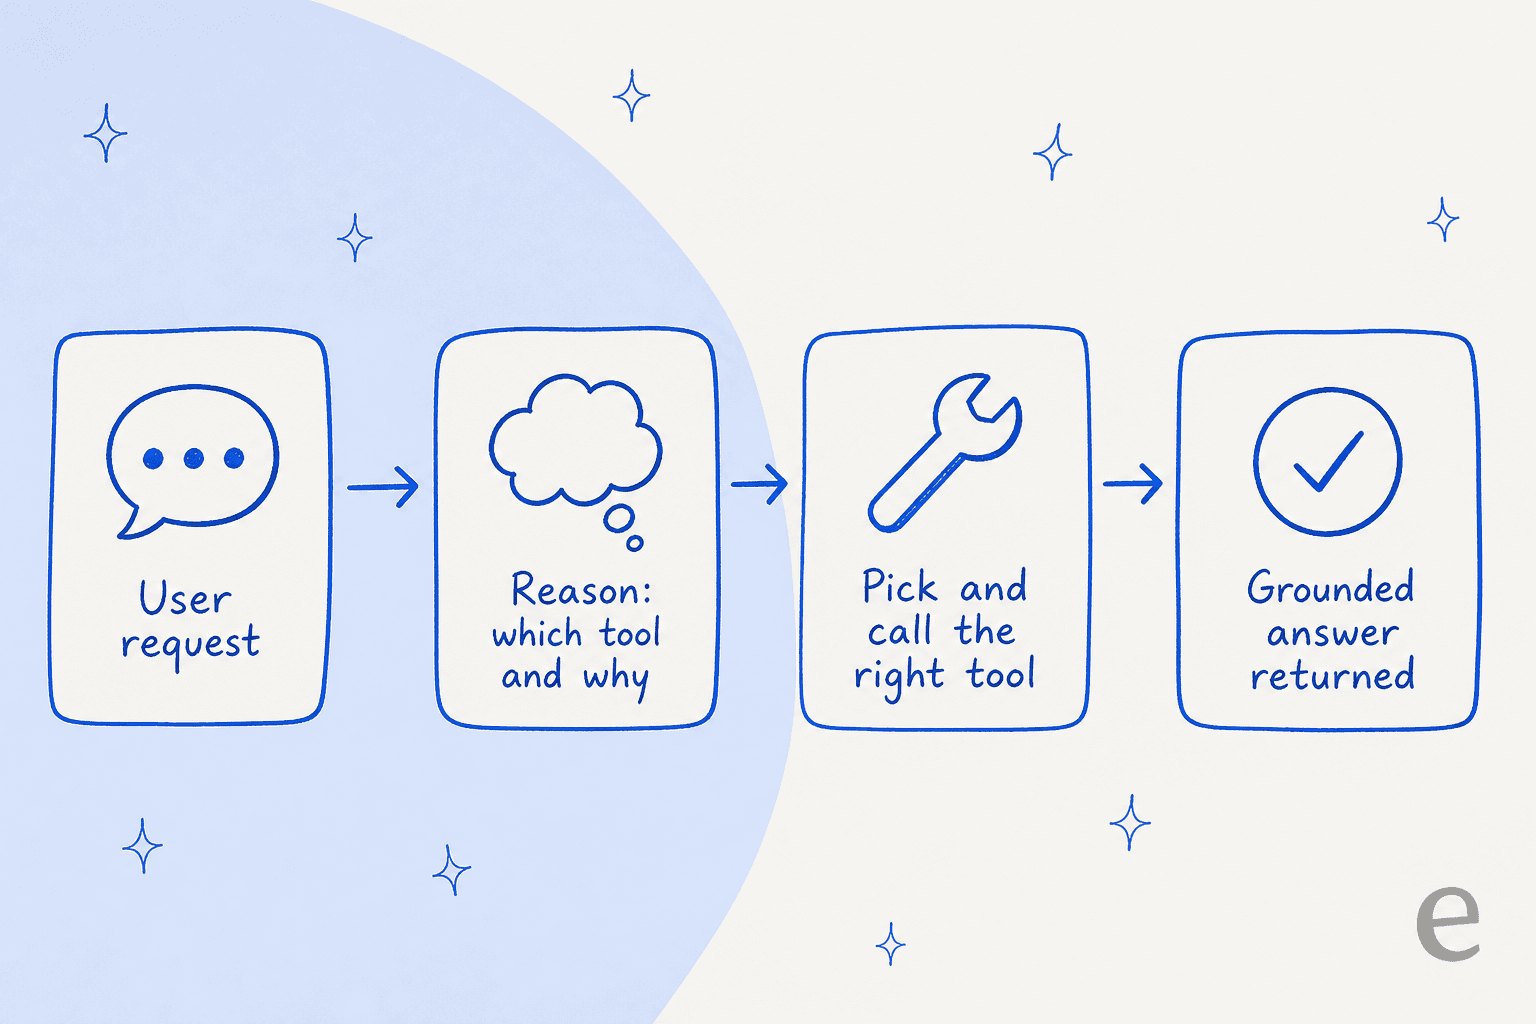
OpenAI互換APIとして公開されており、OpenCodeやOpenHandsのようなエージェント型コーディングハーネスでそのまま動きます。コミュニティの評価もこの設計を裏付けており、Graniteの小型モデルは構造化された作業が静かに得意です。
"IBM Granite 4H-Small, it's very good with tool calls. most tool-calling issues come from the model not sticking to the exact structure you"

ここは、モデル選びが実際のプロダクトと出会う層です。信頼できるツール呼び出しこそが、AIエージェントをルールベースのチャットボットと分けるものであり、注文の検索、チケットへのタグ付け、返金の実行を、もっともらしい文章を書くだけでなく実際に行えるようにします。
入手方法と料金
Graniteが魅力的なのはここです。Apache 2.0なので、下限は無料です。ライセンス料なしでダウンロード、ファインチューニング、本番投入ができ、実行する計算リソース以外にトークン単価もかかりません。実用的なルートは3つあり、利便性とコストが段階的に上がります。
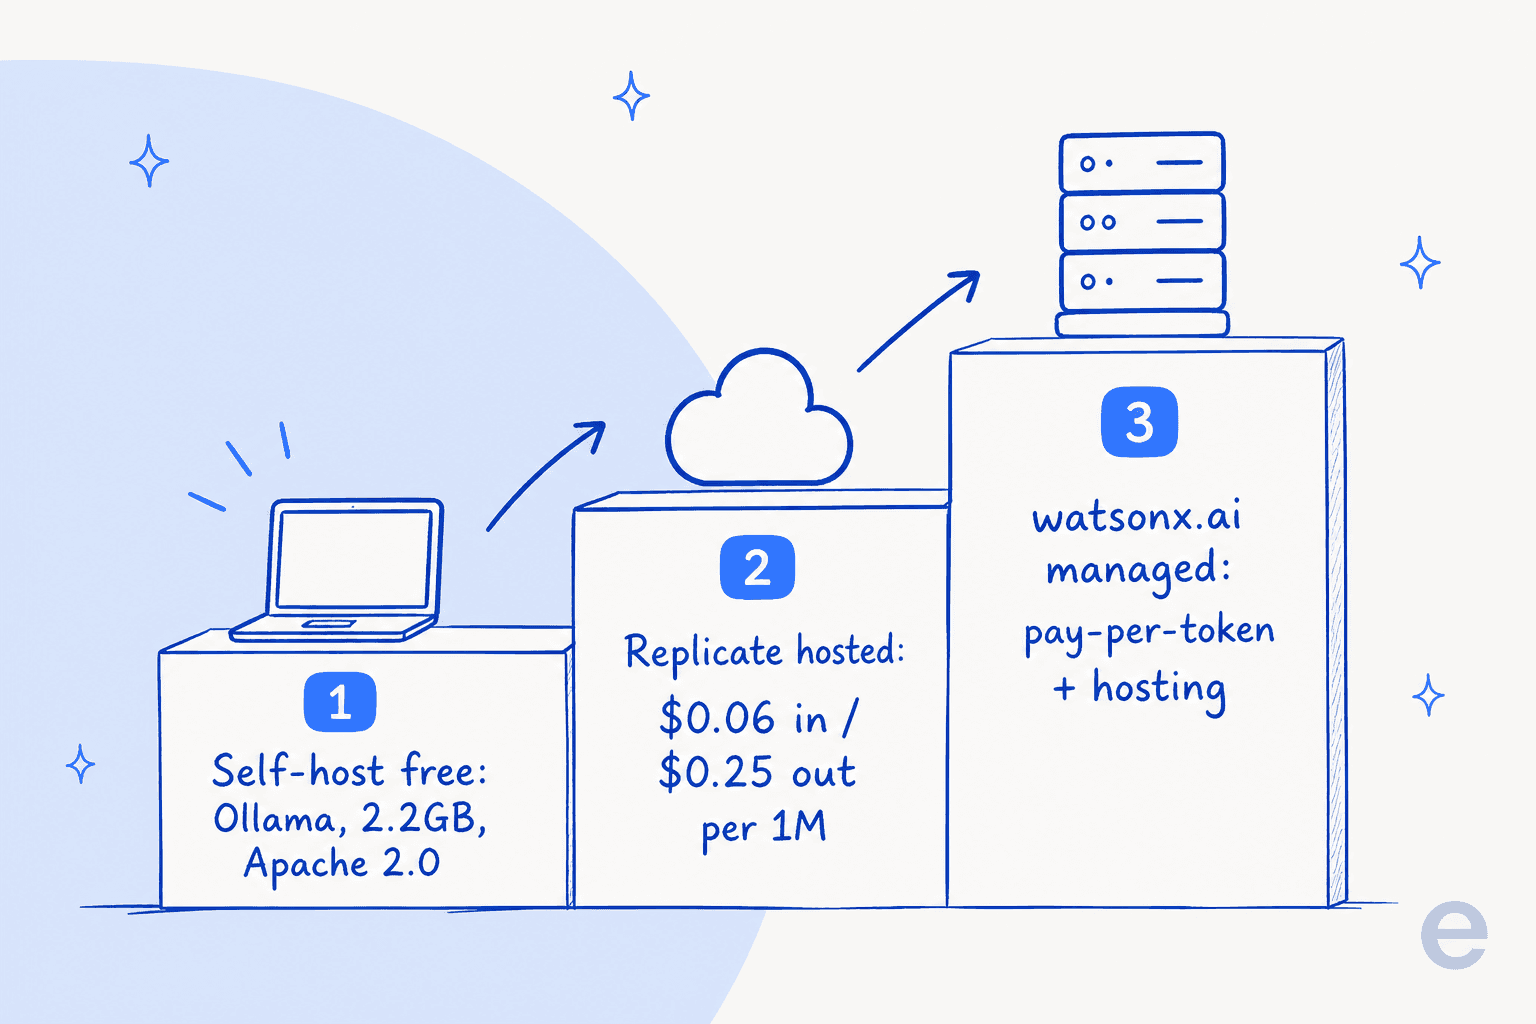
| ルート | 料金 | 備考 |
|---|---|---|
| セルフホスト(Ollama、vLLM、llama.cpp) | 無料(自前の計算リソース) | 3Bはノートで動作。30Bは~18 GB以上のVRAMが必要 |
| Replicateのホスト型API | 入力100万あたり$0.06、出力100万あたり$0.25 | 標準的な1回の実行で約$0.0014。8Bのみ、確認済み |
| watsonx.ai | 100万トークン従量課金+時間単位のホスティング | Standardプランは月額約$1,050。IBMのマネージドプラットフォーム |
正直な注記が2点あります。1つ目に、IBM独自のwatsonx.aiは企業向けのルートで、その料金モデル(100万トークンあたりの従量課金で、従来は1 Resource Unit = 1,000トークン、さらに時間単位のオンデマンドホスティング)は確認できましたが、確認した時点でライブのドキュメントの料金表が500エラーを返したため、Granite 4.2の正確な料金は特定できませんでした。確認できた最も近いGranite 4の料金は、100万入力あたり約$0.06、出力$0.27前後です。2つ目に、執筆時点で4.2モデルはまだOpenRouterに掲載されておらず、Granite 4.1 8Bと4.0 Microだけが表示されていました。
無料ルートをOllamaで試す様子を紹介します。多くの人が最初に試すのはこの方法でしょう。
コミュニティがすぐに見つけた落とし穴があります。ダウンロードサイズは、必要なメモリについて誤解を招きます。r/LocalLLaMAのスレッドでは、8Bが本来のサイズを超えて膨らむことが指摘されました。
"I downloaded the 5.3 GB Granite 4 8b model from Ollama library, but when I run the model, it bloats up to 27 GB, and won't fit onto the GPU VRAM"
これはKVキャッシュとコンテキストの確保によるもので、見込んでおくべき普通のことですが、ダウンロードサイズでGPUを選ぶと足りなくなります。特に長いコンテキストでは余裕を持たせてください。
コミュニティの実際の評価
Granite 4.xへの評価は一貫していて、私は的を射ていると思います。称賛は、IBMがまさに狙った点に集まっています。小型モデルは汎用ハードウェアで高速に動き、学習データが新しく、商用利用に制限のないライセンスであることです。
"I test drove it yesterday. It's pretty impressive at 8b. Runs on commodity hardware quickly... Granite has recent training data which is nice."
批判も同様に一貫しています。生の能力、とりわけコーディングでは、人々は今もQwenを選びます。
"Granite 8B is impressive, but Qwen still wins on raw capability, especially for coding."
そしてXのあるコメント投稿者は、IBM自身のマーケティングよりも的確にポジショニングを捉えました。Graniteはリーダーボードの頂点を狙うのではなく、信頼で勝負しているのです。
"IBM just released a model built to need less of your trust, not more of your capability. Granite 4.2 ships in 3, 8, and 30 billion parameter sizes, fully open under Apache 2.0. It's trained specifically for tool use, terminal work, and multistep agent tasks."
正直なところ、これがレビュー全体を一段落にしたものです。Granite 4.2は、動かせる中で最も賢いモデルになろうとはしていません。セキュリティ部門と法務部門が承認してくれるモデルになろうとしています。署名付きウェイト、ISO認証、高いスタンフォードの透明性評価、そして縛りのないライセンスです。ドメイン特化モデルをオンプレミスで構築する規制業種の企業にとって、この組み合わせはコーディングベンチマークの2ポイントより価値があります。
サポートチームとAIチームにとってGranite 4.2が合う場面
では、サポートチームやオペレーションチームは気にするべきか。はい。ただし、手にしているものが何かを明確にしておくと役立ちます。Granite 4.2はインフラ、つまりエンジンです。それ単体ではカスタマーサービスエージェントではなく、V8エンジンが車ではないのと同じです。
MLチームがいて最大限のコントロールがほしいなら(データがVPCの外に出ない、自社のチケットでファインチューニングしたモデル、大規模でもトークン課金なし)、Graniteのようなオープンモデルのセルフホストは現実的で、ますます人気の高い道です。8Bはカスタマーサービスの自動化の妥当な出発点です。ツール呼び出しが優れ、動かすコストが低く、ライセンスも明確です。残りは自分で構築することになります。ヘルプセンターに対する検索、エスカレーションのロジック、ハルシネーションへのガードレール、解決率を測る方法、そして本番前に安全にテストする方法です。
その「残りを自分で作る」ことこそが仕事のすべてであり、モデルレビューが飛ばす部分です。状況を悪化させずにティア1のチケットを実際に抑制するサポートエージェントを届けるうえで、モデル選びは多くても10%です。残りの90%は配管、テスト、運用上の安全性で、社内プロジェクトの多くがつまずくのはそこです。
eeselを試す:Graniteが提供しない層
モデルを土台に作ることではなく、動くサポートエージェントが目的なら、まさにそのギャップを埋めるのがeeselです。Graniteはエンジンを渡してくれます。eeselはそのエンジンを備え、さらにその周りのすべてを揃えた、すぐ働けるAIヘルプデスクのチームメイトです。過去のチケットとヘルプセンターで学習し、すでに使っているヘルプデスク(Zendesk、Freshdesk、Gorgias、そして1,000以上のその他の連携)に接続し、数四半期ではなく数分でキューに加わります。

違いは、冒頭で私が重視すると述べた点です。eeselが実際のお客様に1件でも回答する前に、数千件の過去のチケットでシミュレーションし、どのように返信し何を解決したはずかを正確に確認できます。これは、Graniteに限らず素のモデルには付いてこないセーフティネットです。お客様の1社であるGlobal Payは、これにより最大80%の時間削減を報告しました。
作るならGranite 4.2を使ってください。チケットに回答したいならAIヘルプデスクのチームメイトを使ってください。eeselを試すなら無料で、クレジットカードも営業との通話も不要で始められます。