

GLM-5.3 Flashは、現時点で呼び出せるモデルの中で、価格あたりの知能が最も高いモデルです。この点は反論しにくいでしょう。Artificial AnalysisのIntelligence Indexでは57点、1タスクあたり約0.045ドルで、フルサイズのGLM-5.3にわずか3ポイント差まで迫りながら、価格はごく一部です。GLM-5シリーズで初めてネイティブにマルチモーダルとなったモデルで、Z.aiが公表したすべてのベンチマークでGLM-5.2を上回り、オープンウェイトはHugging Faceで公開されています。
多くの記事が触れない点があります。これは安価なモデルですが、実質的な注意点が2つあります。Z.aiの自社APIでは遅く、毎秒約49トークンです。「AAがこれまで見た中で最も遅いモデル」という評判は、重みではなくこのエンドポイントに由来します。Databricksのようなホストに切り替えれば、同じモデルで毎秒273トークンが出ます。もう1つはデータです。署名済みの契約も、ゼロ保持の階層もなく、自社サービスは中華人民共和国の法律の下で運営されています。
結論を短く言えば、大量のコーディング、エージェントの実行、ビジョン作業を行い、レイテンシよりコストを重視するなら、特にセルフホストで、GLM-5.3 Flashは迷わず選べます。お客様の前でリアルタイムにモデルを動かすなら、価格はそもそも難しい問題ではなかったのです。その理由は最後に触れます。
まず、どのGLM-5.3をレビューするのか?
混乱しやすいので先に整理します。名前に「5.3」が付くモデルは2つあり、同じものではありません。
フラッグシップのGLM-5.3はテキスト専用のコーディング・サイバー向けモデルで、100万トークンあたり入力1.40ドル、出力4.40ドルです。GLM-5.3 Flashはより安価でマルチモーダルな姉妹モデルで、2026年8月26日に登場しました。このレビューの対象はこちらです。総パラメータ数3,200億、アクティブは180億のみのMixture-of-Experts構成で、ローンチ前にはZ.aiが「ox-alpha」という名前で匿名のままOpenRouterとOpenCodeで提供し、一時はその週で最も使われたモデルになりました。すべて中国製AIチップで提供されていました。
ですので、ベンチマーク表に「GLM-5.3」とあれば、どちらなのかを確認してください。以下で引用するスコアは、特に断らない限りFlashのものです。ファミリー全体を知りたい方は、GLM-5.3 Flashの概要で両者の位置づけを確認できます。
実際に業務で使うかもしれない大規模言語モデルを評価するときと同じ方法で検証しました。両方のスコアボードを読み、ベンダー自身のベンチマーク表を取得し、Artificial AnalysisやCloudflareのモデルページと照合し、マーケティング上の主張を、実際に試した実務者の声と突き合わせています。
ベンチマーク:実際の立ち位置
Z.aiの売り文句は、GLM-5.3 Flashが「outperforms GLM-5.2 across benchmarks and real-world workloads at one-tenth the price, while approaching Claude Opus 4.8 on coding and agentic benchmarks.」というものです。公表された表は、前半をはっきり裏付けています。
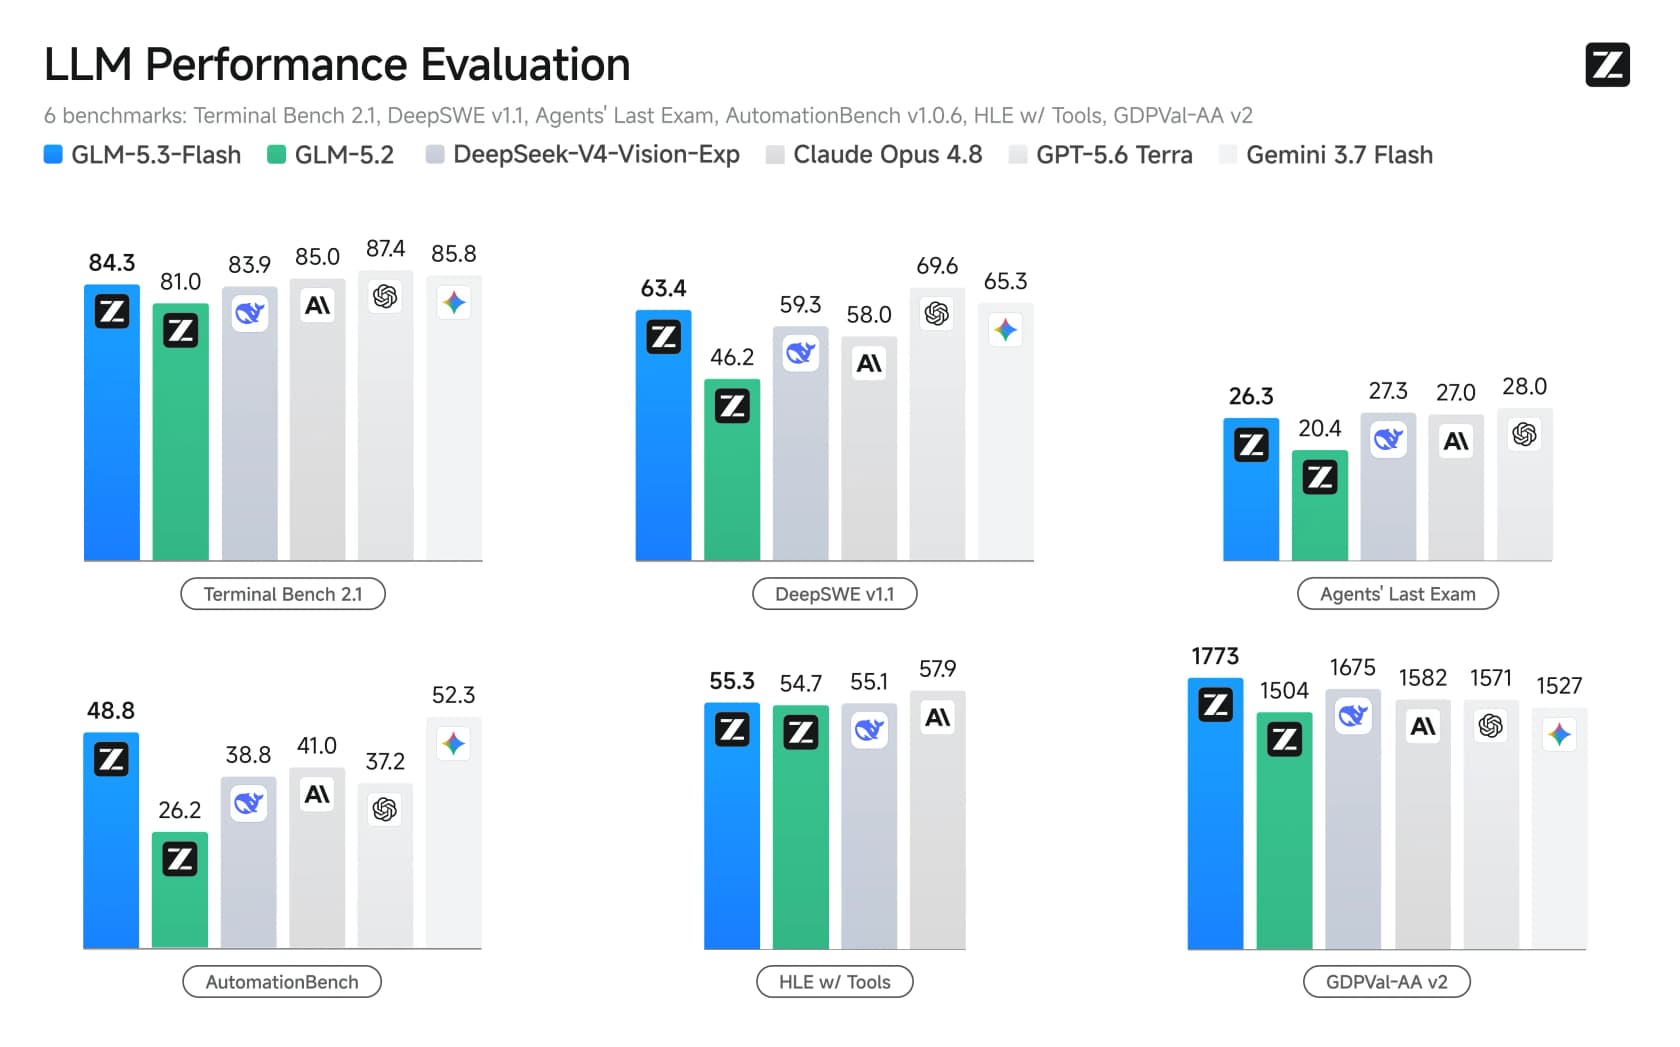
GLM-5.2からの伸びは大きく、一貫しています。DeepSWE v1.1は46.2から63.4へ、AutomationBenchは26.2から48.8へ、GDPval-AA v2は1504から1773へ上がりました。最大エフォートでClaude Code内で実行したZ.ai Code Bench v1.0では、FlashがClaude Opus 4.8の29.5に対して29.0で、「Opusにほぼ並ぶ」という表現そのものです。
コーディングとエージェント作業で「Opusに迫る」という言い方は妥当で、どこまでかについても正直です。クローズドなフロンティアモデルに対しては、DeepSWEはGPT-5.6 Terra(69.6)が、AutomationBenchはGemini 3.7 Flash(52.3)がわずかに上回ります。GLM-5.3 Flashが最高のクローズドモデルを完全に打ち負かしているわけではありません。10分の1の費用で同じ水準に入っている、という点が、より興味深い主張です。
表で明確に先頭に立つのは、低価格モデルに誰も期待しない2か所です。GDPval-AA v2では1773でトップ、ビジョンの項目ではCharXiv reasoningで89.4、MMVUで80.5を記録し、どちらもDeepSeek-V4-Vision-ExpとOpusを上回っています。これだけ安いモデルとしては意外な点です。
はっきり述べておきたい注意点として、どちらのページにもMMLU、GPQA、AIMEのスコアはありません。Z.aiが公表しているのはコーディング、エージェント、ビジョンのスイートで、従来型の学術知識の表ではありません。幅広い事実知識に依存する用途では、公表された根拠は何も語っていません。合否ではなく、データの空白として扱ってください。
価格がすべてを物語る
GLM-5.3 Flashをレビューする価値があるのは、この数字のためです。ローンチプロモ中は入力100万トークンあたり0.075ドル、出力0.25ドルで、キャッシュ入力は0.015ドルです。2026年9月9日にプロモが終わった後の定価は0.15ドルと0.50ドルです。いずれにしても、フラッグシップのGLM-5.3のおよそ10分の1で、市場全体の効率フロンティア上に位置します。
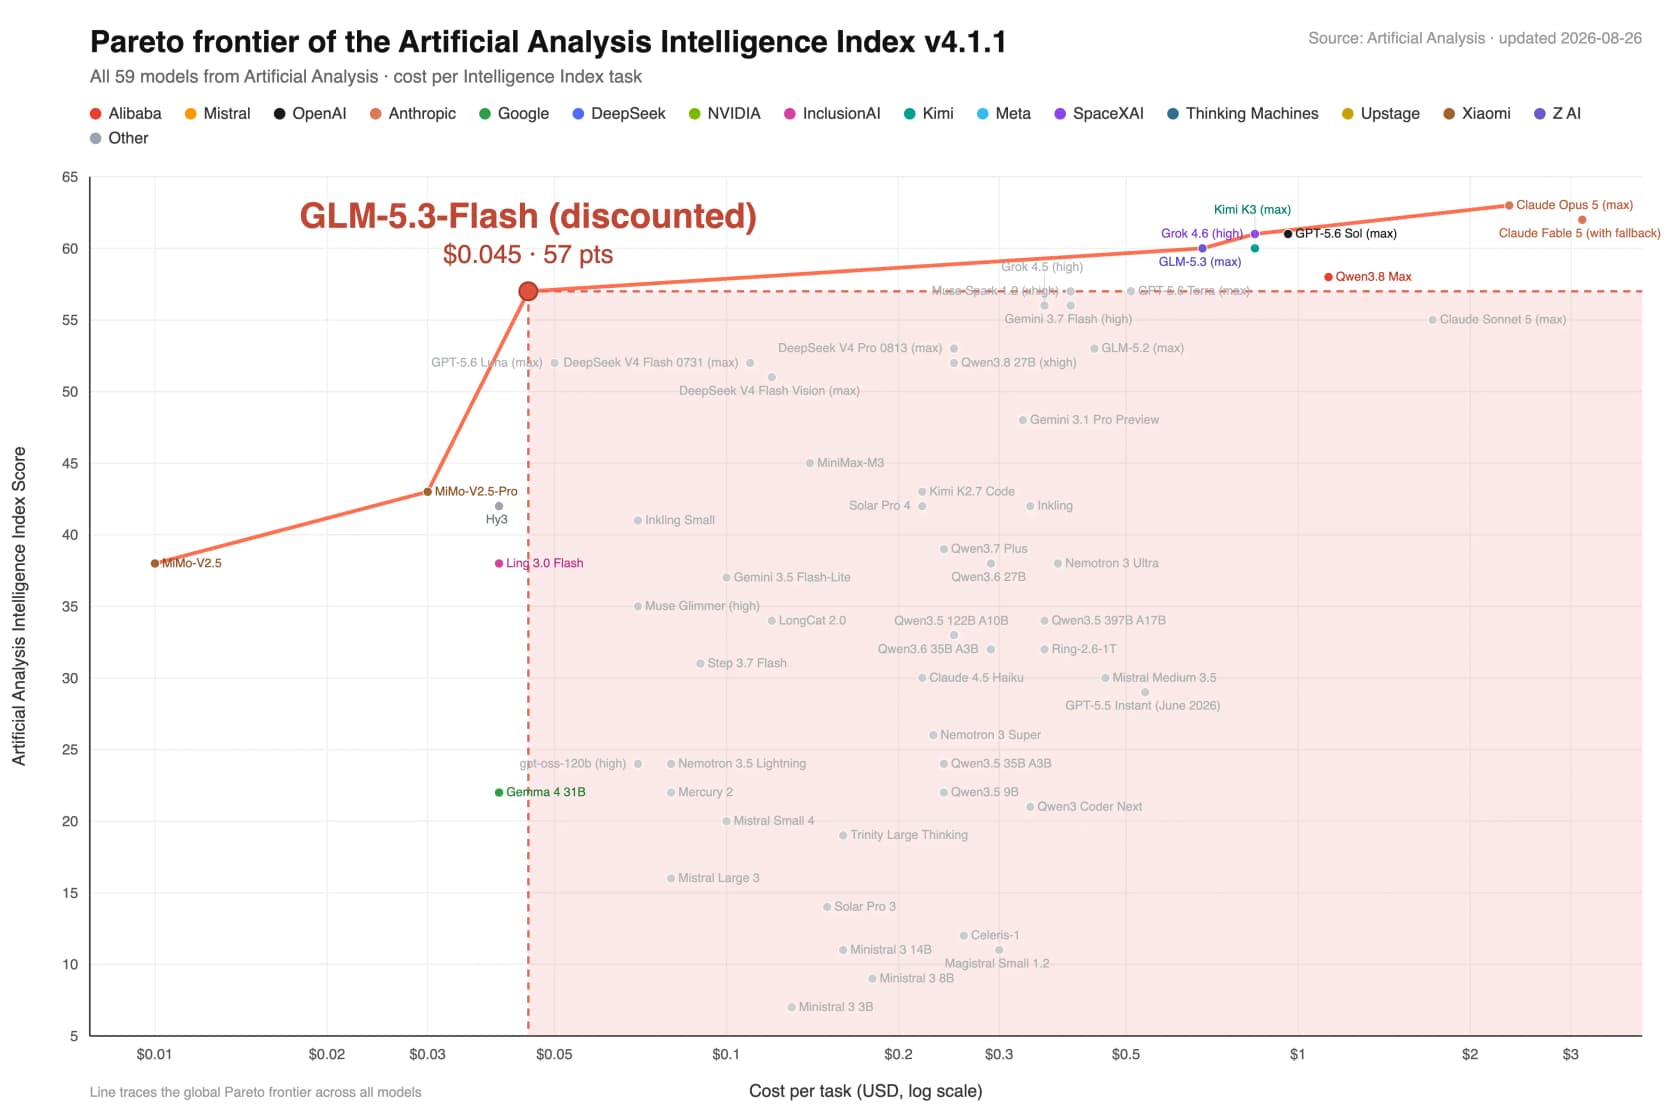
その赤い点が売りです。GLM-5.3 Flashはパレートフロンティアを押し広げています。その知能で、これより安いモデルはグラフ上にありません。Z.aiの言葉では「a level of intelligence previously only available at roughly 10x the cost.」です。コミュニティの反応は、まさにその点への驚きが中心でした。
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Coding Planの経路にも触れておく価値があります。多くの人が実際にこのモデルに出会うのはここだからです。Z.aiのGLM Coding Planは、Lite、Pro、Maxで月額18ドル、80ドル、168ドルで、Claude Code、Cline、OpenCode、Cursor、Roo Codeで使え、同じプランでFlashならGLM-5.3の3倍の利用枠が得られます。すでにコーディング用のサブスクリプションを払っているなら、Flashにすればクレジットが3倍長持ちします。他の低価格フロンティア級との比較は、近いライバルを扱うDeepSeek V4 FlashレビューとKimi K3レビューをご覧ください。価格が一段上がるのがQwen 3.8 Maxです。
最も重視する点を選んでください。率直な見解をお伝えします。
なぜこれほど安くできるのか
これだけ安いと、たいてい小さくて性能の低いモデルです。このモデルはどちらでもなく、その理由は、すぐ消える値引きではなくアーキテクチャにあります。Z.aiの説明では、コストは1つの工夫ではなく、3つの層が連携して生まれています。
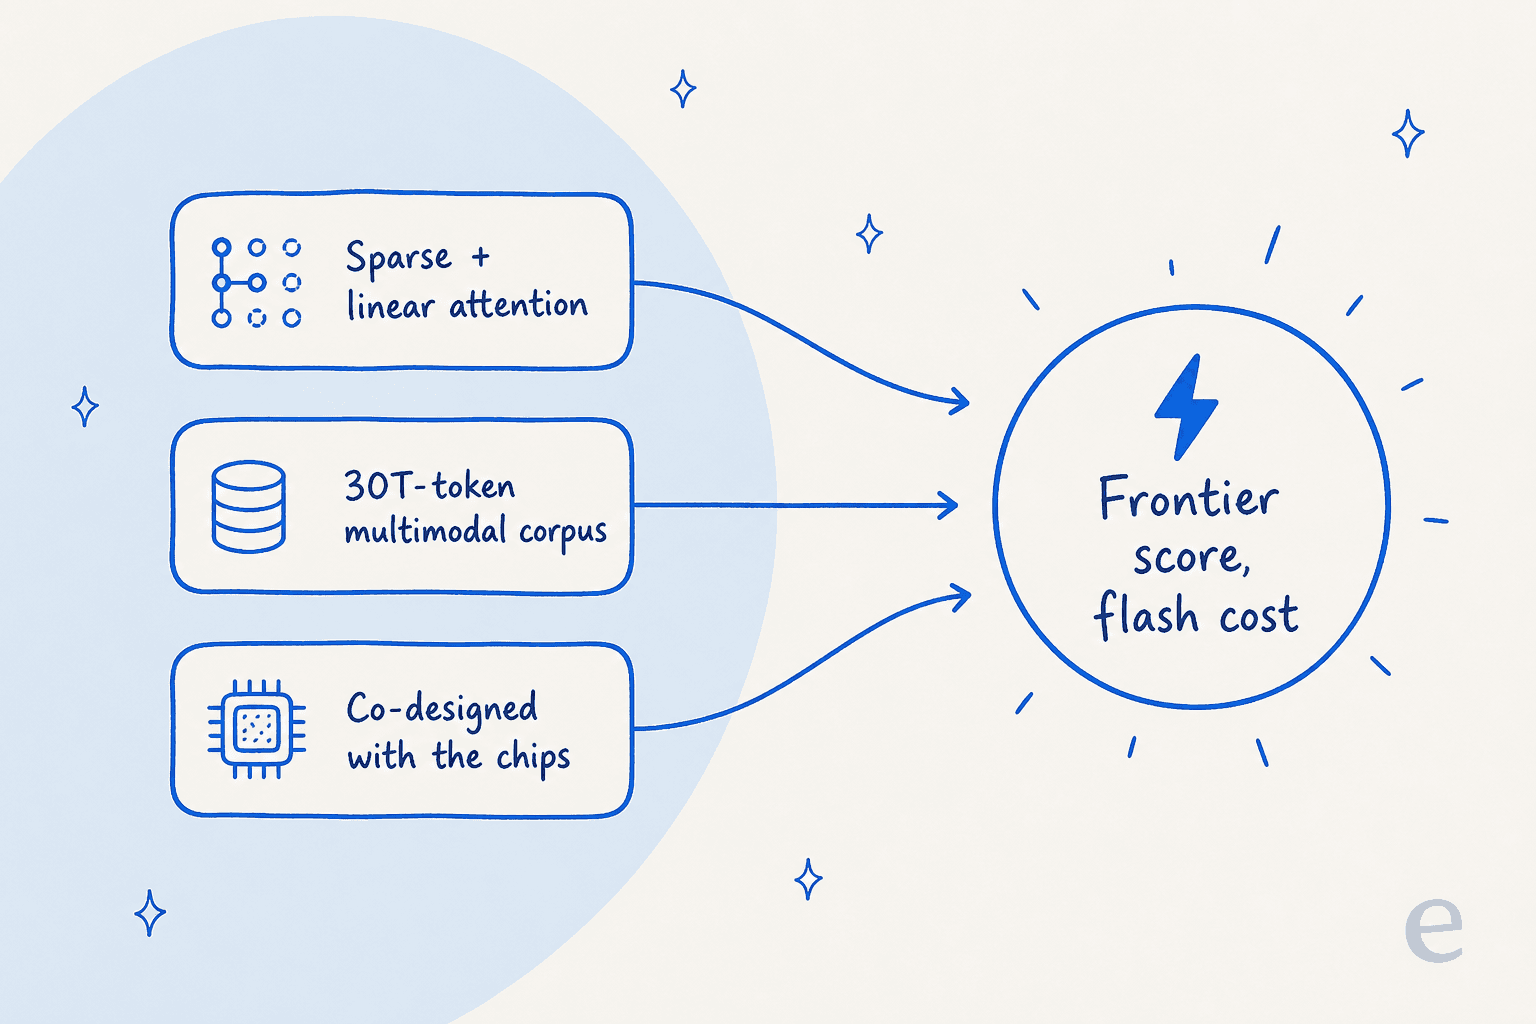
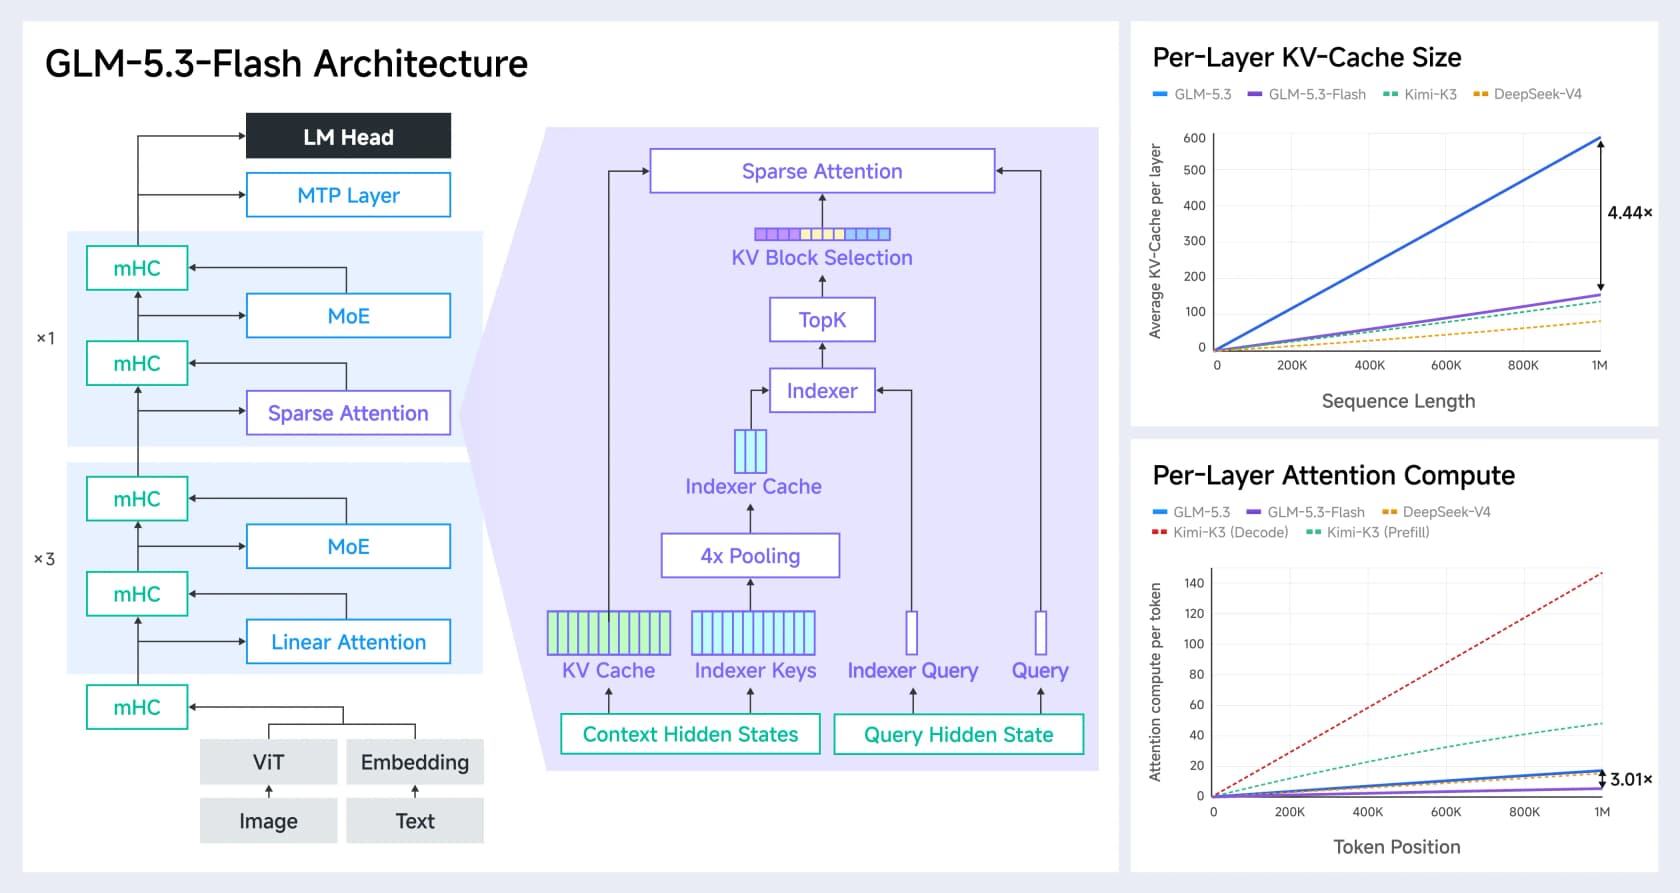
中心となるのはアテンションの設計です。GLM-5.3 Flashは、スパースアテンションとリニアアテンションを組み合わせた初のオープンモデルです。リニアアテンションが状態モデリングで局所的な依存関係を扱い、軽量なインデクサーがグローバルな文脈を取得します。Z.aiによると、その結果、フラッグシップのGLM-5.3と比べてアテンション計算が3分の1、KVキャッシュが4.4分の1になり、これが100万トークンのコンテキストでも提供コストを抑えられる主な理由です。
残りの2層は日常的にはさほど重要ではありませんが、知っておく価値があります。30兆トークンのマルチモーダルコーパスで学習され、全体が中国製の推論ハードウェアと協調設計されています。Z.aiが繰り返し強調する点です:「Chinese chips can support frontier-model inference efficiently and economically at scale.」旧世代のGLM-4.5と比べると、総サイズは同程度のまま、アクティブパラメータ(180億対320億)も層数(45対92)もほぼ半減しています。ローンチ週限定の赤字販売ではなく、本物の効率化の成果です。
マルチモーダルへの賭け:コーディングのループにビジョンを組み込む
GLM-5.3 Flashの最も興味深い点は、ベンチマーク表には載っていません。ビジョンをコーディングのループに組み込み、モデル自身が出力をレンダリングして見て、おかしな点を直せることです。Z.aiの表現が的確です:「Code lets the model build and change the world. Vision lets it enter the world people see and use.」
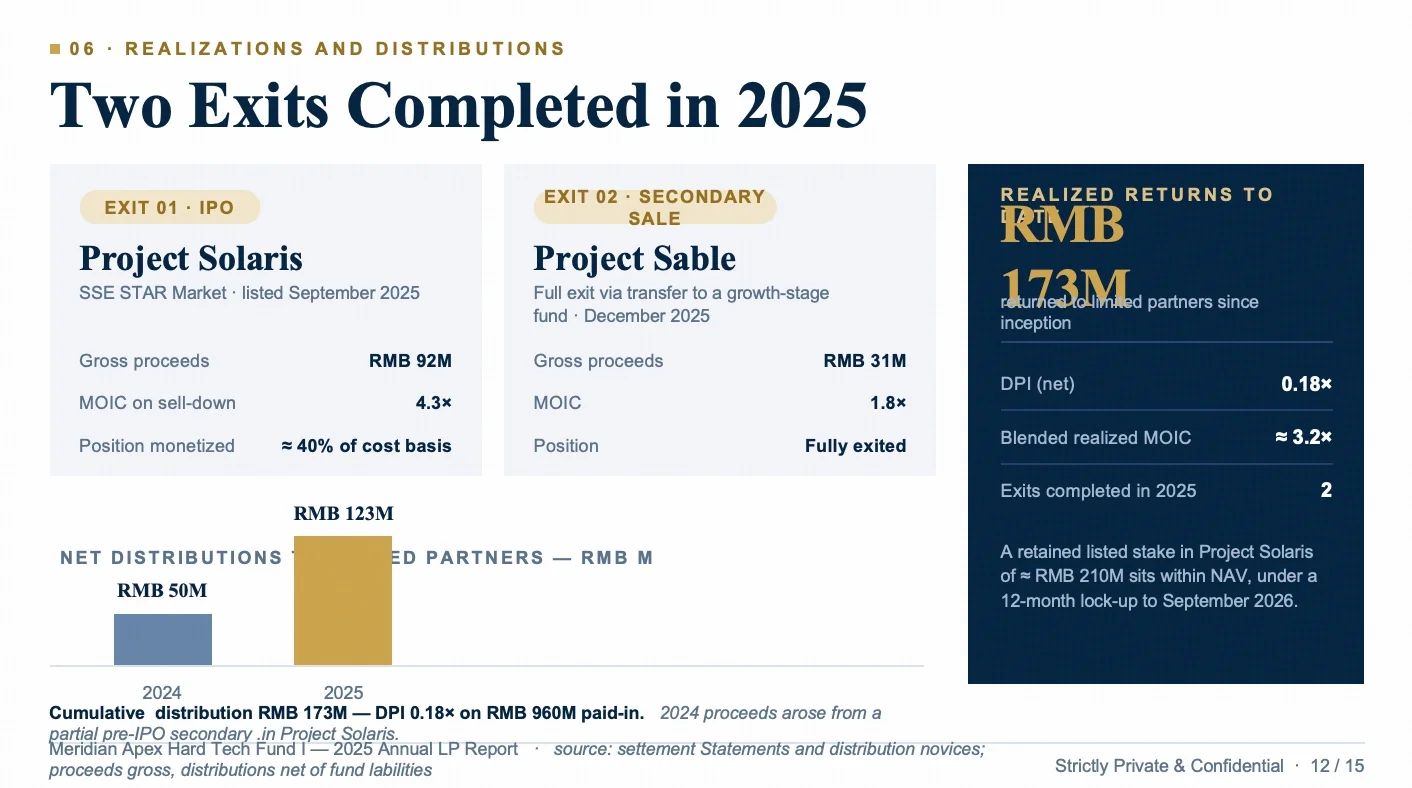
最も分かりやすいデモは、モデルが自分で生成し、自分で修正したスライドです。まず最初の出力で、テキストの重なりとレイアウト崩れがあります。
そして、モデルが自分のレンダリング結果を見て衝突を修正した後の同じスライドです。
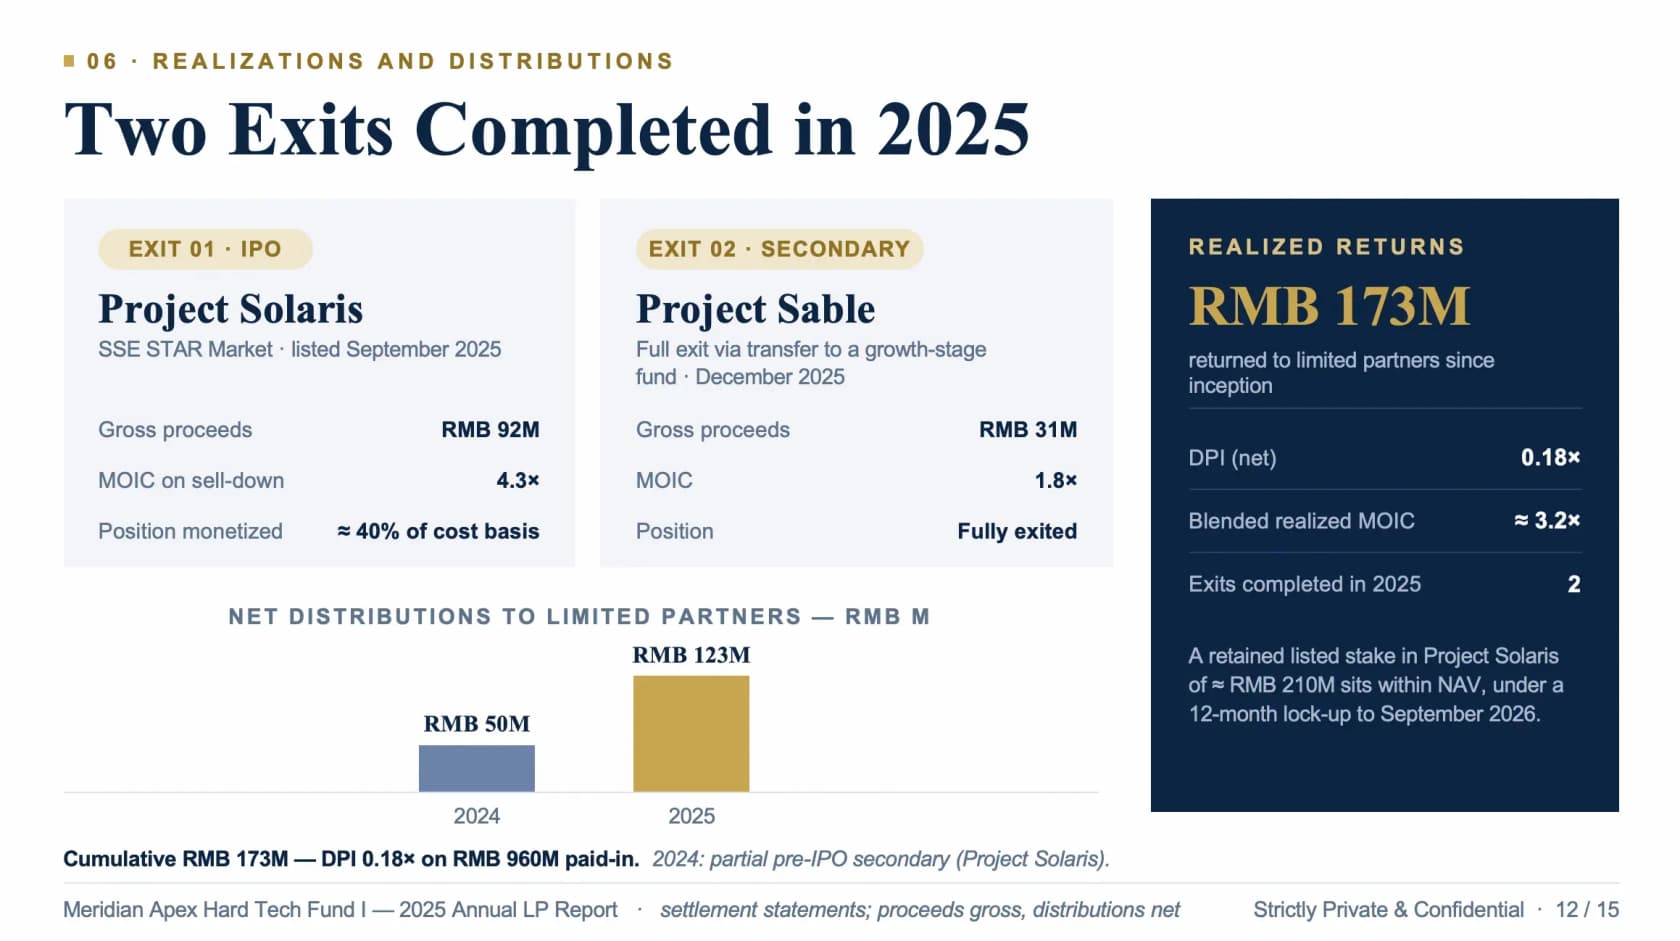
「コンパイルできる」と「見た目が正しい」が別の問題になるフロントエンド、ゲーム、3Dの作業で役立つループです。コードにとどまらず、ダッシュボード、スプレッドシート、プレゼンテーションの読み取りや、ZCode内のコンピューター操作・ブラウザー操作エージェントにも広がります。ビジョン面を試した実務者は、納得して帰ってきました。
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
それでも、自己検証は保証ではなく、役立つ習慣として扱うのが良いでしょう。明らかな視覚的ミスは拾えますが、公開するものを人が見る代わりにはなりません。それでも、初のネイティブマルチモーダルのリリースとして、ビジョンの品質は価格から想像するよりはるかに上です。
弱点
長所だけを並べるレビューはプレスリリースです。GLM-5.3 Flashには、組み込む前に知っておくべき弱点が2つあります。
**自社APIは遅く、その評判は本物です。**Z.aiの自社エンドポイントでは毎秒約49トークンで、フルのGLM-5.3の約86に対して遅く、あるスレッドは率直にこう述べました。
"GLM 5.3 Flash is one of the slowest models AA [has ever seen]. GLM's visible context grows half as fast as Deepseek Flash and is much more precise and direct."
重要なニュアンスであり、この引用で結論を出すべきでない理由は、これが重みではなく自社サービスについての話だという点です。Artificial Analysisは11のプロバイダーを掲載しており、その差は非常に大きいです。
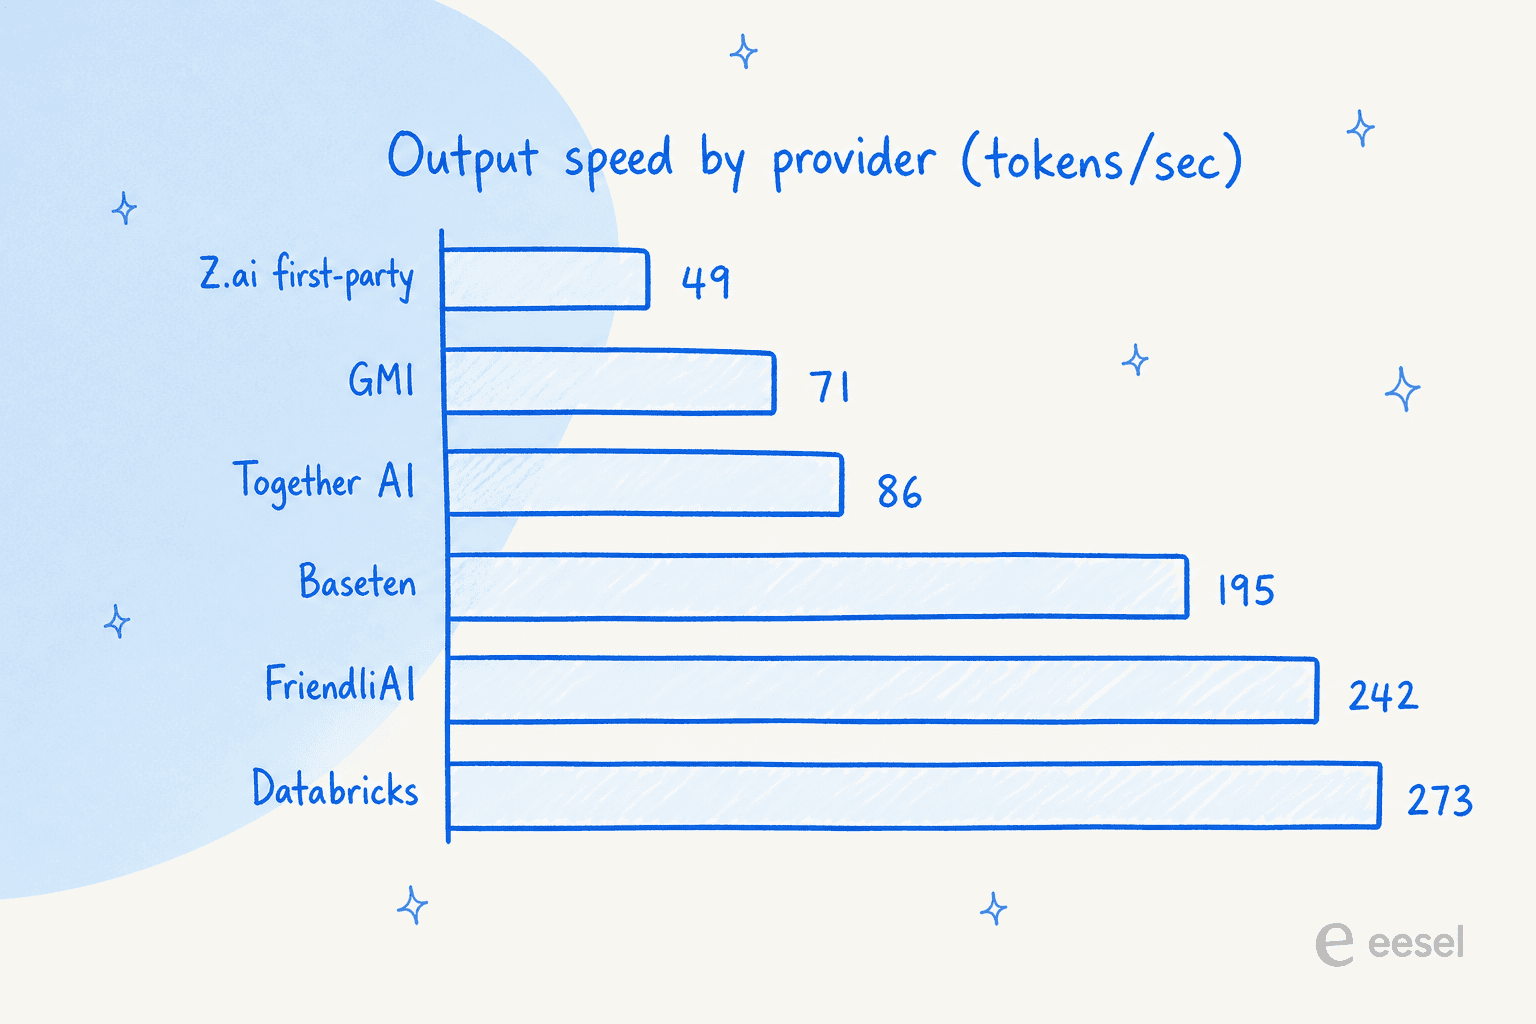
Databricksは同じモデルを毎秒272.9トークンで提供し、自社APIの5倍以上で、最初のトークンまでの時間は8秒です。つまり「GLM-5.3 Flashは遅い」の実態は「Z.ai自身のAPIが遅い」です。ホストを意識して選べば、問題はほぼ消えます。決める前に確認すべきはプロバイダーのベンチマークページで、実際のトラフィックを流すなら、きちんとした利用状況の追跡の仕組みがあれば請求書で驚かずに済みます。
**顧客のコンテンツを扱う場合、データ面の説明は不十分です。**自社APIには公開されたデータ処理契約もゼロ保持のオプションもなく、サービスはPRCの法律の下で運営されています。これはモデルへの批判ではなく現実的な制約で、誠実な解決策はオープンウェイトです。SGLang、vLLM、TokenSpeedでのセルフホストが、管理されたデータ経路を得る方法です。顧客データに関わるなら、まずSOC 2とGDPRを読んでください。
もう1つ計画に入れておくべき点があります。GLM-5.3シリーズは思考優先なので、コストに推論トークンを見込んでください。Cloudflareはlow、medium、highのreasoning_effortコントロールを提供しており、簡単な作業では下げられますが、一部のモデルにあるような、何も考えない無料のモードはありません。これはハルシネーションについての注意でもあります。推論が増えても正確さが増すとは限らず、ビジョンの自己チェックは事実に関する主張には及びません。
実際に何が作られているか
最も示唆に富むシグナルはベンチマークではなく、ベンダーや開発者が数日で採用したことです。James Grugettは、ローンチ時にこれを自社製品へ無料で組み込みました。
"GLM 5.3 Flash is 100% free in our [product]. Leading capabilities at a highly competitive price - Natively multimodal with a 1M-token context window. Previously previewed as Ox Alpha."
価格対価値の比率が最も大きな反応を呼んだのは、セキュリティレビューの用途です。あるチームは脆弱性ベンチマークで試し、計算して見せました。
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
これがGLM-5.3 Flashに向いた仕事の形です。大量で、多少遅くても許容でき、フロンティアモデルには払わないような作業にも惜しみなく投げられる価格です。こうしたパターンはおすすめオープンソースAIエージェントのまとめにさらに載っており、サポートに限った話なら、サポートチケットに最適なモデルがそこで本当に重要な点を絞って解説しています。
用途別の結論
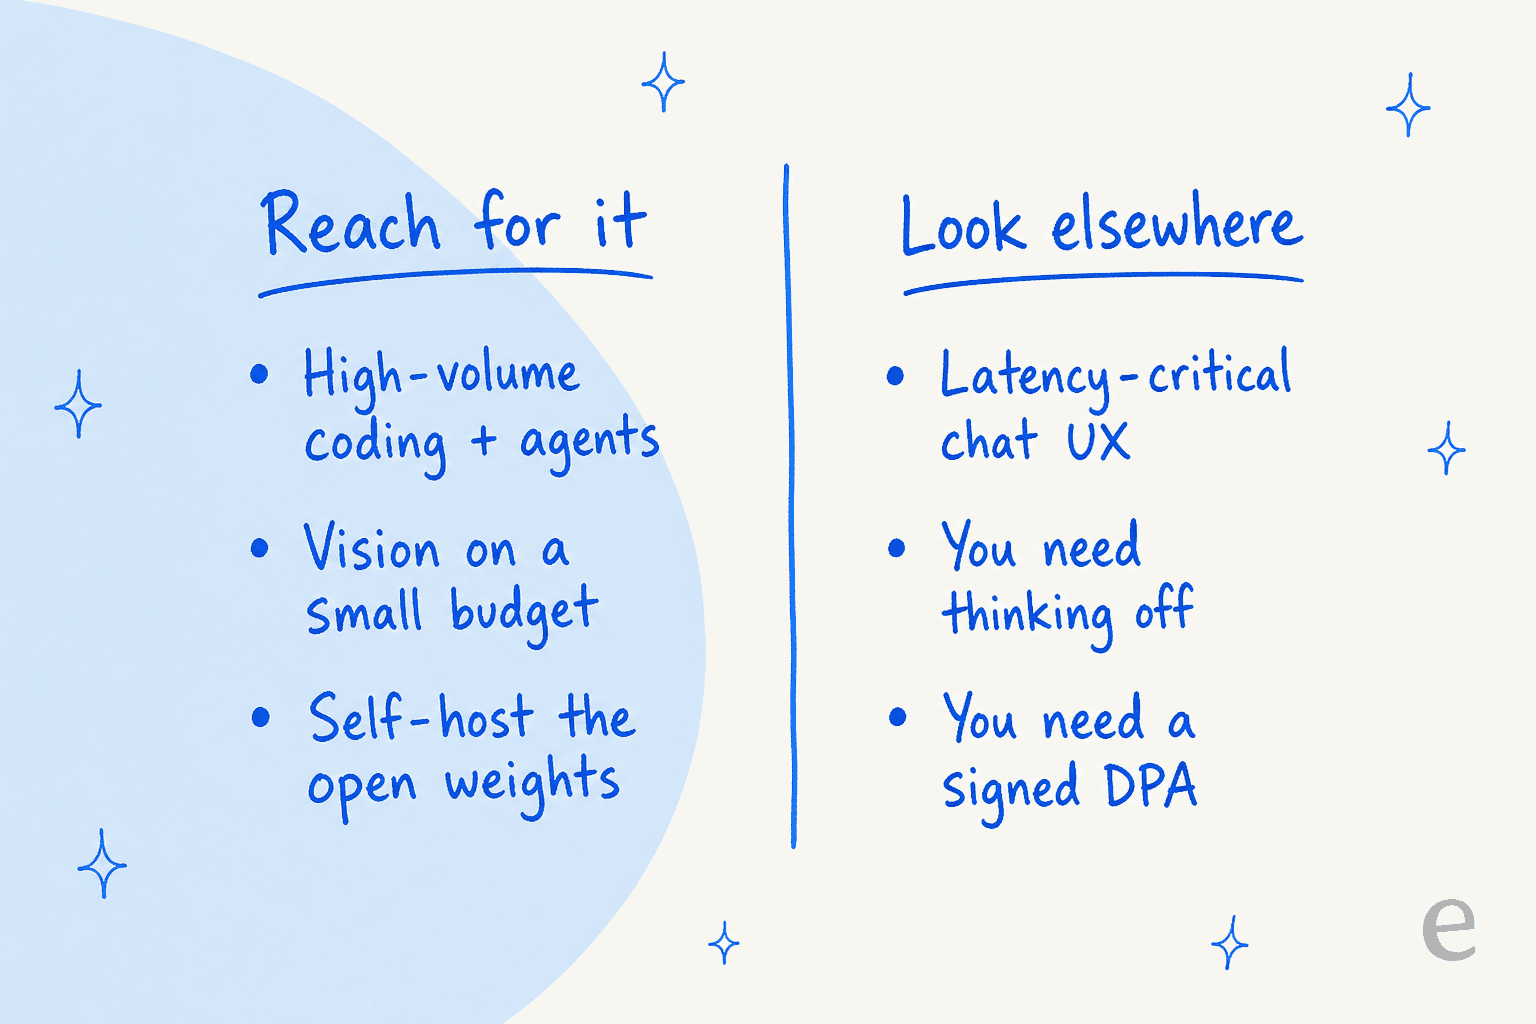
GLM-5.3 Flashを選ぶべきなのは、大量のコーディングやエージェント作業を行う場合、フロンティア価格なしで本格的なビジョン品質が欲しい場合、あるいはオープンウェイトをセルフホストしてデータを社内に留めたい場合です。この3つすべてで、現在利用できる中でも屈指のコストパフォーマンスで、セットアップ先としてはGLM-5.3 Flashの概要をおすすめします。
他を探すべきなのは、レイテンシが製品そのものなのにプロバイダーを制御できない場合、推論を完全に省くモードが必要な場合、セルフホストなしでは得られない署名済みのデータ契約が必要な場合です。どれも致命的ではありませんが、より高価で、速く、あるいはガバナンスの整ったモデルがプレミアムに見合う場面です。クローズドなフロンティア製品と比べるなら、価格の反対側の基準点としてClaude Opus 5の料金が参考になります。
一行でまとめると、GLM-5.3 Flashは、安く、大量で、遅さを許容できる仕事のデフォルトにしたいモデルです。レイテンシに敏感な製品を賭ける前には、慎重にベンチマークしたいモデルでもあります。
Try eesel
サポートをAIに任せたくてトークン単価を比べてここに来たなら、コーヒーを片手にこう言いたいです。トークンの価格は、そもそも難しい部分ではありませんでした。GLM-5.3 Flashのようなモデルはエンジンです。ヘルプデスクにつなぎ、実際のマクロと過去のチケットで裏付けを取り、お客様の目に触れる前に何を言うかを把握する。それが本当の仕事で、まったく別の製品です。
そこでeeselの出番です。eeselは、特定の業務に向けてすぐ働けるAIチームメイトを提供します。Zendeskや既存のヘルプデスクにつながるAIサポートエージェントと、コンテンツ向けのAIブログライターです。それぞれが役割に必要なスキル、連携、会社のコンテキストを備えて届くので、生のモデルアクセスを借りるのではなく、チームメイトを迎える形になります。
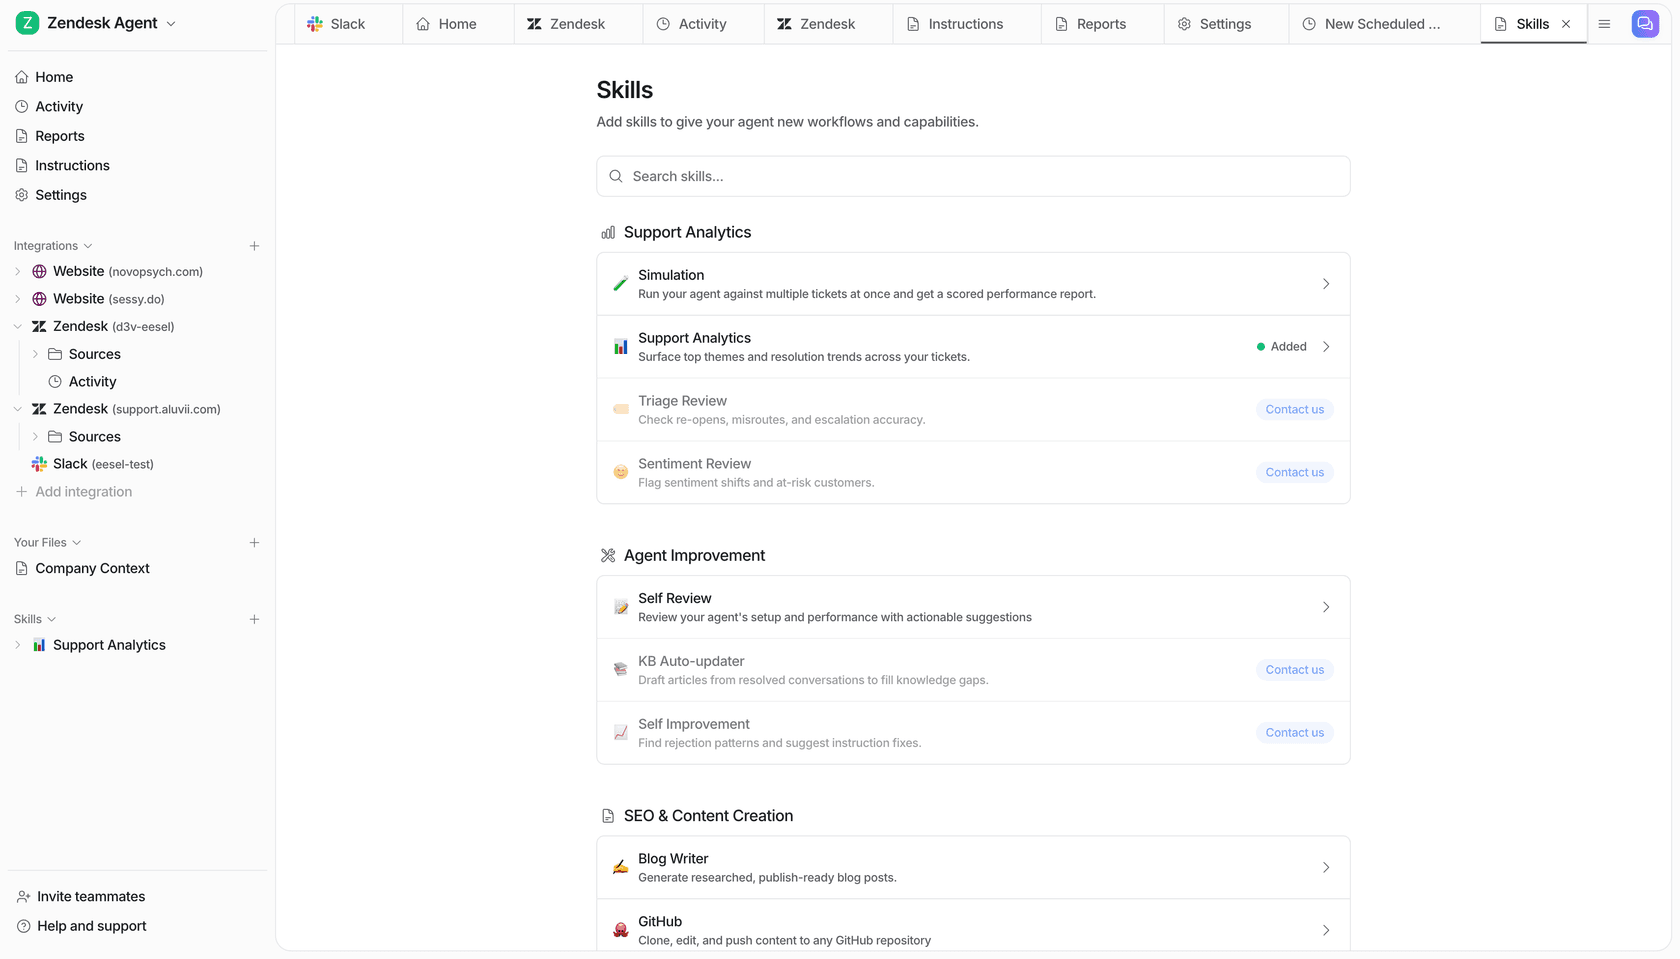
サポートで最も重要なのは、私たちは何年も実際のサポートキューでAIエージェントを動かしてきて、自信ありげなボットが、やってもいない作業をやったかのように語る場面を見てきたということです。だからこそ、eeselの導入はすべて、実際の会話に触れる前に過去のチケットでシミュレーションされます。料金はシート単位ではなく、ボリュームに合わせた月額固定(チケットまたはチャット1件につき1クレジット)なので、段階的な導入が現実的で、開始時には100クレジットが無料です。このクレジット制のおかげで、AIカスタマーサービスのコストも、生のトークン請求書とは違った形になります。先月のチケットでシミュレーションを実行すれば、1時間以内に時間をかける価値があるかが分かります。暗闇でモデルをベンチマークするよりずっと確かです。