

要点
LongCat 2.5は、スクリーンショットや動画も読み取れる低価格のコーディングエージェントが欲しいなら、試す価値があります。Meituanの1.6Tパラメータモデルで、画像と動画のネイティブ入力に対応し、料金は100万トークンあたり入力$0.30、出力$1.20です。これはDeepSeek V4.1 Flashのピーク時料金と同じです。注意点はMeituan自身のベンチマーク表にあります。同じ料金のDeepSeek V4.1 Flashが、コーディングの大半の項目で勝っています。そしてLongCat 2.5の重みは、今も"coming soon"のままです。視覚入力が多いエージェント業務に使い、Meituanがデータポリシーを公開するまでは顧客データを入れないようにしましょう。サポート用途なら、過去のチケットでテストできるeeselのようなヘルプデスクのチームメイトのほうが安全です。
LongCat 2.5とは?
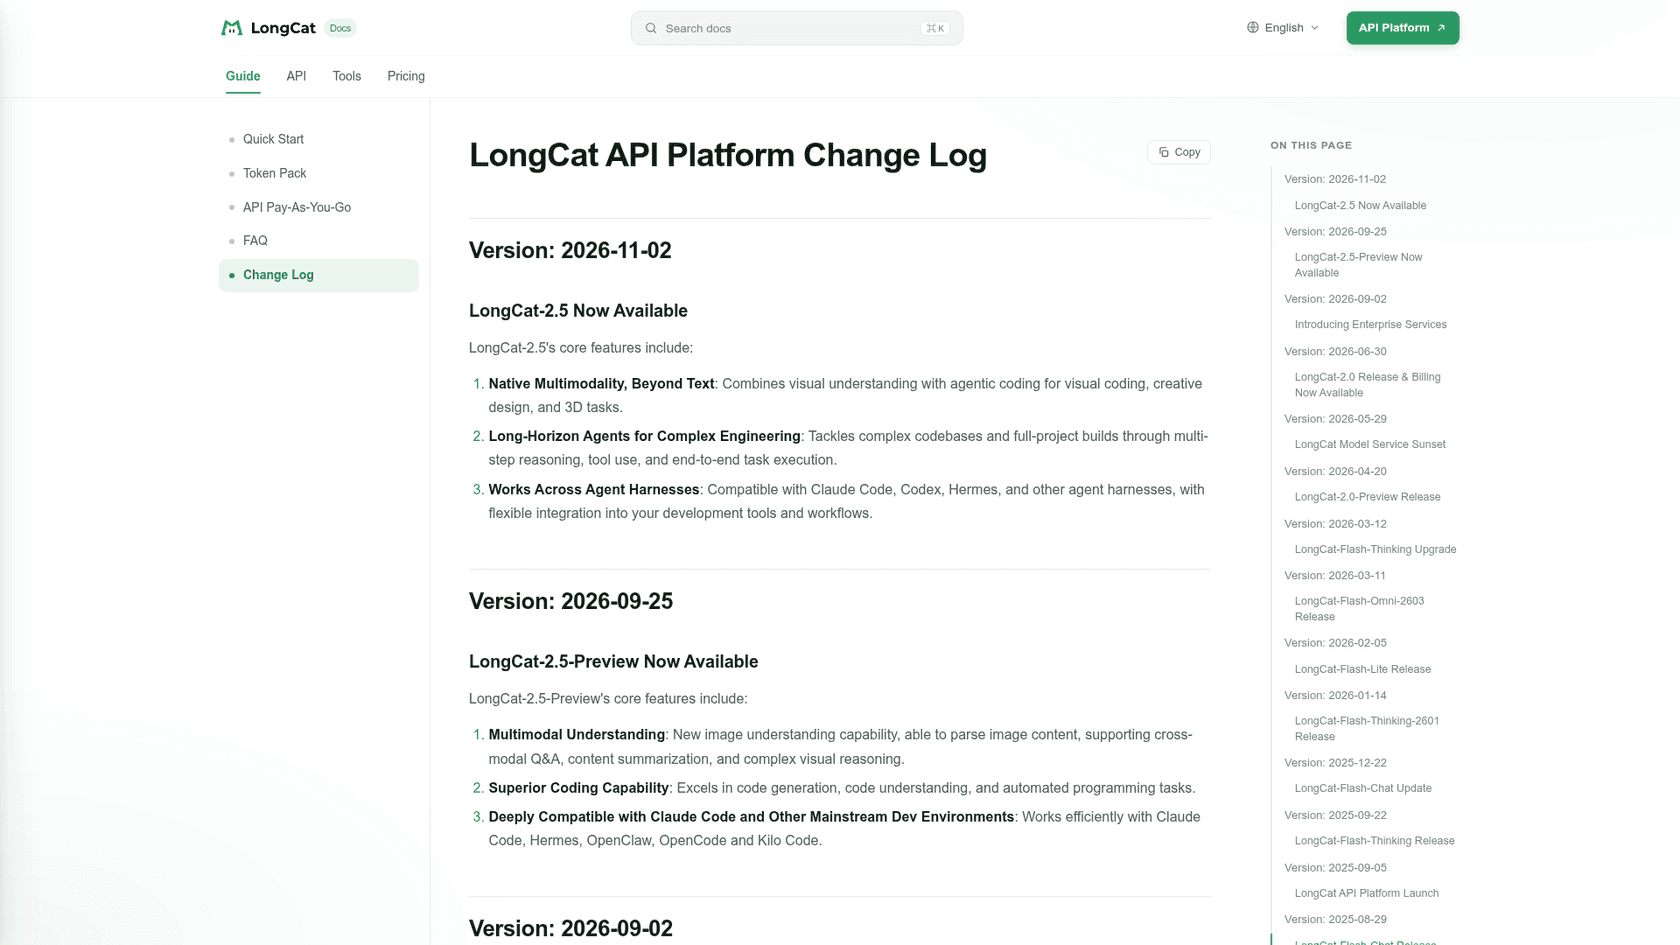
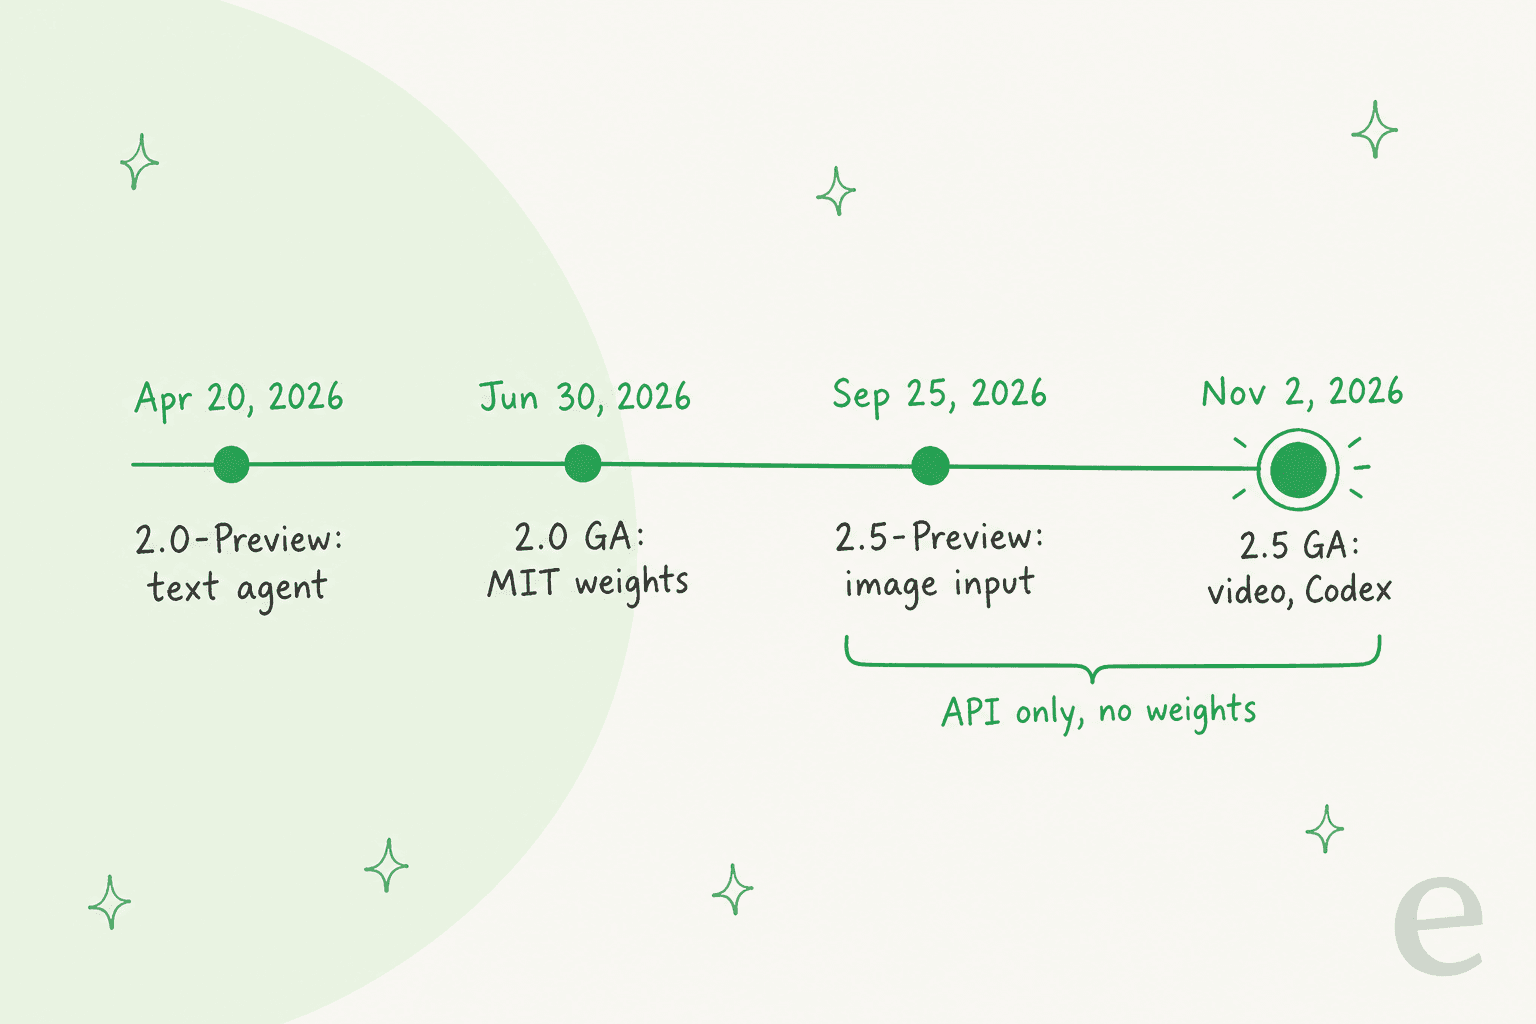
LongCat 2.5は、MeituanのLongCatチームによる最新モデルです。9月25日にプレビュー版が登場してから5週間後の2026年11月2日に、LongCat API Platformで一般提供が始まりました。Meituanの変更履歴では、3つの主要機能が挙げられています。"Native Multimodality, Beyond Text"、"Long-Horizon Agents for Complex Engineering"、そして"Works Across Agent Harnesses"です。
前回のリリースを見逃した方に説明すると、LongCat 2.0は1.6兆パラメータのMixture-of-Experts基盤モデルで、トークンごとに約48Bのパラメータが有効になります。MITライセンスで公開され、重みはHugging Faceにあります。エージェント型のコーディング作業向けに作られた、テキスト専用モデルでした。
私はeeselのAIエージェントを開発するチームのソフトウェアエンジニアです。そのためモデルのリリース情報を読むときは、「これを実際に動かすには、何を変える必要があるだろう?」という1つの問いを意識しています。この記事は、MeituanのLongCat 2.5技術ブログ、プラットフォームのドキュメントと変更履歴、Xでのリリース投稿、そして無料プレビューを使った開発者の報告をもとにしています。
LongCat 2.0から何が変わったのか?
本体は同じで、新たな感覚が加わりました。Meituanの技術ブログによると、2.5は"1.6 trillion total parameters and approximately 48 billion activated per token"で、"builds on LongCat-2.0"とされています。つまり、新しい、より大きなモデルではありません。2.0のMixture-of-Experts設計に視覚機能を加え、エージェント向けの学習を大幅に追加したものです。これまでの流れを見てみましょう。
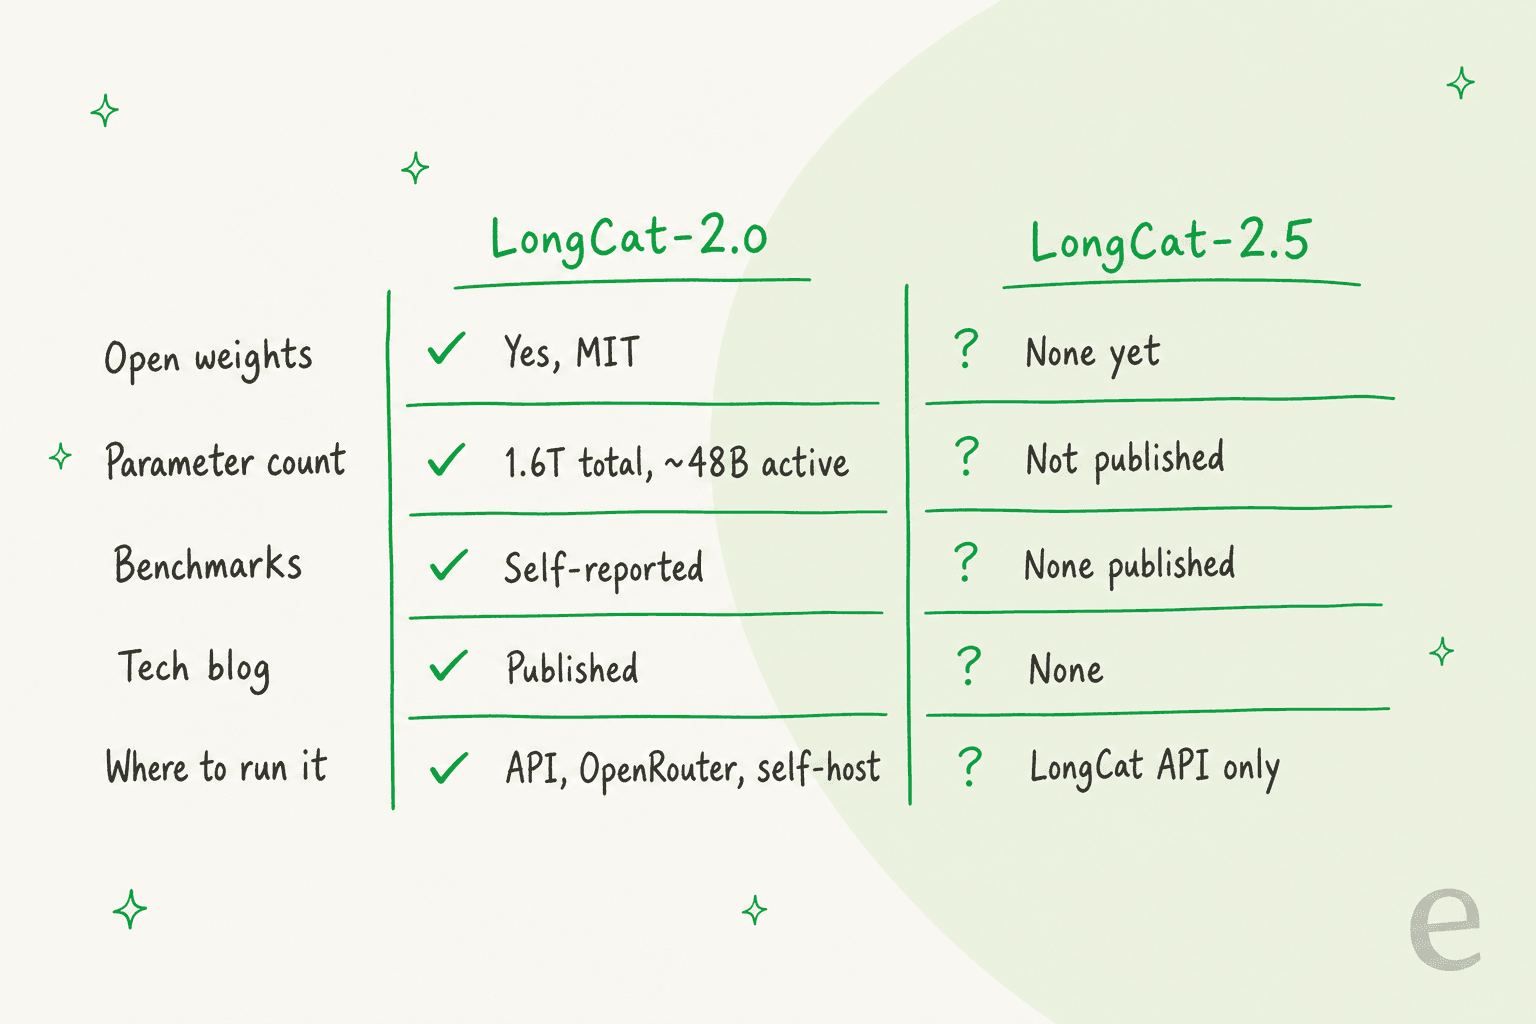
2.0はプレビューから約10週間でMITライセンスの重みが公開されました。2.5はプレビューと一般提供を通じて、登場から5週間が経っています。技術ブログには"GitHub Coming soon"と"HuggingFace Coming soon"と表示されていますが、Hugging FaceにもGitHubにもまだ何も出ていません。"Coming soon"は表示上の文言であって日付ではなく、Meituanは時期を示していません。
画像と動画の入力
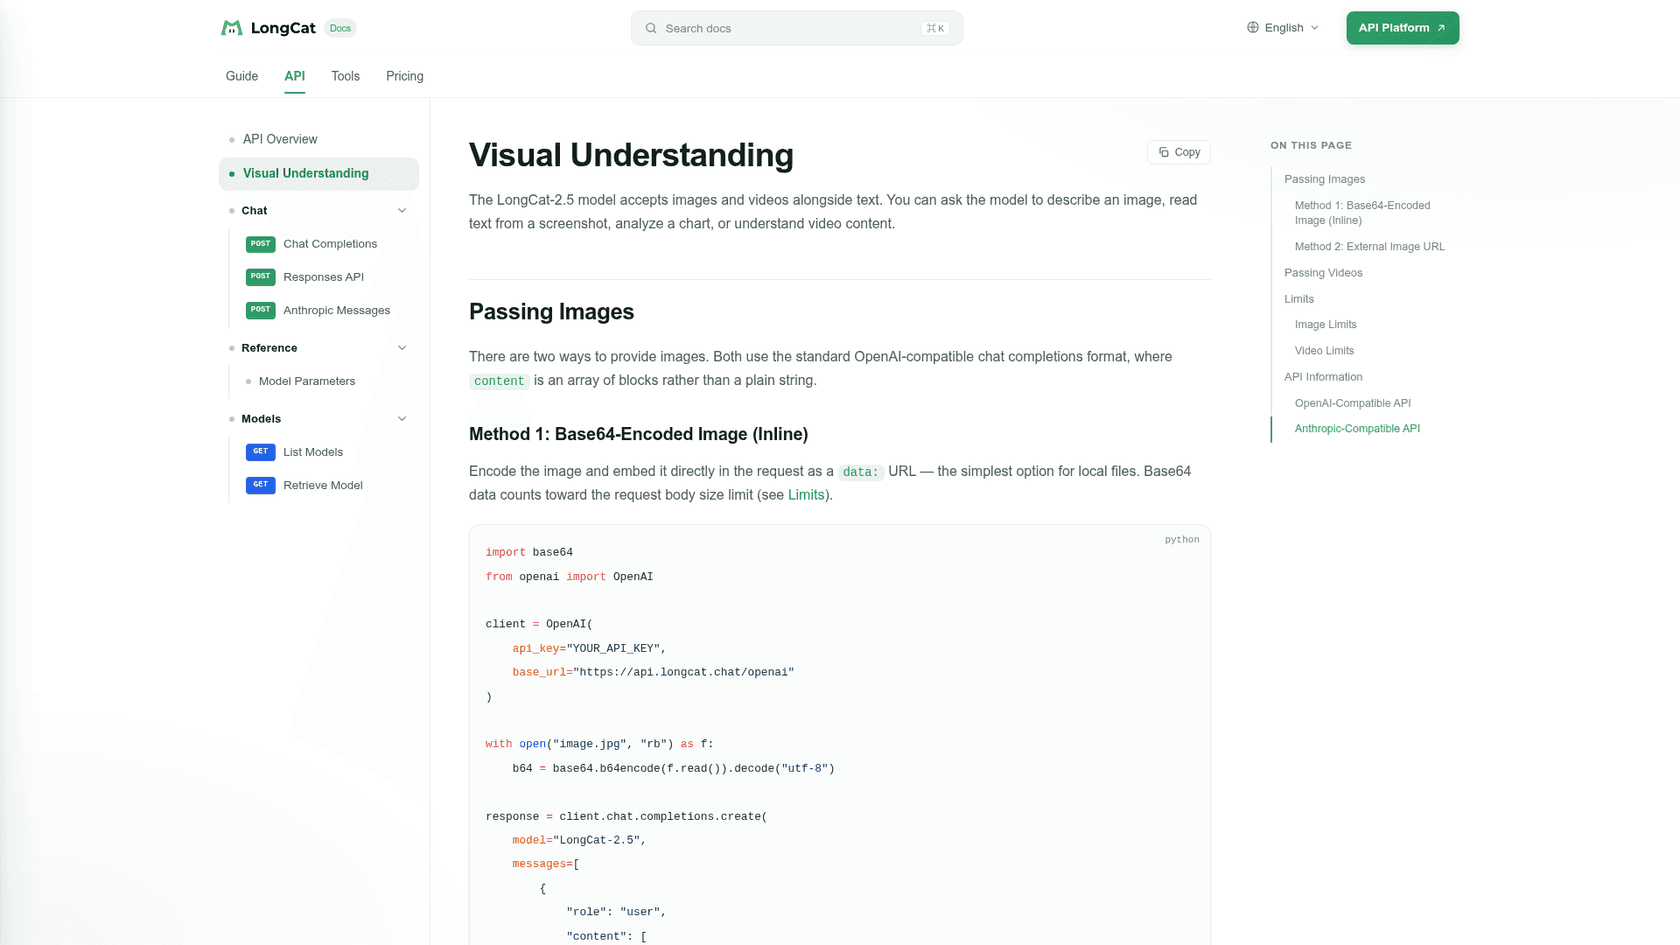
これが目玉機能です。視覚理解のドキュメントには"The LongCat-2.5 model accepts images and videos alongside text"とあり、上限にも余裕があります。
| 入力 | 形式 | サイズ上限 | リクエストあたり | 送信方法 |
|---|---|---|---|---|
| 画像 | PNG, JPG, JPEG, WebP, GIF | 1枚あたり10 MB | 最大50枚 | Base64データURLまたは公開URL |
| 動画 | 記載なし | 1本あたり100 MB、3,600秒未満 | 最大10本 | 公開URLのみ |
プレビューでうたわれていたのは画像理解だけでした。動画対応は一般提供版で加わりました。出力は引き続きテキストのみなので、これはスクリーンショットや画面録画を読み取るモデルであって、画像を作るモデルではありません。SVGとHEICファイルには対応しておらず、アスペクト比が200:1を超える画像はエラーになります。また、料金ページに画像や動画の個別料金の記載はありません。変換後のトークンに対して支払います。
コーディングで重要な理由は、変更履歴で"visual coding, creative design, and 3D tasks"向けと紹介されているためです。簡単に言えば、崩れたレイアウトのスクリーンショットを貼り付けて、エージェントにCSSの修正を頼めます。これはDeepSeek V4 Flash Visionが進んだ方向と同じで、2.0に実際に欠けていた機能です。
視覚機能の仕組み
ほとんどの視覚モデルは、テキストモデルに画像エンコーダーを後付けします。LongCat 2.5は、画像を単語と同じ種類のトークンに変換します。技術ブログでは"represents visual signals as multi-level discrete tokens"と説明されており、基幹モデルはテキストと画像のトークンが混在する1つのストリームを読み取ります。トークナイザーが固定されているため、画像トークンは一度計算してオフラインでキャッシュできます。だからこそMeituanは、学習から視覚エンコーダーを完全に外すことができました。
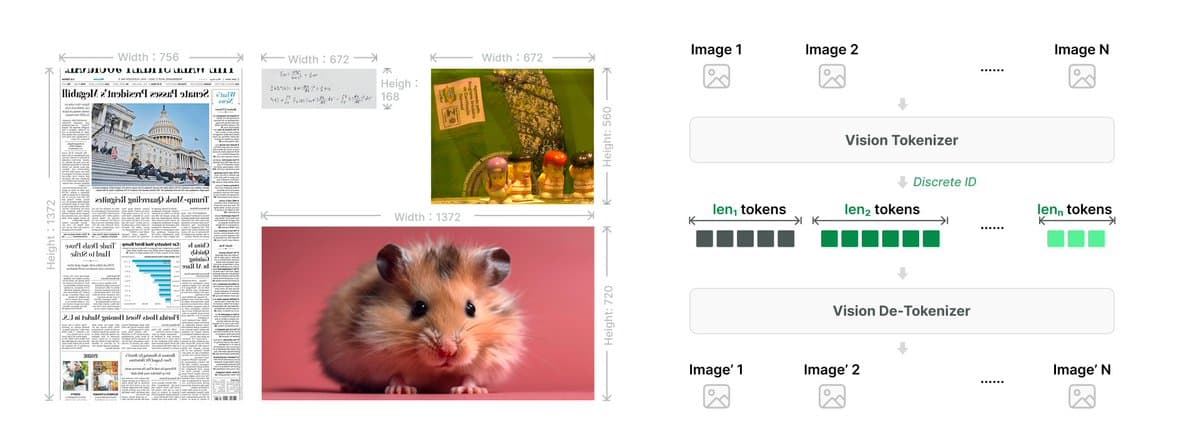
実用面での利点は、元の解像度を維持できることです。縦長のスクリーンショットは、押しつぶされたサムネイルではなく、より多くのトークンになります。エージェント側についてMeituanは、フィルタリングしたGitHubのプルリクエストから作ったタスクで"large-scale long-horizon reinforcement learning"を行い、"repetitive reasoning and repeated tool calls"にペナルティを与えると説明しています。この最後の一文は、コミュニティの反応を読むときに覚えておいてください。
対応ハーネスの一覧にCodexが追加
プレビューではClaude Code、Hermes、OpenClaw、OpenCode、Kilo Codeの名前が挙がっていました。一般提供版ではCodexが加わり、ドキュメントにもCodexが必要とするOpenAI形式の新しいResponsesエンドポイント(POST /openai/v1/responses)が掲載されています。このエンドポイントでは、noneからxhighまでの推論努力レベル、デフォルトで有効な並列ツール呼び出し、JSONスキーマ出力が利用できます。ツールのサイドバーには、ClineからHermes Agentまで、合計13のセットアップガイドが並んでいます。
仕様上は、本当の1Mコンテキスト
2.0は宣伝では1Mコンテキストとされていましたが、公開された設定の上限は256Kでした。2.5には確認できる設定ファイルがなく、APIしかありません。モデルパラメータのページでは、コンテキストウィンドウを、リクエストごとの入力と出力を合わせて1,048,576トークンと定義しています。出力については、ドキュメント内で記述が食い違っています。
- モデルパラメータのページでは、
max_tokensを最大262,144まで許可しています。 - クイックスタートとFAQには、どちらも最大出力は128Kとあります。
- Meituan自身のClaude Code設定では、出力を128Kにあたる
131072に設定しています。
私なら出力128Kを前提に計画し、それを超える分はテストして使える追加枠として扱います。
LongCat 2.5のベンチマークから何がわかるのか?
Meituanの数値は、2.0からの大幅な向上と、エージェントタスクでは2025-2026年の最先端に近い位置にあることを示しています。ただし、同じ価格帯で見ると、自社の表からはそれほど好意的ではない実情が見えてきます。以下の数値はすべて、技術ブログの評価表にあるもので、Meituanが思考を有効にして実行した結果です。
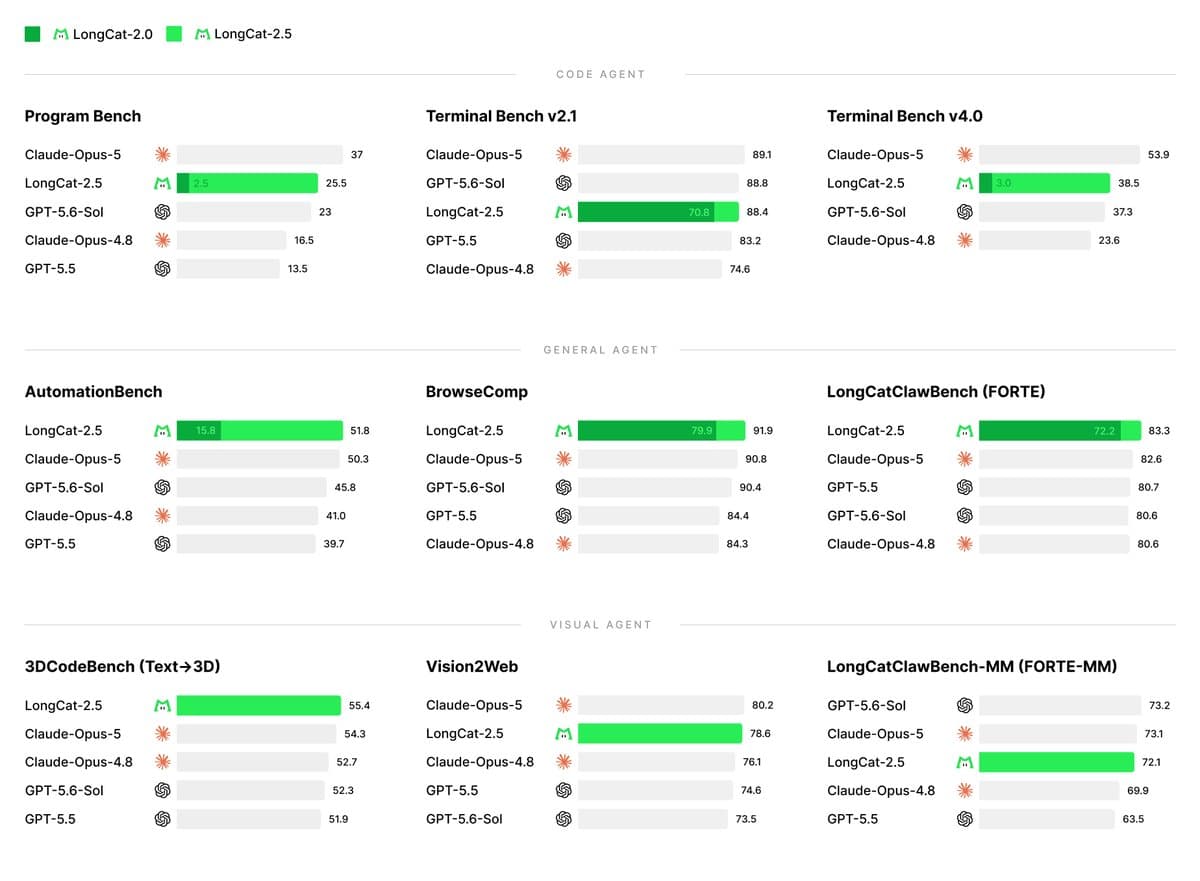
数値上、2.0から2.5への向上は確かです。Terminal Bench 4.0は3.0から38.5、AutomationBenchは15.8から51.8、DeepSWE v1.1は9.7から64.6になっています。これが、数か月にわたる長期的なエージェント学習の成果です。
注意したいのは比較対象です。目立つ位置にあるグラフでは、GPT-5.5、GPT-5.6-Sol、Claude Opus 4.8、Claude Opus 5と比較しています。Claude Opus 5.5も、GPT-6.1 Solも、Kimi K3.1 Proもありません。ページの下のほうにある完全版の表にはGLM-5.3、Kimi K3、DeepSeek V4.1 Flashも加わっています。私なら、この最後の列から読みます。料金がまったく同じモデルだからです。
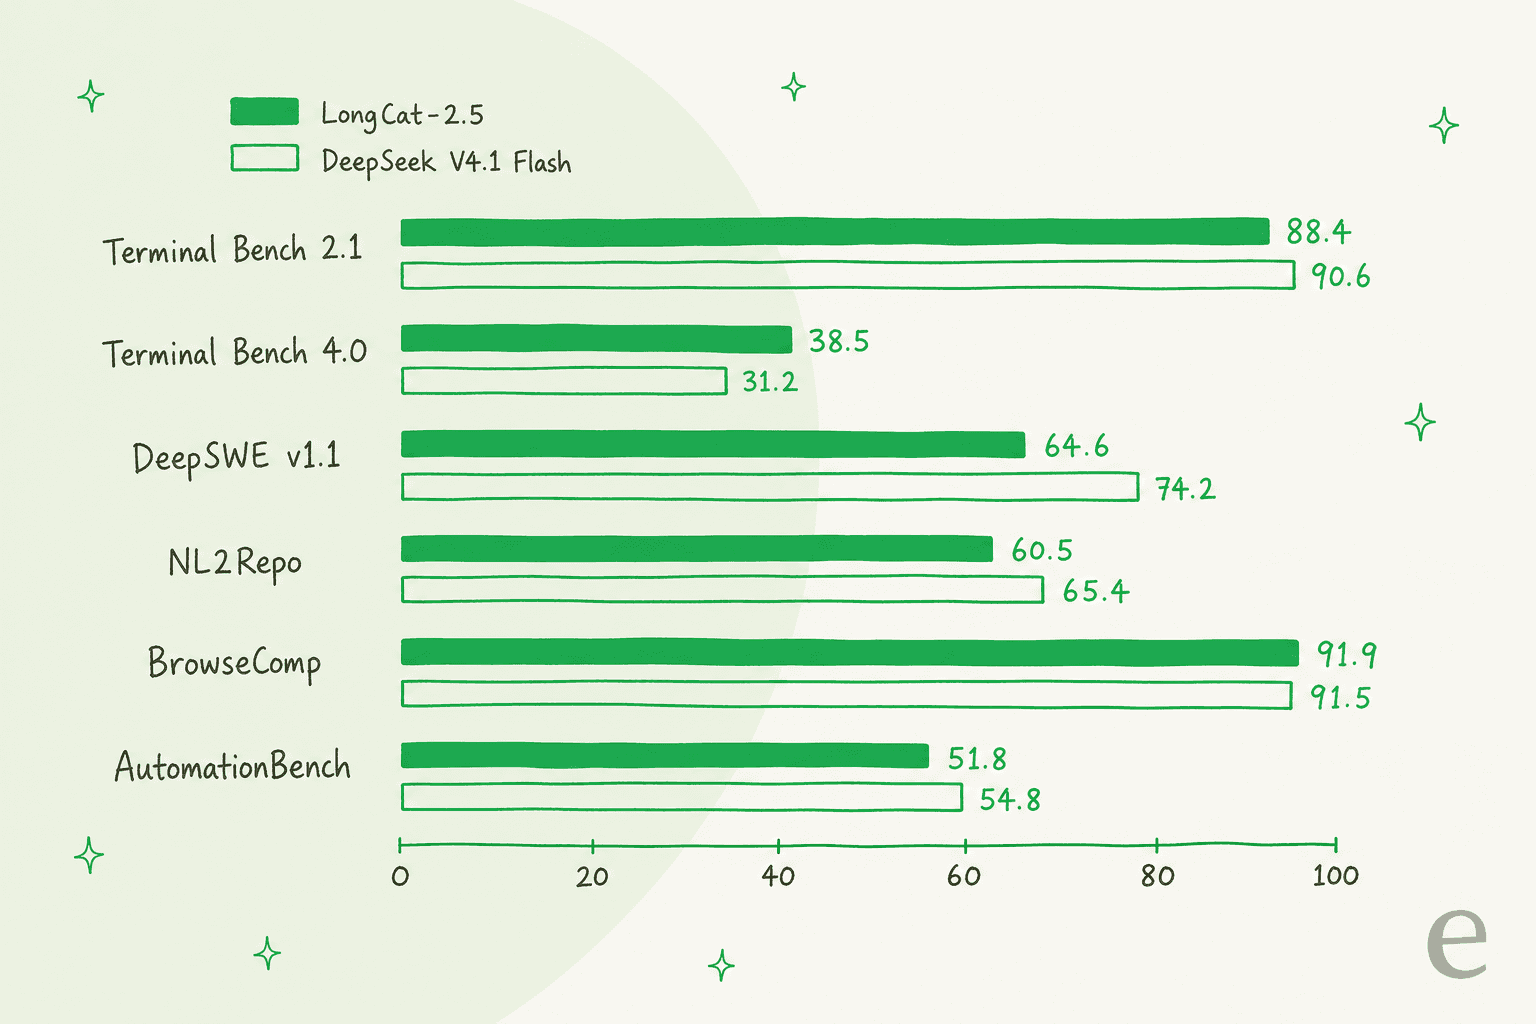
| ベンチマーク(Meituanの表) | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| VideoMME | 85.2 | - | - | 90.0 | - |
出典:LongCat-2.5技術ブログ。他モデルのスコアには、Meituanが公開レポートから引用した数値と自社で実行した結果が混在しており、ブログでは"are indicative only"とされています。
そのまま読み取ると、Meituan自身のコーディング項目では、DeepSeek V4.1 Flashは負ける項目より勝つ項目のほうが多いということです。LongCat 2.5はTerminal Bench 4.0、Program Bench、SWE AtlasのコードベースQ&A、BrowseCompで上回り、この2つのモデルのうち動画のスコアが公開されているのもLongCat 2.5です。ただ、今回のリリースが主題としている長期的なコーディングタスクでは、オフピーク時にさらに安くなるDeepSeekモデルが先行しています。
独立した評価はまだ追いついていません。Artificial Analysisに載っているのはLongCat 2.0とLongCat Flash Liteだけで、OpenRouterのモデルAPIが返すMeituanモデルはmeituan/longcat-2.0の1つです。差を確認するうえで参考になる点があります。Artificial Analysisが測定したLongCat 2.0のTerminal-Bench 2.1スコアは50.2%ですが、Meituanの表では2.0に70.8を付けています。ハーネスは異なりますが、20ポイントの差は、どちらかの列を信じるより自分でテストする理由になります。
LongCat 2.5の料金はいくらか?
LongCat 2.5の料金は、入力100万トークンあたり$0.30、出力100万トークンあたり$1.20で、キャッシュ済み入力は$0.006です。ページ上のすべての数値には"Discounted Price (limited-time)"という表示が付いています。
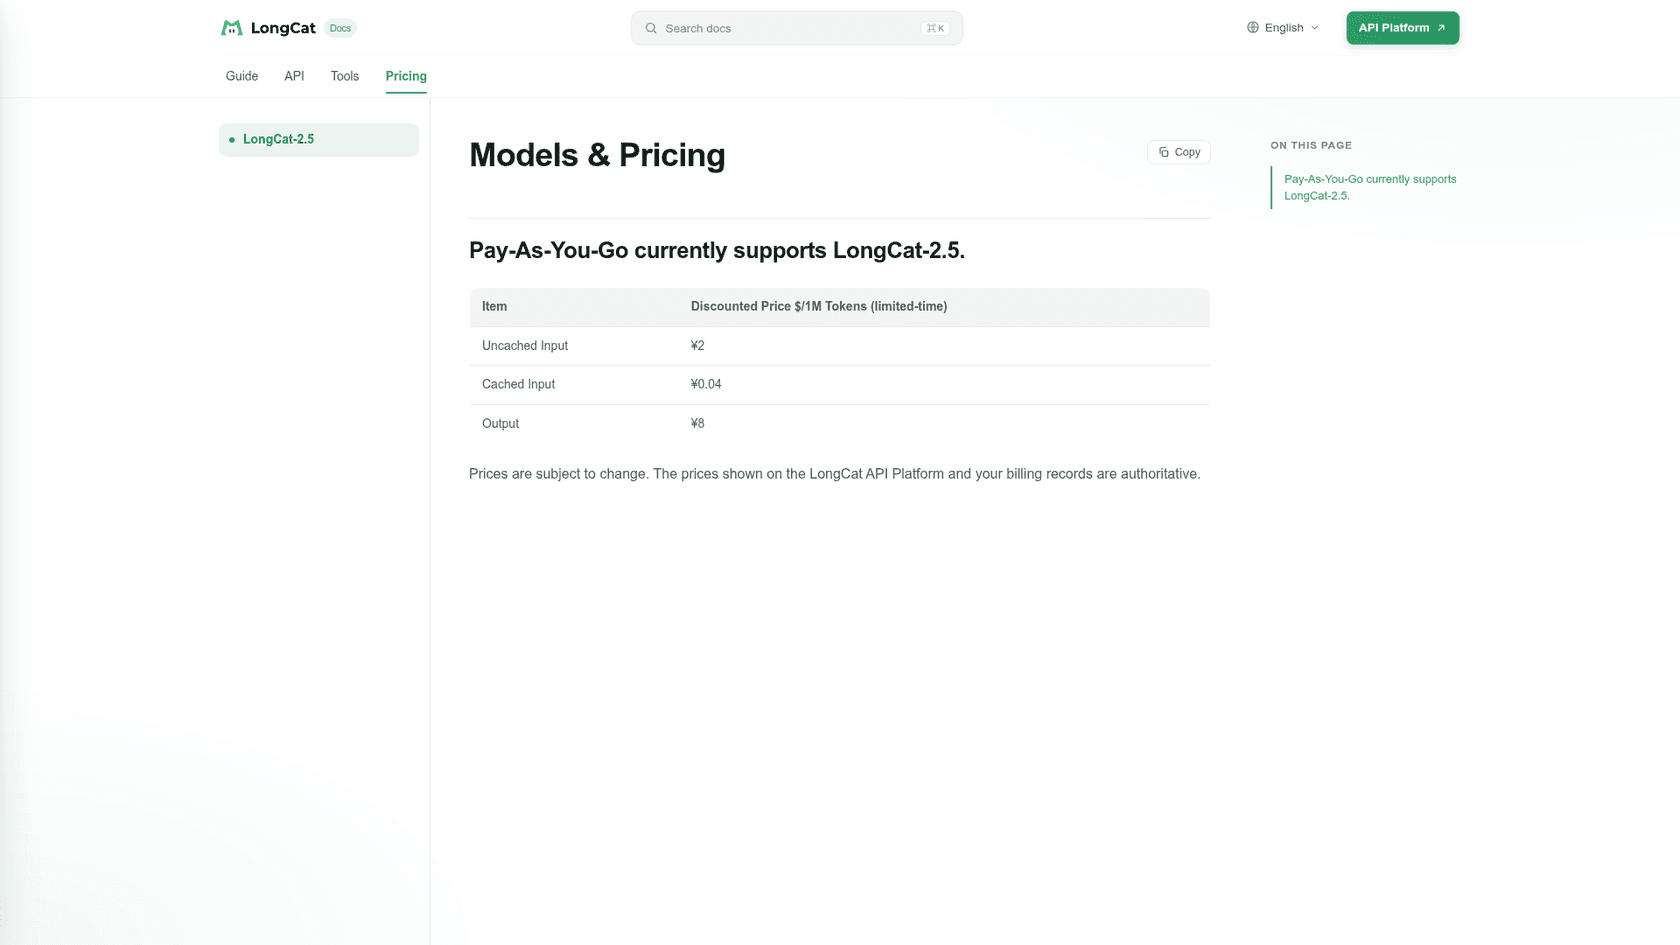
| 項目 | 1MトークンあたりのUSD料金 | 1MトークンあたりのCNY料金 |
|---|---|---|
| 未キャッシュ入力 | $0.30 | ¥2 |
| キャッシュ済み入力 | $0.006 | ¥0.04 |
| 出力 | $1.20 | ¥8 |
| コンテキスト長による追加料金 | なし | なし |
| 画像または動画の追加料金 | 記載なし | 記載なし |
注目したい点は2つあります。キャッシュ済み入力は未キャッシュ料金の2%で、毎ターン同じファイルを再送するコーディングエージェントには大きな利点です。そして、どの長さでも段階別料金がないため、900Kトークンのリクエストも9Kトークンのリクエストも、トークンあたりの料金は同じです。
Meituan自身の計算例では、未キャッシュ入力600,000トークン、キャッシュ済み入力400,000トークン、出力500,000トークンのリクエストは$0.7824です。課金されるのは成功した呼び出し(HTTP 200)だけで、前払い残高に有効期限はなく、最低利用額の契約もありません。
割引が終わるとどうなるのか?
誰にもわかりません。そして、それが本当の料金リスクです。2.5のページには割引後の列しかありません。リンクされていない古いLongCat 2.0の料金ページには、同じ割引料金の隣に、2.0の通常料金が今も表示されています。入力$0.75、キャッシュ済み入力$0.015、出力$2.95です。2.5がいずれ2.0の通常料金に移行した場合、出力コストは約2.5倍になります。Meituanはそうすると言っていませんし、そうしないとも言っていません。
他モデルとの料金比較
| モデル | 入力 / 1M | キャッシュ済み / 1M | 出力 / 1M | コンテキスト / 最大出力 | ベンダーの料金ページ |
|---|---|---|---|---|---|
| LongCat 2.5(キャンペーン) | $0.30 | $0.006 | $1.20 | 1M / 128K | LongCat |
| DeepSeek V4.1 Flash(ピーク時) | $0.30 | $0.006 | $1.20 | 1M / 384K | DeepSeek |
| DeepSeek V4.1 Flash(オフピーク時) | $0.15 | $0.003 | $0.60 | 1M / 384K | DeepSeek |
| Qwen 3.8 Max | $2.00 | $0.25 | $6.00 | 1M / 131K | QwenCloud |
| Kimi K3.1 Pro | $2.00 | $0.20 | $10.00 | 1M | Kimi |
| Kimi K3 | $3.00 | $0.30 | $15.00 | 1M | Kimi |
興味深いのはDeepSeekの行です。LongCat 2.5のキャンペーン料金は、DeepSeek V4.1 Flashのピーク時料金と端数まで同じで、DeepSeekはオフピーク時にその半額になります。つまり、2.5だけが特別に安いわけではありません。このカテゴリーで最も使われている低価格モデルと同じ価格帯なのです。そのモデルには独立した評価スコアがあり、最大出力も長く、公開済みのAPIガイドもあります。LongCatが優位に立つには、動画入力と、自分で測定したコーディング品質で差を出す必要があります。
支払いがしやすくなった
2.0のチャージ方法はAlipayとWeChat Payだけだったため、欧米のほとんどのチームは利用できませんでした。現在の従量課金ページには、USDサイト向けにクレジットカード、デビットカード、Google Payが記載されており、中国本土以外では本人確認なしでメールアドレスによる登録ができます。Token Packs(有効期間30日の固定利用枠で、北京時間10:00、16:00、21:00、23:00のフラッシュ販売)も引き続きありますが、容量と価格はログイン後のコンソールでしか確認できません。
認証済みの企業には、従量課金の利用額に応じたボリュームディスカウントもあります。
| 月間利用額(USDサイト) | 月間利用額(CNYサイト) | 割引 |
|---|---|---|
| $75以上 | ¥500以上 | 10%オフ |
| $300以上 | ¥2,000以上 | 20%オフ |
| $1,200以上 | ¥8,000以上 | 30%オフ |
| $6,000以上 | ¥40,000以上 | 40%オフ |
出典:LongCat FAQ。
Claude CodeやCodexでLongCat 2.5を動かすには?
ハーネスの接続先をLongCatのAnthropic形式またはOpenAI形式のエンドポイントに向け、モデル名をLongCat-2.5に設定します。Claude Codeガイドでは、~/.claude/settings.jsonに次の設定を入れています。
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "your_longcat_api_key",
    "ANTHROPIC_BASE_URL": "https://api.longcat.chat/anthropic",
    "ANTHROPIC_MODEL": "LongCat-2.5",
    "ANTHROPIC_SMALL_FAST_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "LongCat-2.5",
    "CLAUDE_CODE_MAX_OUTPUT_TOKENS": "131072",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": 1
  }
}
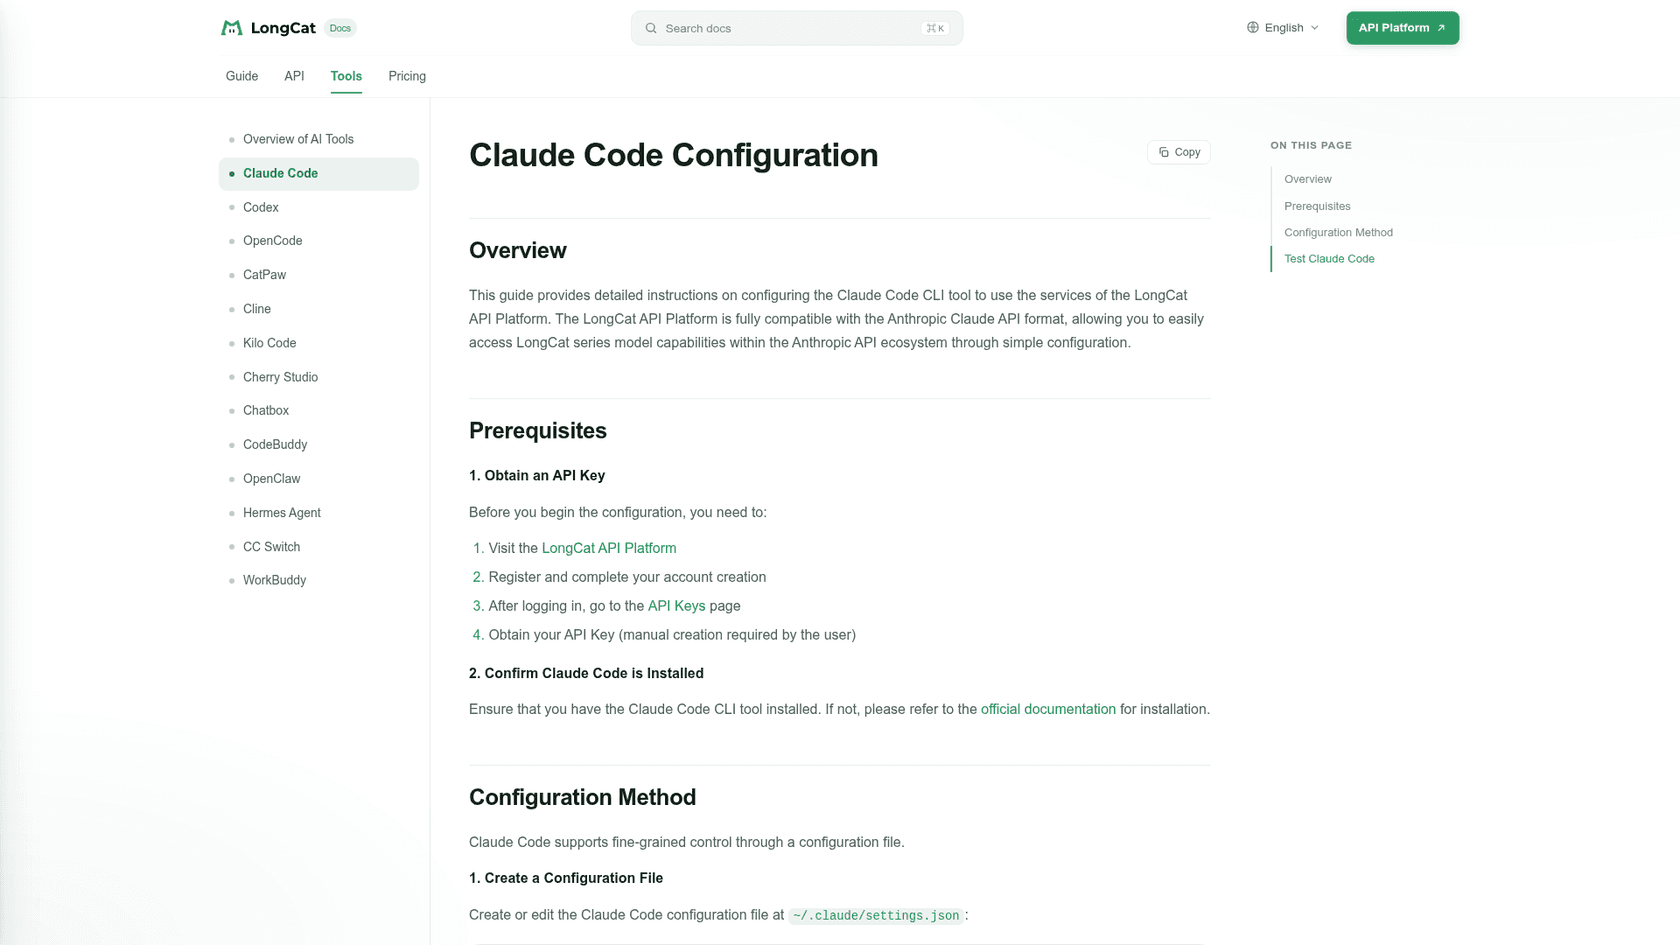
Claude Codeが通常、低コストのバックグラウンド呼び出しに使う"small fast"の枠も含め、すべてのモデル枠が同じモデルを指している点に注目してください。出力$1.20なら問題ありませんが、本当の小型モデルを使った場合のような速度の使い分けはできなくなります。
Codexでは、~/.codex/config.tomlにmodel = "LongCat-2.5"、model_reasoning_effort = "high"、ベースURLのhttps://api.longcat.chat/openai/v1、wire_api = "responses"を設定し、キーは~/.codex/auth.jsonに入れます。
初回実行前に知っておきたい癖は3つあります。
- Temperatureは固定です。 思考が有効なら1.0、無効なら0.7で、それ以外の値は拒否されるのではなく、通知なく上書きされます(モデルパラメータ)。評価ハーネスでTemperatureを変えながら試しても、思ったとおりの動作にはなっていません。
- レート制限は非公開です。 制限はAPIキーごとに適用され、
retry_after: 60付きの429が返りますが、API概要のどこにも1分あたりのリクエスト数やトークン数は載っていません。 - 古いモデルIDは消える可能性があります。 LongCat 2.0と2.5-Previewは、日付付きの提供終了通知がないまま、すべての対応モデル表から消えています。
LongCat-2.0に固定しているなら、今日テストしてください。
選ぶ前にターミナル型コーディングエージェントの全体像を知りたい場合は、エージェント型コーディングCLIのまとめ記事で横並びに比較しています。
開発者はLongCat 2.5をどう評価しているのか?
プレビューはOpenCode内で2週間無料で使えたため、リリース翌日のモデルとしては普段より多くの実体験に基づくフィードバックがあります。最も目立つ話題は、長いタスクでループに陥ることです。
"Longcat is fantastic until it get stuck in loops. I think around 200k tokens of context it loses it. I have been compacting and continuing."

これは、Meituanが学習時に"repetitive reasoning and repeated tool calls"へのペナルティを加えたことと一致します。一般提供版で直ったかどうかは、私なら最初にテストする点です。公平に反対側の意見も見ると、役割を狭く限定して使った人たちには好評でした。
"Longcat is ok as cheap vision agent, tiny tasks, commit. But definitely not as planner, creative writing."
ある開発者は無料プレビューでTerminal-Bench 2.1を自ら実行し、pass@1で48.7%を記録しました。試行あたり約0.54Mトークンで、テストした4モデルの中で最もトークン効率が高かったそうです(r/opencode)。これはプレビュー版であり、Meituanの88.4とはハーネスも設定も違うため、結論ではなく妥当性を確認する材料として読んでください。
Hacker Newsのリリーススレッドでは、料金と比較相手の選び方に注目が集まりました。
"Same price as DS4.1F ... On benchmarks they seem comparable. The wild cards are the cache hit rate and speed."

"LongCat-2.5's chart skips Opus 5.5 and every current frontier model. This always happens, and people defend it because they say it's not fair to compare them. But it absolutely is!"
一般向けチャットはAPIよりも粗削りだという点も覚えておきましょう。あるHNの投稿者は、longcat.aiのチャットのリンクが別ドメインのログインページにリダイレクトされ、返答がデフォルトで標準中国語になると報告しています。チャットアプリだけで試しているなら、APIで得られるものをテストしているわけではありません。
LongCat 2.5をカスタマーサポートに使うべきか?
少なくとも現時点では、サポートキューを支えるモデルとしてはおすすめしません。理由は料金でも品質でもなく、データです。LongCatのFAQと課金ページには、プロンプトをどれだけの期間保存するのか、APIトラフィックを学習に使うのかについて何も書かれていません。プロンプトに顧客の名前、注文、住所が含まれるなら、その説明がないこと自体が判断を決めます。2.0の記事でも指摘したのと同じ障壁です。
さらに大きな論点もあります。モデルはインフラです。チケットに適切に回答するには、ナレッジベースとの接続、エスカレーションのルール、口調、そして顧客に届く前に回答を確認する仕組みも必要です。APIの上にかなりのものを構築することになります。このトレードオフは、AIサポートの自社開発と購入の比較で取り上げています。
そのギャップを埋めるのがeeselです。eeselはAIチームメイトのプラットフォームで、そのAIヘルプデスクチームメイトは既存のヘルプデスクに加わり、ヘルプセンターと過去のチケットから学び、キュー内で回答します。本番稼働の前には過去のチケットに対して実行されるので、どんな回答をしたはずなのかを読んで確認できます。私は実際のキューで、自信たっぷりに聞こえるボットが間違った回答をするのを見てきました。だからこそ、eeselのすべての導入では、実際のチケットに触れる前に過去のチケットでシミュレーションを行います。
SE Rankingは、実際の運用をイメージするのに良い例です。同社はZendesk上で3つの製品を運用し、それぞれにeeselエージェントを1つ配置しています。これらのエージェントは約16,800ページのナレッジをもとに、1か月で4,650件の会話を処理しました。そのうち2,100件は、eeselが最初に回答したライブチャットです。SamCartはFreshdeskのチケット用に1つ、ウェブサイトのチャット用にもう1つのエージェントを運用し、280件のヘルプセンター記事をもとに回答しています。
また、LongCat 2.5に注目した理由が、Claude CodeやCodexから作業するのが好きだからであれば、eeselもそこで使えます。eesel CLI(@eesel/cli)を使えば、ヘルプデスクの接続、エージェントの常設指示の閲覧と編集、アクションの承認と却下、各実行でエージェントが行ったことの確認を、すべてターミナルから行えます。すべてのコマンドはJSONを出力し、書き込み操作は--dry-runに対応しているため、コーディングエージェントが安全に操作できます。また、各ワークスペースはClaude Codeに追加できるMCPサーバーでもあります。コーディングエージェントはサポートのチームメイトをセットアップするのであって、自分がその役割を担う必要はありません。
LongCat 2.5は誰に向いているのか?
Meituanが公開したすべてのページを読んだうえで、私の見解は次のとおりです。
- 試してみましょう。 限られた予算でコーディングエージェントを動かしていて、スクリーンショットや画面録画を読み取れるものが欲しい場合です。$0.30 / $1.20でキャッシュ済み入力が2%なら、自分のリポジトリで午後いっぱいテストしても数ドルです。同じ料金のDeepSeek V4.1 Flashと直接比較してください。
- 待ちましょう。 オープンな重み、ライセンス、セルフホスティングが必要な場合です。Meituanは重みを"coming soon"としていますし、公開されたとしても1.6Tモデルには複数GPUのノードが必要です。現時点でこの2つのうちダウンロードできるのはLongCat 2.0だけです。
- 今は見送りましょう。 プロンプトに顧客データや規制対象データが含まれる場合です。保存や学習に関するポリシーが公開されていなければ、どんな料金でも利用にゴーサインは出せません。
- 代わりにDeepSeekを選びましょう。 仕事のすべてが長期的なコーディングである場合です。同じ料金で、Meituan自身の表ではDeepSeek V4.1 FlashがDeepSWE、NL2Repo、Terminal Bench 2.1で上回り、オフピーク時にはさらに安くなります。独立して測定されたスコアが必要なら、Kimi K3.1 ProとQwen 3.8 Maxは高価ですが、テスト済みです。
公平にまとめると、LongCat 2.5は2.0から確かに進歩しており、料金は据え置きで、後付けではなく組み込まれた視覚機能を備えています。ただ、純粋なコーディング用途で、この価格帯なら当然これを選ぶという存在ではありません。それは自社のベンチマーク表を見ればわかります。
eeselを試す
低価格モデルでチームのチケット対応を減らせるのではと期待してLongCat 2.5にたどり着いたなら、基盤づくりは省きましょう。eeselのAIヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgiasなどに数分で接続し、過去のチケットから学び、本番稼働の前にどのような回答をしたはずなのかを見せてくれます。プランは月額$299からで、テスト用の無料枠もあります。

eeselを試す、無料で始められます。