

Ripple-65Bの料金は100万入力トークンあたり$0.20、100万出力トークンあたり$0.60、キャッシュ入力は$0.05で、提供元はGMI Cloudの1社のみ(直接、またはOpenRouter経由)です。入力1M(80%キャッシュ)と出力50Kのコーディングエージェント1セッションで約$0.11となり、Reflection Beamより5分の1安く、GPT-5.6 Lunaとほぼ同水準です。セルフホストが得になることはまれで、B200を2基借りると月約$7,300かかり、24時間休みなく毎時約91タスクを超えて初めてAPIに勝ちます。サポートキューを回すためにRippleの料金を調べているなら、モデルは安い部分にすぎません。残りは eesel の AI ヘルプデスクチームメイトが担い、その CLI を使えば、コーディングエージェントがヘルプドキュメントを読み込み、公開前に回答をテストできます。
Ripple-65Bの料金はいくらですか?
Ricursive Intelligence は2026年11月4日に、Apache 2.0の65B密モデルのコーディングモデルとしてRipple-65B Previewを公開しました(モデルの概要とスコアはRipple-65Bの概要を参照)。重みは無料です。ホスト型の利用料金はどこでも同じです。なぜなら、提供されている場所はすべて1社のGPUだからです。
| 経路 | 入力 / 1M | 出力 / 1M | キャッシュ入力 / 1M | コンテキスト | 状況(2026年11月5日) |
|---|---|---|---|---|---|
| GMI Cloud(直接) | $0.20 | $0.60 | $0.05 | 1,000,000 | 提供中、BF16、無料枠の記載なし |
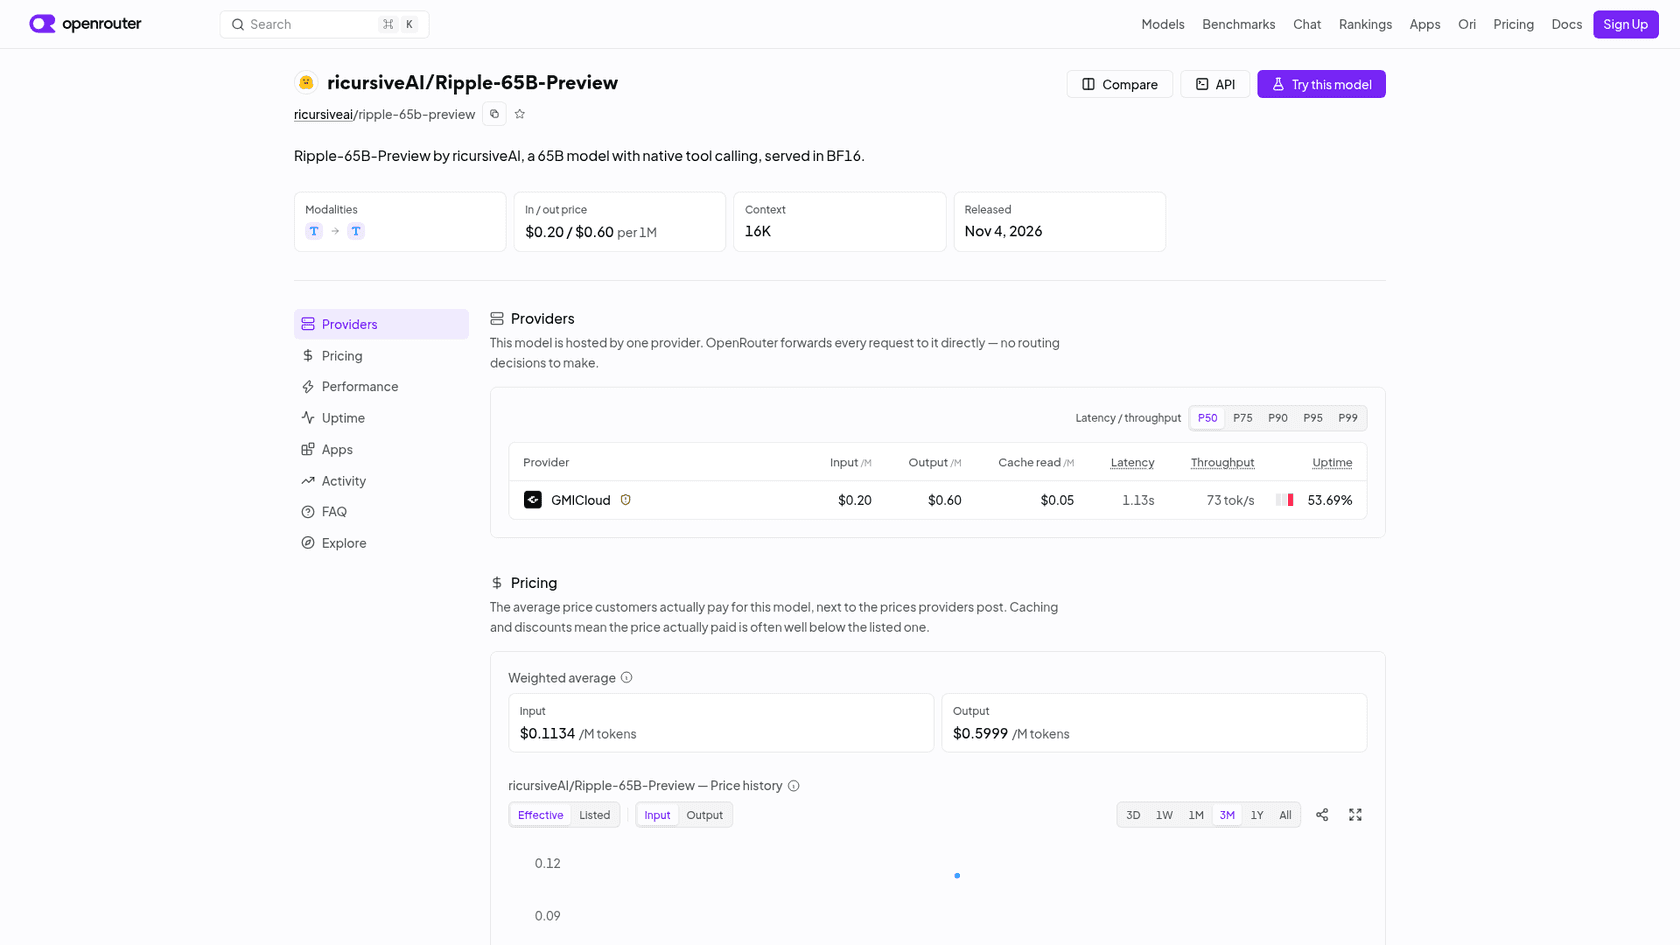
| OpenRouter | $0.20 | $0.60 | $0.05 | APIでは1,048,576(ページ表示は16K) | 提供中、プロバイダーはGMI Cloudのみ |
| Together AI | 記載なし | 記載なし | 記載なし | 仕様パネルでは1M | 「近日公開」 |
| Hugging Face の重み | 無料 | 無料 | 該当なし | 最大1M | Apache 2.0、ホスト型の推論プロバイダーなし |
表示価格より重要な点がいくつかあります。
- 課金単位は入出力ともトークンです。 出力は入力の3倍の価格です。多く読んで少なく書くコーディングエージェントは$0.20側に寄り、長い差分を書くエージェントは$0.60の比重が増えます。
- キャッシュは大きな節約手段です。 GMIはキャッシュ入力トークンを$0.05で課金し、キャッシュ書き込み料金は記載していません。OpenRouterの料金パネルでは、繰り返しのプロンプトがキャッシュにヒットするため、実際に支払った入力トークンの加重平均は100万あたり約$0.11でした。
- 無料枠はありません。 OpenRouterに
:free版はなく、GMIのモデルページにもありません。
執筆中にコンテキストウィンドウが変わりました
11月5日の午前、OpenRouterのエンドポイントAPIはRippleをコンテキスト16,384トークン、出力14,745トークンに制限していました。午後には同じAPIがコンテキスト1,048,576トークン、出力131,072トークンと報告し、上記のモデルページは「16K」のままでした。GMI自身のページは最初から1,000,000としていました。私の見立てでは、大きなウィンドウは順次展開中で、ページの表示が追いついていないのでしょう。長いコンテキストウィンドウを必要とするエージェントの予算を組む前に、長いプロンプトを1回送って、切り捨てられないか確認してください。
今日、Ripple-65Bはどこで買えますか?
現時点では、入口が2つある1か所だけです。OpenRouterはすべてのリクエストを同じ価格でGMI Cloudに転送するので、どちらを選ぶかは利便性の問題です。すでに複数のモデルを1つのキーでルーティングしているならOpenRouter、中間層なしでOpenAI互換エンドポイントを使いたいならGMI直接です。
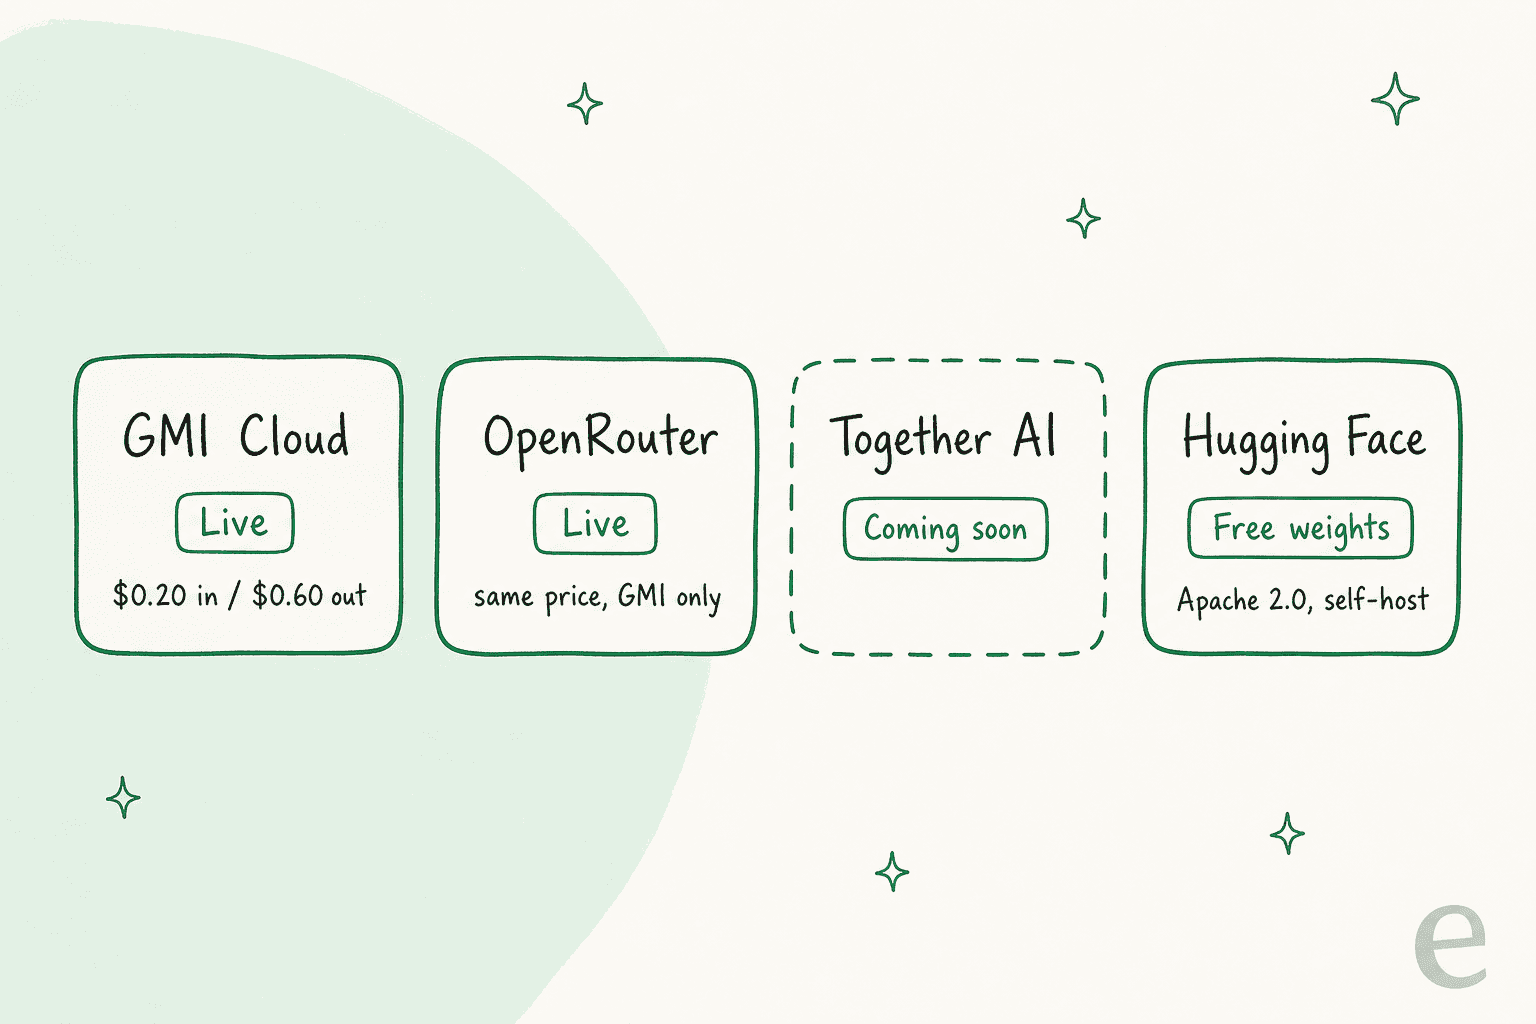
ホストが1社であることには、料金表に出ないコストがあります。キャパシティです。11月5日に確認した時点で、OpenRouterが示すGMIエンドポイントの稼働率は前日で51%から60%の間でした。前日に追加されたモデルとしては普通の立ち上げ時の不安定さですが、顧客向けの用途には厳しい数字です。Ricursiveは、RippleをTogether AIとFireworksにも提供すると述べています。Togetherのページはまだ「近日公開」で、「Notify me」ボタンがあるだけで価格はありません。
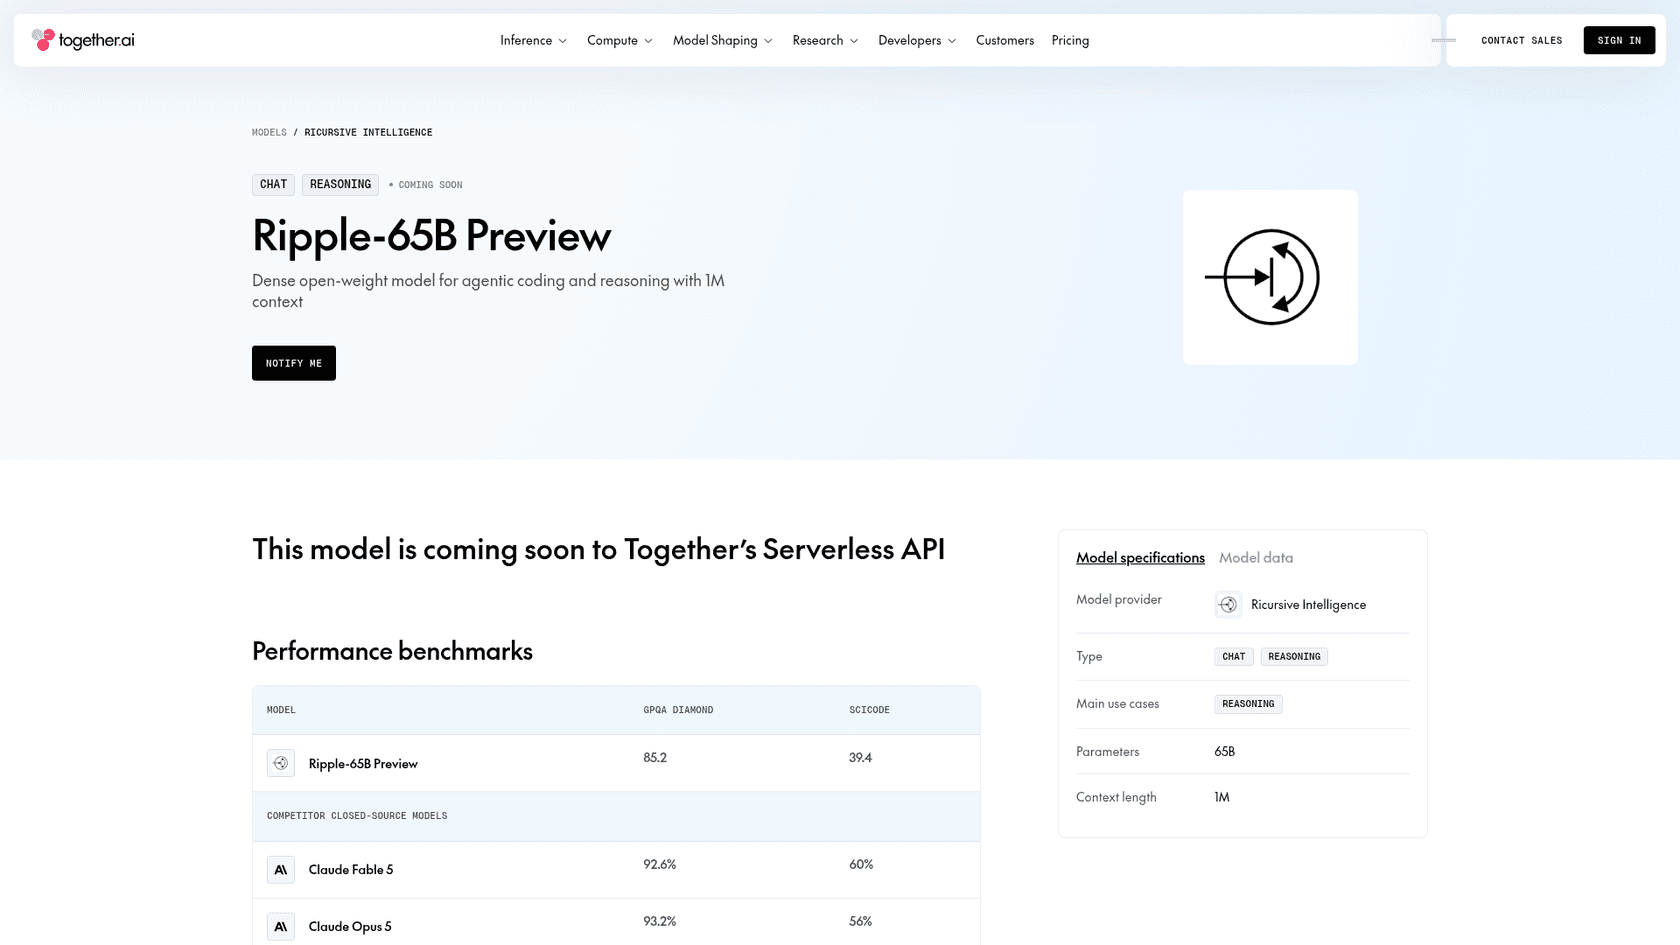
今日フェイルオーバー用の2社目のプロバイダーが必要でも、存在しません。Rippleに本番トラフィックを任せる前に数週間待つべき最大の理由はこれであり、価格とは関係ありません。
Ripple-65Bでコーディングエージェント1タスクはいくらですか?
100万あたりの価格は、実際の仕事で計算するまで実感が湧きません。そこで想定するのは、全ターンの入力が合計1Mトークン(その80%がキャッシュヒット)で、出力50Kトークンを書くコーディングAIエージェントのセッションです。リポジトリを読み、テストを実行し、数ファイルを修正するエージェントとして妥当な規模です。
Rippleなら計算は短く済みます。
- 新規入力200K × 100万あたり$0.20 = $0.04
- キャッシュ入力800K × 100万あたり$0.05 = $0.04
- 出力50K × 100万あたり$0.60 = $0.03
- 合計:1タスクあたり約$0.11、1,000タスクで$110
キャッシュを切ると同じタスクが$0.23になり、2倍以上です。2026年11月5日のOpenRouterの定価で、近いモデルの同じタスクを並べると次のようになります。
| モデル | 入力 / 1M | 出力 / 1M | キャッシュ / 1M | 1タスクあたり | 1,000タスクあたり |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | $0.048 | $48 |
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | $0.110 | $110 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | $0.116 | $116 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | $0.140 | $140 |
| Qwen3.8 27B | $0.15 | $1.875 | $0.0375 | $0.154 | $154 |
| Inkling Small | $0.45 | $1.20 | $0.10 | $0.230 | $230 |
| Nemotron 3 Ultra 550B | $0.60 | $2.40 | $0.12 | $0.336 | $336 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | $0.583 | $583 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | $0.980 | $980 |
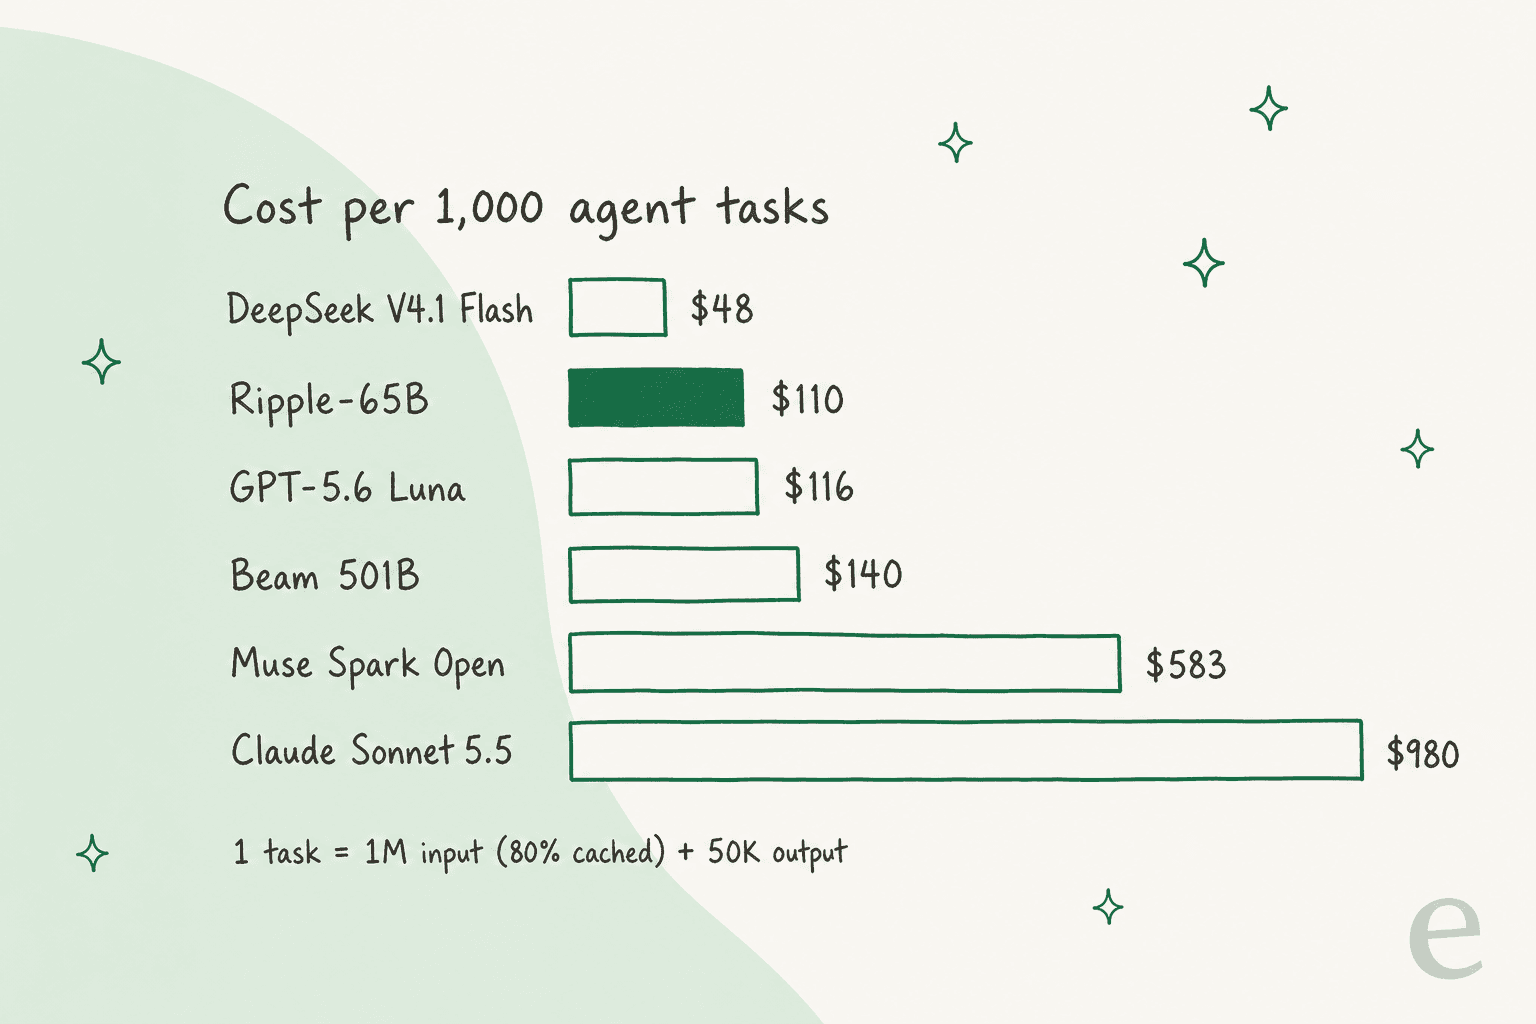
目を引く点が2つあります。第一に、Rippleは表の中で最も安い米国製オープンウェイトモデルで、Terminal-Bench 2.1でスコアが並ぶBeamより約21%安価です(モデルカードでは80.5対80.1)。米国製モデルしか使えないなら、これが重要な比較であり、Rippleは価格で勝っています。
第二に、全体で最も安いモデルではありません。DeepSeek V4.1 Flashは同じタスクを半額以下でこなし、GPT-5.6 Lunaとは1セント以内の差です。つまり「安い」ことがRippleを選ぶ理由になるのは、すでに米国製オープンウェイトに絞り込んでいる場合だけです。より広い範囲については、Kimi K3.1 Proの料金とDeepSeek V4.1 Flashの料金の解説でも同じ種類の計算をしています。
自分の数字を入れてみたいですか?この計算ツールは、各モデルで1か月分のエージェント作業を再計算します。タスク数とトークン構成を設定すると、Rippleがどこに位置し、レンタルの2x B200サーバーがAPIに勝つかどうかを表示します。
Ripple-65BのセルフホストがAPIより安くなるのはいつですか?
思ったより先の話です。Apache 2.0のおかげでセルフホストは合法でライセンス無料ですし、65B密モデルは試したくなるほど小さいサイズです。しかしAPIの価格はすでにぎりぎりまで抑えられているため、張り合うにはハードウェアを常に稼働させ続ける必要があります。
Ricursiveは2つの実行方法を公開しており、どちらもHugging FaceのモデルカードとNVFP4リポジトリにあります。
- データセンター:NVIDIA B200 GPU 2基でBF16。SGLangとDFlash2のドラフトモデルを使い、カードによれば "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels." に達します。
- デスク:NVIDIA DGX Sparkでの実験的なNVFP4ビルド。同時に処理できるのは1リクエストで、コンテキストは128Kまでです。
それぞれのAPIとの比較コストは次のとおりです。
| オプション | コスト | 得られるもの | APIとの損益分岐 |
|---|---|---|---|
| Ripple API | 1Mあたり$0.20 / $0.60 | トークン従量課金、ホストは1社 | 該当なし |
| 2x B200(レンタル) | GMI Cloud "from $5.00/GPU-hour" = 1時間$10、730時間の月で約$7,300 | 1Mコンテキスト、バッチ処理 | 月約66,000タスク、または24時間で毎時約91タスク |
| DGX Spark(購入) | NVIDIAマーケットプレイスで$6,950(128 GB) | 同時1リクエスト、128Kコンテキスト | 本体の寿命の間に約63,000タスク |
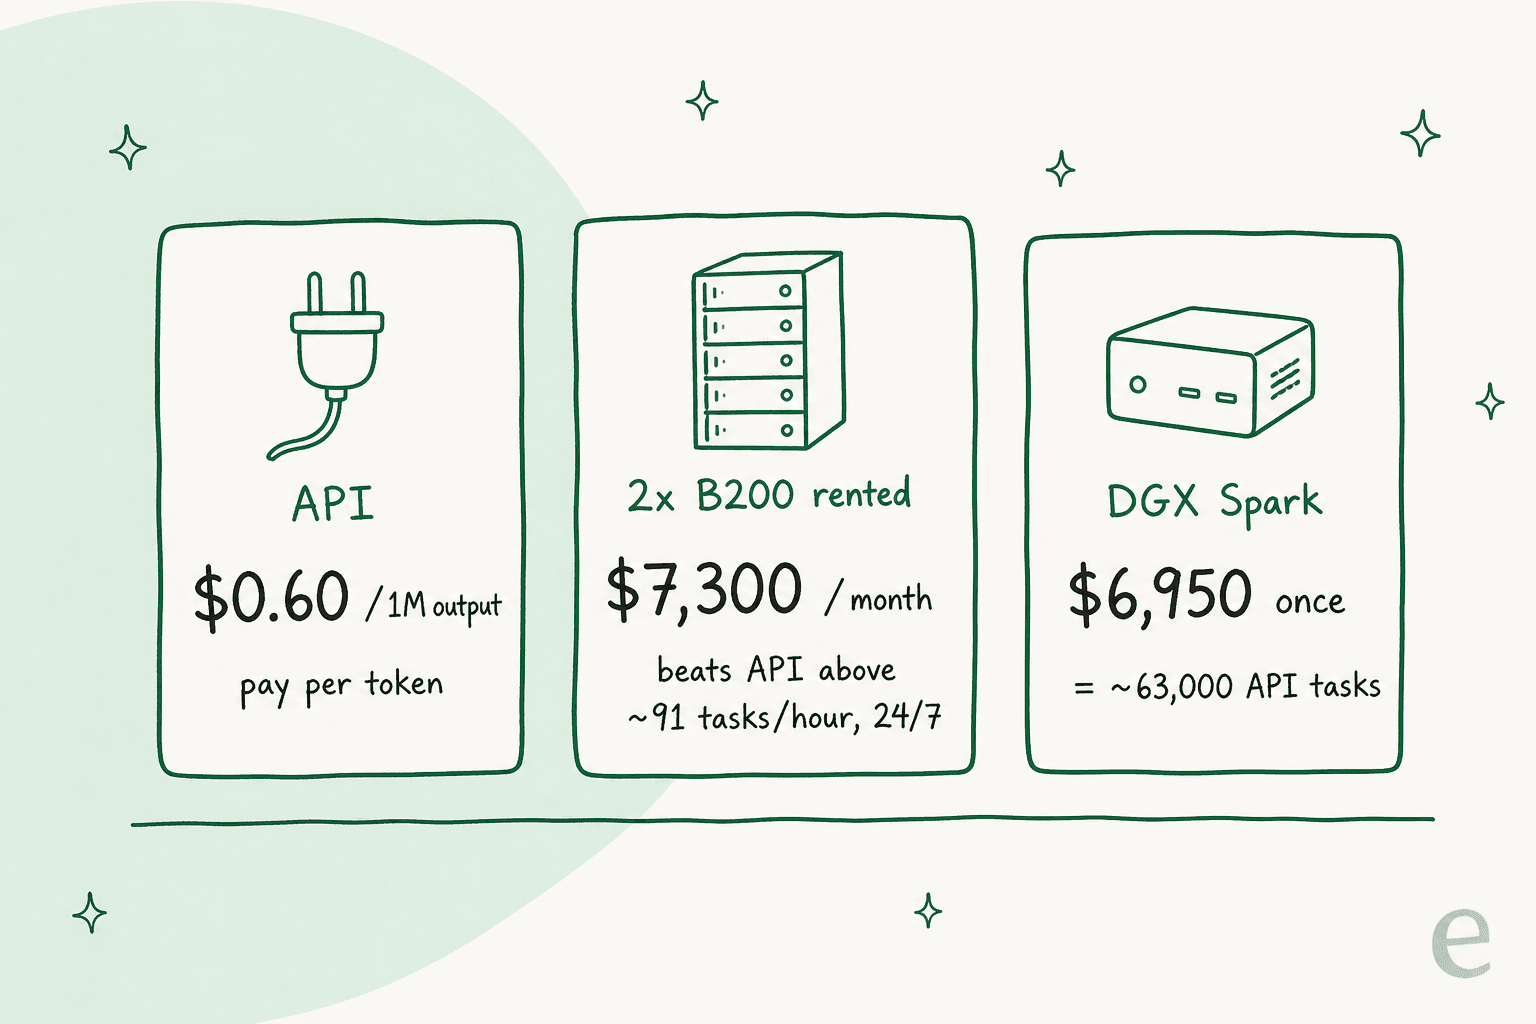
B200の計算は、あの250 tok/sをどう読むかで変わります。リクエストごとの値なら、8リクエスト同時で出力は毎秒約2,000トークン、私のサンプルタスクで最大でも毎時144件です。APIに並ぶだけでも、サーバーを1か月のすべての時間でおよそ63%稼働させる必要があります(これはプリフィル時間、空いた夜間、エンジニアの工数を考える前の話です)。8リクエスト合計の値なら、サーバーの上限は毎時約18タスクで、APIには永遠に追いつきません。Ricursiveはどちらか明記していません。さらにGMIのページではB200は「limited availability」とされ、$5.00は「from」価格です。
DGX Sparkは別の買い物です。$6,950はAPI上のエージェントタスク約63,000件、出力トークン116億個に相当し、同時に1リクエストしか処理しません。Rippleでコストを節約するために買う人はいません。コードとデータを社外に出さないために買うのであり、HNのコメントにもまさにその主張がありました。
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States. It doesn't mean these models are competitive when looked at from a global view but it is also not an irrelevant differentiation."

ローカルでの速度については、懐疑的な声もありました。65B密モデルはトークンごとにすべての重みを読み込みます。一部だけを有効化するMixture-of-Expertsモデルとは異なります。
"But as is, it's probably hard to become popular amongst hobbyists and local model enthusiasts like Qwen's 27B class models or MOE models because it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware, and seems like the goal/mission of the company behind this model is to automate chip design."
私の結論はこうです。ルールで求められる場合か、B200 2基を1日の大半で稼働させ続けられる場合にだけ、Rippleをセルフホストしてください。それ以外の人には、$0.60のAPIが最も安い実行方法です。使う価値があるかどうかはベンチマークの詳細を載せたRipple-65Bのレビューで判断できます。
なぜRipple-65Bはこれほど安く設定されているのですか?
理由の1つはサイズです。BF16で65B密パラメータなら2基のB200に収まりますが、Inkling(975B)やMuse Spark Open(816B)のような競合は、1コピーあたりはるかに多くのメモリを必要とします。もう1つは立ち位置です。Ricursiveは新しいラボで、より安価な中国製モデルがひしめく市場に参入しており、売りは効率です。モデル全体が小さな予算から生まれたと述べています。
"Ripple was built on a $32 million compute budget, one-tenth the cost of the previous open-weight SOTA on agentic coding. We're grateful to the open-source community, whose tools and research helped make this possible."
これは学習コストであって提供コストではなく、APIの価格を決めるものでもありません。価格を決めるのはGMI Cloudです。ただ、ローンチが生のスコアよりも価値を前面に出した理由は説明できます。今日の価格は、1社のホストによるローンチ価格として扱ってください。Together AIとFireworksが掲載を始めれば、料金はどちらにも動き得ますし、2社目のプロバイダーはコストより信頼性の面で重要になるでしょう。
Ripple-65Bはサポートキューを回せるほど安いですか?
トークンの安さは十分です。サポートの返信はコーディングセッションよりずっと小さな仕事で、入力は数千トークン、出力は数百トークンということが多く、入力3,000・出力300トークンで月10,000件返信しても、Rippleなら$8未満です。価格が障害になることはありません。
問題は適合性です。Rippleは軽い後学習のコーディングモデルで、Ricursive自身の表にあるサポートに近い項目のスコアは中程度です。モデルカードによると、τ³-benchのバンキングで31.27(Beam:36.1)、MCP Atlasのツール使用で71.67(Muse Spark Open:89.2)です。そして、モデルはサポートエージェントの安い5%にすぎません。残りはナレッジベースの同期、エスカレーションルール、でっち上げの回答を防ぐガードレール、そして顧客に見せる前に返信を確認する仕組みです。これこそが自社構築か購入かの判断における本当のコストで、支払うのはトークンではなくエンジニアの月数です。
その部分を担うのがeeselです。eeselのAIヘルプデスクチームメイトは、既存のヘルプデスクに参加し、ヘルプセンターと過去のチケットから学習し、誰かに回答する前に過去のチケットでテストされます。自信満々のボットが本番のキューで誤った回答をするのを見てきたからです。デンマークで安全なメールとDigital Postのソフトウェアを販売するTimengoは、約5,300件の過去チケットをもとにeeselにデンマーク語の技術的な返信を下書きさせ、月に約300件のFreshdeskチケットを準備しています。SE RankingはZendesk上で製品ごとに1つのeeselエージェントを運用し、1か月で4,650件の会話を処理しました。
ターミナルで仕事をしているためにRippleにたどり着いたなら、eesel CLIは馴染みやすいはずです。コーディングエージェントは、エクスポートしたヘルプ記事やマクロのような承認済みのナレッジをアップロードし、チームメイトの指示を調整し、公開前にテスト質問を実行できます。ヘルプデスク自体の接続には、引き続き管理者の承認が必要です。ターミナルからのAIエージェント管理の手順も用意されています。
Ripple-65Bは払う価値がありますか?
考えられるあらゆる方法で料金を計算したうえでの私の結論です。
- APIを使うのは、米国製のオープンウェイトのコーディングモデルを試す場合です。キャッシュ利用で1エージェントタスクあたり約$0.11と、同クラスで最安であり、Beamより21%安価です。
- 数週間待つのは、本番トラフィックを任せる場合です。ホストが1社、日次稼働率51〜60%、日中に変わったコンテキストウィンドウは、いずれもローンチ週の問題であり、2社目のプロバイダーがその大半を解決するでしょう。
- セルフホストするのは、ルールでデータを社内に留める必要がある場合か、B200 2基を毎時およそ3分の2稼働させ続けられる場合だけです。
- ほかを探すのは、価格がすべてを決める場合です。DeepSeek V4.1 Flashは半額以下で、より広い範囲はおすすめのAIコーディングアシスタントツールの特集で扱っています。
eeselを試す
チームの負担を減らすためにオープンモデルの料金を調べていたのなら、高いのはトークン代ではありませんでした。eeselのAIヘルプデスクチームメイトは、Zendesk、Freshdesk、Gorgiasなどに数分で接続し、過去のチケットから学習し、公開前に、それらにどう回答したかを見せてくれます。プランは月額$299からで、試せる無料プランもあります。

eeselを無料で試す。