

Edge0-145Bは無料のオープンウェイトなコーディング・エージェントモデルで、145Bパラメータを持ち、16 GiBメモリと20 GiBのシステムRAMを備えた1枚のNVIDIA GPUで動く。よく使う「熱い」エキスパートをカード上に保持し、残りはRAMとSSDから読み込む仕組みだ。Qwen3.8-Flash-Nextを大幅に作り直したモデルで、Edge0自身のテストではコーディングでベースモデルを上回っている。ローンチ記事がさらりと流している2点は、macOSがまだ非対応であること、そしてライセンスが別途契約なしでの商用モデルサービスを禁止していることだ。目的がローカルGPUではなくサポートチケット上のAIなら、eeselはホスト型モデルでそれを実現し、eesel CLIを使えばコーディングエージェントが承認済みのヘルプ記事をアップロードし、本番に出る前に回答をテストできる。
Edge0-145Bとは何か
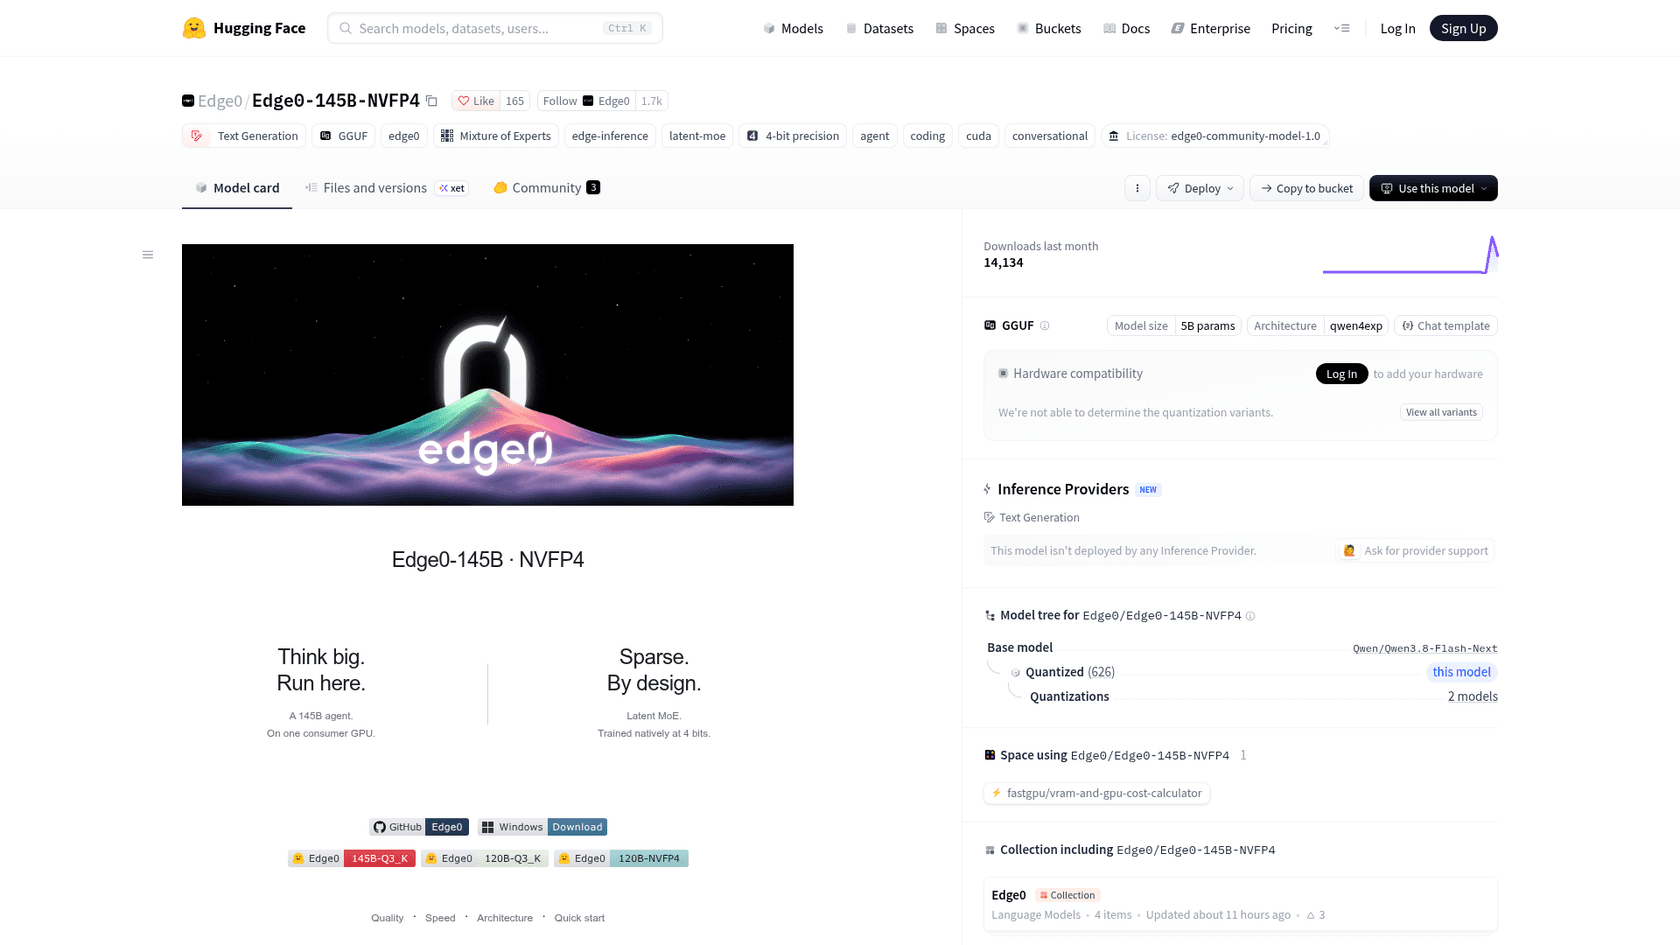
Edge0-145Bは、Edge0が2026年11月12日に、より小さな兄弟モデルEdge0-120Bと同時に発表したオープンウェイトの言語モデル。Edge0のローンチ記事は、これを個人用コンピューターで動く初の1450億パラメータモデルであり、コーディング、推論、エージェント能力がクラウドモデルに近いと紹介している。
私はeeselのプロダクト内でAIエージェントを作っているので、こういったローンチ記事はまず仕組みを、そのあとマーケティングを読む。今回それが重要だったのは、Hugging FaceのモデルカードとGitHubリポジトリがローンチ記事よりも正確な話を語っていたからだ。自分のデスクにRTXカードはないので、以下の内容はすべてこれらの文書とリリースノートからのもので、自分で動かした結果ではない。品質についての評価は、同僚によるEdge0-145Bレビューが別途掘り下げている。
Edge0がモデル自体について公開している内容はこちら。
| 仕様 | Edge0-145B |
|---|---|
| 総パラメータ数 | 145B、トークンあたり約10.12Bが活性化 |
| ベースモデル | Qwen3.8-Flash-Nextから派生 |
| アーキテクチャ | 潜在空間でのスパースMixture-of-Experts、48層、層あたり512エキスパート |
| トークンあたりのエキスパート | ルーティング10 + 共有1 |
| コンテキスト | 256Kトークン(int8 KVキャッシュ、GPU上に32Kを保持) |
| ビルド | Q3_Kが40.81 GiB、NVFP4が47.79 GiB |
| 投機的デコード | 内蔵の1.26Bドラフトヘッド |
| エンジン | edge0-strata、edge0-infer経由で実行 |
| 現在対応プラットフォーム | LinuxとWindows、CUDA 13対応のNVIDIA GPU |
| ライセンス | Edge0 Community Model License 1.0とQwen Community License |
ベースモデルはローンチ記事が埋もれさせている部分だ。モデルカードはベースとしてQwen/Qwen3.8-Flash-Nextを挙げており、謝辞ではQwenとオープンなStrata推論エンジンの両方を挙げている。これはオープンウェイトでは普通のやり方であり、知っておくと便利だ。すでにQwen3.8-Flash-Nextを使っているなら、Edge0-145Bは知っているモデルを再アーキテクチャし再学習したバージョンであり、無関係なファミリーではない。
145Bモデルがどうやって1枚のGPUに収まるのか
収まらない、少なくとも一度に全部は。トリックは、145Bパラメータのうちトークンごとに働くのは約10Bだけという点で、エンジンはそれだけをGPUの近くに置けばいい。Edge0はこれを実現するために4つのアイデアを組み合わせている。
- 共有エキスパート行列。 通常のMixture-of-Expertsモデルでは、各エキスパートが独自の完全な重みセットを保持する。Edge0は各トークンをより小さい「潜在」幅に投影し、大きな投影行列はエキスパート間で共有される。各エキスパートが保持するのは小さなレコード(約1.6 MB)だけなので、数千個がGPUメモリに収まる。
- 3段の保存層。 よく使うエキスパートはGPU上に置かれる。残りはシステムRAMに置かれる。モデルがめったに読まない512億パラメータ分のルックアップテーブルはSSD上に留まり、必要なときに読み込まれる。
- CPUとGPUの連携。 GPUはすでに保持しているエキスパートを計算し、CPUが残りを並行して処理する。
- 投機的デコード。 小さな1.26Bのドラフトヘッドが複数のトークンを提案し、メインモデルがそれを1回のパスでチェックすることで、重みを読む負担をより多くの出力に分散させる。
Edge0はまた、後からクラウドモデルを無理に小さくするのではなく、最初からこの形でモデルを学習させている。このアーキテクチャは、良いニュース(ゲーミングカードで動く)と落とし穴(システムRAMとSSDの速度に大きく依存する)の両方を説明しており、落とし穴については次のセクションで扱う。
実際に必要なハードウェアは何か
ここでローンチ記事とリリースファイルの内容が食い違っている。ローンチ記事の見出しは、「MacBook Proのような対応する個人向けラップトップ」で「ピークメモリ29GB」というものだ。ファイルのほうはより完全な像を示している。
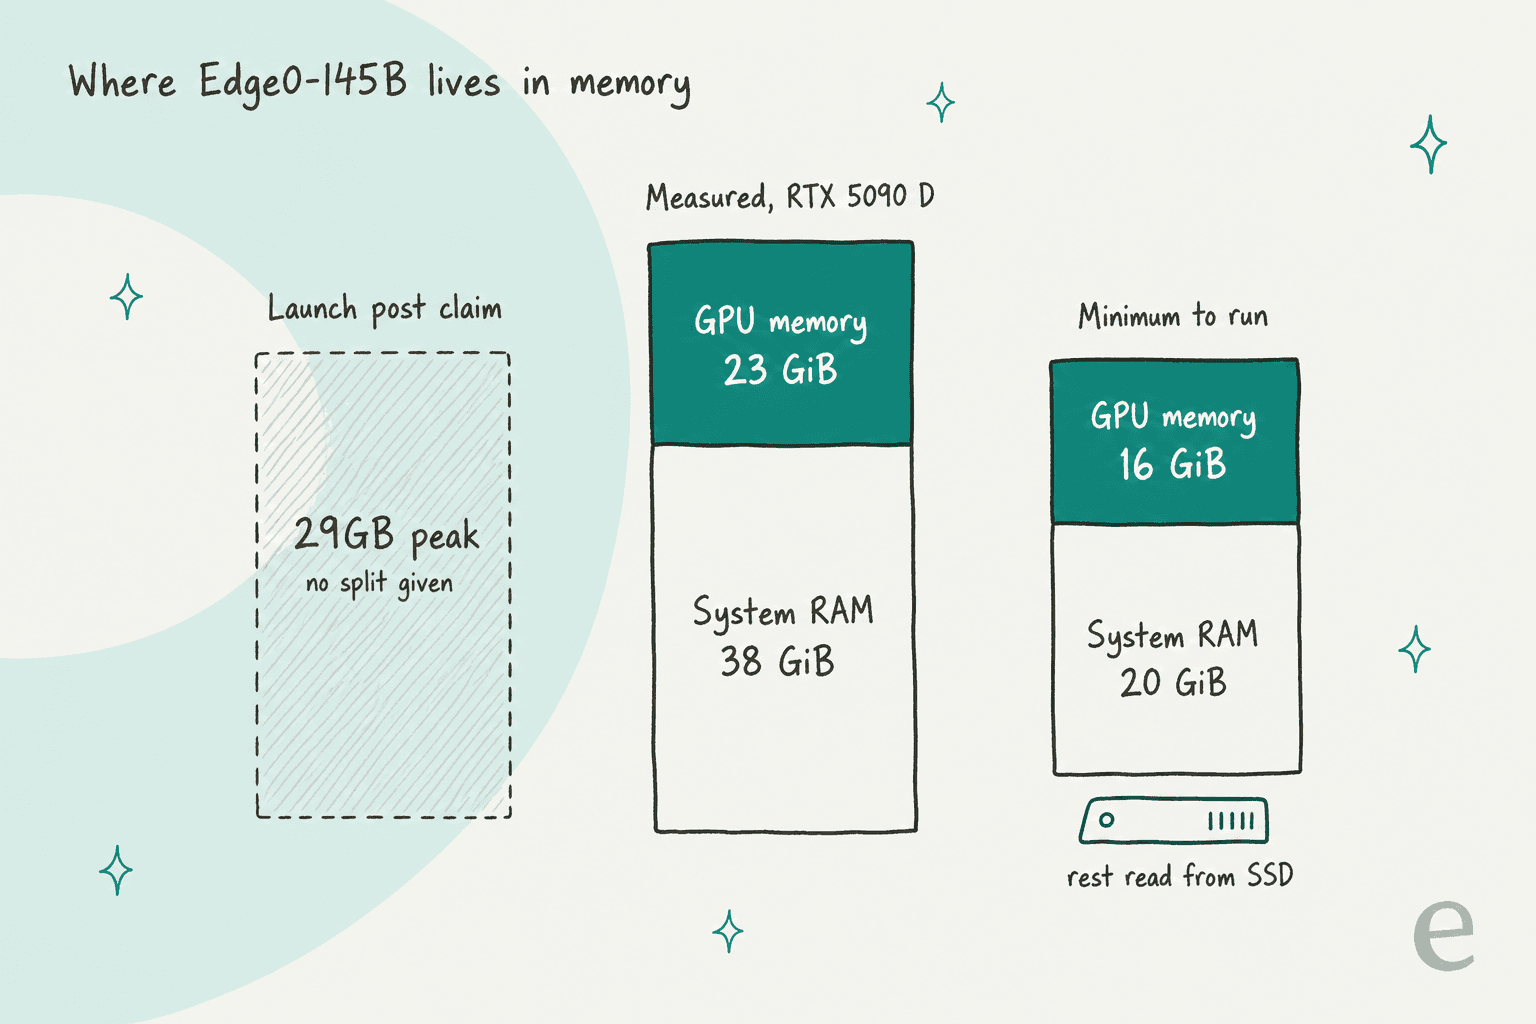
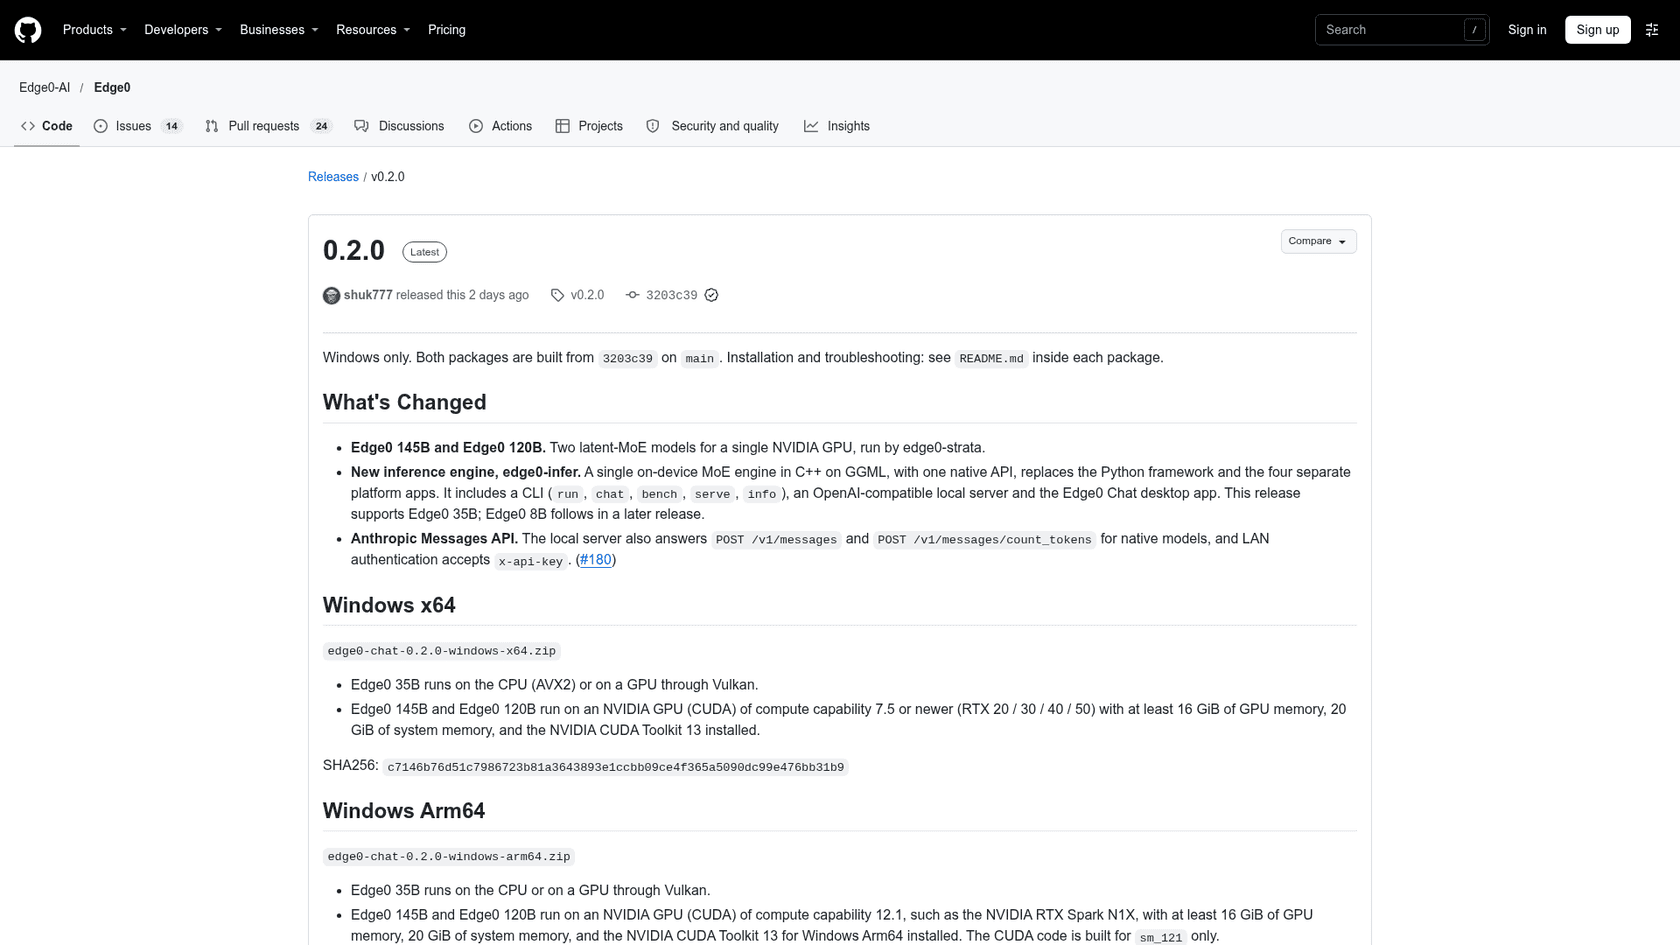
v0.2.0のリリースノートは、Windows x64向けの最小構成として、compute capability 7.5以上のNVIDIA GPU(RTX 20/30/40/50シリーズ)、GPUメモリ16 GiB以上、システムメモリ20 GiB以上、CUDA Toolkit 13を定めている。Windows Arm64ではターゲットはRTX Spark N1Xだ。
フルスピードではもっと使う。モデルカードによると、residencyを有効にした場合、NVFP4ビルドはRTX 5090 D 24 GB上で23.25 GiBのVRAMと38.27 GiBのホストRAMを使い、Q3_Kビルドは23.14 GiBと31.28 GiBを使った。16 GiBと20 GiBという数字は、同じカードに制限をかけ、速度を落とした場合のものだ。
Macに関する主張がもっとも大きな食い違いだ。GitHub READMEのプラットフォーム表は145Bと120Bモデルについてmacos非対応と記載し、モデルカードもApple M2 Ultraのベンチマークは「does not establish macOS release availability」としている。Hacker Newsの読者は初日からこれに気づいていた。
"The blog post mentions Mac repeatedly, saying things like 'day-one support covers macOS'. But the released stuff so far seems to be CUDA only."

つまりApple Siliconなら、今日動くEdge0モデルはより小さいEdge0-35Bだ。Mac上でもっと大きなものが欲しければ、Qwen 3.8 MaxやDeepSeek V4.1 Flashのようなホスト型モデルが今のところ実用的な選択肢だ。
自分のマシンを選んで、どこに当たるか見てみよう。
自分のマシンでEdge0-145Bは動く?
Edge0-145Bはどれくらい速いのか
適切なカードなら速い。モデルカードの速度表は、すべてEdge0自身の計測によるもので、単位は毎秒トークン数。
| マシン | ビルド | 16Kプリフィル | チャットデコード | エージェントデコード |
|---|---|---|---|---|
| RTX 5090 D 24 GB | Q3_K | 3,554.9 | 99.7 | 121.2 |
| RTX 5090 D 24 GB | NVFP4 | 3,165.7 | 79.6 | 98.3 |
| RTX 4090 24 GB | Q3_K | 3,179.4 | 69.9 | 91.7 |
| RTX Spark N1X 60 GiB | NVFP4 | 922.4 | 40.1 | 46.0 |
| Apple M2 Ultra (Metal) | Q3_K | 800.3 | 60.9 | 57.0 |
| 16 GiB VRAM + 20 GiB RAM | Q3_K | 335 | 36.8 | 44.9 |
「エージェントデコード」がチャットより速いのは、エージェントの出力(コードやツール呼び出し)の方が予測しやすく、ドラフトヘッドの予想が当たる頻度が高いからだ。実用上のポイントは2つ。同じカードではQ3_Kビルドの方がNVFP4より小さく速いこと、そしてRTX 5090 Dは5090の中国市場向けバリアントなので、標準の5090なら少なくとも同等以上の速度になるはずだということだ。
Edge0によると、性能はどの程度か
Edge0の内部評価では、Edge0-145Bはエージェントとコーディングの2つのテストでQwenベースを上回り、知識系のテストではわずかに劣っている。
| モデル | DeepSWE 1.1 | Terminal-Bench 2.1 | GPQA-Diamond | IFBench | HLE | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 90.4 | 80.6 | 35.4 | 79.3 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 91.7 | 81.3 | 35.9 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 90.8 | 79.2 | 33.8 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 89.2 | 79.5 | 30.8 | 82.0 |
| Claude-Opus-4.6 (Max) | n/a | 78.2 | 91.3 | 62.5 | 40.0 | 78.0 |
この数字をそのまま信じる前に3つの注意点がある。まず、Edge0がこれを自分自身で実施しており、再現手順を含む完全な技術レポートは約束されているがまだ出ていない。次に、クラウド比較対象はClaude Opus 4.6で、現行のClaude Opus 5.5やClaude Fable 5.2から2世代遅れている。最後に、Edge0自身のページ同士でも120Bについて食い違いがあり、ローンチ記事はDeepSWEで53.6、Terminal-Benchで81.3としているが、GitHub READMEは51.3と75.3としている。
ある開発者が指摘したように、Terminal-Benchはエージェント作業にとって今でも有用な指標だ。
"TerminalBench scores often correspond to real world performance for coding agents that rely heavily on bash."
自分のタスクでモデルを評価するより広い方法を探しているなら、AIサポートエージェントのベンチマークに関する私のノートと、LLM追跡ツールのまとめがその手法を扱っている。
Edge0-145Bのインストールと実行方法
ルートは2つあり、どちらも上記のNVIDIAセットアップが必要だ。
デスクトップアプリ(Windowsのみ)。 リリースページからedge0-chat-0.2.0-windows-x64.zipをダウンロードし、Hugging Faceからモデルフォルダをダウンロードし、Edge0 Chatを開いてそのフォルダを選ぶ。Edge0によれば、アプリのコア機能はアカウントも使用量の上限もなしでオフラインで動く。
コマンドライン(LinuxまたはWindows)。 リポジトリをクローンし、リポジトリ内の手順に従ってedge0-strataエンジンとedge0-inferをビルドし、1つのモデルフォルダを指定する。
git clone https://github.com/Edge0-AI/Edge0.git edge0
build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-Q3_K
重みがロードされると、Listening: http://127.0.0.1:8000と表示され、モデル名edge0_145bのもとでOpenAIおよびAnthropic互換のエンドポイントを提供する。edge0-infer chatは代わりに対話セッションを開く。
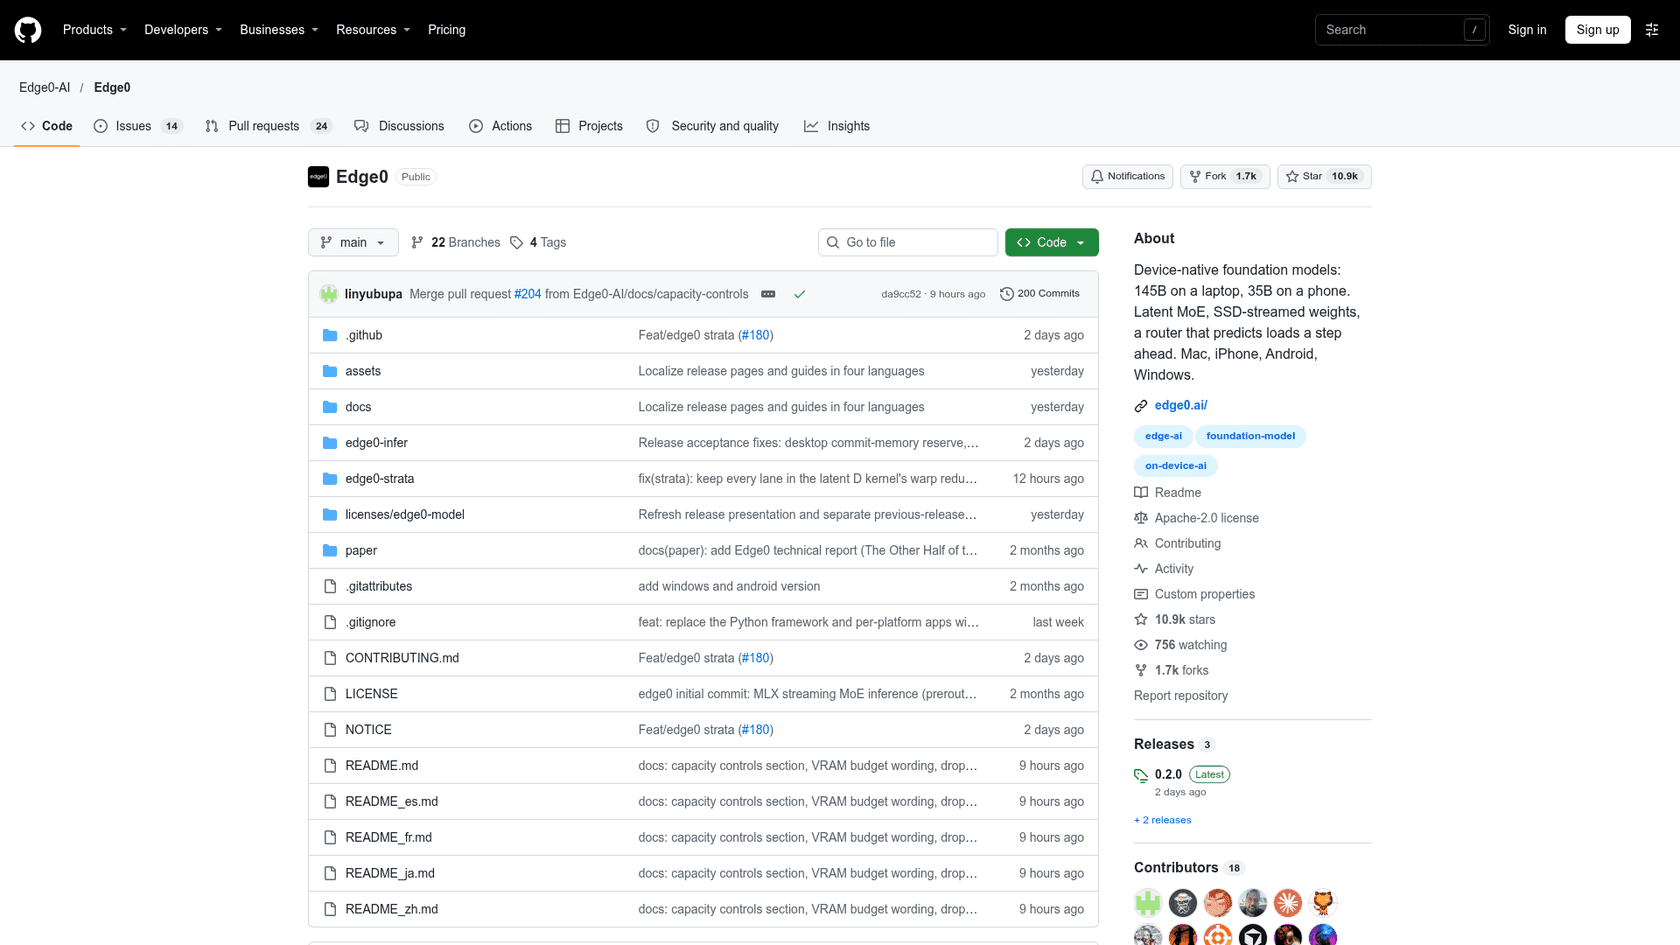
メモリが厳しいときに最も重要な設定が2つある。--mmap-expertsはキャッシュされていないエキスパートをRAMに保持する代わりにSSDから読み込み、--resident-budget-gib 20はRAM上のエキスパートキャッシュを20 GiBに制限する(これには静的なエキスパートプロファイルファイルが必要)。両方ともモデルフォルダのmodel.jsonにあり、アプリとCLIがそれを読み込む。
コーディングエージェントから使う
ローカルサーバーがAnthropic Messages形式を話すため、カスタムのベースURLを受け付けるツールは原則としてそこを指すことができる。Claude Codeの場合、ANTHROPIC_BASE_URLをhttp://127.0.0.1:8000に設定し、モデルとしてedge0_145bを選べばよく、これはどのカスタムエンドポイントでも同じパターンだ。Claude Codeの環境変数とモデル選択のガイドが変数を扱っている。
OpenClawや他のOpenAI互換ツールは/v1/chat/completionsエンドポイントを使える。どちらの経路も自分では試していないので、確認済みのルートというより、ドキュメント上のルートとして捉えてほしい。
ライセンスは何を許可しているのか
ローンチ記事はEdge0-145Bを「open-source」と呼んでいる。ライセンスはその言葉が示すよりも狭く、Hacker Newsでも数分のうちに指摘された点だ。
"This is not open source, this is open weights"
モデルカードによれば、Edge0 Community Model License 1.0が許可しているのは次の点だ。
- 個人利用、研究、改変
- 非商用の共有と企業内での利用
- モデルが生成した出力の商用利用
次の用途にはEdge0から別途書面でのライセンスが必要になる。
- モデルの販売や商用バンドル
- 商用モデルサービスの運営
- それをベースにした独立した商用コーディングまたはオフィスアシスタントの提供
モデルがQwenの素材から派生しているため、Qwenのコミュニティライセンスも上乗せで適用される。エンジンのコード自体はApache-2.0だ。実務上は、開発者自身のマシンや社内ツールには問題ないが、先にEdge0と話をせずに販売するプロダクトのエンジンとして使うのは問題があるということになる。それが障害になるなら、オープンソースAIエージェントのまとめがより緩い条件のツールを挙げている。
Edge0-145Bはサポートチームにとって何を意味するのか
サポートにとっての魅力は明らかだ。顧客データが自分のハードウェアから出ないこと、そしてトークン単位の請求がないこと。これは私が実際によく耳にする懸念だ。あるeeselのセールスコールでは、ハードウェア企業の技術評価担当者が、話を先に進める前に、AIが承認済みの知識だけから回答し、ウェブや一般的な学習データからは回答しないことの保証を求めていた。
しかしローカルモデルが答えるのは別の問題だ。モデルがどこで動くかは、データがどこで処理されるかを決める。顧客に何を伝えるかは、その周りのレイヤー、つまりどのヘルプ記事と過去のチケットを読めるか、回答が見つからないときに何をするか、いつ人間に引き継ぐか、そして実際の会話でそれが事前にテストされているかどうかに依存する。RTXカード上の145Bモデルはそのどれも備えずに届き、ライセンスは契約なしにそれを商用サポートアシスタントにすることを禁じている。
そのレイヤーを担うのがeeselのAIヘルプデスク・チームメイトだ。すでにZendeskやFreshdeskで運用しているキューに加わり、自分たちの知識から回答し、本番に出る前に過去のチケットに対してシミュレーションされる。
SE Rankingは3つのプロダクトでZendesk上にプロダクトごとに1つのeeselエージェントを運用し、約16,800ページの知識から月間4,650件の会話を処理しており、返金や人間への対応依頼はチームに引き継いでいる。オランダのスマート照明企業Innrは、1,500件のヘルプ記事と過去のチケットから、顧客自身の言語でFreshdeskの返信をeeselに下書きさせている。
自分のサポートコンテンツ用にモデルを検討しているなら、Claudeをヘルプデスクに接続する、カスタマーサポート向けMCP、AIエージェントのハンドオフに関する私のガイドが、モデルカードよりも先まで踏み込んでいる。
Edge0-145Bを試すべきか
はい、16 GiB以上のRTXカード、32 GiB以上のRAM、高速なSSDを持っていて、トークン料金なしの強力なローカルコーディングモデルが欲しいなら。Q3_Kビルドを使い、すでに解決済みのタスクでClaude Codeや普段使いのエージェント上で動かし、自分のクラウドモデルと比較してみよう。
待った方がいい場合もある。Mac上、AMD上にいる、あるいは商用プロダクトに組み込む予定があるなら。前者2つはまだリリースされていないプラットフォーム対応が必要で、3つ目はライセンスについての話し合いが必要だ。その間、注目すべきベースはQwen3.8-Flash-Nextであり、Qwenの概要とKimi K3に関する記事が、もっとも近いオープンな代替を扱っている。
サポートキューのAIにeeselを試す
Edge0-145Bを見ていた理由が顧客に回答するAIだったなら、eeselはGPUを買わずにそこへ連れていってくれる。eeselはZendesk、Freshdeskなど複数のヘルプデスクに接続するAIヘルプデスク・チームメイトで、自分たちのヘルプセンターと過去のチケットだけから回答し、本番の会話に触れる前に過去の会話でテストされる。SE Rankingが3つのプロダクトでそれを運用しているのと同じやり方だ。料金を見るか、eeselを試す(無料)。
よくある質問
Edge0-145Bとは何ですか?
Edge0-145Bにはどんなハードウェアが必要ですか?
Edge0-145BはMacで動きますか?
Edge0-145Bはオープンソースですか?
Edge0-145Bの料金はいくらですか?
Edge0-145BはQwen3.8-Flash-Nextと比べてどうですか?
Edge0-145BをClaude Codeで使えますか?
edge0-infer serveは127.0.0.1:8000上でモデル名edge0_145bとしてOpenAIおよびAnthropic互換のエンドポイントを公開するので、カスタムのベースURLを受け付けるツールはそこを指すことができる。Claude Codeの環境変数ガイドのようにANTHROPIC_BASE_URLをローカルサーバーに設定し、モデルを選ぶ。商用プロダクト内で使う前にライセンスを確認すること。