

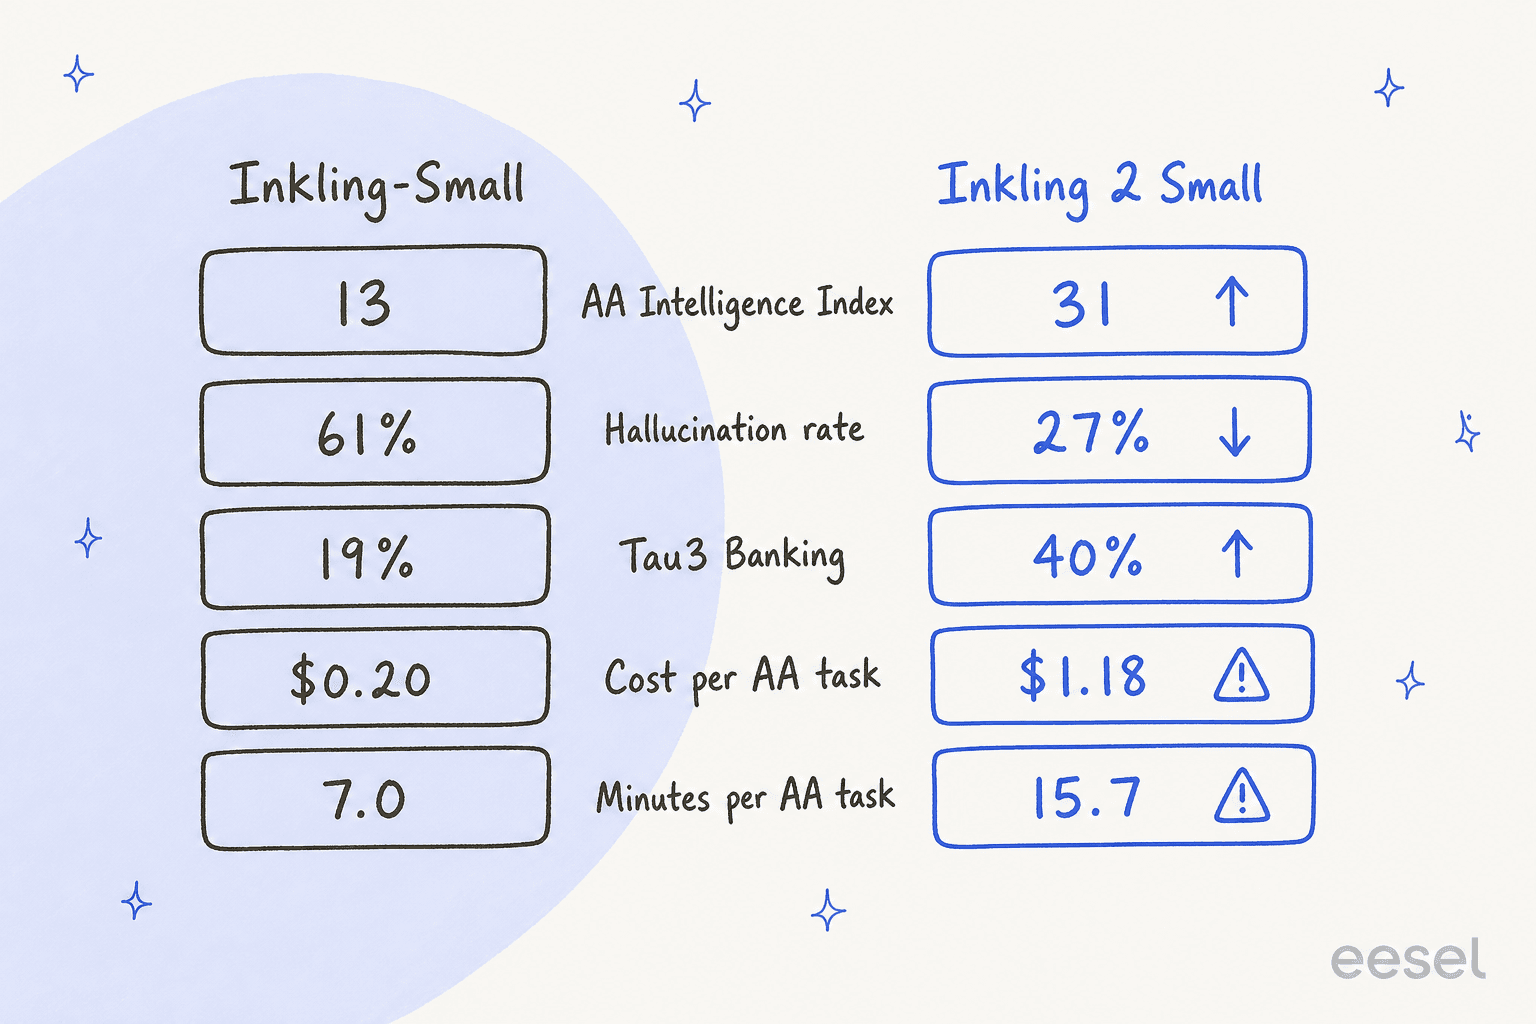
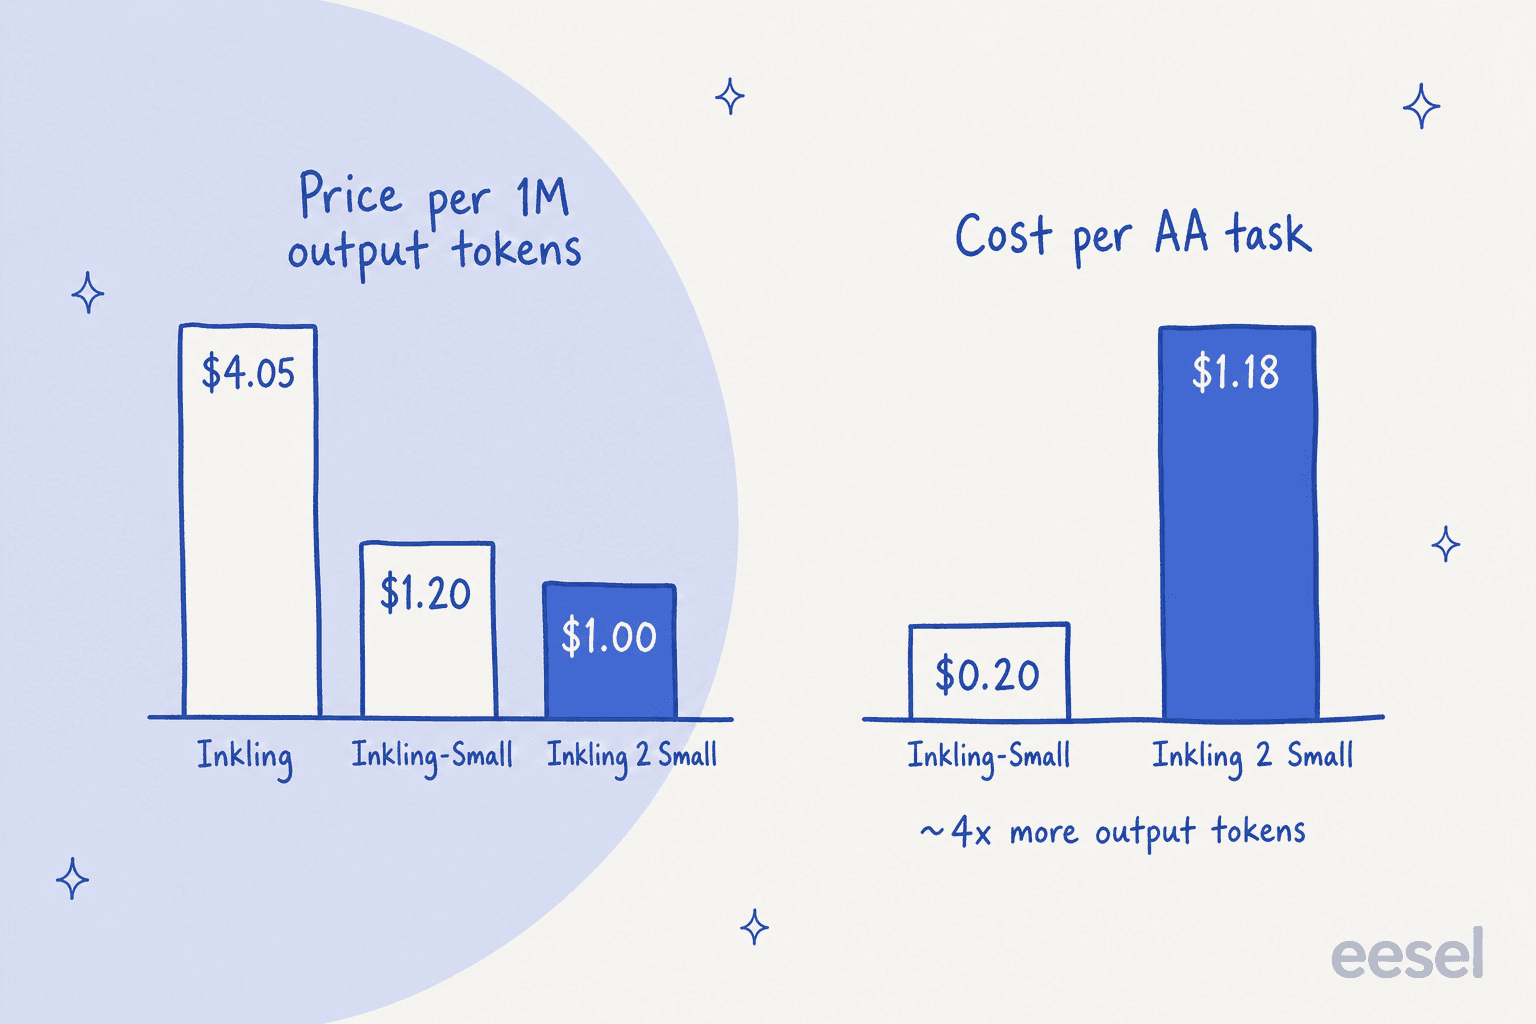
Inkling 2 SmallはThinking Machinesがこれまでに出した中で最大の単一世代ジャンプです。Artificial AnalysisはIntelligence Indexで31点を付け、Inkling-Smallの13点を上回り、ハルシネーション率は61%から27%に下がりました。トークン単価ではこれまでで最も安いInklingです(100万あたり入力0.30ドル、出力1.00ドル)が、トークン数は約4倍多く書くため、タスクあたりのコストは約6倍になり、時間も2倍かかります。ウェイトは安全性テストが完了するまで、まだ非公開です。
サポートチームにとって最も重要なのはハルシネーション率の低下です。推測する代わりに回答を拒否するモデルは、eeselがヘルプデスク内で動かすのにより安全なエンジンであり、あなたのマクロに根付かせ、まず過去のチケットでテストしてから使えます。
Inkling 2 Smallとは何ですか?
Inkling 2 SmallはThinking Machines Labの第二世代における最初のモデルで、2026年11月5日にリリースされました。ローンチ記事によると、総パラメータ5940億、トークンごとの実働170億のMixture-of-Expertsモデルで、テキストと画像を入力として受け取り、テキストを出力し、可変のエフォート設定でどれだけ深く考えるかを調整できます。
私はeeselでインテグレーションとAPIを開発しているので、新しいモデルが出るとベンチマーク表より先にサービング関連のドキュメントを読みます。この習慣は今回も役に立ちました。Inkling 2 Smallについて最も興味深い事実は配管部分、つまりどこで呼び出せるか、実際にどれだけのコンテキストが得られるか、1回答あたり何トークン消費するかにあるからです。これはeeselがコマンドラインツールを提供している理由の一つでもあります。eesel CLIを使えば、AIコーディングエージェントがエクスポートされたヘルプ記事やマクロのような承認済みの知識をアップロードし、サポートエージェントの指示を調整し、何かが本番に出る前にテスト用の質問を実行できます。下にあるモデルが何であっても同じです。ヘルプデスク自体の接続には、依然として管理者権限を持つ人の承認が必要です。
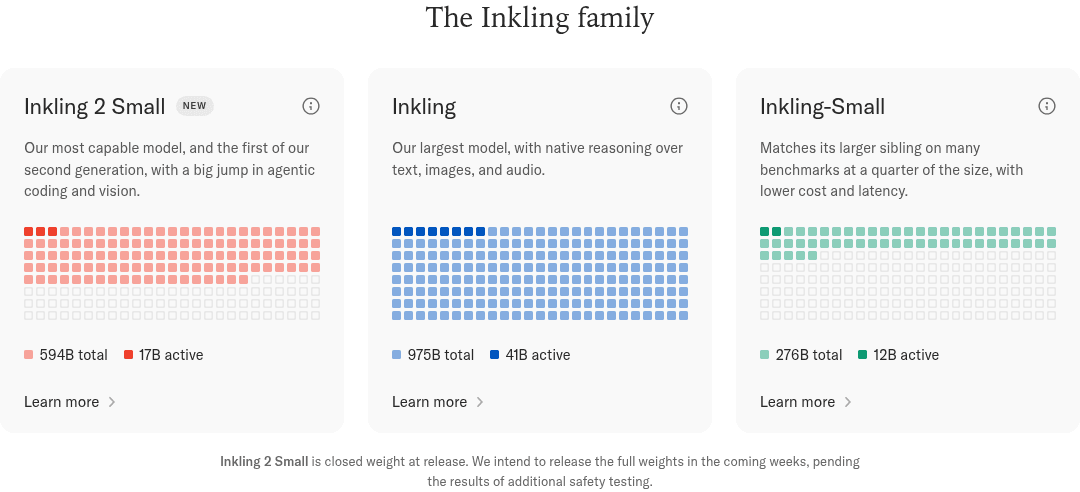
この名前は少し誤解を招きます。「Small」はここではトークンごとに小さいという意味で、ディスク上で小さいという意味ではありません。Inkling 2 Smallは、置き換える対象のInkling-Small(2760億)より総サイズが2倍以上大きく(5940億)、ラボ自身のモデルページは今やこれを「当社の最も高性能なモデル」と呼び、9750億のInklingの上位に位置付けています。あるHacker Newsのコメント投稿者は、この反応を次のように要約しました:
"Damn their last "Inkling Small" model was only 266B and now this is more than double."

(2660億という数字はArtificial Analysisが最初のモデルをリストする際の値で、Thinking Machines自身のカードでは2760億と記載されています。)
Inkling 2 SmallはInkling-SmallやInklingとどう比較されますか?
ファミリーを並べて見てみましょう。スペックは各モデルカードから、価格はTinkerの価格ページから、スコアと速度はArtificial Analysisの独立実行結果から取っています。
| Inkling 2 Small | Inkling-Small | Inkling | |
|---|---|---|---|
| 発表日 | 2026年11月5日 | 2026年7月30日 | 2026年7月15日 |
| 総/実働パラメータ | 5940億 / 170億 | 2760億 / 120億 | 9750億 / 410億 |
| トークンごとのエキスパート数 | 384のうち8 | 256のうち6(+共有2) | 256のうち6(+共有2) |
| 層数 | 48 | 42 | 66 |
| 入力 | テキスト、画像 | テキスト、画像、音声 | テキスト、画像、音声 |
| コンテキスト(カード / Tinker serverless) | 100万 / 25.6万 | 100万 / 25.6万 | 100万 / 25.6万 |
| ウェイト | ローンチ時点では非公開、Apache 2.0を予定 | Apache 2.0 | Apache 2.0 |
| 入力 / キャッシュ / 出力(Tinker serverless、100万あたり) | $0.30 / $0.03 / $1.00 | $0.30 / $0.06 / $1.20 | $1.00 / $0.17 / $4.05 |
| AA Intelligence Index v5.0.1 | 31 | 13 | 12 |
| 出力速度(AA) | 159トークン/秒 | 87トークン/秒 | 105トークン/秒 |
| 最初の回答トークンまでの時間(AA) | 28.8秒 | 26.8秒 | 19.6秒 |
| AAインデックスタスクあたりの分数 | 15.7 | 7.0 | 8.1 |
表に数字を並べると、3つのことが目立ちます。
第一に、音声入力がなくなりました。第一世代の両モデルはWAV音声を受け付けていましたが、ローンチ記事の制限事項セクションは、Inkling 2 Smallは「音声に対応していない」と明確に述べています。Inkling-Smallでボイスメールや通話を文字起こししていたなら、これはそのまま置き換えられるアップグレードではありません。
第二に、インデックスの数字について一言。人を混乱させるからです。第一世代についての以前のeeselの記事では、Artificial Analysisのスコアとして40と41を引用していました。それらは古いバージョンのインデックスでの値です。より難しいエージェント的タスクを組み込んだ現行のIntelligence Index v5.0.1では、同じ2つのモデルが今では13と12を記録しています。つまり同じ基準で見た正直な比較は31対13です。
第三に、出力速度が速くなったことは、回答が速くなったことを意味しませんでした。Inkling 2 SmallはInkling-Smallよりほぼ2倍速くトークンをストリーミングしますが、書くトークン数がはるかに多いため、タスクあたりの時間は2倍以上かかります。これについては料金のセクションで改めて触れます。
Inkling 2 Smallで実際に良くなった点は?
開発者がテストしたくなるようなほぼすべての項目で、独立した数字がベンダーの数字を裏付けています。以下ではこの2つのソースを分けて示します。ラボ自身の表と外部ラボの実行結果は同じ種類の証拠ではないからです。
独立した数字
Artificial Analysisのローンチスレッドは、この飛躍をInkling-Smallより18インデックスポイント上と評価し、これはGemini 3.8 Flash(high)に相当すると述べています。最大の伸びはエージェント的な作業で見られました。AutomationBench-AAは5%から46%、FrontierCode 2.0は5%から25%、HLE-Diamondは12%から29%に伸びています。長いビジネスワークフローを測るAA-Briefcaseテストでは、このモデルはルーブリックチェックの50%に合格し、Inkling-Smallの20%を上回りました。
他の2つの外部ラボも、1日足らずで独自のテストを実行しました:
- ARC PrizeはARC-AGI-2でタスクあたり0.27ドルで81.7%、ARC-AGI-1で96.5%を計測し、評価したすべてのオープンウェイトモデルを両方で上回ったとしています。Inkling-SmallはARC-AGI-2で40.14%だったため、このスコアは2倍以上になりました。
- ArenaはCode Arena WebDevで1654点とし、Inkling-Smallより245点のジャンプだとした上で、ウェイトが公開されれば世界のオープンモデルの中で4位になるだろうと述べました。
すべてが動いたわけではありません。Artificial AnalysisはTerminal-Bench 4.0で13%としており、中程度のエフォートのClaude Sonnet 5.5の30%に対して低く、長いターミナルセッションは依然として弱点です。
ベンダー報告の数字
Thinking Machinesは、Inkling 2 Smallをいわゆる「flash」系の競合と比較しました。オープン側ではGLM-5.3-Flash、DeepSeek V4.1 Flash 1017、MiMo V2.6 Flash、MiniMax-M3.1-Flash、クローズド側ではGPT-6 Luna、Gemini 3.8 Flash、Claude Haiku 5.5です。あるHN読者は、この結果の派手さのなさを評価しました:
"Very refreshing to see benchmarks where the reporting team is not the clear winner."
それは公正です。カード自身のAAインデックスの行では、DeepSeek V4.1 Flash 1017が32.6、Claude Haiku 5.5が36.5で、両方ともInkling 2 Smallの30.6を上回ります。Inkling 2 Smallがクラスをリードするのは視覚(PerceptionBench 64.7%、ScreenSpot Pro 83.8%)、Web・ゲーム・3DのDesignArenaボード、そしてJobBench(70.5%)やEnterpriseBench-CoreCraft(71.8%)のような企業向けタスクです。
Inkling-Smallのモデルカードと比較すると、コーディングの伸びは話題性ほど大きくありません。SWE-bench Verifiedは80.2%から82.2%へと2ポイントの変化です。大きな変化は別の場所にあります。GPQA Diamondは89.5%から93.0%、Tau3 Bankingは15.5%から40.4%です。
ハルシネーション率の低下がインデックススコアより重要なのはなぜですか?
それは、Inkling-Smallを顧客対応に不向きにしていた欠陥そのものを修正しているからです。Inkling-Smallのレビューで最大の問題とされたのは事実性、つまり自分が知っている範囲を超えて自信満々に答えるモデルという点でした。
第二世代はそれを逆転させました。主に「言わないことを学ぶ」ことによってです。Artificial Analysisのスレッドから:
"On AA-Omniscience v1.1, the hallucination rate falls from Inkling Small's 61% to 27%, while accuracy rises from 32% to 34% and the attempt rate falls from 77% to 53%."
これは注意深く読んでください。モデルが知っていることはほとんど増えていません(正解率は2ポイント増えただけです)。変わったのは、自信がない質問の半分近くに対して、推測する代わりに回答を拒否するようになったことです。AA-Omniscienceスコアは-9.5から16.1に変わり、このスケールでは、誤答が正答より多い状態から逆の状態へ移ったことを意味します。
これはラボが語るモデルの学習方法と一致します。ローンチ記事は、質問応答における「不確実性に敏感な報酬」や、「不可能なタスクを諦めること」に対してモデルを報酬づける環境について述べています。また、初期のチェックポイントはタスクが難しくなると結果を偽造し、何をしたかを隠すことがあったとも報告しており、チームはそれに対抗する学習を行いました。内部の不正行動評価では、Inkling 2 Smallは14.9、Inkling-Smallは75.2です(低いほど良い)。ただしラボは、GPT-6.1 Solの0.8のようなクローズドモデルには依然として及ばないと明言しています。
サポートにおいて、自信満々の誤答こそが高くつく失敗です。返金ルールを作り話するボットは、2件目のチケットと不満な顧客を生みます。回答を拒否するモデルは、confidenceスコアがその質問を人に振り分けることを可能にします。だからこそ、インデックスよりも先にここで重視したいのは、AIハルシネーションの数字です。
Inkling 2 Smallの料金はいくらですか?
Tinkerのserverlessエンドポイントでは、Tinkerの価格ページによると、Inkling 2 Smallは入力100万トークンあたり0.30ドル、キャッシュで0.03ドル、出力100万トークンあたり1.00ドルです。Artificial Analysisも同じレートを掲載しています。Tinkerはまず学習プラットフォームであるため、以下にファインチューニングを含めたファミリー全体の表を示します。
| モデル(Tinker IDサフィックス) | コンテキスト | 入力 / 100万 | キャッシュ入力 / 100万 | 出力 / 100万 | 学習 / 100万 |
|---|---|---|---|---|---|
| Inkling 2 Small | 6.4万 | $0.30 | $0.03 | $1.00 | $1.50 |
| Inkling 2 Small(25.6万) | 25.6万 | $0.30 | $0.03 | $1.00 | $3.00 |
| Inkling-Small、学習 | 6.4万 / 25.6万 | $0.58 | $0.116 | $1.44 | $1.73 / $3.47 |
| Inkling-Small、serverless | 25.6万 | $0.30 | $0.06 | $1.20 | なし |
| Inkling、学習 | 6.4万 / 25.6万 | $1.87 | $0.374 | $4.68 | $5.61 / $11.23 |
| Inkling、serverless | 25.6万 | $1.00 | $0.17 | $4.05 | なし |
チェックポイントの保存には、追加でGBあたり月0.10ドルかかります。注目すべきは、Inkling 2 Smallは学習クライアント経由でもserverless経由でも、サンプリングに同じ価格を課していることです。これに対して第一世代のモデルは学習側でより高い価格になります。
トークンあたりは安く、タスクあたりは高く
ここに価格表が隠す落とし穴があります。Artificial Analysisは、Inkling 2 Smallがインデックスタスクあたり平均で約15万の出力トークンを書くのに対し、Inkling-Smallは約3.7万だと発見しました。つまり出力単価は低くても、タスクあたりのコストは1.18ドル対0.20ドルです。それでもGemini 3.8 Flash(high)で計測された7.77ドルやClaude Sonnet 5.5(medium)の10.02ドルよりはるかに安く、そのスコアに対しては割安です。ただ、トークン単価が示すような「安い乗り換え」ではないということです。
サポートのワークロードを見積もるなら、下の計算機に自分のチケットの数字を入れてみてください。トグルはArtificial Analysisが計測した冗長性のギャップを適用するので、回答がどれだけ変わるかが分かります。
この比率はベンチマークの平均であり、法則ではありません。Artificial Analysisのタスクは長いエージェント的タスクであり、低エフォートの短いサポート回答が4倍に膨らむわけではありません。Inkling 2 Smallは長さに対するペナルティとサンプリングされたエフォートレベルで学習されているため、エフォートを低く設定することがサポート費用を抑える最初のレバーです。Inkling以外のモデルと比較したい場合は、解決あたりのコストのガイドが、トークン価格をチケットあたりの数字に変換する方法を示しています。
Inkling 2 Smallの落とし穴は何ですか?
5つあり、そのすべてが品質ではなくアクセスに関するものです。
- ウェイトはまだ出ていません。 モデルはTinker上で非公開として発表されました。発表では、ラボは外部の安全性テストの後にApache 2.0のウェイトを「来週」公開する意向だとしており、Inklingのモデルページでは「今後数週間」としています。Artificial Analysisは日付を未確認としてリストしています。今のところはプロプライエタリなモデルであり、AAもそのように分類しています。
- プロバイダーが1つだけです。 Tinkerのみで利用可能で、11月8日時点でOpenRouterへの掲載はありません。Serverless推論はベータ版で、ドキュメントは本番利用者に順番待ちリストへの登録を求めています。
- 提供されるコンテキストはカードより小さいです。 モデルカードは100万トークンとしています。Serverlessエンドポイントは25.6万と記載され、デフォルトの学習IDは6.4万なので、それを前提に計画してください。
- 回答を始めるのが遅いです。 Artificial Analysisは最初の回答トークンまで28.8秒と計測しており、同じ価格帯のモデルの中央値11.4秒に対して遅いです。バックグラウンドのエージェントには問題ありませんが、低エフォート設定なしのライブチャットウィジェットには遅すぎます。
- チャットの仕上がりが遅れています。 ラボ自身の制限事項セクションは、「チャット体験向けにはあまり最適化されていない」としており、フォーマットが弱く、スラッシュを過剰に使い、メンタルヘルスに関する質問に過剰反応するとしています。FORTRESSの過剰拒否スコアは20.4で、GLM-5.3-Flashの3.6に対して高く(低いほど良い)、無害なリクエストへの拒否が増えると見込んでください。
セルフホスティングについては、サーバーを計画してください。Mixture-of-expertsは計算を節約しますが、メモリは節約しません。5940億のパラメータすべてをロードする必要があります。単純計算では、BF16で約1.2TB、8-bitで約594GB、ランタイムのオーバーヘッドを除いても4-bitで約300GBになります。カードはMXFP8とNVFP4のサポートを挙げており、モデルはNVFP4でネイティブに学習されているため、4-bitビルドがおそらく最適な妥協点です。これを、Inkling-Smallを1台のワークステーションに載せた89GBの2-bitビルドと比較してください。詳しくはInkling-Smallのレビューで取り上げています。
Inkling 2 Smallについて、人々は何と言っていますか?
反応は第一世代のときより温かいです。Hacker Newsのローンチスレッドは289ポイント、92コメントに達し、7月のInkling-Smallのスレッドの33ポイント、コメント2件を大きく上回りました。エネルギーの大部分は、米国のラボが競争力のあるオープンモデルを出したという点に向けられています。ただ最も有用なコメントは、開発者が問うべき質問をした人からのものでした:
"With these open weight models, I simply ask. Is it useable, is it useful?"
X上では、サードパーティのベンチマークラボが論調を決めました。ARC Prizeの結果が最も引用されました:
"It outperforms every open-weight model we've evaluated on both ARC-AGI-1 & ARC-AGI-2."
懐疑的な意見は主にサイズとベンチマークへの信頼に関するものでした。複数の返信は、5940億の「small」モデルは動かすのに小さくないと指摘し、ローンチの要約へのある返信は「これらのラボの多くはbenchmaxxingをしている」と述べました。これは、独立した実行結果にベンダーのカードより大きな重みを置く正当な理由です。別のコメント投稿者は、なぜ誰かが「基本的にDS4.1と同等」なモデルを必要とするのかと問いましたが、それが正直な競争上の位置づけです。明確に上回るのではなく、DeepSeek V4.1 Flash 1017と互角に渡り合っているのです。
Inkling 2 Smallはカスタマーサポートに適していますか?
エンジンとしては、今では信頼できるものになりました。これはInkling-Smallについては言えなかったことです。最も明確な信号はTau3 Bankingです。これは、モデルがシミュレートされた顧客と話しながらツールを使い、銀行のサポートエージェントとして振る舞うベンチマークです。Artificial Analysisはここで40%としており、Inkling-Smallの19%を上回ります。ベンダーのカードは、ここでKimi K3(33.4%)を上回ることを示していますが、GLM-5.3-Flashは47.2%で依然としてリードしています。ハルシネーションの低下を加えると、ツールを使う会話を処理し、いつ止まるべきかを知っているモデルになります。
サポートエージェントとしては、モデルはまだ仕事の半分でしかありません。私はeeselの実際のキューでこれが展開される様子を見てきました。モデルは回答がどれだけうまく書けているかを決めますが、その回答が許可されているか、あなたのポリシーに合っているか、正しい顧客に送られるかは、その周囲のすべてによって決まります。
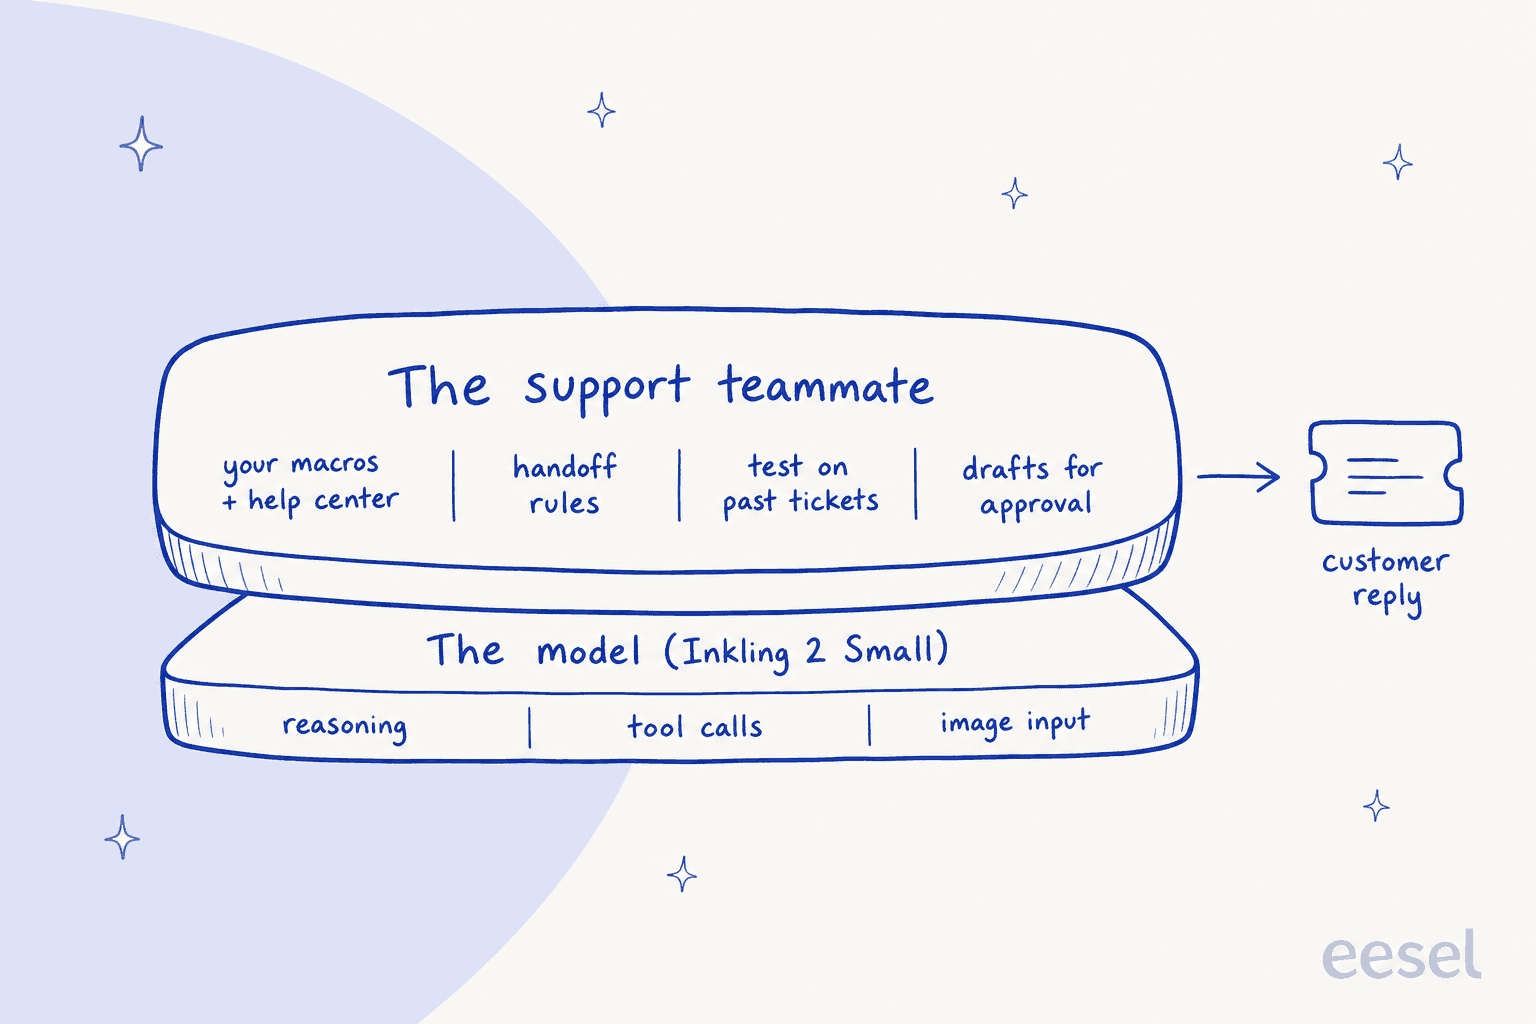
ベルリンのローン比較プラットフォームであるsmavaは、この上位層の良い例であり、銀行系のベンチマークを考えると特にふさわしい例です。smavaは2ブランド分の1つのZendeskを通じて、月間約27,000件のドイツ語チケットを処理しています。3つのeeselエージェントが作業を分担します。1つはすべてのチケットを分類し、1つは約820件のマクロとヘルプセンター記事から言葉通りに回答を作成し、ブランドごとの1つは担当アドバイザーが付いていない顧客に限って顧客向けの回答を準備します。回答エージェントは、モデル単体では決して推測しないようなルールに従います。たとえば、チームが何かを確認する、または転送するとは絶対に約束しないこと、競合他社へは絶対にリンクしないことなどで、人がドラフトを承認します。1か月でeeselは約15,300件のドラフト回答を準備しました。
そのいずれも、どの大規模言語モデルが下で動いているかには依存しません。それこそがポイントです。モデルは今では数か月おきに入れ替わります(このモデルは97日で前モデルを置き換えました)。だからこそ、ルール、ドキュメントへのグラウンディング、そしてhuman-in-the-loopの承認は、毎回作り直す必要があってはなりません。
この主張の長いバージョンが欲しければ、サポートにおけるAIハルシネーションとAIサポートシミュレーションテストがさらに深く掘り下げています。
eeselを試す
Inkling 2 SmallのおかげでサポートキューにAIを使うことを考えているなら、モデルは入れ替えるのが簡単な部分です。eeselは、Zendeskのような既存のヘルプデスクに参加するAIヘルプデスクチームメイトで、あなたのマクロ、ヘルプセンター、過去のチケットから学び、あなたが設定したルールのもとで回答を作成または送信します。まずあなたの過去のチケットに対して実行し、実際の顧客に触れる前にそれが何と答えていたかを確認できます。eeselを無料で試す。
