

Eleven v4とは?
Eleven v4は、ElevenLabsの音声モデルの第4世代です。ElevenLabsは最も知られたAIボイス企業の一つで、同社はEleven v4のドキュメントページでこれを「the first in a new generation of models」と呼んでいます。
ローンチ記事によると、これはまったく新しいアーキテクチャで動作し、声優のように台本を読みます。誰が話しているか、直前に何があったかに注意を払ってから、その一行をどう届けるかを決めます。
私はeesel(AIチームメイトのプラットフォーム)でAIエージェントを作っており、チームは長年、実際のサポートキューにAIを投入してきました。そのため、このようなリリースがあると、本番に出す人にとって何が変わるのかだけを知りたくなります。短く言うと、v4は確かな前進ですが、移行作業でもあり、そのまま差し替えられるものではありません。
モデルリファレンスによると、2つのバリアントがあります。
- Eleven v4(
eleven_v4):品質重視のモデル。10,000文字の上限(約10分の音声)、複数話者の対話に対応し、Text to Dialogue API経由で提供されます。 - Eleven v4 Turbo(
eleven_v4_turbo):リアルタイム用のモデル。推論レイテンシ中央値は約100msで、Text to Dialogue WebSocketとElevenAgents内で提供されます。
9月28日の更新履歴によると、どちらも現在、ElevenCreative(Webアプリ)、ElevenAgents、APIで利用できます。動画のほうが好みなら、ElevenLabsが短い開発者向け解説動画も公開しています。
v3から実際に何が変わった?
表現力とクローンの精度が見出しになります。ただ、実際に計画を立てるうえで必要な詳細はドキュメントにあります。そこで、モデルページとAPI料金ページから次の比較表を作りました。
| Eleven v3 | Eleven v4 | Eleven v4 Turbo | |
|---|---|---|---|
| 向いている用途 | ドラマチックな演技 | オーディオブック、ナレーション、吹き替え | ボイスエージェント、インタラクティブアプリ |
| 対応言語 | 70以上 | 90以上 | 90以上 |
| 1リクエストあたりの文字数上限 | 5,000 | 10,000 | ストリーミング |
| レイテンシ | リアルタイムではない | リアルタイムではない | 推論中央値 約100ms |
| 1,000文字あたりのAPI定価 | $0.08 | $0.08 | $0.04 |
| Professional Voice Clone | 完全には最適化されていない | 対応 | 対応 |
| StyleとSpeedのスライダー | あり | なし | なし |
| SSML | なし | なし | なし |
| アリーナのElo(Artificial Analysis) | 1174 | 1321 | 1334 |
表のセルには収まりきらない点がいくつかあります。
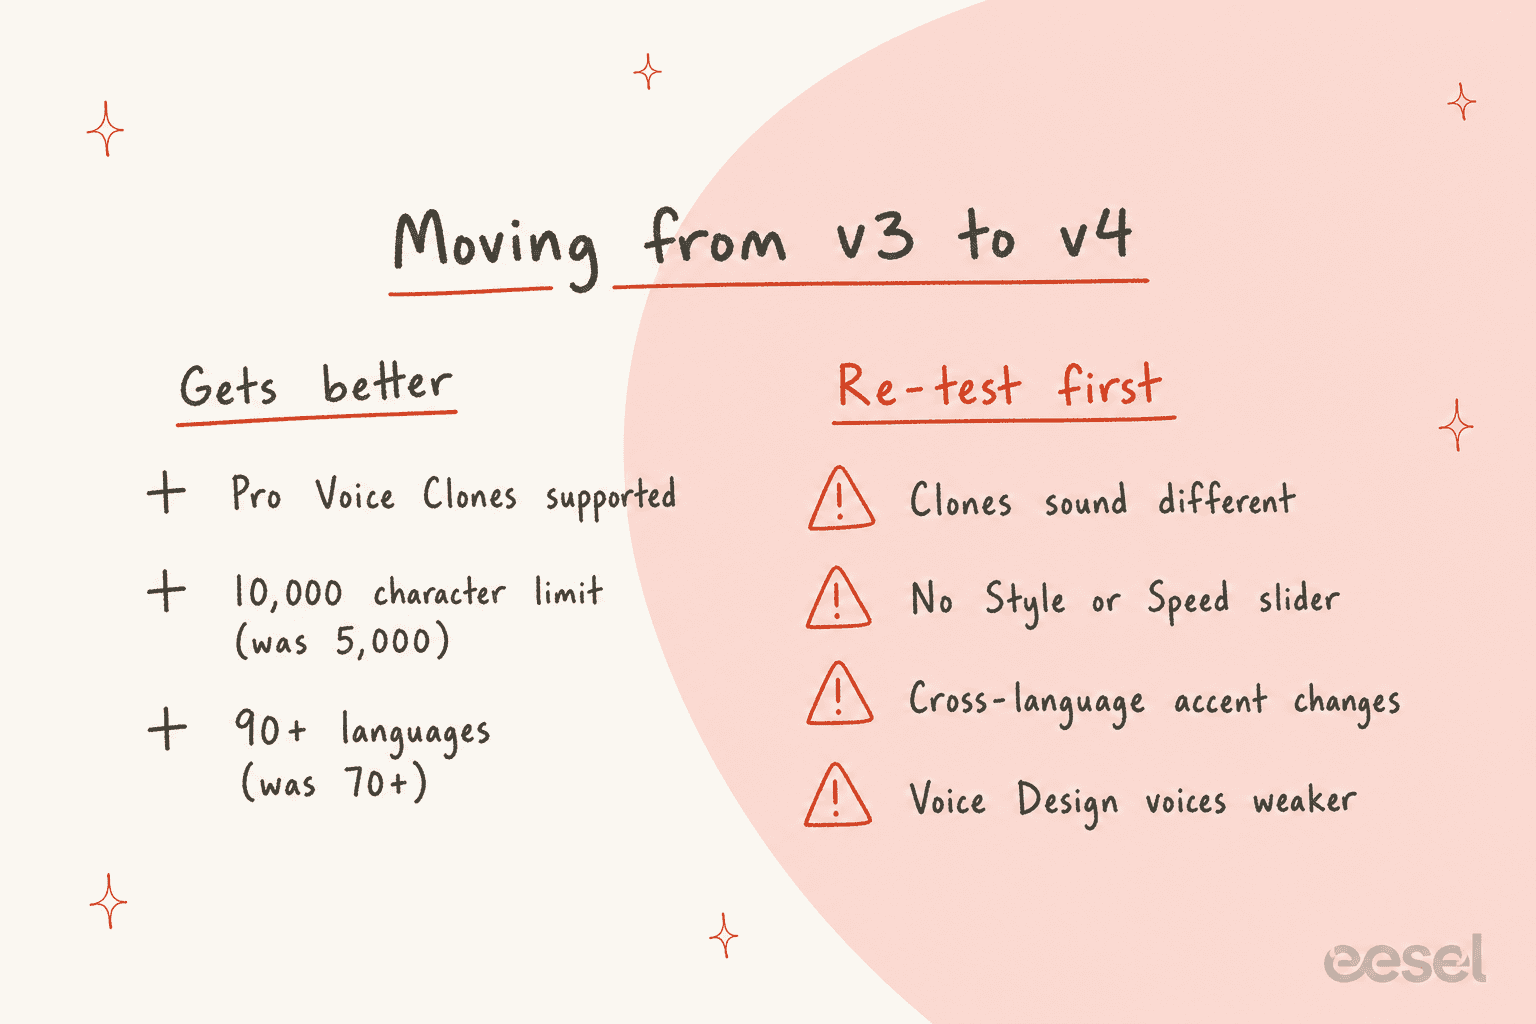
Professional Voice Cloneが復活しました。 v3のベストプラクティスのページによると、PVCはv3向けには完全に最適化されていなかったため、高価なプロフェッショナルクローンを持つチームは古いモデルにとどまることが多くありました。ベストプラクティスガイドは、これらの声をv4に向けるよう案内しています。ただし注意点があります。ドキュメントによれば、PVCのサポートは「is currently rolling out to everyone」とのことで、一部のアカウントはまだ待っている可能性があります。
インスタントクローンに必要な音声が減りました。 ローンチ記事は、Instant Voice Cloneが「just 10 seconds of audio」で声を取り込めるとしていますが、しっかりした結果を求めるならドキュメントは今も1〜2分を推奨しています。
長尺が安定しました。 ElevenLabsは、リクエストスティッチング(複数の生成をつないで長い一つの作品にすること)が「significantly more reliable」だとしています。Studioで作業するオーディオブック制作者がいちばん実感するでしょう。
スライダーは2つだけ残ります。 StabilityとSimilarityはv4でも残ります。StyleとSpeedはなくなったため、演出は台本そのものの中、つまり[whispers]や[sighs]のようなオーディオタグで行います。
なぜ大半の人にTurboをおすすめするのか
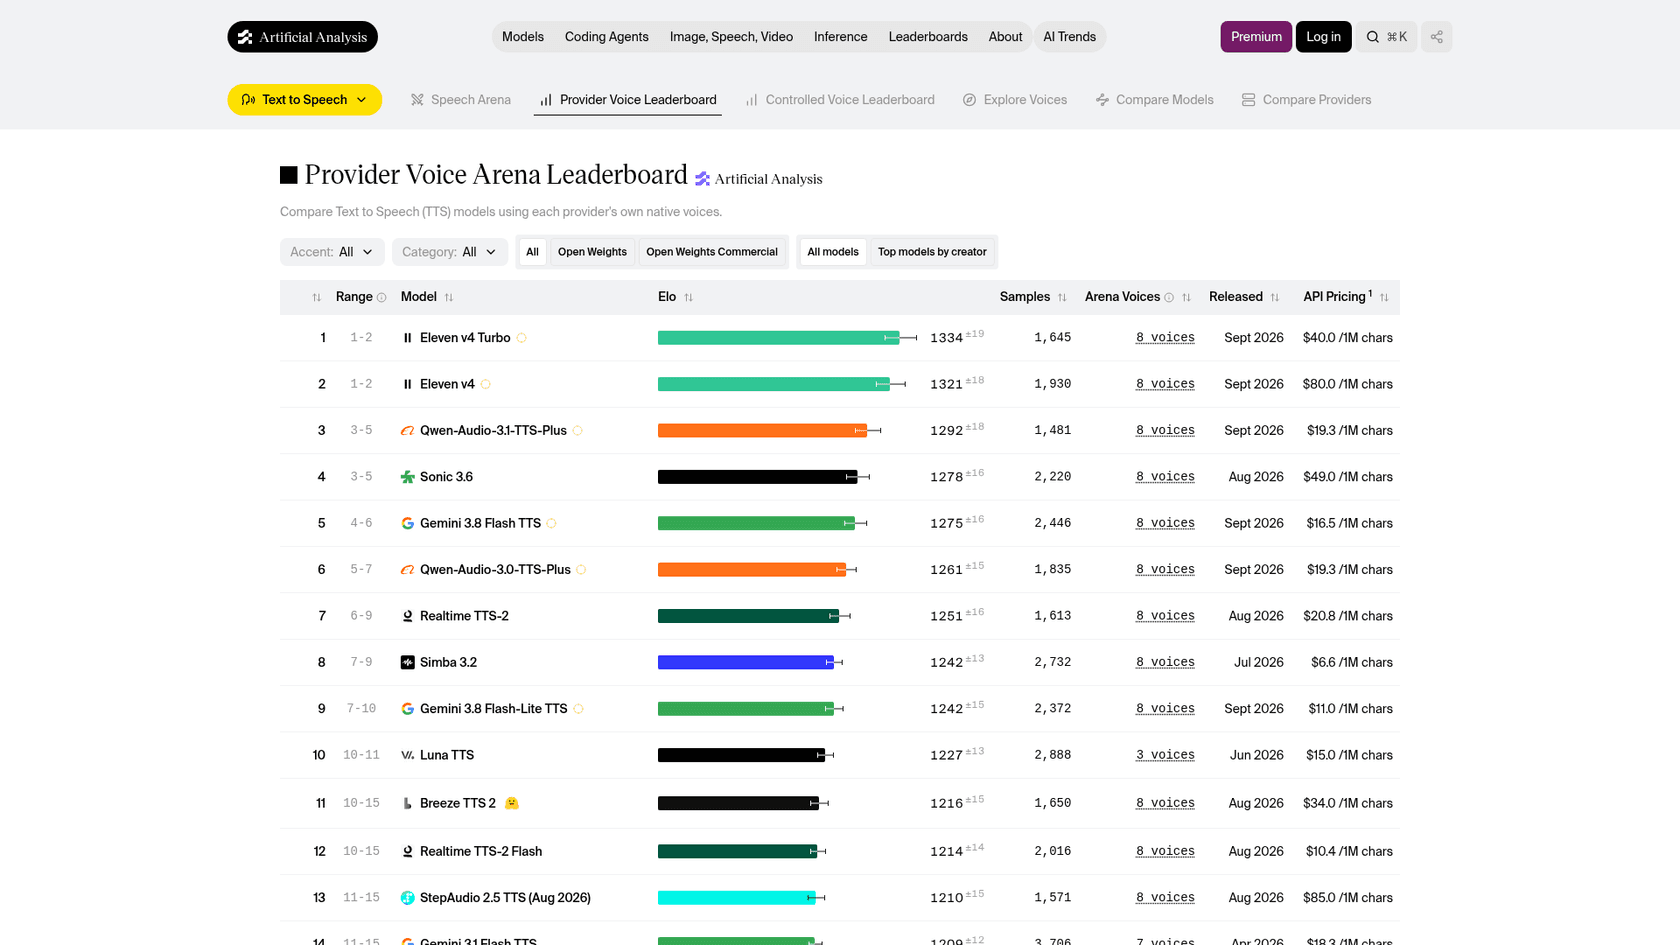
ここは私にとって意外でした。「品質」モデルのほうが「高速」モデルより品質で勝つと思うでしょう。しかし、聴取者がどのモデルが作ったかを知らずに2つのクリップから自然なほうを選ぶArtificial Analysis Provider Voice Arenaでは、逆の結果になっています。
- Eleven v4 Turbo: 1,645票で1334 Elo、100万文字あたり$40。
- Eleven v4: 1,930票で1321 Elo、100万文字あたり$80。
- Qwen-Audio-3.1-TTS-Plus: 1292 Elo、100万文字あたり$19.30。
- Cartesia Sonic 3.6: 1278 Elo、100万文字あたり$49。
- Gemini 3.8 Flash TTS: 1275 Elo、100万文字あたり$16.50。
2つのv4モデルは信頼区間内で重なっており(どちらも「1-2」のランク帯にいます)、公平に読むなら、Turboは短いクリップの自然さでフルモデルに並び、価格は半分ということです。フルモデルが価格に見合うのは、アリーナでは測れない部分、たとえば10,000文字の上限や、長い台本全体でシーンの文脈を保つ点です。章全体をぶれずにつなぎ合わせることもそうです。
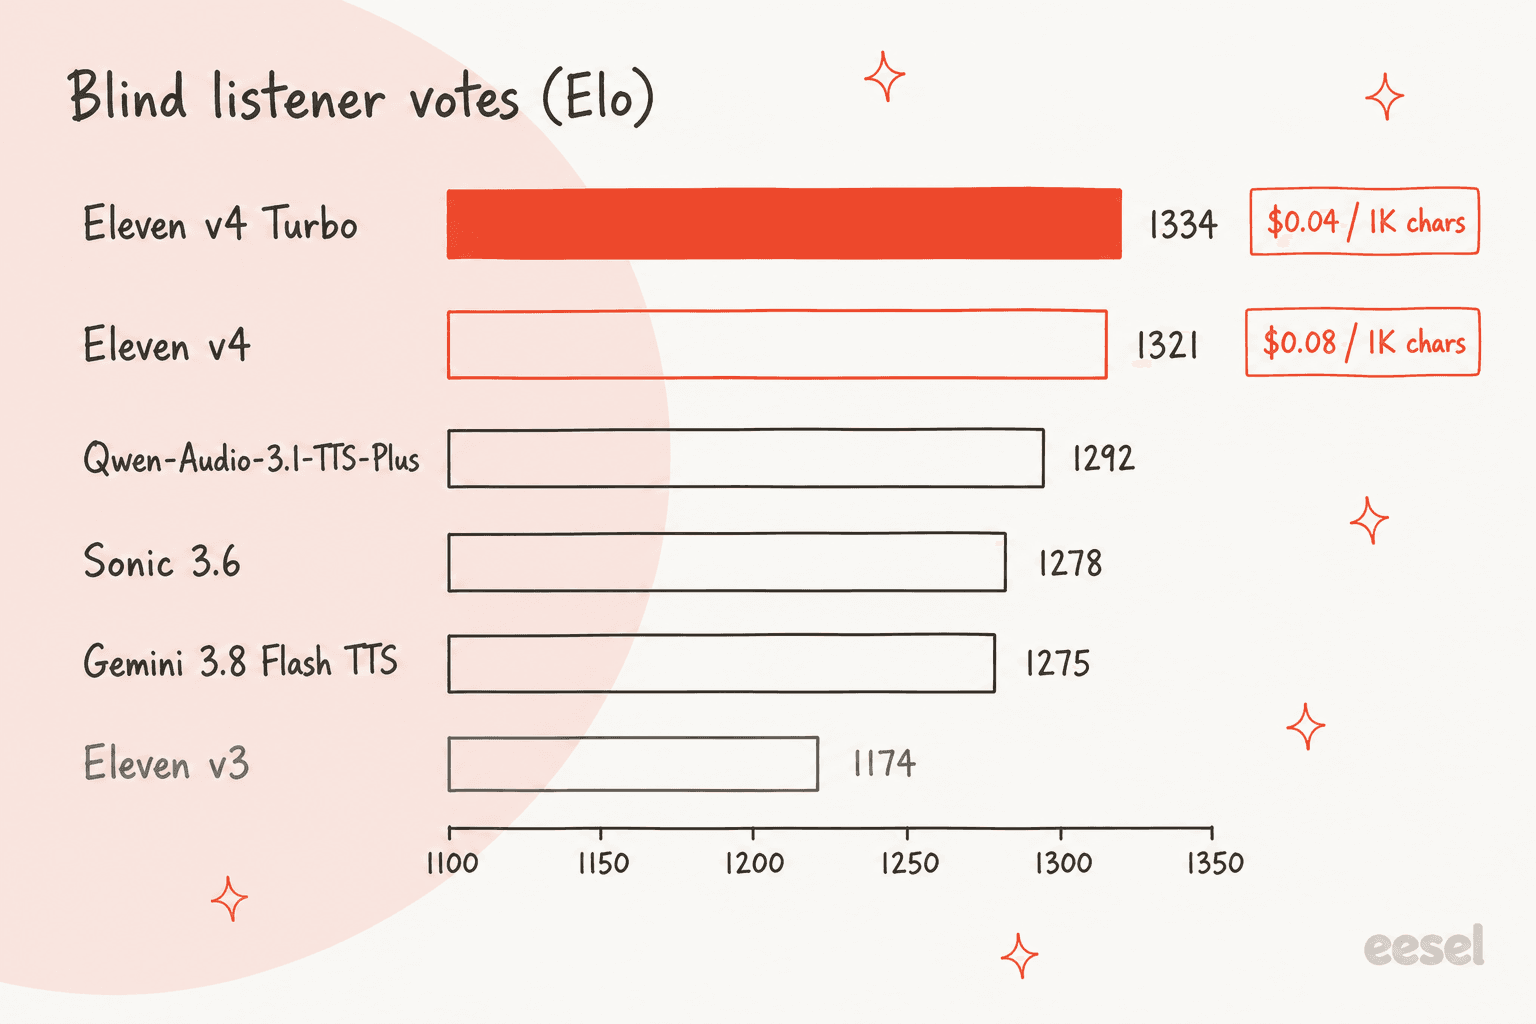
v3との差も確かで、マーケティング上の丸めではありません。v3は同じボードで1174、v4より147ポイント低く、Eloスケールでは聴取者がたいていv4を好むことを意味します。ElevenLabs自身のテストでは、ローンチ記事の脚注によると、Cartesia Sonic 3.6、Inworld TTS-2、2つのGemini 3.8 TTSモデルと比べて、v4が聴取者の約75%に選ばれたとされています。これはベンダー側の主張として扱い、独立した検証としてはアリーナの数値を頼りにするのがよいでしょう。
私の経験則は、基本はTurbo、1回のリクエストで数分間の連続ナレーションを担う必要があるときだけフルモデル、です。
ベンダーを比較中ですか?Cartesia Sonic 3 vs ElevenLabsとGemini 3.8 Flash TTSレビューで、そのボードの次の2つを取り上げています。
Gemini 3.8 Flash TTSの料金の記事は、Googleがなぜ他社よりコストを抑えられるのかを説明しています。より幅広い候補リストはElevenLabsの代替にあります。
あなたのプロジェクトに合うElevenモデルは?
作りたいものを選んでください。価格は1,000文字あたりのAPI定価です。
ネイティブアクセントの扱いは多言語の声をどう変えるか
ドキュメントは、これをv4の最大の変更点の一つとして挙げています。既存の顧客がいちばん不意を突かれやすい点でもあります。
v3でクローンした声は、他の言語にもそのアクセントを持ち込みました。v4はこれを2つのケースに分けます。出力言語が声自身の言語と一致する場合はアクセントが保たれ、一致しない場合は、v4がターゲット言語のネイティブアクセントで流暢な音声を生成します。ドキュメントの例はこうです。韓国語話者をクローンして英語を生成すると、自然な英語になります。韓国語訛りの英語にはなりません。
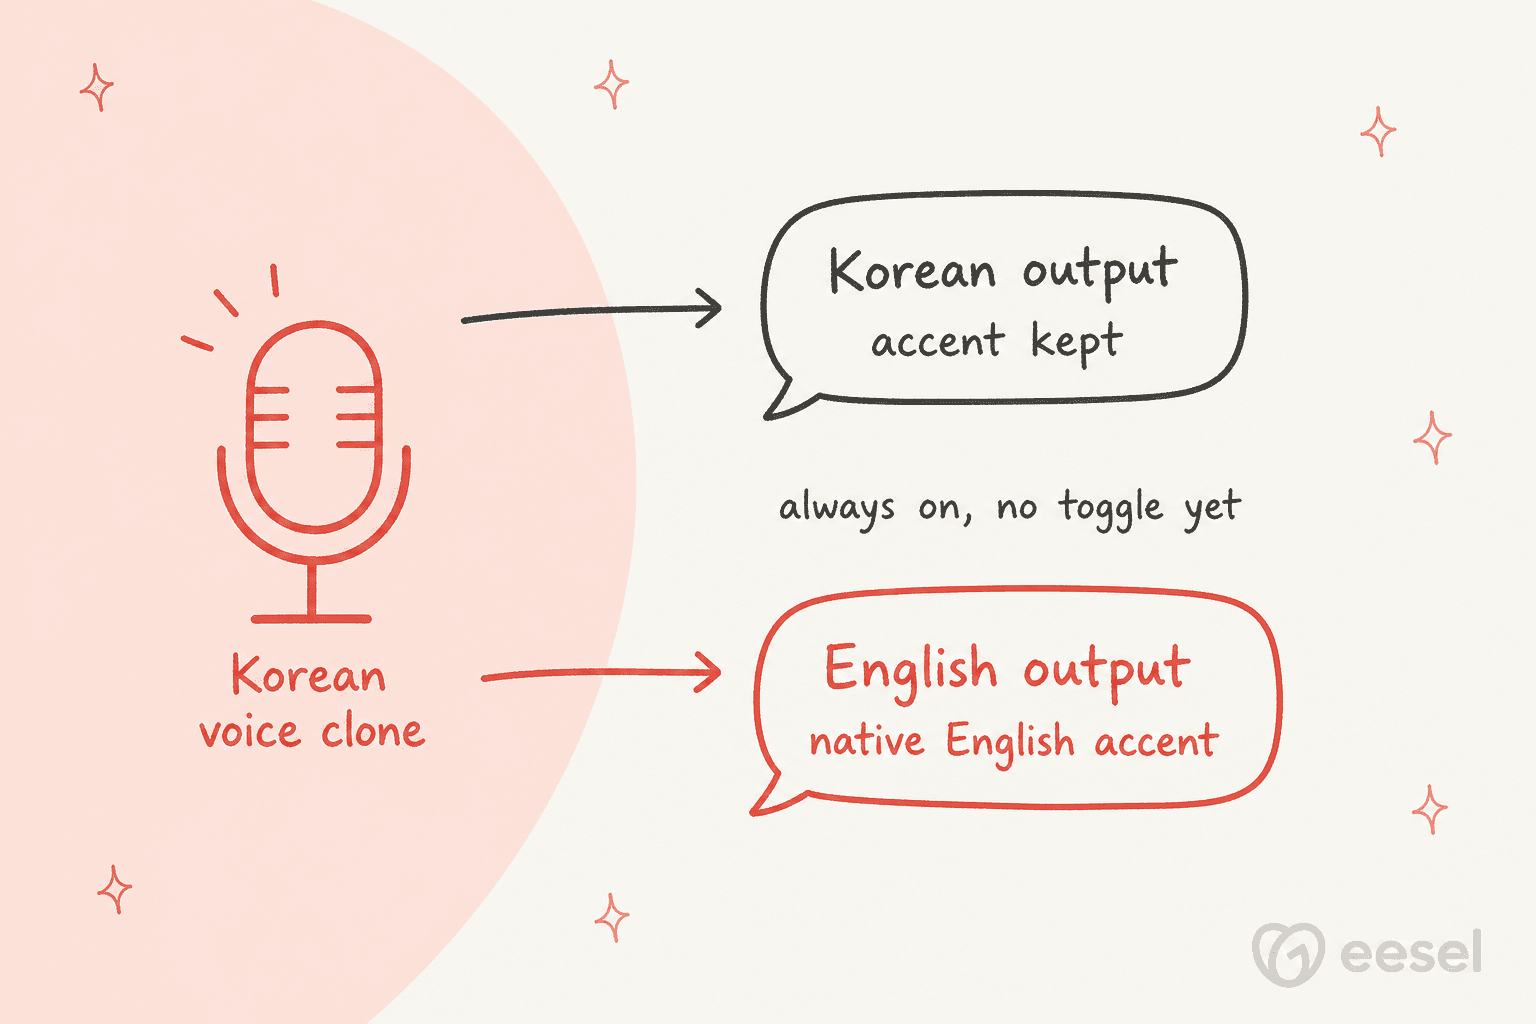
吹き替えや、複数言語で通話に対応するエージェントにとっては大きな改善です。一つのブランドボイスがどこでも現地の声に聞こえるからです。ただし、アクセントそのものがあなたの声の個性なら、後退です。ElevenLabsは、切り替えオプションは「still a research project」で、時期は未定だと明言しています。
初期ユーザー全員が説明どおりに動くと感じているわけではありません。公式サブレディットのスレッドでは、あるコメント者が逆の問題に遭遇しました。
"In English it's good but the American accent bleeds terribly into other languages."

別の人は、アクセントの制御を1行ごとではなく声のレベルで設定したいと述べていました。長いシリーズを制作する人にとっては、もっともな要望です。
"I want accent/dialects to be encoded at the voice level, not have to prompt for it in every single line. It is really impossible to keep a stable idiolect that way and generic [Scottish] or whatever can still come out a million ways."
実務的には、ボイスエージェントで多言語カスタマーサポートを運用しているなら、切り替える前に主要な各言語でテスト台本を生成してみてください。AgentsでのTurboに関する記事によると、最も大きな改善は日本語、ブラジルポルトガル語、中国語(普通話)、広東語でした。最初に試すのに向いています。
クローンした声は同じように聞こえる?
おそらく同じではありません。ElevenLabsもそう認めています。v4は元の声をより正確に再現するため(音色、リズム、音量、さらには録音の欠点まで)、v4のFAQによると、v4のクローンは「may sound quite different from its Eleven v3 version」とのことです。ドキュメントには、音声担当者全員に二度読んでほしい一文もあります。正確さと個人の好みは、必ずしも同じではありません。
これには2つの波及効果があります。
- 学習用音声がこれまで以上に重要になります。 v4は破裂音ときつい歯擦音、そして音量の跳ねまで忠実にコピーします。ドキュメントページのデモクリップは、これを示すためにあえて加工されていません。クローンの元がノイズの多い録音なら、モデルのせいにする前に録り直してください。
- ライブラリの声が知らないうちに変わることがあります。 ElevenReader(聴取アプリ)のユーザーは、本の途中で声が変わったことに気づきました。気に入った人もいれば、そうでない人もいました。
"In ElevenReader it genuinely blew me away. I didn't even know the update was coming, but suddenly my narrator sounded like an actual real human was reading my book to me."
特定の抑えた語り口に声を調整していたクリエイターは、逆に感じました。
"I'm actually having big issues with v4 its super expressive but for my niche its too damn theatrical and you cannot make certain voices be straight/monotone while speaking..."
Voice Design(テキストの説明から生成した声)には、目立たない但し書きもあります。ドキュメントによると、v4でも使えますが「may not be as performative or sound as good as with earlier models」とのことです。
v4ではオーディオタグとプロンプトはどう機能する?
StyleとSpeedのスライダーがなくなったため、演出は台本から出す必要があります。[whispers]、[sighs]、[laughs harder]のようなタグや、[door slams]、[light rain]のような効果音の合図を文中に書きます。v4のランディングページによると、v4はそれらに「more reliably than v3」従います。ElevenLabsには50以上の例を載せたオーディオタグ一覧もあります。
プロンプトガイドから、再生成を1〜2回減らせるかもしれないメモをいくつか紹介します。
- SSMLは使えません。 v4もv3も、SSMLのbreakタグに対応していません。古い音声APIから移る場合は変更点です。代わりに三点リーダーや改行、あるいは
[short pause]や[long pause]のようなタグを使います。 - タグが効果音と解釈されることがあります。 v4は声だけでなく効果音も生成するため、曖昧なタグは物音として出力されることがあります。ドキュメントは、
[low, gravelly voice]のようにもっと具体的な表現を勧めています。 - タグは声の守備範囲内で最もよく効きます。 学習データで一度もささやいたことのない声でも
[whispering]に従えますが、「the result may not be optimal」です。 - IPAによる発音指定がネイティブ対応になりました。 IPA記号をテキスト中でスラッシュで囲むだけで、XMLの音素タグは不要です。サポート用ボイスエージェントが正確に発音すべき薬品名、製品名、地名に便利です。
私が見かけた不満の中では、Speedスライダーがないことが最も多く挙がっていました。あるクリエイターは、同じRedditスレッドで、v4は「does seem to be speaking much faster (there isn't a slider in the voice settings to control that)」と書き、サブレディットのモデレーターがフィードバックとして伝えました。それが変わるまでは、ペース配分は書き方で対応します。文を短くし、ポーズタグを明示しましょう。
Eleven v4の料金は?
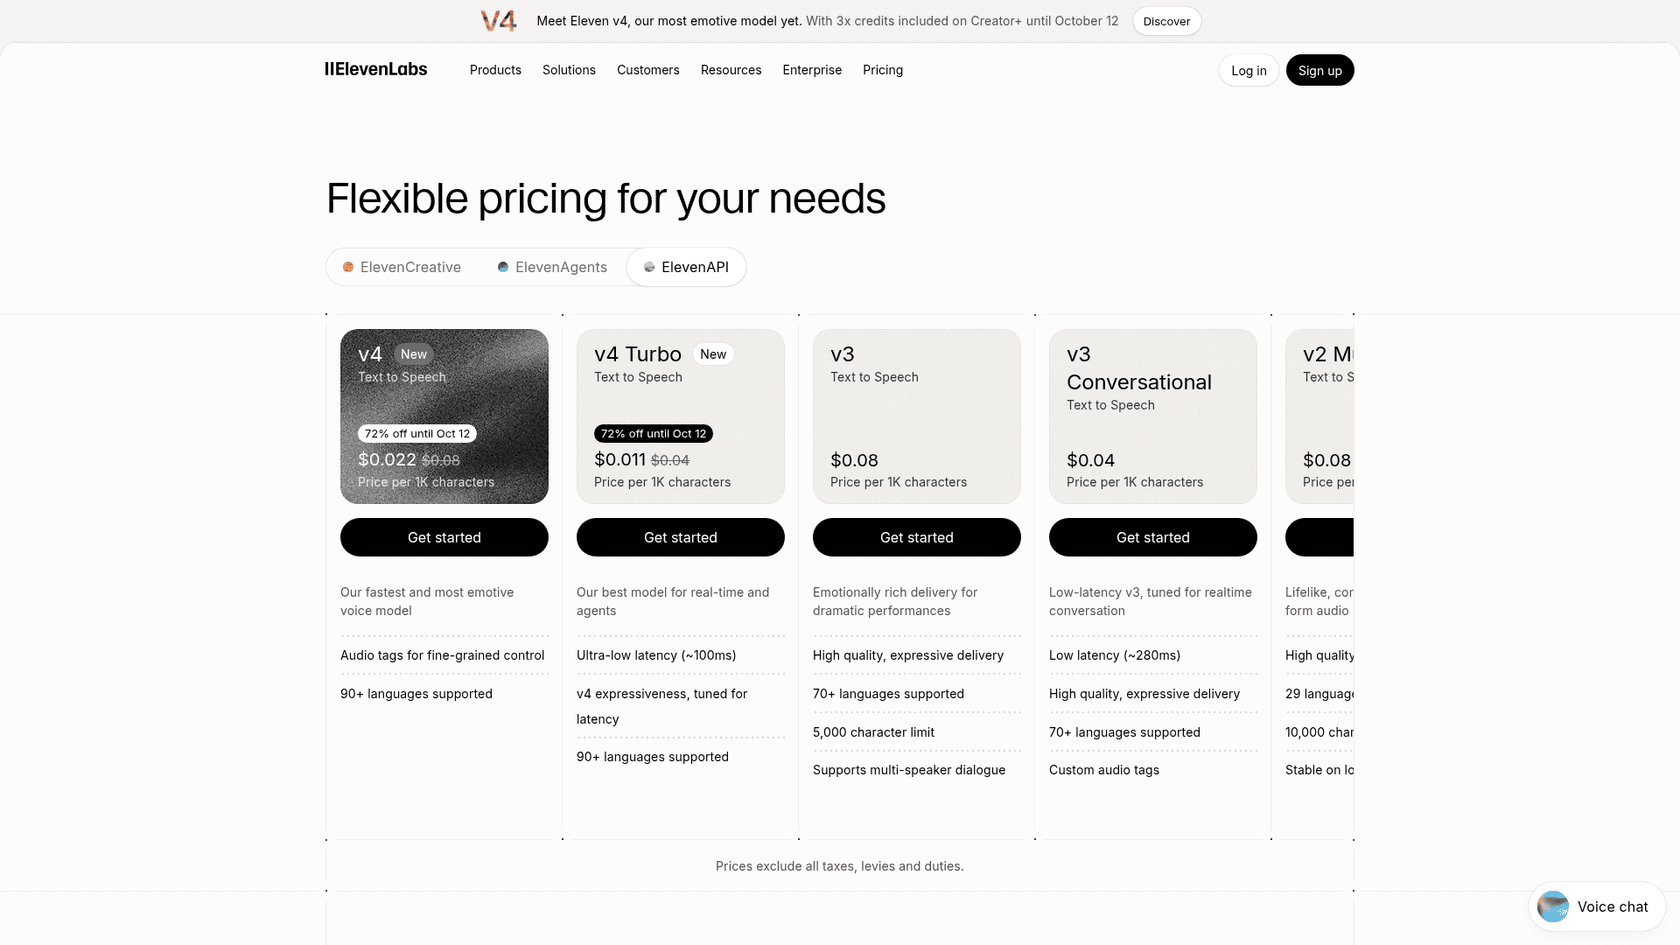
APIの定価では、Eleven v4はv3と同額で、Turboはv3 Conversationalと同額です。API料金ページによると、現在は2026年10月12日までの72%発売記念割引もあります。
| モデル | 1,000文字あたりの定価 | 発売記念価格(10月12日まで) | レイテンシ | 文字数上限 |
|---|---|---|---|---|
| Eleven v4 | $0.08 | $0.022 | リアルタイムではない | 10,000 |
| Eleven v4 Turbo | $0.04 | $0.011 | 約100ms | ストリーミング |
| Eleven v3 | $0.08 | n/a | リアルタイムではない | 5,000 |
| Eleven v3 Conversational | $0.04 | n/a | 約280ms | ストリーミング |
| Flash v2.5 | $0.04 | n/a | 約75ms | 40,000 |
Webアプリでは、v4はほかの機能と同じ月間クレジットプールから消費されます。ElevenCreativeの料金ページの現行プランは、Free($0、10,000クレジット)、Starter($6、30,000)、Creator($22、121,000)、Pro($99、600,000)、Scale($299、180万)、Business($990、600万)です。料金FAQでは、Text to Speechはおおよそ1文字につき1クレジットとされています。Creatorプラン以上には発売記念プロモーションもあり、WebとモバイルアプリでのEleven v4の利用は、月間TTSクレジットの最大2倍まで残高に影響しません。ただ、そのページのバナーとプロモーションの節で2倍か3倍かが食い違っているので、計画を立てる前にご自身の残高を確認することをおすすめします。ElevenLabsの料金ガイドで全プランを解説しており、ElevenLabsのレビューでは有料ユーザーがクレジット制度についてどう言っているかを紹介しています。
計算例。 Redditのユーザーが、8時間のオーディオブックにいくらかかるか尋ねていたので、計算してみます。ドキュメントでは10,000文字が約10分の音声とされており、8時間はおよそ480,000文字になります。
- APIの定価でEleven v4: 480 × $0.08 = $38.40
- 発売記念価格でEleven v4: 480 × $0.022 = $10.56
- 定価でEleven v4 Turbo: 480 × $0.04 = $19.20
- アプリの場合: 約480,000クレジット。月額$99のProプランの600,000に収まります。
ボイスエージェントは文字単位では課金されません。ElevenAgentsの料金は通話分数単位で、Free(15分)からBusiness(12,375分で$990)までのプランがあり、追加分は1分あたり$0.08、LLMは別料金です。同じ計算をおすすめのAIボイスエージェントのまとめでも解説しました。
Eleven v4 Turboをサポート窓口に導入すべき?

ElevenLabsはTurboをカスタマーサービス向けに据えています。ElevenAgentsのローンチ記事は、配送遅延には「apologetic about a missed delivery, brisk when someone just wants a confirmation」と話すエージェントについて語っており、v4のページではSalesforceのAgentforce Voiceチームが、Turboの「faster, more natural responses」を称賛するコメントが引用されています。
今月は競合も多い時期です。OpenAIのGPT-Live-1、xAIのGrok Voice Think Fast 2、Decagon Voice 3は、いずれも同じサポート電話を狙っています。
Salesforceにも独自のAIボイスエージェントがあります。電話をかける側にとっては確かな改善です。返金ポリシーを棒読みする単調なボットは、人が0を連打して人間につなごうとする理由の一つだからです。ただし、TTSのリリースで直せないのは回答そのものです。声はエージェントが作ったものを読み上げるだけで、返金期限を誤ったまま申し訳なさそうに美しく伝える声も、間違いは間違いです。むしろ説得力が増してしまいます。
実際のサポートキューでAIを長年見てきて、同じ教訓にたどり着きます。正確さは、エージェントが何を知っているか(ヘルプセンター、マクロ、過去のチケット)と、顧客より先にテストすることから生まれます。だからeeselの導入は必ず、先に過去のチケットでシミュレーションします。ボイスプラットフォームを比較検討中なら、AIコールセンターエージェント、Retell AI、Vapiのガイドで、各社のナレッジと引き継ぎの扱い、ヘルプデスク連携を比較しています。
ボイスサポートのまとめでは、すべてを並べて比較しています。
また、サポート全体に占める音声の割合は、体感より小さいものです。多くのチームでは、依然として量の大半がチケットとチャットで、回答品質の問題はまずそこに現れます。すでにZendeskを使っているなら、そのボイスAIエージェントと、チケットキュー向けのAIカスタマーサポートレイヤーで同じナレッジを共有できます。
声の裏側にある回答をeeselで試す
eeselはAIチームメイトのプラットフォームで、AIヘルプデスクチームメイトはまさにこの課題のために作られています。既存のZendesk、Freshdesk、Gorgiasのキューに参加し、過去のチケットとヘルプセンターから学び、チームのトーンで返信を下書きまたは送信します。実際の顧客に触れる前に、過去のチケットでシミュレーションを走らせ、何と答えていたかを確認できます。
範囲について正直に言うと、eeselは現時点ではテキスト中心で、チケットとチャットを扱い、電話の音声は扱いません。eeselを使っているあるサポートチームは、音声録音のサポートがあれば「would significantly increase our usage」と話してくれました。そのため、検討項目に入っています。ボイスプラットフォームをEleven v4 Turboと組み合わせるなら、eeselが同じナレッジのチケット側を担います。eesel CLI(詳しくはこのAIエージェントCLIのガイドを参照)を使えば、スクリプトやClaude Codeのようなコーディングエージェントがターミナルからナレッジを更新し、回答をテストできるので、両方のチャネルを同期できます。プランは料金ページの100クレジット付き無料プランから始まり、処理したチケットまたはチャット1件につき1クレジットです。
eeselを試して、先月のチケットをどう扱うか確認してから、何を決めるかを考えましょう。
よくある質問
Eleven v4とは何ですか?
eleven_v4とリアルタイム用途向けのeleven_v4_turboの2種類があり、90以上の言語に対応し、v3にはなかったProfessional Voice Cloneのサポートが戻ってきました。