Gemini 3.8 Flash TTSとは実際何なのか
まず、地味だが重要な事実から。オンラインの混乱の多くは、モデルIDの取り違えによるものだからです。
Gemini 3.8 Flash TTSはテキスト読み上げモデルです。テキストが入力され、音声が出力される、それだけです。プレビューではなく安定版としてgemini-3.8-flash-ttsというIDでリリースされ、Googleは旧モデルgemini-3.1-flash-tts-previewの推奨後継として位置づけています。より安価な姉妹モデルgemini-3.8-flash-lite-ttsもあり、これについては後述します。
Google自身の音声生成ドキュメントから、押さえておくべき仕様をいくつか挙げます。
- Flash TTSは130言語に対応し、入力言語は自動検出されます。
- 1リクエストあたり入力8,192トークン、出力16,384トークンで、1回の呼び出しで小説全体を扱うのではなく、発言や段落単位向けに作られています。
- デフォルト出力は24kHzモノラルWAVで、電話音声向けにmulawとalawのオプションもあります。
- 音声は秒あたり25トークンで課金され、これが料金計算を成立させる重要な詳細です。
関数呼び出し、構造化出力、思考(thinking)、検索グラウンディング、Live APIには対応していません。これはレンダリングエンジンであり、エージェントではありません。この位置づけは後で重要になるので覚えておいてください。
実際の音質はどれほどか
これは音声モデルにとって唯一重要な問いであり、マーケティングと現実が少し乖離している部分でもあります。
Googleの主張は強力です。 発表記事では、Hume AIのVoice Design Benchmarkで1位(71.4)、FlashとFlash-LiteについてHumeのOverall Quality Indexで1位と2位を主張しています。これらは実際の数値です。ただし、事前に把握しておきたい留意点が一つあります。Humeの創業者がGoogle自身の発表の著者としてクレジットされており、ベンダーとベンチマークの著者が完全に独立しているわけではないという点です。これがスコアを誤りにするわけではありませんが、私はその分、やや割り引いて評価しています。
独立した評価のほうが参考になります。Artificial Analysisによると、Gemini 3.8 Flash TTSはPronunciation Robustnessで89.5%となり1位を獲得しました(3.1 Flash TTSの88.2%からの上昇)。しかしブラインドのProvider Voice Arenaでは、Elo約1,263でSonic 3に次ぐ2位にとどまりました。公平にまとめると、単語を正しく発音する点では同クラス最高、実際に選びたいと思える声である点では2位ということです。
"GoogleはGemini 3.8 Flash TTSとGemini 3.8 Flash-Lite TTSをリリースしました。Gemini 3.8 Flash TTSは、当社のPronunciation Robustness Benchmarkで1位、Provider Voice Arena Leaderboardで2位としてデビューしています"
実際に試した開発者たちはもっと率直でした。Hacker Newsのローンチ当日のスレッドで最も鋭いコメントです。
"利用可能な音声はどれも私にはありきたりなGeminiの声に聞こえる。特別に興味深い、あるいは印象的だと言えるものは何もない。"

これはベンチマークの差と符合します。発音は解決済み、個性はそうではありません。あなたの仕事が明瞭で正確、かつニュートラルなナレーションであれば、非常に満足するでしょう。聞き手の記憶に残る声が必要なら、期待は控えめにしておいてください。
実際に何を制御できるのか
単純なニューラル音声ではなくGeminiを選ぶ理由は制御にあり、これが私が最も気に入った部分です。棚から音声を選ぶだけでなく、それを演出できるのです。
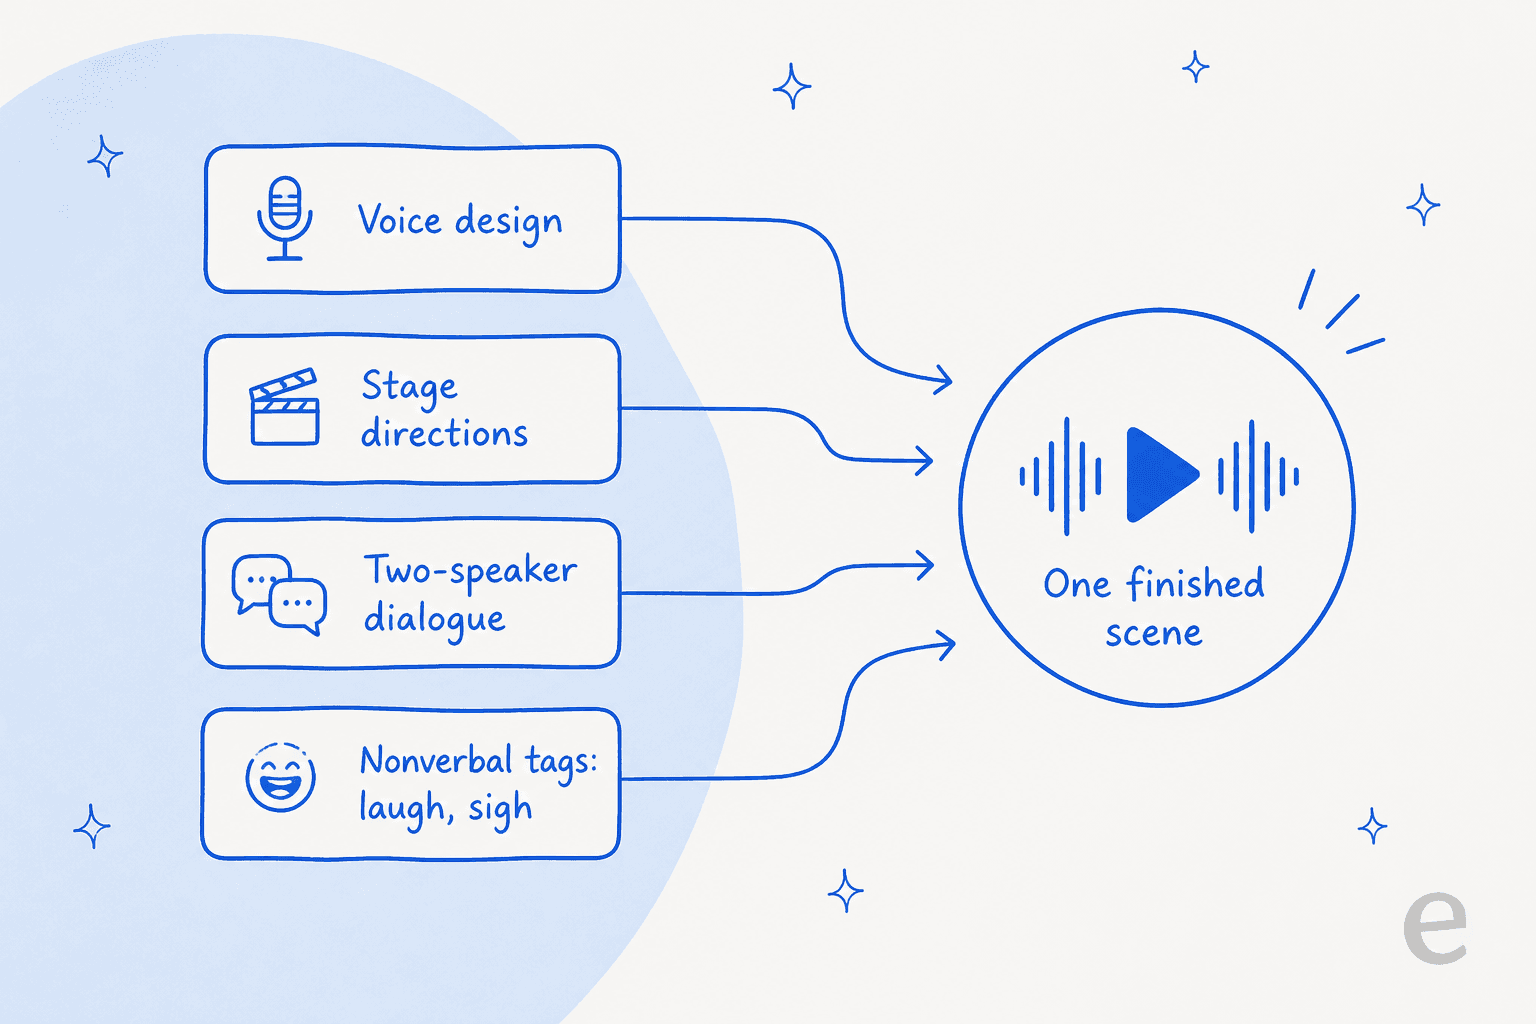
4つのレイヤーが組み合わさります。
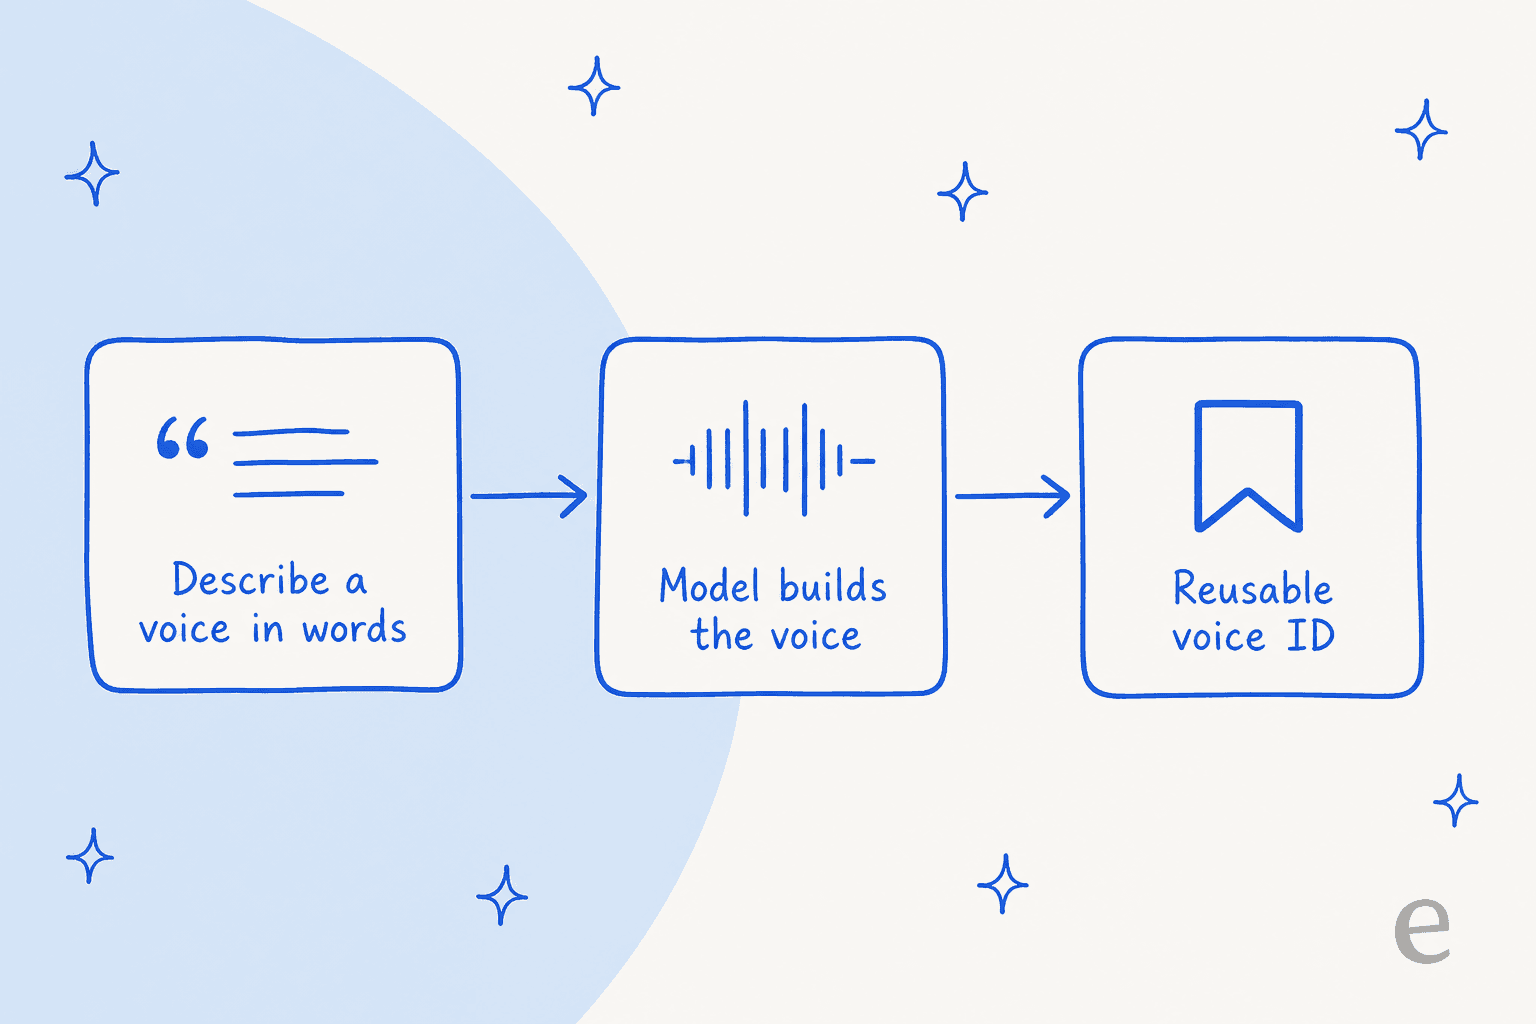
- 音声デザイン。 平易な言葉でペルソナを記述すると、モデルがその説明から音声を構築し、再利用可能なIDとして保存できます。
- 演出指示。
speech_metadataのようなフィールドで、発言ごとにトーン、アクセント、ペースを調整できます(「これは温かく、やや急いだ感じで読んで」など)。 - 2話者対話。 会話モードでは、1リクエストで最大2つのプリセット音声を扱えるため、ポッドキャスト風の短いクリップを手早く作れます。
- 非言語タグ。
<laugh>、<sigh>、<breath>、<short pause>のようなインラインマーカーで、声のイベントを狙った位置に正確に挿入できます。
音声デザインのフローが目玉機能で、本当によくできています。何も録音することなく、1文の説明から永続的で再利用可能な音声へと進めます。
正直な限界もあります。制御性は本物ですが、完全に信頼できるわけではありません。以前のGemini TTSのリリースでは、ある開発者が演出指示が完全に無視されることがあったと報告しています。
"音声プロファイルに何を書いても、AI Studioはシーンや文脈に関係なく一切従わなかった。例えば男性の声を得ようとしたが、女性の声ばかり返ってきた。"
Googleは3.8でクリエイティブな指示への対応が改善したと述べており、私の見る限りその通りですが、指示が一発で決まらない場合に備えて何度か再生成する予算を見込んでおいてください。それはプロンプトであって、保証ではありません。
音声複製(クローン)も導入されました。これは一時期Googleが慎重な姿勢を見せていた分野です。Simon Willisonは次のように表現しています。
"音声クローンは他社ですでに十分広く利用可能になっているので、Googleがもはや躊躇せずリリースしたのだと思う。"
Flash対Flash-Lite:どちらを使うべきか
2モデル構成は一度理解すればシンプルで、選び方を間違えるとコストか品質のどちらかが犠牲になるだけです。
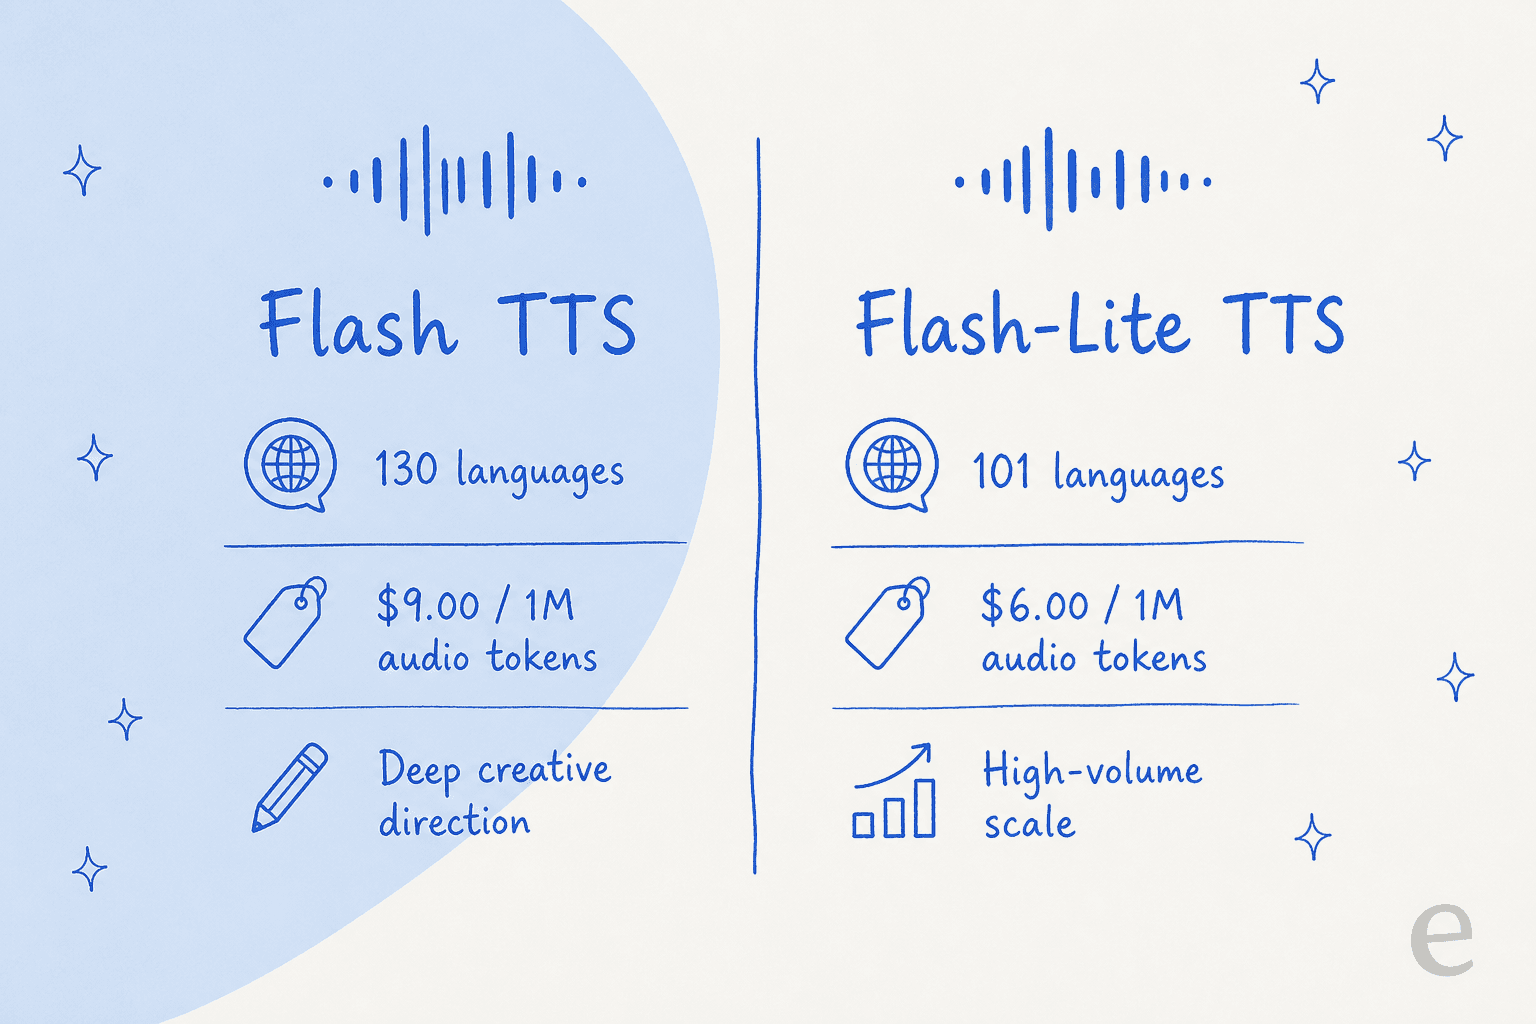
Flash TTSは表現力重視のモデルです。130言語に対応し、音声トークン100万あたり9.00ドルで、クリエイティブな演出ツール一式が揃っています。オーディオブック、ブランド広告、キャラクターボイスなど、音声そのものが製品となる場合に選んでください。
Flash-Lite TTSはワークホースです。101言語に対応し、音声トークン100万あたり6.00ドルで、「良くて安い」が「表現力豊か」より優先される大量レンダリング向けに調整されています。数千件のクリップを生成し、多少平坦な読み上げに誰も気づかないような場合に選んでください。
私の経験則は、まずFlashで試して品質の上限を確認し、大量にレンダリングするものはFlash-Liteに切り替えることです。どちらも合わない場合は、Geminiの代替案としてCartesiaのSonic 3やElevenLabsも試す価値があります。
価格の現実(そして2027年の落とし穴)
詳細な数値はGemini 3.8 Flash TTSの料金の記事にまとめていますが、このレビューに関係する部分は短くまとめられます。
標準ティアでは、Flash TTSは音声出力トークン100万あたり9.00ドルです。音声は秒あたり25トークンで課金されるため、1時間分の音声は約90,000トークンとなり、生成音声1時間あたり約0.81ドルになります。BatchとFlexはこれより50%安くなります。Google AI Studio経由での実質的な無料枠もあります。
計画しておくべき落とし穴は、これらは2026年12月31日までのプロモーション料金であり、2027年1月1日にほぼ倍になるという点です(Flashは音声トークン100万あたり18.00ドルになります)。2027年分のワークロードを予算計画するなら、ローンチ時の数値ではなく倍になった数値で計画してください。これはGeminiの料金全体に共通するパターンなので、Geminiを注視している人には驚きではないでしょう。
コスト面では、懐疑的な人々の間でもコミュニティの評価は明確でした。会話モードをテストしたSimon Willisonの言葉です。
"会話モードは素晴らしく、私の実験の大半は1セント未満で済んでいる。"
競合との比較
課金単位が異なるため、ベンダー間のTTS料金比較は厄介です。Amazon、Azure、Deepgramは文字数課金である一方、OpenAIとGoogleは音声トークン課金です。公平に比較するため、すべてを1時間あたりの音声料金(ドル)に正規化しました(Amazon自身の目安である「文字100万あたり音声約23時間」を基準としています)。話す速度によって計算が変わるため、これらは推定値として扱ってください。
| モデル | 表示価格 | 音声1時間あたり(概算) | 無料枠 |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 音声トークン100万あたり9.00ドル | 約0.81ドル | あり(AI Studio) |
| Gemini 3.8 Flash-Lite TTS | 音声トークン100万あたり6.00ドル | 約0.54ドル | あり(AI Studio) |
| Amazon Polly Neural | 文字100万あたり16ドル | 約0.70ドル | 文字100万/月(12か月) |
| Azure Neural / HD Flash | 文字100万あたり15ドル | 約0.65ドル | 文字0.5百万/月 |
| OpenAI gpt-4o-mini-tts | 音声トークン100万あたり12ドル | 約0.90ドル | なし(TTS) |
| Deepgram Aura-2 | 文字100万あたり30ドル | 約1.30ドル | 登録時200ドル分クレジット |
| ElevenLabs Business | "1分あたり最低5セント" | 約3.00ドル | 月1万クレジット |
要点はこうです。Gemini 3.8 Flash TTSはコモディティ的なニューラル音声と同水準の価格でありながら、表現力豊かな生成モデルのように振る舞うということです。コスト面ではAmazon Polly NeuralやAzureとほぼ同水準に位置し、OpenAIやDeepgramより安く、ElevenLabsの1時間あたり料金のごく一部で済みます。価格と表現力の比率を重視するなら、これがこのローンチ全体の見出しと言えます。
公平を期すために一つ補足すると、ElevenLabsの料金は、コスト表には現れない音声ライブラリと個性のレベルを買っているのであり、ElevenLabsのレビューが示す通り、チームがそれに対価を払い続けている理由もまさにそこにあります。
使うべきか:即断できるガイド
「場合による」という段落をもう一つ重ねる代わりに、用途別に私ならどう判断するかを示します。
物足りない点
公平を期すために、契約前に伝えておきたい実際の限界を挙げます。
- 音声に個性が足りない。 開発者から最も支持を集めた批判は、すべてが「ありきたりなGemini」に聞こえるというものでした。実用面では優秀ですが、ブランディングには弱いです。
- 演出指示が無視されることがある。 クリエイティブな制御はプロンプトであって契約ではないため、時折の失敗や再生成を見込んでおいてください。
- アリーナの頂点ではない。 発音では1位ですが、ブラインドでの人間の好みではSonic 3に次ぐ2位です。「最高の音声」が要件なら、これはまだ決着していません。
- コストは2027年に倍になる。 ローンチ価格はプロモーションです。2026年に見積もったワークロードは、1月には2倍のコストになります。
- ローカルモデルが追いついてきている。 複数の開発者が、コストやプライバシー要件でクラウドAPIを使えない場合に、Fish Audio、Higgs、Qwen3 TTSのようなオープンな選択肢が最終レンダリングに十分だと指摘しています。
これらのどれも決定的な欠陥ではありません。「すごい」と「とても良くてとても安い」の違いであり、私の評価はそこに落ち着きます。
みんなが本当に知りたい部分:サポート用の音声
音声モデルを探している多くの人は、実際には別の質問をしています。これを顧客の前に出していいのか? これは飛ばすべきではないセクションです。
TTSモデルはインフラです。テキストを音声に変換する、それが仕事のすべてです。返金ポリシーを知らず、あなたのカスタマーサービスソフトウェアを読むことはできず、今読み上げた文章が実際に正しいかどうかも分かりません。生の音声モデルをそのままサポート窓口に置くと、間違った答えを美しい声で自信たっぷりに読み上げることになり、これは単純なエラーメッセージよりも悪い結果です。これはほとんどのチームが求めているコスト削減とは正反対です。
私はeeselでまさにこの領域に取り組んでおり、考え方はシンプルです。モデルは声であり、チームメイトは従業員である。eeselはAIチームメイトのプラットフォームであり、ここで関係するチームメイトはAIヘルプデスクエージェントです。既存のヘルプデスクに接続し、過去のチケットとヘルプセンターから学習し、設定したルールに従い、実際の顧客に応答する前に実際のチケット履歴に対してシミュレーションされます。この最後の部分が重要です。自信ありげに聞こえるボットが静かに間違った答えを出すのを私たちは見てきましたし、だからこそすべての展開はまず過去のチケットでドライランされます。音声モデルにはこれに相当する安全網がありません。
ターミナルで作業する、あるいはこれをスクリプト化したい場合、eesel CLIはダッシュボードと同じチームメイトとワークスペースを操作します。人間はコマンドラインからチームメイトの指示内容を確認でき、スクリプトはワークフローを自動化でき、Claude Code、Codex、Cursorのようなコーディングエージェントはeeselをプログラム的に操作し、JSON結果を出力し、承認者が承認できる範囲の変更を提案できます。これは同じ製品のエージェントフレンドリーなインターフェースであり、別物ではありません。これは、Gemini TTSを自分で組み上げ、オーケストレーション全体、サポート指標、エスカレーションロジック、SLA管理をすべて自前で背負う場合との、本質的な違いです。
つまり、Gemini 3.8 Flash TTSは、安価で明瞭かつ制御可能な音声という、本当に得意な分野に使いましょう。顧客の問題を実際に解決する音声のためには、生のモデルではなく、その上にテストされたチームメイトが必要です。それが本当の目標なら、まず本格的なAIヘルプデスクチャットボットや、より広範なサポート自動化ツールから始め、何かをゼロから構築する前にカスタマーサービス向け最良のAIエージェントの選択肢を比較検討してください。
私の結論
Gemini 3.8 Flash TTSは、本当に破壊的な価格の非常に優れた音声モデルです。発音を極め、本物のクリエイティブな制御を提供し、音声デザインとクローンを備え、ElevenLabsの1時間あたり料金のごく一部で済みます。正直な留保点は、音声に際立った個性が足りないこと、ブラインド評価で1位ではなく2位であること、そして価格が2027年に倍になることです。
大規模に音声をレンダリングするほとんどの開発者にとって、これは新しい合理的なデフォルトです。ブランドを象徴する音声には、ElevenLabsとSonic 3が依然として選択肢に残ります。そして、顧客と話し、本当に問題を解決するAIを求めてここに来たのなら、音声は簡単な部分にすぎないことを覚えておいてください。時間を割く価値のあるAIカスタマーサービス企業は難しい部分を解決する企業であり、チケットを解決するAIヘルプデスクソフトウェアのほうが、回答を読み上げる声よりもはるかに重要です。

素敵な声だけでなく、サポートキュー向けのAIチームメイトが欲しいですか?eeselは数分でヘルプデスクに接続でき、あなた自身のチケットから学習し、本番稼働前に実際の履歴でシミュレーションできます。**eeselを試す**のは無料、あるいはデモを予約して自社データでの動作を確認してください。
よくある質問
Gemini 3.8 Flash TTSは良いモデルですか?
はい、ただし留意点があります。明瞭さと発音についてはスタジオ品質で、Artificial AnalysisのPronunciation Robustnessベンチマークで1位デビューを果たしました。しかしブラインドでの人間の好み評価では2位で、CartesiaのSonic 3に次ぐ結果でした。また複数の開発者がプリセット音声を「ありきたり」と評しています。優れたデフォルト選択ではありますが、完全な圧勝ではありません。
Gemini 3.8 Flash TTSの料金はいくらですか?
標準ティアでは、2026年12月31日まではテキスト入力トークン100万あたり0.50ドル、音声出力トークン100万あたり9.00ドルで、1時間分の音声で約0.81ドルになります。両方の料金は2027年1月1日に倍になります。詳細な料金体系はGemini 3.8 Flash TTSの料金の記事に、Geminiファミリー全体の料金はGemini 3の料金ガイドにまとめています。
Gemini 3.8 Flash TTS対ElevenLabs:どちらが優れていますか?
Geminiは料金面で大差をつけて勝っており、1時間あたりの音声でおよそ4〜5倍安価です。ElevenLabsは際立った個性のある音声とその音声ライブラリで依然優位に立っています。コストと規模が最優先ならGemini、際立った個性のある音声が最優先ならElevenLabsの代替案も検討する価値があります。
Gemini 3.8 Flash TTSとFlash-Lite TTSの違いは何ですか?
Flash TTSは130言語に対応し、音声トークン100万あたり9.00ドルで、表現力豊かで方向性を指定した音声向けに作られています。Flash-Lite TTSは101言語に対応し、音声トークン100万あたり6.00ドルで、大量生産かつコスト重視の用途向けに作られています。クリエイティブな制御が重要ならFlash、大規模にレンダリングするならFlash-Liteを選んでください。
Gemini 3.8 Flash TTSは音声をクローンできますか?
はい。言葉でペルソナを記述する音声デザインと、短い参照クリップと同意音声からクローンする音声複製の両方に対応しています。クローンした音声は、プロジェクトあたり200個・有効期間1年の再利用可能な音声IDとして保存するか、7日間有効なステートレスキーとして保存できます。
Gemini 3.8 Flash TTSは複数話者に対応していますか?
プリセット音声を使えば1リクエストあたり最大2話者に対応し、対話用の会話モードもあります。3話者以上の場合は各発言を個別に合成し、後で音声をつなぎ合わせる必要があります。
Gemini TTSのような音声モデルはカスタマーサポートに十分ですか?
いいえ。TTSモデルはテキストを音声に変換するだけで、ヘルプセンターを読んだり、ポリシーに従ったり、チケットを解決したりはしません。サポートには、その上に載せるAIチームメイトが必要です。たとえば、カスタマーサービスソフトウェアと連携し、実際のチケット履歴でまずテストされるAIヘルプデスクエージェントのようなものです。


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.