

スマートフォンでは、公開されている中でこれに勝るものはありません。物理Android端末で実行される400タスクのベンチマークMobileWorld-Realで92.2%。Seed 2.1 Pro、Gemini 3.1 Pro、GPT-5.6 Sol、Claude Opus 4.8を上回りました。これがAlibabaの新しい基盤GUIエージェント、Qwen-UI-Agentです。ただし、私が何度も立ち返ったのはその下にあるエンジニアリングです。画面クリックとBashコマンドを混在させる単一のアクション空間。モデルの1ターンで複数のことが起きるバッチ化されたアクション。そして100ステップを超える軌跡に対するオンライン強化学習。
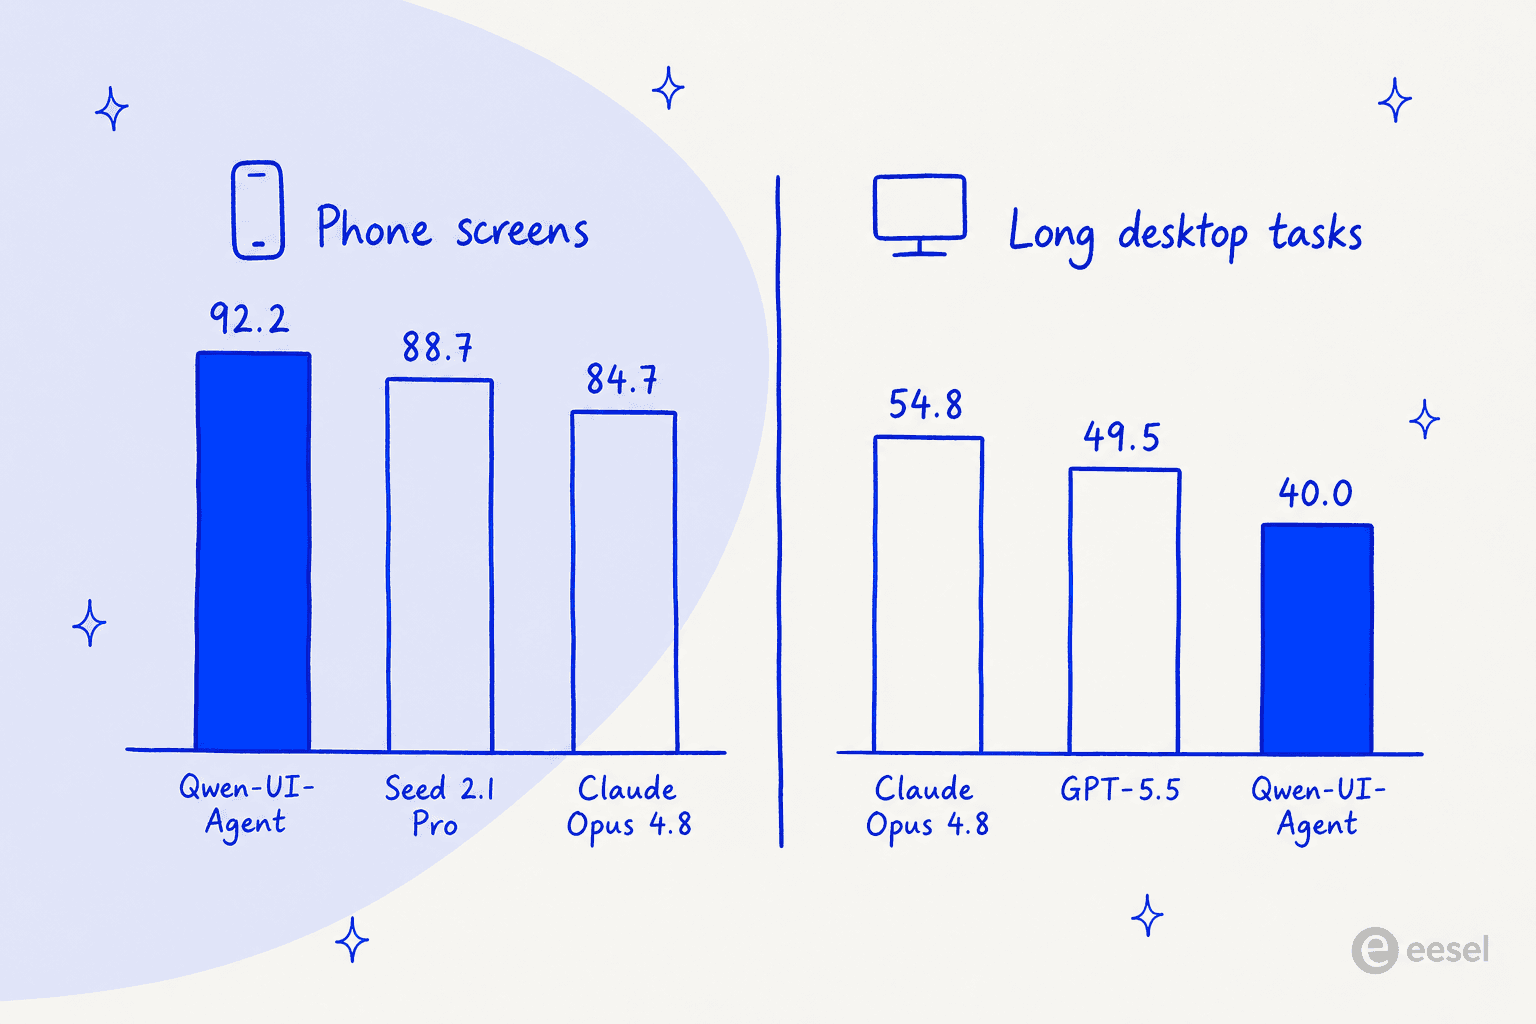
そして、誰も引用しないデスクトップの数値があります。長期ホライズンのコンピュータ利用セットであるOSWorld-v2では、Qwen-UI-Agentの部分進捗は40.0%で、Claude Opus 4.8の54.8%に及びません。つまり、スマートフォンのエージェントであり、デスクトップでは競争力がある、ということです。たまたまスマートフォンが得意な汎用の画面操作エージェントではありません。「最先端」という言葉を見て、あらゆる場面でそうだと思い込む前に、知っておく価値があります。
これがあなたに関係するかどうかを決めるのは次の点です。実行できません。Hugging Faceにウェイトはありません。ホスト型エンドポイントも料金もありません。私はeeselで、実際のサポートキュー内で動作するAIエージェントを作っており、3年以上ライブのチケットにエージェントを投入してきて心に残っている教訓は、スコアが示すのは上限であり、下限については何も語らないということです。エージェントがサポートリーダーの審査を通る決め手は、顧客に触れる前に、リーダー自身の履歴で証明することです。そのためeeselの導入はすべて、ローンチではなく過去チケットでのシミュレーションから始まります。
Qwen-UI-Agentとは実際に何か
Qwen-UI-Agentは、人間と同じように、画面を見てクリックすることでソフトウェアを操作する単一のモデルです。Alibabaの通義研究所内のMAI-UIチームから生まれ、2025年12月に8Bと2Bのチェックポイントを公開したMAI-UI 1.0の直接の後継です。まずAlibabaの全体像を知りたい方は、Qwenの概要とQwenのレビューでモデルファミリーを扱っています。
論文は2026年7月30日にarXivに公開され、ほぼ即座にHugging Faceでその日の1位の論文となり、現在は308件のアップボートを獲得しています。プロジェクトサイトは、「モバイル、デスクトップ、ウェブにわたって考え、検索し、行動する」1つのエージェントとして位置づけています。
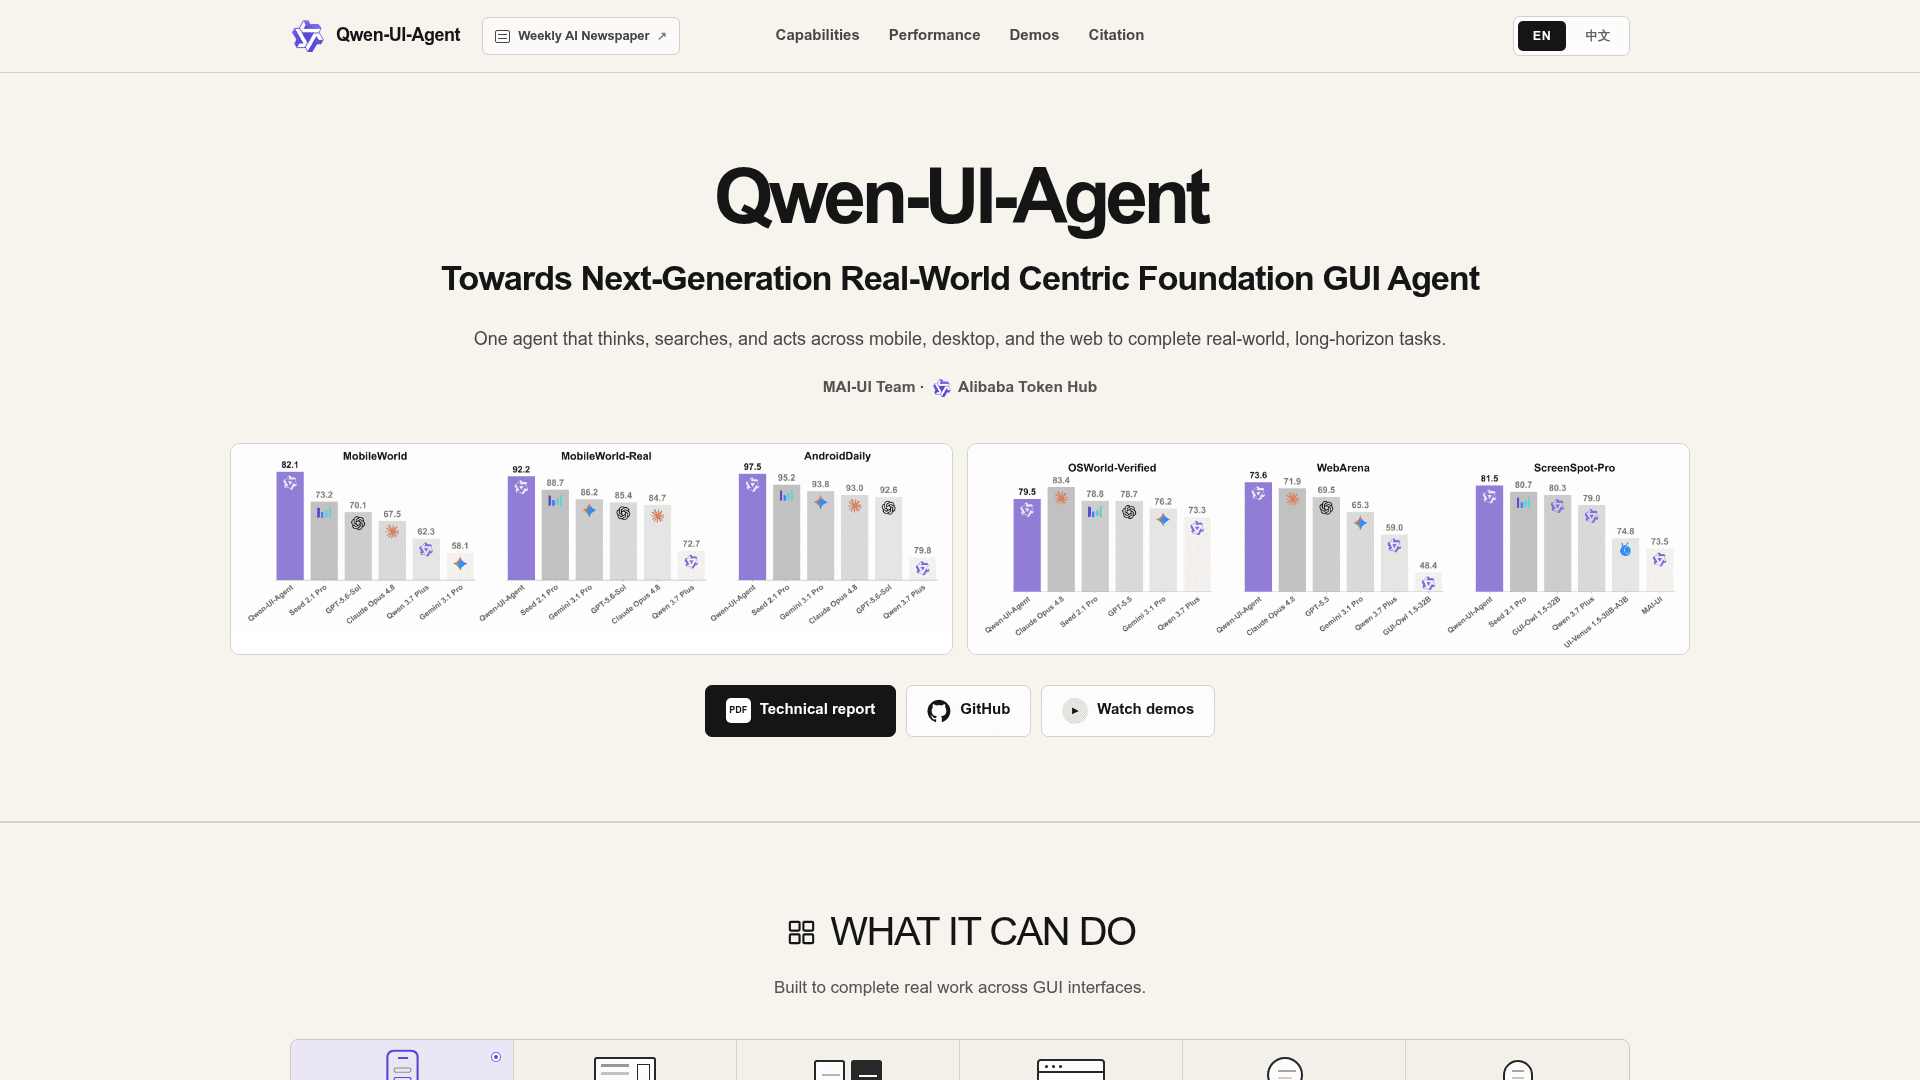
チャートの下にある3つのボタンに注目してください。技術レポート、GitHub、デモを見る。現時点での配布手段はこれがすべてで、この点には後ほど戻ります。
1つのモデルの中に4つのシナリオがあります。モバイルGUI利用とコンピュータ利用、ブラウザ利用、そしてAlibabaがDeepSearchと呼ぶものです。最後のものはディープリサーチの挙動で、後付けではありません。エージェントはアプリを離れ、オープンなウェブで何かを確認し、見つけた内容に基づいて行動するためにアプリへ戻ることができます。公開されているデモの1つでは、ソーシャル動画から主張を抜き出し、研究論文と照合し、戻って具体的な問題点を指摘するコメントを書きます。
カテゴリ自体が初めての方には、AIエージェントとエージェント対チャットボットの記事のほうが、論文よりも早く全体像をつかめます。寛容なライセンスの側については、オープンソースAIエージェントのまとめもあります。
内部の仕組み
エージェントを仕事として作っている人間として、ここが最も興味深い部分です。設計上の3つの選択は自明ではなく、3つとも同じ失敗モードを狙っているからです。
1つのアクション空間にGUIとCLI
ほとんどの画面エージェントはクリックしかできません。Qwen-UI-AgentはクリックまたはBashコマンドの実行ができ、単一の統一されたアクション空間の中でその2つを選びます。Alibaba自身のコンピュータ利用タスクの報告では、CLIコマンドとGUIクリックが2つの支配的なアクションタイプとして現れると述べており、これは、一部の作業は30回のクリックよりシェルコマンド1つのほうがはるかに安いとモデルが見抜いた、という上品な言い方です。
ブラウザエージェントが40個のファイルをドラッグでリネームしようとするのを見たことがある人なら、これがなぜ重要か、すぐに理解できるでしょう。
バッチ化されたアクション
1つのアクションを出し、スクリーンショットを待ち、また考える代わりに、モデルは1回の判断の中で複数のアクションを出します。Alibabaは、コンピュータ利用タスクでアクション出力の約40%がバッチ化されていると報告しています。
コストへの影響は現実的です。画面エージェントのターンごとに新しいスクリーンショットがコンテキストに入り、スクリーンショットは高価なトークンです。長いタスクでターン数を半分にすることは、成り立つワークフローと、静かに予算を食いつぶすワークフローの分かれ目であり、大規模なAIエージェントのコストの背後にある計算と同じです。
シミュレーターだけでなく、実際のスマートフォンで訓練
これが目玉の主張であり、できることなら最も厳しく検証したい点でもあります。Alibabaは、150以上のアプリをカバーする100台以上の物理スマートフォンからなるライブのモバイル環境を構築し、タスク構築、軌跡収集、訓練、評価に使ったと述べています。さらにその端末群の上に独自のベンチマークMobileWorld-Realを構築し、100以上のアプリで400以上のタスクを用意しました。
目的はシムからリアルへのギャップを埋めることで、設計はシミュレーターのスコアが誤解を招く根本原因に実際に取り組んでいます。実際のアプリには、読み込み中のスピナー、A/Bテストされたレイアウト、期限切れのセッション、サンドボックスでは再現されないネットワークの不安定さがあります。
訓練はその後、100ステップを超える軌跡に対して、約10,000の環境を同時にロールアウトしながらオンライン強化学習を行います。これを支えるのがAutoResearch型のデータフライホイールで、エージェントがタスク、環境、検証器を構築し、自らの失敗を診断して、次のイテレーションを計画します。
能動的な作業のためのハーネス
最後の要素は、プロンプトではなく現実世界のシグナルからエージェントが作業を開始できるようにする軽量なハーネス層です。Alibabaのデモはフライトのキャンセル通知です。エージェントはそれに気づき、ライブの旅行アプリを開き、ユーザーの14時の会議に合わせて航空券と電車を比較し、ランク付けした選択肢を持って戻ってきます。予約はしません。これは特筆に値します。判断材料を提示して、そこで止まります。
その抑制は正しい本能であり、サポートにおける優れたAIエージェントのハンドオフのベストプラクティスの背後にあるものと同じです。Googleは、先に尋ねるのではなくブラウザ内で行動するChromeの自動閲覧で、逆の道を選びました。
ベンチマーク結果を正直に読む
ここで話は2つに分かれます。
スマートフォンでは明確に勝つ
| モバイルベンチマーク | Qwen-UI-Agent | Seed 2.1 Pro | Gemini 3.1 Pro | GPT-5.6 Sol | Claude Opus 4.8 |
|---|---|---|---|---|---|
| MobileWorld | 82.1 | 73.2 | 58.1 | 70.1 | 67.5 |
| MobileWorld-Real | 92.2 | 88.7 | 86.2 | 85.4 | 84.7 |
| AndroidDaily | 97.5 | 95.2 | 93.8 | 92.6 | 93.0 |
私にとって際立つのはMobileWorldの差です。次点のモデルを9ポイント近く、GPT-5.6 Solを14ポイント以上上回っています。しかもタスクが、盲目的な実行ではなく、エージェントとユーザーのやり取りを含むベンチマークでの話です。丸め誤差の差ではありません。
デスクトップでは競争力があるが、そのあとは違う
| コンピュータ・ブラウザのベンチマーク | Qwen-UI-Agent | Claude Opus 4.8 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|
| OSWorld-Verified | 79.5 | 83.4 | 78.7 | 76.2 |
| OSWorld-v2(部分進捗) | 40.0 | 54.8 | 49.5 | 未報告 |
| WebArena | 73.6 | 71.9 | 69.5 | 65.3 |
OSWorld-Verifiedは惜しい結果です。Claude Opus 4.8に4ポイント届きませんが、GPT-5.5とGemini 3.1 Proよりは上です。WebArenaは完全に制しています。そして長期ホライズンのセットであるOSWorld-v2では、Opus 4.8との間に14.8ポイントの差が開きます。
このパターンは、モバイル訓練から読み取れることと一致します。スマートフォンのタスクは短く、範囲が限られ、あの実機の端末群の中で十分に練習されています。長いデスクトップのワークフローはモデルがドリフトする場所で、ドリフトは訓練で消すのが最も難しいものです。Alibaba自身の要旨は、コンピュータ利用には「競争力がある」という言葉を使い、「最先端」はモバイルにのみ使っています。これは公正な表現ですが、多くの報道はそれをひとつの主張にならしてしまいます。
グラウンディングは総なめ
グラウンディングは、上記のすべてが実際に機能するかを決める地味なスキルです。モデルはカーソルを正しいピクセルに置けるか。Qwen-UI-Agentはレポート内のすべてのグラウンディングベンチマークでトップです。ズーム付きのScreenSpot-Proで81.5%、ズームなしで76.6%、SS-V2で97.5%、UI-Visionで70.0%です。
ここで正直な数値はズームなしのものです。ズームインは画面を切り出して再度調べるハーネスのトリックなので、それがあって初めて勝つモデルは足場に頼っています。なしで勝つということは、知覚そのものが本物だということです。
土台となる汎用モデルはどうか
Alibabaは、GUI訓練がベースモデルを劣化させなかったとも報告しており、それを示すためにQwen3.5-27Bとの比較を公開しています。
| 汎用ベンチマーク | Qwen-UI-Agent | Qwen3.5-27B |
|---|---|---|
| MMLU-Pro | 86.5 | 86.0 |
| MMMU-Pro | 72.4 | 73.5 |
| MathVision | 82.8 | 82.0 |
| IFEval (strict) | 90.2 | 90.4 |
| Tau2-Bench | 89.9 | 89.2 |
| Terminal-Bench 2.0 | 50.1 | 41.1 |
| BrowseComp-ZH | 75.0 | 62.1 |
Terminal-Benchが9ポイント、BrowseComp-ZHが13ポイント跳ね上がるのは、シェルの使い方と検索を教えられたモデルなら予想されることです。MMMU-ProとIFEvalのわずかな低下はその代償で、小さな代償です。1行だけ逆方向に動いています。QwenClawBenchは48.5から44.2に下がっており、レポートはそれを隠さずに公開しています。
数字が語らないこと
3つの注意点があります。Alibabaの名誉のために言えば、そのうち2つはAlibaba自身によるものです。
すべてのスコアは著者自身の環境で再現されたものです。 プロジェクトサイトの評価に関する注記がそれを直接述べ、ハーネス、ジャッジ、シミュレーター、ランタイム、タスクのサブセットの設定が公式評価と異なる場合があると付け加えています。競合他社の行の多くには、ベンダー自身のレポートからの転載ではなく、著者による再現であることを示す短剣符が付いています。これは多くのモデルのローンチがわざわざ行うよりも高い開示水準ですが、同時に、ベンダーが公表した条件と同じではないことも意味します。
デモは中国のアプリエコシステムの上に作られています。 Douyin、Hema、Trip.com、Amap、Dianping、Xiaohongshu、12306、DingTalk、Beike。エンジニアリングは一般化できます。92.2%という具体的な数値が、Slack、Shopify、Gmailを動かすスマートフォン群に自動的に当てはまるわけではありません。ワークフローが欧米のSaaSなら、このモバイルの数値は手法に関する強いシグナルとして扱い、ご自身のアプリについての約束とは受け取らないでください。
ウェブサイトのリポジトリがリリース状況を物語っています。 プロジェクトサイト自身のリポジトリには、「近日公開」のリソースカードを、リリース時に最終的なレポート、コード、チェックポイントのURLに置き換えるという編集指示が今も残っており、草稿内で矛盾する結果の数値は値が確定するまで意図的に省略するとの注記もあります。これは出荷された製品ではなく、まだ途中のプロジェクトです。
今日実際に実行できるか
できません。そして、私があなたなら最初に読むのがこのセクションです。
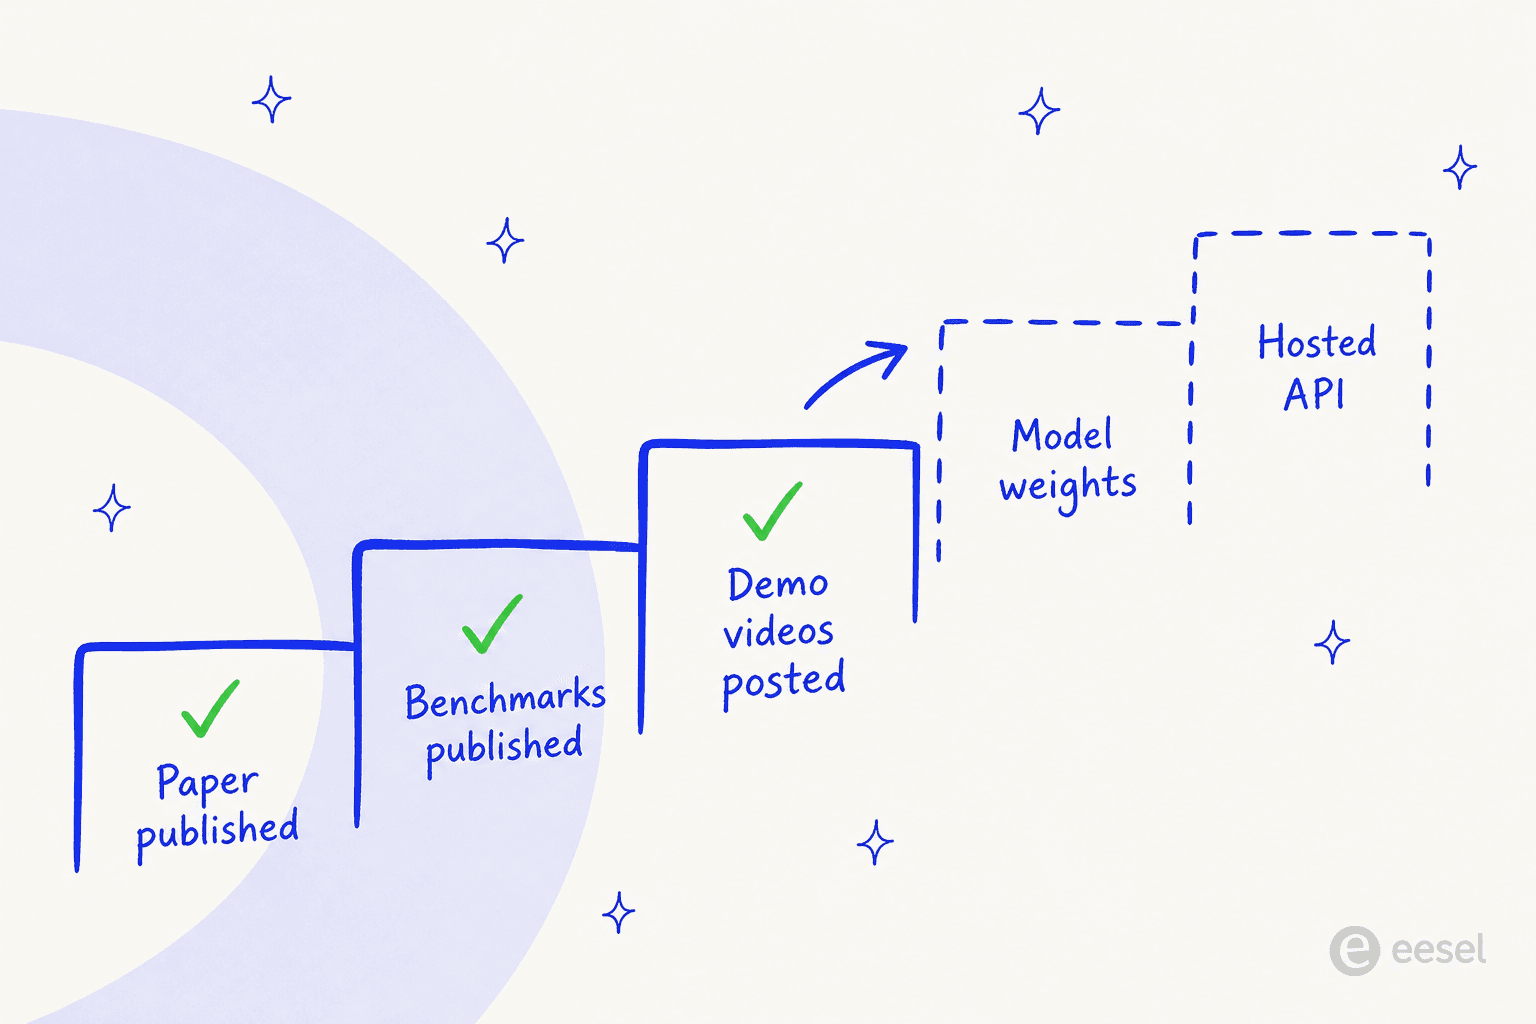
2026年8月24日に私が確認した内容は次のとおりです。
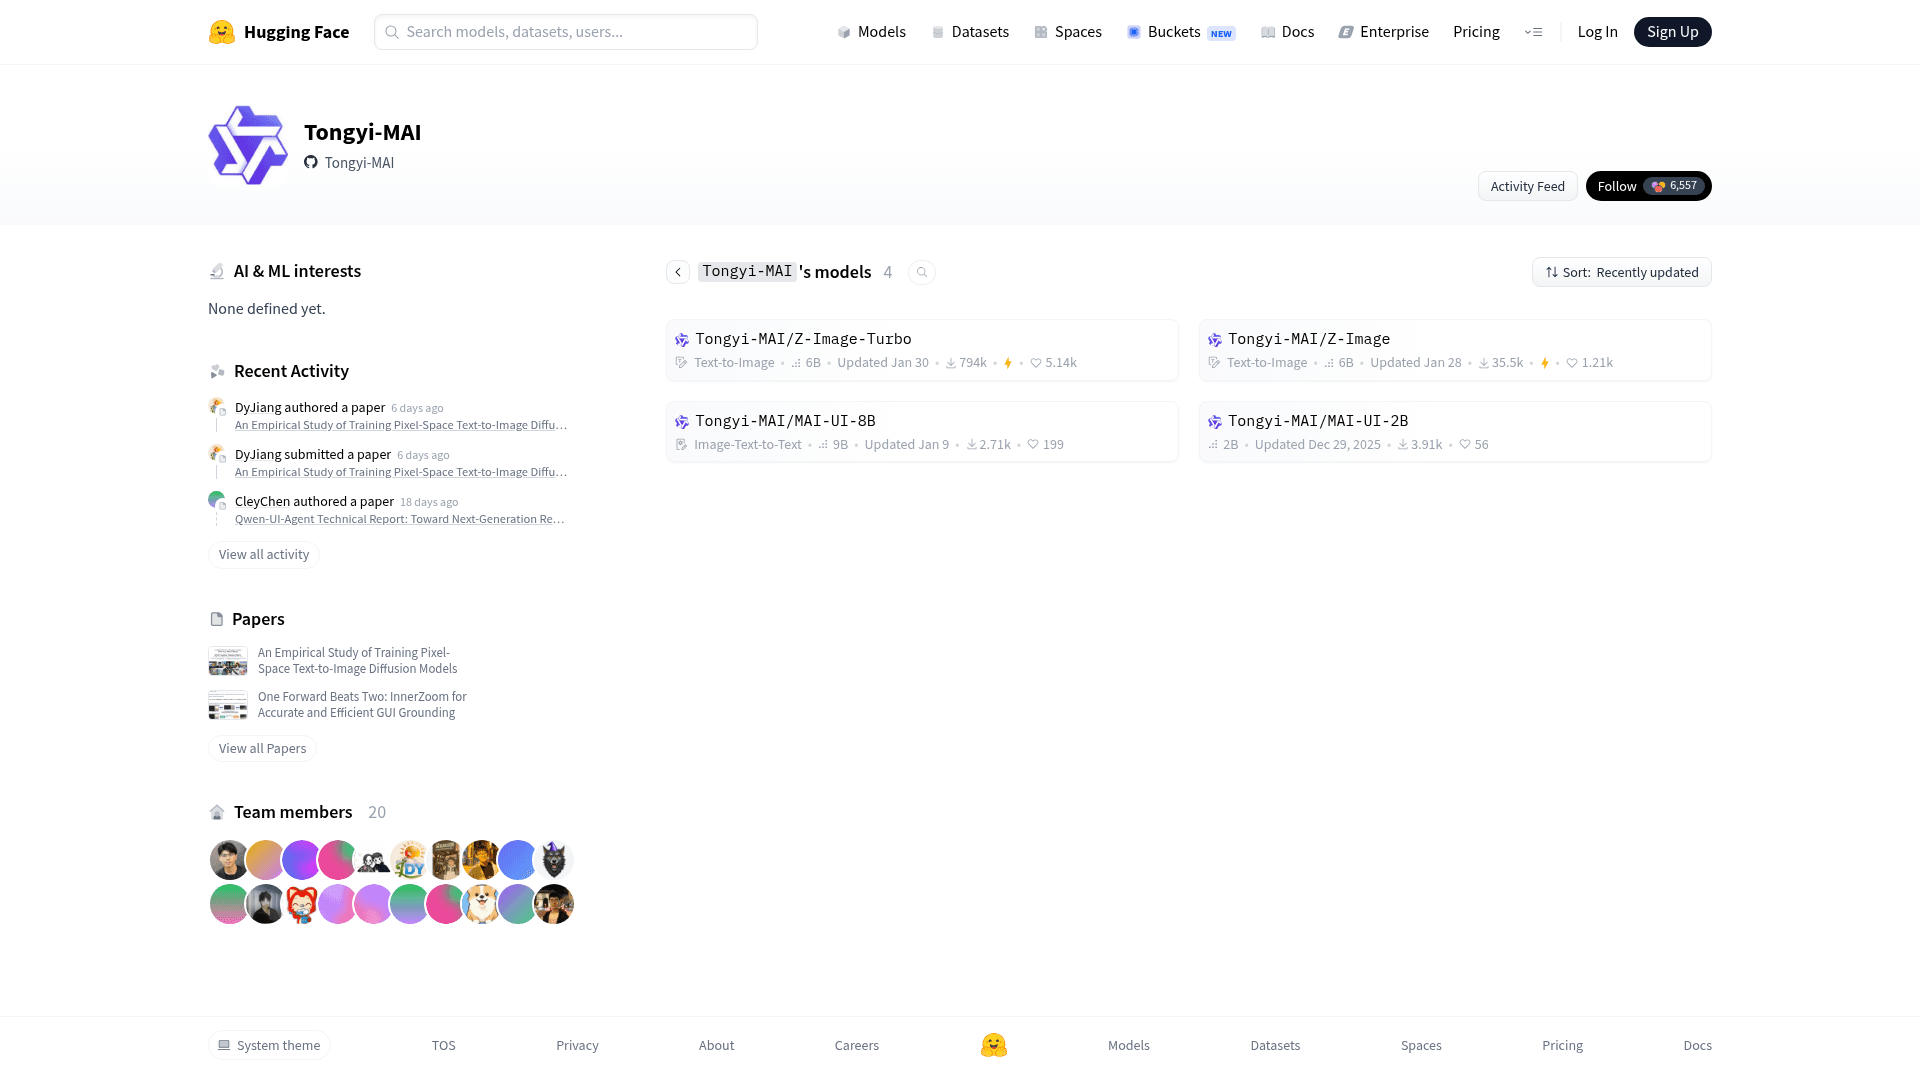
- Hugging FaceのTongyi-MAI組織は4つのモデルを掲載しています。Z-Image、Z-Image-Turbo、MAI-UI-8B、MAI-UI-2Bです。Qwen-UI-Agentはありません。
- 論文ページには、リンクされたモデル、データセット、Spaceがいずれもゼロと表示されています。
- Qwen-UI-Agentという名前のGitHubリポジトリはウェブサイトのソースだけで、readmeの冒頭に太字でそう書かれています。
- 実装リポジトリTongyi-MAI/MAI-UIは2.2kスターを持ちますが、このモデルのリリース、タグ、チェックポイントへのリンクはありません。
- Alibabaのモデルカタログには Qwen-UI-Agent の項目がなく、エンドポイントも料金表もありません。
唯一の心強い材料は前例です。同じチームが2025年12月にMAI-UI 8Bと2Bを公開しており、readmeにはプロジェクトがApache 2.0ライセンスであると書かれています。Alibabaは主力ラインについてもウェイトを出荷しており、Qwen 3.8 Maxのレビューで取り上げています。したがって、オープン公開は十分あり得ます。ただ、それを前提に四半期の計画を立てられるものではありません。
今月中に呼び出せるものが必要なら、実用的な候補リストはQwenの代替とKimi K3を経由します。より安価なオープンの選択肢としてはDeepSeek V4 Flashがあります。
サポートキューを運営している場合の意味
このセクションでは慎重でありたいと思います。「GUIエージェントがサポートのベンチマークで89.9」というのは、まさに取締役会向け資料に載ってしまう類の見出しだからです。
Tau2-Benchは本物のベンチマークで、89.9はその中で良いスコアです。しかし、それが測っているものを、サポートリーダーが実際に必要とするものと並べて見てください。通話で、私は同じ要件を何度も耳にします。自社の過去のチケットで訓練してほしい。すべての回答に引用を付けてほしい。そして実行する前に、何をするはずだったかを見せてほしい。画面を操作するエージェントには、構造上、2つ目と3つ目を提供できません。クリックするだけです。出典を付けられる回答オブジェクトはなく、マウスにはドライランモードもありません。だからサポートにおけるハルシネーション防止は、モデル選びではなく範囲の設定から始まります。
私が話を聞いたあるハードウェアサポートチームは、Zendeskで月およそ250件のチケットを複数の言語で処理しており、何かが本番に出る前に、引用を必須要件にしました。もう1つは公共部門のIT サービス会社で、今年ベテランのエージェント2名を失う予定で、去っていく人の知識が一緒に消えてしまわないよう、AIに自社の解決済みチケットで学習させることを求めました。どちらも画面の問題ではありません。どちらも検索とガバナンスの問題で、この論文のどの内容よりもサポートに向いているLLMの問いに近く、だから最良のサポートチケット向けAIモデルが最大のモデルであることは稀なのです。
実際に機能するパターンは地味なもので、私が見てきたほぼすべての導入に当てはまります。AIが書いて人間が送信する下書きモードで始める。数字がそれに値すると示したら、完全自動化へ進む。これがAIエージェント支援の作業の形であり、だからこそ、コンテインメントとエスカレーションの質は、このページのどのベンチマークよりも導入の成功をうまく予測します。サポートQAはそのループのもう半分です。
GUIエージェントが本当に居場所を得るのは、誰もAPIを作らなかった社内業務のロングテールです。レガシーな管理画面。仕入先ポータル、あるいは2014年の社内ツール。それは本物の価値で、過小評価もされています。ただ、顧客チケットの解決とは別の仕事であり、ワークフロー自動化がチケットのデフレクションとは別の仕事であるのと同じことです。
eeselの位置づけ
本当に欲しいのがヘルプデスクのキューを小さくすることで、GUIエージェントの論文を読んでいるのなら、近道は画面の層を丸ごと飛ばすことです。eeselはZendesk、Freshdesk、Gorgiasなどに直接接続し、公開クロールではなく、お客様自身の過去のチケットとヘルプセンターから学習し、すべての回答に出典を引用します。画面操作エージェントというより、この仕事に私たちが使っているAIチームメイトやAI従業員という考え方に近い動きをします。
この比較で最も重要な点は、数千件の過去のチケットでシミュレーションを実行し、顧客の目に触れる前に、何と返信したはずかを正確に読めることです。これはベンチマークのスコアでは決して代替できない「まず証明する」ステップで、調達サイクルではなく数分で済みます。無料でお試しいただけます。
Qwen-UI-Agentは誰のためのものか
**注意深く追う価値があるのは、**モバイル自動化を構築している、実際のAndroid端末に対するQAを行っている、あるいはGUIエージェントを研究していて現時点で最も文書化された手法を知りたい場合です。実機での訓練ループと、GUIとCLIを合わせたアクション空間は、他社の次のリリースに登場する可能性が最も高い2つのアイデアです。
**当面は無視してよいのは、**今四半期に本番で動くものが必要な場合です。デプロイできるものがありません。論文を読み、手法をメモして、チェックポイントが出たら再訪してください。それまでは、実際に呼び出せるAlibabaのモデルはQwen 3.7 Flashです。
**懐疑的であるべきなのは、**ワークロードが長いデスクトップワークフローの場合です。その判断を左右すべき数値は、スマートフォンの92.2%ではなく、OSWorld-v2の40.0%です。その種の仕事では、Claude Opus 5とその前のモデルがより安全な選択肢であり、残りの顔ぶれはOpus 5の代替に関する記事で扱っています。
**まったく適したツールではないのは、**カスタマーサポートを自動化しようとしている場合です。弱いからではありません。狙っている面が違うだけです。サポートチームに必要なのは、ヘルプデスクに接続し、ナレッジベースと解決済みチケットから学習するものです。
そこから先の仕事は、ルーティング、チケット分類、そして人間が必要なときのきれいなサポートのエスカレーションです。そこでは画面操作がボトルネックではなく、それをボトルネックとして扱うと、印象的なデモと変わらないキューだけが残ることになります。
結論
Qwen-UI-Agentは今年最も興味深いGUIエージェントの論文であり、この比較の中で最も使えない製品です。この2つは同時に真実です。
モバイルの結果は本物の見出しであり、それにふさわしい。物理スマートフォンの群で400以上のタスクにわたって92.2%、4つの最先端モデルを上回るというのは、ベンチマーク上の見せかけではありません。その背後にある手法、特にクリックの流れにシェルコマンドを混ぜることと、ターンごとにアクションをバッチ化することは、真似される類のアイデアです。
デスクトップの結果は本物の注意点です。長期ホライズンのコンピュータ利用で40.0%、Claude Opus 4.8は54.8%という差は大きく、ビジネスの文脈で人々が「コンピュータ利用」と言うとき、そのほとんどは結局、長期ホライズンのデスクトップ作業です。
そして提供状況が本物の障害です。readmeにあるApache 2.0は意図にすぎません。チェックポイントが実際に出るまでは、これは学ぶための研究であり、買うソフトウェアではありません。目の前のキューが画面ではなくサポートキューなら、最良のAIエージェントは、最も速くクリックするものではありません。信頼する前に、ご自身のチケットでテストさせてもらえたものです。