

Qwen-UI-Agentは、これまでに公開されたスマートフォン操作エージェントとして最高の存在ですが、使うことはできません。AlibabaのTongyi MAIチームは、2026年7月30日に論文、デモ動画、ベンチマークを公開しました。GitHubリポジトリのスターは2.2k、リリースはゼロです。Hugging Faceに重みはなく、APIも料金表もありません。
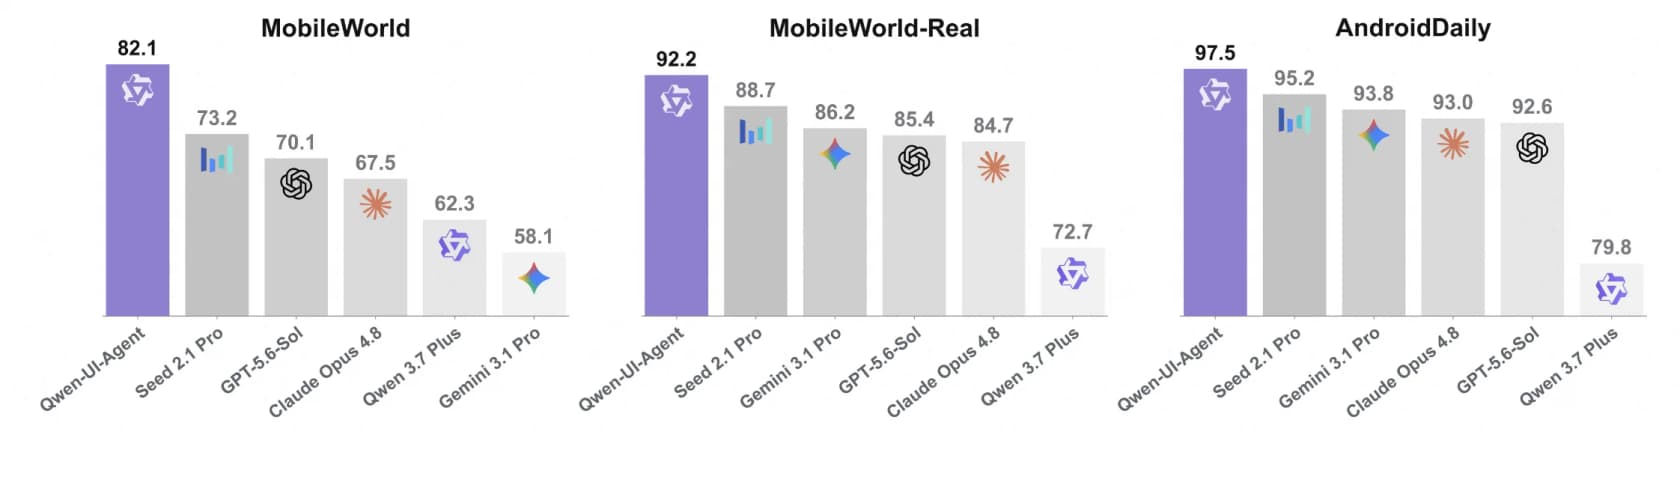
モバイルの数値は本物で、しかも大きなものです。MobileWorldで82.1%、これはClaude Opus 4.8を14.6ポイント、それ以前の最良の専用GUIモデルを38.2ポイント上回ります。英語圏の報道が誤ったのはデスクトップの数値です。OSWorld-Verifiedでは、Alibaba自身のグラフでOpus 4.8が83.4、Qwen-UI-Agentが79.5です。長時間のデスクトップ作業では、完了できるタスクは13.9%にとどまります。英語の難しいWeb調査では64.1で、GPT-5.5の90.1に届きません。
私はeeselでエージェント側を開発しているので、この論文で何度も読み返すのはリーダーボードではありません。実機での失敗をすべて分類した表10です。失敗の52%はモデルではなく画面のせいでした。広告、ペイウォール、CAPTCHA、空白のページ、入力済みの文字と取り違えたグレーのプレースホルダーなどです。この数字が、画面操作が向く場面と向かない場面を教えてくれます。
Qwen-UI-Agentとは何か
皆さんが目にするモデルの多くは質問に答えます。これはデバイスを操作します。普通の言葉でタスクを渡すと、スクリーンショットを見て、タップ、スワイプ、キー入力、bashコマンドのいずれかを出力します。そしてもう一度画面を見ます。
論文では3つのサイズを評価しています。27B、スパース型の35B-A3B、そして4Bです。目玉の数値はすべて27Bのものです。ベースはほぼ確実にQwen3.5-27Bです。論文の汎用能力の表で両者が並んでいて、スコアがほぼ同じだからです。MMMU-Proで72.4対73.5、RealWorldQAで83.1対83.1です。GUI訓練が何をしたにせよ、モデルの汎用的な推論力は損なわれていません。これは多くの専用ファインチューニングには言えないことです。
同じチームの前作であるMAI-UI 1.0の後継で、測るものにちなんで名前を付ける習慣も受け継いでいます。このファミリーが初めてなら、主力モデルはQwenの概要で、ビジネス視点の評価はQwenレビューで扱っています。Alibabaの現行フラッグシップであるQwen3.8-Maxはまったく別物で、より大きく、より饒舌で、ボタンを押すために作られてはいません。
モバイルボットではなく基盤GUIエージェントと言えるのは、守備範囲の広さゆえです。1つのモデルで4つの環境を扱います。Androidスマートフォン、Linuxデスクトップ、Webブラウザ、そしてAPIベースのディープサーチモードです。このうち1つをこなす名のある製品は存在します。4つすべてを1つのチェックポイントでこなすことが、今回の主張です。
ベンチマーク表と、読み込まれすぎた部分
公開された主要な数値をすべて1か所にまとめ、実際に誰が首位かを示します。
| 軸 | ベンチマーク | Qwen-UI-Agent | 公開されている最高値 | 評価 |
|---|---|---|---|---|
| モバイルGUI | MobileWorld (50 steps) | 82.1% | Qwen-UI-Agent | Seed 2.1 Proを8.9上回り首位 |
| モバイル、実機 | MobileWorld-Real | 92.2% | Qwen-UI-Agent | Seed 2.1 Proを3.5上回り首位 |
| モバイル、日常タスク | AndroidDaily | 97.5% | Qwen-UI-Agent | 2.3差で首位 |
| デスクトップ | OSWorld-Verified | 79.5% | Claude Opus 4.8、83.4% | 2位 |
| デスクトップ、長時間作業 | OSWorld-v2 partial | 40.0% | Claude Opus 4.8、54.8% | 3位、GPT-5.5の後ろ |
| デスクトップ、完了タスク | OSWorld-v2 binary | 13.9% | Claude Opus 4.8、20.6% | 2位 |
| ブラウザ | WebArena | 73.6% | Qwen-UI-Agent | 1.7差で首位。人間は78.2% |
| グラウンディング | ScreenSpot-Pro (zoom) | 81.5% | Qwen-UI-Agent | 0.8差で首位 |
| ディープサーチ、英語 | BrowseComp | 64.1% | GPT-5.5、90.1% | 26ポイント差 |
| ディープサーチ、中国語 | BrowseComp-ZH | 75.0% | Apodex-1.0-mini、80.6% | 2位 |
この表のモバイル側は接戦ではありません。ご覧ください。
次に、デスクトップとWebの同じグラフ群を見てください。中央と右のパネルは勝利です。左のパネルは違い、それを上回るバーにはラベルが付いています。
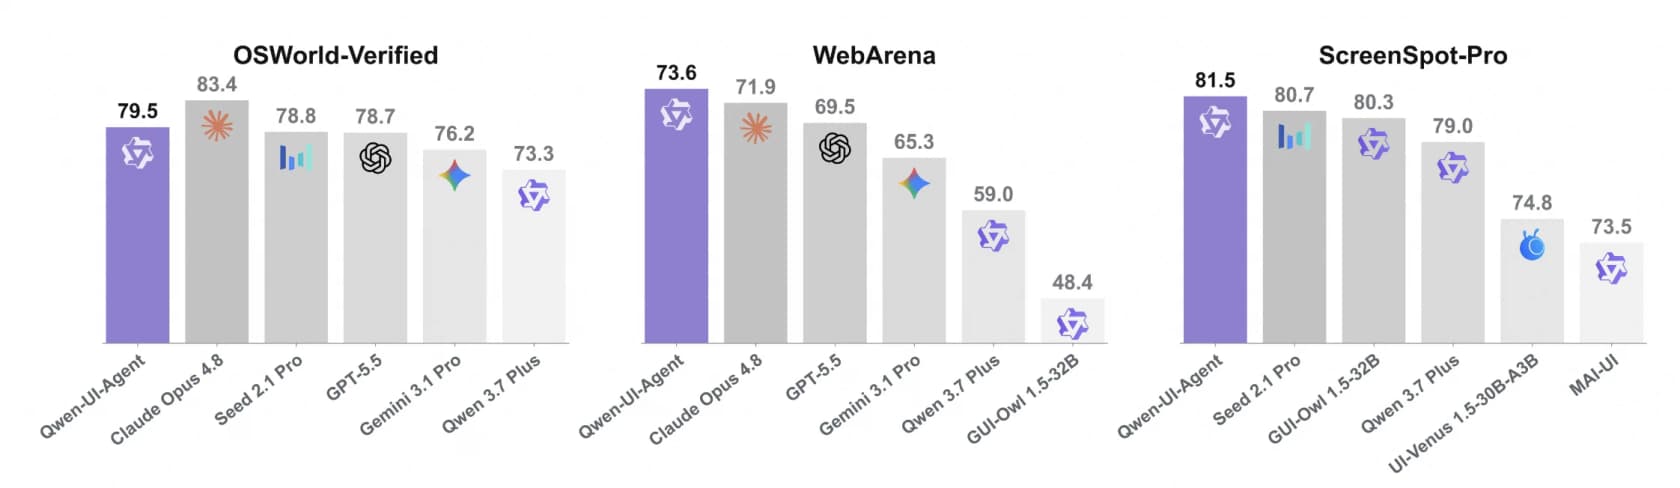
Alibabaはこの点について率直でした。論文はOSWorld-Verifiedについて、比較対象のなかで「second among all compared models and trailing only Claude Opus 4.8」と述べており、要旨でも主張を丁寧に分けています。モバイルでは最先端、コンピューターとブラウザでは競争力あり、というものです。丸められたのはその後です。広く共有された中国AI週間まとめは、MobileWorld、OSWorld-Verified、WebArenaの3つすべてで最高スコアだと報じ、「beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro.」と書きました。3つのうち2つは正しいです。デスクトップは、Alibaba自身の棒グラフによれば違います。
これが重要なのは、2つの軸が別の仕事を表しているからです。アプリで電車の切符を予約するのはモバイルのタスクです。4つのウィンドウをまたいで表計算を突き合わせるのはデスクトップのタスクです。モデルは一方で勝ち、もう一方で負けることがあり、これがまさにそうです。
仕事を選んでから、数値を読む
タップとターミナルコマンドを1つにまとめた行動空間
私が最も興味深いと思う設計上の判断は、視覚とは関係ありません。アクションの一覧です。
click、long_press、type、drag、system_button、waitといった想定どおりのGUI操作に加えて、モデルにはbashを実行するcli_command、構造化されたサービス呼び出しを行うapi_call、人間に確認するために止まるask_userがあります。すべてが1つのフラットな空間にあり、ターンごとに選ばれます。そのためエージェントは「40個のファイル名を変更する」ことを40回のクリックで表現する必要がなく、コマンドを書くだけで済みます。
実際、ひっきりなしにそうしています。OSWorld-v2では、エージェントの操作の55.1%が画面操作ではなく入力されたコマンドです。OSWorld-Verifiedでは40.7%で、タスクの92.0%に登場します。
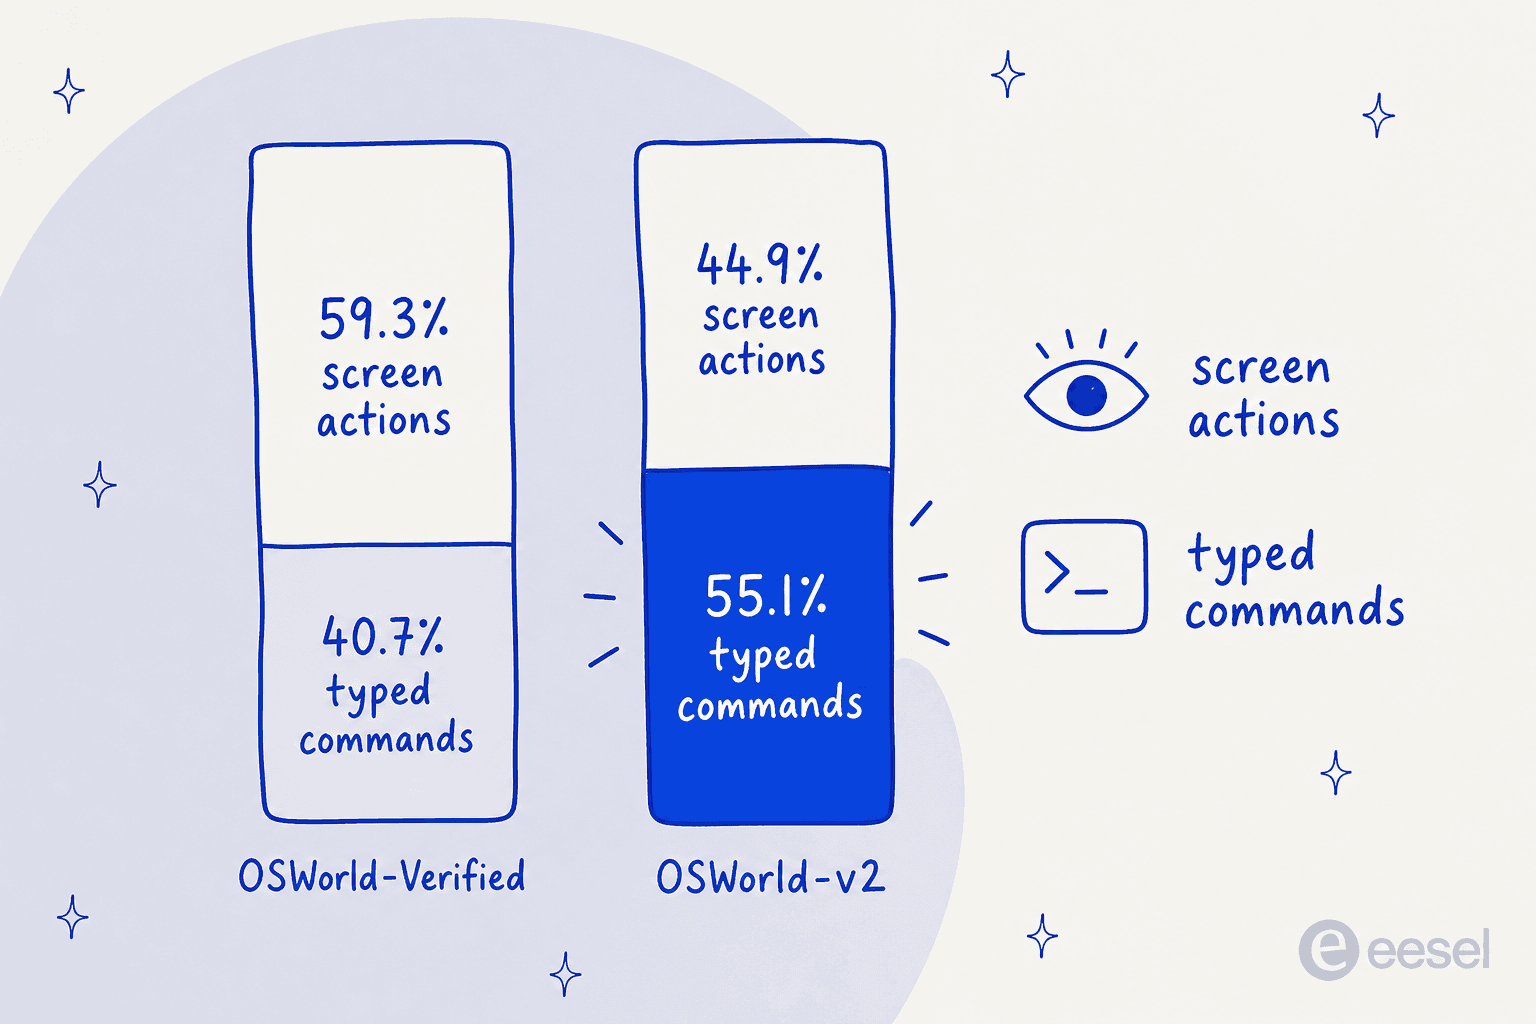
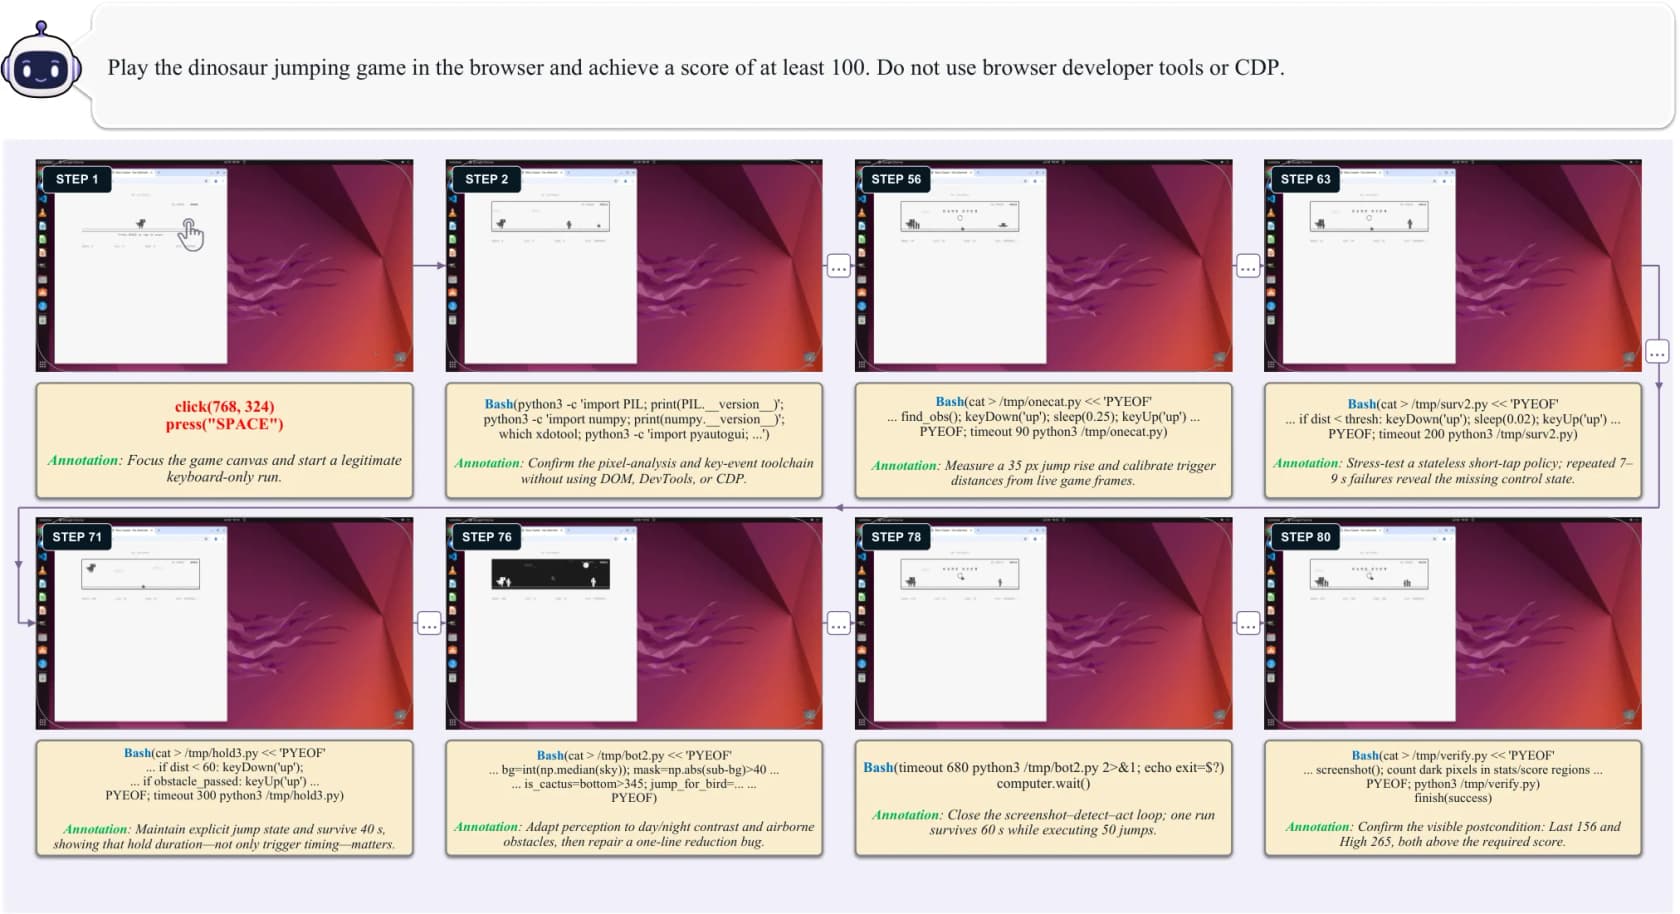
少し考えてみてください。看板製品は画面エージェントです。キーボードとシェルを与えると、より難しいデスクトップのベンチマークでは、操作の大半が画面にまったく触れないものになります。論文自身はこのパターンを「bashは手、GUIは目」と呼んでいて、それを最もよく示す軌跡は、開発者ツールを開かずにブラウザの恐竜ゲームで100点を取るというタスクです。80ステップにわたり、エージェントはスクリーンショットでキャンバスを観察し、Pythonを書いては書き直してジャンプのタイミングを合わせます。
2つ目の効率化の工夫はバッチ処理です。モデルの1ターンにつき1つの操作ではなく、複数を出力します。OSWorld-Verifiedの操作の39.6%、OSWorld-v2の41.6%がバッチで届き、平均3.1個のプリミティブを含みます。論文の例の1つは、メールを入力して添付ファイルの選択画面まで進む21操作の連続で、次の判断には新しいスクリーンショットが必要なのでそこで止まります。避けたターンが1つ増えるごとに、スクリーンショット、推論、往復の通信が1回ずつ減ります。これは論文が今後の課題の節で、実用化への最大の障害として挙げているコストそのものです。
ブラウザエージェントがフォームを1項目ずつ這うように進むのを見たことがあるなら、これが解決策です。Chrome auto-browseにも同じ種類の問題があり、デモを台無しにするのが精度ではなく1ステップあたりの遅延であることが多いのはそのためです。
実機での数値こそ興味深い
ほとんどのGUIエージェントはシミュレーターで訓練・採点されます。シミュレーターはリセットして検証できるからです。Alibabaはその逆を作りました。100台を超える実機のスマートフォンと150以上のアプリを備えた実行環境と、それに合わせたベンチマークです。
MobileWorld-Realは、訓練から除外された、104の実在のAndroidアプリにわたる人間が書いた409のタスクです。実際のアカウント、変化するコンテンツ、実際の権限、実際のネットワークがあります。タスク一覧は誰かの土曜日のようです。最も保存されているレシピ投稿を見つける、調味料を除いた材料を18:45の配達で買う、3つのホテルから橋までの徒歩時間を比べる、電車の到着時刻を調べてその次の正時に会議を入れる、といったものです。
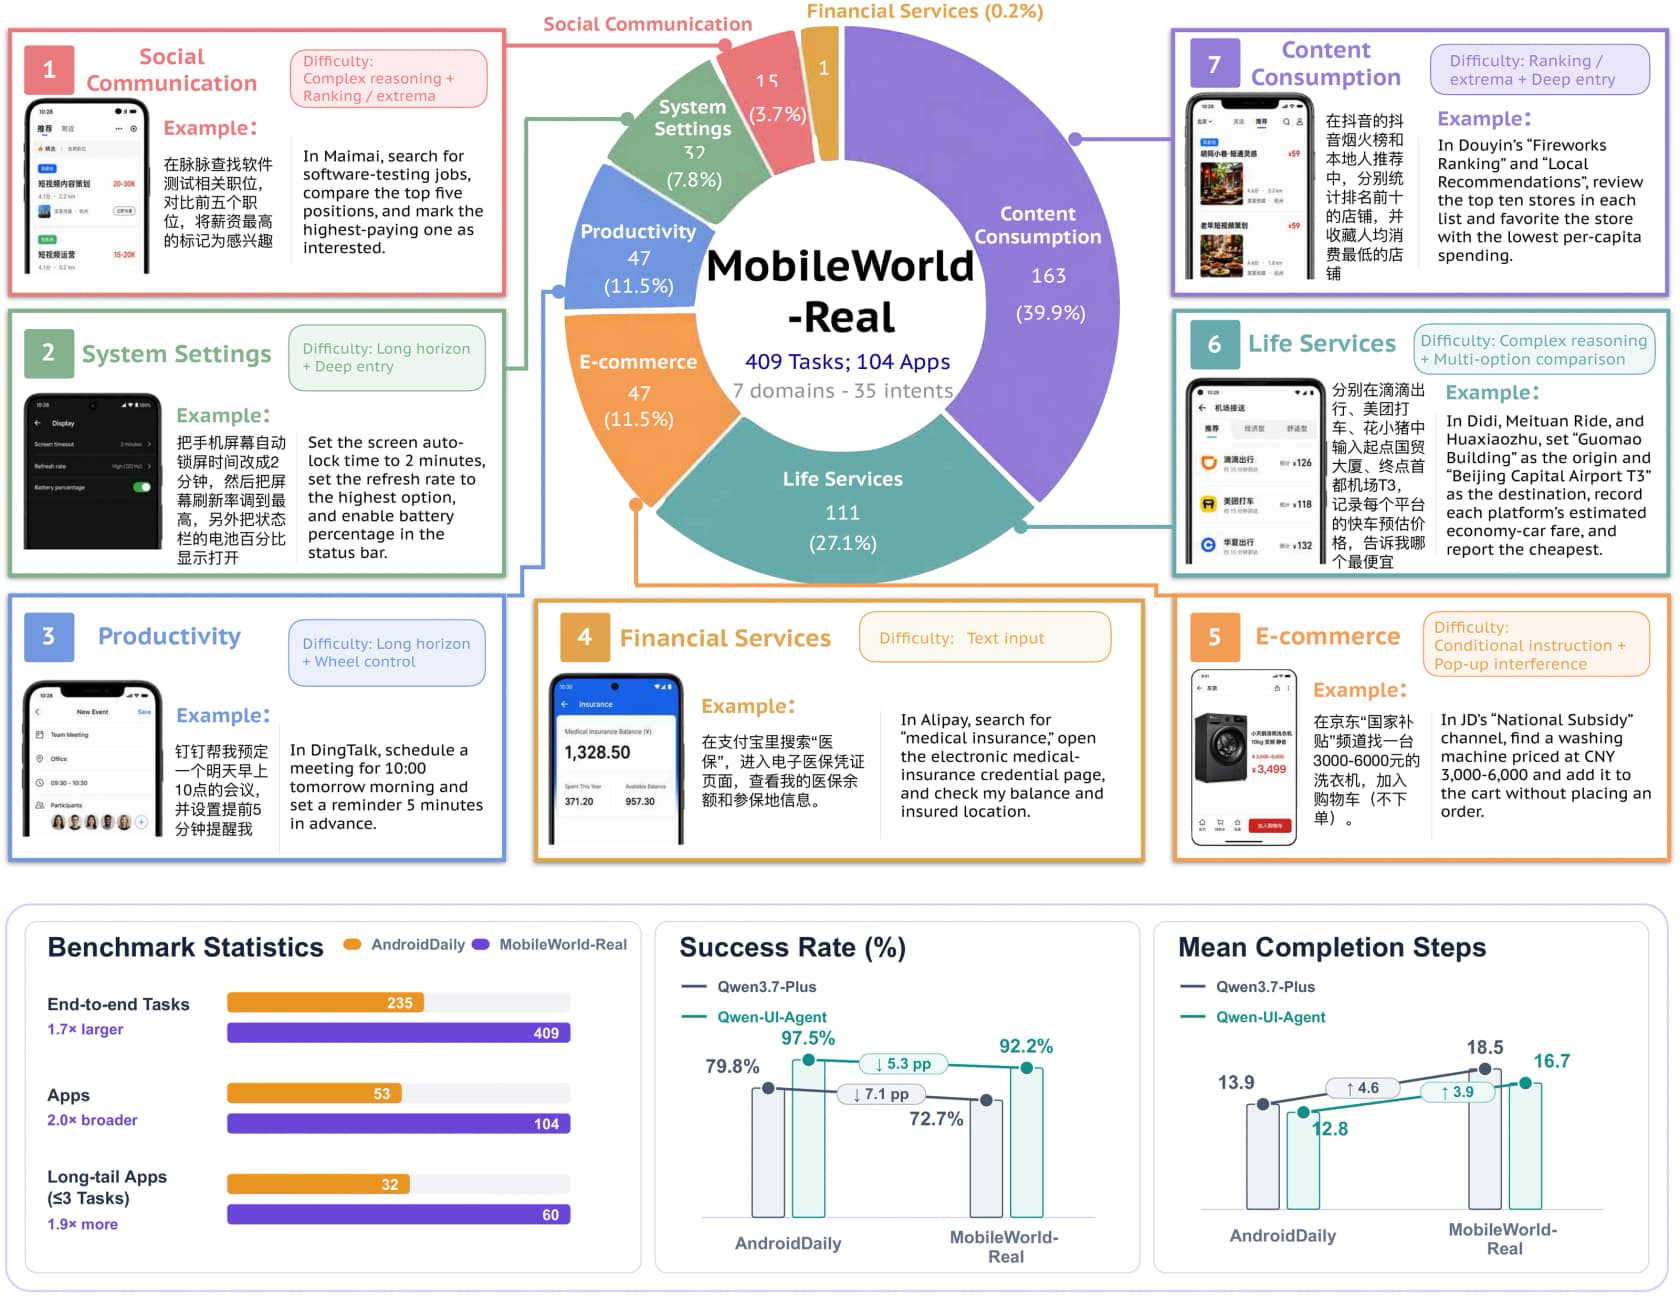
92.2%には2つの率直な留意点があります。1つ目は、これがAlibaba自身のベンチマークだということです。それは普通のことですが、独立したスコアボードではありません。2つ目は、実機のスマートフォンはアプリの内部を公開しないため、決定論的な検証手段がないことです。採点はAutoJudgeというエージェントが行い、指示と操作・スクリーンショットの全履歴を読んで、合格、不合格、環境エラーのいずれかを返します。チームはその精度を、専門家がレビューした666件の例に対して92.8%の完全一致と報告し、審査の誤りを論文の最初の制約として挙げました。最初に書いた姿勢は評価できます。同時に、そのリーダーボードの上位には許容幅があるということでもあります。
そのハードウェアの見返りは失敗分析に表れます。5分しかなければ私が最初に読む節です。チームは、実機で失敗したQwen 3.7 Plusの軌跡をすべて取り上げて分類しました。
| 失敗のパターン | 割合 | 具体的な様子 |
|---|---|---|
| UIの読み違い | 24.7% | グレーのプレースホルダーを入力済みの文字と読み、空の欄を何度も消し続ける |
| ポップアップによる妨害 | 18.2% | 広告、ペイウォール、CAPTCHA、空白のページ |
| 探索の失敗 | 19.5% | いくつものメニューの奥にある機能を見つけられない |
| 誤った操作のループ | 14.3% | 何も起きなかった操作を12回繰り返す |
| 物理的なウィジェットの操作 | 9.1% | 時刻ピッカーを両方向に行き過ぎて、止まれない |
| 実行状態の喪失 | 6.5% | 完了したサブタスクを忘れ、最初からやり直す |
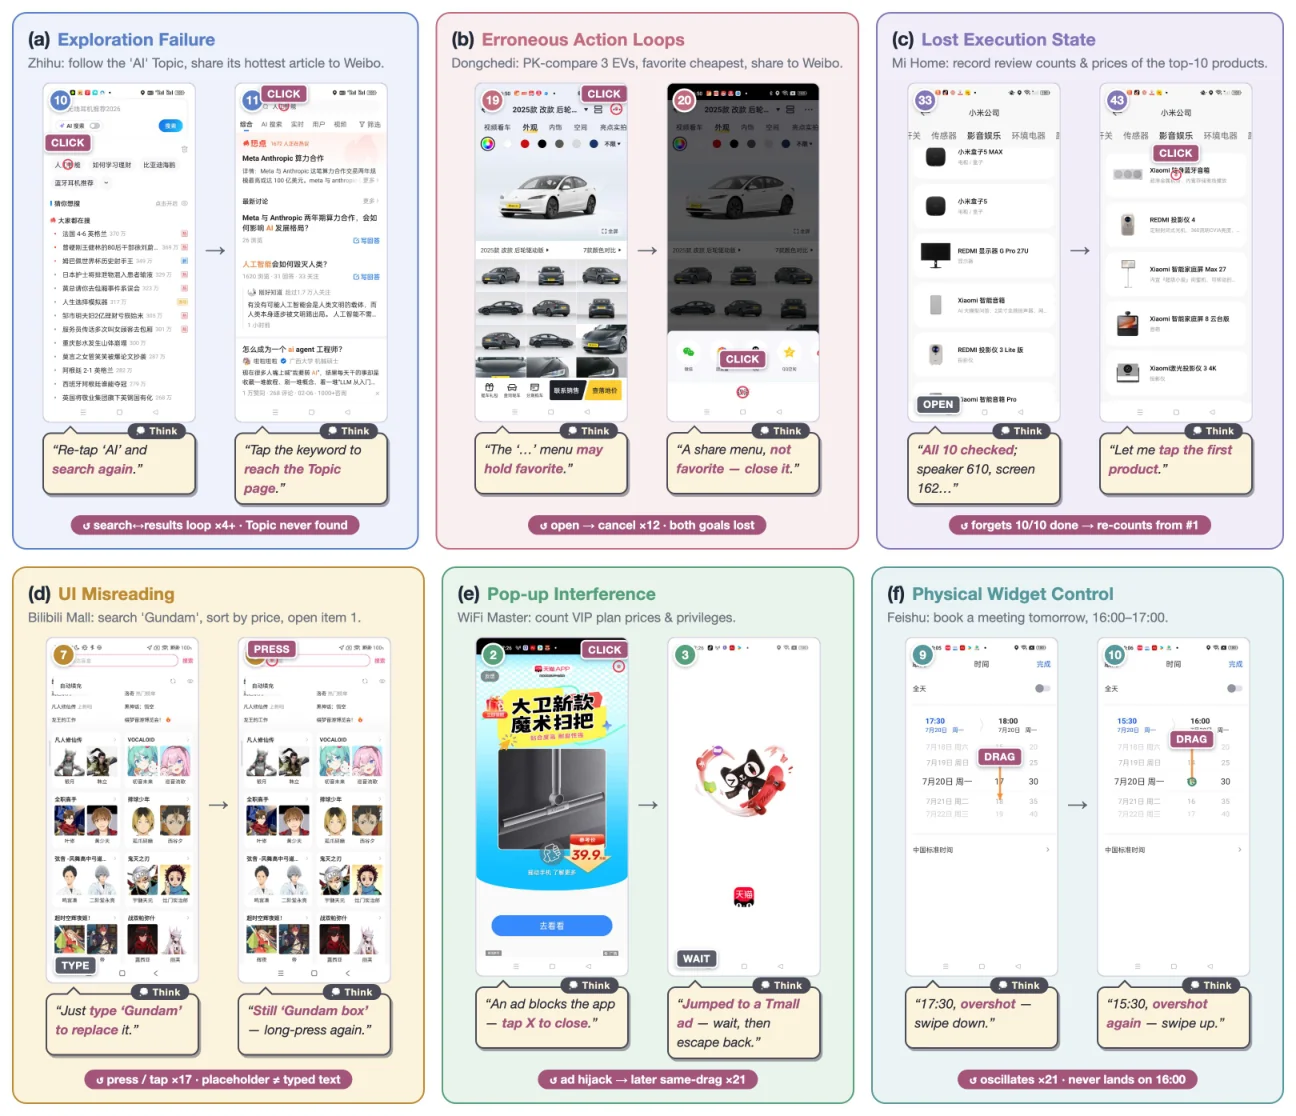
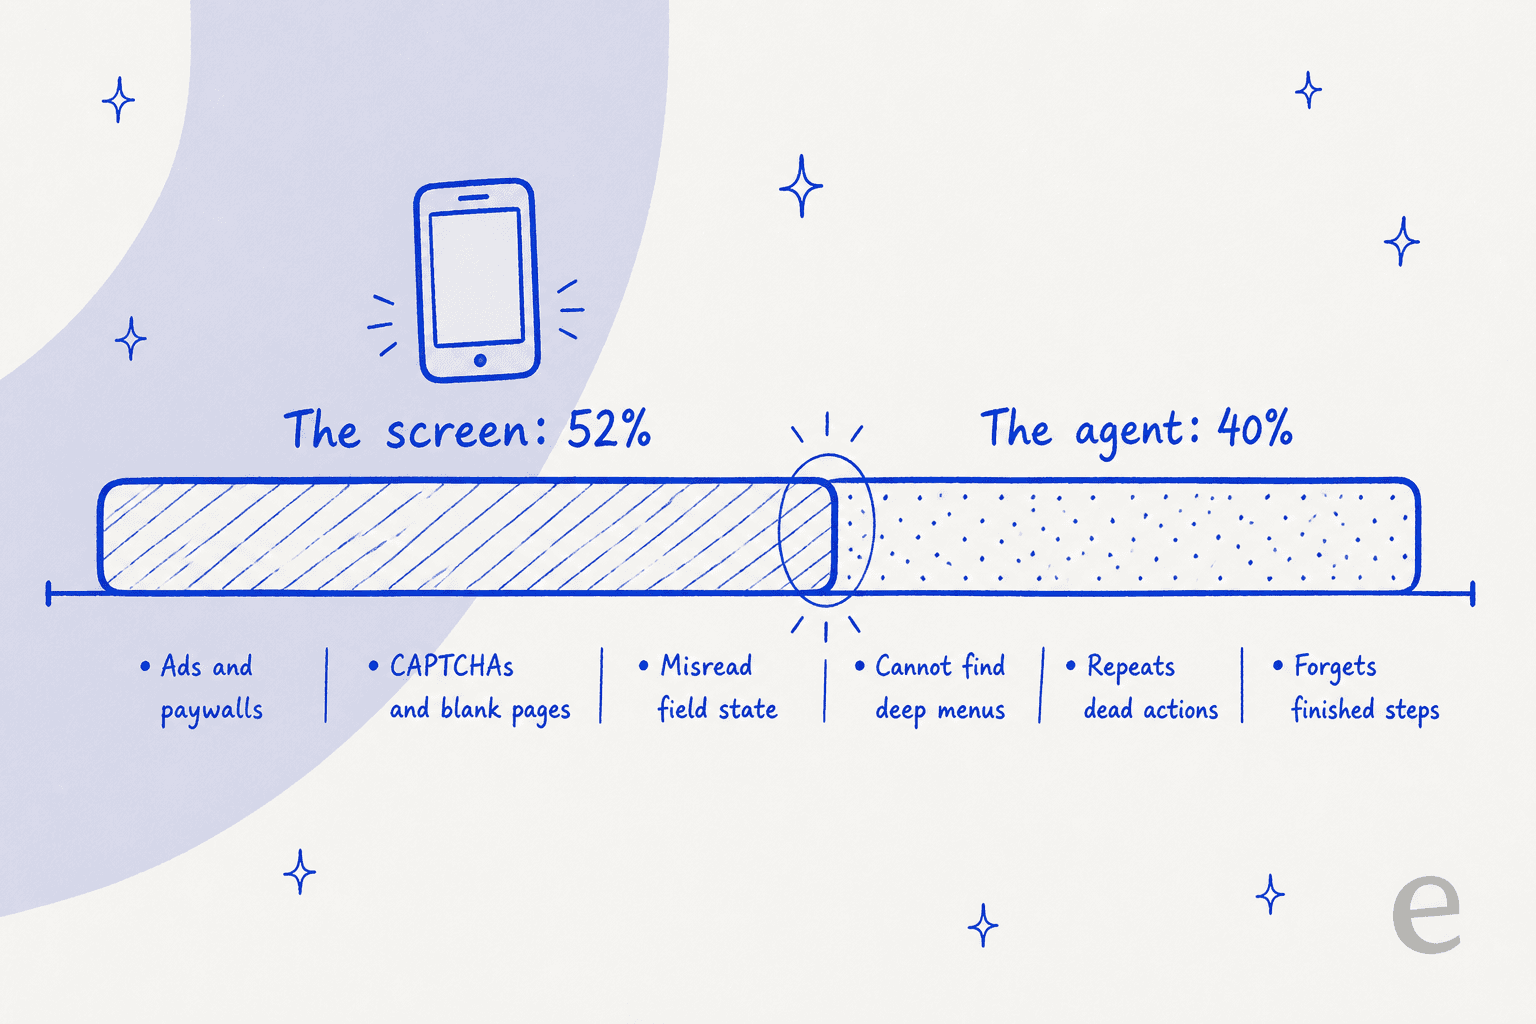
上の行を合計すると、失敗の52.0%は推論ではなく環境によるものです。広告が現れた、ページが空白になった、プレースホルダーが文字に見えた、といったものです。エージェント自身の力不足による失敗は40.3%にすぎません。GUIエージェントの真の敵はインターフェースであり、インターフェースは誰にも知らせず変わります。
実際に使えるか?いいえ、まだです
発表のスレッドがどれも飛ばした部分なので、何が存在するのかをはっきり述べます。
| 欲しいかもしれないもの | 現時点であるもの |
|---|---|
| モデルの重み | なし。Hugging FaceのTongyi-MAIには2025年12月と2026年1月のMAI-UI-2BとMAI-UI-8Bがあるだけで、それより新しいものはありません |
| 推論コード | なし。リポジトリはスター2.2k、フォーク199、リリースゼロ、パッケージゼロ |
| ホスト型API | 公開なし |
| 料金 | なし。課金するものがないため |
| 一般向けアプリ | 発表なし |
| 読めるもの | 技術レポート、プロジェクトサイト、デモ動画、MobileWorld-Realベンチマーク |
READMEのApache 2.0ライセンスはリポジトリの内容に適用されるもので、チェックポイントには及びません。これはオープンだと誰かに言われる前に知っておく価値があります。Alibabaには最終的に重みを公開してきた実績があるので、妥当な見方は「決してない」ではなく「まだない」です。ただ現時点のQwen-UI-Agentは研究成果であり、ワークフローに組み込めるものではありません。実際に呼び出せるモデルについてはQwenの料金ガイドで扱っており、Qwen 3.7 Flashは本番で使われている低コストのモデルです。
読むのではなく選ぶのであれば、率直な比較対象は、今日すでにAPI呼び出しに応答するモデルです。デスクトップ操作ではまずClaude Opus 5で、理由の詳細はOpus 5レビューにあります。
その下では、Gemini 3.5 Proが視覚対応で最も安価な有力候補で、GPT-5.6は多くのチームがすでにキーを持っているものです。
好みではなくオープンな重みが必須条件なら、直接比較する価値があるのはKimi K3とDeepSeekの低価格帯の2つです。低価格帯が実際に導入される理由は、DeepSeek V4 Flashの記事で解説しています。
サポートキューを運用しているなら、これは何を意味するか
ここで利害関係を明らかにしておく必要があります。これは私の本業だからです。私はeeselでエージェント機能を開発しており、GUIエージェントがサポート責任者に売り込む夢は具体的で魅力的です。ヘルプデスクにログインして、新入社員のようにチケットをさばくAIで、連携プロジェクトは不要というものです。
この論文には、それを真っ先に選ぶことに反する点が2つあります。
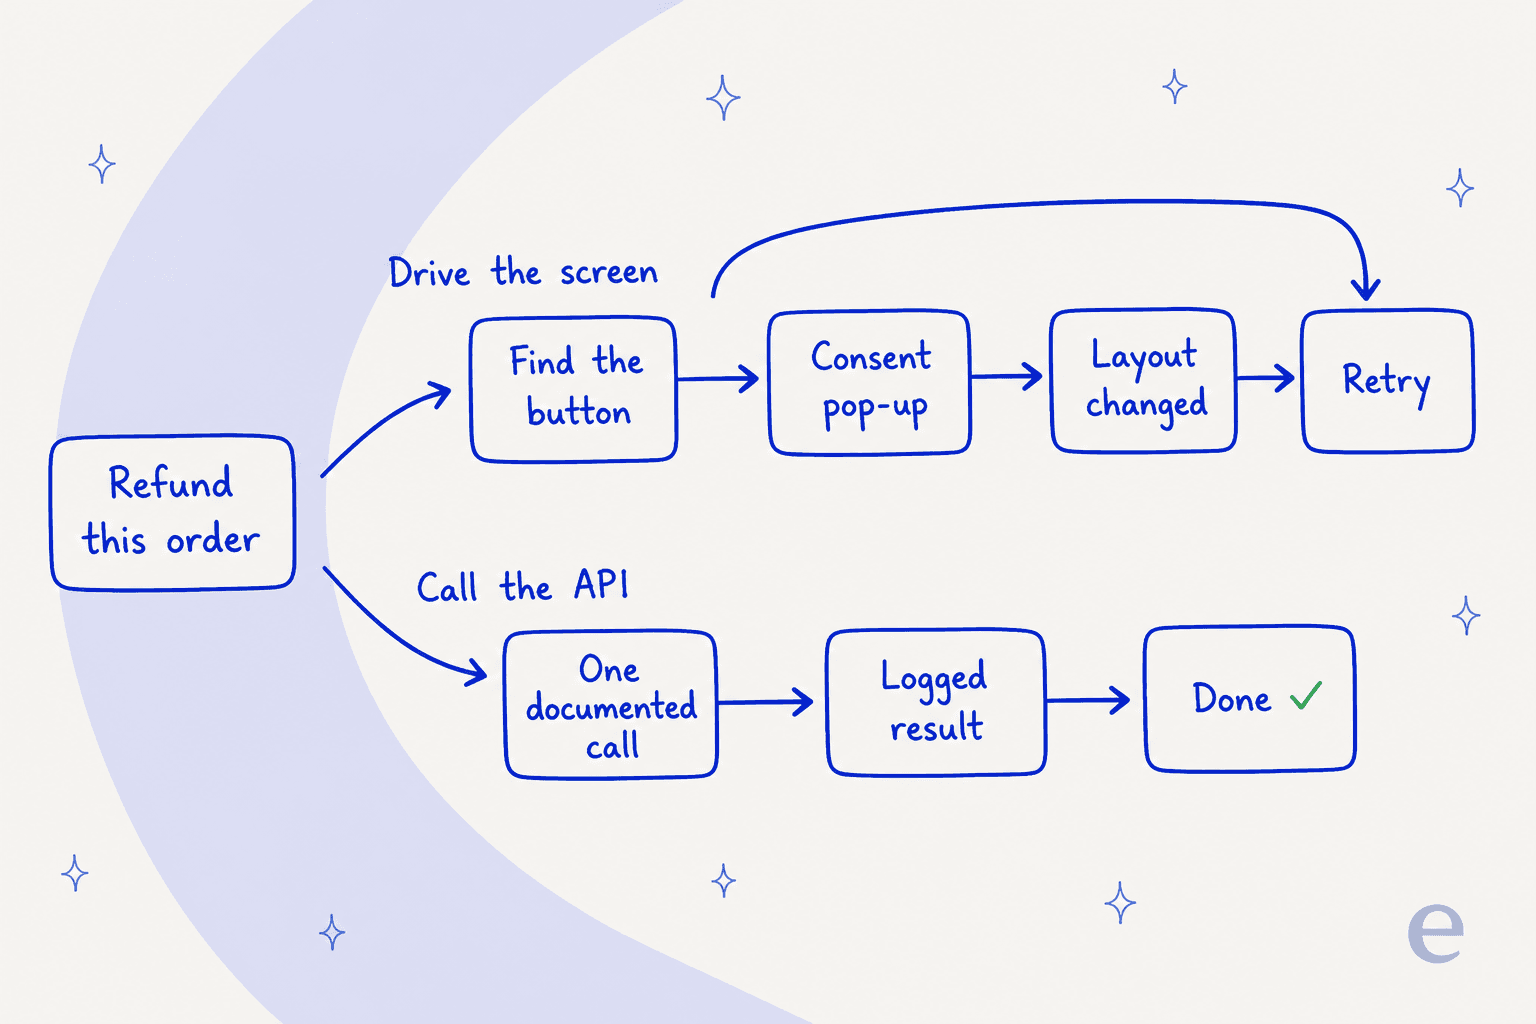
1つ目は先ほどの失敗の表です。広告、ペイウォール、空白ページ、読み違えたフィールドの状態が実機での失敗の大半を占めており、ヘルプデスクのUIにも同じ危険がやや穏やかな形である、という点です。同意バナー、機能紹介のツールチップ、管理者にだけ表示されるモーダル、ズーム倍率が違うと組み替わる表などです。返金フローが、CSSのリリース1回で壊れるようではいけません。使えるヘルプデスクにAPIがあるのには理由があります。Zendesk APIは、ピクセルベースのエージェントが6回のクリックと少しの運で勝ち取るものを、文書化された1回の呼び出しで実現します。公開されたレート制限に基づいて計画できるFreshdesk API v2も同じです。画面操作が適しているのは、APIが提供されなかった社内システムという長い裾野であり、APIがあるものではありません。
2つ目はask_userで、これは称賛の意味で言っています。Alibabaは「止まって人間に確認する」を後付けではなく行動空間に組み込みました。そのためエージェントはAlipayの金額とメモを入力し、支払いのステップで止まります。これはサポートの現場で私が最も多く聞く懸念とまさに同じ形です。月に約7,000件のチケットを扱うCX責任者が私たちにこう語り、それ以来ずっと頭に残っています。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
これは画面に関する機能要望ではありません。確信度の境界を求める要望で、Alibabaがアクションとして実装したのと同じ設計思想です。そこを目指すなら、引き継ぎルールが実践的な出発点です。トリガーの仕組み自体はエスカレーションルールにあります。会話がどちらの振り分けに入るかを最初に決めるのは、たいていチケット分類です。
3つ目はAlibabaが100台のスマートフォンを使って証明したことで、モバイルを超えて一般化できます。シミュレーターの数値は、実環境での挙動を予測しません。それが実機環境を用意した理由のすべてであり、AIエージェントが本番のチケットに答える前に、自社の過去のチケットで走らせる理由でもあります。私たちは数年前、自信ありげなボットが落ち着き払って間違った答えを返すのを見て、痛い目に遭いながらこれを学びました。eeselでシミュレーションを通さずに本番稼働するものがないのはそのためです。この議論のより広い版は、チームが実際にどう測定しているかを扱ったサポートの品質保証にあります。人間側に相当するものはエージェントのコーチングです。
Qwen-UI-Agentへの批判ではありません。これはデバイスを操作するもので、スマートフォンでは非常に優秀です。チケットモデルも、ナレッジベースも、キューも、顧客という概念もないため、おすすめのAIエージェントのまとめや、より絞ったカスタマーサービス向けおすすめAIエージェントのリストにあるツールより一つ下の層にあります。まったく別の仕事です。
カテゴリの全体像が知りたい場合は、AIエージェントの例で各タイプがどこで役立つかがわかります。AIエージェントとチャットボットは、購入者が実際に知りたい境界線を引き、ルールベースのチャットボットはその前の世代を扱っています。
eeselを試す
キューの周りでクリックして回るAIではなく、キューをさばくAIが欲しいなら、それが私たちの作っているものです。eeselはすでにお使いのヘルプデスクのAPIを通じて接続し、推測するのではなく過去のチケットとヘルプセンターから学び、お客様が返信を目にする前に、実際のチケット履歴でシミュレーションを実行します。合格率、不足している点、修正すべき文面が最初にわかります。料金は席数ではなく処理したチケット数に応じて課金されるため、閑散とした月は繁忙な月より安くなります。

この承認パネルは、ask_userの考え方を本番で形にしたものです。エージェントが実行しようとしたツール操作のすべてについて、人間が承認したか、却下したか、まだ判断していないかがわかります。
概要を知りたいならヘルプデスクAIから、特定の数値を目指すならチケットのデフレクションから、まだ比較中ならサポート自動化ツールから始めてください。
そうでなければ、eeselを無料でお試しください。通話は不要です。
では、結局どこに位置づくのか
Qwen-UI-Agentは、オープンなアーキテクチャの中規模モデルが、最先端の汎用モデルよりも上手にスマートフォンを操作できることを示す、これまでで最も強力な公開された証拠です。MobileWorldで82.1%対Opus 4.8の67.5%は端数処理の誤差ではなく、従来の専用モデルの最高値を38.2ポイント上回るのは飛躍的な進歩です。ハイブリッドな行動空間は正しい発想で、バッチ処理は正しい最適化です。Alibabaは自社に都合のよくない部分も報告しており、これは本来あるべき水準よりまれなことです。
一方で、利用できず、欧米のアプリスタックでは未検証で、デスクトップでは2位、英語の調査では26ポイント遅れています。リーダーボードの先まで読むなら、表10にしてください。敵はモデルではなく画面です。それはインターフェースがDouyinでも、皆さんのヘルプデスクでも同じです。APIがあるならAPIを使ってください。ないところでは、いずれこの系統の研究がその隙間を埋めるでしょうし、だからこそ注目する価値があります。
その間、四半期の成果を左右するのは地味な問いです。AIナレッジベースは、そこから回答できるほど十分か。チケットルーティングは、AIが触れる前に適切な場所へ振り分けているか。
次にお金の問いです。ベンダーの想定ではなく、実際の件数でのAIエージェントと人間のコスト比較です。そして位置づけの問いもあります。AIチームメイトの売り文句とAI従業員のそれは、マーケティングが示唆する以上に食い違っているからです。
最後に、後回しにされがちな問い。今使っているものから移行する価値がAIチケットシステムにあるかどうかです。Alibabaのほかのラインナップについては、Qwenの代替がまとめ、Qwen3.8-Maxレビューがこの記事に最も近い関連記事です。
よくある質問
Qwen-UI-Agentとは何ですか?
Qwen-UI-Agentはオープンソースですか、ダウンロードできますか?
QwenのUIエージェントはClaudeやGPTと比べてどのくらい優れていますか?
Qwen-UI-Agentの料金はいくらですか?
GUIエージェントにヘルプデスクを任せられますか?
実際のチケットでエージェントが間違えたらどうなりますか?
ask_userアクションがあり、支払いや削除の前に止まれます。これはサポートにおける確信度のしきい値と同じ考え方で、自信のあるものは自動で回答し、残りは人に引き継ぎます。設定方法は引き継ぎルールとエスカレーションルールのガイドで解説しています。