Qwen-UI-Agentの代替: 2026年に実際に使える8つのGUIエージェント

Rama Adi

Katelin Teen
最終更新 August 24, 2026
Qwen-UI-Agentから乗り換えることはできません。乗り換え元となるものがまだ存在しないからです。AlibabaのTongyi MAIチームは2026年7月30日に優れたモバイルの数値を載せた技術レポートを公開しましたが、その後チェックポイントもAPIも価格も出していません。Hugging Faceの組織には4つのモデルが並んでいますが、このモデルはありません。つまり代替を探すことは、実在するGUIエージェントを探すことに他なりません。
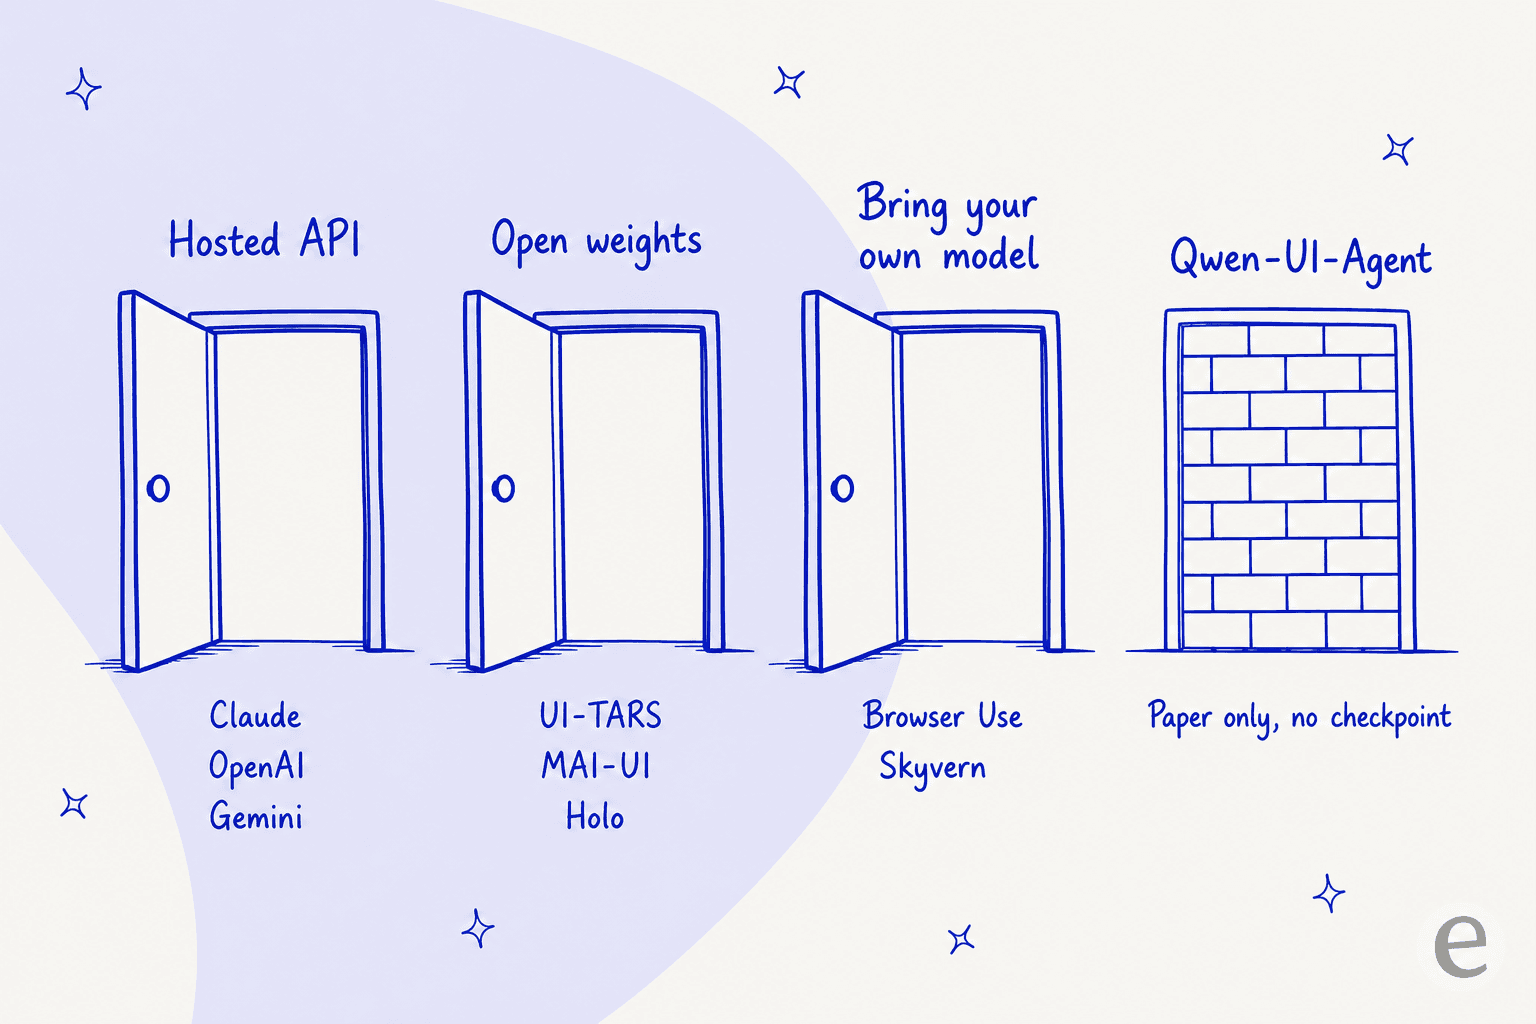
実在するのは8つで、順位ではなく3つの道に分かれます。Anthropic、OpenAI、Googleのホスト型APIは最も強力なモデルと最良の安全機構を提供し、GoogleだけがAndroidも操作できます。UI-TARS、MAI-UI、Holo 3.1のオープンウェイトはApache 2.0と自分で管理できるノートPCを提供しますが、精度は実際に落ちます。Browser UseとSkyvernは独自のモデルも謎も持たず、指定したLLMでChromiumを操作します。Webタスクを終わらせる最も安い方法です。
意外だったことが2つあります。ダウンロードできるオープンウェイトのGUIエージェントはすべてQwenのファインチューニングなので、Alibabaを離れるのはアーキテクチャの話ではなくライセンスの話です。そしてQwen-UI-Agent自身のトレースでは、最も難しいデスクトップベンチマークでアクションの55.1%がクリックではなく入力されたコマンドでした。世界最高の画面操作エージェントは、可能なら画面を避けるのです。想定している仕事がサポートチケットなら、このヒントを受け取ってください。eeselはZendeskやGorgiasとAPIで連携し、先月のチケットでドライランを実行できます。マウスにはできないことです。
この検索で人々が本当に探しているもの
私は仕事で連携機能を作っているので、新しいエージェントモデルを見ると最初にエンドポイントを探します。Qwen-UI-Agentにはそれがありません。
残念なことです。Alibabaは普通、きちんとリリースするからです。Qwenの代替のまとめやQwenのレビューから来た方は、テキストモデルには公開された料金表と実際のエンドポイントがあることをご存じでしょう。このモデルにはありません。
報道が正確でなかったので、ここは正確に述べる価値があります。プロジェクトサイトにあるボタンはちょうど3つで、技術レポート、GitHub、デモ動画です。GitHubリポジトリのスターは2.2kで、リリース、タグ、パッケージはいずれもゼロです。Hugging FaceのTongyi-MAI組織が公開しているのはZ-Image、Z-Image-Turbo、MAI-UI-8B、MAI-UI-2Bで、リストはそれだけです。READMEにはApache 2.0とありますが、図だけのリポジトリのライセンスは、実行できるモデルではありません。
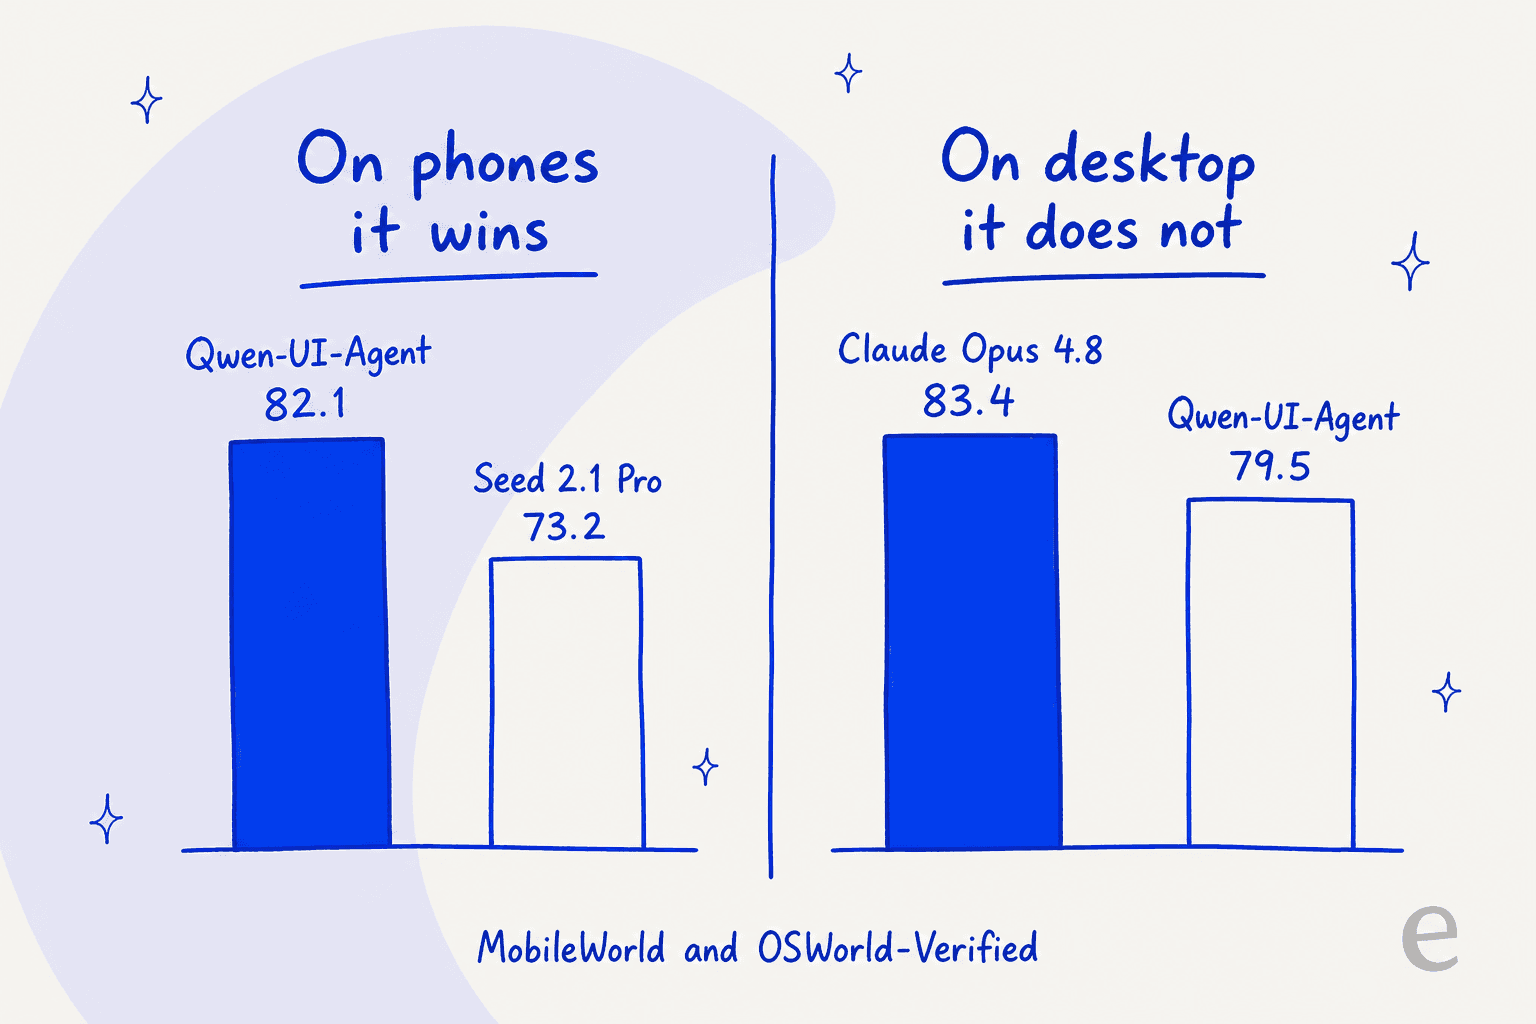
だからといって研究の価値が下がるわけではありません。技術レポートによれば、論文の看板は著者がエンドツーエンド評価の主力モデルと呼ぶ27Bの派生で、スマートフォンでは公開されたなかで文句なしに最高です。MobileWorldで82.1%(Seed 2.1 Proは73.2)、104のライブAndroidアプリにわたる409タスクのホールドアウトベンチマークで92.2%、しかも100台超の実機で実行されています。この最後の数字が興味深いのは、エミュレータではなく実機で測定されているからです。
デスクトップでは、話が伝わるうちに平坦化されます。広く共有された週次まとめはこう書きました。
"Alibaba also released Qwen-UI-Agent, a 27B GUI agent model that claims top scores on MobileWorld (82.1%), OSWorld-Verified (79.5%), and WebArena (73.6%), beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro."
真ん中の数字については、Alibaba自身のグラフが違うことを示しています。OSWorld-VerifiedではClaude Opus 4.8が83.4、Qwen-UI-Agentが79.5で、論文はOpus 4.8に次ぐ2位であることをはっきり述べています。より難しい長期タスクセットOSWorld-v2では、部分的な進捗でOpus 4.8の54.8に対して40.0と差が広がります。「上回った」という主張はモバイルとWebArenaでは成り立ちますが、多くの購入者が引用するデスクトップのベンチマークでは成り立ちません。
このカテゴリには、誇大な約束をしてきた歴史があることも思い出す価値があります。Adept AIは画面をクリックする最初の本格的なエージェントACT-1を出した後、方向転換しました。Rabbit AIは大規模アクションモデルを消費者向けガジェットで売りました。ソフトウェアを操作するエージェントのデモが現実を先行したことは以前にもあり、この記事のすべてのグラフを2回読む十分な理由です。
そこで、この記事全体の誠実な位置づけはこうです。あなたは製品を置き換えるのではなく、最初の1つを選ぶのです。そして選択はスコアよりも、3つの扉のどれを通るかで決まります。
中立のリーダーボードは何と言っているか
前のセクションの数字はほぼすべてベンダー自己申告で、Alibabaも含みます。そこで、リストの前に、売るものを持たない誰かが実行した同じベンチマークを見ておきます。
OSWorld-Verifiedにはメンテナーが運営するボードがあり、OSWorldチームが統一設定のもと同じ361タスクで提出物を自ら評価します。ページ上ではテーブルとして表示されず、スプレッドシートからクライアント側で読み込まれるため、そのファイルから上位8件のベスト実行をここに示します。
| 順位 | エージェントまたはモデル | 機関 | 種類 | 成功率 |
|---|---|---|---|---|
| 1 | Intelligence-Indeed Agent | Intelligence Indeed | エージェントフレームワーク | 90.19 |
| 2 | claude-fable-5[1m] | Anthropic | 汎用モデル | 85.96 |
| 3 | Pointer Agent w/ Opus 4.7 | Pointer | エージェントフレームワーク | 83.64 |
| 4 | claude-opus-5[1m] | Anthropic | 汎用モデル | 83.39 |
| 5 | Coasty CUA v1 | Coasty Team | 汎用モデル | 82.81 |
| 6 | Holo3-35B-A3B | H Company | 特化型モデル | 82.56 |
| 7 | Pointer Agent w/ Sonnet 4.6 | Pointer | エージェントフレームワーク | 81.45 |
| 8 | Muse Spark 1.1 | Meta Superintelligence Labs | 汎用モデル | 80.67 |
ここから3つのことが分かり、そのすべてがこの記事を形づくりました。
**Qwen-UI-Agentは載っておらず、載ることもできません。**ボードの提出ルールは、会議を設定してメンテナーが自分たちの側であなたのエージェントコードを実行するというものです。チェックポイントもAPIもなければ、実行するものがありません。66件のシート全体でAlibabaのエントリは、Qwen 3.7 Plusの73.3とGUI-Owl-1.5 32Bの55.44だけです。Alibabaの自己申告79.5を額面どおりこの表に入れると、66件中9位で、上位8件の外になります。
**首位はモデルではなくハーネスです。**上位12件のうち5件は他社のモデルを包むエージェントフレームワークで、1位のエントリもその1つで90.19です。モデルを買えば終わりと期待していたなら、ボードが示しているのは、足場のほうが重みより多くの点を稼ぐということです。
**オープンウェイトのモデルが1つ、実際に争っています。**Holo3-35B-A3Bは82.56で6位につけ、H Company自身が発表した78.85を上回っており、H以外の誰かが検証しています。ダウンロード可能なGUIエージェントとして最も信頼できる数字で、私のリストでHoloの順位を押し上げました。
これらの数字を引用する人のために付け加えると、OSWorldの人間のパフォーマンスは72.36%で、上位12件はすべて今やそれを超えています。また名称の落とし穴にも注意してください。AnthropicはOpus 4.8について83.4を自己申告していますが、このシートで83.39の行はclaude-opus-5[1m]というラベルで、Opus 4.8の行はそこにまったく存在しません。数字は一致し、ラベルは一致しません。
選び方と、測ったもの
今週は、各候補のドキュメント、モデルカード、ライセンスファイル、料金表を調べ、ベンダー自身のページで確認できなかったものはすべて除外しました。リストは6つの基準で決まりました。
**今日入手できるか。**論文は代替ではありません。重みがダウンロードできるか、価格つきのエンドポイントがあるか、さもなくば対象外です。
**誰が画面を用意するか。**これらはどれも操作する対象が必要です。VM、ヘッドレスChromium、Androidデバイスなどです。用意してくれるものはほとんどありません。皆が忘れる費用項目です。
**どの画面を操作するか。**ブラウザ、デスクトップ、モバイルは同じ名前を持つ3つの別製品で、どれができるかについてベンダーは同じように誠実ではありません。
**誰のハーネスでスコアが出たか。**この記事の数字はすべて、特に断らない限りベンダー自己申告で、いくつかは改変されたベンチマークで測定されています。そのたびに明記します。その差の大きさは仮定の話ではありません。あるLaunch HNのスレッドで、創業者がSOTAの主張を問われ、1つの文で両方の数字を答えました。
"We've hit 82.8% on OSWorld Verfied(on the official page) and with our latest internal testing we're hitting 85.6% which we've posted"

これは自己測定による2.8ポイントの上乗せで、誠実に述べられています。しかも、中立ボードの数字を私が確認できるベンダーです。このカテゴリのすべてのグラフの裏に、Alibabaのものを含め、似たものがあると考えてください。
**1回の実行にいくらかかるか。**100万トークンあたりの価格ではなく、1回あたりのコストです。これは各ステップが軌跡全体と新しいスクリーンショットを再送するため、ステップ数に支配されます。同じ計算を人件費に当てはめたい場合は、エージェントのコスト比較がそれを行っています。実務家はこれを執拗に追跡しており、その数字は穏やかではありません。
"Numbers I was seeing: - 20 to 50 LLM calls per task - $0.50 to $3.00 per task at Claude Sonnet 4.6 prices - Half the runs drifted off-task halfway through"

**本番前にテストできるか。**実務で最も重要なのに、誰も解決していない点です。テキストエージェントでは、OpenAI Evalsのガイドが示すように、ほぼ解決済みの問題です。出力がマウスの動きになった途端、未解決になります。
コストについて、GUIエージェントの予算の考え方を変えた計算をここに示します。ステップ数をドラッグして、曲線が曲がるのを見てください。
8つの代替を一覧で
| ツール | 最適な用途 | 入手方法 | 操作できる画面 | ライセンスまたは価格 | 公表された最高スコアと誰のハーネスか | 画面の提供者 | 本番前のドライラン | インジェクション対策 | 無料枠 |
|---|---|---|---|---|---|---|---|---|---|
| Claude computer use | 正確さが求められるデスクトップ作業 | ホスト型API、GA | デスクトップ、ブラウザ | Opus 5 $5 / $25 per MTok | 83.4% OSWorld-Verified (Opus 4.8, Anthropic) | 自分 | なし | 分類器がデフォルトで有効 | なし |
| Gemini computer use | スマートフォンとデスクトップを1つのAPIで | ホスト型API、プレビューフラグ | ブラウザ、モバイル、デスクトップ | 3.7 Flash $0.75 / $3.75 per MTok | 83.0% OSWorld-Verified (3.6 Flash, Google) | 自分 | なし | オプトイン、デフォルトはオフ | なし |
| OpenAI computer use | すでにResponses APIを使っているチーム | ホスト型API、GA | デスクトップ、ブラウザ | Sol $4 / $20, Luna $0.20 / $1.20 | 92.8% Online-Mind2Web (OpenAI) | 自分 | なし | ポリシーは公開、実装は自分 | なし |
| ByteDance UI-TARS | 出荷できる寛容なライセンス | Hugging Face上の重み | デスクトップ、ブラウザ、テンプレート経由でAndroid | Apache 2.0 | 27.5% OSWorld オープン8B (ByteDance) | 自分 | なし | なし | 重みは無料 |
| MAI-UI 8B と 2B | ダウンロードできる最も近い親戚 | Hugging Face上の重み | モバイル、デスクトップ | Apache 2.0 | 65.7% ScreenSpot-Pro 8B (Alibaba) | 自分 | なし | なし | 重みは無料 |
| Holo 3.1 | ホスト型の代替を備えたオープンウェイト | 重みとホスト型API | Web、デスクトップ、モバイル | Apache 2.0, API $0.25 / $1.80 | 82.56% OSWorld-Verified, 6位 (メンテナー運営ボード) | 自分、またはHのマネージドエージェント | なし | 文書化なし | 10 RPM、カード不要 |
| Browser Use | 大量に回すブラウザ作業 | Pythonライブラリとクラウド | ブラウザのみ | MITライブラリ、クラウドは月$29から | 87.4% Odysseys (第三者ホスト) | クラウドがChromiumを提供 | なし | 文書化なし | 月10タスク |
| Skyvern | 2FAが立ちはだかるログイン済みフロー | セルフホストまたはクラウド | ブラウザのみ | AGPL-3.0、クラウドは月$29から | 85.85% WebVoyager, 2025年1月 (Skyvern) | クラウドがChromiumを提供 | なし | 文書化なし | 5,000クレジット |
注目すべき列が2つあります。ドライランを提供するところはなく、カテゴリ全体で最大の運用上のギャップです。そして画面の提供者がリストをきれいに分けます。3つのフロンティアラボはモデルを渡してVMの幸運を祈り、Browser UseとSkyvernは動作するブラウザを渡してモデルを選ばせてくれます。
1. Claude computer use
最適な用途は、誤クリックが高くつくデスクトップ自動化です。
**仕組み。**ツールエントリを1つ宣言すると、Anthropicのモデルがアクションを返し、あなたのコードがそれを実行します。現在のバージョンはクライアントツールセットのcomputer_toolset_20260801で、1つの宣言の背後に17のメンバーツールをまとめ、ベータヘッダーは不要です。Fable 5、Mythos 5、Opus 5、Opus 4.8、Sonnet 5で動作し、注目すべきことにHaiku 4.5では動作しません。実際のパイプラインを作る人にとって良い点は、同じtools配列にbashツールとファイルエディタを渡せることで、モデルがタスクの途中でGUIから出てターミナルに移れます。
この道を進むなら知っておく価値のある隣接サービスが2つあります。ループのホスティングと監督のためのClaude Managed Agentsと、OS全体ではなく1つのアプリにエージェントを限定したい場合のClaudeデスクトッププラットフォームです。
**良い点。**スコアはデスクトップで公表されているなかで最高です。Opus 4.8のOSWorld-Verifiedで83.4%、より新しく難しいOSWorld 2.0でOpus 5が70.57%(GPT-5.6 Solは62.6)です。ただ私が本当に評価しているのは安全レイヤーです。公式ツールを宣言すれば、Anthropicはすべてのスクリーンショットに対してプロンプトインジェクション分類器を自動で実行し、反応した場合、モデルは次に動く前に確認を求めるよう誘導されます。Anthropicによれば、推論と並列で実行され、追加レイテンシーはほぼゼロ、追加コストもありません。このリストでこれをデフォルトで有効にして提供しているところは他にありません。
**限界。**モバイルの話は一切ありません。参照環境はコンテナ内のLinux上のX11で、語彙は完全にマウスとキーボードであり、17のメンバーのどこにもタップ、スワイプ、ピンチはありません。つまりQwen-UI-Agentが最も強い軸では代替になりません。Anthropicもレイテンシーを自らの最初の制約として挙げており、自分たちの言葉で、人間が同じクリックをするより遅い可能性があるとしています。そしてトークンのオーバーヘッドは現実です。ツールセット定義は、ピクセルを1つも送る前から、リクエストごとに約4,520入力トークンかかり、スクリーンショット1枚ごとに1,000〜1,800が加わります。実装者向けの罠がもう1つあります。APIは大きすぎる画像を縮小してくれず、拒否します。
価格。
| モデル | 入力 / MTok | 出力 / MTok | キャッシュ読み取り | 備考 |
|---|---|---|---|---|
| Opus 5 | $5.00 | $25.00 | $0.50 | 高速モードはちょうど2倍 |
| Opus 4.8 | $5.00 | $25.00 | $0.50 | 83.4%のスコアを保持 |
| Sonnet 5 | $2.00 | $10.00 | $0.20 | ツールセット対応 |
| Fable 5 | $10.00 | $50.00 | $1.00 | ツールセット対応 |
| Haiku 4.5 | $1.00 | $5.00 | $0.10 | ツールセット非対応 |
バッチは両側を半額にし、1Mのフルコンテキストは段差なしの標準料金で動き、ループがあなたの側で動くためコンピューター利用はゼロデータ保持の対象です。
**結論:**作業がデスクトップで行われ、ミスの影響が単なる煩わしさ以上なら、私はこれから始めます。理由は組み込みのインジェクション分類器です。作業がスマートフォンで行われるならスキップしてください。単にできないからです。懸念が能力ではなくベンダーロックインなら、Claudeの代替のリストが残りの選択肢をカバーしています。2大APIベンダーを直接比較する人は、ベンチマークのグラフよりOpenAIとAnthropicのAPI比較のガイドから得るものが多いでしょう。
2. Gemini computer use
最適な用途は、1つのホスト型エンドポイントでスマートフォンとデスクトップをカバーすることです。
**仕組み。**専用のコンピューター利用モデルはもうありません。Googleはこの機能を、汎用のFlashモデルに付く組み込みのcomputer_useツールに統合し、古いgemini-2.5-computer-use-preview-10-2025はレガシープレビューと表示されています。ツール自体に追加料金はなく、モデルの料金で通常のトークンとして課金されます。座標は0から999のグリッドに正規化されて返り、Googleはこれがクライアント側のツールだと明言しているので、ループは自分で回します。
**良い点。**リストで唯一、モバイル環境を文書化しているホスト型APIで、これは宣伝文句ではなく本物の差別化要因です。3つの別々のアクション表があります。21アクションのENVIRONMENT_BROWSER、GoogleがAndroid向けに最適化と説明し、open_app、list_apps、long_pressを追加してscrollとhotkeyを除いた10アクションのENVIRONMENT_MOBILE、OSレベルのカーソル制御用の17アクションのENVIRONMENT_DESKTOPです。デスクトップの軌跡も急です。OSWorld-Verifiedは3 Flashの65.1から3.5 Flashの78.4、そして3.6 Flashの83.0へと上がり、Anthropicの最高値の半ポイント以内に迫っています。そしてホスト型では群を抜いて最も安いルートです。
限界。ドキュメントは、午後を丸ごと潰すような散らかり方をしています。モデル一覧ページはツールおよびエージェントモデルの下にまだレガシーの2.5モデルしか載せておらず、Googleが公表する最高のOSWorldスコアはコンピューター利用ページに載っていないモデルのもので、コンピューター利用は一般提供のgemini-3.7-flashでさえ「Supported (Preview)」のままです。Googleは3.x系のどのモデルについてもOnline-Mind2Web、WebVoyager、AndroidWorldを再公表していないため、モバイル機能には文書化されたアクション空間はあっても、最新のベンチマークがありません。プロンプトインジェクションの検出はありますがデフォルトではオフで、Anthropicの姿勢とは逆です。これには無料枠が一切ありません。そして推奨モデルの価格は2027年1月1日に2倍になります。
価格。
| モデル | 入力 / MTok | 出力 / MTok | 備考 |
|---|---|---|---|
gemini-3.7-flash | $0.75 | $3.75 | 推奨。2027年1月1日に$1.50 / $7.50へ上昇 |
gemini-3.5-flash | $1.50 | $9.00 | |
gemini-3.5-flash-lite | $0.30 | $2.50 | この記事全体で最も安いルート |
gemini-2.5-computer-use-preview | $1.25 | $10.00 | レガシープレビュー |
**結論:**ブラウザ、デスクトップ、Androidを1社でまとめたいなら、そして実行ごとのコストが決定的な制約なら、これを選びます。ほかの何よりも先にインジェクション検出をオンにし、2027年の予算は値上げ後のレートで見積もってください。きちんとモデル化するならGemini 3の料金の解説にもっと幅広い料金表があり、スクリーンショットがクリック対象になる仕組みはGemini Agentic Visionで扱っています。Googleを他社と比較検討するのは、Geminiの代替の記事の役目です。
3. OpenAI computer use
最適な用途は、スタックがすでにResponses APIで終わっているチームです。
仕組み。computer-use-previewは非推奨で料金表からも消えました。コンピューター利用は現在、GPT-5.6の3つのティアすべてでtools: [{ type: "computer" }]であり、ツール自体に呼び出しごとの料金はありません。ガイドは1つではなく3つのハーネス形態を文書化していて、これは好印象でした。構造化されたUIアクションを返す組み込みループ、すでにお持ちのPlaywrightやSeleniumのハーネスの上に載せるカスタムツール、そしてモデルがクリックと短いスクリプトの記述を行き来するコード実行ハーネスです。アクションの語彙は9種類で、1つずつではなくactions[]配列にまとめて渡されます。
**良い点。**ブラウザの数字はここで抜きん出て強力です。Online-Mind2Webで92.8%、WebArena-Verifiedで67.3%、BrowseCompで90.4%。OpenAIはベンチマークだけでなく顧客事例の結果も公表しており、約30,000の固定資産税ポータルで初回成功率95%、3回以内に100%と報告しています。そしてLunaティアは入力$0.20、出力$1.20で実験を安くしてくれます。
**限界。**モバイルはなく、5通りで確認できます。文書化された2つの環境はどちらもデスクトップで、推奨解像度の名前がデスクトップで、語彙にタップもスワイプも戻るもなく、公表されているベンチマークはすべてデスクトップかブラウザです。安全モデルも逆方向に進みました。一般提供のツールはプレビュー時代のpending_safety_checksハンドシェイクをやめたため、今得られるのは公開された3段階の確認ポリシー、貼り付けて使えるプロンプトインジェクション対策のスニペット、ドメイン許可リストを維持せよという指示で、そのすべてを自分で実装します。消費者向けを前提に計画する前に知っておくべきこととして、ChatGPT agentは廃止され、後継のChatGPT Workのクラウドブラウザは、認証情報を受け付けず、オートフィルやパスワードマネージャーを使わず、Webサイトにサインインせず、支払いを完了しません。OpenAI自身のAPIは、自社の消費者向けエージェントをOnline-Mind2Webで21.9ポイント上回ります。
価格。
| モデル | 入力 / MTok | キャッシュ | 出力 / MTok | 長コンテキスト 入力 / 出力 |
|---|---|---|---|---|
gpt-5.6-sol | $4.00 | $0.40 | $20.00 | $8.00 / $30.00 |
gpt-5.6-terra | $2.00 | $0.20 | $12.00 | $4.00 / $18.00 |
gpt-5.6-luna | $0.20 | $0.02 | $1.20 | $0.40 / $1.80 |
BatchとFlexはどちらも半額、高速モードは2倍で、これらは2026年11月21日までのプロモーション料金です。ローンチ記事ではSolが$5 / $30、Lunaが$1 / $6と記載されていたため、Lunaは現在、自身の定価の5分の1で動いています。さらに、スクリーンショットのループが思ったより早く到達する270Kトークンの長コンテキスト境界があり、無料枠には一切対応していません。消費者向けの数字はAtlasの料金のガイドにあり、こちらは別の製品で別の価格です。
**結論:**ブラウザ優先の選択肢で、周辺システムがすでに関数呼び出しを扱っていて、ベンダーを採用するよりツールを追加したい場合に私が選ぶものです。安全レイヤーのための開発工数を見込んでください。その作業は今やあなたのものだからです。3つのティアが他の場面でどう違うかはOpenAIモデルをご覧ください。
4. ByteDance UI-TARS
最適な用途は、商用製品で実際に出荷できる寛容なライセンスです。
**仕組み。**6つのチェックポイントがByteDance-Seed組織にApache 2.0で置かれており、ゲートもクリック同意もありません。2B、7Bの2種、72Bの2種、そして誰もが実際に使う1.5-7Bです。リポジトリ名はサイズを控えめに表しており、「7B」は実際には8.3Bパラメータ、「72B」は73.4Bです。COMPUTER_USE、MOBILE_USE、GROUNDINGの3つのプロンプトテンプレートが付属し、モバイルはlong_press、open_app、press_home、press_backのアクションを持つ文書化されたモデル機能です。
**良い点。**非商用の但し書きのないApache 2.0で、LICENSEファイル、6つのモデルカードすべて、デスクトップアプリのリポジトリで確認できます。8Bの周辺のエコシステムは、オープンなGUIエージェントのなかで最も厚く、11のファインチューニング、13の量子化、llama.cpp、LM Studio、Jan、Ollama向けに整えられたGGUFビルドがあります。だから月間約808,000回ダウンロードされる一方で、72Bは446回です。今夜、ノートPCで商用利用可能なGUIエージェントを無料で動かせます。
**限界。**目玉のベンチマークは、手に入らないモデルのものです。ByteDance自身のスケール表では、ダウンロード可能な1.5-7BはOSWorldで27.5%、ScreenSpot-Proで49.6%ですが、報道された社内の1.5は42.5%と61.6%です。これは15ポイントと12ポイントの差で、奇妙なことに72Bはどちらも7Bより低いスコアです。Hugging Faceのコミュニティ評価パネルは、7BにScreenSpot-Proで61.6%を帰属させることで状況をさらに濁しており、ByteDance自身の49.6%と矛盾するため、その列は未確定として扱ってください。UI-TARS-2は2025年9月に発表されましたが重みが出たことはなく、Alibabaの報告書がクローズドソースとして挙げていることでも独立に確認できます。ByteDanceは、OSWorld-Verifiedを生んだ修正への貢献者としてクレジットされているにもかかわらず、OSWorld-Verifiedの数字を一切公表していません。
勢いの様子が私が最も重視する部分です。モデルのリポジトリはスター11,374、タグはゼロ、リリースは一度もなく、最後のコミットは2025年9月5日です。デスクトップのモノレポはスター38,697で、最後のコミットは2026年7月です。ツールは生きていて、モデルの系統は凍結されています。インストール可能なアプリはmacOSとWindowsのみでLinuxビルドはなく、インストーラー付きの最後のリリースは2025年8月のv0.2.4で、/releases/latestは添付ファイルがゼロのCLIリリースに解決されます。まさにクイックスタートがクリックしろと言っているリンクです。
リーダーボードを追うのではなく、自分のハードウェア向けに小さなモデルのサイズを検討しているなら、この判断には、どんなベンチマーク表よりも小規模言語モデルの記事のほうが良い枠組みになります。
**価格。**重みは無料です。ホスト型のルートはVolcengine上のdoubao-1-5-ui-tars-250428で、掲載価格は入力100万あたり¥1.75、出力100万あたり¥3.50ですが、そのページは価格をクライアント側で描画するため、予算を組む前に再確認することをお勧めします。またVolcengineは中国リージョンのクラウドです。後継のDoubao-Seed-2.1-Proは¥6と¥30で、別の製品で別の価格です。欧米での導入では、セルフホストか第三者の推論プロバイダーが現実的な道です。
**結論:**スコアではなくライセンスとエコシステムのために選び、42.5%ではなく27.5%を基準に見込んでください。1つのリスクははっきり言っておく価値があります。ByteDance自身の制限事項セクションは、このモデルがCAPTCHAを扱うことを指摘し、それを不正アクセスの懸念と説明しており、Apache 2.0のチェックポイントには技術的な防護がありません。オープンウェイト全般を検討しているなら、Kimi K2.5の代替の記事がその分野の他の価格設定を扱っています。
5. MAI-UI 8B と 2B
最適な用途は、同じ研究室の、実際にダウンロードできるQwen-UI-Agentに最も近いものです。
**仕組み。**AlibabaのMAIチームが実際にリリースした2つのチェックポイントで、2025年12月25日に公開され4日後に発表されました。どちらもApache 2.0で、どちらもqwen3_vlアーキテクチャです。MAI-UI-8Bは4つのシャードにまたがる8.77Bパラメータで16.33 GiB、MAI-UI-2Bは単一の3.96 GiBファイルで2.13Bです。Qwen-UI-Agentの直接の前身であり、そのチームのポストトレーニングが実際に何をもたらすかを知る、最も誠実な代理になります。
**良い点。**同じ研究室、同じ系統、Apache 2.0で、実用的な小ささです。特に2Bは、重みの計算上、8GBのカードに余裕で収まります。どちらにもコミュニティの量子化があり、8Bに7つ、2Bに5つです。そしてMobileWorldベンチマーク自体は、それを首位で突破するモデルがなくても自由にダウンロードできるので、少なくとも誠実に評価できます。
**限界。**モデルカードは注意して読んでください。チェックポイント自身の数字ではなく、ファミリーの旗艦モデルの数字が載っているからです。2Bカードにある76.7%のAndroidWorldの数字は、リリースされなかった235Bモデルのものです。チームが公表したサイズ別の数字は、リポジトリのニュースログにあるズームなしのScreenSpot-Proだけで、同じくリリースされなかった32Bで67.9%、8Bで65.7%、2Bで57.4%です。同じ設定でのQwen-UI-Agentの76.6%に対し、グラウンディングで10.9ポイントと19.2ポイント遅れています。エンドツーエンドの作業では、差はもっと醜くなります。MAI-UIの最良のMobileWorldの結果は41.7%で、82.1%に対して40.4ポイントの差でした。グラウンディングはオープンウェイトでほぼ解決済みの問題です。複数ステップのワークフローを最後までやり遂げることは、そうではありません。
実務上の注意が2つあります。VRAMの数値はどのカードにもリポジトリにもどこにも公表されておらず、上の数字はベンダーの主張ではなく重みサイズからの私の計算です。そしてHugging Faceの推論プロバイダーはどちらのモデルも提供していないため、ローカルが唯一の道です。
**価格。**無料でApache 2.0で、費用はすべてGPU時間です。
オープンウェイト全体が期待値をどう設定しているかの背景として、Mistral AIはこれら2つのカードのどちらよりも詳細なチェックポイントごとの情報を公開しています。DeepSeek V3.2も同様です。
**結論:**Qwen-UI-Agentがどうなるかを理解するにはここで最も興味深いモデルで、実際に作業をするには最も弱いものの1つです。私なら8Bを動かしてアクション空間を学び期待値を調整し、顧客の目に触れるものにはホスト型APIを使います。MAI-UIのコレクションが今も2項目のままで、最終更新が2026年1月6日、Qwen-UI-Agentの発表の6か月前であることも示唆的です。
6. Holo 3.1
最適な用途は、フォールバック用のホスト型エンドポイントも欲しいオープンウェイトです。
**仕組み。**パリに拠点を置くH Companyは12か月で5世代を出荷し、Holo 3.1は2026年6月1日に登場しました。珍しいのは、同じチェックポイントが2通りで販売されていることです。HのAPIは、Holoがブラウザやデスクトップのエージェントの頭脳になるエージェントループモードと、画像とターゲットの説明を渡して0から1000のグリッド上の{x, y}を受け取る要素ローカライズモードを文書化しています。この2つ目のモードのおかげで、他者のエージェント内にそのまま組み込めるグラウンディング部品になり、これはどのフロンティアAPIも提供していません。
**良い点。**記事全体で唯一、目玉の数字を鵜呑みにしなくてよかったエントリです。Holo3-35B-A3Bは、メンテナー運営のOSWorld-Verifiedボードで82.56%の6位につけ、MetaのMuse Spark 1.1より上で、AnthropicのOpusの行と1ポイント以内で、上位6件にいる唯一の特化型オープンウェイトモデルです。Hが公表したHolo3の主張は78.85%だったので、今回はベンダーが自分を過小評価しました。
それに加えて、Holo 3.1はHがこれまでで最も寛容なリリースです。0.8B、4B、9B、35B-A3Bのエキスパート混合までを含む7つのチェックポイントがすべてApache 2.0で、旗艦のFP8、NVFP4、Q4 GGUFビルドもあります。Hは、量子化ビルドがOSWorldでBF16チェックポイントの約2ポイント以内に収まると報告しています。モバイルがこの世代の最大の進歩で、35B-A3BのAndroidWorldは67%から79.3%に上がりました。そしてホスト型の価格はこの記事のどのモデルより低い入力$0.25、出力$1.80で、無料枠は毎分10リクエスト、カード不要です。
限界。ライセンスの寛大さには但し書きがあります。以前の世代では、小さいモデルはApache 2.0、大きいモデルは研究専用というパターンでした。Holo2-30B-A3BとHolo2-235B-A22Bはどちらも、Holo1.5-72Bと同様にCC BY-NC 4.0で、Hを呼ばずに製品で使えるものはありません。そして現在の旗艦は、研究専用以上に進みました。holo3-122b-a10bには重みがまったくなく、APIのみで、Hの自社モデル一覧がそう述べています。Hの2つのページは、小型バリアントのAndroidWorldの数字で1ポイント食い違っています(71%と72%)。Holo 3.1のベンチマーク別グリッドは、テキストではなくモデルカード上の画像の中でのみ公表されています。目玉の総合スコアにはH Corporate Benchmarksが含まれ、これはH独自の合成環境ファクトリーで作られた486タスクなので、このグラフから導かれるパレートの主張は、一部が非公開の宿題で採点されています。そして2026年7月のマネージドComputer-use Agents製品は、料金表を一切公表していません。
価格。
| ルート | 料金 | コンテキスト | 備考 |
|---|---|---|---|
| 重み、Holo 3.1ファミリー | 無料、Apache 2.0 | n/a | 0.8Bから35B-A3B、加えてFP8、NVFP4、GGUF |
holo3-1-35b-a3b API | $0.25 入力 / $1.80 出力 per MTok | 65,536 | 関数呼び出し、無料枠10 RPM |
holo3-122b-a10b API | $0.40 入力 / $3.00 出力 per MTok | 65,536 | 重みなし、関数呼び出しなし |
| Computer-use Agents | 非公開 | n/a | ブラウザとデスクトップは稼働中、モバイルは記載なし |
**結論:**オープンウェイトの選択肢での私の推しで、ホスト型APIよりも実力で前に置く唯一のものです。82.56%がHのボードではなく他者のボードにあるからです。ホスト型で始めてモデルファミリーを変えずにセルフホストへ移りたいチームにも最も形が合い、同じ重みを別のエージェント内のグラウンディングのサブルーチンとして使える唯一の選択肢でもあります。選ぶ世代のライセンスは、思い込まずに読んでください。サイズごとに変わり、現在の旗艦には重みがまったくないからです。
7. Browser Use
最適な用途は、見張りなしで千回回す必要があるブラウザタスクです。
**仕組み。**多くの人が誤って説明する選択肢なので、正確に述べる価値があります。Browser Useはモデルではなくハーネスとして始まりました。Chromiumに対して観察、判断、行動のループを実行するAgentクラスで、LLMはコンストラクタの差し替え可能な引数です。現在はモデルも提供しており、デフォルトがbu-2-0のホスト型bu-*エンドポイントと、オープンウェイトのbu-30b-a3b-previewがあります。しかしハーネスはモデルより前からあり、モデルを必要とせず、プロバイダーの一覧は異例に長いです。Google、OpenAI、Anthropic、Azure、Bedrock、Groq、Cerebras、DeepSeek、Mistral、OpenRouter、LiteLLM、ローカルのOllama、カスタムベースURL経由のOpenAI互換のもの。常に自分のキーを持ち込みます。
**良い点。**110.3kのスター、12.1kのフォーク、ライブラリはMIT、そして鈍っていないリリースの頻度です。クラウドがブラウザを提供する唯一のエントリでもあり、カテゴリ全体で最大の隠れたコストを取り除きます。そして料金は異例に分かりやすく、サブスクリプションは2つのメーターが消費するドル対ドルのクレジットプールを購入するので、実際に見通しが立てられます。
**限界。**ブラウザのみで、彼ら自身もそれをはっきり述べています。すべてのセッションはCDP経由で接続するリモートのChromiumで、APIの表面は/runsと/browsersであり、コンピューター利用エージェントの1つとしてではなく、それに対抗する形で位置づけています。ドキュメントの微妙な罠に注意してください。macOS、Windows、Linuxは、ステルスモードが模倣するフィンガープリントとして登場するだけで、操作されるプラットフォームとしてではありません。1,000を超える連携は、エージェントが呼び出すAPIであり、操作するアプリケーションではありません。
ベンチマークの話も慎重に読む必要があります。よく引用されるWebVoyagerの89.1%は、gpt-4oで、改変されたコードベースとプロンプトを使い、55タスクを除外し、失敗または不明の評価を手動で修正した実行から出たもので、Browser Use自身がその投稿で、このベンチマークは正しいものを実際にはテストしていないと述べています。現在の目玉は、非公開タスクの社内セットで82%の厳密な精度です。最も強い主張は第三者ホストのもので、200の長期WebタスクでOdysseysの1位、87.4%です。またMITはライブラリのみを対象としており、クラウドは別の規約で動き、ドキュメントはCAPTCHA、メモリ管理、並列実行についてクラウドへ誘導することにも注意してください。
価格。
| プラン | 月額 | クレジット | 同時セッション |
|---|---|---|---|
| Free | $0 | チャージのみ、月10タスク | 3、チャージ後は10 |
| Dev | $29 | $29 | 25 |
| Business | $299 | $299 | 200 |
| Scaleup | $999 | $999 | 500 |
プランより、その下にある2つのメーターのほうが重要です。ブラウザインフラはブラウザ1時間あたり$0.02で課金され、これはほぼ無料ですが、マネージドプロキシは1GBあたり$5(Scaleupは$4)、プロキシなしの外向き通信は1GBあたり$0.20です。プロキシ1GBのトラフィックはブラウザ250時間と同じコストなので、真のコストセンターはプロキシです。ホスト型エージェントは基盤プロバイダーの料金の1.2倍で動き、自分のキーを持ち込むと0.2倍のオーケストレーション料金が加わるので、BYOKは節約ではなくコントロールを買うものです。自分のライブラリでBU 2.0を動かすのが最も安い道で、入力$0.60、出力$3.50、ブラウザ時間料金はなしです。エンタープライズプランは公開されておらず、SLAや保持条件は営業経由です。
**結論:**対象がWebサイトなら、フロンティアのコンピューター利用APIではなくここから始めてください。動作するブラウザ、差し替え可能なモデル、予測できる請求が手に入り、第三者によるOdysseysの結果は、この記事で最も信頼できる数字です。単純なスクレイパーと比べている人は、まずWebスクレイピングの代替の記事を読むべきです。エージェント的に見える仕事の多くは、そうではないからです。
8. Skyvern
最適な用途は、2FAが本当の障害になるログイン済みのWebワークフローです。
仕組み。Skyvernは視覚のみではなく、それがこの製品を定義する設計上の選択です。スクリーンショットと簡略化したDOMツリーが一緒にモデルへ渡され、彼らの説明では、画像がレイアウトと視覚的な文脈を、DOMがPlaywrightが狙える要素識別子を提供します。そしてPlaywrightが実行します。認証情報はプロンプトではなくブラウザに注入されるので、モデルがそれを見ることはありません。彼らのアブレーションは好感が持てる形で公開されています。アクター単体でWebVoyagerは約45%、プランナーを足すと68.7%、バリデーターを足すと85.85%です。
**良い点。**ログイン済みWeb作業という退屈な現実を中心に作られている唯一のエントリで、その現実こそ純粋な視覚アプローチが崩れる場所です。4つのエージェントを並べて動かした実務家は、しきい値をこう表現しました。
"the pattern that actually mattered wasn't which agent, it was that any task with login + 3 or more steps breaks on every screenshot-driven approach. … once you drop the browser sandbox and drive the OS accessibility tree directly, you get real element handles instead of pixel guesses and the failure rate falls roughly 4x on long tasks."
SkyvernのDOMとスクリーンショットの設計は、同じ洞察を1つ上の層に適用したものです。さらに、TOTP、メール、SMSの第2要素に対応し、Bitwarden、1Password、Azure Key Vaultをサポートする認証情報の保管庫があり、実行の途中でライブセッションを人間に返す「Take Control」ボタンがあります。Route Memorizationはロードマップの賢い部分で、成功したエージェントの実行を安価なPlaywrightスクリプトにコンパイルし、壊れたときに自己修復するもので、コードキャッシュとしてすでに出荷されています。ステップごとのコストへの正しい答えです。
**限界。**ライセンスには読んでおくべき例外があります。READMEは、コアロジックはAGPL-3.0だが、マネージドクラウドで利用できるアンチボット対策は除くと述べているので、アンチボット層は意図的にリポジトリにありません。セルフホストはソフトウェア費用はかかりませんが、2つの崖があります。自動CAPTCHA解決は存在せず、代わりにエージェントは手動介入のために30秒停止します。CAPTCHAに関する主張も、深く掘るほど狭まります。ホームページでは第三者サービスなしのネイティブ解決と言い、ドキュメントでは特定の種類を挙げたうえで解決は保証されないと言います。ブラウザのみで、彼ら自身の言葉では、Skyvernが動かせるブラウザで起きることなら可能です。WebVoyagerの85.85%は2025年1月のGPT-4oで8タスクを除外したもので、Skyvernは同じページで、その後リーダーボードは進んだと述べています。より新しい数字は、自社のWebBenchで64.4%です。彼ら自身のページの一部も、無料枠のアクション数やプロキシの対応国で互いに食い違っています。
価格。
| Free | Hobby | Pro | Enterprise | |
|---|---|---|---|---|
| 価格 | $0 | 月$29 | 月$149 | 個別見積もり |
| クレジット | 5,000(1回限り) | 月30,000 | 月150,000 | 個別見積もり |
| 推定アクション数 | ~170 | ~1,200 | ~6,200 | 個別見積もり |
| 同時実行数 | 1 | 10 | 25 | 100 |
| 2FAとTOTP | なし | なし | あり | あり |
| プロキシ | データセンター | データセンター | レジデンシャル | レジデンシャル |
ステップごとのクレジットコストは公表されていないため、私が導きました。1アクションあたり約25クレジットで、2つの有料ティアで1ステップあたり約$0.024となり、どちらも同一です。つまりアップグレードで買えるのは、より良い単価ではなく、ボリューム、同時実行、2FAです。典型的なタスクは2〜10ステップなので、約$0.05〜$0.24です。超過料金はどこにも公表されておらず、失敗した実行もクレジットを消費します。
**結論:**専門家の選択肢で、専門家は過小評価されています。仕事が、自分のものではないポータルにサインインし、第2要素の向こうのフォームを完了することなら、どんな汎用のコンピューター利用APIよりも形が合っています。ティアを比較するときは2FAを念頭に置いてください。$29ではなく$149から始まるからです。学習するエージェントとハードコードされたセレクタを比べているなら、AIエージェントとチャットボットの記事がそのトレードオフをうまく整理しています。
Qwen-UI-Agent論文で誰も引用しない数字
ここに、私にとってこのカテゴリを捉え直させた発見があります。競合ではなく、現職自身のトレースから出てきたものです。
Qwen-UI-Agentのアクション空間は純粋にグラフィカルではありません。click、type、drag、long_pressに加えて、bash用のcli_command、api_call、ask_user、terminateを公開しています。つまりモデルがデスクトップタスクを実行するとき、ボタンをクリックするか、コマンドを入力するかを選べます。そして、よくコマンドを選びます。OSWorld-VerifiedではCLIアクションが全アクションの40.7%を占め、タスクの92.0%に現れます。より難しいOSWorld-v2では、これがタスクの98.2%でアクションの55.1%に上がります。
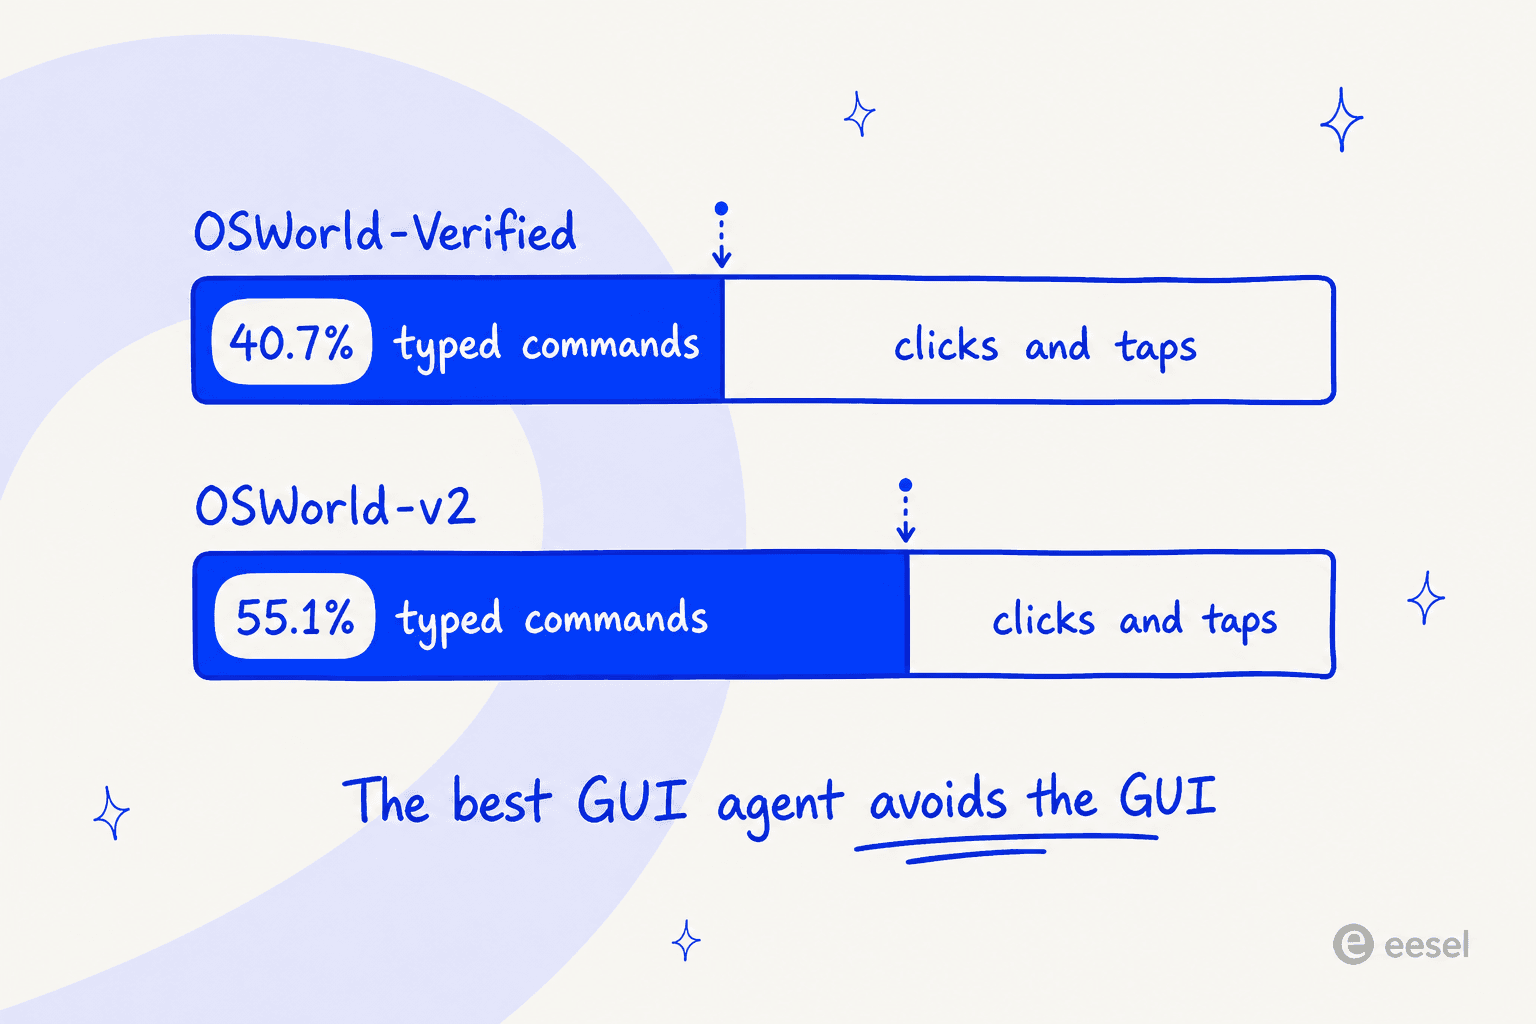
もう一度読んでください。2026年に公表された最高の画面操作エージェントは、自由に選べるとき、最も難しいデスクトップベンチマークでアクションの半分以上を、画面を操作しないことに費やしています。
ByteDanceの数字は反対側から同じことを言っています。UI-TARS-2は完全なツールキットでBrowseCompを29.6%、SDKなしのGUIのみの操作に制限すると7.0%です。これは彼ら自身のアブレーションで、そのスコアの約4分の3がピクセルではなくターミナルとツールへのアクセスから来ていることを意味します。
これが、ターミナルが届くあらゆるものについてエージェント型CLIツールが画面エージェントを静かに上回る理由であり、エンドポイントが存在するときは常にZapier AIのようなAPI優先の自動化がピクセルをクリックする自動化に勝つ理由です。
実際的な教訓は、上の表から何かを選ぶ前に問うべき質問です。**この仕事にはAPIがあるか?**もしあるなら、画面を操作するエージェントは、認証済みの呼び出しで済むことを行う、高価で壊れやすく監査できない方法です。GUIエージェントが価値を発揮するのはAPIがない面で、それは現実の大きなカテゴリです。レガシーな社内ツール、政府のポータル、2009年のデスクトップソフト、連携の仕組みがないベンダーのダッシュボード。ただ、デモが示唆するよりずっと小さいのです。
失敗の半分はモデルのせいではなかった
Qwen-UI-Agentの報告書のもう1つの有用な点は表10で、著者はベースラインのモデルQwen 3.7 Plusを取り上げ、成功率を報告するだけでなく、失敗した実機の軌跡をすべて分類しました。他の研究室がこれを公開するのを見たことがなく、予算の立て方を変えるはずです。
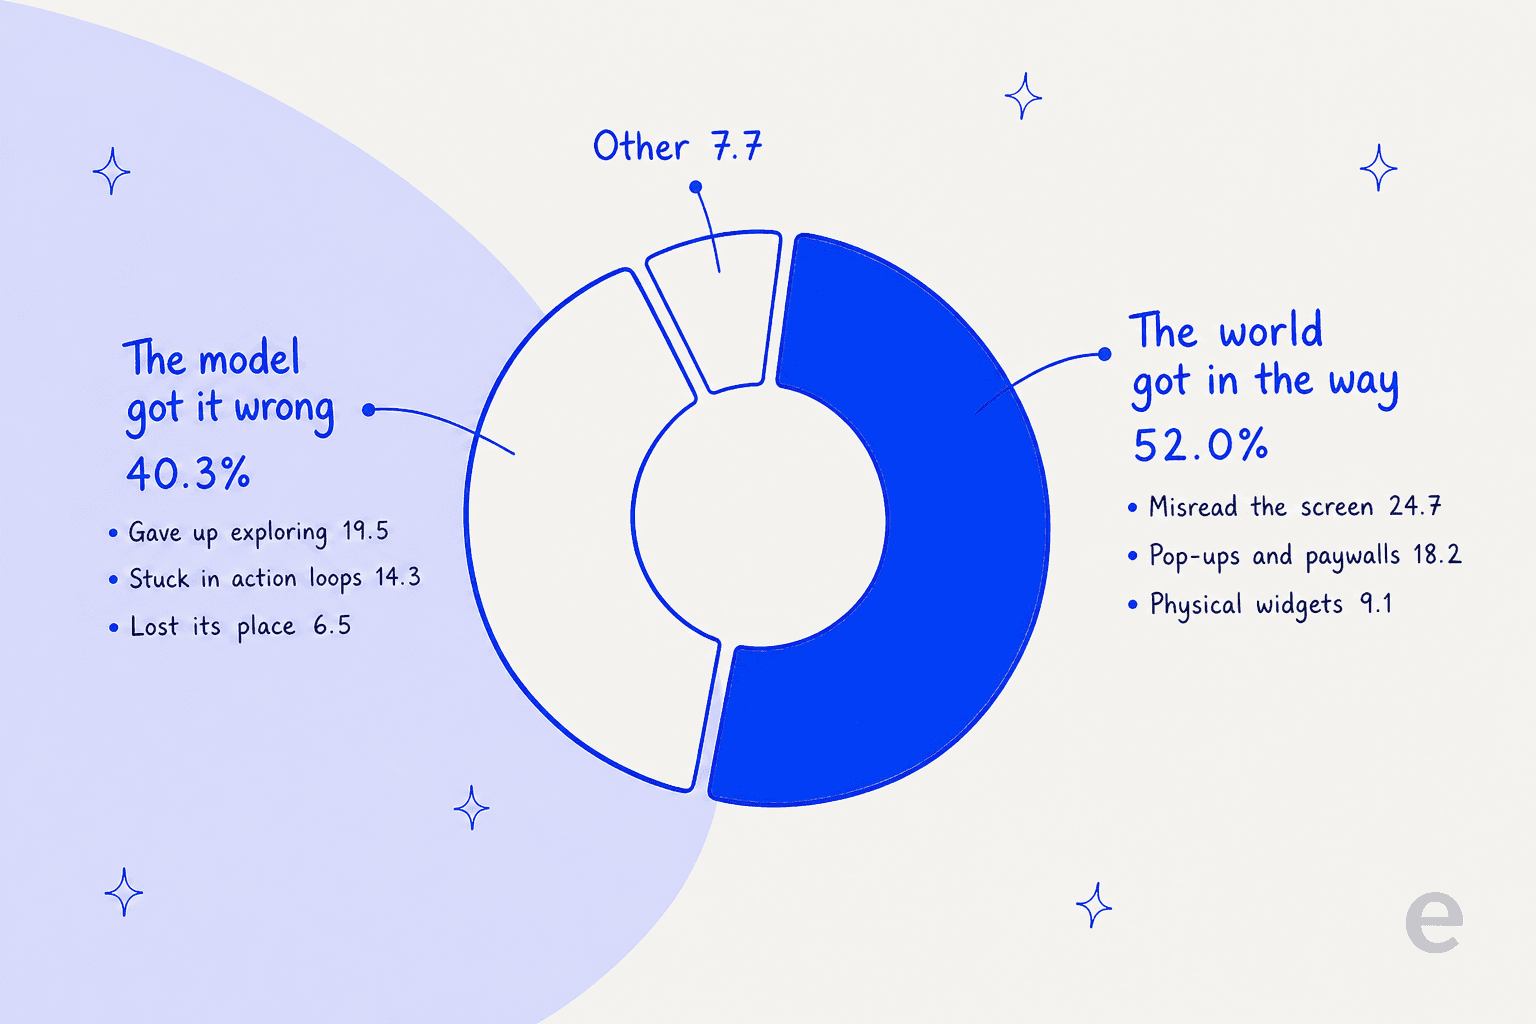
Qwen 3.7 Plusの失敗した実行全体で、現実世界のシナリオ上の課題が**52.0%**を占めます。UIの読み違いが24.7%、ポップアップ、広告、ペイウォール、CAPTCHAによる妨害が18.2%、物理的なウィジェットの問題が9.1%です。実行能力の限界は40.3%で、探索の失敗が19.5%、アクションのループに陥るのが14.3%、実行状態を見失うのが6.5%です。Qwen-UI-Agentはより強いモデルなので内訳は異なるでしょうが、分布の形こそが発見です。
この内訳が重要な理由は、より良いモデルを買っても、小さいほうの半分にしか対処できないからです。モーダルダイアログ、クッキーバナー、ペイウォール、CAPTCHAはモデルの問題ではなく、うまくいかないことの大半を占めます。Browser Useのプロキシの項目やSkyvernのCAPTCHA対応が付随的な機能ではないのも、そのためです。彼らは実際の失敗の分布を攻めており、フロンティアAPIは40%のほうを攻めています。
私はAlibabaの数字に終始頼ってきたので、1つ但し書きを述べておく必要があります。MobileWorld-RealはAlibaba自身のベンチマークで、採点はAlibaba自身のエージェント審査員AutoJudgeによって行われ、論文はこれが専門家が検証した666件の例で92.8%の完全一致精度だと報告しています。著者は審査員の誤りを最初に述べた制限として挙げており、これは正しい姿勢です。デモのアプリも中国の消費者向けエコシステムのものなので、実機での92.2%は、手法についてのシグナルであって、欧米のSaaSについての約束ではありません。
オープンな代替はすべてQwenのファインチューニング
これには意表を突かれました。Alibabaからアーキテクチャ上の逃げ道を探したのに、ありません。
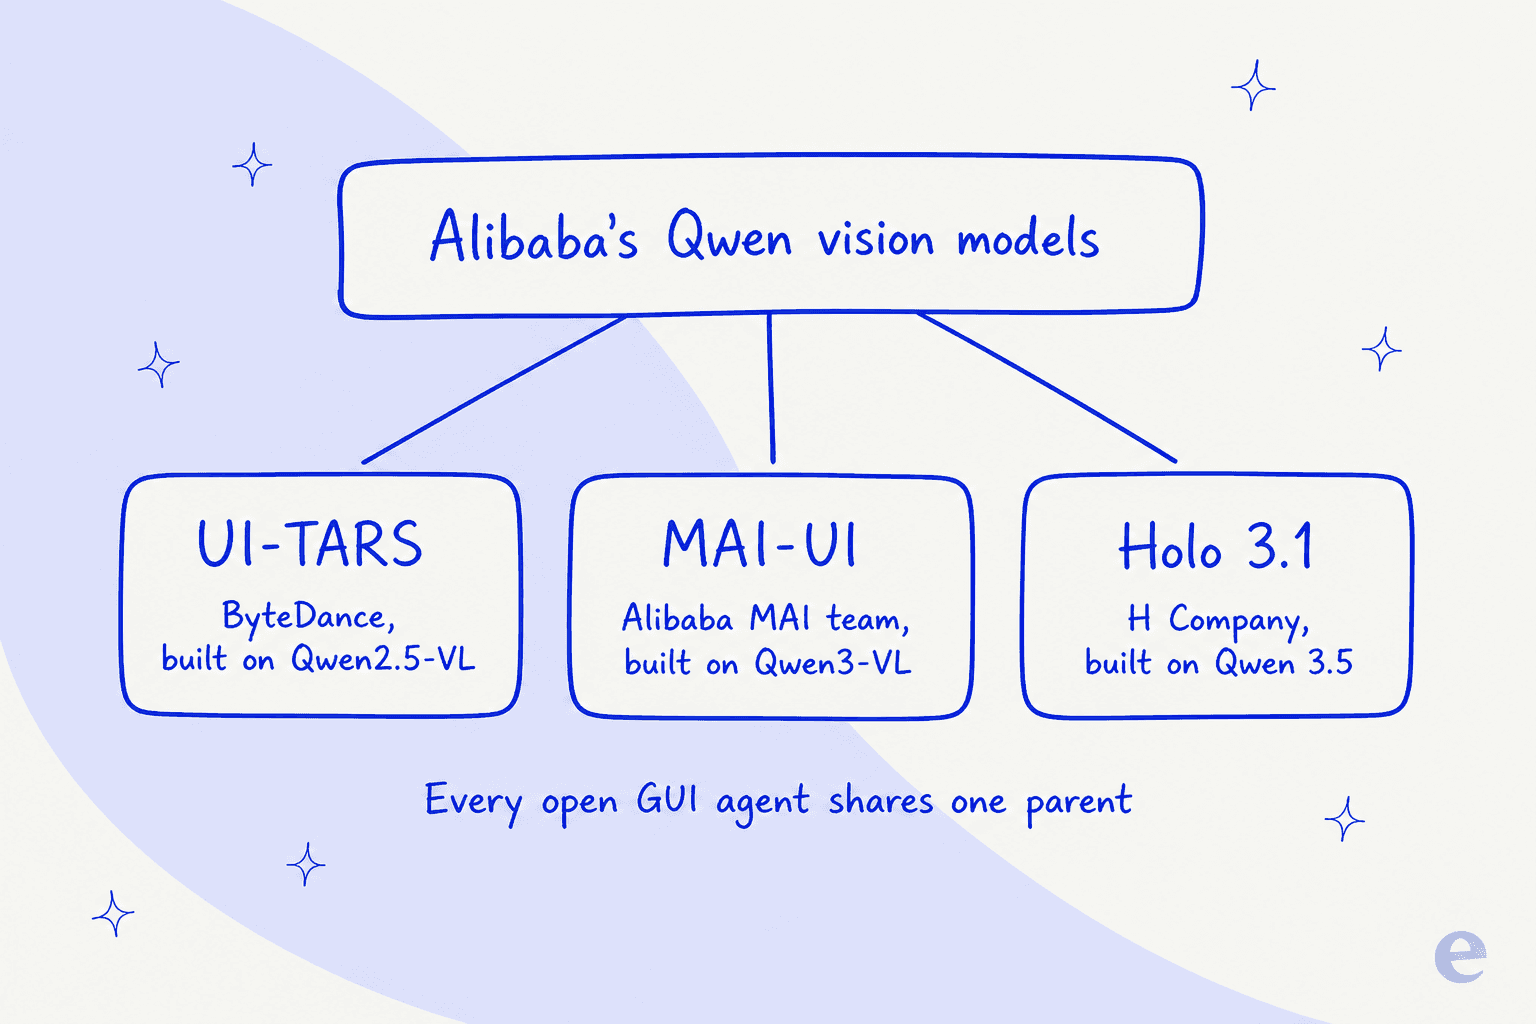
UI-TARS-1.5-7BはQwen2.5-VL-7Bから学習されており、ByteDance自身のSeedページに明記され、Hugging Faceのアーキテクチャタグはqwen2_5_vlです。MAI-UIはqwen3_vlです。Holoのすべての世代はQwenの派生で、Qwen2.5-VLからQwen3-VL、Qwen 3.5ファミリーまで続き、Holo1のライセンスファイルは、製品がQwenで構築されたこと、そして衝突する場合はQwen Research Licenseが優先することを述べています。Holo 3.1のリリースのすべてのベンチマークチャートは、AlibabaのGUIエージェント系統ではなくQwen 3.5ファミリーとHoloを比較しています。
つまりオープンウェイトGUIエージェントで「Alibabaから離れる」とは、ライセンス、法域、ポストトレーニングのチームを変えることであって、基盤アーキテクチャを変えることではありません。特にライセンスが障害になっているなら、それは本当に望む価値のあることで、H Companyの貢献はそれ自体が独自です。GUI特化のポストトレーニング、合成環境ファクトリー、ハーネスです。しかしこの3つのどれかを選んでQwenから逃れたと思うべきではありません。率直な読みは、Alibabaのビジョンモデルがこのオープンなカテゴリ全体の土台であり、だからAlibabaのGUIエージェントがそれを先導しているということです。
外したものとその理由
**Manus。**評価しようとしましたがログインできませんでした。彼らのサイトには現在、2026年8月25日午前8時にアクセスが再開されるという通知が表示されており、特定の法域の規制要件に準拠するため予定されたデータ削除を処理していて、Manusが独立した会社として事業を再開する準備をしているとの説明があります。今日開けなかった製品は推薦できません。再訪の価値はあり、それまでの間はManus AIの概要とManus AIの料金の解説がカバーしています。
**Seed 2.1 Pro。**ByteDanceの現在のフロンティアのコンピューター利用モデルは本物で競争力があり、Alibabaの比較ではOSWorld-Verifiedで78.8%です。しかし中国リージョンのクラウドでのAPI専用で、100万トークンあたり¥6と¥30であり、ByteDance自身のSeed 2.1の発表はUI-TARSに一切言及していないため、多くの報道が前提とする系譜は、主張ではなく推測です。
**GUI-Owl-1.5-32B-Instruct。**Alibabaの表では、これまでで最も強いオープンな特化モデルとして全体に登場しますが、MobileWorldで43.9%対82.1%という世代間の差は、現行の選択肢として推薦するには大きすぎます。
画面を読むだけで行動しないアシスタント。Cluely型のツールは画面を見てアドバイスし、Edge Copilotのようなブラウザのコパイロットは今見ているページを要約します。有用ですが、タスクを完了する仕事とは別なので、ここでは対象外です。
**価格のないものすべて。**H Companyのマネージド版Computer-use Agents製品と、私が見た「お問い合わせください」型のエージェントプラットフォームすべてです。従量課金の製品でベンダーが料金を公表しないなら、購入者は比較できず、私はそうではないふりをするつもりはありません。
仕事がサポートチケットなら、画面は間違った扉
これを検索している人のかなりの部分は、レガシーなデスクトップアプリを自動化しようとしているのではありません。ヘルプデスクを担当するAIが欲しいのであり、画面操作エージェントはそこへ至る汎用的な道に見えます。
私はそれに反論します。代替を作っている立場だからというだけではありません。あなたのヘルプデスクにはすでにAPIがあります。Zendesk、Freshdesk、Gorgias、Front、Jira Service Managementはいずれもチケットを読み書きできるオブジェクトとして公開しており、つまり画面操作エージェントは、そのチケットを見て探し、クリックして見つける道をわざわざ選んでいるのです。だから、専用のチケットトリアージツールやAIヘルプデスクエージェントは、同じキューで画面自動化を上回ります。レイアウトの変更、モーダル、A/Bテストのすべてが新しい故障モードになり、上の表10によれば、その種の問題が壊れることの大半を占めます。
さらに、本番でこれを運用しているチームが痛い目にあって見つけた、より微妙な問題があり、今週読んだなかで最も鋭いものです。
"we run screen-driven agents against web forms in production and the failure mode that took us longest to find wasn't navigation, it was commits that don't commit. a react controlled select can render the right value after a click while the framework's internal state never updated, so every pixel says done and the submitted payload says null. vision-only verification passes because the screen genuinely looks correct."
すべてのピクセルが完了と言い、送信されたペイロードはnullと言う。これがチケットキューにおけるピクセル駆動エージェントのリスクのすべてを1行で表しており、そのスレッドで問われたベンダーもそれを認めました。彼らのエージェントは画面駆動なので、ピクセルがすべての隠れた状態遷移を証明できるとは主張しません。APIの呼び出しは、200を返したか返さなかったかのどちらかです。
より大きな問題はテストです。この記事のどのベンダーも、隔離されたVM、ドメイン許可リスト、人間による確認を推奨していますが、自社の過去の作業に対するドライランを提供するところは1つもありません。このギャップは学術的なものではありません。サポートリーダーが最初に尋ねる質問であり、ほぼ次のような言葉で出てきます。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
これは、GorgiasとShopifyで月に約7,000件のチケットを扱う、サプリメントのD2Cブランドのカスタマーエクスペリエンス責任者の言葉です。GUIエージェントにはこれに対する答えがありません。クリックには信頼度スコアがなく、AIエスカレーションに相当するものもないからです。ここではモデルの選択よりも検索のほうがはるかに重要で、サポートに最適なLLMの記事がそれを扱っています。
この部分は、理論ではなく痛い経験から学びました。初期に、有料のeeselアカウント3つで、ハードなフォールバックがなかったために、検索結果が空のとき回答をでっち上げるボットがありました。1つは太陽電池に関するサブスクリプションの主張をでっち上げ、実際の顧客に送信しました。別の1つは製品の質問に対して、周期表からそのまま「Oxygen」と答えました。製品が私に嘘をついていたわけではなく、達成していない成功を語っていただけで、GUIエージェントがボタンをクリックしたと報告するのと同じ種類の主張です。違いは、APIの呼び出しは確認できる記録を残し、座標は残さないことです。その出来事が、すべての導入が顧客に近づく前に過去のチケットでシミュレーションされるようになった理由であり、プロンプトではなく設計によってハルシネーションを防ぐための、私が知る最も強い論拠です。
ヘルプデスクにeeselを試す
本当に必要なのが、ロボットのマウスではなくチケットキューのAIチームメイトなら、それがeeselです。Zendesk、Freshdesk、Gorgias、Front、Help Scout、HubSpot、Salesforce Service Cloud、Jira Service ManagementとAPIで連携し、名前付きのツールを呼び出すので、1つのアクションは、誰かが正しいピクセルに落ちることを願う座標ではなく、記録されたAPI呼び出しです。
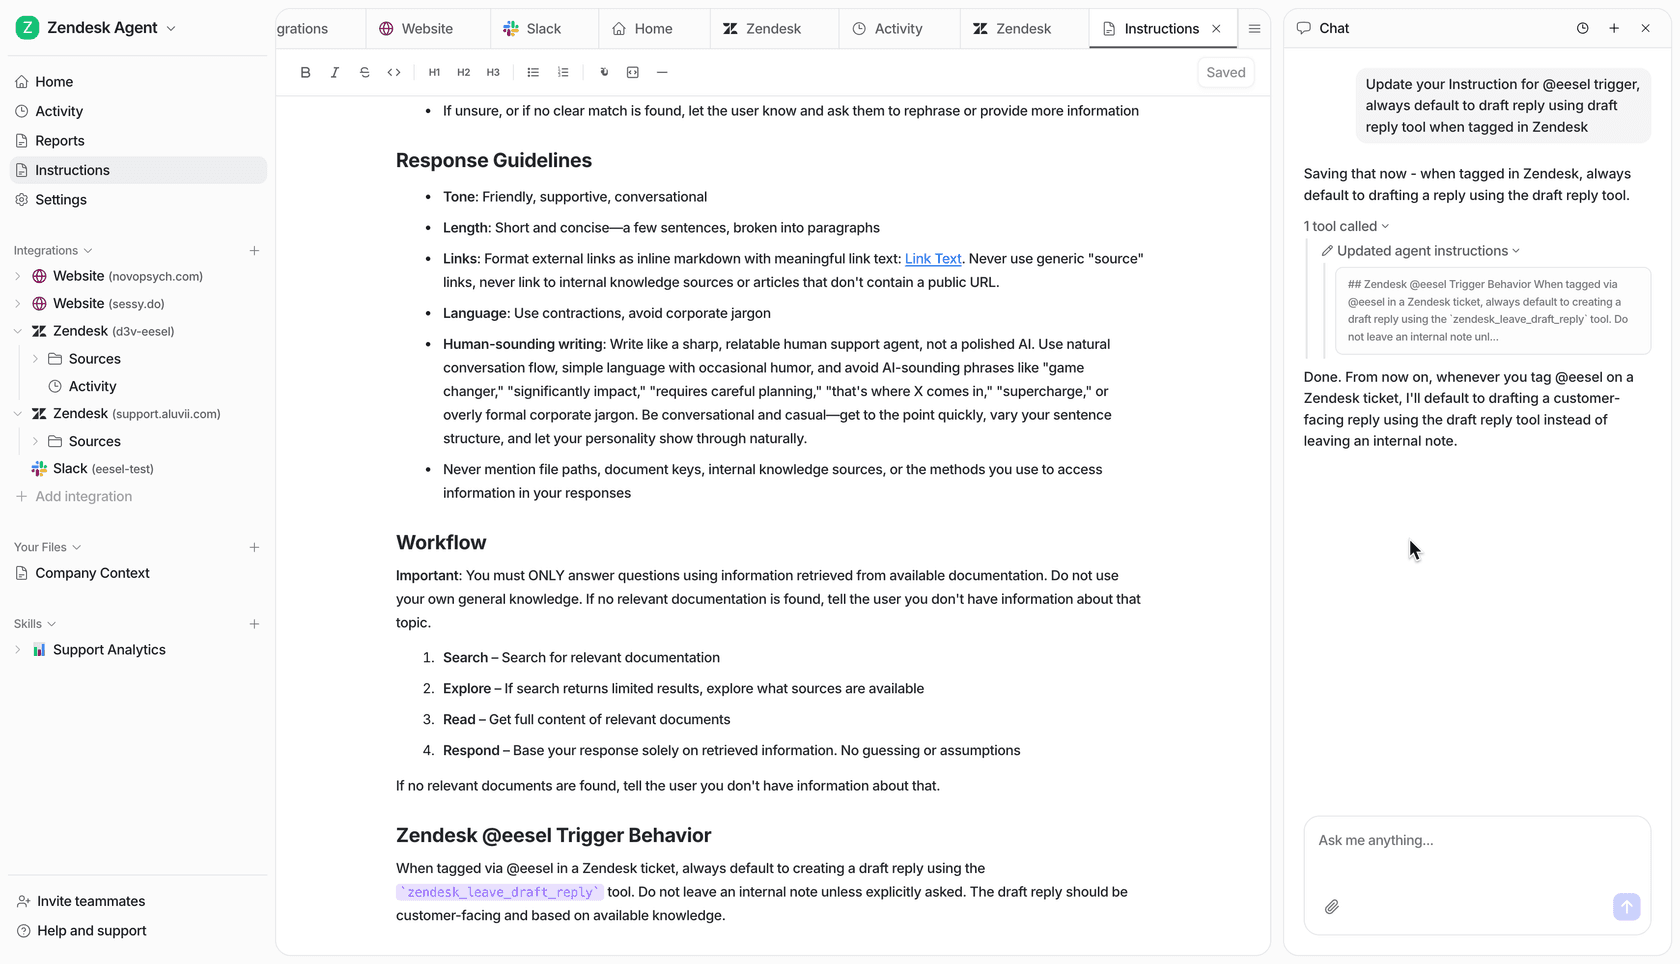
テストできないエージェントについて8つのセクションを読んだばかりの方にとって最も重要な部分は、シミュレーションです。自社の過去のチケットに向けると、実際の返信を一切送らずにサンドボックスでエージェントのパイプライン全体を実行し、審査員が各回答を採点し、チームが実際に送ったものとの並列比較を表示し、各回答を「完璧」「許容」「失敗」にマークし、テーマごとのカバレッジのギャップと、指示の修正案を返します。それからもう一度実行します。これが、この記事のどれも提供していないドライランです。
料金は、上のウィジェットが示唆するとおりに機能します。固定の月額料金で、500クレジットで月299ドルから、1クレジットはやりとりするメッセージの数に関係なく1チケットまたは1チャットで、プラットフォーム料金も席ごとの料金もありません。1,000件のチケットのうち200件をルーティングすれば、その200件だけがクレジットを使います。月1,000クレジットは499ドルです。同じチケットがその日のUIの都合でいくらかかるか分からないステップごとのメーターと比べてください。正直な但し書きが1つあります。結果が完璧でもそうでなくてもクレジットは消費されるので、これは解決したチケットあたりではなく、対応したチケットあたりです。
グラウンディングがもう半分です。eeselは画面を見るのではなく、既存のヘルプセンター、ドキュメント、過去のチケットを読み取ります。ナレッジベースで学習させる方法とナレッジベースを接続する方法のガイドで、実際の仕組みを扱っています。
本番での様子について、Gridwiseは7日間のトライアルの後、最初の1か月でティア1のリクエストの73%を解決したと報告し、SmavaはZendesk上でドイツ語で月に10万件を超えるチケットを完全自動で処理しています。まず広い市場を見たいなら、カスタマーサービスAIのまとめが誠実な比較です。
100の無料クレジットで始められます。カード不要で、全機能が使えます。**eeselを試す**か、決める前にまず先月のチケットに向けてスコアを確認してください。