2026年版 Claude Sonnet 5.5の代替モデル best 8(乗り換える理由別)

Kurnia Kharisma

Katelin Teen
最終更新 September 29, 2026
なぜClaude Sonnet 5.5の先を探すのか
まず公平に。Sonnet 5.5はClaude Sonnet 5から大きく進歩しています。Anthropicのローンチ表では、Terminal-Bench 4.0で70.6%とOpus 5.5の66.4%を上回り、ZendeskはAnthropicに、これを使うとチケット処理が20%速くなったと伝えています。Sonnet 5.5のレビューでそのすべてを取り上げており、同僚の結論(Mediumのeffortなら素晴らしい)は今も変わりません。
私はSEOに2年携わってきたので、このモデルをめぐる検索行動は、ベンチマークより先に何かを教えてくれました。「Sonnet 5.5 alternatives」はローンチの翌日に出始めました。モデルを使い倒して物足りなくなるには早すぎます。人々が検索していたのは、何かが壊れたか、請求額に驚いたからです。この4つの理由に沿って、以降を構成します。
理由1:破壊的変更が5つ、うち1つはボットを直撃する
Anthropicは、Sonnet 5で動いていたコードに対する5つの破壊的変更を挙げています。thinking: disabledは400を返すようになり、between_toolsを案内されます。旧computer_20251124ツールはClaude APIとGoogle Cloudで拒否されます。一部のadvisorツールの組み合わせも拒否されます。
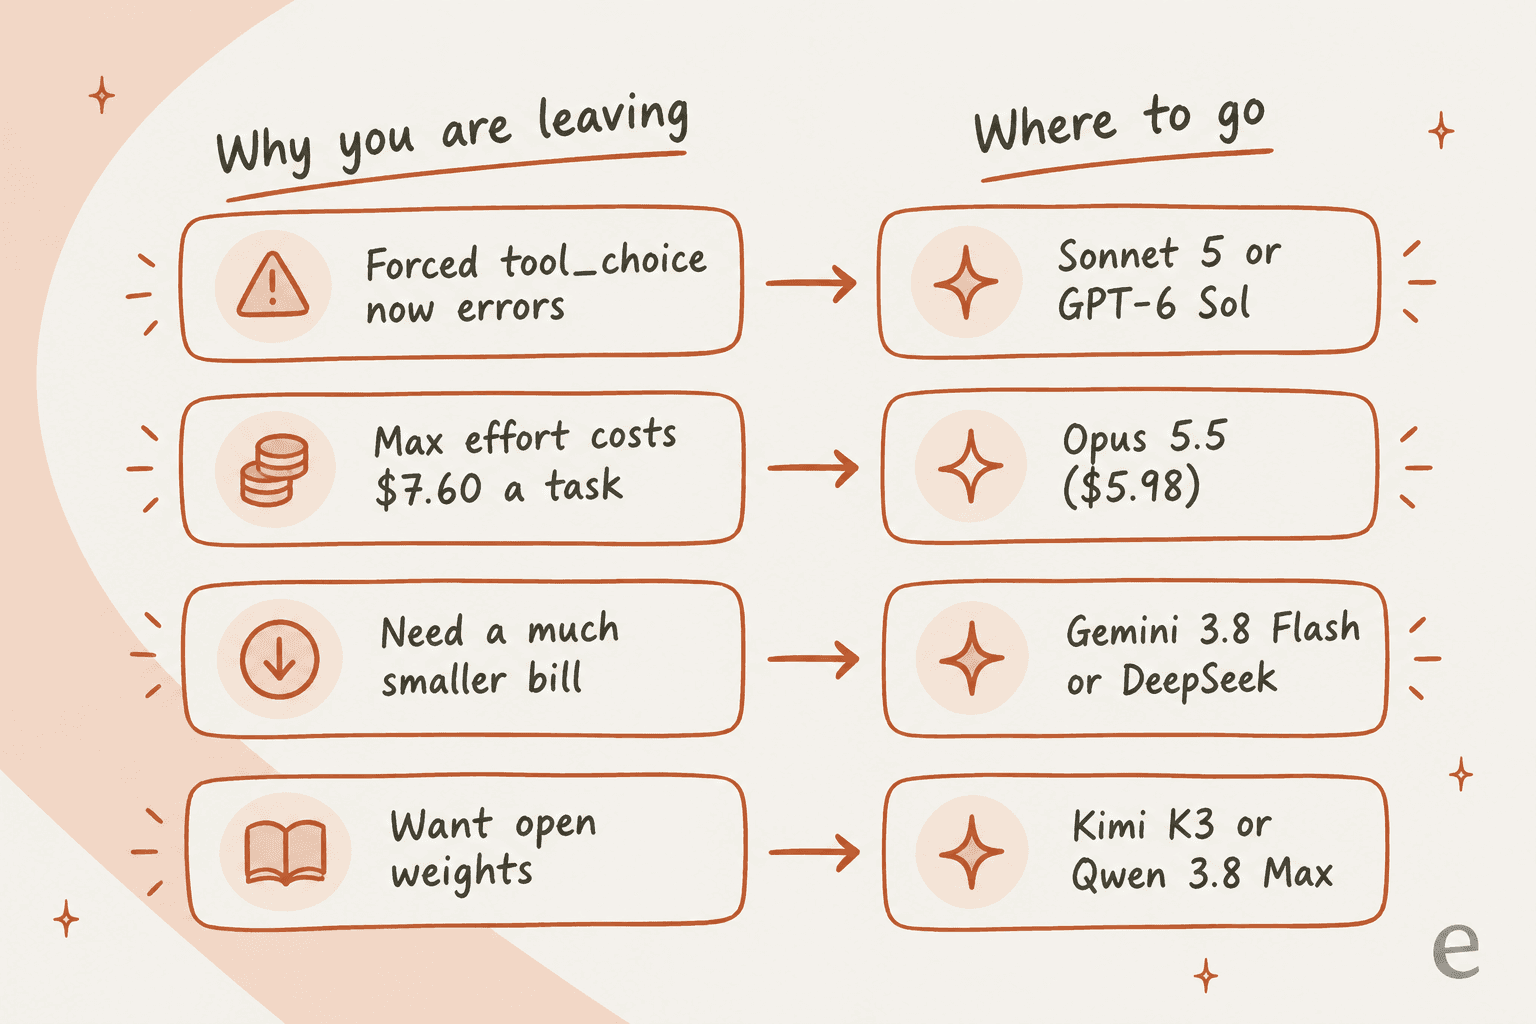
本番のボットを壊すのは強制ツール呼び出しです。Sonnet 5.5では、tool_choiceにanyや特定ツールを指定すると400のinvalid_request_errorが返ります。Anthropicの推奨は、autoのままにする、strict: trueを設定する、構造化出力に移行する、そして「ツールが適用される場面をプロンプトで伝える」ことです。それで動きますが、結局は保証を依頼に置き換えているだけです。チケットのトリアージや抽出のステップが、モデルが必ずclassify_ticketを呼ぶことを前提にしていたなら、変更すべき1行ではなく、再テストすべき挙動が生まれます。しかもOpus 5.5に上げても解決しません。その移行ノートにも同じ400が載っています。
理由2:最大effortはOpusより高くつく
Sonnet 5.5のAPIデフォルトeffortはhighです。最上段では高価になります。Artificial AnalysisのIntelligence Indexでは、Sonnet 5.5のmaxは1タスク$7.60でスコア56、Opus 5.5のmaxは$5.98でスコア58でした。Sonnetは、そのスコアに届くまでにより多くのトークンを使っただけです。
"I'm a bit confused myself. On artificial analysis, sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98. Sonnet 5.5 max was using 193k tokens per task while opus 5.5 max was using 119k."

Simon Willisonも同じ傾向を見ていますが、対象は1つのプロンプトだけです。彼のeffort表はlowの1.6セントからmaxの$1.28まで並び、maxではモデルが約15分で「burned through 128,000 thinking tokens」し、完了できませんでした(Hacker Newsのsimonw)。
理由3:キャッシュ読み取りがOpusと同じ価格
Sonnet 5.5は、入力、出力、キャッシュ書き込みでOpus 5.5の半額です。例外はキャッシュ読み取りで、どちらも100万あたり$0.20です。Opus 5.5がキャッシュ読み取りを0.05倍で課金するためです。長いエージェントのループではトークンの大半がキャッシュ読み取りに使われるので、差は縮まります。倍率はAnthropic APIの料金のページにあります。
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

理由4:同じ価格表示でも、買える仕事は大きく違う
調べていて最も意外だったのがこのグラフです。3つのモデルは、入力$2/出力$10と全く同じ価格です。それでも最大effortでは、完了したタスク1件あたりの請求額が大きく違います。
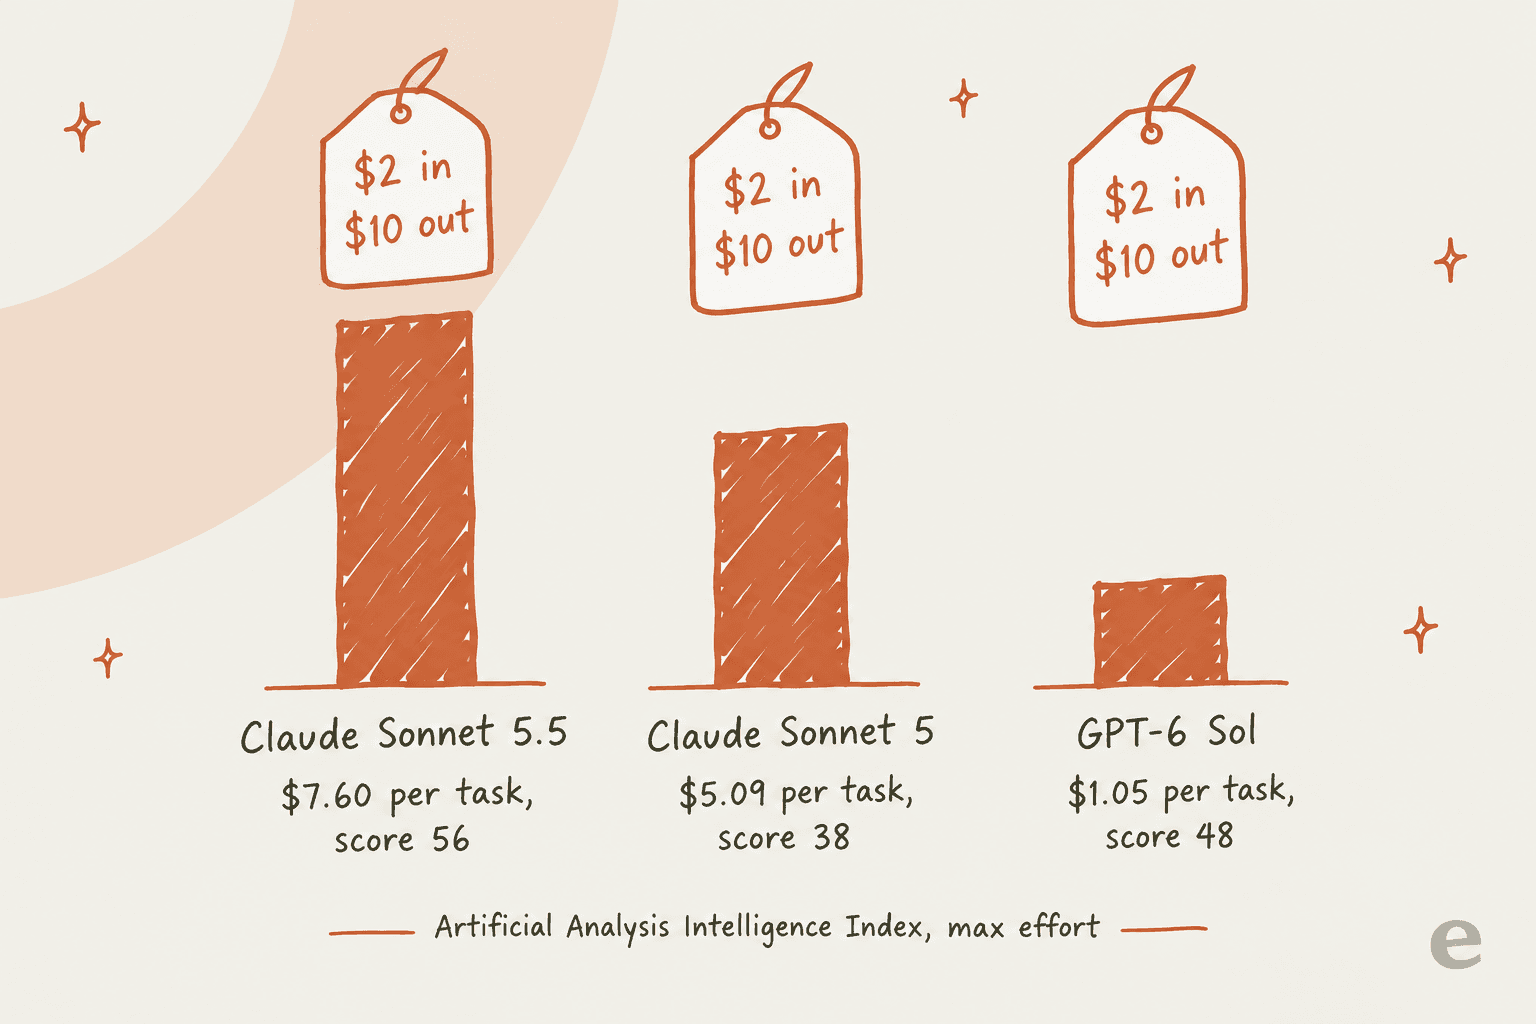
Sonnet 5.5は3つの中で最も賢く、タスク単価でも大差をつけて最も高価です。トークン単価は、請求額についてほとんど何も教えてくれません。重要なのはタスクあたりのトークン数で、これはモデルの性質であり、実際に動かして初めて分かります。
Claude Sonnet 5.5の代替モデル一覧
価格は各社の公式料金ページに記載の100万トークンあたりの金額で、2026-09-29に確認しました。Artificial Analysisの列は現行のIntelligence Index基準で、AAがテストしたeffort設定をカッコ内に示しています。旧基準のスコアを混ぜるより、空欄のままにしました。
| モデル | 入力 / 出力 | キャッシュ読み取り | コンテキスト | AAスコア、タスク単価 | 強制ツール選択 | オープンウェイト | 向いている用途 |
|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5(基準) | $2 / $10 | $0.20 | 1M | 56, $7.60 (max) | 不可、400を返す | なし | Low/Mediumでの高速なコーディング |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | 58, $5.98 (max) | 不可、400を返す | なし | 高effortでの難しいタスク |
| Claude Sonnet 5 | $2 / $10 | $0.20 | 1M | 38, $5.09 (max) | 可 | なし | 書き換え不要の退避先 |
| GPT-6 Sol | $2 / $10 | $0.20 | 1.05M | 48, $1.05 (max) | 可(Responses API) | なし | 同価格で請求額が小さい |
| Gemini 3.8 Flash | $0.75 / $3.75 | $0.075 | 1M | 41, $1.24 (high) | 可(anyモード) | なし | 安価なマルチモーダルのバッチ処理 |
| Grok 4.7 | $2 / $6 | $0.50 | 500K | 46, $3.74 (xhigh) | 可(requiredまたは名前指定) | なし | 長いエージェントのループ |
| Qwen 3.8 Max | $2 / $6 | $0.25 | 1M | - | 名前指定のツール、非thinkingのみ | ベースモデル、独自ライセンス | 安い出力、オープンなベース |
| Kimi K3 | $3 / $15 | $0.30 | 1M | - | requiredのみ | あり、独自ライセンス | 視覚対応のオープンウェイト |
| DeepSeek V4.1 Flash | $0.15 / $0.60(オフピーク) | $0.003 | 1M | 39, $0.27 (max) | 非thinkingモードのみ | あり、MIT | コストの下限 |
強制ツール選択の列は、各社のfunction callingドキュメントに基づいています。多くの人が誤解する列なので、慎重に読んでください。Anthropicのツール定義ドキュメントは、Opus 5.5、Sonnet 5.5、Fable 5.1をまとめて、anyとtoolが400を返すモデルとして挙げています。DeepSeekとQwenはthinkingをオフにした場合にのみ強制ツールを許可し、常に思考するKimi K3はrequiredを受け付けますが、名前指定のツールは受け付けません。推論をオンにしたままツール呼び出しを強制できるのは、Sonnet 5、GPT-6 Sol、Gemini 3.8 Flash、Grok 4.7だけです。
選定の方法
上の4つの理由から出発し、各候補に1つの問いを立てました。このモデルは、Sonnet 5.5を離れる具体的な理由を、より悪い理由を生まずに解決できるか。価格はすべて各社の公式料金ページのものです。タスク単価はすべてArtificial Analysisの数値で、同じIntelligence Indexを各モデルに実行し、かかった費用を公開しています。コミュニティの引用は、人々が自分でモデルを動かしたHacker NewsとRedditのスレッドからです。
Claude Haiku 4.5は主要な候補から外しました。$1/$5で現実的な選択肢ですが、Anthropicが挙げる最も早い廃止日は2026年10月15日、約2週間後です。その日付が付いたモデルへの移行は始めません。
10秒で見つける、あなたの代替モデル
ここに来た理由をタップしてください。
Claude Sonnet 5.5から乗り換える理由は何ですか?
1つ選ぶと、私ならどこへ行くかが表示されます。
1. Claude Opus 5.5
**向いているのは:**Sonnet 5.5をxhighまたはmaxのeffortで運用し、その費用を払っているチーム。
直感に反する選択肢を先頭に置きます。Claude Opus 5.5はトークン単価が2倍なのに、それでも安いモデルになり得ます。Artificial Analysisの最大effortでは、Opus 5.5は1タスク$5.98でスコア58、Sonnet 5.5は$7.60でスコア56でした。Opusは、Anthropic初の値下がりしたOpusとして登場し、$5/$25から$4/$20になりました。キャッシュ読み取りは0.05倍で課金されるため、Sonnetの$0.20と並びます。
下げる選択も報われます。Sonnet 5.5の料金の解説では、MediumのOpus 5.5がスコア51で1タスク$1.34、XhighのSonnet 5.5がスコア52で$2.74でした。ほぼ同じスコアが、約半分の費用で得られます。
メリット
- Intelligence IndexでSonnet 5.5より上限が高い(maxで58対56)。
- 最大effortでのタスク単価がSonnet 5.5より安い。
- 同じClaude API、同じツール、同じClaude Codeのワークフロー。
デメリット
- 入力、出力、キャッシュ書き込みのトークン単価がSonnetの2倍なので、LowとMediumではSonnet 5.5が有利。
- 遅い。ローンチのスレッドですぐ指摘されました。
- Sonnet 5.5と全く同じく強制
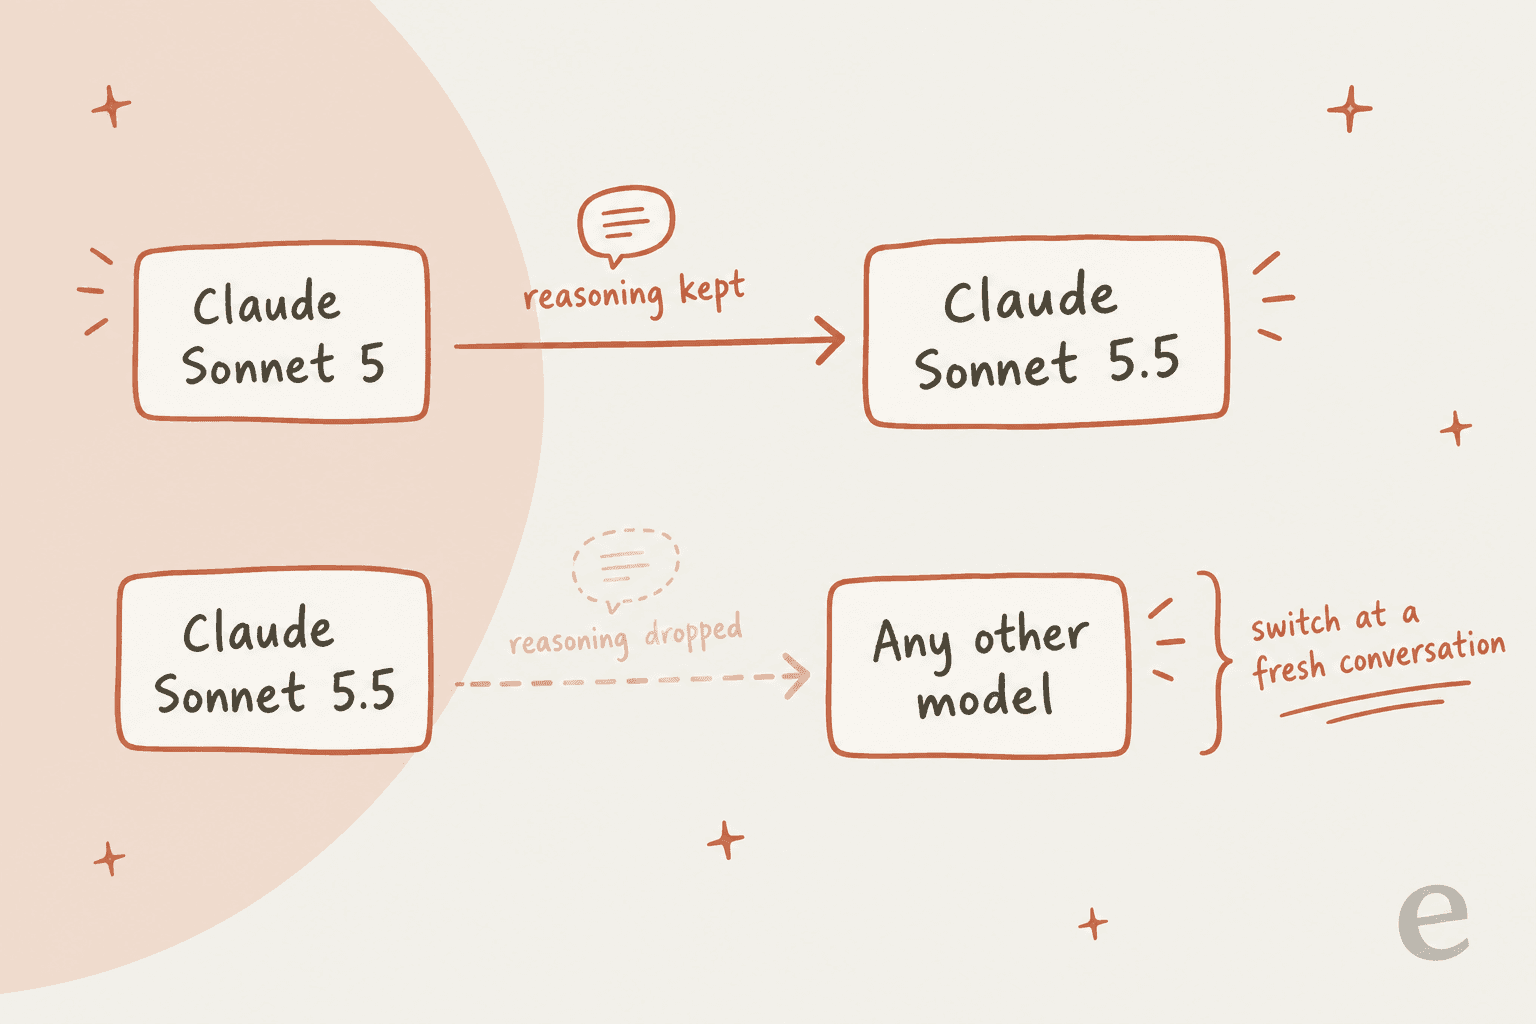
tool_choiceを拒否するため、この破壊的変更の解決策にはならない。 - Sonnet 5.5はOpus 5.5のthinkingブロックを読めず、その逆も同様なので、1つの会話で混ぜると推論が失われる。
料金
100万トークンあたり入力$4、出力$20、キャッシュ読み取り$0.20。Batchは半額。全項目はClaude Opus 5.5の料金の記事をご覧ください。
**私の見解:**ワークロードがxhighかmaxにあるなら、Opus 5.5に移してeffortを1段階下げてください。支払いはおそらく減り、答えも良くなります。LowやMediumで動かしているなら、Sonnet 5.5のままで。この選択肢は当てはまりません。
2. Claude Sonnet 5
**向いているのは:**Sonnet 5.5の強制ツール呼び出しやthinking: disabledの変更で本番コードが壊れた人。
地味な答えですが、パイプラインが400を投げ始めた日には、これが正解です。Claude Sonnet 5は、5つの破壊的変更の基準となるモデルなので、定義上どれも当てはまりません。価格も同じ$2/$10です。Anthropicの廃止予定ページでは現行扱いで、2027年6月30日より前の廃止はありません。
段階的な移行を考える人には、ドキュメントに良い点があります。Sonnet 5.5はSonnet 5のthinkingブロックを読めるので、Sonnet 5で始めて上に移った会話は推論を保てます。逆はできません。
メリット
- 1行でロールバックできる。モデルIDを変えるだけ。
- 強制
tool_choice、手動のthinking予算、旧computer useツールが使える。 - 廃止まで20か月以上ある。
デメリット
- 明らかに性能が低い。Anthropicのローンチ表では、Terminal-Bench 4.0が10.3%で、Sonnet 5.5の70.6%に遠く及ばない。
- タスク単価も安くない。maxで
$5.09、スコアは38。 - Anthropicの現行モデル表から外れているため、新機能は5.5に先に入る。
料金
100万トークンあたり入力$2、出力$10、キャッシュ読み取り$0.20。プランとBatchの詳細はClaude Sonnet 5の料金の記事にあります。
**私の見解:**Sonnet 5は目的地ではなく、駐車場として使ってください。今日ロールバックし、ブランチでSonnet 5.5かGPT-6 Solを相手にツール呼び出しを直し、それから前へ進みます。長く留まるなら、Claude Sonnet 5の代替モデルの一覧も見ておく価値があります。
3. GPT-6 Sol
**向いているのは:**Sonnetクラスの価格で、強制ツール呼び出しとタスクあたりの小さい請求額が欲しいチーム。
GPT-6 Solの価格表示はSonnet 5.5と同一です。入力$2、キャッシュ$0.20、キャッシュ書き込み$2.50、出力$10(OpenAIの料金)。違いは使うトークンの量です。Artificial Analysisの最大effortで、GPT-6 Solは1タスク$1.05でスコア48、Sonnet 5.5の最大effortでの請求額の約7分の1でした。最上位の性能は劣ります。48対56です。
強制ツール使用が必要な人向けに、OpenAIのfunction callingガイドはrequiredと、関数名を指定するツール選択を文書化しています。モデルページには1つ注意があります。Chat Completions経由では、GPT-6 Solのfunction callingはreasoning_effortがnoneのときだけ使えます。ツールと推論を併用したい場合は、Responses APIを使ってください。
メリット
- Sonnet 5.5と同じトークン単価で、maxでのタスク単価がはるかに低い。
- 強制ツール選択が文書化されている。
- 1,050,000トークンのコンテキストと、Responses APIのフルツールセット。
デメリット
- 上限が低い。Intelligence Indexで48、Sonnet 5.5は56。
- 入力272Kトークンを超えるプロンプトは、リクエスト全体が入力2倍、出力1.5倍で課金される。
- ベンダーを変えると、新しいSDKコード、新しいプロンプト調整、新しいevalが必要になる。
"Sonnet 5.5 is way better than GPT 6 Sol. Does that even make sense?"
このコメントは、数字に対する正直な対抗意見です。難しいコーディング作業では、Sonnet 5.5を好む人が多く、ベンチマークもそれを裏付けています。
料金
入力$2、キャッシュ$0.20、出力$10、BatchとFlexは半額。さらに詳しくは、GPT-6 Solの料金の記事とGPT-6 Solの代替モデルの一覧をご覧ください。
私の見解:「最高」より「タスクあたりで十分良く安い」が勝つ、大量でツールを多用する仕事に最適な直接の乗り換え先です。コーディング品質を最優先するなら、Anthropicに留まってください。
4. Gemini 3.8 Flash
**向いているのは:**誰も最初のトークンを待っていない、大量のバッチ処理やマルチモーダルの仕事。
Gemini 3.8 Flashは、thinkingトークンを含めて100万トークンあたり入力$0.75、出力$3.75で、2026年12月31日までです(Gemini APIの料金)。Sonnet 5.5の料金の40%未満です。テキスト、画像、音声、動画、PDFを入力でき、音声と動画ではSonnetが及びません。Artificial Analysisのhigh effortでは、スコア41で1タスク$1.24でした。
計画に入れておくべき点が2つあります。価格は2027年1月1日に$1.50/$7.50へと2倍になります。また、Artificial Analysisは最初のトークンまでの時間を13.3秒と計測しており、同クラスの中央値よりはるかに長い一方、出力速度は上位です。夜間ジョブには向きますが、ライブチャットの返信には向きません。
メリット
- トークン単価がはるかに安く、BatchとFlexでさらに半額。
- このリストで最も幅広い入力形式。
- プロトタイプ用の無料枠。
デメリット
- 3か月後に価格が2倍になる。
- 最初のトークンが遅く、人が待つ用途には使えない。
- Googleは3.8を「works harder」でトークンを多く使うと説明しており、効率重視の用途には引き続き3.7 Flashを推奨している。
料金
年末まで入力$0.75、出力$3.75、キャッシュ読み取り$0.075。Gemini 3.8 Flashの料金とGemini 3.8 Flashのレビューをご覧ください。
**私の見解:**文書処理、文字起こし、動画を扱う用途に有力です。1月の価格変更は、12月ではなく今のうちに予算に入れてください。
5. Grok 4.7
**向いているのは:**出力トークンが安いことが積み重なって効いてくる、長時間のエージェントループ。
Grok 4.7は、プロンプトが200Kトークン未満なら100万トークンあたり入力$2、出力$6です(xAIの料金)。出力はSonnet 5.5より40%安く、推論モデルが最も費用を使うのは出力です。xAIは、より大きなベースモデルに、数時間規模のタスクを狙った長いRL学習を施して構築し、xAI自身の表でTerminal-Bench 4.0がGrok 4.6の20.3から37.6へと、ほぼ倍増しました。Artificial Analysisのxhighでは、スコア46で1タスク$3.74でした。
メリット
- 出力は
$6で、Sonnet 5.5より40%安い。 - 500Kのコンテキストと、長いセッション向けのContext Compaction API。
- xAIのEEBenchとBriefcaseの数値で、エージェント系のスコアが高い。
デメリット
- プロンプトが200Kトークンを超えると、超過分だけでなくリクエスト全体が
$4/$12で課金される。 - Terminal-Bench 4.0の37.6は、Sonnet 5.5の70.6を大きく下回る。
- キャッシュ読み取り
$0.50は、Anthropicの$0.20より高い。
料金
200K未満で入力$2、キャッシュ$0.50、出力$6。ツール呼び出しのメーターはGrok 4.7の料金の記事で扱っています。
**私の見解:**エージェントの出力が多く、コンテキストが200K未満に収まるなら試す価値があります。長いコンテキストの崖は急なので、プロンプトは短く保ってください。
6. Qwen 3.8 Max
**向いているのは:**Sonnetと同じ入力価格で、より安い出力と、ダウンロード可能なベースモデルが欲しいチーム。
Qwen 3.8 Maxは、Qwen Cloudで100万トークンあたり入力$2、出力$6。1Mのコンテキスト、131Kの最大出力、最大262Kの推論トークンを備えています。2.4Tパラメータ、アクティブ95BのMixture-of-Expertsモデルです。ベースのウェイトはHugging FaceにQwen3.8-2.4T-A95Bとして公開されており、Apacheではなく独自のQwenライセンスです。
ライセンスと機能一覧は合わせて読むべきです。ホスト版のMaxには、視覚入力、非thinkingモード、組み込みツールがありますが、オープンなベースにはありません。ここでの「オープン」は、ベースモデルを動かせるという意味で、ホスト版の製品が手に入るという意味ではありません。
メリット
- Sonnet 5.5と同じ入力価格で、出力は40%安い。
- 人間の好みによる評価が高く、8月にはLMArenaのテキスト部門で5位。
- 将来必要になったときのセルフホストの道がある。
デメリット
- オープンなベースは、ホスト版と同等の機能を持たない。
- 独自ライセンスなので、出荷前に法務で確認が必要。
- セルフホストしない限り、データはAlibabaのクラウドに送られる。
料金
入力$2、出力$6、暗黙のキャッシュ読み取り$0.25。Qwen 3.8 Maxの料金とQwen 3.8 Maxのレビューをご覧ください。
**私の見解:**Sonnetの出力価格が痛くて、将来1社のベンダーから抜け出す道も欲しいなら、良い中間の選択肢です。
7. Kimi K3
**向いているのは:**ネイティブの視覚対応を備えたオープンウェイトが必要で、本格的なハードウェアを動かす準備があるチーム。
Kimi K3はMoonshot AIのフラッグシップで、2.8Tパラメータ、アクティブ104B、1Mのコンテキスト、画像と動画のネイティブ理解を備えます。ウェイトはHugging Faceにあり、ここに挙げた欧米のモデルはどれも公開していません。APIでは100万トークンあたり入力$3、キャッシュ$0.30、出力$15で(Moonshotの料金)、キャッシュ書き込みはTTLに応じて$3か$6が別に課金されます。
そのためAPIではSonnet 5.5より高くなります。選ぶ理由はコストではなく、コントロールです。
メリット
- フロンティア規模のオープンウェイトで、視覚対応が組み込み済み。
- 1Mのコンテキストと、最大1Mトークンまで設定できる出力。
- ネットワークの外に出せないデータのためのセルフホストの道。
デメリット
- ホスト版APIでは、トークン単価がSonnet 5.5より高い。
- どのeffortでも推論をオフにできない。
- ウェイトのリポジトリは約1.5TBで、セルフホストはクラスタ規模の作業になる。
料金
入力$3、キャッシュ$0.30、出力$15。Kimi K3の料金とKimi K3の代替モデルをご覧ください。
**私の見解:**Kimi K3は、実際にセルフホストする場合だけ選んでください。どのみちAPIを呼ぶなら、MediumのSonnet 5.5のほうが安くて簡単です。
8. DeepSeek V4.1 Flash
**向いているのは:**可能な限り低い請求額と、このリストで唯一の寛容なオープンライセンス。
DeepSeek V4.1 Flashは、オフピークで100万トークンあたり入力$0.15、出力$0.60、ピーク時は$0.30/$1.20です(DeepSeekの料金)。API名は現在deepseek-flashです。Artificial Analysisの最大effortでは、ピーク料金で計算して1タスク$0.27、スコア39でした。オフピークならその約半分になります。ウェイトはMITライセンスです。
DeepSeekがV4 Proのトラフィックをこのモデルに移したことも、同社の自信を物語っています。ツール呼び出し、Anthropic API形式、Responses APIに対応しており、AnthropicのSDKを使ったコードベースは、ベースURLの変更だけで向け先を切り替えられることが多いです。
メリット
- AAの数値では、maxでのタスク単価がSonnet 5.5の約28分の1。
- MITライセンスのウェイトと、Anthropic互換のエンドポイント。
- 視覚対応がメインモデルに組み込み済み。
デメリット
- 上限がはるかに低い。Intelligence Indexで39。
- 有料APIの規約には、データ処理契約もゼロリテンションの選択肢も公開されておらず、データは中国で処理される。
- ピーク料金は、平日のUTC 01:00-04:00と06:00-10:00に料金が2倍になる。
"I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it."
料金
オフピークは入力$0.15、出力$0.60、キャッシュヒット$0.003。ピーク時は2倍です。DeepSeek V4.1 Flashの料金をご覧ください。
**私の見解:**社内ツール、コード生成、バッチジョブに最適です。顧客データを扱う用途では、価格より先にデータ条件をよく考えてください。
Sonnet 5.5と他のモデルについて、開発者は何と言っているか
Hacker Newsのローンチスレッドは556コメントに達し、意見ははっきり分かれました。速度とベンチマークの伸びは好評です。一方で、Opus 5.5との棲み分けがどこにあるのかは、判断が割れています。
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost. But Sonnet 5.5 at medium and below gives you a cheaper option at a performance worse than the lowest thinking Opus (low), which may be viable for "low intelligence" use cases."
何人かが落ち着いたパターンは、そもそも「Sonnet 5.5を離れる」ではありません。仕事を分けることです。Opusが計画し、SonnetがLowかMediumで作り、Opusが仕上げます。あるコメンターは「80% Sonnet 5.5, Opus 5.5 to finish the last 20%」と表現しました(Hacker Newsのvektormemory)。あなたの環境に合うなら、Claude Codeのサブエージェントのガイドが構成方法を示しています。
知っておくべき品質の後退もあります。敵対的ベンチマークを回した開発者は、Sonnet 5.5のスコアがSonnet 5の17.8%に対して7.4%だったと報告しています。理由は「returns to ask the user questions whether to keep going」だからです(Hacker Newsのdom96)。無人で動かすエージェントにとっては、テストすべき挙動の変化です。
乗り換えはモデルだけの問題ではなく、サポートの問題
このリストのどのモデルも、数か月以内に新バージョンを出し、そのうちいくつかは何かを壊します。Sonnet 5.5は破壊的変更を5つ持って登場しました。Gemini 3.8 Flashの価格は1月に2倍になります。Haiku 4.5には2週間後の廃止日があります。今日どれを選んでも、来四半期にそれを再テストする担当が、あなたのチームに必要です。
購入者が過小評価しがちな部分です。私がレビューしたeeselの営業通話で、小さなハードウェア会社の予算重視の購入者は、以前のベンダーの価格が「more than doubled」して痛い目を見たと話し、何かにサインする前に契約での価格固定を求めていました。モデル層にも同じリスクがあり、時計の進みがより速いだけです。
特にサポートキューについては、ここでモデル選びをやめるのが私の考えです。eeselはライブのヘルプデスクキューでAIチームメイトを動かしており、すべてのロールアウトは、実際の顧客に返信する前に、チームの過去チケットでシミュレーションされます。下のモデルが変わったとき、そのシミュレーションが、顧客より先に強制ツール呼び出しの挙動の後退を見つける手段になります。サポートチケットに最適なモデルのまとめは、その仕事でモデルを比較し、AIサポートエージェントの費用のガイドは予算面を扱っています。
モデルをヘルプデスクに入れるなら、eeselを試してください
素のモデルはインフラです。選び、ツール呼び出しを配線し、evalを書き、破壊的変更が入るたびに再実行します。eeselはその上に立つ従業員です。Zendeskなどのヘルプデスクに加わり、過去のチケットとヘルプセンターから学び、誰かに返信する前に過去のチケットでテストされるAIヘルプデスクチームメイトです。tool_choiceを設定する必要は一切なく、モデルの破壊的変更はサポートキューではなくeeselが吸収します。
ターミナルから来た方には、eesel CLIが同じチームメイトを操作できます。npm i -g @eesel/cliでインストールし、eesel integrations connectでヘルプデスクを接続し、eesel instructionsで常設ルールを編集し、eesel activityですべての実行をJSONで読めます。書き込みは--dry-runに対応し、すべてのワークスペースはMCPサーバーでもあるため、Claude Code、Codex、Cursorがあなたの代わりに操作できます。モデルAPIに求めたくなるプログラム可能な制御を、すでに仕事をこなしているチームメイトに向けたものです。

eeselの料金は月額固定のクレジットプランで、自分のチケットで試せる無料枠があります。eeselを試して、モデルを先に選ばなくてもキューに返信が付く様子をご覧ください。
よくある質問
Claude Sonnet 5.5の最良の代替モデルは何ですか?
強制ツール呼び出しに対応したClaude Sonnet 5.5の代替モデルはありますか?
tool_choiceにanyや特定ツールを指定する使い方を引き続き受け付けており、2027年6月30日より前に廃止されることはありません。GPT-6 Sol、Gemini 3.8 Flash、Grok 4.7もツール呼び出しを強制できます。なお、Claude Opus 5.5もこれを拒否するため、Claudeの上位モデルへ移っても解決しません。サポートで強制ツール呼び出しが効いてくる場面は、AIヘルプデスクAPIのガイドで解説しています。Claude Opus 5.5はClaude Sonnet 5.5より安いですか?
Claude Sonnet 5.5の代替モデルで最も安いのはどれですか?
Claude Sonnet 5.5にオープンソースの代替モデルはありますか?
会話の途中でClaude Sonnet 5.5から別のモデルに切り替えられますか?
カスタマーサポートのボットにはどのClaude Sonnet 5.5代替モデルが最適ですか?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.