2026年におけるClaude Opus 5の代替ツール・ベスト8

Rama Adi

Katelin Teen
最終更新 August 5, 2026
なぜClaude Opus 5の先を見る人がいるのか
Opus 5は2026年7月24日に登場した、強力なモデルだ。指標では首位に立ち、長文コンテキストへの追加料金なしで100万トークンのコンテキストウィンドウを保持し、Anthropicは価格をOpus 4.5から変わらず100万トークンあたり5ドルと25ドルのまま維持している。ここには何のスキャンダルもない。Claude Opus 5の解説記事では実際に何が新しくなったのかを、Opus 5レビューでは見出しの数字ほど印象が良くない部分を解説している。
人々を他へ向かわせる理由は「悪いモデルだから」よりもっと具体的で、3つの点に集約される。
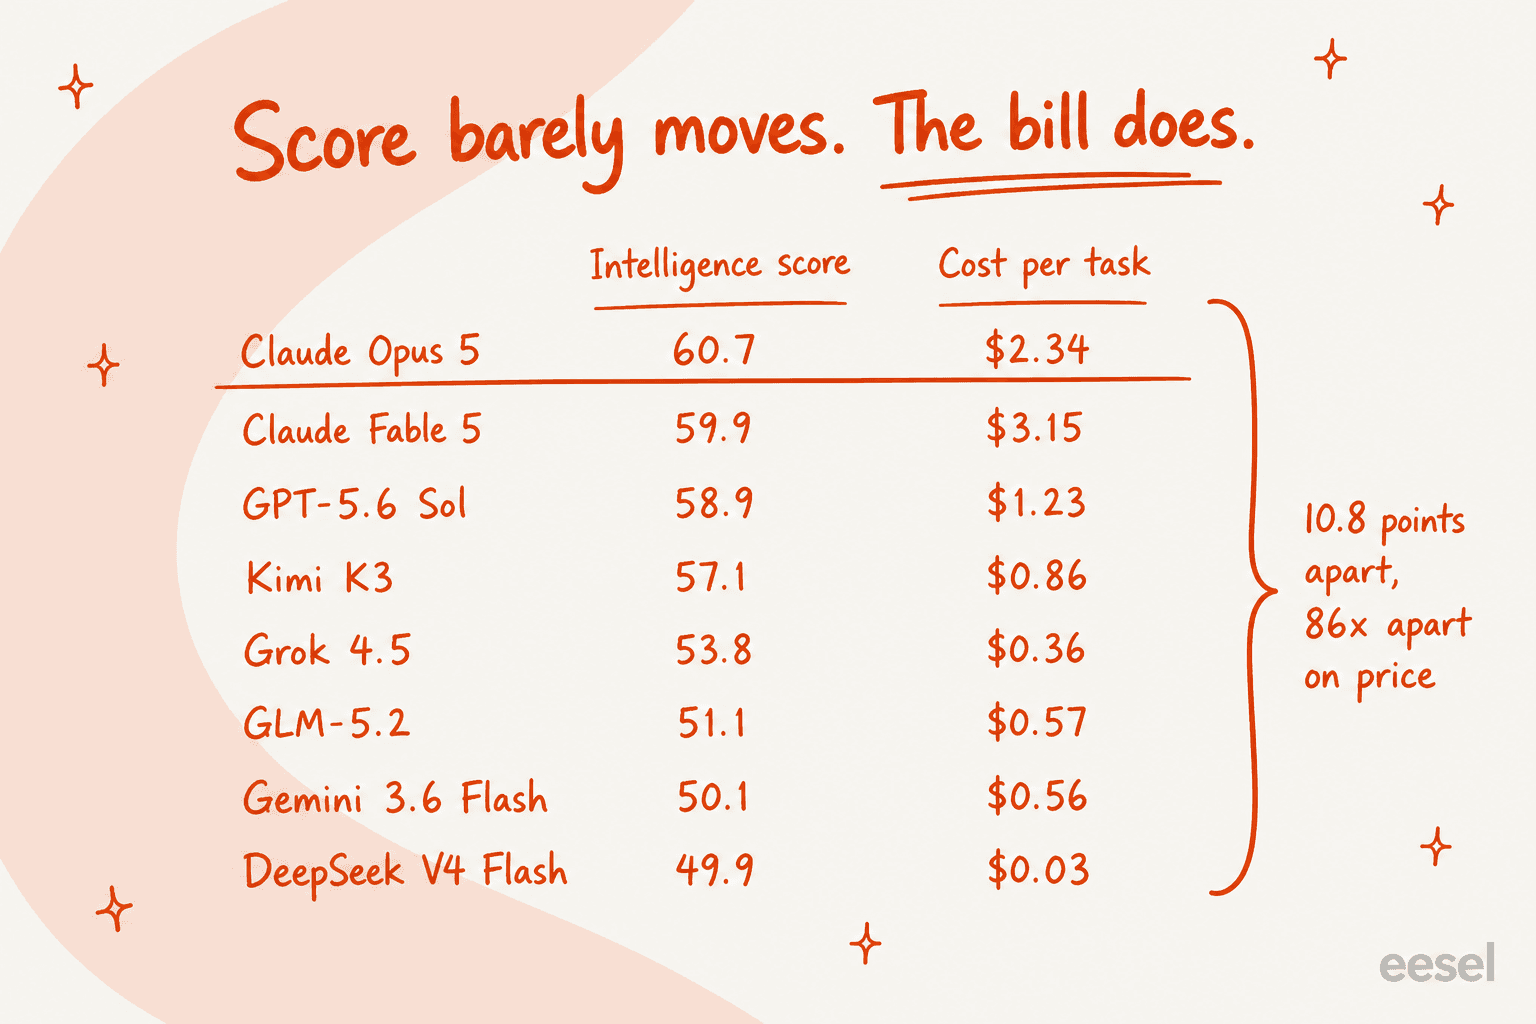
価格表は変わっていないのに、タスクあたりの請求額は上がった。 AAは最大出力設定のOpus 5について、指標タスクあたりのコストを2.34ドルと計測している。その前身であるOpus 4.8は同じ価格表で2.03ドルだ。トークンあたりの単価は同じなのに、消費トークン数が増えている。これは私が最もよく耳にする不満であり、実際に的を射ている。Opus 5の価格分解記事では、それが月々の請求にどう影響するかをモデル化している。
遅い。 AAは出力速度の中央値を毎秒55.7トークンと計測している。Gemini 3.6 Flashは同じ測定で213.5、つまり3.8倍速い。人間が座って見ているようなあらゆる場面では、この差こそが製品そのものになる。
重みが存在しない。 AnthropicはこれまでにOpusのチェックポイントを一度も公開しておらず、公開を始める兆しもない。自社のハードウェア上で、自社のリージョンで、自社の保持ルールの下でモデルを動かす必要があるなら、どのClaudeモデルもどんな価格でもそれに応えられない。これはリストの中でAnthropicが値引きで解決できない唯一の理由であり、だからこそMITライセンスの2つのモデルがこのまとめに加わっている。
すでにその移行を行っている人たちもいて、彼らが語る取引は無料の得ではなく、正直な代償を伴うものだ。
"I'd assume open weight models hosted on openrouter aren't being run at a loss. As such, I've been experimenting with them lately and results are pretty promising. Requires slightly more patience and handholding than just cranking Opus 5 in Claude Code, but for the cost saving it's definitely worth it."

そのリストに含まれていないものに注目してほしい。それは「性能」だ。私が話をする誰も、Opus 5が仕事をこなせないという理由で離れているわけではない。
この8つをどう選んだか
こうしたまとめ記事の罠は、都合の良いベンチマークで順位をつけてしまうことだ。そこで私はまず測定基準を固定し、その結果として順序が決まるようにした。
ここに挙げたすべてのモデルはArtificial Analysisが同一のテスト環境で採点したものであり、ベンダー自身の報告ではなく比較可能な数値だ。この記事の数値はすべて2026年8月5日に取得した。知能スコアに加えて、AAの完了タスクあたりコストも採用した。これはモデルが課す料率ではなく、実際に消費する推論トークンを価格化したものだ。この2つの数値は常に食い違い、その食い違いこそが興味深い部分だ。
各モデルは今日時点で利用可能であり、価格が公開されていて待機リストがないことも条件とした。ライセンスにも目を通した。というのも、このうち2つはオープンウェイトで、そのうち1つには収益しきい値が付いているからだ。ベンダーとAAの数値が食い違う場合は、都合の良い方を選ぶのではなくその旨を記載した。その理由で今回外したモデルの一つがQwen3.8-Maxだ。人間の好みに基づくリーダーボードでは強いが、AAのボードにはまったく登場せず、ここにある他のモデルと同じ軸で比較できない。
私がやっていないことは、8つすべてに6ヶ月分の本番トラフィックを流すことだ。ドキュメント、価格表、独立機関の測定結果を読み、それらが裏付ける範囲内で主張をとどめている。
Claude Opus 5の代替候補一覧
価格はすべて100万トークンあたりの米ドル表記。スコア、速度、タスクあたりコストは2026年8月5日にArtificial Analysisが測定した数値。
| モデル | 最適な用途 | 指標 | コスト/タスク | 速度(t/s) | 知識 | 入力 | 出力 | コンテキスト | 重み |
|---|---|---|---|---|---|---|---|---|---|
| Claude Opus 5(基準) | 頂点に立つ標準モデル | 60.7 | $2.34 | 55.7 | 31.3 | $5.00 | $25.00 | 1M | 非公開 |
| GPT-5.6 Sol | ほぼ同スコアで請求額は半分 | 58.9 | $1.23 | 70.6 | 21.7 | $5.00 | $30.00 | 1M | 非公開 |
| Kimi K3 | 長時間のエージェント実行 | 57.1 | $0.86 | 37.1 | 18.4 | $3.00 | $15.00 | 1,048,576 | 公開、独自ライセンス |
| Claude Fable 5 | 知識で唯一上回るモデル | 59.9 | $3.15 | 73.8 | 40.2 | $10.00 | $50.00 | 1M | 非公開 |
| Claude Sonnet 5 | Anthropicに残りつつコストを抑える | 53.4 | $1.72 | 83.0 | 15.3 | $2.00 | $10.00 | 1M | 非公開 |
| Gemini 3.6 Flash | 人間が待つあらゆる場面 | 50.1 | $0.56 | 213.5 | 23.5 | $1.50 | $7.50 | 1M | 非公開 |
| Grok 4.5 | 知識を落とさず低コスト | 53.8 | $0.36 | 61.3 | 26.4 | $2.00 | $6.00 | 500K | 非公開 |
| GLM-5.2 | MITライセンスの高速オープンウェイト | 51.1 | $0.57 | 182.7 | 4.0 | $1.35 | $4.29 | 1M | MIT |
| DeepSeek V4 Flash | 価格の下限 | 49.9 | $0.03 | 122.7 | 未採点 | $0.14 | $0.28 | 1M | MIT |
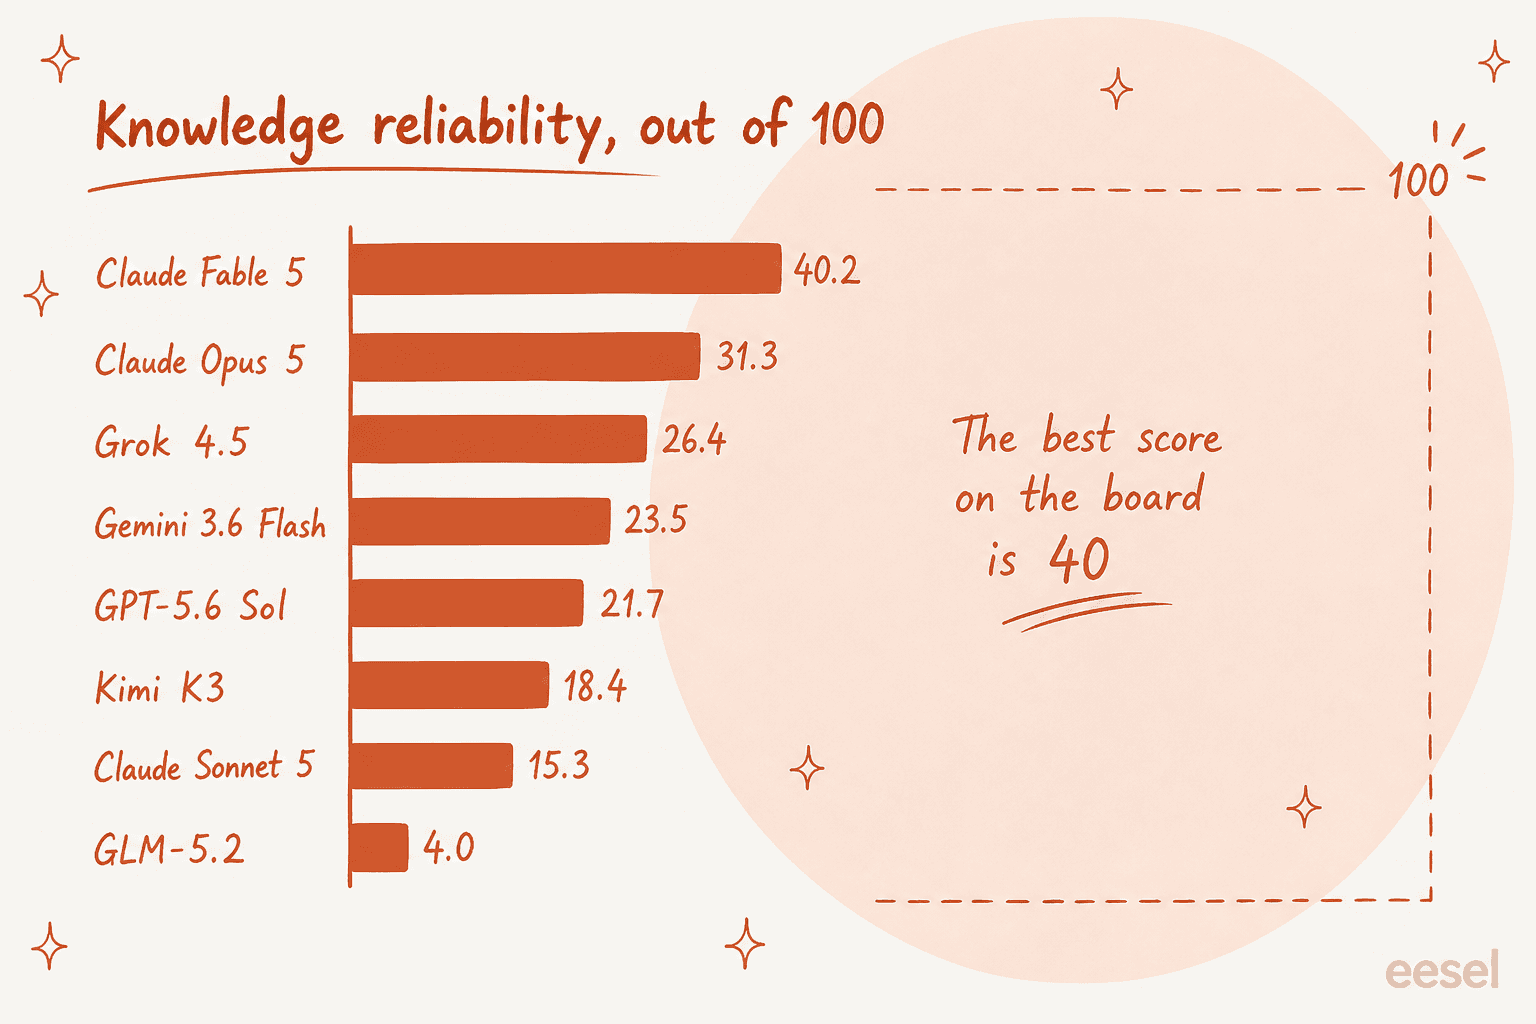
「知識」はAA-Omniscience Indexを指し、-100から100の範囲でモデルが実際に物事を知っているか、それとも自信満々にでっち上げているかを測る。この列は二度読んでほしい。そこにある最高値は40.2だ。
1. GPT-5.6 Sol
最適な用途: 実測コストの約半分でOpus 5に2ポイント差まで迫ること。
OpenAIのフラッグシップモデルは2026年7月9日に一般提供が始まり、前身と同じ価格、100万トークンあたり入力5ドル・出力30ドルを維持している。書面上は2つのうち高価な方だ。しかし実際には、AAは指標タスクあたり1.23ドルと計測しており、Opus 5の2.34ドルより安い。これは同じ仕事をより少ない推論トークンで終えるためだ。私のGPT-5.6解説記事ではモデルファミリー全体を、価格ページではその下にあるTerraとLunaの各ティアを解説している。
Opus 5に勝る点。 タスクあたりコストで47%安い。出力速度は毎秒70.6トークンで55.7より速い。中程度の出力設定での最初のトークンまでの時間は6.1秒で、推論モデルとしては速い。
勝らない点。 指標スコアは58.9でOpus 5の60.7に劣る。より大きな差は知識信頼性で、AA-Omniscienceでは21.7対31.3となる。長時間のエージェント作業を測るAA-Briefcaseでは、最大出力設定のSolが1502 Elo、同設定のOpus 5が1719 Eloだ。単発の回答よりも長時間のエージェント実行がワークロードの中心なら、この差を重視すべきだ。
価格。 100万トークンあたり入力5.00ドル、出力30.00ドル、キャッシュヒット0.50ドル。コンテキストは1M。
結論。 このページで最も優れた単純な乗り換え先。 指標2ポイントの差と請求額半減という取引は、ほとんどのチームが受け入れるべきものだ。ただし知識面のギャップは、私の評価ではなく自社の評価で確認してほしい。
2. Kimi K3
最適な用途: コストの3分の1で長時間のエージェント作業を行うこと。
Moonshot AIのフラッグシップモデルは2026年7月16日に発表された。2.8兆パラメータ(うちアクティブは1040億)、1,048,576トークンのウィンドウを持ち、重みは予定どおり2週間後に公開された。AAのスコアは57.1、より重要なのはタスクあたり0.86ドルという点だ。私のKimi K3概説記事ではさらに詳しく解説しており、これが最終目的地ではなく出発点であるなら専用の代替モデルまとめもある。
Opus 5に勝る点。 タスクあたり価格は2.7倍低い。重みが公開されている点は、どのClaudeモデルにもない。AA-Briefcaseでは1541 Eloを記録し、GPT-5.6 Solの1502を上回る。つまり、安価なモデルなら崩れると予想される長時間のエージェント実行でも、まさにそこで踏みとどまっている。
勝らない点。 弱点は出力速度で、毎秒37.1トークンとこのまとめの中で最も遅い。知識信頼性は18.4。どの出力設定でも推論をオフにできず、最も低い利用ティアでは1分あたり3リクエストしか許可されないため、多くの人がここで戸惑う。
価格。 100万トークンあたり入力3.00ドル、キャッシュヒット0.30ドル、出力15.00ドル。バッチティアはなし。
結論。 上位4モデルの中で最良のスコア対コスト比であり、エージェントが秒単位ではなく分単位で動く場面での選択肢だ。人がカーソルを見つめて待つような場所には置かないこと。
3. Claude Fable 5
最適な用途: Opus 5が最も苦手とする、まさにその一点。
Anthropicの最上位モデルは、このまとめの中で唯一、知識信頼性でOpus 5を上回る:40.2対31.3、ボード上最高の数値だ。同時にタスクあたりコストも最も高く3.15ドルで、指標スコアの59.9はOpus 5の60.7よりわずかに低い。つまり単に「より大きなモデル」というわけではない。私のOpus 5対Fable 5の比較記事では、それぞれが優れている点を解説している。
この2つについて実践者の評価は両方向に分かれており、それは0.8ポイントの差が現場でどう感じられるかをよく表している。
"I also have preferred Opus 5 to Fable 5 for most things. Fable is way better than Opus 4.8 for me - it just produces much more complete work in one shot reliably. But when Opus 5 came out, I found that I was getting the same results as Fable, just faster and cheaper."
Opus 5に勝る点。 知識で8.9ポイント上回る。速度は毎秒73.8トークンで55.7より速い。コンテキストは同じ1M、ツールも同じ、SDKも同じなので、切り替えはモデル名の文字列を変えるだけで済む。
勝らない点。 コストはタスクあたり1.35倍、価格表では2倍。指標スコアは0.8ポイントの差でノイズの範囲内だが、2倍の料金を払う前に知っておく価値はある。AA-Briefcaseでは、最大出力設定でFable 5が1574 Elo、Opus 5が1719 Eloだ。
価格。 100万トークンあたり入力10.00ドル、出力50.00ドル、キャッシュヒット1.00ドル。
結論。 コスト重視の選択ではなく、汎用的なアップグレードでもない。自信満々の誤答が実際の金銭的損失につながり、リトリーバルによる改善をすでに試し尽くした場合に手を伸ばすべきモデルだ。
4. Claude Sonnet 5
最適な用途: Anthropicにとどまりつつ支出を抑えること、ただし注意点あり。
Sonnet 5は同系列内での明確な下位モデルで、100万トークンあたり入力2ドル・出力10ドル、コンテキストは1M、APIも同一だ。同時に、価格表がいかに誤解を招くかを最も分かりやすく示す例でもある。出力トークンはOpus 5より60%安い。しかし完了タスクあたりのコストは27%しか安くならず、1.72ドル対2.34ドルにとどまる。これはSonnet 5が目的を達成するまでにはるかに多くのターンを要するためだ。私のOpus 5対Sonnet 5の記事にターン数の詳細がある。
Opus 5に勝る点。 出力速度は毎秒83.0トークンで、ここにあるClaudeの中で最速。価格表でも実測タスクでも安い。
勝らない点。 指標スコア53.4はOpus 5の60.7に対して、上位半分のモデルの中で最も大きな差だ。知識信頼性は15.3でOpus 5の半分にも届かない。AA-Briefcaseでは1385 Eloで1719に劣る。
価格。 100万トークンあたり入力2.00ドル、出力10.00ドル、キャッシュヒット0.20ドル、2026年8月31日まで。9月1日からは3.00ドルと15.00ドルになる。現在の料率で組んだコストモデルは4週間以内に失効する。
結論。 実質的な性能低下に対してささやかな節約でしかなく、9月にはさらにその節約分も縮小する。大量かつリスクの低い作業には価値がある。コストモデルは現在の料率ではなく9月の料率で組むべきだ。
5. Gemini 3.6 Flash
最適な用途: 相手側に人間が待っているあらゆる場面。
Googleの主力モデルであるFlashは2026年7月21日に登場し、毎秒213.5トークンとこのまとめの中で最速、Opus 5の3.8倍にあたる。コストはタスクあたり0.56ドルだ。詳細はGemini 3.6 Flashの記事に、またGoogleの製品ライン内で比較検討したいなら別の代替モデルリストもある。
Opus 5に勝る点。 速度は大きく上回る。タスクあたりコストは4.2倍低い。テキスト、画像、動画、音声、PDFすべてで入力単価が一律であり、これは珍しく、入力が多様な場合に有用だ。知識信頼性23.5はこの価格帯としては十分立派で、GPT-5.6 Solの21.7より良い。
勝らない点。 指標スコア50.1は10.6ポイント低い。AA-Briefcaseでは962 Eloで、長時間のエージェント実行には向いていない。1Mの入力ウィンドウを持つにもかかわらず、出力は65,536トークンに制限される。
価格。 100万トークンあたり入力1.50ドル、出力7.50ドル、キャッシュヒット0.15ドル。バッチはその半額。
結論。 レイテンシそのものが製品となる場面では、これが正解だ。 ライブチャット、自動補完、ユーザーへのストリーミング表示など。監視なしで複数ステップの作業を行うエージェントには適さない。
6. Grok 4.5
最適な用途: 記憶力を落とさずに支出を削減すること。
xAIのモデルはここで目立たないながらお得な選択肢だ。指標スコアは53.8でタスクあたり0.36ドル、Opus 5の6.4分の1にあたる。知識信頼性26.4はこのページで3番目に高い数値で、Gemini 3.6 Flash、GPT-5.6 Sol、そしてまとめの中のすべてのオープンウェイトモデルを上回る。私のGrok 4.5概説記事ではより広い視点を扱っている。
Opus 5に勝る点。 タスクあたりコストは6.4倍低い。出力速度は毎秒61.3トークンで55.7より速い。入力2ドル、出力6ドルという価格表は、非公開モデルの中でも比較的安い部類に入る。
勝らない点。 指標スコア53.8は6.9ポイント低い。コンテキストは500Kが上限で、ここにある他のモデルの半分にすぎない。リポジトリ全体や長いチケット履歴を入力する場合には重要な制約だ。AA-Briefcaseでは1314 Eloとなっている。
価格。 100万トークンあたり入力2.00ドル、出力6.00ドル、キャッシュヒット0.30ドル。
結論。 サポート業務で最も重要な軸において過小評価されているモデルだ。ティアを下げようとしていて、モデルが事実をでっち上げることを心配しているなら、まず試すべきはこれだ。
7. GLM-5.2
最適な用途: 顧問弁護士が疑問を持たないライセンスの、高速なオープンウェイトモデル。
Z.aiのフラッグシップモデルはMITライセンスで、指標スコアは51.1、毎秒182.7トークンとGemini 3.6 Flashに次ぐ速度だ。タスクあたり0.57ドルでOpus 5より4.1倍安い。デプロイの詳細は私のGLM-5.2企業向け解説記事にまとめている。
Opus 5に勝る点。 MITライセンスによるオープンウェイトは、利用可能な中で最もクリーンな商用ライセンスであり、どのClaudeモデルも満たせない唯一の要件だ。速度は3.3倍、コストは4.1倍。フルの1Mコンテキストにも対応する。
勝らない点。 知識信頼性は4.0で、このまとめの中で最も低い採点値であり、Opus 5の31.3を大きく下回る。指標スコアは9.6ポイント低い。出力は128Kに制限される。
価格。 ホスト型APIで100万トークンあたり入力1.35ドル、出力4.29ドル、キャッシュヒット0.23ドル。セルフホスティングはライセンス料が不要な一方でハードウェアコストがかかり、私のオープンソースAIエージェントまとめではそれに実際何が必要かを解説している。
結論。 速度と許諾範囲の広いライセンスを求めるなら、最良のオープンウェイト選択肢だ。ただしその知識スコアは厳しい制約として扱うべきだ。これは質問をするモデルではなく、ドキュメントを与えるためのモデルだ。
8. DeepSeek V4 Flash
最適な用途: 価格の底値。
0731ビルドは2026年7月31日に公開ベータへ移行し、まとめの中で本格的なモデルとしては桁違いに最も安い。AAのスコアは49.9でOpus 5より10ポイント低いが、指標タスクあたり0.03ドルだ。重みはMITライセンスで約167GB、コミュニティによる量子化版も57種類存在する。私のDeepSeek V4 Flash記事と価格分解記事では各モードについて詳しく解説している。
Opus 5に勝る点。 価格はタスクあたり86倍安い。重みはMIT。コンテキストは1Mで、出力上限は384Kとここでは最大。出力速度は毎秒122.7トークンでOpus 5の2倍以上。キャッシュヒットは100万トークンあたり0.0028ドル。
勝らない点。 指標スコアは10.8ポイント低く、設定を誤るとその差はさらに広がる。DeepSeek自身の表によれば、Flashは思考なしでHLE 8.1、最大出力設定で34.8となる。重みは同じでも実行結果は異なる。AAは0731ビルドをOmniscienceでまだ採点していないため、その知識信頼性は「良好」ではなく「未測定」として扱うべきだ。ピーク時間の2倍料金サーチャージも発表されているが、開始日は未定だ。
価格。 100万トークンあたり入力0.14ドル、キャッシュヒット0.0028ドル、出力0.28ドル。
結論。 コストの面では無敵であり、注意すべき理由は品質ではない。DeepSeekの有料APIの利用規約は学習利用について保護的ではなく沈黙しており、公開されたDPAもゼロリテンションのオプションも存在せず、データは中国の法律の下に置かれる。これは技術的な問題である前に、まず調達上の問題だ。
これらのチャートが測るものと、ユーザーが本当に尋ねることの間にある溝
Anthropicはローンチ時に自社のコスト対スコアのチャートを公開しており、それはどのベンチマークでも一貫した物語を語っている。フロンティアの傾斜は緩やかで、その最後の部分を登るには急激なコストがかかる。
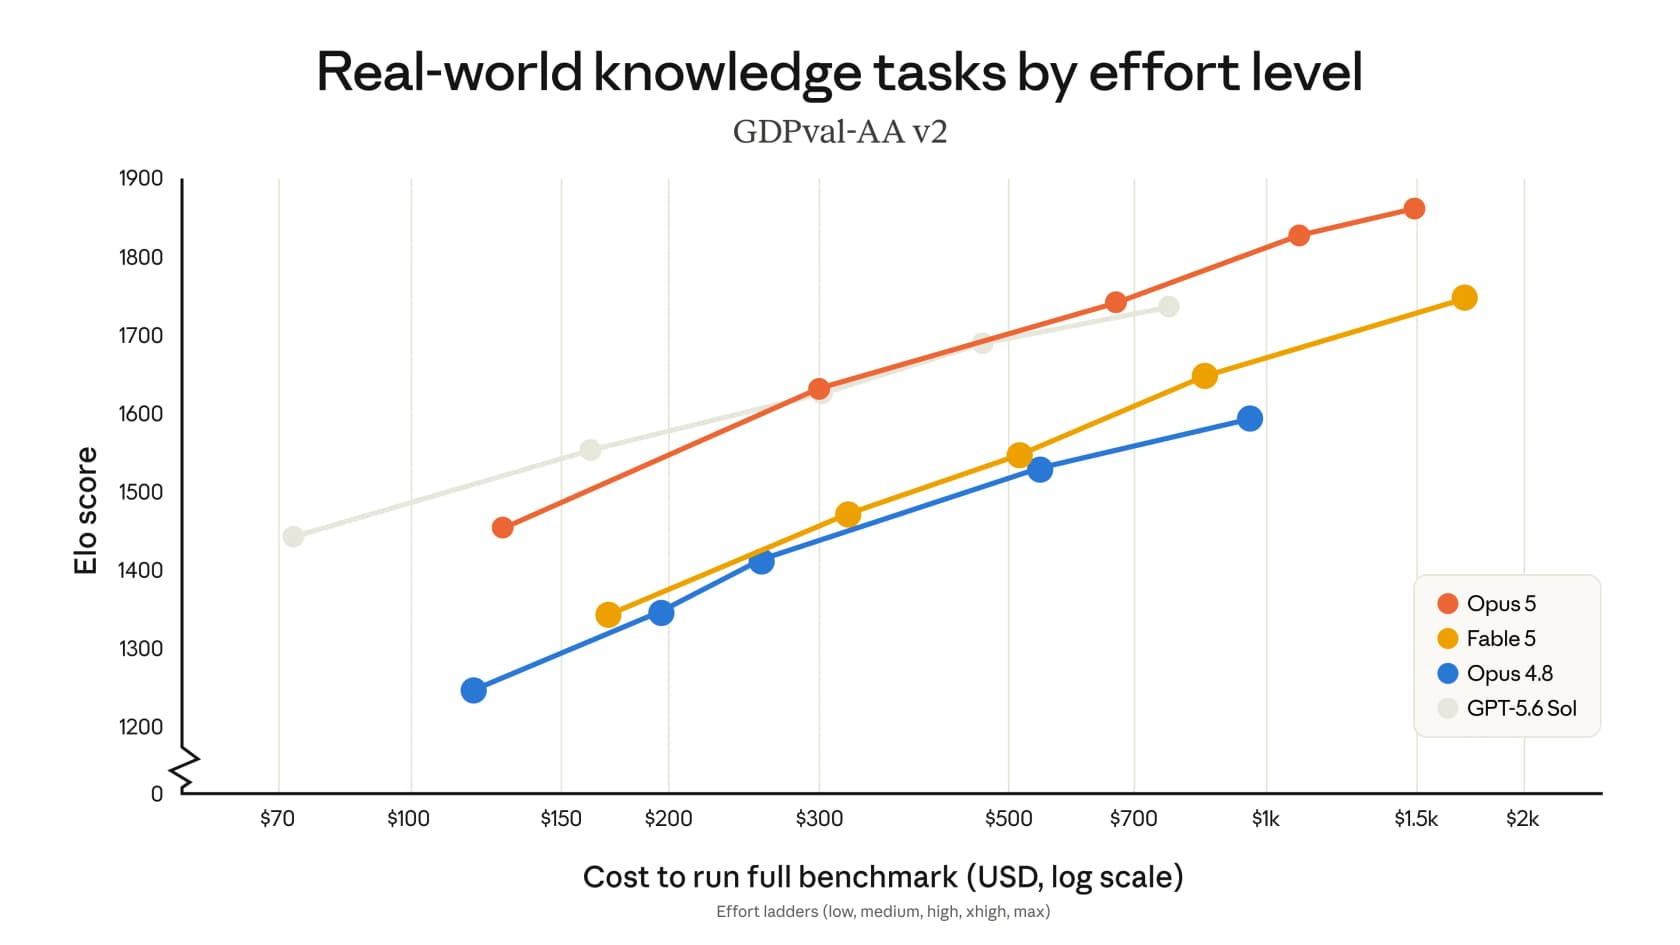
そしてこれらのどれも測っていないことがある。このページのすべての評価は一般的な性能を測るものだ。あなたのエンタープライズプランにSSOが含まれているか、あるいは3月にノルウェーへの発送を停止したことをモデルが知っているかを測るものは一つもない。
だからこそ「もっと賢いモデルを使えばいい」という反射的な発想は、それを試した人々を何度も失望させ続けている。
"At work I am sitting on a small pile of incomplete/wrong/missing-the-point bug reports right now, all generated by Opus 5 on High effort. Even under good conditions, LLMs are still wrong quite a lot, and confidently so."
私はこの光景を何度も見てきたので、その形を見分けられるようになった。あるオペレーターは、シフトの最中にエージェントへの指示にこう書き込む。
"客に対して、できないことを約束するのはやめてくれ。この客の注文が金曜までに届くとは保証できない"
これは、AIが顧客に配送日を過度に約束してしまう様子を目にしたECサポートマネージャーによる、実際の修正指示だ。そしてこれをモデル選定に関する記事で引用する価値がある理由がここにある。このページのどのモデル変更もこれを解決しない。 モデルは混乱していたわけではない。流暢で自信に満ちていたが、その事実が業務運用の中にあり、自分の重みの中にはないことを知らなかったのだ。
私が同席した別のチーム、Zendeskで月間約200件のチケットを処理するデンマークの車両テレマティクスサポート窓口は、反対側から同じ壁にぶつかった。彼らのボットは、データベースに存在しない自動車ブランドのサポートを何の疑いもなく肯定した。ヘルプセンターの記事に「すべてのモデルに対応」と書かれていたからだ。モデルはドキュメントを正しく読んでいた。ドキュメントの方が間違っていたのだ。知能指標を50から60に上げても、これは何一つ解決しない。これこそ、モデルではなくナレッジベースそのものをテスト対象にすべき理由だ。
だからこそサポート業務においてはAA-Omniscienceの列が指標の列よりも重要であり、そこにある最高値であるFable 5の40.2でさえ解決策にはならない。解決策はアーキテクチャの問題だ。回答を自社ドキュメントに基づかせ、出典を示し、確信度が低いときは控える。これこそAIエスカレーション管理が本来扱うべきことであり、それはどのモデルを選ぶかよりも一段上の層に位置する。引き渡しそのものの仕組みはエージェントハンドオフのベストプラクティスで解説している。
サポートキュー向けに特化してモデルを選ぶなら、結果を決めるのはリトリーバルの品質、確信度のしきい値、そして本番投入前のテスト方法だ。AIサポート品質保証ではテストの側面を解説している。
グラウンディングの側面については、まずハルシネーション対策から始めるとよい。この層こそが、下にあるモデルがどれだけ優れていても、本物のエージェントとルールベースのチャットボットを分ける決め手になる。
eeselを試す
Opus 5とこの8つのモデルの間で選ぶのは実際の重要な決断であり、上の表がその選択を少しでも早めてくれることを願っている。しかしそれは、あなたのAIサポートが実際に機能するかどうかを決める決断ではない。
eeselはモデルより上の層に位置する。チームがすでに解決したチケットから学習し、すべての回答を自社のヘルプセンターと内部ドキュメントに基づかせ、確信が持てないことについては推測せず沈黙する。顧客が一人も見る前に、過去数千件のチケットに対して実行できるので、実際の解決率を知る唯一のテストになる。Zendesk、Freshdesk、Gorgias、HubSpotなどへは数分で接続できる。料金は席数ではなく解決済みチケット単位のため、請求額が実際の仕事量に連動する。ほとんどのチームはまずTier-1のデフレクションにeeselを導入する。そこがカスタマーサービスの自動化の投資回収が最も早い場所だからだ。
すでにタスクあたりコストでモデルを比較しているなら、同じ計算を一段上に適用したものが解決あたりコストであり、それこそ財務チームが求めてくる数値だ。より詳しい解説はAIカスタマーサービスのコストにあり、自律動作よりまずドラフト作成から始めたいならサポート向けAIコパイロットがリスクの低い入り口となる。

eeselを試す のは無料。あるいはデモを予約すれば、まずあなた自身のチケット履歴に対して実行してみせる。
私の見解
これを3行にまとめるなら、こうなる。
請求額が理由でここに来たのなら、まずGPT-5.6 Solを選ぶべきだ。 指標では1.8ポイント劣るが、タスクあたり47%安く、このページ最良の取引になる。出力単価の高さから一見間違った選択に見えるが、実測データを確認すればそうではないと分かる。
理由がレイテンシならGemini 3.6 Flashを、請求額をほぼゼロにしたいならDeepSeek V4 Flashを選ぶべきだ。ただしDeepSeekのデータ規約は先に読んでおくこと。そこにある沈黙こそが実際のコストだからだ。
そして、探している理由がモデルが何かを間違えたからなら、Opus 5にとどまるべきだ。モデルを乗り換えても、最高スコアが40しかない100点満点のスケール上で数ポイント動くだけだ。回答を自社ドキュメントに基づかせることは、それよりもはるかに大きく状況を動かし、最終的にどのモデルを呼び出すかにかかわらず機能する。さらに探したいなら私のClaude代替まとめがより広いモデルファミリーを扱っており、カスタマーサービス向けAIは実際に仕事をこなす層を扱っている。