2026年、DeepSeek V4 Flashの代替ベスト8選

Kurnia Kharisma

Katelin Teen
最終更新 August 6, 2026
なぜスコアでランキングしないのか
私はSEOと検索意図を仕事にしている。「deepseek v4 flash alternatives」というクエリには、「より良いもの」を探しているという前提が隠れている。しかしこのモデルを測定している2つのボードを見る限り、多くの場合そうではない。
Artificial Analysisは最大エフォートでFlashを50とし、「知性面でトップクラスに位置し、同規模のオープンウェイトモデルと比較して価格も適正」と評している。Lunaは51点、Gemini 3.6 Flashは50点。知性面では横移動でしかなく、それに追加コストを払うことになる。
実際に買っているのは、機能かコンプライアンス上の答えだ。だからこのリストは、埋めるギャップごとに、乗り換えの正直なコストを添えて並べている。乗り換え元のモデルそのものについて純粋なスペック評を知りたければ、DeepSeek V4 Flashの概要とFlashレビューがカバーしており、Flash対GPT-5.6は最も近い一対一比較を詳しく扱っている。
数字を一箇所にまとめると
以下の数字はすべてArtificial Analysisかベンダー自身の料金ページからのもので、2026年8月4日に確認済みだ。「Index run」はAAがそのモデルをIntelligence Index全体で評価するのにかかった費用で、各社が公開している中でタスクあたりの実コストに最も近い数字だ。
| モデル | AA Index | 入力/100万 | 出力/100万 | Index run | 出力速度 | 最初のトークンまで | Index実行に使ったトークン数 | 入力形式 | コンテキスト | 重み |
|---|---|---|---|---|---|---|---|---|---|---|
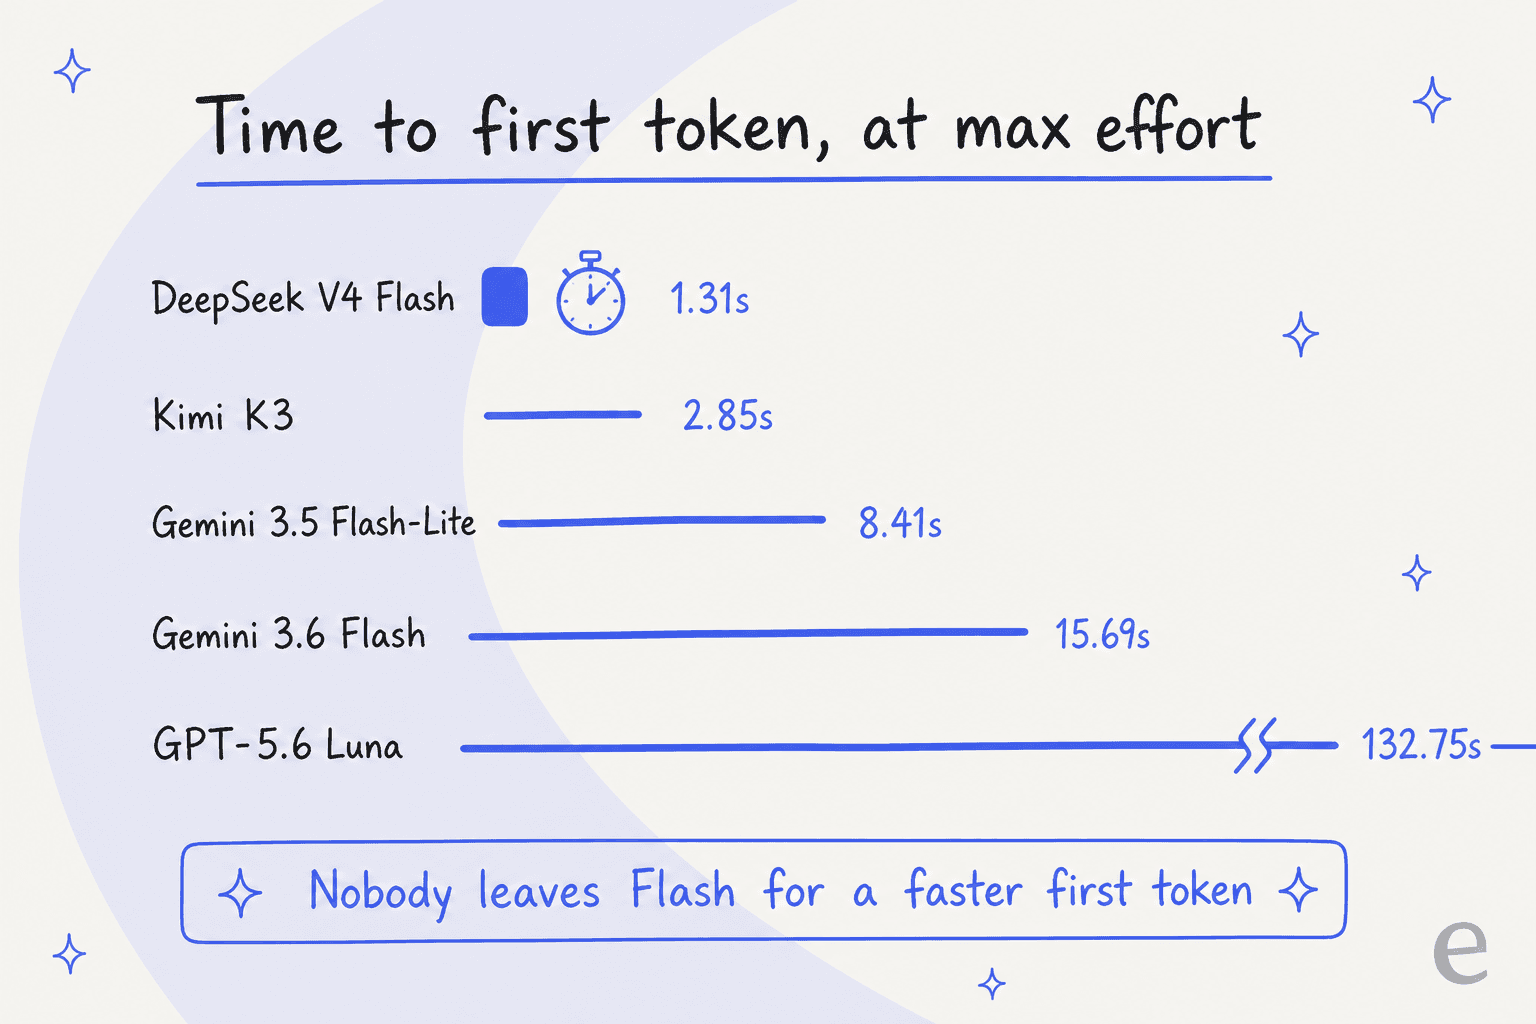
| DeepSeek V4 Flash 0731(max) | 50 | $0.14 | $0.28 | $72.02 | 113 t/s | 1.31秒 | 2.1億 | text | 1M | MIT |
| GPT-5.6 Luna(max) | 51 | $0.20 | $1.20 | $174.06 | 181 t/s | 132.75秒 | 1.3億 | text, image | 1.05M | closed |
| Gemini 3.6 Flash(high) | 50 | $1.50 | $7.50 | $726.70 | 213 t/s | 15.69秒 | 5,900万 | text, image, speech, video | 1M | closed |
| Gemini 3.5 Flash-Lite | 36 | $0.30 | $2.50 | $153.08 | 366 t/s | 8.41秒 | 4,300万 | text, image, speech, video | 1M | closed |
| Claude Haiku 4.5(non-reasoning) | 24 | $1.00 | $5.00 | 未公開 | 90 t/s | 0.96秒 | 未公開 | text, image | 200K | closed |
| Kimi K3(max) | 57 | $3.00 | $15.00 | $2,437.41 | 36 t/s | 2.85秒 | 1.3億 | text, image | 1M | kimi-k3ライセンス |
| DeepSeek V4 Pro | 44 | $0.435 | $0.87 | 未公開 | 未公開 | 未公開 | 未公開 | text | 1M | open |
| Qwen3.7-Flash | 未掲載 | $0.03–$0.20 | $0.13–$0.80 | 未公開 | 59 t/s | 未公開 | 未公開 | text, image, video | 1M | closed |
この表から浮かび上がる2点がある。FlashはHaikuを除く全モデルの中で最初のトークンまでの速さが2倍であり、ここではオープンウェイトかつ実際に安価な唯一のモデルだ。それ以外はすべてトレードオフになる。
スコアではなくギャップで選ぶ
リストの前に、これが5クリックで済む意思決定だ。何が自分をブロックしているかを選べば、選ぶべきモデルと乗り換えコストが両方わかる。
本当に何のために乗り換えるのか?
Flashはすでに最も安く、最初のトークンまでも最速。だからギャップで選ぶ。
Flashには画像入力の記載がない。Lunaはテキストと画像を扱い、AAインデックスでは1点高い51点、181トークン/秒で動く。この比較の中で画像対応モデルとしては最も安く、入力$0.20、出力$1.20だ。
乗り換えコスト:キャッシュ多用、推論多用、長文プロンプトのいずれの形状でも実際の請求は約3倍。最大エフォートでの最初のトークンまでは132.75秒。エフォートを下げない限りインタラクティブな用途には向かない。
同じモデルをそのまま使い、推論の場所だけを変える。重みはMITライセンスで、単一のAMD MI300X上で0731チェックポイントを動かす公開済みの本番構成は、シングルストリームで168.6トークン/秒に達する。これはファーストパーティAPIで計測された113を上回る。
乗り換えコスト:ハードウェア。156.67GiBの重みをHBMに載せる必要があり、MI300Xを単体で購入するのは難しい。GPUを運用したくないなら、Geminiの有料プランはコンテンツを製品改善に使わないと明記している。
このグループで最速の366トークン/秒、そして最も簡潔:AAインデックスの実行にかかった出力トークンはFlashの2.1億に対して4,300万。テキスト、画像、音声、動画を入力できる。大量のトリアージや分類に向いている。
乗り換えコスト:知性。FlashのIndex 50に対して36と、別の重量級のタスクになる。どんな価格でもコンピュータ操作は使えない。
信頼性重視の選択肢。AA-Omniscienceハルシネーション率はFlashの84%に対して51%、Omniscience IndexはFlashの-16に対して18、そしてこの中で生の知性が最も高い57点。
乗り換えコスト:タスクあたりのコストで約29倍、速度は36トークン/秒。予算版K3は存在しない。K3(low)行はFlashより3点低い47点なのに、コストは8倍。推論はオフにできない。
同じファミリーに留まる。Proはリコールと長文コンテキストの検索精度で明確に勝つ:SimpleQA-VerifiedはFlashの34.1に対して57.9、1MコンテキストでのMRCRは78.7に対して83.5、LMArenaの人間投票ではFlashの1436に対して1458と評価されている。
乗り換えコスト:キャッシュミス入力と出力で3.11倍、そして安価な実行方法はない。DeepSeek自身のエフォートマッピング表はlowのリクエストをProでhighとして処理する。
1. GPT-5.6 Luna
向いている用途: 最も近い一対一の乗り換え先で、画像入力を追加する最も安い方法。
実際はどんなモデルか
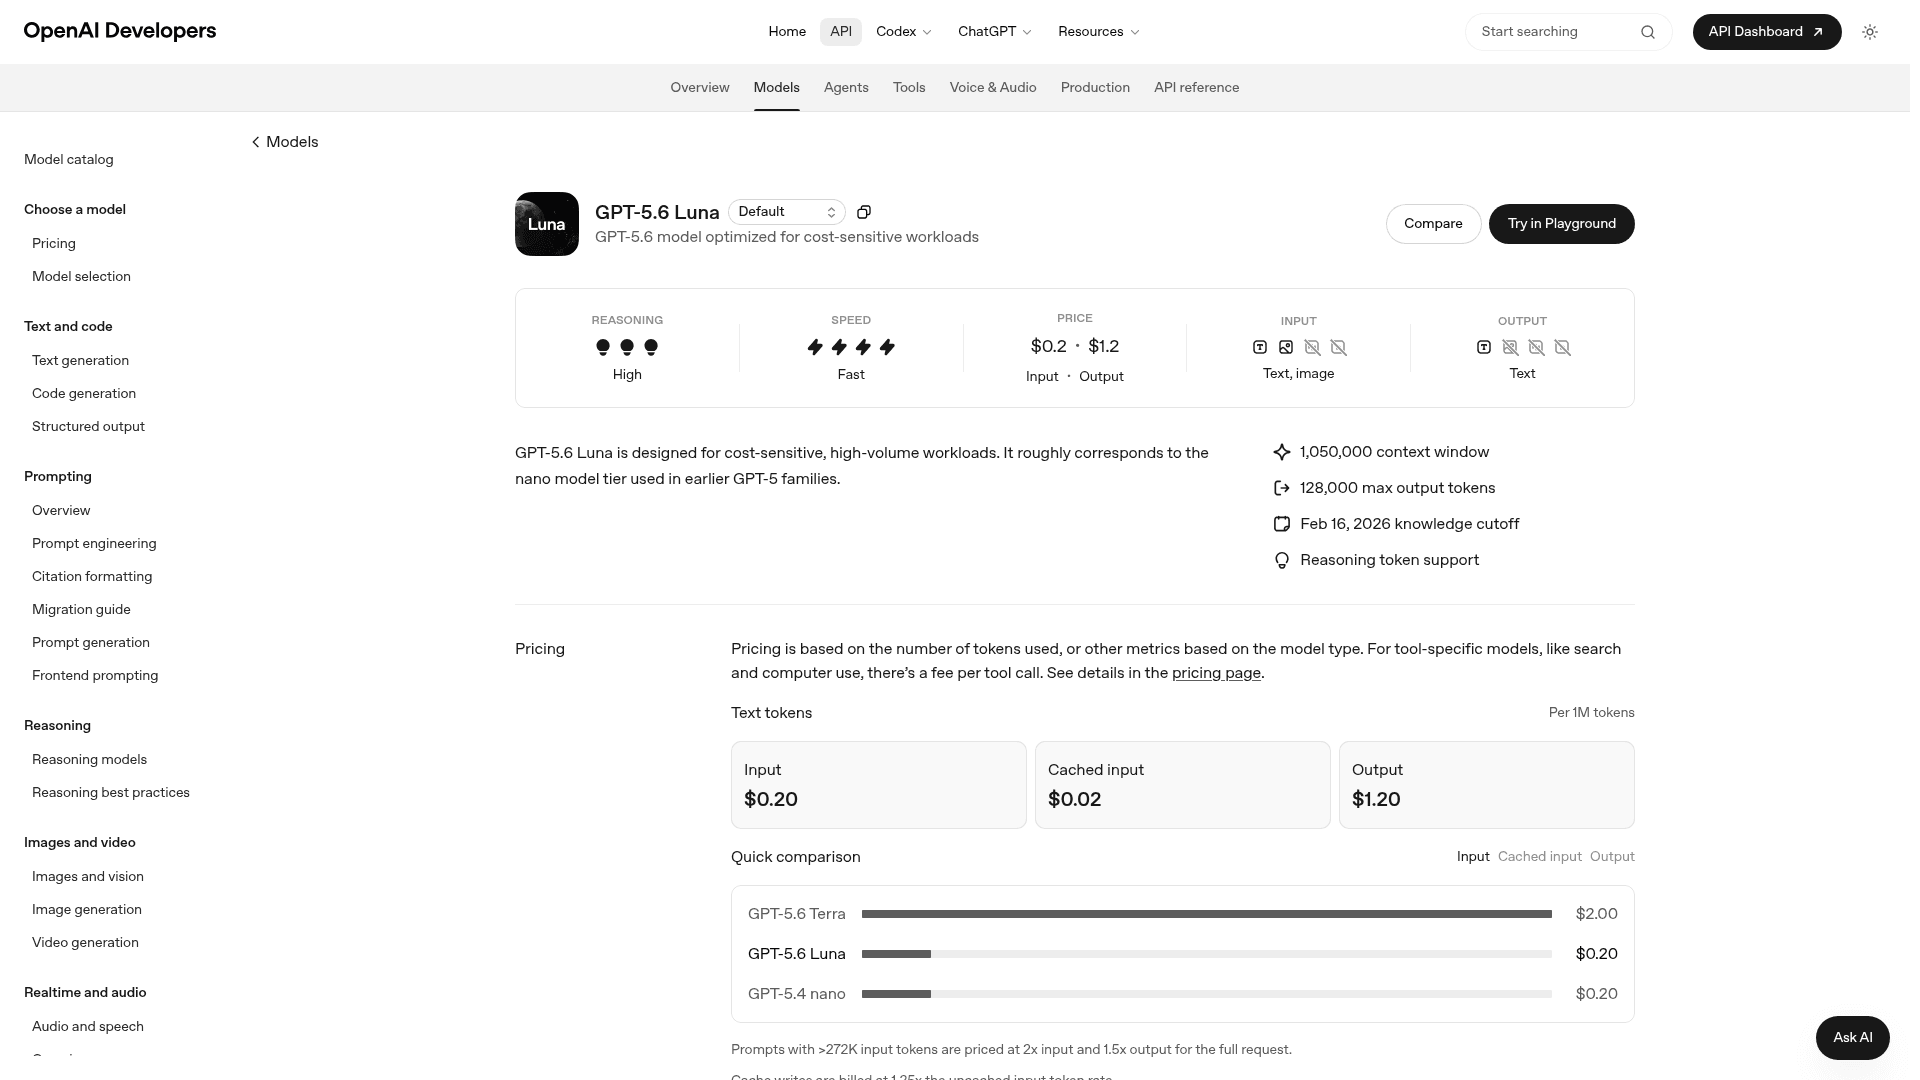
LunaはGPT-5.6ファミリーの低価格帯で、モデルページ自身に「コスト重視のワークロード向けに最適化」と書かれている。Flashとの比較で多くの記事が間違える理由は、gpt-5.6がフロンティア級のSolを指す別名になっているからだ。そのため人々は誤って$0.14のモデルを$5のモデルとベンチマークしてしまう。Luna限定で見れば、知性の比較はほぼ引き分けだ:AAインデックスで51対50。
コンテキストウィンドウは1,050,000トークン、最大出力トークンは128,000、ナレッジカットオフは2026年2月16日、推論トークンにも対応する。テキストと画像の入力、テキストの出力。
料金
100万トークンあたり入力$0.20、キャッシュ入力$0.02、出力$1.20。実はその下に多くの記事が見落としている割引の段階がある。
| ティア | 入力/100万 | キャッシュ/100万 | 出力/100万 |
|---|---|---|---|
| Standard | $0.20 | $0.02 | $1.20 |
| Batch | $0.10 | $0.01 | $0.60 |
| Flex | $0.10 | $0.01 | $0.60 |
| Fast mode | $0.40 | $0.04 | $2.40 |
| Long context(272K超) | $0.40 | $0.04 | $1.80 |
BatchやFlexでは、Lunaの入力$0.10はFlashの$0.14より実際に安い。ワークロードが一晩かけて処理できるもので、入力が多く出力が短いなら、これはチケット分類の多くに当てはまる話だが、Lunaが優位になり得る。Flashにはバッチ割引がまったくない。
Flashより優れている点
画像入力、計画に使える公開レイテンシ、そしてセキュリティレビュー担当者に説明できるデータ処理の説明だ。ウェブ検索についても正確に言っておく必要がある:Flashは実際にサーバーサイドのweb_searchツールを持っているが、それはFlash専用のResponses APIだけで、chat-completions経路にはない。「DeepSeekにはウェブ検索がない」という広く繰り返された説明は古い。
Flashに劣る点
Hacker Newsの実測値によれば、実際のギャップは出力列が示す4.3倍ではなく2倍から3倍だ。Lunaのキャッシュ入力も安いからだ。しかし3倍でも3倍だ。そしてレイテンシの数字は容赦ない。
"2x to 3x the price… 2 to 5 times faster inference"

その「faster inference」はスループットのことであり、応答性のことではない。最大エフォートでのLunaの最初のトークンまでの時間は132.75秒だ。バッチ処理には十分だが、チャットウィジェットには向かない。
計画すべき非対称の崖もある。入力が272Kを超えるプロンプトは、超過分だけでなくリクエスト全体が入力2倍、出力1.5倍で再計算される。キャッシュ書き込みは非キャッシュ料率の1.25倍で課金される。
結論
Flashから離れる理由が画像入力かコンプライアンスの話であれば、まず試すべきはこれだ。バッチ料率のおかげで想像より安くなる。最大エフォートでインタラクティブな面に置くことは勧めない。ティアの詳しい内訳はGPT-5.6の料金ガイドにあり、GPT-5.6レビューはファミリー全体をカバーしている。
2. Gemini 3.5 Flash-Lite
向いている用途: 大量の分類、トリアージ、そしてトークン/秒がボトルネックになる用途全般。
実際はどんなモデルか
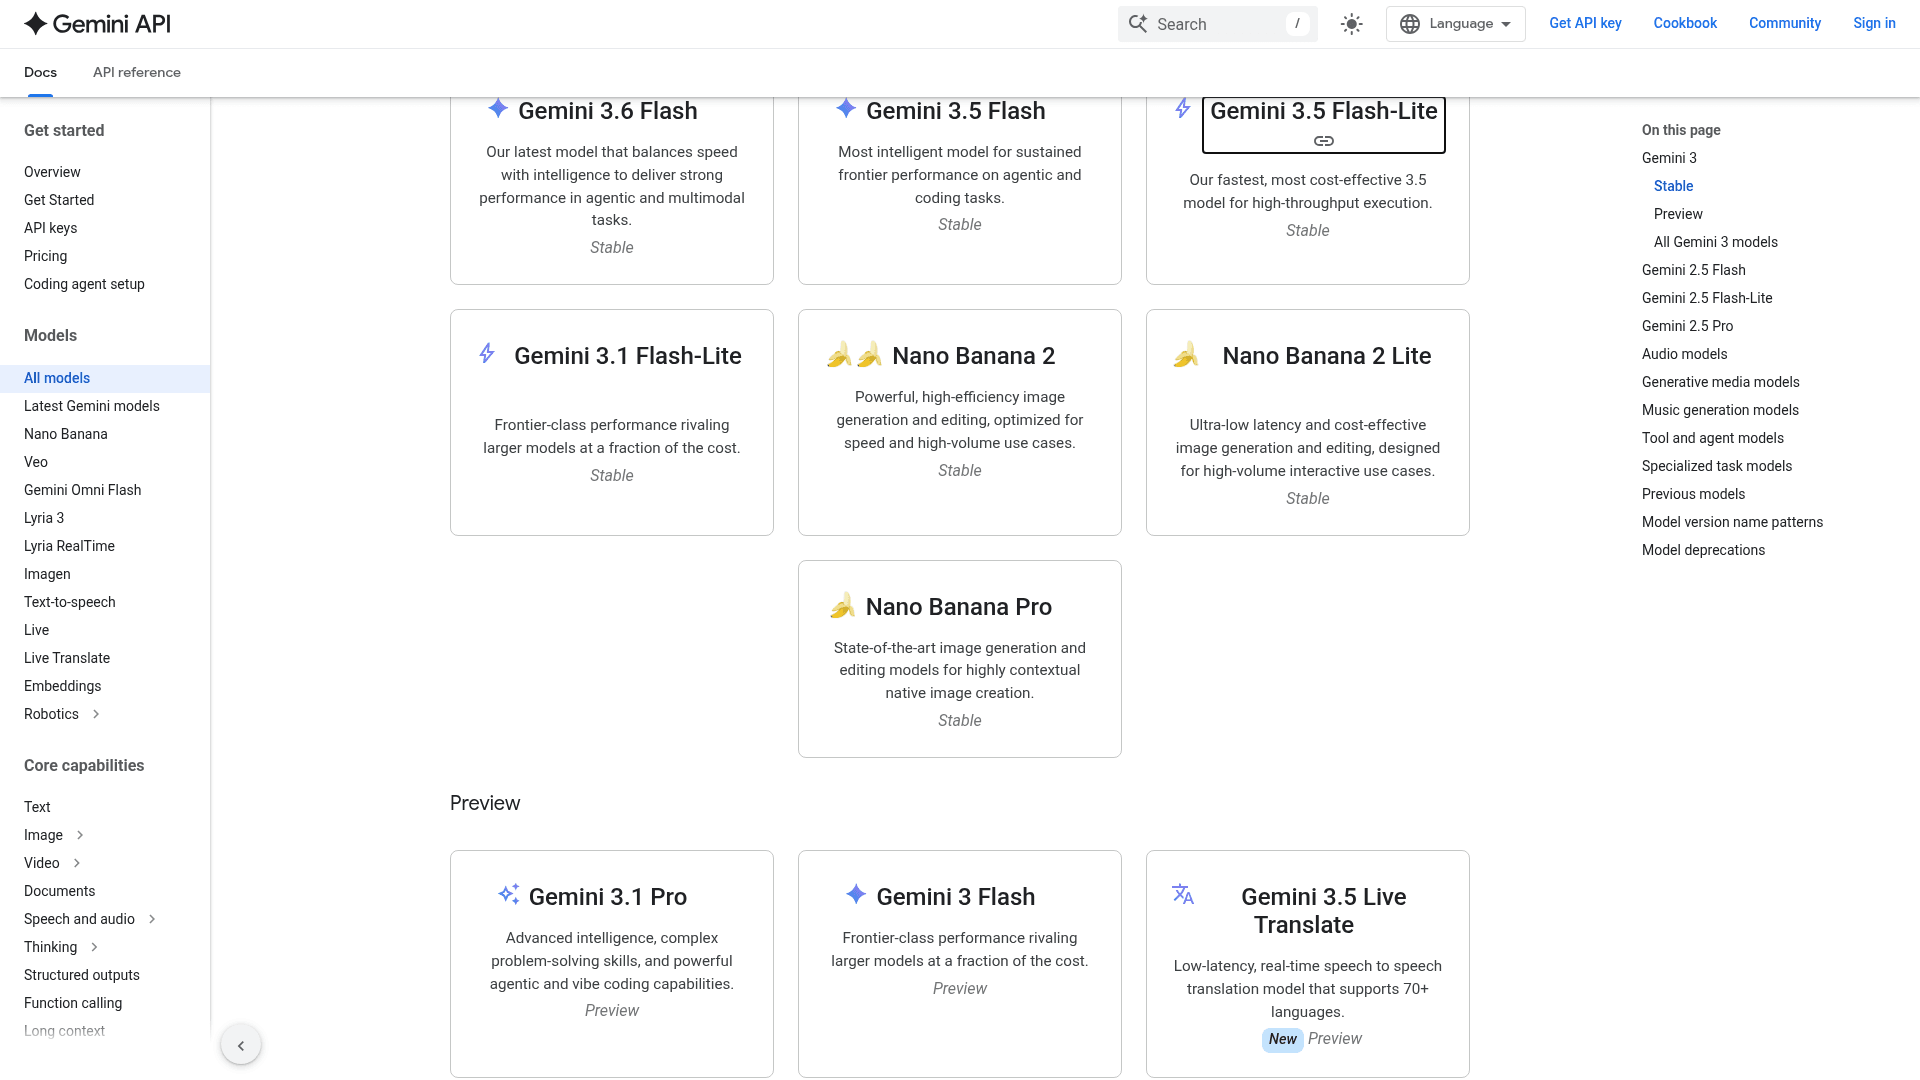
Googleの3.5系で最も安価な一般提供モデルで、モデルページには「高スループット実行に向けた、最速かつ最も費用対効果の高い3.5モデル」と説明されている。モデルコードはgemini-3.5-flash-lite、入力コンテキストは1,048,576、出力は65,536で、テキスト、画像、音声、動画、PDFを入力できる。
料金
Standardで100万トークンあたり入力$0.30、出力$2.50。BatchとFlexは両方を半額の$0.15/$1.25にする。Priorityは$0.54/$4.50。コンテキストキャッシングは$0.03。
Flashより優れている点
2つの数字がある。この中で最速の366トークン/秒、そしてAAインデックスの実行にかかった出力トークンはFlashの2.1億に対して4,300万。AAはこれを「かなり簡潔」と評し、Flashを「非常に冗長」と評している。この簡潔さのおかげで、名目上9倍高い出力レートを持つモデルなのに、Flashの$72.02に対してインデックス実行にかかったコストは$153.08、つまり9倍ではなくおよそ2倍にとどまっている。
4つのモダリティすべてでマルチモーダル入力がネイティブに対応している。そしてGoogleの有料ティアはDeepSeekが何も言わない部分を明言している:料金ページには有料ティアの特性として「コンテンツは製品改善に使用されない」とあり、無料ティアでは「コンテンツは製品改善に使用される」とある。
Flashに劣る点
Intelligence IndexはFlashの50に対して36。これは小さな差ではなく、まったく別の重量級であり、エージェント的なタスクや複数ステップのタスクではFlash-Liteの方が劣る。どんな価格でもコンピュータ操作は使えない。最初のトークンまでは8.41秒で、Flashの6倍だ。
結論
大量の意図分類や感情分析を回すなら、これは正しい形であり、簡潔さが実際にコストを節約する。エージェントを動かすなら向かない。詳しくはGemini 3.5 Flash-Liteの概要を参照。
3. Gemini 3.6 Flash
向いている用途: Flashと同じ知性を出力トークン3分の1で実現し、さらにコンピュータ操作も使える。
実際はどんなモデルか
Googleの主力Flashティアで、2026年7月21日に発表された。「エージェント的かつマルチモーダルなタスクで強力な性能を発揮するよう、速度と知性のバランスを取ったモデル」と位置づけられている。ナレッジカットオフは2026年3月に更新。コンピュータ操作が組み込まれている。コンテキストは1M、出力は65K。
料金
100万トークンあたり入力$1.50、出力$7.50。Batchは両方を半額の$0.75/$3.75にする。
Flashより優れている点
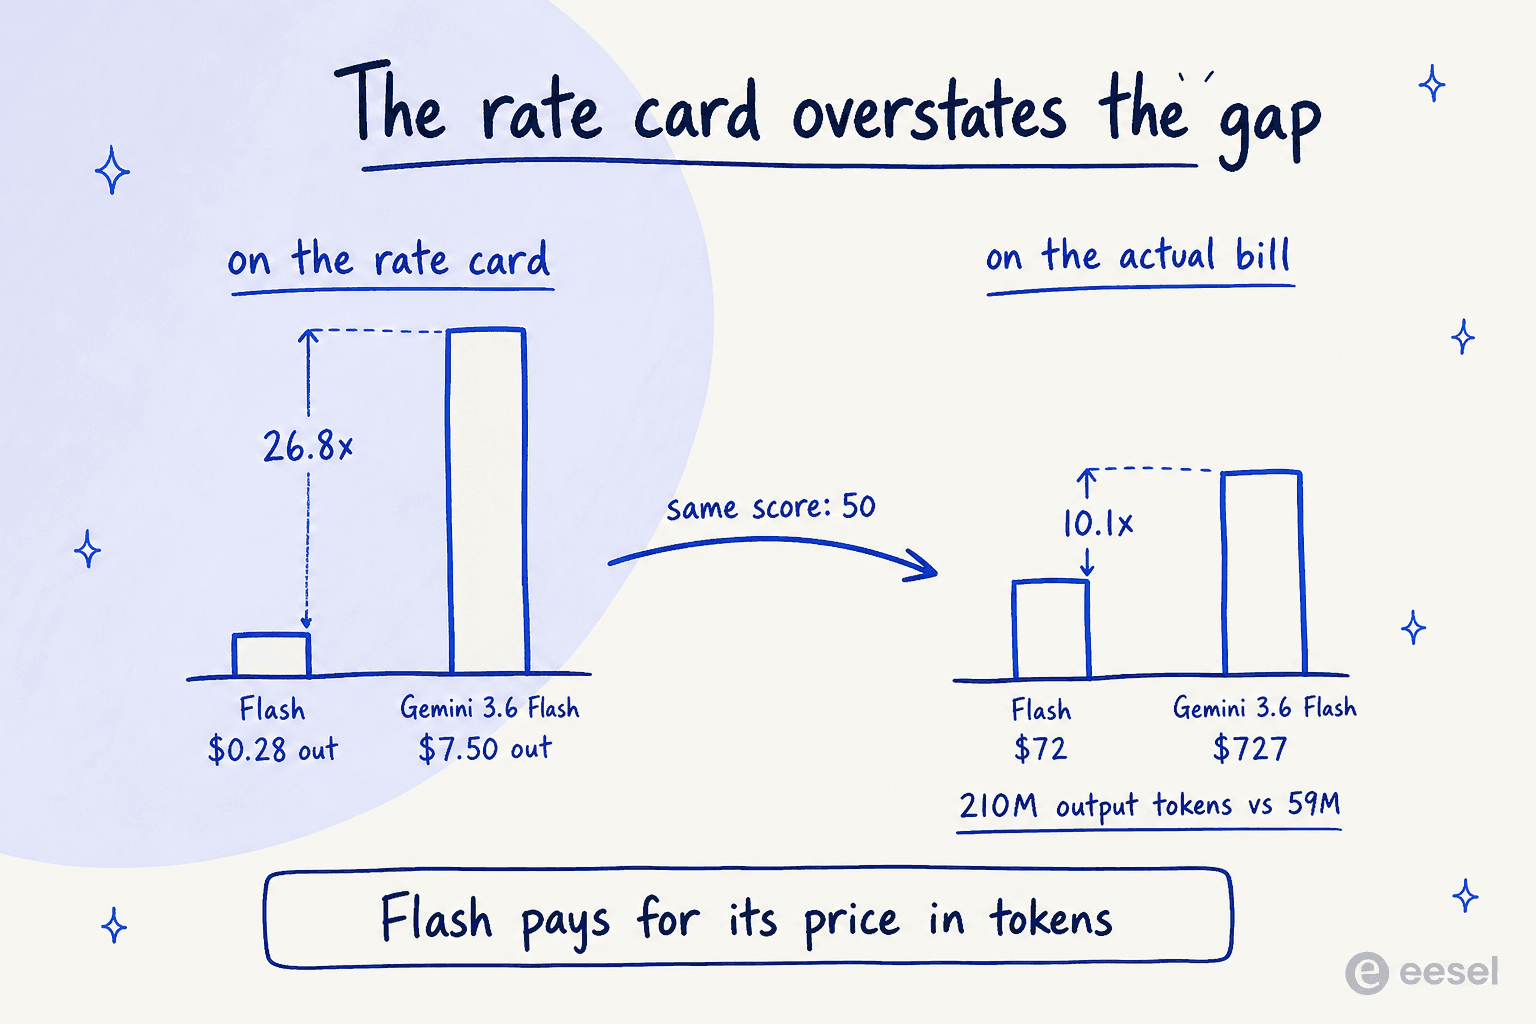
この項目が、この比較全体の読み方を変えるものだ。Gemini 3.6 FlashはFlashと同じ50点を出しながら、出力トークンはFlashの2.1億に対して5,900万で済む。定価上ではこれは出力の26.8倍のギャップだが、AAの実際のインデックス実行の請求額では$726.70対$72.02、つまり10.1倍になる。
10倍は依然として10倍なので、これは安いモデルではない。だが方向性が重要だ:この記事のあらゆる冗長性比較はFlashに不利な方向に動く。もし1トークンあたりの列を基準に予算を組んできたなら、節約額を過大評価してきたことになる。
さらに4つの入力モダリティ、213トークン/秒、そしてこのリストのこのティアでは他にないコンピュータ操作も備えている。
Flashに劣る点
知性が同等でもタスクあたりのコストは10倍。最初のトークンまでは15.69秒。重みは非公開のため自社ホストは選択肢にない。
結論
モデルが混在メディアのナレッジベースに対してエージェント的な作業をしていて、トークン数を減らしたいときに選ぶべきモデルだ。Gemini 3.6 Flashの概要、または評価の詳細はレビューを参照。
4. Claude Haiku 4.5
向いている用途: このグループで最速の最初のトークン、そして最も簡単なセキュリティレビュー。
実際はどんなモデルか
Anthropicの小型モデルclaude-haiku-4-5で、ドキュメントには「フロンティア級に近い知性を持つ最速モデル」と説明されている。テキストと画像の入力、200Kコンテキスト、ナレッジは2025年7月まで。Claude API、Amazon Bedrock、Google Cloud、Microsoft Foundryで利用可能。
料金
100万トークンあたり入力$1.00、出力$5.00。
Flashより優れている点
最初のトークンまで0.96秒、このページでFlashの1.31秒を上回る唯一の数字で、90.2トークン/秒だ。AAはこのTTFTを、その価格帯の中央値1.43秒と比べて「非常に競争力がある」と評している。
もう一つFlashより優れているのは調達面だ。BedrockとGoogle Cloudを通じたマルチクラウド提供により、データレジデンシーと契約はすでに誰かが解決済みの問題になり、自分で抱える問題ではなくなる。私の経験上、実際のブロッカーはどんなベンチマークよりもこちらの方が多い。
HIPAA/BAAでデモ中に完全にブロックされ、ソフトな懸念ではなくハードなブロッカーだと説明された。
Zendeskを使う米国の医療・理学療法プラットフォームで、月間約500チケットを処理している
その取引はハルシネーション率で頓挫したわけではなかった。
Flashに劣る点
非推論モードでのIntelligence Indexは24で、この中で最低。コンテキストウィンドウも200Kと最小で、他の全モデルの1Mに劣る。AAはインデックス実行のコストを公開していないため、タスクあたりのコストは不明だ。Anthropicは推論版も出しているが、24というのは非推論の行であり、デフォルト設定での$1/$5が買うのはそれだ。
結論
生の性能よりも応答性と契約面が重要な場合に選ぶべきで、それは顧客対応チャットの大半に当てはまる。エージェント的な作業には選ばないこと。開発者体験の側面はOpenAI API対Anthropic APIがカバーしており、上位ティアはClaude Sonnet 5の料金が扱っている。
5. Kimi K3
向いている用途: 29倍のコストを払う正当化ができる唯一のケース:間違えられない回答。
実際はどんなモデルか
Moonshot AIのフラッグシップで、2026年7月16日にローンチされた。総パラメータ2.8Tでアクティブ104B、コンテキストは1M、画像と動画にネイティブな視覚対応。オープンウェイトは約束どおり7月27日に公開され、96シャードにわたる1,561GBで、大規模MaaS事業者や非常に大規模なプロダクト向けの条件を含むkimi-k3ライセンスのもとで提供されている。
料金
100万トークンあたり入力$3、キャッシュヒット入力$0.30、出力$15。これはClaude Sonnetの領域であり、予算モデルの領域ではない。
Flashより優れている点
信頼性で、その差は小さくない。AA-Omniscienceハルシネーション率はFlashの84%に対して51%。Omniscience IndexはFlashの**-16**に対して18で、負のスコアは正解より誤答が多いことを意味する。正答率は37%に対して46%。この比較の中で生の知性は最高の57点。
規制業種や、お金に関わるAIエージェントが用途であれば、この差がすべての論拠になる。
Flashに劣る点
コストで、その差は定価どおりではない。出力レートはFlashの54倍だが、AAのタスクあたりコストは$0.03に対して$0.86であり、実際のギャップは29倍だ。K3は知性のポイントあたりで見ると言葉数が多いからだ。インデックス実行全体では$72.02対$2,437.41。
36トークン/秒で、この中で最も遅い。そして予算版K3は存在しない:AAは別にK3(low)行を掲載しており、Intelligence Indexは47、Flashより3点低く、タスクあたり$0.24かかる。これはFlashの8倍でありながら速くもない。Moonshotのクイックスタート自身が、推論をオフにできないことを確認しており、エフォートレベルはコストのティアではなくレイテンシの制御にすぎない。
データポリシーを比較する人向けに、もう一つ正直に述べておくべきことがある。Moonshotの規約は、DeepSeekが何も言わない部分について明確かつ許容的だ。第4条には「別途書面で合意しない限り、顧客コンテンツは前述の目的のために使用される可能性がある」とあり、オプトアウトは交渉済みのエンタープライズ契約を通じてのみ可能だ。データはシンガポールに置かれる。
結論
誤答のコストがトークン代の29倍を上回るなら購入する価値がある。それは実際にあり得る状況だが、多くの購入者が思うより狭い状況だ。それ以外なら計算が合わない。この一対一比較はFlash対Kimi K3でしっかり検証しており、Kimi K3レビューと料金ガイドもある。
6. DeepSeek V4 Pro
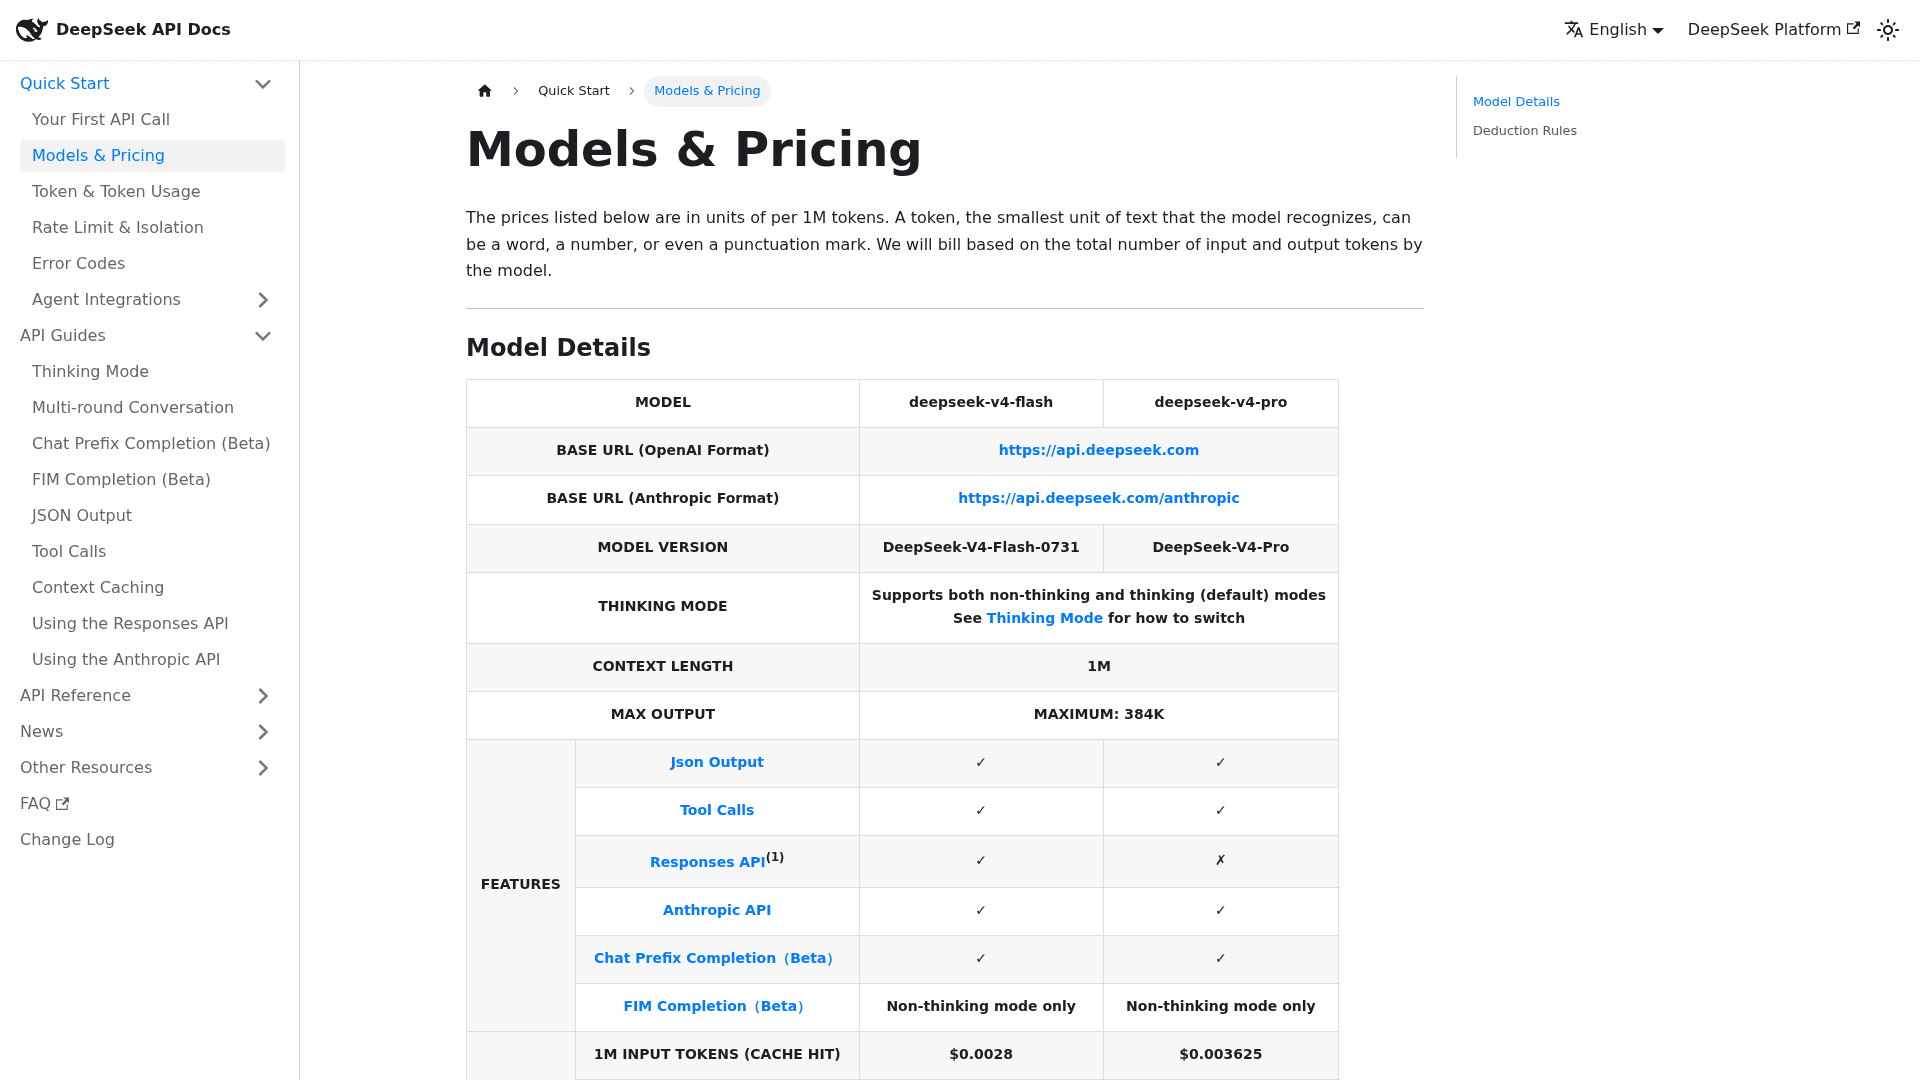
向いている用途: 推論よりリコールが必要なとき、同じファミリーに留まる。
実際はどんなモデルか
上位のV4ティアdeepseek-v4-proで、アクティブパラメータはFlashの13Bに対して49B。まだ4月のプレビュービルドのままで、0731相当版は存在しない。これがこの比較を奇妙にしている理由そのものだ。
料金
100万トークンあたりキャッシュミス入力$0.435、キャッシュヒット入力$0.003625、出力$0.87。キャッシュミス入力と出力ではFlashの3.11倍だが、キャッシュヒットでは1.29倍にとどまる。
Flashより優れている点
リコールと長文コンテキストの検索精度、つまり追加のアクティブパラメータが買っているものだ。DeepSeek自身のクロスモード表(最大エフォート)から:SimpleQA-Verifiedは34.1に対して57.9、GDPval-AA Eloは1395に対して1554、BrowseCompは73.2に対して83.4、1MコンテキストのMRCRは78.7に対して83.5。
そして人間投票もProに賛同している。自動インデックスとは違う結果だ。LMArena Textはそれぞれ約49,000票をもとに、Proを1458±4、Flashを1436±4とランクしている。2つのボードはそれぞれ違うものを測っており、どちらも正しい。
Flashに劣る点
Flash 0731は、DeepSeekが公開している9つのエージェント系タスクすべてでProのプレビュー版を上回る。DeepSWEは54.4対12.8で最大の差だ。AAではFlashが50点でタスクあたり$0.03、Proは44点で$0.05。正直に言っておくべき点として、9つのうち2つはDeepSeek自身の内部セットであり、評価ハーネスは未公開だ。
安価なPro実行方法もない。DeepSeekが公開しているエフォートマッピング表は、Proのlowリクエストをhighとして処理するため、3.11倍を支払いながら推論を下げることができない。このマッピングは2026年8月上旬に変更予定だった。
結論
狭いが実在する選択:長文書に対するリトリーバル重視の作業ならProを、エージェント的作業やコーディングならFlashに留まる。詳細はFlash対V4 Proを参照。
7. Flashの重みを自社ホストする
向いている用途: モデルはそのままに、レジデンシーの問題を一度の対応で解決する。
実際はどんなモデルか
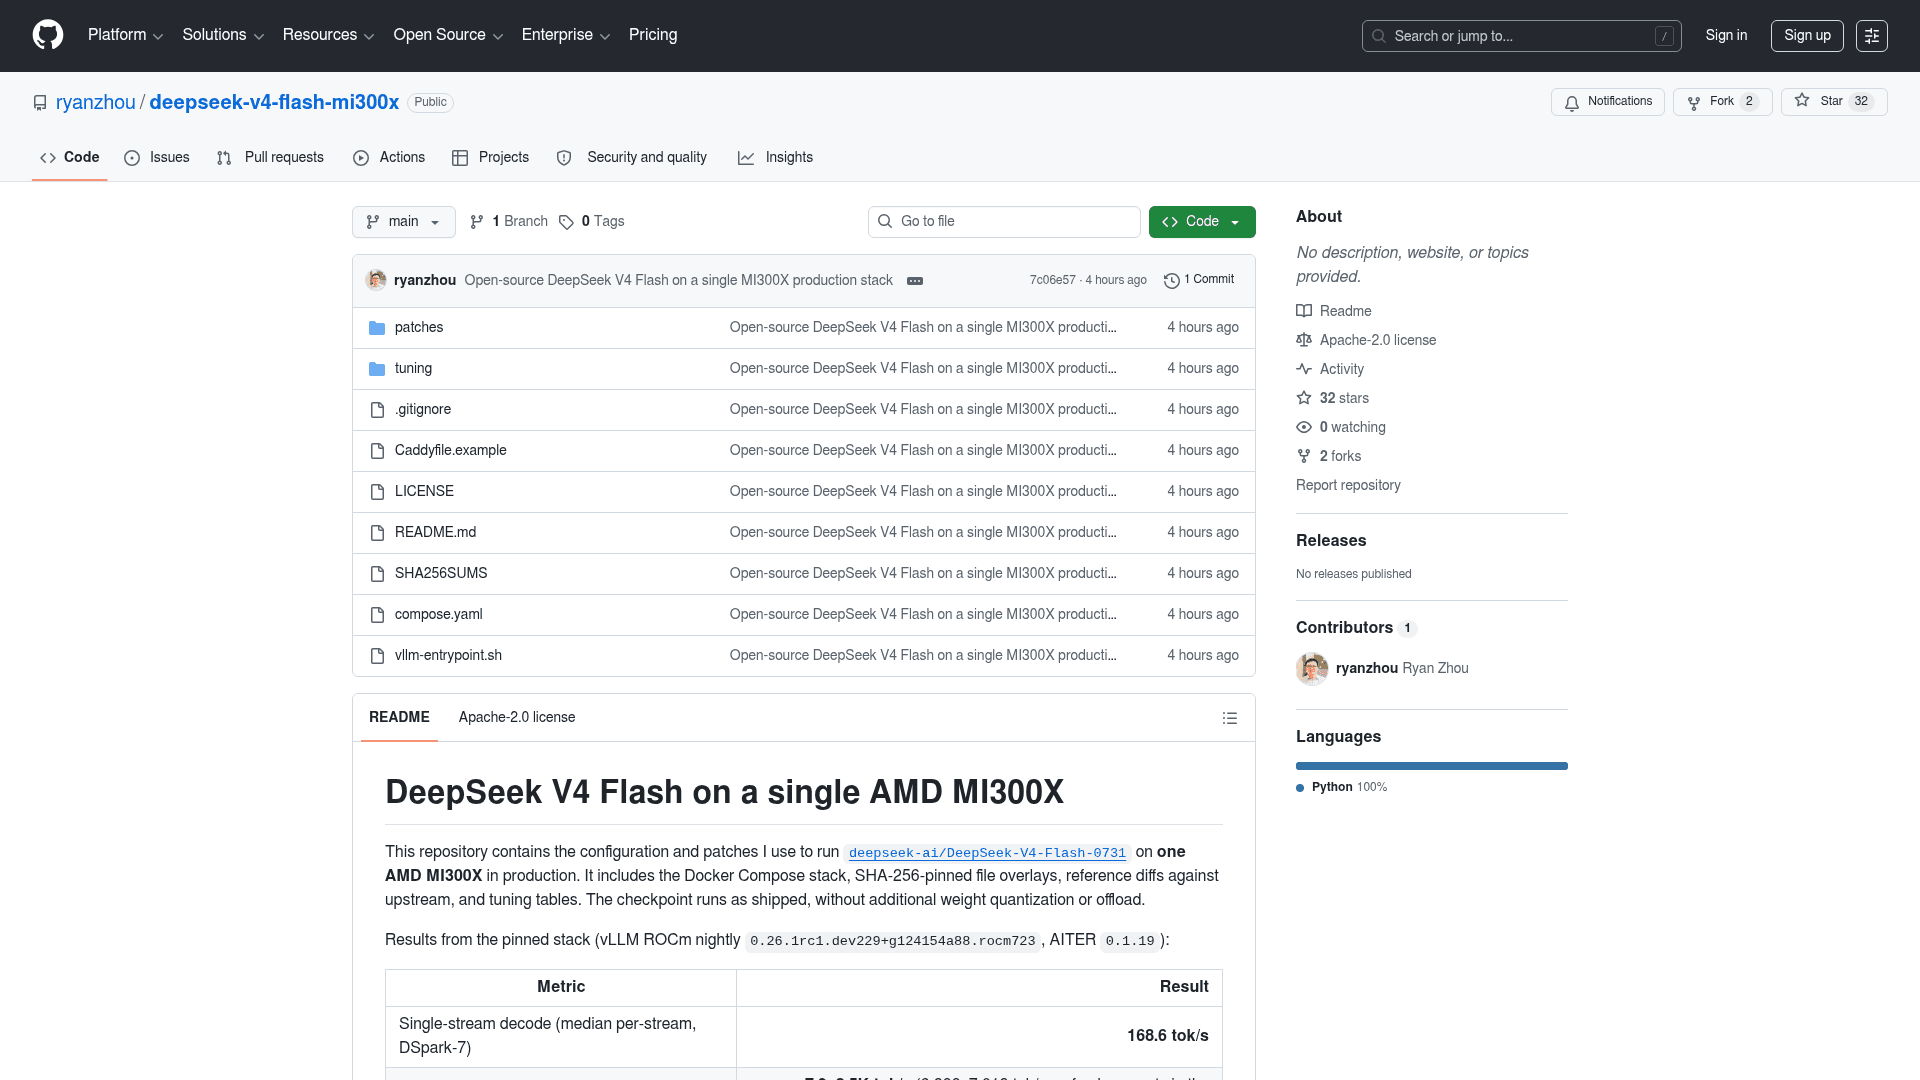
別のモデルではない。同じMITライセンスのDeepSeek-V4-Flash-0731チェックポイントを、自分で管理するハードウェア上で動かすだけだ。この項目がここに入る理由は、本番構成が本日公開され、Hacker Newsのフロントページで165ポイントを獲得したからだ。
料金
トークンではなくハードウェアだ。ブロッカーが予算ではなくセキュリティレビューであるなら、これこそが本質だ。
FlashのAPIより優れている点
リポジトリに固定されたvLLM ROCmスタックから得られた、単一のAMD MI300Xでの公開数値:
| 指標 | 結果 |
|---|---|
| シングルストリームデコード | 168.6 tok/s |
| チューニング済みカーネルでのプリフィル | 約7.9〜8.5K tok/s |
| 8並列ストリーム | 集計542 tok/s、ストリームあたり中央値90.3 tok/s |
| 64ストリームバースト | 集計830 tok/s、OOMなし |
| 検証済みコンテキスト | 256K(アーキテクチャは1Mをサポート) |
| HBM上の重み | 156.67 GiB、追加の量子化なし |
1枚のカードでの168.6トークン/秒は、Artificial AnalysisがDeepSeek自身のAPIで計測した113 tok/sを上回る。リポジトリは「チェックポイントは追加の重み量子化やオフロードなしで、出荷時のまま動作する」と明記しているため、これは速度と品質のトレードオフではない。
また、モデルそのものとは関係のない、最も多く聞く反論にも答えている。
Philは「答えを知らない場合に何らかの別のChatGPTのようなものを使うのか」、そしてそれをオフにできるのかを尋ねた。Gilは知識が自社組織内に閉じられたままかを尋ねた。
自社が承認したナレッジのみからAIが回答すること、一般的な学習データからではないことの保証を必要としていた、B2B半導体ハードウェア企業の技術評価担当者
このページの中で、この問いに利用規約の読み込みではなくネットワーク図で答えられる選択肢は、自社ホストだけだ。
Flashに劣る点
調達しなければならないハードウェア、そしてコミュニティはそれについて率直だ。
"I don't think you can buy a single 'MI300X' unit, right? Only the box with x8 of these at a cost of ~250K EUR."
同じスレッドに回避策もある。
"The MI350P is the one you want: It's a PCIe card, but it has less memory: 144GB. Luckily, DeepSeek V4 Flash will run in 144GB too because it's 256 MoE exports are native MXFP4 quantized."
もう2つ正直な注意点がある。リポジトリはチェックポイントを304Bパラメータと説明しているが、AAは総284Bを公開しており、実際のパラメータ数には食い違いがある。そして同じスレッドのxorfishによれば、DeepSeekは自社のDSparkペーパーでH800上で15K tok/s/gpuを得ているとされており、この構成にはまだ伸びる余地がある。
結論
データレジデンシーが乗り換えの理由なら、これはリストの一番下ではなく一番上に置くべきだ。モデルの品質を何もトレードオフしていない。関連記事:オープンソースAIエージェント、カスタムAIモデル、自社構築か購入か。
8. Qwen3.7-Flash
向いている用途: プロンプトが本当に小さいなら、最安の定価。
実際はどんなモデルか
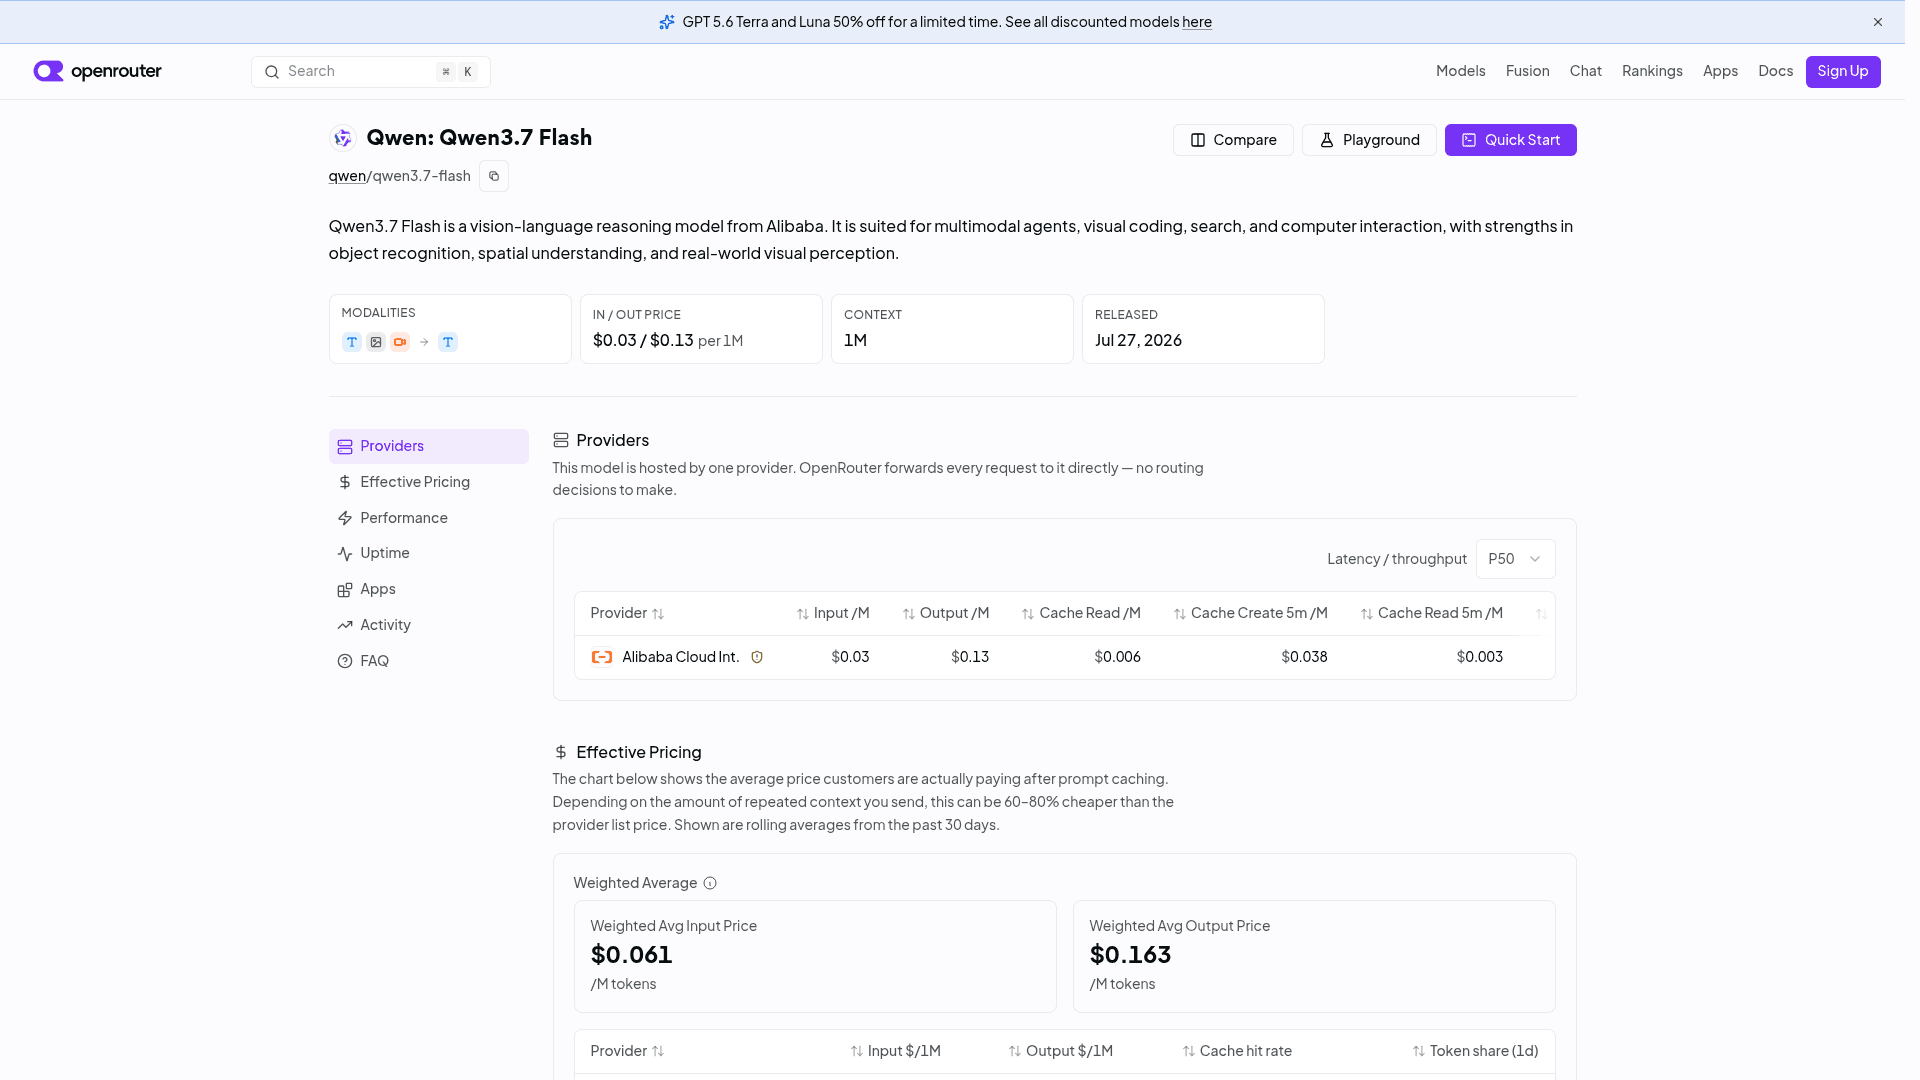
Alibabaのビジョン言語推論モデルで、2026年7月27日にリリースされた。OpenRouterでは「マルチモーダルエージェント、視覚的コーディング、検索、コンピュータ操作」に適していると説明されている。コンテキストは1M、テキストに加えて画像と動画を入力できる。
料金
ここが興味深い点であり、DeepSeekの「Flash」との名称の衝突が実際に混乱を招いている部分だ。料金はプロンプトサイズによって帯で分かれているため、見出しの料率と1Mコンテキストが同じ呼び出しの中で両方成立することはない。
| プロンプトサイズ | 入力/100万 | 出力/100万 |
|---|---|---|
| 32K未満 | $0.03 | $0.13 |
| 32K〜256K | $0.10 | $0.40 |
| 256K〜1M | $0.20 | $0.80 |
入力で6.7倍の振れ幅がある。そしてOpenRouterは実際に顧客が支払っている過去30日間の平均を公開している:入力$0.061、出力$0.163で定価を上回っており、実際のトラフィックが上位の帯に着地していることを示している。
Flashより優れている点
32K未満の帯では$0.03/$0.13で、Flashの$0.14/$0.28より実際に安く、入力ではおよそ4.6倍だ。Flashがどちらも扱えない画像と動画を扱える。キャッシュ読み取りは$0.006。
Flashに劣る点
独立して検証されているものがほとんどなく、それこそが本題であり脇の話ではない。Qwenはベンチマークもアーキテクチャもパラメータ数も公開していない。Artificial Analysisにはまったく掲載されていないため、上の表に匹敵するインデックススコアがない。重みは非公開だ。
私が信頼する唯一の第三者評価はRoboflowのビジョンベンチマークで、全体では**23モデル中22位で61.7%**としながら、コストでは23モデル中1位に位置づけている。識別は得意でも位置特定は苦手だということだ。
ここでの「Flash」は速いという意味ではなく安いという意味だ:Flashの113、Flash-Liteの366に対して59トークン/秒。ツールコールのエラー率は8.88%、P99エンドツーエンドレイテンシは90.19秒。OpenRouterは「単一プロバイダーがホストしている」ため「ルーティングの判断はない」と注記しており、そのプロバイダーの調子が悪い日にはフォールバックがない。
結論
プロンプトが本当に32K未満で、予算内でビジョンが必要な場合にのみ選ぶ価値がある。それを超えると帯の仕組みが優位性を消してしまい、評価データが欠けているため信用で買うことになる。帯の計算はQwen 3.7 Flashの料金ガイドで詳しく解説しており、Qwen 3.7 Flashの概要がスペックをカバーしている。
この8つのどれもやってくれないこと
ここに挙げたモデルはすべて最下層のレイヤーにすぎない。これははっきり言っておく価値がある。人々が私に持ち込んでくる乗り換えの判断は、普通モデル選びとして語られるが、実際にはほとんどそうではないからだ。
84%のハルシネーション率は、モデルがチケットの84%を間違えるという意味ではない。これはコンテキストが与えられていない質問について測定されたAA-Omniscienceの数字であり、サポートエージェントの正しい運用のちょうど正反対だ。同じモデルを検証済みのヘルプセンター上のRAGに接続すれば、重要になる数字は完全に変わる。
これがRAG対LLMとハルシネーション対策の背景にある論点だ。解決策はグラウンディングとガードレールであり、より良いベースモデルではない。
こうした取引を実際に決める買い手の反論は、抽象的な精度の話ではない。制御だ。あるCXリーダーが、どのベンチマークよりも的確に言い表していた。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Gorgias・Shopifyを使うDTCサプリメントブランドのCXリーダー、月間約7,000チケット・30,000注文規模
上の表のどの項目もそれを解決していない。確信度スコア、エスカレーションルール、チケットタイプの除外、そして人間によるチェックがそれを解決するのであり、それらはAPIより上の層にある。
確信度のしきい値とコンテインメント率については別途詳しく書いている。これらこそが、この仕組みが実際に機能するかどうかを決める部分だからだ。
これら8つがやってくれないもう一つのことは、実際に予算組みに使う数字を教えてくれないことだ。トークン料率は入力にすぎない。解決あたりのコストが出力であり、リトリーバル、リトライ、後始まつに費やす人的時間を加えると、両者は比例しなくなる。
私が実際にサポートキューに対してすること

サポートキューのためにモデルを買い比べるのは、最初のステップとして間違っている。今週8つのモデルカードを読んで過ごした私が言うのだからそうだ。問題はどのモデルが最もハルシネーションを起こさないかではなく、自社のチケットに対する精度がどうなるかであり、それはリーダーボードからはわからない。
それこそがeeselが生のAPIにはできないことだ。Zendesk、Freshdesk、Gorgias、Front、Help Scoutに数分で接続し、すべての返信をヘルプセンター、過去のチケット、マクロに根拠づけ、そして実際の過去チケットに対してシミュレーションを実行し、顧客に触れる前に実際の解決率を確認できる。基準を満たさなければ、導入しない。
料金は対応チケット1件あたり40セント、席数の課金はなく、人間が対応したチケットには課金されない。月間1,000チケットのうち200件をルーティングして始めれば、支払いは$80だ。eeselを試す、$50分の利用枠付きで無料、クレジットカードも不要。
私はeeselがベースモデルを賢くすると主張しているわけではない。主張しているのは、あなたが本当に探しているもの、つまり顧客の前で信頼できるモデルというものは、そもそもモデルの問題ではないということだ。そう確信できるのは、私たち自身のエージェントがどのベンチマークにも捉えられない形で失敗するのを見てきたからだ。これまで記録した中で最悪のパターンは、あるエージェントがAPIに一度も触れずに約10ターンにわたって「Zendesk検索を実行中」と語り続けたことだった。何をしたかについて嘘をつくことほど、チームメイトへの信頼を壊すものはなく、どんなインデックススコアもそれを予測できなかった。
では、どれを選ぶべきか
- 画像入力が必要→GPT-5.6 Luna。ここでは最も安いビジョン対応の選択肢で、知性はFlashと同等、実際のコストは約3倍。レイテンシが重要ならエフォートを低く保つこと。
- データレジデンシーが必要→Flashの重みを自社ホストする。同じモデル、MITライセンス、1台のMI300Xで168.6 tok/s。最も安いマネージドのフォールバックはGeminiの有料プランで、コンテンツを学習に使わないと書面で明記している。
- スループットが必要→Gemini 3.5 Flash-Lite、366 tok/sでこのグループ最も簡潔な出力。Index 36は受け入れる必要がある。
- 同等スコアで出力トークンを減らしたい→Gemini 3.6 Flash。2.1億トークンではなく5,900万トークンで同じ50点を出すが、タスクコストは10倍。
- 信頼性が必要→Kimi K3。ハルシネーション率84%に対して51%、タスクあたりコストは29倍。K3(low)には手を出さないこと。
- 長文書に対するリコールが必要→DeepSeek V4 Pro。SimpleQA-Verifiedで34.1に対して57.9で勝ち、LMArenaの投票者もそれに同意している。
- 最安の定価が必要→Qwen3.7-Flash。ただし32K未満のプロンプトに限り、独立した評価がほとんどないことを受け入れられる場合のみ。
- 上記どれも当てはまらない→Flashに留まる。最も安く、最初のトークンまでも最速で、オープンだ。ただし保留中の2倍ピーク時間サーチャージには注意すること。DeepSeekが開始日を発表すれば、北京時間9:00〜12:00と14:00〜18:00に適用される。
顧客チケットに回答させるモデルを選んでいるなら、最適なAIサポートエージェントの解説とAIカスタマーサービスのコストは、上のどのモデルページよりも次に読む価値がある。文章を書くために選んでいるなら、ブログ執筆に最適なLLMから始めるのがおすすめだ。
Sources
- Artificial Analysisのモデルページ、すべての数字は2026年8月4日確認済み: DeepSeek V4 Flash 0731
- Artificial AnalysisのGPT-5.6 Luna
- Artificial AnalysisのGemini 3.6 FlashとGemini 3.5 Flash-Lite
- Artificial AnalysisのKimi K3とClaude 4.5 Haiku
- DeepSeek APIの料金とResponses APIガイド
- OpenAIプラットフォームの料金とGPT-5.6 Lunaモデルページ
- Gemini Developer APIの料金とモデルカタログ
- ClaudeモデルズオーバービューとClaudeの料金
- Moonshot AIのモデル料金
- OpenRouter、Qwen3.7 FlashとRoboflow Vision Evals
- 単一のAMD MI300X上のDeepSeek V4 FlashとそのHacker Newsスレッド
- eeselの社内カスタマーコール・ドシエ、匿名化した記述子のもとで引用
Frequently Asked Questions
DeepSeek V4 Flashの代替として最適なのはどれですか?
DeepSeek V4 Flashより安い代替はありますか?
画像入力に対応しているDeepSeek V4 Flashの代替はどれですか?
モデルを切り替える代わりにDeepSeek V4 Flashを自社ホストできますか?
DeepSeekは有料顧客のAPIデータで学習していますか?
DeepSeek V4 Flashは他の代替と比べてどのくらいのコストですか?
FlashではなくDeepSeek V4 Proを使うべきですか?
lowのリクエストもhighで処理されます。詳細はFlash対V4 Proで解説しています。