2026年版、Gemini 3.8 Flashの代替候補ベスト8

Rama Adi Nugraha

Katelin Teen
最終更新 September 8, 2026
そもそもGemini 3.8 Flash以外を検討すべき理由
Gemini 3.8 Flashは良いモデルです。出力速度は196モデル中3位で302トークン/秒、Artificial AnalysisのIntelligence Indexでは59点と、中央値を大きく上回っています。大量の未処理タスクを一晩で処理するバッチジョブには、価格面でこれを上回るものはなかなかありません。
問題は、その「より一生懸命な仕事」が何を犠牲にしているかです。Googleの発表ノート自体が珍しく率直にこう述べています。
「このパフォーマンス向上は、核心的な設計上の選択に由来する。3.8 Flashはより一生懸命働く。複雑なタスクではより高い勤勉さを示し、追加の推論ステップを実行し、ツールを反復的に呼び出す。時にはパフォーマンスを最大化するために、特に高い努力レベルにおいて、より多くのトークンを使用する場合がある。」
そして、アップグレードの判断を決定づけるべき一文が続きます。Googleは計算効率を重視する開発者に対し、「効率重視のワークロードでは引き続き完全にサポートされているGemini 3.7 Flashに依拠し続けること」を推奨しています。ベンダーが自社の旧モデルの方が今でも正しい選択だと言うのは、それだけで真剣に受け止める価値がある珍しさです。
この事情を実際に探す理由にする数字が2つあります。まず、Artificial Analysisによると、最初のトークンまでの時間は13.3秒で、クラス中央値の約3秒に対して著しく長いです。スループットは応答性と同じではなく、13秒の無音状態はチャットウィジェットやサポート返信にとっては致命的です。次に、AA Indexを完了するために1.2億の出力トークンを消費しており、中央値の7,100万に対してかなり多く、AA自身も「非常に冗長」とフラグを立てています。冗長な出力は、2027年1月に倍増する出力単価そのものに対して、より大きな請求額を意味します。
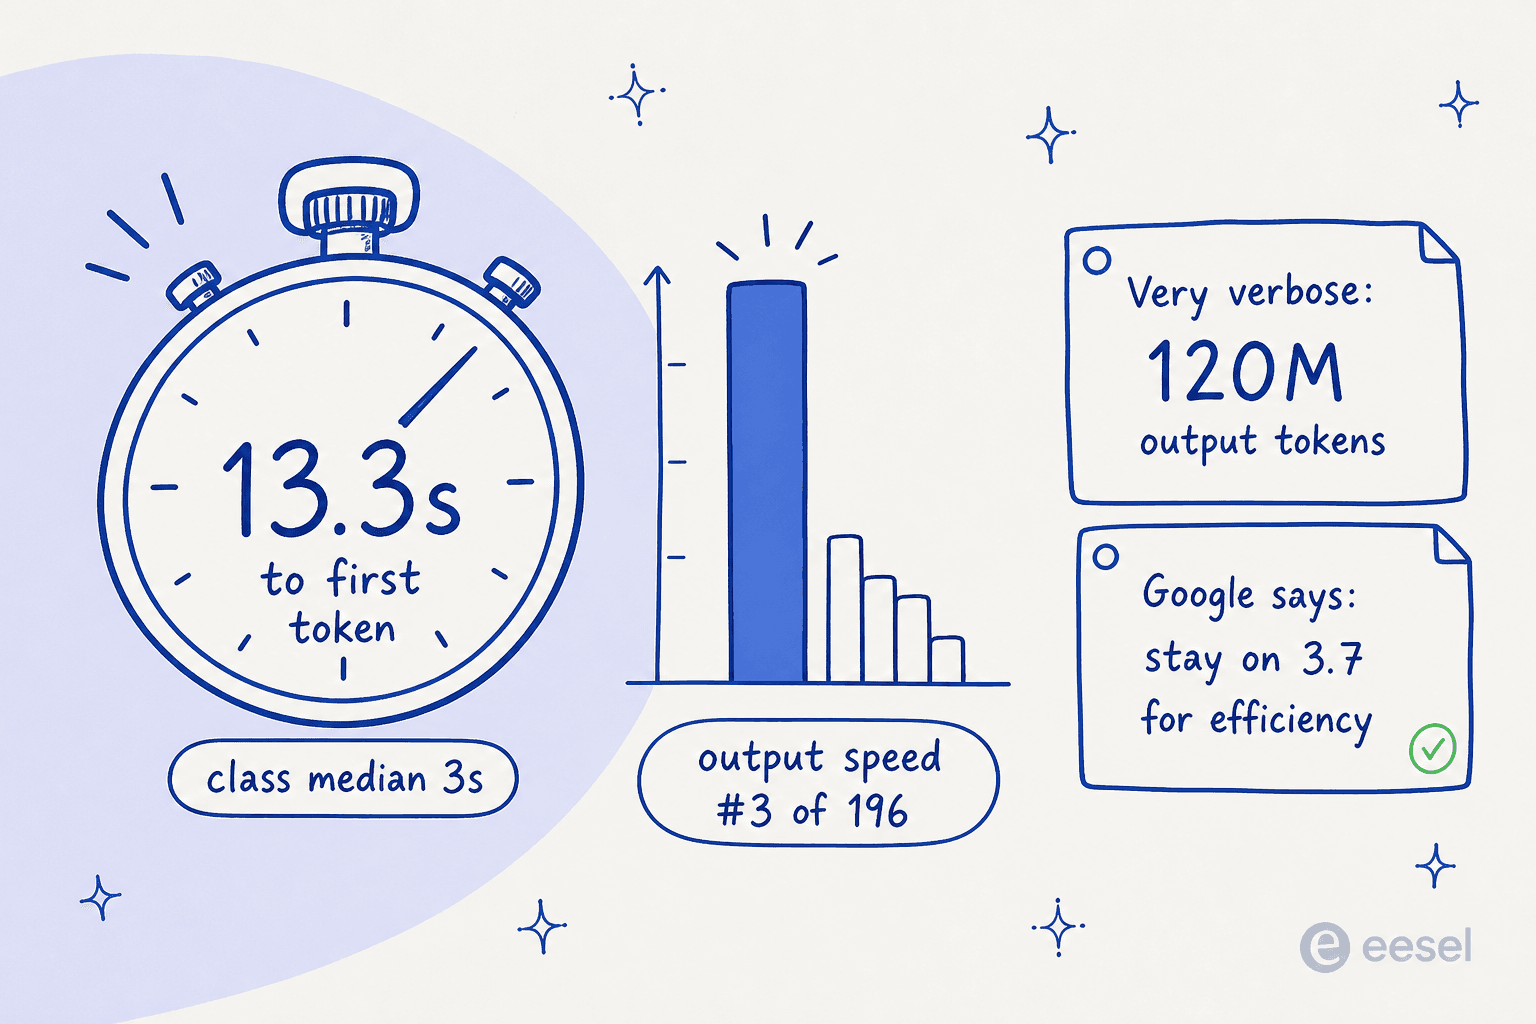
つまりこれは「3.8 Flashが悪い」という話ではありません。「高速で安価」という見た目が、レイテンシの壁とトークン肥大という税金を隠しているということであり、多くのワークロードにとっては、別のモデル、時にはGoogle自身の旧モデルの方が良い選択になるということです。
これらの代替モデルの選定方法
このリストは、Flashと実際に同じ役割を担うモデルに絞りました。エージェント、分類器、コーディングアシスタントを動かすために使うような、高速で手頃な高ボリューム向けの働き者であり、1Mあたり$30もするようなフラッグシップモデルではありません。それぞれについて、以下の4点を評価しました。
- 表示価格ではなく、タスクあたりの実質コスト。 トークン単価が半分でも、出力が2倍冗長なら安くはありません。冗長さこそ、多くの「格安」モデルが静かにコストを取り戻す部分です。
- 許容できるレイテンシ。 人が相手側にいる瞬間、最初のトークンまでの時間はピークスループットより重要になります。
- オープンかクローズドか。 これらのうち複数は自前でホスティングできるオープンウェイトを提供しており、データの保管場所とコストの計算を完全に変えます。
- 実際のユーザーの声。Hacker NewsやRedditのスレッドから拾ったもので、ローンチ日のベンチマーク投稿ではありません。
以下の価格は1Mトークンあたり、標準ティアで、各ベンダー自身の価格ページに記載されている数字です。推論・思考トークンはここに載っているどのモデルでも出力単価で課金されるため、たいてい出力側の列が請求額を左右します。
Gemini 3.8 Flashの代替モデル一覧
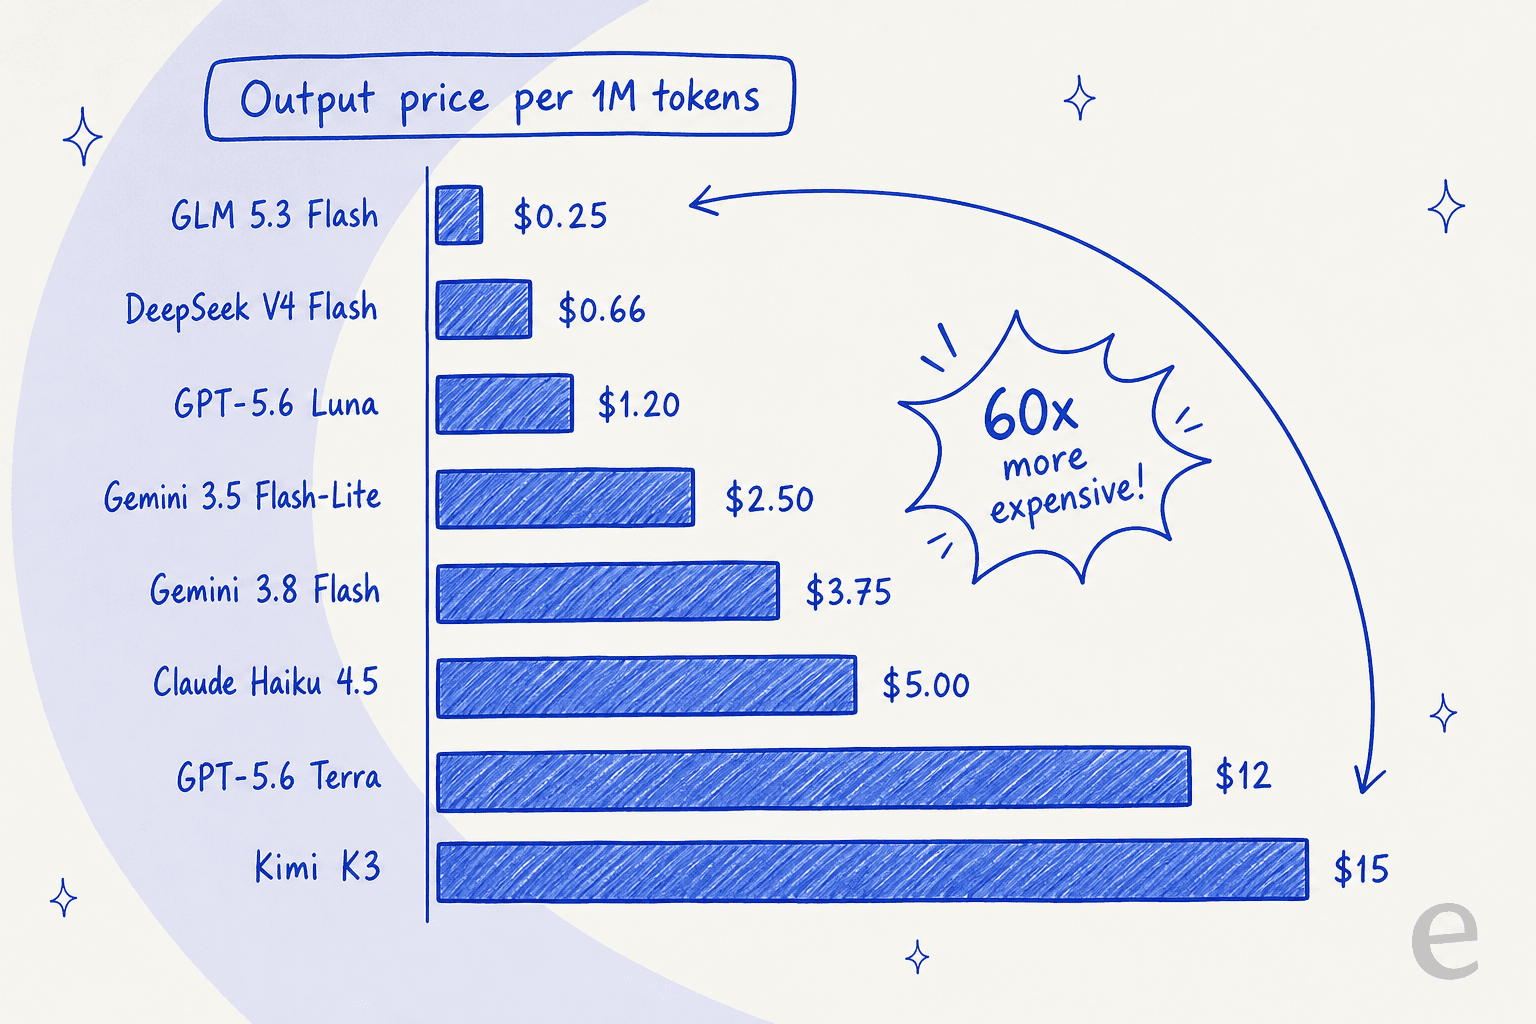
| モデル | 最適な用途 | 入力/出力($/1M) | オープンウェイト | コンテキスト | 主な落とし穴 |
|---|---|---|---|---|---|
| Gemini 3.7 Flash | 効率重視、同価格 | $0.75 / $3.75 | なし | 1M | 2027年1月に倍増;minimal廃止 |
| OpenAI GPT-5.6 (Terra) | よりスリムなフロンティア代替 | $2.00 / $12.00 | なし | 400K | ロングコンテキスト層は2倍の価格 |
| DeepSeek V4 Flash | 実質コスト最安 | $0.22 / $0.66(オフピーク) | あり(MIT) | 1M | ピーク時サーチャージ;幻覚あり;テキストのみ |
| Kimi K3 | オープンウェイトの推論モデル | $3.00 / $15.00 | あり | 1M | トークン単価が高い;思考を止められない |
| Qwen 3.8 Flash-Next | 長文コンテキスト、オープンプレビュー | 入力〜$0.03-$0.20 / 出力$0.13-$0.80 | あり | 1M | 学習不足のプレビュー;単一プロバイダー |
| Claude Haiku 4.5 | 信頼性+安全性 | $1.00 / $5.00 | なし | 200K | 格安勢より高価 |
| GLM 5.3 Flash | 最安のマルチモーダル | $0.075 / $0.25(プロモ) | あり | 200K | プロモ終了あり;エコシステムが小さい |
| Gemini 3.5 Flash-Lite | 大量のOCR/分類 | $0.30 / $2.50 | なし | 1M | 難しい推論には弱い |
出力列の広がりがすべてを物語っています。1Mあたり$0.25から$15まで、60倍の差があり、しかもすべてが概ね同じ「高速で安価」というカテゴリーに収まるモデルです。
1. Gemini 3.7 Flash
最適な用途: Flashの得意なことはすべて欲しいが、余分なトークン消費は避けたいチーム向け。同じ価格で。
Gemini 3.8 Flashに対して最も誠実な代替は、それが構築されたベースであるモデル自身であり、それをGoogle自らが伝えています。3.8は3.7 Flashをさらに学習させたものなので課金は同一で、実質的な違いは3.8がタスクあたりにより多くの作業をこなし(そしてより多くのトークンを消費する)ことだけです。難しい推論ベンチマークの最後の数ポイントを追っていないなら、3.7 Flashは同じ速さでより小さい請求額を実現します。
これを安価で疲れ知らずの監査役として使う開発者からの評価は高いです。
"I've been using 3.7 Flash to audit the work of Opus High, and Flash finds lots of subtle and insidious defects even while all the unit tests are green... it is blazing fast in Antigravity CLI. Easily 10x faster than Opus."

メリット: 3.8 Flashと同一価格、トークン肥大が少ない、フルの1Mトークンのコンテキストウィンドウ、そして同じ広範なマルチモーダル入力(テキスト、画像、音声、動画、PDF)。
デメリット: 導入価格は2027年1月1日に$1.50/$7.50へ倍増します(3.8と同様)。また3.7ではminimalの思考レベルが廃止されたため、OCRやチケット分類向けの最安の下限がなくなり、lowが新たな下限になっています。
価格: 2026年末まで1Mあたり入力$0.75/出力$3.75。
結論: すでに3.8 Flashに手を伸ばしているなら、まず自分のプロンプトで3.7 Flashをベンチマークしてみてください。10回中9回は、より安くその仕事をこなします。だからこそGoogleは今でも3.7を推奨し続けているのです。
2. OpenAI GPT-5.6
最適な用途: Google以外のフロンティアモデルで、少ないトークンで回答に到達したいチーム向け。
GPT-5.6は3つのバリエーションで提供されており、実際にFlashと競合するのは、より安価なLunaではなくTerra層です。Geminiに対してこれを検討する理由は効率性です。GPTモデルは、はるかに少ない出力量で同じ答えに到達する傾向があり、これが出力量の多い作業では高めの表示価格を相殺します。ある開発者はこの取引を端的に述べています。
"Sol high is almost the same speed if you take into account drastically lower token use. Look at the artificial analysis speed vs token use. Gemini is 7x faster but 5x more tokens."
これがGPT対Gemini Flashの決定を一文でまとめたものです。生のトークン/秒はGeminiに有利で、完了タスクあたりのトークン数はしばしばOpenAIに有利です。請求額が出力に支配されているなら、両方で計算してみてください。各層の詳細な内訳は、当社のOpenAIモデル一覧を参照してください。
メリット: 本物のフロンティア級推論、巨大なツールエコシステム、そして比較可能なタスクではGemini Flashより冗長さが少ない。ダウングレードしたいならLuna($0.20/$1.20)が実質的な格安下限になります。
デメリット: OpenAIは短いコンテキストウィンドウを超えると単価が倍増するロングコンテキスト層を課しており、これはxAIが使うのと同じ200K的な段差です。GeminiやAnthropicはこれを行いません。高ボリュームで運用する場合はレートリミットにも注意してください。
価格: Terra $2.00入力/$12.00出力;Luna $0.20/$1.20;Sol $5.00/$30.00(1M、短いコンテキスト)。
結論: Googleに縛られていないなら最も強力な総合的代替であり、特にワークロードが出力量重視で、トークン単価ではなくトークン数そのものがコストを圧迫している場合に有効です。
3. DeepSeek V4 Flash
最適な用途: ここで紹介するホスト型モデルの中で実質的なトークン単価が最も低く、オープンウェイトを求める人向け。
DeepSeek V4 Flashは価格破壊者です。総パラメータ284B/アクティブ13BのMixture-of-ExpertsモデルでMITライセンスのウェイト(約167GB、自宅で$10,000未満で動作)を持ち、オフピーク時は入力$0.22/出力$0.66という、Gemini Flashのごく一部の価格で提供されています。そしてコストだけでなく、実際の作業でも実力を発揮します。
"I benched DS4 flash and Pro vs opus 4.8 xhigh on 16 work-related tasks a month ago across 4 days. Opus 4.8 came out as a winner by 1 task only [...] But flash performed as well or better (as in being more thorough) in 13 out if 16."
正直な落とし穴が2つあります。DeepSeekは2026年8月に価格を改定し、現在はピーク/オフピークのサーチャージを設けています。ピーク時間はUTC01:00-04:00と06:00-10:00なので、米国やEUのキューはほとんどオフピークで課金されますが、中国の営業時間にスケジュールされたバッチジョブは2倍を支払うことになります。さらに、幻覚を起こす頻度も望ましいレベルより高めです。
"DeepSeek V4 hallucinates like crazy and often forgets explicitly mentioned parts of the context."
もう一つ知っておくべきこと。Flashはテキスト専用で、画像入力についての明文化されたサポートがないため、ワークロードにスクリーンショットが含まれる場合はこれが決定要因になります。データについても、DeepSeekの有料APIの利用規約は学習利用について保護的というより無言であり、データは中国国内法の下で中国国内に置かれるため、規制対象の顧客データにそのまま使える置き換え先ではありません。
メリット: ここで最も低い実質トークン単価、MITオープンウェイト、強力なツール利用性能、そして自分で制御できる完全に可視化された推論テキスト。
デメリット: ピーク時サーチャージ、実際の幻覚率、画像入力なし、そして中国国内でのデータ保管。
価格: オフピーク時1Mあたり入力$0.22/出力$0.66(ピーク時は2倍)。Proティアはより高価です。
結論: このリストの中で最も純粋なコスト重視の選択であり、「安い=弱い」というイメージ以上の実力を持っています。RAGを使った構成と同様、RAGベースの構成と検索、そして厳しいテストを組み合わせて幻覚を抑え込むのがおすすめです。
4. Kimi K3
最適な用途: トークン単価の高さを受け入れられるなら、フラッグシップモデルと渡り合えるオープンウェイトの推論モデル。
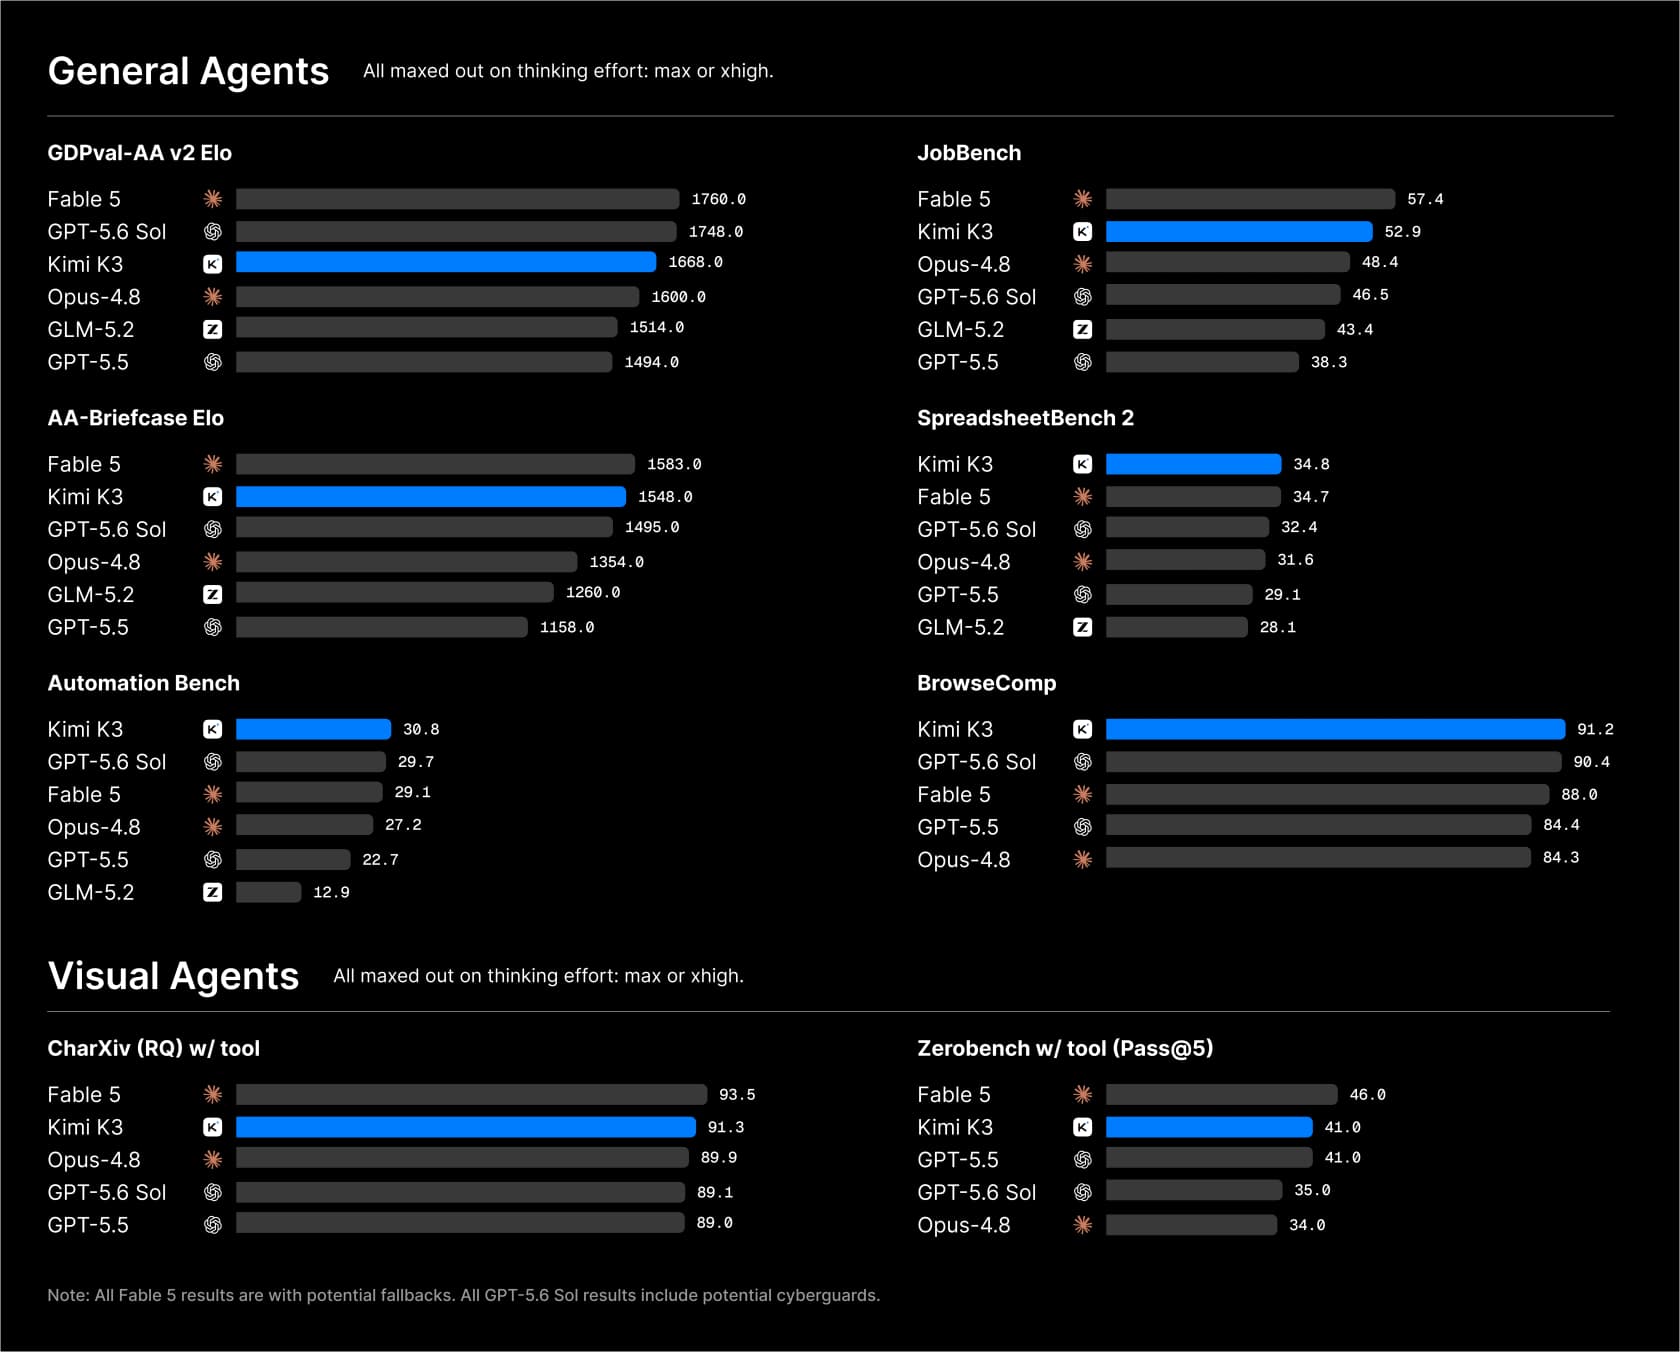
Moonshot AIのKimi K3は、オープンウェイトの世界における推論のヘビーウェイトです。総パラメータ2.8T/アクティブ104B、1Mトークンのコンテキスト、ネイティブなビジョン対応、そして期限どおりにリリースされたオープンウェイト。Artificial Analysisでは Intelligence Index 57を記録し、上位5位圏内に入っており、BrowseCompのようないくつものエージェントベンチマークで明確にトップを走っています。
問題は価格と思考量です。入力$3/出力$15はClaude Sonnetと同じ帯に位置し、DeepSeek Flashの出力単価の約50倍でありながら、推論を止めることができません。lowという設定もありますが、これはレイテンシの調整であってコスト層ではなく、8倍のコストを払いながらDeepSeek Flashより低いスコアになります。ユーザーはその遅さを実感しています。
"Faster iterations are way better for me, I hate waiting for 5-10 minutes on small changes. I tried to use recent versions of Kimi and GLM, but they use too much thinking for no reason and are pretty slow because of it."
メリット: フラッグシップ級の推論、画像・動画のネイティブ入力、1Mトークンのウィンドウ、そしてすでにコミュニティによる量子化版が用意されているオープンウェイト。
デメリット: トークン単価が高い、推論をオフにする方法がない、そして「Flash」の競合として期待するより遅い(そもそもFlashではなく、フロンティアモデルです)。公開の画像URLも受け付けず、Base64またはアップロードしたファイルIDのみです。
価格: 1Mあたり入力$3.00/出力$15.00(キャッシュヒット時の入力は$0.30)。
結論: 本物の推論力が必要で、自前ホスティングという選択肢を欲しい場合の選択であり、安さと速さが必要な場合には向きません。基準が「フラッグシップ級だが自分でウェイトを所有したい」ならK3はそれを満たしますが、基準が「コストの面でFlashを置き換える」ならそうではありません。詳細は当社のKimi K3レビューをご覧ください。
5. Qwen 3.8 Flash-Next
最適な用途: オープンウェイトで、大規模なスループットが重要な長文コンテキスト・高キャッシュのワークロード。
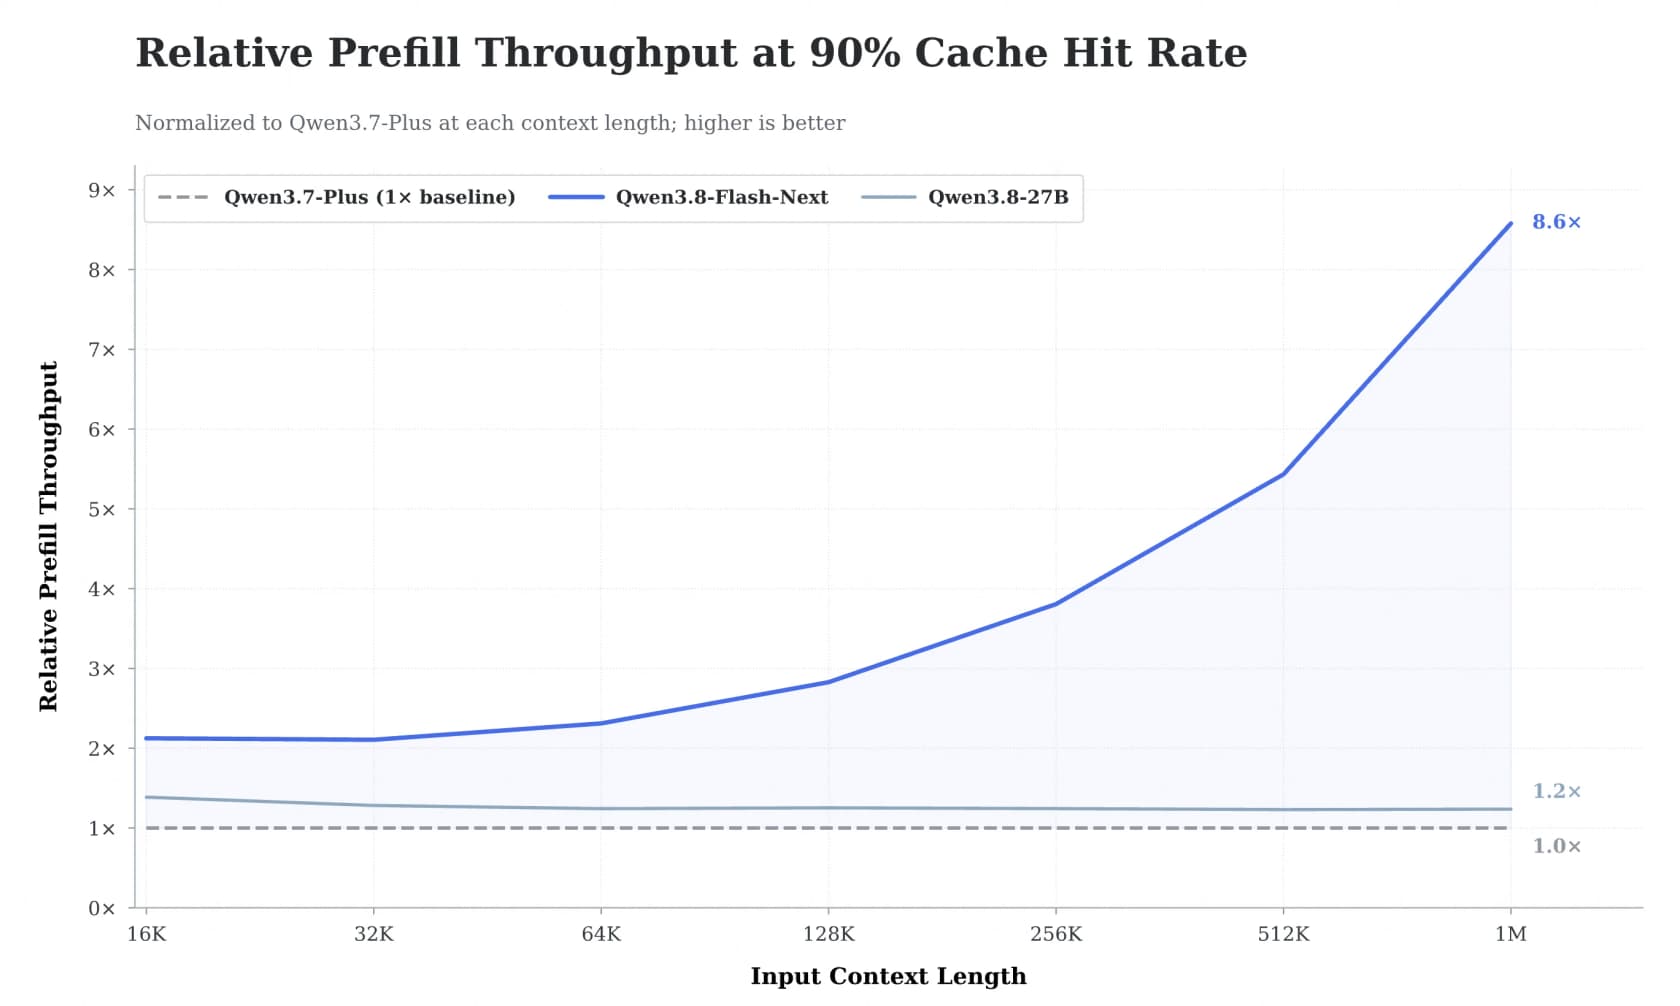
AlibabaのQwen 3.8 Flash-Nextは、ここで最も興味深い異色の存在です。これはQwenの次世代アーキテクチャのプレビューであり、その見せ場はプリフィルのスループットです。Qwen Sparse Attentionにより、1MトークンのコンテキストでQwen3.7-Plusの8.6倍のスループットを達成しています。長文コンテキストかつキャッシュヒット率が高い重量級のワークロードにとって、このスケーリングは本物であり、なかなか対抗できません。オープンウェイトを提供し、価格は段階制で、短いプロンプトでは1Mあたり約$0.03/$0.13から、最大のもので$0.20/$0.80までです。
落とし穴は「プレビュー」という言葉の意味です。これは意図的に未完成です。
"This model is a preview of Qwen's upcoming Qwen4 architecture... They said the model is intentionally under-trained since it is mainly for R&D purposes of proving the new architecture."
それに加えて、Simon Willisonはこれを試し、最終的にはより小さい高密度モデルを好むという結果になり、その原因を、モデルを収めるために必要な低ビットの量子化に帰しています。またホスト型APIは現在プロバイダーが1社のみで、フェイルオーバーがありません。Artificial Analysisもこれを「非常に冗長」と評価しており、Indexを完了するために出力トークンを2億使う一方、中央値は1.1億です。
メリット: 長文コンテキストで例外的なスループット、オープンウェイト、短いプロンプトでは非常に安価、そしてQwenが向かう方向を示すプレビュー。段階制の価格表全体は当社のQwen価格ガイドをご覧ください。
デメリット: 意図的に学習不足、量子化による品質面の打撃、単一プロバイダーによるホスティング、そして請求額を膨らませる冗長な出力。
価格: 段階制で、プロンプトサイズにより1Mあたり入力約$0.03-$0.20/出力$0.13-$0.80。
結論: 研究段階のプレビューであり、本番のデフォルト選択ではありません。長文コンテキストのスループットがボトルネックで、かつ自前ホスティングが可能なら手を伸ばす価値がありますが、そうでなければ完成したQwen4系列を待つべきです。他の選択肢は当社のQwen代替まとめをご覧ください。
6. Claude Haiku 4.5
最適な用途: やや高めの価格を、信頼性とよりクリーンな安全性の記録と引き換えにするチーム向け。
Claude Haiku 4.5はAnthropicの高速・小型モデルで、絶対的に最安のトークンよりも、予測可能に振る舞うモデルを優先したいときに私が選ぶものです。入力$1/出力$5と格安勢よりコストは高いものの、Anthropicのフラット価格(ロングコンテキストのサーチャージなし)、強力な指示追従性、そしてより広いClaudeエコシステムの成熟したツール群が付いてきます。
これが重要な理由は、Gemini 3.8 Flashでは実際に2つの安全性指標が後退したことです。多言語における安全性と、根拠のない拒否の両方が3.7に対して悪い方向に動き、Googleも英語以外での安全性が「わずかに後退した」と述べています。多言語対応の、あるいは規制のある顧客層にサービスを提供している場合、より安定した安全性の実績を持つモデルはその上乗せ分の価格に値します。
メリット: コンテキストの段差がないフラット価格、信頼できる指示追従性、成熟したエコシステム、そして強力な安全性の姿勢。すでにClaude上で構築している人には特に向いています。
デメリット: DeepSeek Flash、GLM、Gemini Flash系列より高価、クローズドウェイト、そしてここに挙げた1Mトークンモデルより小さい200Kのコンテキストウィンドウ。
価格: 1Mあたり入力$1.00/出力$5.00。
結論: 「信頼性への上乗せ分は払う価値がある」という選択です。格安モデルが顧客の前で幻覚を起こして痛い目にあった経験があるなら、Haiku 4.5は多くの安心を買い戻してくれます。当社のClaude代替ガイドで比較を確認してください。
7. GLM 5.3 Flash
最適な用途: ここで最も安価な真のマルチモーダルモデル。
Z.aiのGLM 5.3 FlashはGLM-5シリーズ初のネイティブマルチモーダルモデルで、ローンチプロモ中はここで最も安価な有料モデルです。1Mあたり入力$0.075/出力$0.25(定価は$0.15/$0.50)。オープンウェイトを提供しており、DeepSeek Flashとは違って実際に画像を受け付けます。初期の検証者たちは価格対品質の比率を高く評価しています。
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

GLM Coding Plan(月額$18/$80/$168)というプランもあり、Claude Code、Cursor、Cline、その他20以上のエージェントツール内で動作するため、IDE中心で作業する人にとっては非常に安価なコーディング用バックエンドになります。
メリット: 底値クラスの価格で本番品質、ネイティブなマルチモーダル入力、オープンウェイト、そして専用のコーディング用サブスクリプション。無料のGLM-4.7-FlashおよびGLM-4.5-Flash層は良い入門になります。
デメリット: 50%のローンチ割引が終了すると、単価は$0.15/$0.50に倍増します(それでも安価)。エコシステムはOpenAIやGoogleより小さく、フラッグシップの推論モデルGLM-5.3は別料金の高価なSKUです。
価格: プロモ中は1Mあたり入力$0.075/出力$0.25;定価は$0.15/$0.50。
結論: マルチモーダル用途におけるコストパフォーマンスの王者です。DeepSeek Flashのテキスト専用という制約がネックになるなら、GLM 5.3 FlashはGemini Flashの単価を払わずに画像入力を維持できる最も安価な方法です。
8. Gemini 3.5 Flash-Lite
最適な用途: フルのFlashではやり過ぎになる、大量の分類・タグ付け・OCR。
Gemini 3.8 Flashに対する正しい代替が、より小さいGeminiであることもあります。Gemini 3.5 Flash-LiteはGoogleの格安・高スループットモデルで、入力$0.30/出力$2.50、1Mトークンのコンテキスト、マルチモーダル入力を備えています。フィールドの抽出、チケットのタグ付け、OCRの実行など、範囲が明確で安価な作業を大量にこなす場合、120Mトークンも消費して考え込むヘビーウェイトの推論モデルが不要な場面での回答となります。
これはまた、3.7と3.8 Flashが放棄した安価な下限を維持しているモデルでもあります。Flash-Liteは分類の経済性を成立させる超低思考設定を今も支えており、より新しいFlashモデルがminimalを廃止したことでコストが上がったのは、まさにこのワークロードでした。
メリット: フルのFlashより安価、巨大な1Mトークンのコンテキスト、強力なスループット(約490トークン/秒)、マルチモーダル入力、そしてすでに使っているかもしれないGoogle/Vertexエコシステムの内側にとどまれること。
デメリット: フルのFlashモデルより難しい推論やエージェント的タスクに弱い、コンピュータ操作機能がない、そしてGemini 3.x系列全体に共通する導入価格からの後の値上げパターン。
価格: 1Mあたり入力$0.30/出力$2.50(標準)。
結論: これは妥協ではなく正しいダウングレードです。高ボリュームで複雑度の低い作業では、Flash-Liteが3分の1の価格で仕事をこなし、Googleのインフラにとどまることができます。
実際にあなたが買い物をしている階層
ここが、私が繰り返し戻ってくる論点です。なぜなら私はこれを生業として作っているからです。カスタマーサポートエージェントを動かすために高速・低価格なモデルを選んでいるなら、FlashとDeepSeekとGLMを比較すること自体が間違った問いです。モデルはエンジンです。車そのものではありません。
生のモデルAPIは、テキストを入れてテキストを出すエンドポイントを与えてくれるだけです。それをチケットを解決するものに変えるには、それでもナレッジベースを組み込み、幻覚を止めるための検索(retrieval)を構築し、エスカレーションルールを書き、顧客に触れる前に実際のケースでテストし、そしてそれを永久に監視し再学習させる必要があります。これは数週間分のエンジニアリングであり、次のFlashが出るたびに6週おきにモデルを入れ替える作業も含めて、そのすべてを自分で所有することになります。
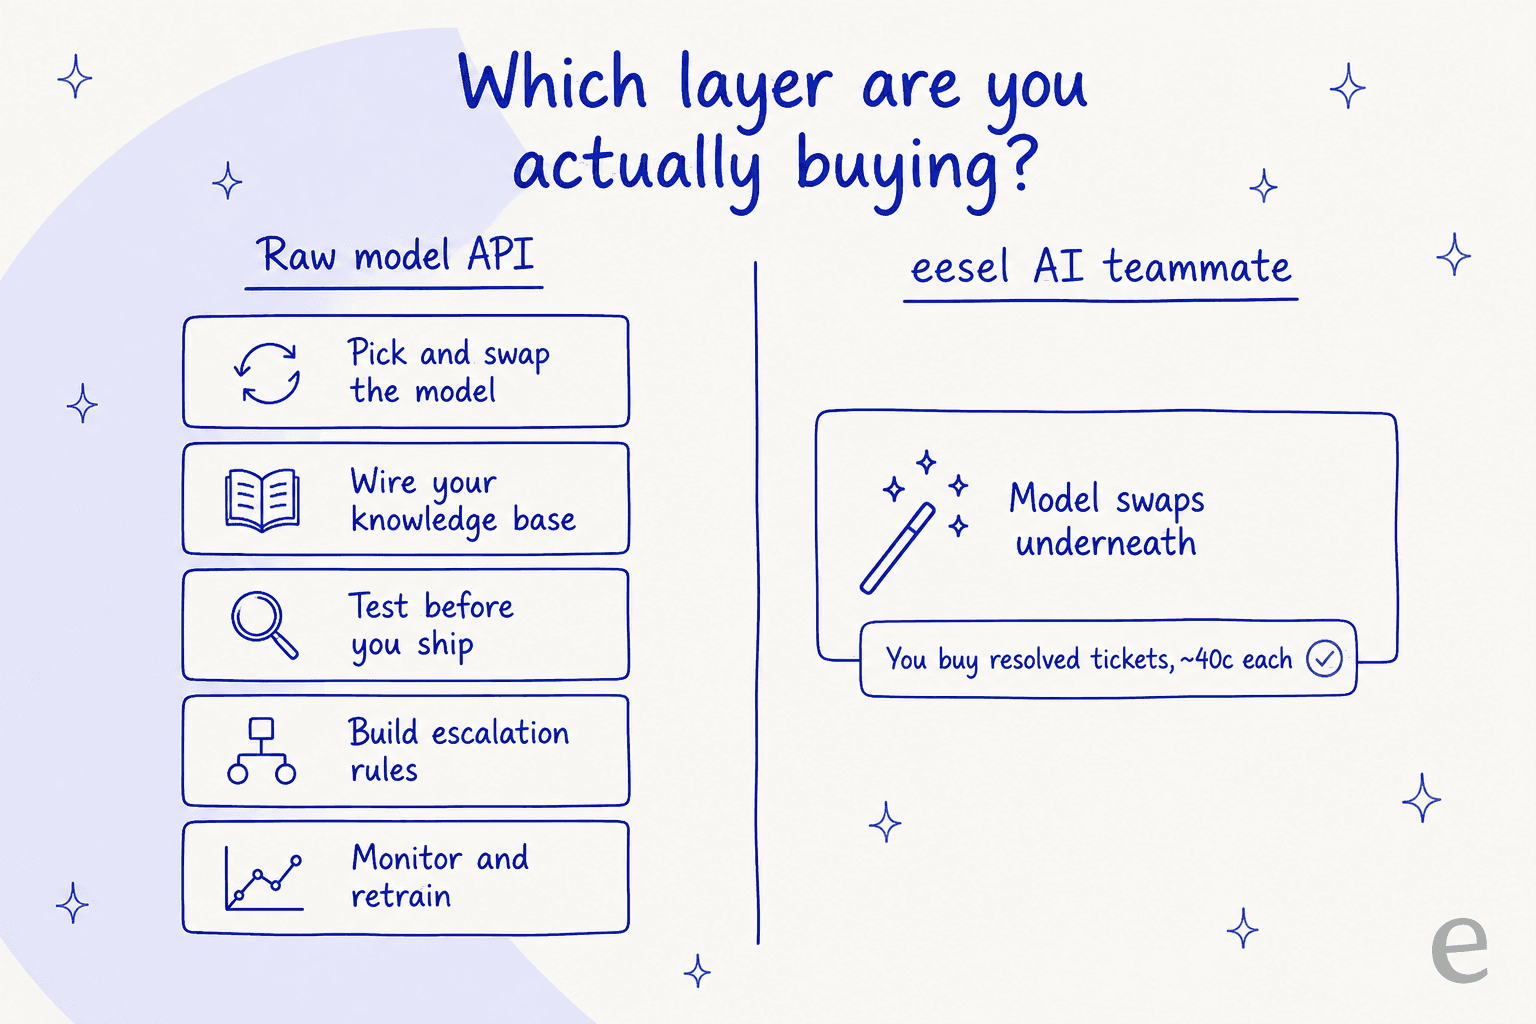
覚えておく価値があるのはこの区別です。モデルはインフラであり、チームメイトは従業員である。目標が動作するAIコーディングアシスタントやリサーチパイプラインであるなら、そうです、最良のモデルを選んで自分で構築してください。しかし目標が「サポートチケットにきちんと答える」ことであるなら、より速く安い道は、完成したチームメイトを買い、今月どのFlashが勝っているかに他人が頭を悩ませるのを任せることです。
カスタマーサポートにeeselを試す
高速・低価格なモデルでサポートを処理したいという理由でここに来たなら、eeselはモデルの上に位置し、実際にその仕事をこなす層です。これはAIチームメイトのプラットフォームであり、この用途にすぐ使えるチームメイトはAIヘルプデスクエージェントです。既存のキューに参加し、過去のチケットとナレッジベースで学習し、モデルをいじる手間なしに会話の解決を始めます。
この正確な課題にちょうど合う理由は2つあります。まず、設計上モデルに依存しないため、「Gemini 3.8 FlashかDeepSeek Flashのどちらが優れているか」という問いはあなたの問題ではなくeeselの問題になります。私たちがモデルの改善に合わせて裏側のモデルを選び、入れ替えます。次に、これらの高速モデルすべてが教える傷跡ですが、eeselは本番稼働前に過去のチケットに対してすべてのロールアウトをシミュレーションするため、実際の解決率を確認でき、顧客より先に「自信満々だが間違っている」回答を検出できます。ターミナルやスクリプトから操作したい場合には、コーディングエージェントやCIパイプラインが同じチームメイトを操作できるよう、フルのeesel CLIも用意されています。課金は使用量ベースで、解決したチケット1件あたりおよそ40セントなので、トークンではなく成果に対して支払う形になります。無料で試すことができます。
よくある質問
低コストなGemini 3.8 Flashの代替として最適なのは何ですか?
Gemini 3.7 FlashはGemini 3.8 Flashの良い代替になりますか?
Gemini 3.8 Flashは他の代替モデルと比べてどのくらいのコストですか?
カスタマーサポートに最適なGemini 3.8 Flashの代替はどれですか?
Gemini 3.8 Flashにはオープンウェイトの代替はありますか?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.