2026年版 Claude Opus 5.5の代替8選(より安く、より速く、オープンな選択肢)

Kurnia Kharisma Agung Samiadjie

Katelin Teen
最終更新 September 23, 2026
なぜ人々はClaude Opus 5.5の先を見るのか
まず、公平な部分から。Opus 5.5はその評判にふさわしい。長時間のエージェント型コーディングやナレッジワーク向けに作られており、あまり手を焼かせずに曖昧さを処理でき、スコア58でArtificial AnalysisのIntelligence Indexの1位に立つ。Anthropicは価格もOpus 5の$5/$25から$4/$20に引き下げており、これは購入者への本物の、強制されない譲歩だ。すでにClaude Codeに深く入り込んでいて、作業が本当に難しいなら、そのまま留まるのも十分正当な判断だ。
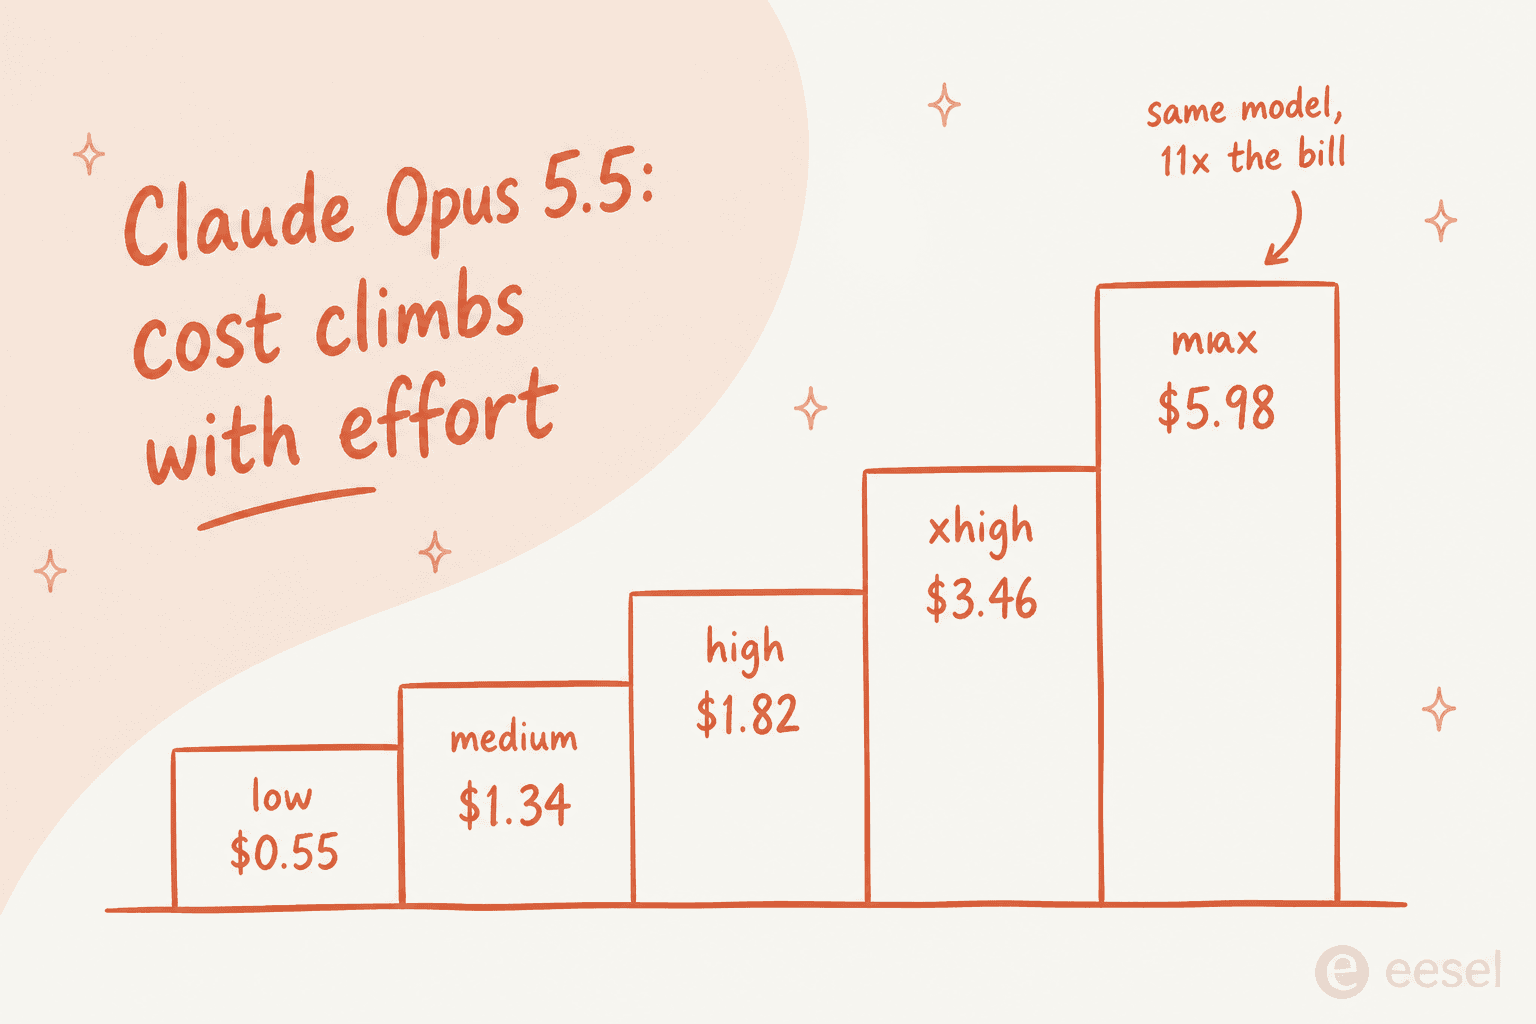
私はここ数年、ライブのカスタマーサポートキューにAIを導入してきたが、フロンティアモデルについて最も驚いたのは品質ではなく、請求額は定価よりもエフォートのダイヤルにはるかに強く連動するということだった。Opus 5.5はその完璧な例だ。トークン単価は中程度だが、タスクあたりのコストは低エフォートの約$0.55から最大エフォートの$5.98まで振れる。これは高エフォート時により長く推論し、より多くのトークンを出力するためだ。
人々が他を探す理由は、通常この4つのいずれかだ。
- 完了タスクあたりのコスト。 スコアが数ポイント低くてもタスクあたりのコストが5分の1のモデルは、ほとんどのワークロードにとってより良い選択だ。
- 速度。 Opusは慎重だ。チャットの返信のように人間が待つものでは、ベンチマークよりもレイテンシの方が重要になる。
- オープンウェイト。 プライバシー、主権、コスト管理のためにセルフホストが必要なチームもある。
- マルチモーダルの幅広さやコンテキスト。 音声、動画、あるいは本当に巨大なコンテキストウィンドウが決め手になる機能になり得る。
それぞれを詳しく見る前に、私が実際に検討する8つの代替モデルがどう比較されるかを見てみよう。
Claude Opus 5.5の代替を一目で比較
| モデル | 最適な用途 | 価格 /1M(入力 / 出力) | コンテキスト | オープンウェイト | ネイティブビジョン |
|---|---|---|---|---|---|
| Claude Opus 5.5(現行) | 最も難しいエージェント型コーディング | $4 / $20 | 約1M | いいえ | はい |
| GPT-6 Sol | フロンティア級の品質、タスク単価が安い | $2 / $10 | 105万 | いいえ | はい |
| Gemini 3.8 Flash | 大規模での安価なマルチモーダル | $0.75 / $3.75 | 1M | いいえ | はい(+音声/動画/PDF) |
| Grok 4.7 | 大量のエージェントループ | $2 / $6 | 500K | いいえ | はい |
| Qwen 3.8 Max | マルチモーダルな価値、オープンなベース | $2 / $6 | 1M | ベースのみ | はい |
| Kimi K3 | ビジョン対応のオープンウェイト | $3 / $15 | 1M | はい | はい |
| DeepSeek V4 Flash | コスト下限 | 約$0.22 / $0.66 | 1M | はい(MIT) | いいえ |
| GPT-6 Luna | 大規模で最も安い | $0.10 / $0.50 | 105万 | いいえ | はい |
| Claude Sonnet 5 | Claudeファミリーに留まる | $2 / $10 | 約1M | いいえ | はい |
価格は2026年9月時点で確認した、短コンテキストにおける標準の公開料金(100万トークンあたり)。DeepSeekの数値はオフピークのキャッシュミス入力料金と標準の出力料金。Gemini 3.8 Flashの料金は2026年12月31日までのプロモーション価格で、その後倍増する。
選定方法について簡単に触れておく。これはカタログではなくショートリストなので、3つの点を重視した。実際に確認できる価格(トークンあたり、そしてArtificial Analysisが計測している場合はタスクあたり)、マーケティングと比べてモデルが実際にどう振る舞うか、そしてOpus 5.5が残す隙間を埋めるかどうかだ。単に「同じ価格でOpusより少し劣る」だけのものはリストに入れなかった。
1. GPT-6 Sol:最も近いフロンティア級のライバル、コストは5分の1
最適な用途: ほぼフロンティア級の品質が欲しいが、Opus 5.5のタスク単価には耐えられないチーム。
GPT-6 SolはOpus 5.5の1日後、2026年9月23日にローンチされ、このリストで最も直接的な比較対象だ。105万トークンのコンテキストウィンドウ、ネイティブな画像入力、そしてウェブ検索、コードインタープリター、ホスト型シェル、コンピュータ操作、MCPを含む完全なOpenAI Responsesツールセットを備える。
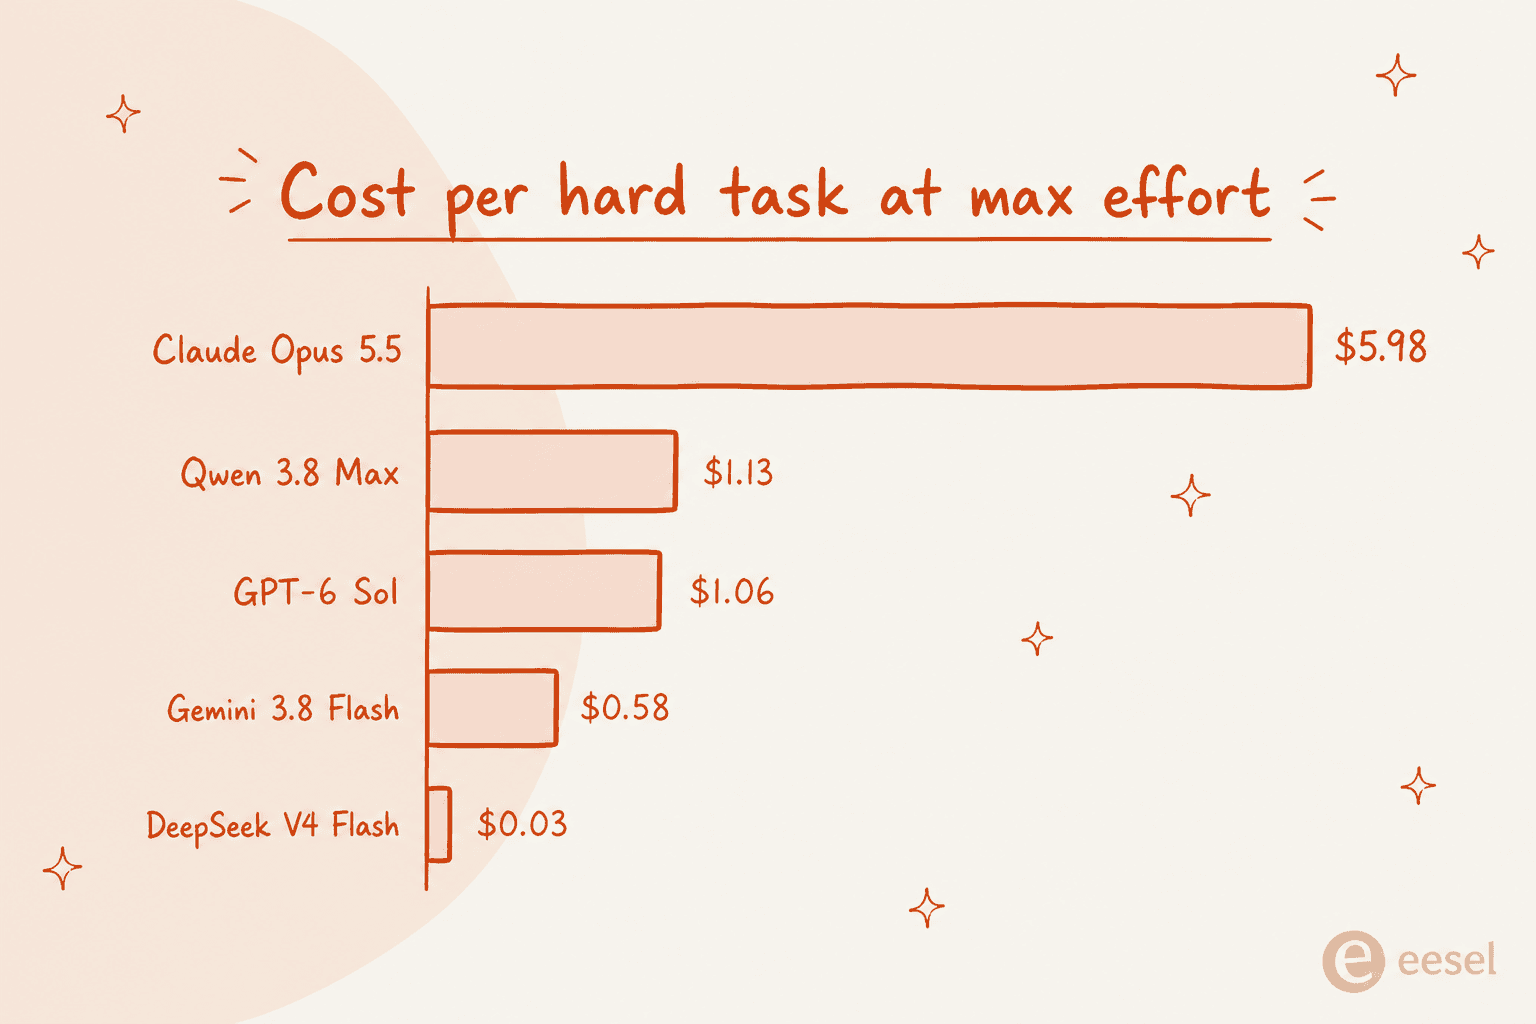
生のインテリジェンスではOpusが勝る。Artificial AnalysisはSolのIntelligence Indexを48と評価しており、Opus 5.5の58に対して劣る。しかし、各ポイントのコストを見てほしい。Solは100万トークンあたり$2/$10でOpusの半額であり、最大エフォートでの難しいタスクはOpusの$5.98に対して約$1.06で完了する。これは出力トークンの排出量がはるかに少ないことも一因だ。これがこの記事全体で最も鋭い数字だ。
この差が見合うかどうかについては本当の議論があり、コミュニティは真っ二つに割れている。ローンチスレッドでの経験豊富なテスターの声を紹介する。
My initial takeaway is that GPT-6 is mostly a lower cost win, for Luna. GPT-6 Max is an upgrade on intelligence too, but its mostly a cost play (which is great, not complaining). I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability.

メリット: 最大エフォートでタスクあたり約5倍安い、デフォルトの文章がより簡潔、巨大なコンテキストウィンドウ、そして事実性における本物の改善(OpenAIは従来のSolの約半分のミスを報告しており、Artificial Analysisによれば最大エフォート時の幻覚率は92%から60%に低下した)。
デメリット: Opus 5.5より推論の上限が低く、ChatGPTの無料プランでは利用できないため、気軽なアクセスには有料プランが必要になる。
評価: エージェントを構築するほとんどのワークロードにとって、Solはより賢い選択だ。ピーク時の推論力を一部手放す代わりに、速度と予算でその大半を取り戻せる。多くのタスクを実行しながら請求額を注視しているなら、ここから始めるとよい。
2. Gemini 3.8 Flash:安価で本当にマルチモーダルな選択肢
最適な用途: 予算が限られている中で音声、動画、PDF入力が必要な高スループットの仕事。
Gemini 3.8 FlashはGoogleの6週間で3回目のFlashリリースであり、興味深いことをやってのける。Artificial Analysis Intelligence IndexでOpus 5.5を上回りながら(59対58)、2026年末までは100万トークンあたり$0.75/$3.75という一部のコストで済む。また、ここで唯一、画像、音声、動画、PDFをネイティブに取り込めるモデルでもあり、入力ウィンドウは1Mトークンだ。
しかし正直な留意点も重要だ。最初のトークンまでの時間は13.30秒で、クラス中央値の約3秒に対して大幅に遅く、人間がライブで待つ用途には失格で、一方で夜間バッチ処理には最適だ。冗長でもあり、Google自身もローンチ投稿で効率優先のワークロードは3.7 Flashに留まるべきだと述べている。価格とマルチモーダルの幅では優れているが、応答性では優れていない。
メリット: フロンティア級のIntelligence Indexスコア、リスト中最も幅広い入力タイプ、非常に安価、テスト用の無料プラン。
デメリット: 最初のトークンが遅い、価格優位性を食いつぶす冗長な出力、そして2027年1月1日にすでに予定されている$1.50/$7.50への価格倍増。
評価: ワークロードが非同期でマルチモーダルなら、このページで最もコストパフォーマンスに優れていると言えるだろう。ただし、13秒の最初のトークン遅延が目立つライブチャットウィジェットの背後には置かないこと。非同期エージェントとリアルタイムエージェントの違いについては、ルールベースチャットボットに対するAIエージェントに関する記事が有用な枠組みになる。
3. Grok 4.7:エージェントループの中で生きるための価格設定
最適な用途: トークンあたりのコストが積み重なる、大量かつ数時間に及ぶエージェント型コーディング。
Grok 4.7は2026年9月21日にリリースされ、4.6よりも大きなベースモデルの上に構築され、数時間に及ぶタスクに重点を置いた長い強化学習を経ている。200Kプロンプト以下では100万トークンあたり$2/$6で、ここに挙げたフロンティア級モデルの中で最も安い出力単価を持ち、500Kのコンテキストウィンドウに加え、長いセッション向けの新しいContext Compaction APIを備える。
ベンチマークの物語は「昨年の価格でフロンティアに近い」というものだ。xAI自身の表では、Grok 4.7はTerminal-Bench 4.0で37.6(4.6の20.3のほぼ2倍)、EEBenchで64.0、そしてSolとOpusクラスのモデル両方を実際に上回るHarvey Legal Agentスコア19.6を記録している。ただし、すべてで勝っているわけではない。HealthBench Professionalでは56.7を記録し、GPT-6 SolとAnthropicのトップティア両方に後れを取る。
メリット: 低い出力単価はトークンを消費するループに適しており、コーディングとターミナルのベンチマークで本物の飛躍があり、これまでで最も強力なxAIの安全性スタックを備える。
デメリット: 500Kのコンテキストウィンドウは1Mトークンのライバルの半分であり、ロングコンテキストの追加料金($4/$12)は200Kを超えるとリクエスト内のすべてのトークンに適用され、ヘルスと一部の推論評価ではフロンティアに劣る。
評価: 何時間も動くコーディングエージェントを組んでいて、最後の数ポイントの推論力よりもトークンあたりのメーターを気にするなら、Grok 4.7は堅実で正直な選択だ。ターミナルから操作したいならxAI CLIもある。
4. Qwen 3.8 Max:フロンティア級のIntelligence Index、半額
最適な用途: Opusクラスのインテリジェンススコアと、フォールバックとしてダウンロード可能なベースモデルの両方を求めるチーム。
Qwen 3.8 Maxは2026年8月2日に一般提供が開始され、コストパフォーマンスに優れたフロンティアモデルの一つとして静かに存在感を示している。全体2.4T/アクティブ95Bのmixture-of-expertsモデルで、コンテキストは1Mトークン、AlibabaのクラウドではToken 100万あたり$2/$6で提供される。Artificial Analysisのボードでは現在6位にランクされ、Intelligence Indexは58.08と、実質的にOpus 5.5の看板スコアと同水準でありながら、コストは一部にとどまる。
ニュアンスとして、自動評価指標と人間の好みがここでは一致しない。LMArenaでは、Qwen 3.8 Maxはブラインド評価で強く、Text #5、WebDev #4、Vision #2という結果だ。しかし複合指標と人間の投票はわずかに異なる方向を示しているため、これについて単一の数字で断定することは決してしない。また、オープンなベースウェイトは存在するが、ビジョン、非思考モード、組み込みツールを追加するホスト版のMaxとは機能面で同等ではないことにも注意が必要だ。
メリット: $2/$6でフロンティア級のIntelligence Index、優れたマルチモーダルなLMArenaランキング、セルフホストオプションを求めるチーム向けのオープンなベース。
デメリット: オープンウェイトは非Apacheライセンスであり、ホスト版の機能を欠いており、自動評価と人間評価のスコアの乖離は自分のタスクでテストすべきことを意味する。
評価: 過小評価されている選択肢。より安価にOpus 5.5に近いベンチマークを求め、単一のスコアを信頼するのではなく自分で評価を行うことに抵抗がないなら、Qwen 3.8 Maxはショートリストに入る価値がある。
5. Kimi K3:本当に「見える」オープンウェイト
最適な用途: 本当にオープンでビジョン対応のフロンティアモデルを求めるチーム。
Kimi K3はMoonshot AIの旗艦モデルで、全体2.8T/アクティブ104Bのmixture-of-expertsモデル、コンテキストは1Mトークン、ネイティブビジョン(画像と動画)を備える。重要なのは、オープンウェイトが2026年7月27日に予定通りリリースされ、safetensorsのインデックスがプレスリリースとは独立に2.8Tというパラメータ数を裏付けている点だ。Artificial Analysis Intelligence Indexでは57に位置し、Opus 5.5と近い水準にある。
価格設定は100万トークンあたり$3/$15で、これは格安クラスではなくClaude Sonnet帯に相当する。知っておくべき癖が一つある。推論をオフにできない。reasoning_effortコントロールには現在lowとhighのレベルがあるが、これらはコストの段階ではなくレイテンシのコントロールであり、どのレベルでも料金は同じだ。公開画像URLも受け付けず、base64またはファイルIDを渡す必要がある。
メリット: ビジョン対応の真にオープンなウェイト、フロンティアに近いインテリジェンススコア、そして強力なエージェント性能とBrowseCompの結果。
デメリット: 安価なオープンモデルではなくSonnet並みの価格設定、オフにできない推論、URLではなくbase64を必要とする画像処理。
評価: 「オープンウェイト」と「画像を扱える」の両方が必須条件である場合の選択肢だ。どちらか一方だけでよいなら、DeepSeekの方が安く、Qwenの方がベンチマークが高いため、Kimi K3はデフォルトの選択というより特定の目的のための選択だ。
6. DeepSeek V4:コスト下限、ただし注釈付き
最適な用途: トークンあたりの絶対的な最安コスト、そしてMITライセンスのウェイトを求めるチーム。
DeepSeek V4 Flashは、このリストの中で有能なモデルを動かす最も安い方法であり、それに尽きる。全体284B/アクティブ13Bのmixture-of-expertsモデルで、コンテキストは1Mトークン、MITのオープンウェイトを持ち、Artificial AnalysisではIntelligence Index 50を記録しつつ、最大エフォート時のタスクあたりコストは約$0.03で、これは誤植ではない。
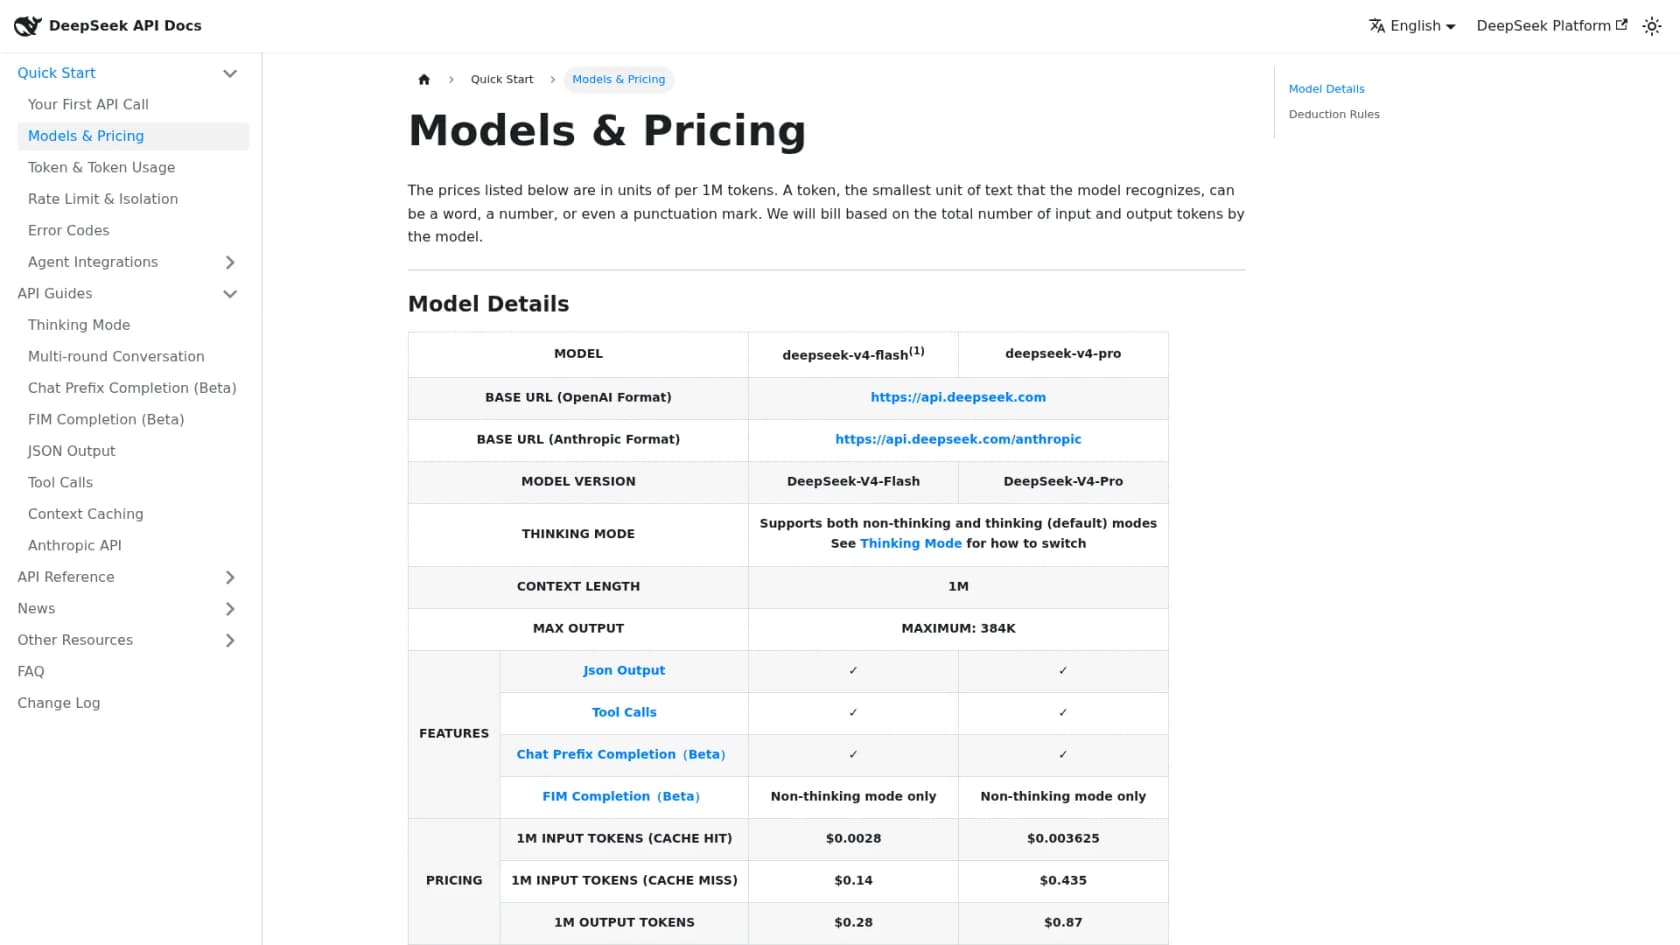
注釈は現実のものであり、率直に述べておく価値がある。価格設定にはピーク/オフピークの追加料金があり、キャッシュミス入力は$0.22/$0.44、出力は$0.66/$1.32(オフピーク/ピーク、100万トークンあたり)で、ピークは中国のビジネスアワーに相当するため、米国やEUのキューは主にオフピークで課金される。モデルはテキスト専用で、文書化された画像入力はない。そしてデータは中国の法律の下、中国国内に置かれる一方、有料APIの利用規約は学習利用について沈黙しており、許可を明示してはいない。この組み合わせにより、コードや社内ツールには素晴らしいエンジンである一方で、規制対象の顧客データにそのまま代替する用途には不向きだ。ある開発者はこの実践的な事情を率直に述べている。
I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it. I use it as a coding assistant in my IDE so the results end up at the same quality I would write by hand.
メリット: どこよりも低いタスクあたりコスト、MITライセンスのオープンウェイト、1Mトークンのコンテキスト。
デメリット: テキスト専用、冗長で幻覚率が高い、脆弱なピーク料金体系の癖、そして機微な顧客データには不向きな中国国内でのデータ保存。
評価: データが機微でないコードや社内作業においてはコストパフォーマンスの王者だ。顧客対応の何かに使う前に、AIの幻覚に関するガイドと組み合わせるとよい。
7. GPT-6 Luna:最も安くスケールする方法
最適な用途: インテリジェンスの数ポイントの差が結果を左右しない、大量かつ低リスクの作業。
GPT-6 LunaはOpenAIの低価格帯であり、100万トークンあたり$0.10/$0.50と非常に安く、GPT-5.6 Lunaから一律50%の値下げとなっている。Solと同じ105万トークンのコンテキストとネイティブな画像入力を共有し、ChatGPTのFreeプランとGoプラン($8)で利用できる唯一のGPT-6モデルだ。OpenAI自身の枠組みは「Solで作り、Lunaでスケールする」であり、市場もそれに同意しているようだ。前世代のLunaはすでにOpenRouterで最も使われているモデルだった。
6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model.
正直な反論としては、「トークンあたり最安」と「タスクあたり最安」は同じではないということだ。キャッシュを多用するコーディングワークフローでは、キャッシュ読み取りの差により、DeepSeekのようなオープンモデルの方が結局安くつくと感じる開発者もいる。キャッシングが利用量を支配しているなら、自分で数字を確認してほしい。
メリット: クローズドなフロンティアファミリーの中で最も安い選択肢、大きなコンテキストウィンドウ、テスト用の無料アクセス。
デメリット: GPT-6系列の中で最も低い推論の上限、そしてキャッシュ多用のジョブではオープンモデルに負ける可能性があるタスクあたりの計算。
評価: 大量処理、分類、翻訳、シンプルなエージェントのステップに適したツールだ。最も難しい推論タスクを任せるモデルではないが、優れた作業馬であり、退屈な80%の作業のための素晴らしいデフォルトだ。
8. Claude Sonnet 5:ファミリーに留まり、半額を払う
最適な用途: Claudeのツール群とエコシステムが好きだが、すべての呼び出しでOpusを必要としないチーム。
Opus 5.5を使っている理由がClaudeのエコシステムであるなら、Claude Sonnet 5は明らかな社内代替だ。100万トークンあたり$2/$10とOpusのちょうど半額で、Anthropicはこれを速度とインテリジェンスの最良のバランスと位置づけている。同じAPI、同じClaude Code統合、同じツールエコシステムを維持したまま、Opusの推論を必要としないタスクにOpus料金を払うのをやめるだけだ。
私が見てきた中で最も理にかなったパターンは、2つのモデルを組み合わせる設定だ。難しく曖昧なタスクはOpus 5.5に振り分け、それ以外はSonnet 5に振り分ける。これにより、Opusの上限が必要なタスクではその大部分を活かしつつ、必要ないタスクでは請求額を抑えられる。
メリット: Opusの半額、エコシステムの切り替えが不要、そしてAnthropicの速度重視ティア。
デメリット: Opus 5.5より推論の上限が低く、それでも単一ベンダーの価格設定の中にとどまる。
評価: このリストの中で最も摩擦の少ない代替だ。Claudeに満足していて単に支出を減らしたいなら、他を探す前にまず行うべき変更がこれだ。
実際にどう選ぶか
ランキングを取り除けば、決定はいくつかの正直な問いに帰着する。「最良」はワークロードの形に依存するため、唯一の勝者は存在しない。
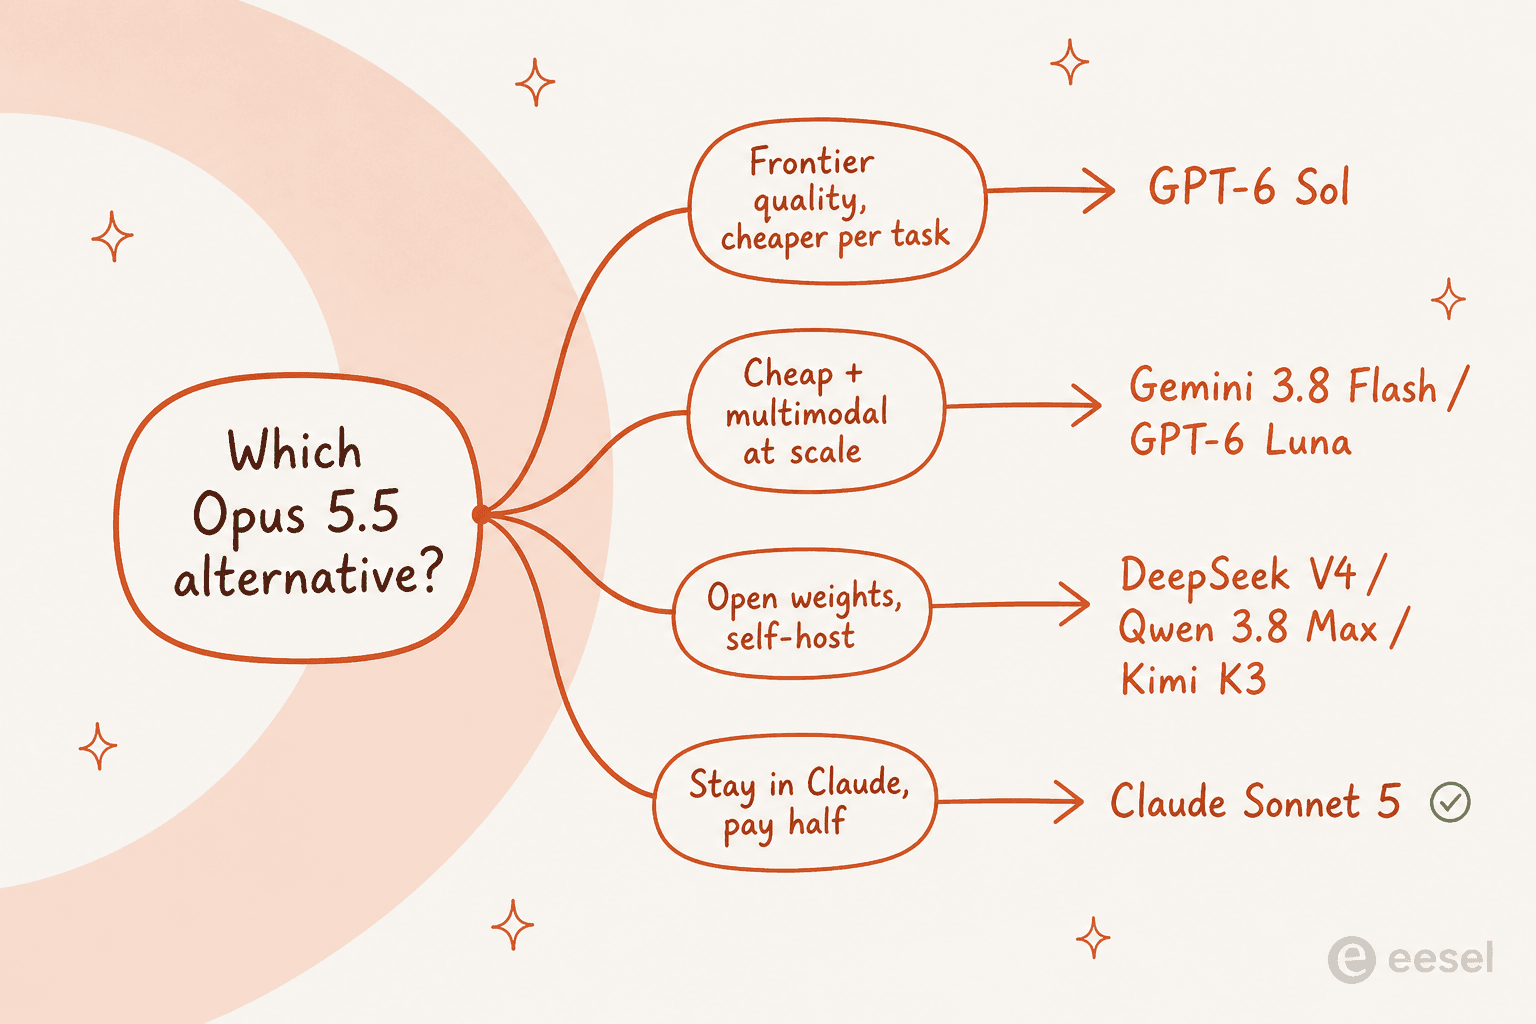
- はるかに安く、Opusに最も近いものが欲しい? GPT-6 Sol。ほぼフロンティア級の品質を、タスク単価の約5分の1で。
- 大規模に非同期・マルチモーダルなジョブを実行している? リーチと価格ならGemini 3.8 Flash、トークンあたり最安ならGPT-6 Luna。
- オープンウェイトが必要? コスト下限ならDeepSeek V4、最高ベンチマークならQwen 3.8 Max、ビジョンも必要ならKimi K3。
- Claudeに満足している? Sonnet 5を半額で、理想的には難しいタスク用のOpusと並行してルーティングする。
そしてこの全体の下には、経験豊富な開発者たちが繰り返したどり着く、より静かな論点がある。ベンチマークはスタートの合図であって、判定ではない。
Only hands-on experience matters in the end, and these days it's very easy to switch models.
この最後の一節、「very easy to switch models」こそが2026年の本当の物語だ。これは、こうした比較記事の多くが飛ばしがちな問いへとつながっていく。
eeselを試す:これらのモデルどれでも動くチームメイト
すべてのモデル対モデルの記事が静かに前提としていることがある。それは、モデルを選び、そのAPIを組み込み、プロンプトエンジニアリングを扱い、ツールに接続し、実際の顧客に対して幻覚を起こさないようにすること全体が、あなたの仕事だという前提だ。ほとんどのチームにとって、それは本来の仕事ではない。本来の仕事は、より高い解決率であり、公開された記事だ。モデルは単なるエンジンにすぎない。
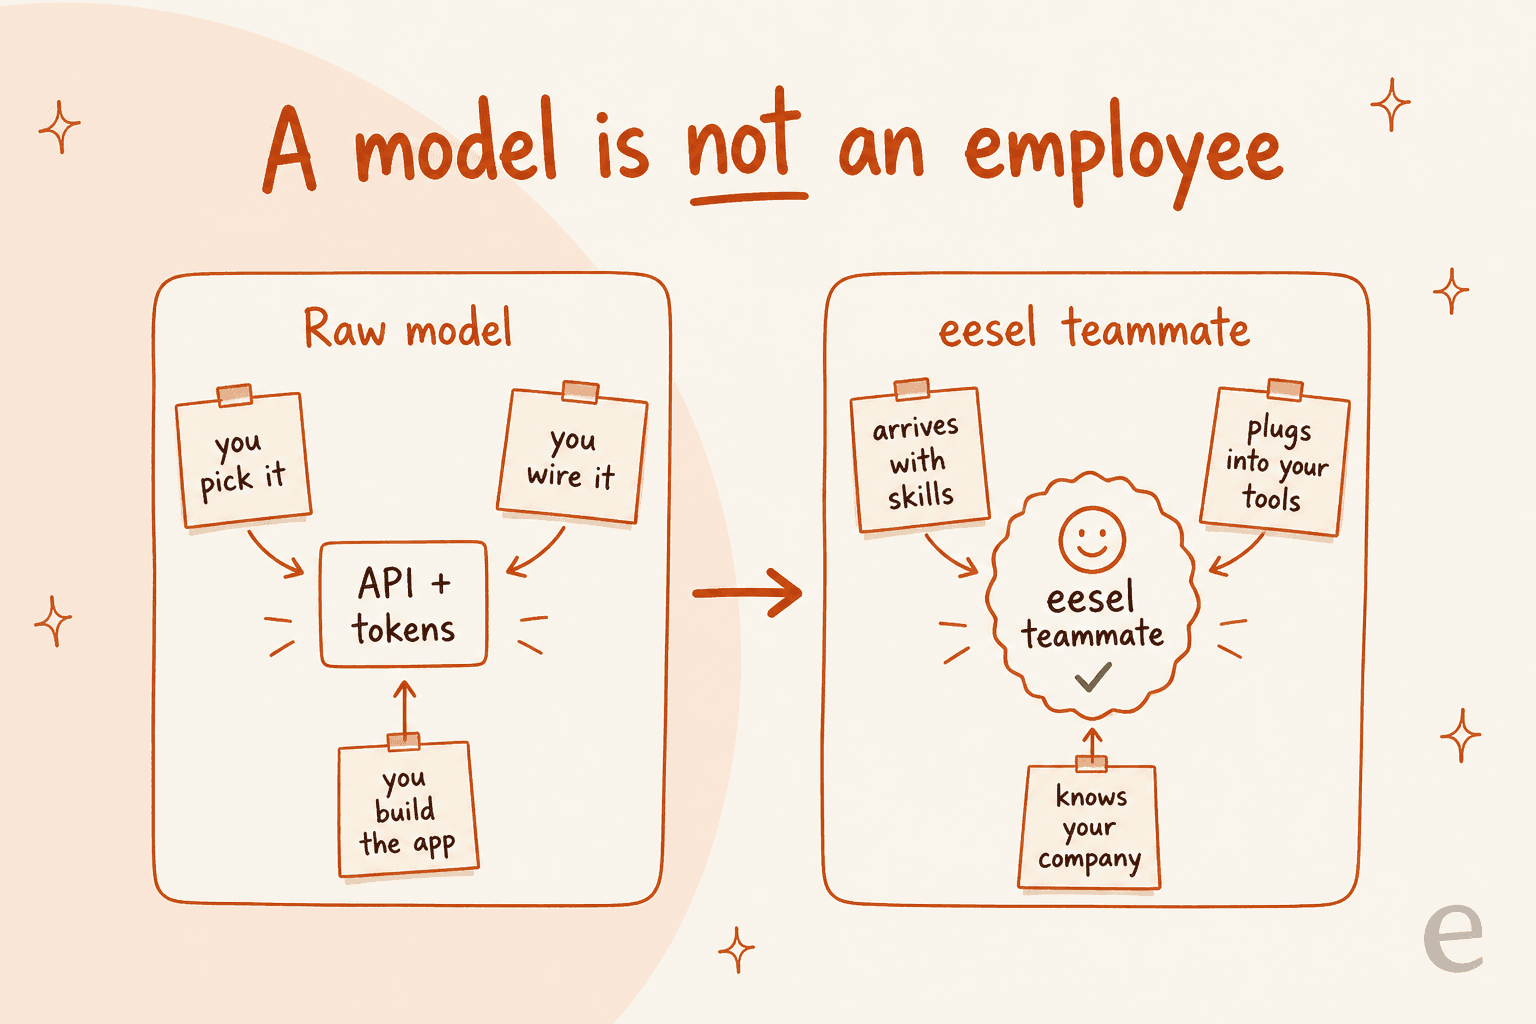
それが私がeeselを捉える方法だ。これはAIチームメイトのプラットフォームであり、特定の仕事のためにすぐ働けるチームメイトを雇うことができる。現在のラインナップは、既存のサポートキューに加わるAIヘルプデスクチームメイトと、リサーチ済みの記事を執筆するAIブログライターだ。それぞれがすでに自分の仕事のやり方を知った状態で到着し、あなたのツールに接続され、会社のコンテキストに根ざしているため、Opus 5.5とSolのどちらを選びプロンプトの面倒を見るかを決めるのはあなたではなくなる。モデルはチームメイトの下に位置しているため、来月より安く、あるいはより優れたモデルが登場しても、それは無料のアップグレードであり、作り直しではない。

モデル代替記事を読むようなタイプの人なら、この部分が気に入るはずだ。すべてがターミナルから操作可能だ。eesel CLI(npx @eesel/cli)を使えば、統合の接続、エージェントの常設指示の編集、過去のチケットに対するロールアウトのシミュレーション、アクションの承認、そしてすべての実行のアクティビティログの閲覧をすべてJSONとして行え、書き込みが送信前に実際どのような呼び出しを行うかを表示する--dry-runフラグも備える。各ワークスペースはMCPサーバーでもあるため、Claude Code、Codex、Cursorのようなコーディングエージェントも同じチームメイトを操作できる。ダッシュボードと同じ製品を、ターミナルで生活する人々やエージェントに向けて公開したものだ。eeselを無料で試すことができる。
よくある質問
Claude Opus 5.5の最良の代替は何ですか?
Claude Opus 5.5の料金はいくらで、代替モデルは安いのですか?
Claude Opus 5.5にオープンソースの代替はありますか?
コーディングエージェントに最適なClaude Opus 5.5の代替はどれですか?
AIサポートエージェントを構築するのに1つのモデルを選ばなければなりませんか?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.