2026年版 Empromptuの代替サービスおすすめ8選: 実際の料金と実際の制限

Kira

Katelin Teen
最終更新 October 14, 2026
Empromptuが売っているのは、証明できる精度という一点です。すでにあるAIプロトタイプを持ち込むと、その上に評価とポリシー、コスト管理、モニタリングが追加され、標準のデプロイはオンプレミスだと説明されています。実在する製品で、手薄だった領域でもあります。料金もこのカテゴリの大半より透明で、これは予想外でした。
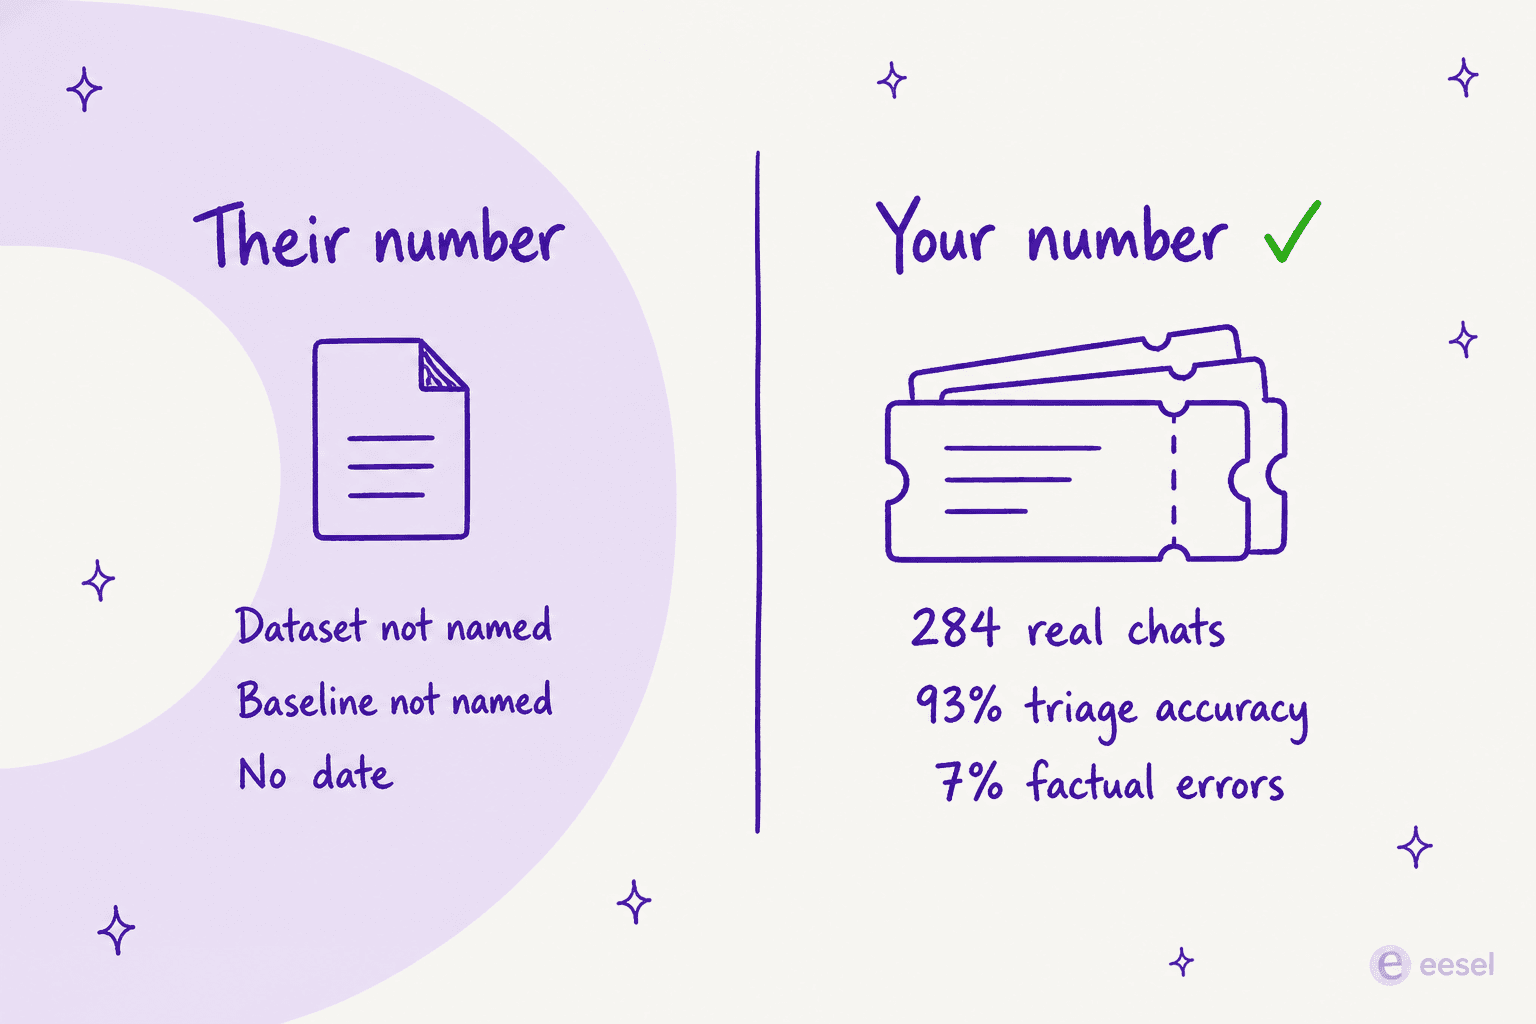
落とし穴は、看板に掲げられた数字にあります。その数字については、マーケティングページよりも自社のヘルプセンターのほうがうまく説明しており、マーケティングページとしては奇妙なことです。精度スコアは自己採点の数字です。アプリが出力を生成し、自分で書いた評価基準ごとにその出力を0から10で採点し、その平均を取ります。ドキュメントには計算式まで載っています。(8.0 + 6.5 + 7.5) ÷ 3 = 7.3。つまり「精度90%以上」とは、自分で書いた基準に対して10点満点中9.0以上という意味です。73本のヘルプセンター記事のどこにも、データセットもベースラインも、外部ベンチマークもありません。自社ドキュメントにある典型的な最適化の流れは、8.4で頭打ちになっています。
したがって、あらゆるEmpromptuの代替サービスを仕分ける問いは、誰の精度の主張が最も高いかとは関係ありません。本当の問いは、顧客の目に触れる前に、誰の精度を自社のデータで測れるかです。この問いで、以下の8つの選択肢は3つのレーンに分かれます。自分で作る、すでに作ったものを測る、すでにその仕事をこなしているチームメイトを雇う、の3つです。仕事がカスタマーサポートなら、eeselは3つ目のレーンに入ります。本番前に過去のチケットでシミュレーションを実行し、課金は対応チケット1件あたり0.40ドルで、料金はページにそのまま公開されています。
なぜチームはEmpromptuの代替サービスを探し始めるのか
まずEmpromptuに対して公平でいたいと思います。アイデアは良いのです。
ほとんどのAIツールは、あなたについて2つのうちどちらかを前提にしています。何も持っていないのでビルダーを使う、またはプラットフォームチームがいるのでSDKを使う、のどちらかです。Empromptuはその中間の空白を狙っており、3ステップの売り込みも約束の範囲では誠実です。AIアプリを持ち込めば、精度チェック、ポリシー、モニタリングを加えてくれて、得た知見はチームのものになります。トップページの文言で私がうなずいたのは、"Most AI fails in production, not because the model was wrong, but because nothing was in place to catch it."でした。その通りです。私も実際に見てきました。
創業者自身の誕生秘話も、同じ観察です。
"We started Empromptu after burning through thousands of credits on AI builders and hitting the same problem: cool looking prototypes or demos that break with real users."

そして現場の実務家も、誰に聞かれなくても同じことを言います。次の引用はエージェントのプロジェクトがなぜ停滞するのかというスレッドからのもので、Empromptuの前提全体に対しては、これまで見つけた中で最良の一行の論拠です。
"Companies need processes, not tools. Once they deploy an agent, it should be boring and reliable. Measurable quality, failure alerts, "report to human" cases. All those wrappers make the enterprise-ready solution much more complicated than building an agent itself."

また、若い会社でもあります。Empromptuは200万ドルのプレシード資金を調達し、Precursor Venturesが主導して2025年12月に発表されました。チームは約12人です。創業者たちも信頼できる実務家です。Shanea Levenは以前CodeSeeを率い、CTOのDr. Sean RobinsonはMadrona Venture Studioで最適化技術を構築しました。
では、買い手が他を探し始める本当の理由を見ていきます。
精度の数字は自己採点で、ドキュメントもそう認めています。 トップページには4通りの表現があります。断定的な「本番での精度98%、測定済み」、FAQ内の控えめな「最大98%の精度」、出典のない「250以上のドキュメントでも98%、他のツールは60〜70%に低下」という比較、そしてマーケティング用のUIモックアップ内の98.2%という数字です。ヘルプセンターは代わりに「90%以上」を6本の記事で使い、その仕組みを十分に分かりやすく説明しています。有効な評価はそれぞれ自然言語の基準であり、モデルがその基準を0から10で採点し、スコアを平均します。基準を変えれば、数字も変わります。評価ごとに有効/無効の切り替えがあり、無効なものは現在のスコアに影響しません。
Empromptuの名誉のために言えば、ドキュメントはまさにこの点で率直です。Evaluations Overviewには**「High Scores But Poor Real-World Performance」**というトラブルシューティング項目があり、原因として、実際の使い方に合っていない評価と、欠けている基準が挙げられています。公開されているガイダンスもマーケティングより控えめです。新規タスクは6.0、本番稼働後は7.5、重要なタスクは8.5を目標とするとされています。9.0以上が一般的だとドキュメントが主張している箇所はありません。文書化されている最適化の流れは8.4で終わっています。
「RAG込み」は主張されているものの、仕様が示されていません。 4本の記事が、すべてのアプリに検索が付属すると述べています。73本のどれも、チャンク分割の方針、インデックス、ベクトルストア、コネクタ一覧、top-kの設定、引用の設定を挙げていません。文書化されている検索の部品はtext_embedderひとつで、知識はビルドプロンプトの中で説明することで付与します。Promptingコレクションは、ベクトルデータベースのような名前を挙げるのをやめるよう積極的に勧めており、これはプロンプトエンジニアリングの助言としては妥当ですが、検索の設定が文書化されないままになります。検索品質が精度を損なう原因なら、サポート系のコンテンツでは多くの場合そうですが、まさにそこの仕様が知りたい部分です。理由はRAGとファインチューニングの比較で説明しています。
コンプライアンスの面は、バッジが示すより薄いです。 ヒーロー帯にはSOC 2、HIPAA、Zero vendor lock-inと書かれています。しかし自社の会社概要ページのFAQでは、SOC 2は取得手続き中と説明されています。料金ページはEnterpriseに「Built for regulated industries」のバッジを付けながら、認証は一つも挙げていません。SOC 2もHIPAAもISO 27001もBAAもデータ所在地もSLAもありません。73本のヘルプセンター記事全体で、HIPAAが出てくるのはちょうど1回で、構築前のワークシートにある未チェックのボックスです。/securityと/trustはどちらも404を返します。オンプレミスの話も、「デフォルトでオンプレミス」から想像されるより限定的です。ドキュメントはそれをエンタープライズ向けの営業施策として、また設計上のハイブリッドとして説明しています。アプリはローカルで動きますが、最適化のためにEmpromptuへの接続を維持します。エアギャップモードは文書化されておらず、その境界を何が越えるのかの説明もありません。医療やフィンテックの買い手にとって、これは致命的ではありません。ただし、パイロットの後ではなく前に実施したいセキュリティレビューです。
ドキュメントは本物ですが、隠れています。 docs.empromptu.aiには15コレクション、73記事の完全なヘルプセンターがあり、正直なところマーケティングサイトより役に立ちます。ただしnoindexに設定されているため、検索エンジンがあなたをそこへ送ることはありません。スクリーンショットも1枚もありません。モデル最適化に関する記事のひとつは、Claude 3 Sonnetの項目の後でリストの途中で終わり、冒頭が約束する5つのセクションをひとつも提供しておらず、モデル一覧には2026年8月の時点でもGPT-4oとClaude 3 Opusが載っています。
追加コストは分かりません。 一括のコストは珍しく明確で、それについては後ろで評価しています。欠けているのは超過分です。追加購入の価格も、繰り越しの方針も、クレジットが尽きたら何が起きるのかの説明もありません。つまり、プランは見積もれますが、請求額は見積もれません。
第三者のシグナルがほとんどありません。 2025年6月から12月の間に自己投稿されたShow HNとLaunch HNの9件の投稿は、合計で14ポイントしか集めず、創業者以外からの返信はちょうど1件で、それは代替サービスとの違いを2文で説明してほしいという依頼でした。G2は、購入の判断材料を提供できるだけのレビューがまだないとはっきり述べており、CapterraやTrustpilotには掲載自体がありません。プレシードの会社なら普通のことで、私の批判ではありません。ただし、最終的に評価する主張がすべてベンダー自身のものだということを意味します。
これらのツールをどう比較したか
私はeeselのプロダクトチームのエンジニアなので、これらを依存ライブラリを読むように読みます。単位は何か。何がロックされているか。スケールすると何が壊れるか。
8つそれぞれについて、ベンダー自身の料金ページとドキュメントを確認し、5つを記録しました。
- 課金単位: ベンダーが定義した通りのものです。クレジットとトークン、トレーススパン、チェックポイント、チケットは、互換性のあるものではありません。
- 超過料金が公開されているか: 公開された価格の隣に非公開の超過料金があるのは、料金表の半分でしかありません。
- 精度測定が組み込まれているか: ソフトウェアテストやセキュリティスキャンが同じ装いをしているのとは別です。この2つの違いは実在し、AIエージェントの性能評価で説明しています。
- 本番前に自社データでテストできるか: 後ではなく前に、です。
- 実際のコンプライアンスの答え: 署名済みBAA、SOC 2報告書の種類、セルフホスト、データ所在地です。
意図的にしなかったことが2つあります。自分で実行したベンチマークで誰かを採点することはしませんでした。私のデータでのベンチマークはあなたのデータについて何も語らず、それがこの記事の要点だからです。また、Empromptuは8つに含めませんでした。ここでは基準となる既存の存在です。
この一覧全体を仕分けるひとつの問い
以下のすべてのツールは3つのレーンのいずれかに入り、レーンが判断の残りすべてを決めます。
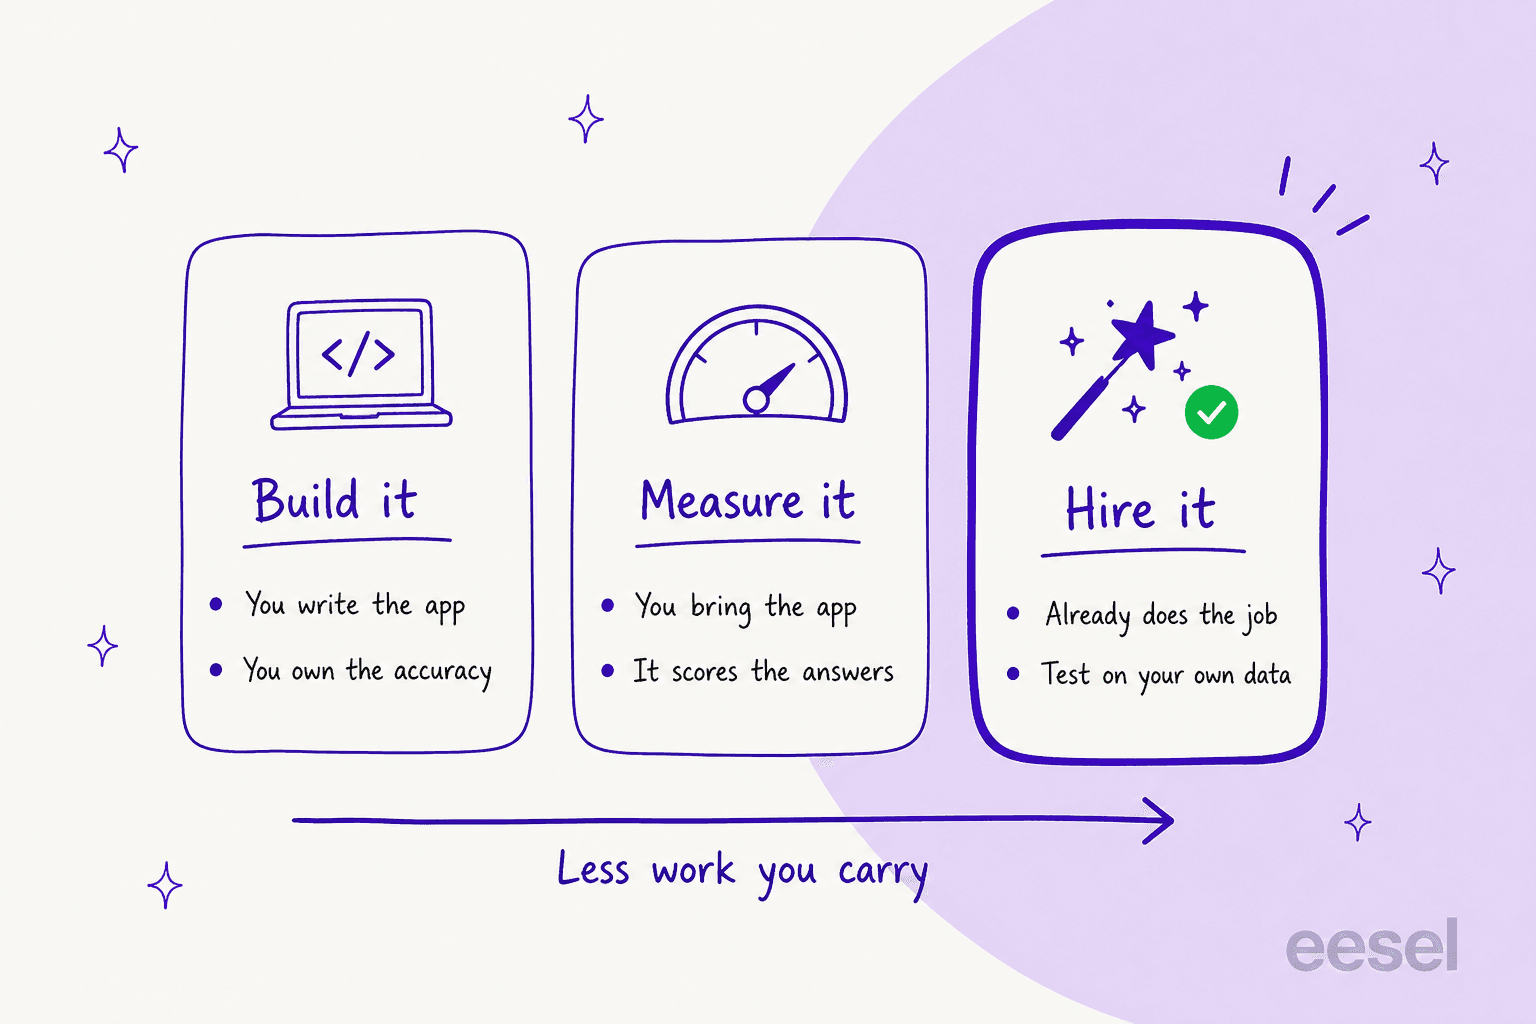
作る。 Lovable、Replit、BoltとGoogleのプラットフォームは、アプリケーションを生み出す手段を渡してくれます。そのどれも、答えが正しいかどうかは教えてくれません。これは欠陥ではなく、ただの守備範囲です。つまり、精度の問題は自分のものになり、これらのプロジェクトが力尽きるのはまさに精度のところです。
測る。 ArizeとLangfuseは、測定レイヤーそのものです。それが得意で、境界についても誠実です。Langfuseのドキュメントはタスクを「the application code that you want to test」と定義しており、アプリは自分のものだとはっきり伝えています。知っておく価値があります。この2つはEmpromptuと同じ基本手法、つまり自分で書いた基準に対するLLM-as-a-judgeを使っているので、仕組み自体は差別化要因ではありません。違いは、本番前の実際の過去トラフィックに向けられるか、本番後に届くトラフィックにしか向けられないかです。
雇う。 Gleanとeeselは購入のレーンです。仕事はすでに済んでおり、連携もすでにあり、設定するのは範囲とガードレールだけです。特にサポートでこのレーンが勝つ理由は、難しかったのはモデルではなく、検索とエスカレーションのロジックだったからで、これはRAGと素のLLMを比較して分かったことそのものです。
このレーンには、ここに載せきれないほどの名前があります。仕事が社内のAIアプリではなく顧客向けのサポートなら、候補リストは変わり、DecagonやSierraもそこに入ります。
私が何度も立ち返るテストは、あるエンジニアが私よりうまく言い表しています。
"you shouldn't build anything that doesn't make YOUR beer taste better... your CS team buys a COTS solution for their tickets - why should you build an agent when there are multiple startups doing this? What, are you going to be better at it than those startups?"
逆方向の但し書きもはっきり言っておきます。eeselがこれで案件を失うことがあるからです。技術チームにとって、ClaudeやOpenAIのAPIの上に直接構築するのは本物の選択肢であり、常に間違いとは限りません。ARを扱う建設テック企業や、Claude APIに直接移行したD2Cの美容ブランドなど、何社ものeesel顧客がまさにそのために離れていきました。用途が狭く、量が少なく、余力のあるエンジニアがいるなら、作ってください。
自作の費用を実際に見積もると、反対の側の重みが出てきます。
"When I started deep diving into the BRD I realized there were several full startups, charging thousands if not tens of thousands of dollars monthly for what we were trying to build. When I brought this up to my manager and showed them examples, they said ya that BRD probably has to be redone"
Empromptuの代替サービス比較
| ツール | 向いている用途 | レーン | 公開されている入門価格 | 課金単位 | 超過料金の公開 | 精度評価の組み込み | 本番前に自社データでテスト可能か | HIPAA / BAA | SOC 2 | セルフホストまたはオンプレミス | 無料枠 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| eesel AI | サポートのチームメイトを雇う | 雇う | 月額299ドルから(500クレジット) | クレジット(チケットまたはチャット1件) | 上限付きの任意の超過課金、追加1クレジットにつき0.80ドル | 過去のチケットでのシミュレーション | はい | EnterpriseでHIPAA対応、署名済みBAAあり、要相談 | SOC 2 Type II認証取得 | いいえ | 100クレジット無料、カード不要 |
| Gemini Enterprise Agent Platform | 署名済みBAAが必要な規制対象の構築 | 作る | 従量課金のみ、シート料金なし | トークンとコンポーネントごとのメーター | はい、料金表は完全公開 | 評価サービス、合成ペルソナ | 合成データのみ | はい、BAAの対象 | はい | Google Cloud、VPC-SC、CMEK | 300ドルのクレジット |
| Glean | 社内ナレッジ全体への全社的なAI | 雇う | 非公開、ページは現在リダイレクト | Flexシートとフレックスクレジット | クレジット単価は非公開 | プラットフォーム内のエージェント評価 | 限定的 | HIPAA評価 | Type 2 | プライベートデプロイ | なし |
| Arize AX | すでに動かしているアプリの測定 | 測る | 無料0ドル、Pro月額50ドル | トレーススパンと取り込みGB | いいえ | はい、LLM-as-a-judge | 自社データセットでオフライン | Enterpriseのみ | Proプランから | Phoenix、ELv2 | あり、25kスパン |
| Langfuse | 自分で管理できるオープンソースの評価 | 測る | Hobby 0ドル、Core月額29ドル | ユニット: トレース、オブザベーション、スコア | はい、100kあたり8ドル | はい、ジャッジと実験 | 自社データセットでオフライン | HIPAA対応リージョン、Pro以上 | はい | はい、MITライセンス | あり、50kユニット |
| Lovable | プロトタイプを素早く出す | 作る | Pro月額25ドル | クレジット | はい、1クレジットあたり0.30ドル | いいえ | いいえ | いいえ、BAAは締結しない | Type IIとISO 27001 | いいえ | あり、上限付き |
| Replit | ひとつの場所で構築とホスティング | 作る | Core月額20ドル | 作業量ベースのチェックポイント | クレジットパックのみ | いいえ | いいえ | 記載なし | Type II | Enterpriseのシングルテナント | あり、制限付き |
| Bolt | 最も安い最初のたたき台 | 作る | Pro月額25ドル | トークン | 非公開 | いいえ | いいえ | 「対応準備済み」との表現、認証ではない | Type 2 | Enterpriseで自社クラウド持ち込み | あり、1日300K |
この表からは2つのパターンが見えてきます。超過料金を公開しているのは8つのうち3つだけで、Empromptuが比較対象に挙げる3つのプロトタイプビルダーはいずれも価格を公開しているのに、答えが正しいかどうかを測るものは何も提供していません。この空白についてはEmpromptuが正しいのです。争点は、誰がそれを埋めるべきかだけです。
この8つよりも広く網を張りたい場合は、eeselの仕事のためのAIアプリとノーコードのエージェントビルダーのまとめが、隣接する棚をカバーしています。
比較する前にEmpromptuの請求額を見積もる
一覧の前に、やっておく価値のある計算があります。Empromptuは、料金表とクレジット消費表の両方を公開している、ここでは数少ないベンダーのひとつなので、ドルを操作に換算するのに営業との通話は要りません。チャット応答は10クレジット、Webリサーチの呼び出しは10、最適化の実行は10、プロンプトの適用や評価の作成のような小さな操作は1つにつき1です。
ご自身の量を入力してみてください。
見ておく価値があるのはここです。199ドルの「Most Popular」のLaunchは、料金表全体で最も悪いクレジット単価で、Buildの0.078ドルに対して0.0796ドルです。199ドルが実際に買うのは量ではなく機能です。本番デプロイ、独自ドメイン、GitHubへのエクスポート、そして基本的な評価とオブザーバビリティが、すべてこの段階から始まります。本当の量の割引はOperateで来て、クレジットが約37%下がって1つあたり0.0499ドルになります。
チャット1回が10クレジットなので、無料プランは月10会話、Buildは50会話に相当し、会話型のワークロードは構築作業よりも10倍速く枠を使い切ります。コミットする前に、会話あたりの固定料金と照らし合わせる価値があります。私がこのAIサポートのコスト分析でやったとおりです。
もうひとつ、計画に入れておくべき下限があります。失敗のクラスタを見つける散布図であるEdge Case Detectionは、ドキュメント自身の説明によれば、パターンが見えるまでに約15〜20回の最適化実行が必要です。1回10クレジットなので、機能が何かを教えてくれる前に150〜200クレジットが消えることになり、無料枠の100クレジットを超えます。しかも機能自体が499ドルのOperateプランからしか始まりません。
1. eesel AI
向いている用途: 仕事をするためのプラットフォームではなく、サポートの仕事そのものを片付けたいチーム。
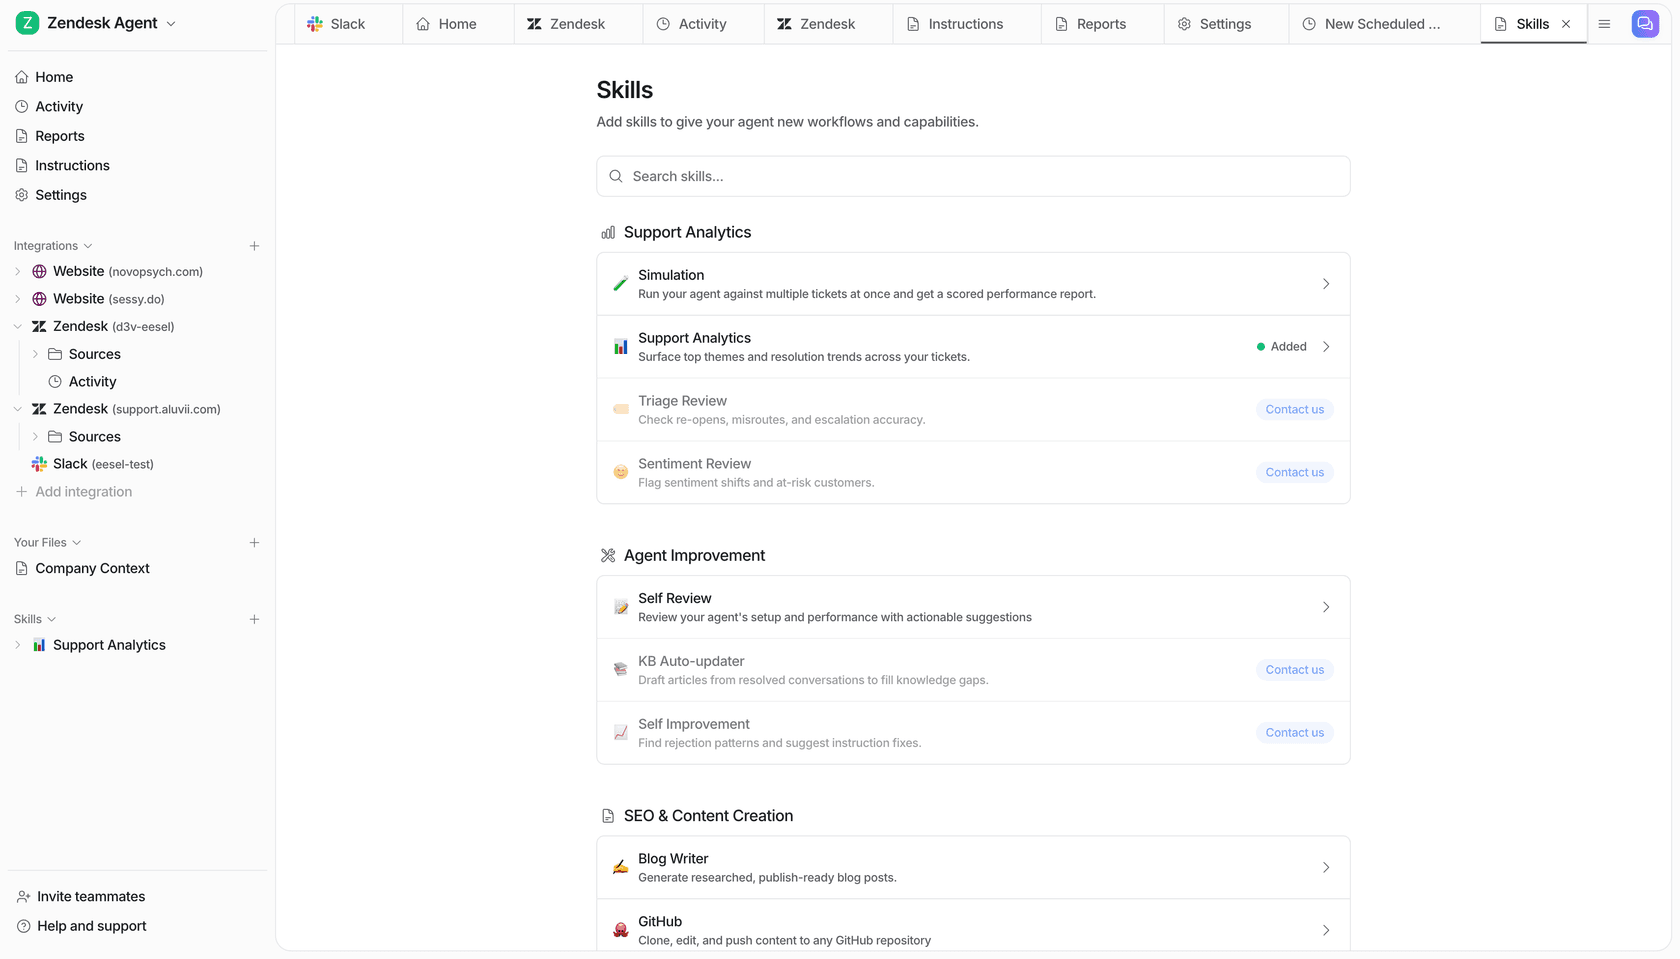
私はこれに携わっているので、以降はそのことを念頭に読んでください。正直な位置づけはこうです。Empromptuはインフラで、eeselは従業員です。eeselはAIチームメイトのプラットフォームで、現在の顔ぶれはAIヘルプデスクエージェントとAIブログライターです。チームメイトは作るものではありません。雇うものであり、キューの捌き方をすでに知った状態で来ます。
何をするか。 ヘルプデスクのチームメイトは、すでに使っているヘルプデスクに接続し、ヘルプセンター、過去のチケット、社内ドキュメントを取り込み、エージェントがすでにいるのと同じツールの中でチケットの下書きや解決を行います。確信度のしきい値とチケットタイプの除外が、何に手を付けるかを決めます。範囲外のものは、人間へのエスカレーションが標準です。
この比較で重要な部分。 本番前に過去のチケット全体でシミュレーションを実行し、予測を返します。つまり測定は自社のデータで行われ、ベンダーのデータでは行われません。この設計の背景は自社構築と購入の分析に、ガードレール側はサポートにおけるハルシネーション防止にあります。
料金
| プラン | 月間クレジット | 料金 |
|---|---|---|
| Free | 100 | 0ドル、カード不要 |
| Teammate | 500 | 月額299ドル |
| Teammate | 1,000 | 月額499ドル |
| Teammate | 2,500 | 月額999ドル |
| Teammate | 5,000 | 月額1,899ドル |
| ブログ記事の下書き | 1記事あたり | 1本4ドル |
1クレジットはチケット1件またはチャット1件で、最終的に何往復の返信になっても同じです。プラットフォーム料金もシートごとの課金もありません。料金ページにパッケージの全リストが公開されており、5,000クレジットを超える場合はチームにご相談ください。年払いは2か月分が無料になります。クレジットが尽きた場合は、自分で設定した月額上限付きで超過課金を有効にできます(追加1クレジットにつき0.80ドル)。SSOとMFAは月額199ドルからのアドオンで、署名済みBAA付きのHIPAA対応はEnterpriseでご相談により提供されます。無料プランはクレジットカード不要で100クレジットです。
長所
- 本番前に自社の過去チケットでシミュレーションできる点は、ここにある「作る」レーンのどの選択肢にもない空白です。
- 単位がチケット1件なので、請求は先に換算が必要なクレジットではなく、仕事量に連動します。
- 確信度ベースのルーティングとチケットタイプの除外は、サポートリーダーから最もよく聞く懸念への答えです。
- スプリントではなく数分でヘルプデスク上で稼働します。
短所
- HIPAAはEnterpriseプラン(署名済みBAA)の取り決めで、チームと話して設定するもので、セルフサービスの選択肢はありません。小さな医療チームにとっては本物のハードルです。
- 特定の仕事に絞られています。任意のAIアプリケーションを作るのが目的なら、これは違うレーンで、Empromptuのほうが合います。
- 出力が完璧だったかどうかにかかわらず、タスクに対して支払います。クレジット課金のAIツールはどれも同じです。
私の見解: 作ろうとしていたAIアプリがサポートエージェントなら、作らないでください。ある顧客が、私よりうまく言っています。
"We could try to write our own LLM application but we didn't want to invest our time into that. We wanted something that we would not have to maintain."
Karel, GENERAL BYTES, from our case study
用途が文書処理パイプラインや予測ダッシュボードなら見送ってください。どちらもEmpromptu自身の構築可能リストにあり、ヘルプデスクのチームメイトがやることではありません。
2. Gemini Enterprise Agent Platform
向いている用途: 署名済みBAAと実際のコンプライアンスの証跡が必要な、規制対象の構築。
探しに行く前に、まず名称変更に注意してください。以前のVertex AI Agent Builderは現在、Gemini Enterprise Agent Platformにリダイレクトされ、Googleはこれを「an evolution of Vertex AI」と説明しています。Agent EngineはAgent Runtimeに、Vertex AI SearchはAgent Searchになりました。
何をするか。 EmpromptuのEnterpriseプランが示唆するもの全部を、分解してコンポーネントごとに価格を付けたものです。モデル推論、RAG Engine、Vector Search、グラウンディング、評価サービス、ガードレール、マネージドのエージェントランタイム。組み立てるのは自分です。
コンプライアンス、これが選ぶ本当の理由です。 HIPAAのBAAの対象には、Agent Platform、Agent Search、プラットフォーム上の生成AIが明記されています。SOC 2とISO/IEC 27001:2022はどちらも対象範囲に入り、FedRAMP HighはAssured Workloadsを通じて利用できます。VPC Service ControlsとCMEKにも対応していますが、ここで弱いのはRAG Engineで、データ所在地の保証がなく、CMEKはSpannerモードのみです。
料金
| メーター | 料金 |
|---|---|
| Gemini 3.1 Pro Preview | 入力2.00ドル / 出力12.00ドル(100万トークンあたり、コンテキスト200K未満) |
| Gemini 3.7と3.6 Flash | 入力0.75ドル / 出力3.75ドル(100万あたり)、2027年1月1日に1.50ドル / 7.50ドルへ上昇 |
| Google Searchによるグラウンディング | 1,000回のグラウンディングクエリあたり14ドル、月5,000回無料 |
| 自社データによるグラウンディング | 1,000プロンプトあたり2.50ドル |
| Vector Search | 処理データ1GiBあたり3.00ドル、ストリーミング挿入1GiBあたり0.45ドル、さらにノード時間が1時間0.0938ドルから |
| Agent Compute | vCPU時間あたり0.085ドル、月50時間無料 |
| 新規顧客向けクレジット | 300ドル |
長所
- 規制対象の買い手が実際に必要とするコンプライアンスの答えが、BAAとともに書面で得られます。
- シート料金もプラットフォーム料金もありません。純粋な従量課金なので、静かな月は安い月です。
- 厄介なものも含め、すべての料金が公開されています。
- Gemini 3の料金の階段により、退屈な8割のトラフィック向けに安いモデル層が使えます。
短所
- 200Kのコンテキストの崖では、上限を下回るトークンも含めてリクエスト全体が長いコンテキスト向けの料金で再計算されます。
- ヘルプデスクのコネクタがありません。Zendesk、Freshdesk、Gorgias、Frontのいずれもありません。すべての連携は自分で書いて保守するコードです。
- 評価サービスは合成ペルソナをシミュレートするもので、自社の過去チケットではないため、分かるのは想像上の顧客にエージェントがどう対応するかです。
- いくつかのメーターはまだ課金が始まっておらず、今日の請求書は定常状態ではありません。
- Googleは自社のパッケージアプリを「no IT setup」で済むと宣伝しており、これはプラットフォームについてのさりげない自白です。
私の見解: プラットフォームチームとコンプライアンス担当者がいるなら正解で、その両方を省けると期待していたなら不正解です。Vector Searchのコストも急激に伸びます。Google自身の例では、10億ベクトルが月5,910ドルです。検索の半分は簡単なほうだと思い込む前に、サポート向けRAGパイプラインの解説を読んでください。まだGoogle Cloudを使っていないなら、Geminiの代替サービスも検討してください。
3. Glean
向いている用途: 権限をそのまま保ったまま、会社全体の社内ナレッジにAIを展開すること。
何をするか。 275以上のコネクタにまたがるエンタープライズ検索とエージェントで、この一覧で最も強力な権限の仕組みを持っています。その仕組みには「permission mirroring」という名前があります。コネクタがクロール時に各ソースのACLとグループメンバーシップを取り込み、Gleanはクエリ時にサインイン中のユーザーをそのミラーされた権限に照らして評価します。エージェントは作成者ではなく、起動したユーザーのIDで実行されます。
コンプライアンス。 SOC 2 Type 2、ISO 27001:2022、AIマネジメント向けのISO/IEC 42001:2023、HIPAA評価報告書、GDPR、TX-RAMPレベル2。FedRAMPはどこにも主張されていません。TX-RAMPは似て聞こえますが全く別物なので、この点は触れておく価値があります。より軽い選択肢との比較は、ナレッジ検索ツールのまとめをご覧ください。
料金
| 項目 | 公開されている内容 |
|---|---|
| プラン料金 | なし。glean.com/pricingは現在トップページへ301リダイレクト |
| 課金単位 | ユーザーあたり月額のEnterprise Flex Seatsと、共有のFlexCredits |
| FlexCreditのドル単価 | 非公開 |
| Fast Modeのクエリ | 無制限 |
| Thinking Mode、標準モデル | ユーザーあたり週100回まで含まれ、以降は従量 |
| Glean Agent Run | 中央値で約7 FlexCredits、p90で約114 |
| Deep Research | 中央値で約33、p90で約144 |
| プラットフォーム料金 | 年額のサイト全体料金が2つ: Glean Protect+とPremium Support |
長所
- permission mirroringは本物で、後付けのフィルターではありません。
- 275以上のコネクタがあるので、連携作業はすでに済んでいます。
- Gleanは自社の導入スケジュールとして約1〜3週間を公開しており、珍しく率直です。
- エージェントの作成、テスト、共有は課金されません。課金されるのは実行だけです。
短所
- 料金ページがなくなりました。ドルの数字はすべて営業とのやり取りから出てきます。
- FlexCreditsは、価格のない単位で表された完全な料金表なので、操作同士は比較できても、お金とは比較できません。
- シートは「designed to be deployed to every employee」とされており、下限が高くなります。
- シートに加えて、年額のサイト全体のプラットフォーム料金が2つ別にあります。
私の見解: 問題が全社的なナレッジアクセスで、それに見合う調達プロセスがあるなら、正しい買い物です。問題がサポートキュー1つなら、これは重い道具で、どこに落ち着くかはGleanの料金の内訳とGleanのレビューで詳しく見られます。また、Agent Runのp90は中央値の16倍なので、パイロットでは安く見えるワークロードも、本番では大きく違う請求になりえます。
4. Arize AX
向いている用途: すでに自分で作って動かしているAIアプリケーションの測定。
Empromptuの創業者はHacker Newsでこれを名指しし、「require dedicated teams most startups don't have」なツールに分類しました。半分は当たっています。Arizeの無料プランとオープンソースのPhoenixプロジェクトにより、本格的な評価が1人のエンジニアの手の届く範囲に入りました。もう半分は妥当で、これは作るのではなく測るものだからです。
何をするか。 LLMアプリ向けのトレーシング、評価、オブザーバビリティ。LLM-as-a-judgeの評価器、カスタム評価、そしてデータセットと実験を、オンラインでもオフラインでも。PhoenixはELv2のもとにあるオープンソースのコアで、ローカル、Docker、Kubernetesでセルフホストできます。
料金
| プラン | 料金 | 含まれるもの | 保持期間 | デプロイ |
|---|---|---|---|---|
| AX Free | 0ドル | 月25kのトレーススパン、1GBの取り込み | 15日 | SaaS |
| AX Pro | 月額50ドル | 月50kのトレーススパン、10GBの取り込み | 30日 | SaaS |
| AX Enterprise | 個別見積り | 個別見積り | 個別見積り | SaaSまたはセルフホスト |
| Phoenix (OSS) | 無料、ELv2 | メーターなし | 自分で決める | 自社インフラ |
長所
- ユーザー、評価、実験、アノテーションキューは、どのプランでも無制限です。メーターは人ではなくスパンです。
- Phoenixは本格的なオープンソースプロジェクトで、セルフホストすれば機密性のあるトレースを自社インフラに置いておけます。
- 自社データセットに対するオフライン評価は、「測る」レーンが本番前のテストに最も近づける方法です。
- データリージョンの選択は全プランで同じで、アップセルにはなっていません。
短所
- 超過料金はどこにも公開されていません。ページには「included 25k/month」とあって、そこで終わります。
- HIPAA、SSO、監査ログ、カスタムコード評価器、セルフホストはいずれもEnterprise限定です。
- SOC 2 Type IIとGDPRはFreeではなくProから始まります。
- Arize自身の表がSignalについて矛盾しています。Core Platformの行はFreeとProに枠を与えているのに、Observabilityのセクションは障害モードの検出をEnterprise限定としています。
- あなたのアプリを作ることも動かすこともありません。ドキュメントは前提条件をはっきり述べています。まずデータが流れ込み、LLMプロバイダーが設定されている必要があります。
私の見解: アプリがすでにあり、足りないのはそれについての正直な数字だというときの正しい選択です。ビルダーの代わりではなく補完として扱ってください。より広いLLMトラッキングツールの一覧や、LLM最適化のチューニングループと合わせて検討してください。公開すべきかどうかは教えてくれません。公開した後に何が起きたかだけです。
5. Langfuse
向いている用途: 評価レイヤーが欲しく、それが動く環境を自分で所有したいチーム。
何をするか。 トレーシング、プロンプト管理、データセット、実験、アノテーションキュー、LLM-as-a-judgeによるスコアリング。境界についてドキュメントは気持ちよいほど文字通りで、タスクとは「the application code that you want to test」です。Langfuseの内部で実行されるのは、プレイグラウンドとプロンプト実験、そしてジャッジの呼び出しだけです。
セルフホストが目玉です。 Langfuse OSSはMITライセンスで、使用量無制限で無料、クラウドと同じインフラで動き、スケーラビリティの制限もありません。9つのガバナンス機能にはエンタープライズのライセンスキーが必要です。プロジェクト単位のRBAC、保護されたプロンプトラベル、保持ポリシー、監査ログ、サーバー側のデータマスキング、UIのカスタマイズ、組織の作成者、SCIM付きの組織管理API、インスタンス管理APIです。すべてを自社のVPC内に置きたい規制対象のチームにとって、これは一覧の中で最もすっきりした答えです。
料金
| プラン | 料金 | 含まれるユニット | 超過料金 | ユーザー | データアクセス |
|---|---|---|---|---|---|
| Hobby | 無料、カード不要 | 月50k | なし | 2 | 30日 |
| Core | 月額29ドル | 月100k | 100kあたり8ドル | 無制限 | 90日 |
| Pro | 月額199ドル | 月100k | 100kあたり8ドル | 無制限 | 3年 |
| Teamsアドオン | 月額+300ドル | アドオン | - | - | - |
| Enterprise | 月額2,499ドル、年間契約 | 月100k | 100kあたり8ドル | 無制限 | 3年 |
1ユニットは、トレース、オブザベーション、スコアのいずれか1つです。段階的な超過料金は、1Mまで100kあたり8ドルで、その後は量が増えるにつれて7ドル、6.50ドル、6ドルになります。
長所
- 使用量の上限がないMITのセルフホストは、珍しく、とても太っ腹です。
- 超過料金が公開されており、段階的で、モデル化しやすいです。
- 有料プランはすべてユーザー無制限です。
- フレームワークに依存しないので、作ったものを置き換えるのではなく、その隣に置けます。
短所
- 有料プランはすべて同じ100kユニットと同じ8ドルの超過料金を含みます。29ドルから199ドル、2,499ドルへの階段で買えるのは、保持期間、レート制限、セキュリティ、サポートであって、量ではありません。
- 自前の評価も課金対象です。ジャッジのスコア、アノテーションキュー、実験はすべてユニットに数えられます。
- HIPAAはPro以上の「HIPAA-ready region」で、これはデプロイの選択肢であって認証ではありません。
- Cloud ProでのOkta SSOとプロジェクト単位のRBACには月額300ドルのTeamsアドオンが必要なので、Oktaが必要なProチームは実質月額499ドルです。
- セルフホストのEnterprise料金は、Langfuse自身の説明によれば、ClickHouseのプランに上乗せされます。
私の見解: 「測る」レーンでの私の標準的な推奨で、その大きな理由はライセンスです。Empromptuで魅力的だったのがオンプレミスのデプロイと自社ツールの所有なら、Langfuseはその半分を完全に満たし、試すのにお金もかかりません。もう半分、つまりアプリ本体は、やはり自分で書く必要があります。たいていその隙間に何が入るかは、LangChainとLangGraphの比較で扱っています。
6. Lovable
向いている用途: 今日の午後のうちに、動くプロトタイプを誰かの目の前に出すこと。
Empromptu自身の比較ページは、「vibe coding tools get you to demo. They don't get you to production.」と主張しています。精度という点に限れば、Lovableが実際に提供するものへの妥当な読み方です。
何をするか。 チャットでアプリを説明すると、ホスティング、認証、データベース付きの動くフルスタックのアプリケーションが返ってきます。GitHubとGitLabへのGit同期は無料プランを含む全プランに付き、コードは書面上あなたのものです。
評価について、正確に。 どのプランにも、評価の仕組み、ゴールデンデータセット、精度指標、シミュレーションはありません。提供されるのはソフトウェアテスト(ブラウザテスト、Vitest、edge functionのテスト)とセキュリティスキャンで、評価と取り違えやすいものです。測っているのはアプリが動くかどうかで、AIが正しいかどうかではありません。RAGもここでは構築対象で、埋め込みモデルが提供されるので検索は自分で作ることになり、マネージドの取り込みや検索品質のレポートはありません。
料金
| プラン | 料金 | クレジット | 備考 |
|---|---|---|---|
| Free | 0ドル | 1日5つの構築クレジット、月30まで | コードのダウンロード不可、独自ドメイン不可 |
| Pro | 月額25ドル | 月100 | コードの編集とダウンロードが解禁 |
| Business | 月額50ドル | 月100 | Proと同じクレジット、SSO、RBAC、セキュリティセンターを追加 |
| Enterprise | プラットフォーム料金と量に応じた料金、見積り制 | 量に応じる | 1日の構築クレジットなし |
超過料金は公開されています。Proでは1クレジットあたり0.30ドル、Businessでは0.60ドルです。プランのクレジットは2か月で失効し、追加購入分は12か月で失効します。どちらの階段も10,000クレジットまであり、Proは月額2,250ドル、Businessは月額4,300ドルです。
長所
- アイデアからクリックできるものまでの最速の道です。
- 両方のプランで超過料金が公開されており、ここでは誰もができていることではありません。
- SOC 2 Type II、ISO 27001:2022、DPA付きのGDPR。
- 全プランでメンバー無制限、無料プランでもGit同期があります。
短所
- HIPAAは明確に対象外です。エンタープライズ向けドキュメントは、LovableがBAAを締結せず、HIPAAに準拠していないと述べており、Empromptuの中核である医療の買い手には使えません。
- VPC、シングルテナント、セルフホストの選択肢がありません。論理分離とリージョン固定のあるマルチテナントです。
- BusinessはProのちょうど2倍の価格で、クレジットは同じなので、ガバナンス機能に対して支払うことになります。
- 追加購入には、サブスクリプションから導かれるクレジット単価に対して約20%の割増があります。
私の見解: デモに使って、本番を誰が持つかは別に決めてください。より詳しくはLovableのレビューに、この形は魅力的でもコンプライアンスの答えが合わないなら、Emergentが最も近い仲間です。
7. Replit
向いている用途: 構築、ホスティング、実行をひとつの場所で行うこと。
何をするか。 コードを書き、実行し、デプロイするエージェント付きの、完全なクラウド開発環境。Zipダウンロード、双方向のGitHub同期、シェルアクセスにより、コードの所有は現実のものになりますが、ひとつ注意点があります。Enterpriseの管理者には「Ban source code export」のスイッチがあります。
評価について。 Replit自身の全ドキュメント索引、全412件を検索しましたが、「eval」のヒットはゼロで、精度、RAG、検索、埋め込み、正解データ、ベンチマーク、ハルシネーションに関するページもありません。評価のように見えて評価ではない機能が3つあります。App Testingは実際のブラウザを操作しますが、確認しているのはアプリが動くかどうかです。組み込みのコードレビューはコード品質を、セキュリティスキャンは脆弱性の状況を確認します。
料金
| プラン | 料金 | 単位 | 含まれるもの | 超過 |
|---|---|---|---|---|
| Starter | 無料 | 1日のエージェントクレジット | 量は非公開 | Liteビルド、アプリ1つ、30日で失効 |
| Core | 月額20ドル、年払い18ドル | 作業量ベースのチェックポイント | "$20 towards most powerful models" | クレジットパック |
| Pro | 月額100ドル、年払い90ドル | 作業量ベースのチェックポイント | "$100 towards most powerful models" | クレジットパック、2か月繰り越し |
| Proの上位プラン | 215ドル / 425ドル / 825ドル / 2,000ドル | 同じ | 価格帯ごとのクレジット量は記載なし | 同じ |
| Enterprise | 個別見積り | シートと使用量 | 非公開 | SSO/SAML、シングルテナント、固定IP |
超過の手段はクレジットパックだけです。100ドルで100ドル分、300ドルで290ドル分、500ドルで480ドル分、1,000ドルで950ドル分。有効期限は6か月です。
長所
- 構築、テスト、ホスティング、デプロイがひとつの環境でできます。
- ZipダウンロードとGitHub同期による、本物のコード可搬性があります。
- モデル費用は、上乗せなしでプロバイダーの公開APIレートのまま通されます。
- SOC 2 Type IIはReplit自身のもので、継承したものではありません。
短所
- メーターは「作業量」で、作業量には公開された料金がありません。Replitのドキュメントは、料金表の代わりに見積もりアプリへのリンクを載せています。
- HIPAAは、ドキュメント、セキュリティホワイトペーパー、トラストセンターのすべてで全く見当たりません。
- コンプライアンス一覧にあるISO 27001はGoogle Cloudのもので、Replit自身のものではなくインフラの保証として記載されています。
- ドキュメントはエージェントモード名で矛盾しており、あるページではFree/Power/Max、別のページではLite/Economy/Powerとなっています。
- シングルテナントとSSOは、見積り制のEnterprise限定です。
私の見解: 3つのプロトタイプビルダーの中で構築とホスティングの話が最も強く、請求額を予測するのが最も難しいものでもあります。何かが始まる前に予算を承認しなければならない規制対象のプロジェクトでは、見積もれないメーターは本物の問題です。より深く読むには、Replitの料金の内訳とReplitのレビューがあります。
8. Bolt
向いている用途: コードの所有がはっきりした、可能な限り安い最初のたたき台。
何をするか。 StackBlitzによる、ブラウザ上でのプロンプトからアプリの構築で、双方向のGitHub同期、リポジトリのインポート、プラットフォーム外へのデプロイがあります。所有についてははっきり述べられています。作成したコードはすべてあなた自身のコードです。SupabaseとNetlifyもBolt Cloudの代替として文書化されているので、ロックインの継ぎ目はコードではなくインフラにあります。
評価について。 ありません。ドキュメントの完全な索引を読みましたが、評価やテストに関するページも、精度の採点、ベンチマーク、RAGに関するページもありません。測定に似た機能は、作ったアプリのセキュリティ監査が唯一で、出力が間違っていた場合のセーフティネットはバージョン履歴へのロールバックです。
料金
| プラン | 料金 | トークン | 備考 |
|---|---|---|---|
| Free | 0ドル | 1日300Kと月1M | 上限に達するとサイトがオフラインに、サポートはDiscordのみ |
| Pro | 月額25ドル、年額216ドル | 月10M | 日次の上限なし、独自ドメイン |
| Pro 50 | 月額50ドル、年額540ドル | 月26M | |
| Pro 100 | 月額100ドル | 月55M | |
| Pro 200 | 月額200ドル | 非公開 | 請求ドキュメントの例で確認 |
| Teams | メンバーあたり月額30ドル | プランごと、シートごとで、共有はされない | 自社のデザインシステムに必須 |
| Enterprise | 見積り制 | - | SSO、監査ログ、AWSまたはAzureの持ち込み |
長所
- 「作る」レーンで最も安い実用的な入口で、使える無料プランがあります。
- コードの所有と可搬性が明確に述べられ、双方向同期に裏付けられています。
- Enterpriseは自社のAWSまたはAzureの持ち込みに対応しており、データ管理の面で重要です。
- Lovableから始めた場合のための、文書化されたインポート経路があります。
短所
- メーターはモデルのトークンで、Bolt自身のFAQは、使用量の大半はプロジェクトのファイルシステムをAIと同期することから来ると述べているので、コードベースが大きくなるほどコストが上がります。
- プランのトークンは2か月で失効し、支払いを続けている間しか残りません。解約すると、繰り越しトークンはサイクルの終わりに消えます。
- 追加購入の単価は非公開で、ログイン後にしか見えません。
- HIPAAとFedRAMPは認証ではなく「ready」と表現されており、実際のコンプライアンスの主張があるのはSOC 2 Type 2だけです。GDPRは製品ドキュメントのどこにも出てきません。
- 年払いの割引がページ間で矛盾しており、料金ページでは「up to 28%」、請求ドキュメントでは10%です。
私の見解: アイデアが作る価値があるかを確かめる最も安い方法で、その後それを支えるには最も向いていません。親会社を調べているなら、StackBlitzの料金とStackBlitzの代替サービスのページがその面をカバーしています。
測定された精度の数字とは実際にどういうものか
私は稼働中のサポートキューの近くで十分な時間を過ごし、自信ありげなボットこそ危険だと知っています。だからeeselの導入はどれも、顧客に触れる前に、まず過去のチケットに対してシミュレーションを行います。
そのうちのひとつから出た結果を紹介します。ZendeskとShopifyで月に約1,000件のチケットをさばくドイツのオンラインジュエリー小売業者の例です。実際のチャット284件と、100件のチケットでの交差検証で、レポートはこう示しました。トリアージ精度93%、受信箱の22%がスパムだった状態で誤検知ゼロのスパム検出100%、下書きの方向性の正確さ88%、事実誤りの割合7%。カテゴリ別では、下書きの有用性は返品・返金で93.8%、保証請求で96.4%、製品に関する問い合わせで100%でした。
これが「98%」とどう違うかを見てください。データセットが名指しされています。量もです。そして、成功と同じ息遣いで失敗も公表されています。誤り率が付いていない測定は、マーケティング用の数字だからです。
これが、eeselを含め、この一覧のすべてのベンダーに私が求める基準です。データセットを求め、そして自社のデータで再実行することを求めてください。
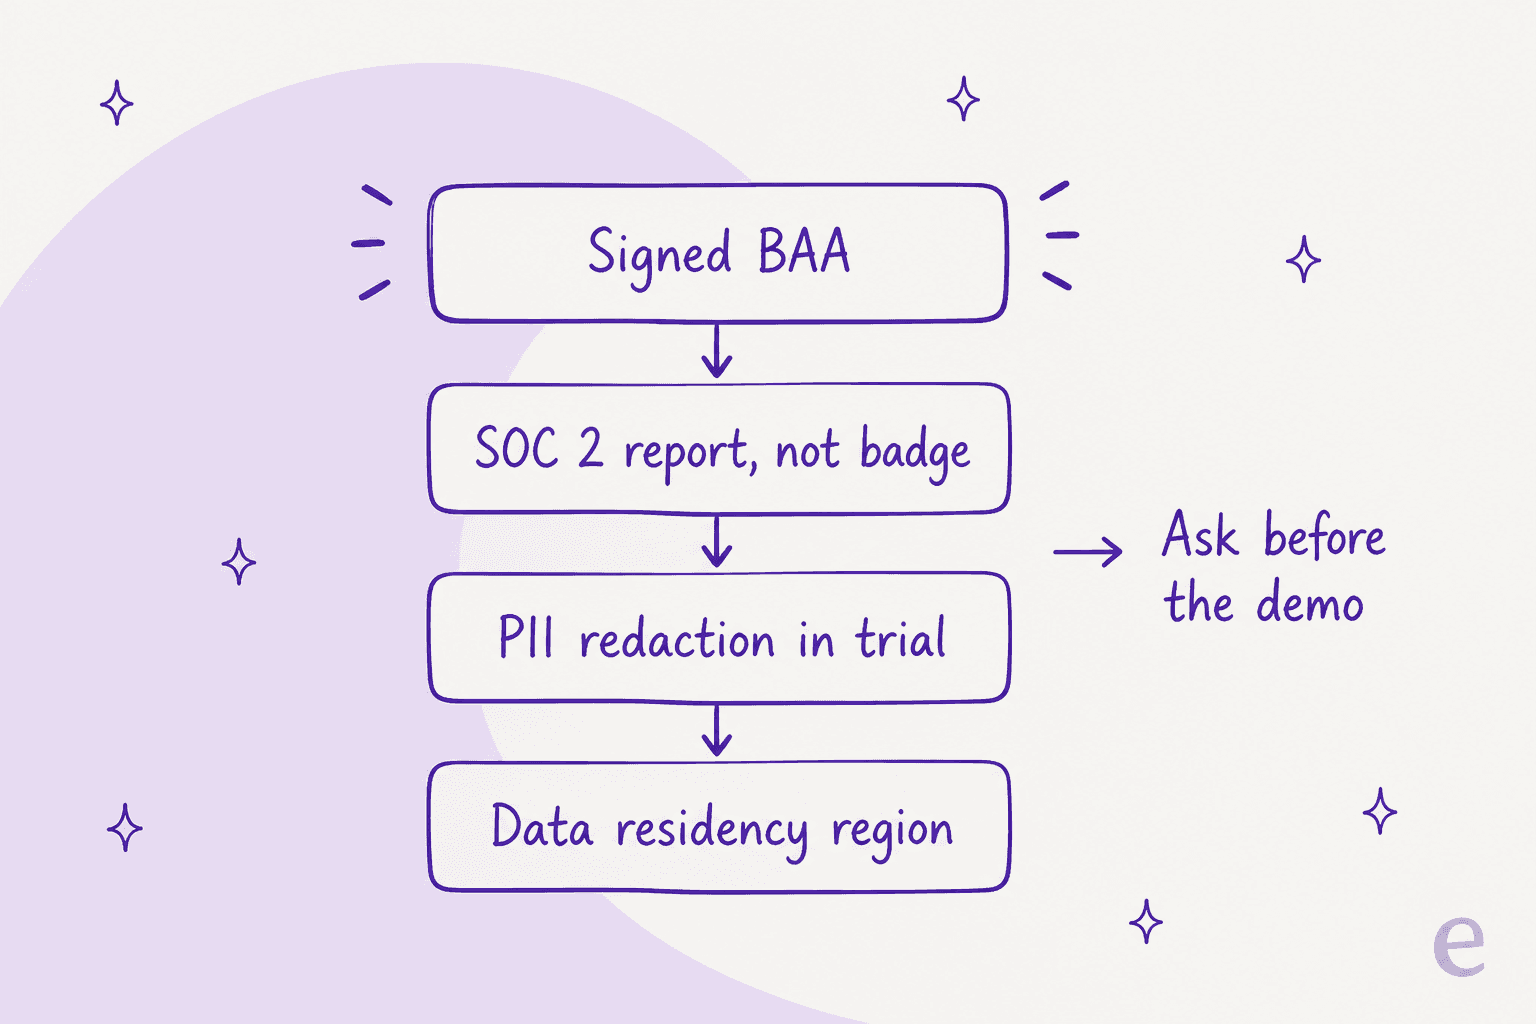
そして、買う側が規制対象のチームなら、上の4つの関門はデモの後ではなく前に確認してください。eeselはその4つすべてで案件を失ってきました。Zendeskを使う米国の医療プラットフォームは、通話の最中にHIPAAとBAAを理由に断固として止まりました。Freshdeskのポッドキャストプラットフォームは、SOC 2がなければ先へ進めませんでした。週に約1,000件のチケットを扱うメディア企業は、トライアルでのPII墨消しを最大の懸念事項としました。これらの会話は、最終的にどのベンダーを選ぶにせよ、6週目よりも1週目のほうがずっと安く済みます。事前に送っておくべき質問は、HIPAA準拠のAIとHIPAA準拠のプラットフォームの私のメモに列挙しています。
eeselを試す
ロードマップにあるAIアプリケーションがサポートエージェントなら、最速の道は作らないことです。eeselのAIヘルプデスクのチームメイトは、すでに使っているヘルプデスクにつながり、ヘルプセンターと過去のチケットから学び、エージェントがすでにいるキューの中で下書きや解決を始めます。プランは月額299ドルから500クレジット(対応チケット1件につき1クレジット)で、プラットフォーム料金もシート料金もなく、開始用にクレジットカード不要の100クレジットの無料プランもあります。
上記すべてに関わる部分はこうです。先に自社の過去チケットでシミュレーションし、顧客が見る前に予測を確認できます。確信度のしきい値とチケットタイプの除外が、何に手を付けてよいかを決めるので、導入は一括の切り替えではなく、設計上、段階的になります。

何かにコミットする前に、自社のチケットでの予測を見たいですか。eeselを無料で試すか、レポートで何を見ればよいかが分かるように、eeselがAIサポートのROIをどう測るかをお読みください。
よくある質問
2026年のEmpromptuのおすすめ代替サービスは?
Empromptuの料金はいくらですか?
EmpromptuはHIPAAに準拠していますか?
/securityも/trustも404を返します。規制対象の導入では、デモの前に署名済みBAAと実際のSOC 2報告書を求めてください。何を確認すべきかは、HIPAA準拠のAIとサポートチャットボットのSOC 2の記事にまとめています。