2026年版 Laya AIの代替ベスト8

Rama Adi

Katelin Teen
最終更新 September 21, 2026
なぜLaya AIの代替を探すのか
私は仕事でインテグレーションとAPIを作っているので、Layaには思い入れがあります。設計は誠実なエンジニアリングです。巨大な自己回帰モデルに「JSONだけで返して」と頼んで祈る代わりに、Layaは双方向エンコーダーで状態を処理し、型付きの質問を1回のフォワードパスで評価して、較正された確率を返します。トークン生成がないので、フィールドの捏造も壊れたJSONも、構造上起こりません。Apache 2.0で、セルフホストなら100万トークンあたり0.00ドルで動き、TypeSafeのクローズドなJevに対するオープンな答えとして位置づけられています。
問題は、Laya自身の制限事項のセクションから始まります。Hacker Newsのスレッドもすぐここに食いつきました。そのままの基本モデルは、型付き判断ベンチマークで約0.35、ランダム基準の0.318をわずかに上回る程度です。印象的な0.766という数字は、ベンチマークの学習分割でファインチューニングした後にしか出ません。これは大きな注釈で、スレッドの実務者たちもはっきり指摘しました。
"Idk, your limitations section sure makes it seem less drop in and less general than Jev. Like the point here isn't your ML aptitude it's how easy is it for developers to drop this into a product and use it. I'm more than capable of training a bert classifier... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores."

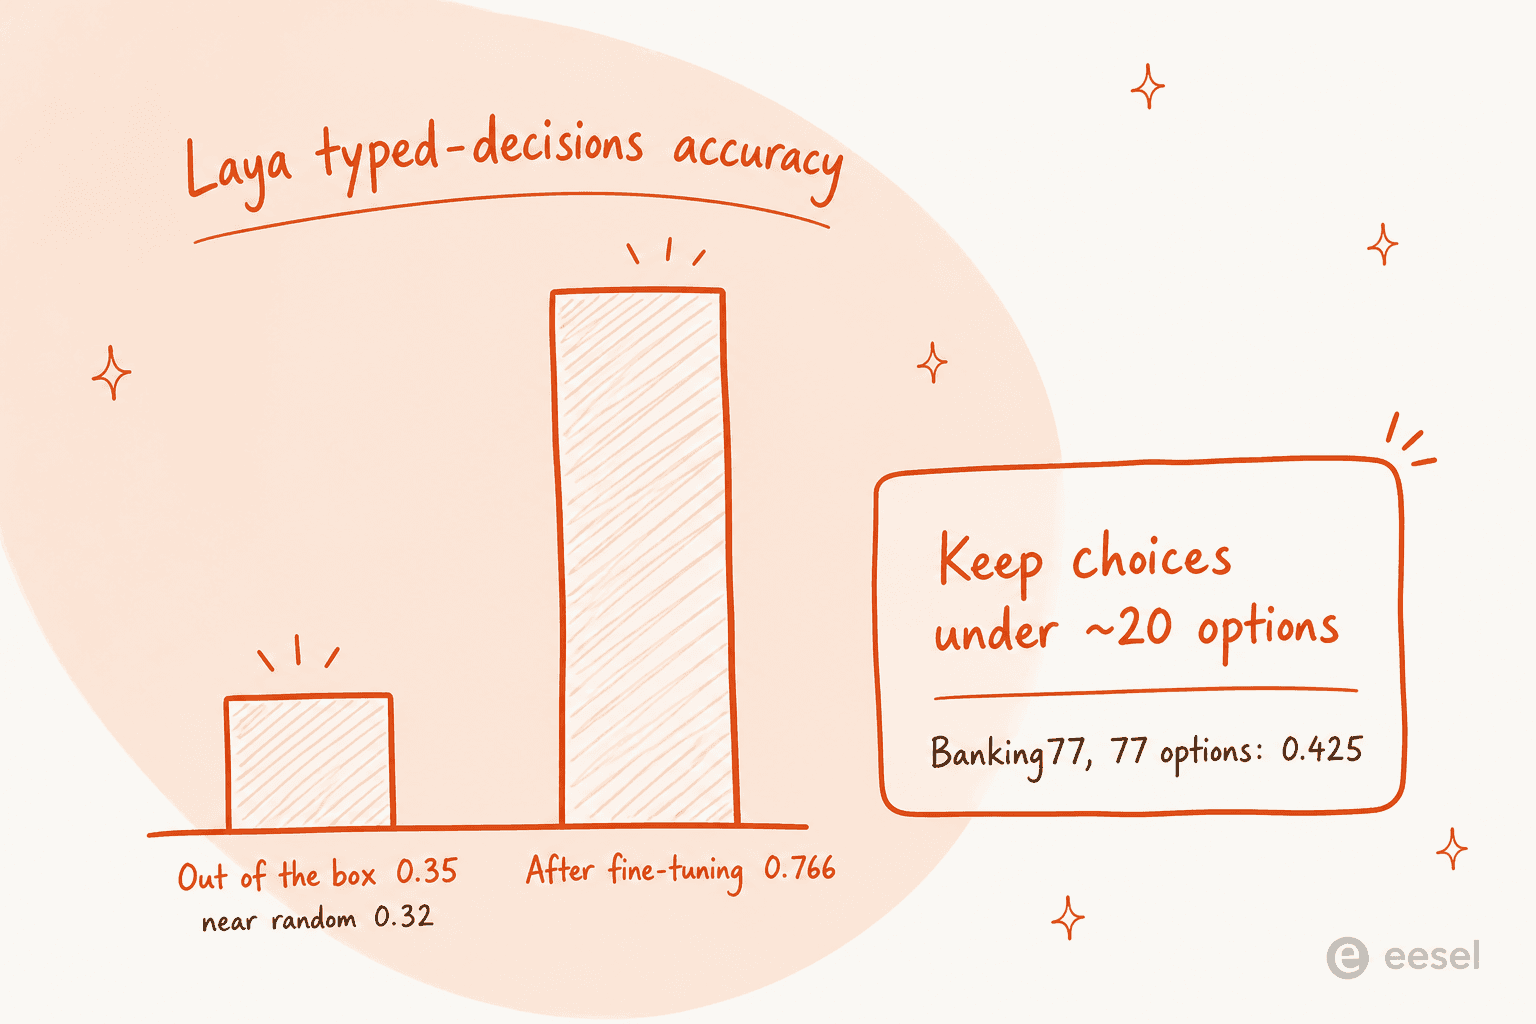
決める前に知っておきたい2つ目の上限もあります。Layaの選択式の質問は約20択を超えると精度が落ちます。候補ラベルが固定のトークン予算を分け合うためです。77ラベルの意図データセットBanking77では、Layaは0.425、Jevは0.870でした。実際のルーティング問題には20を超える振り分け先があるものも多く、誰にとっても例外的なケースとは言えません。
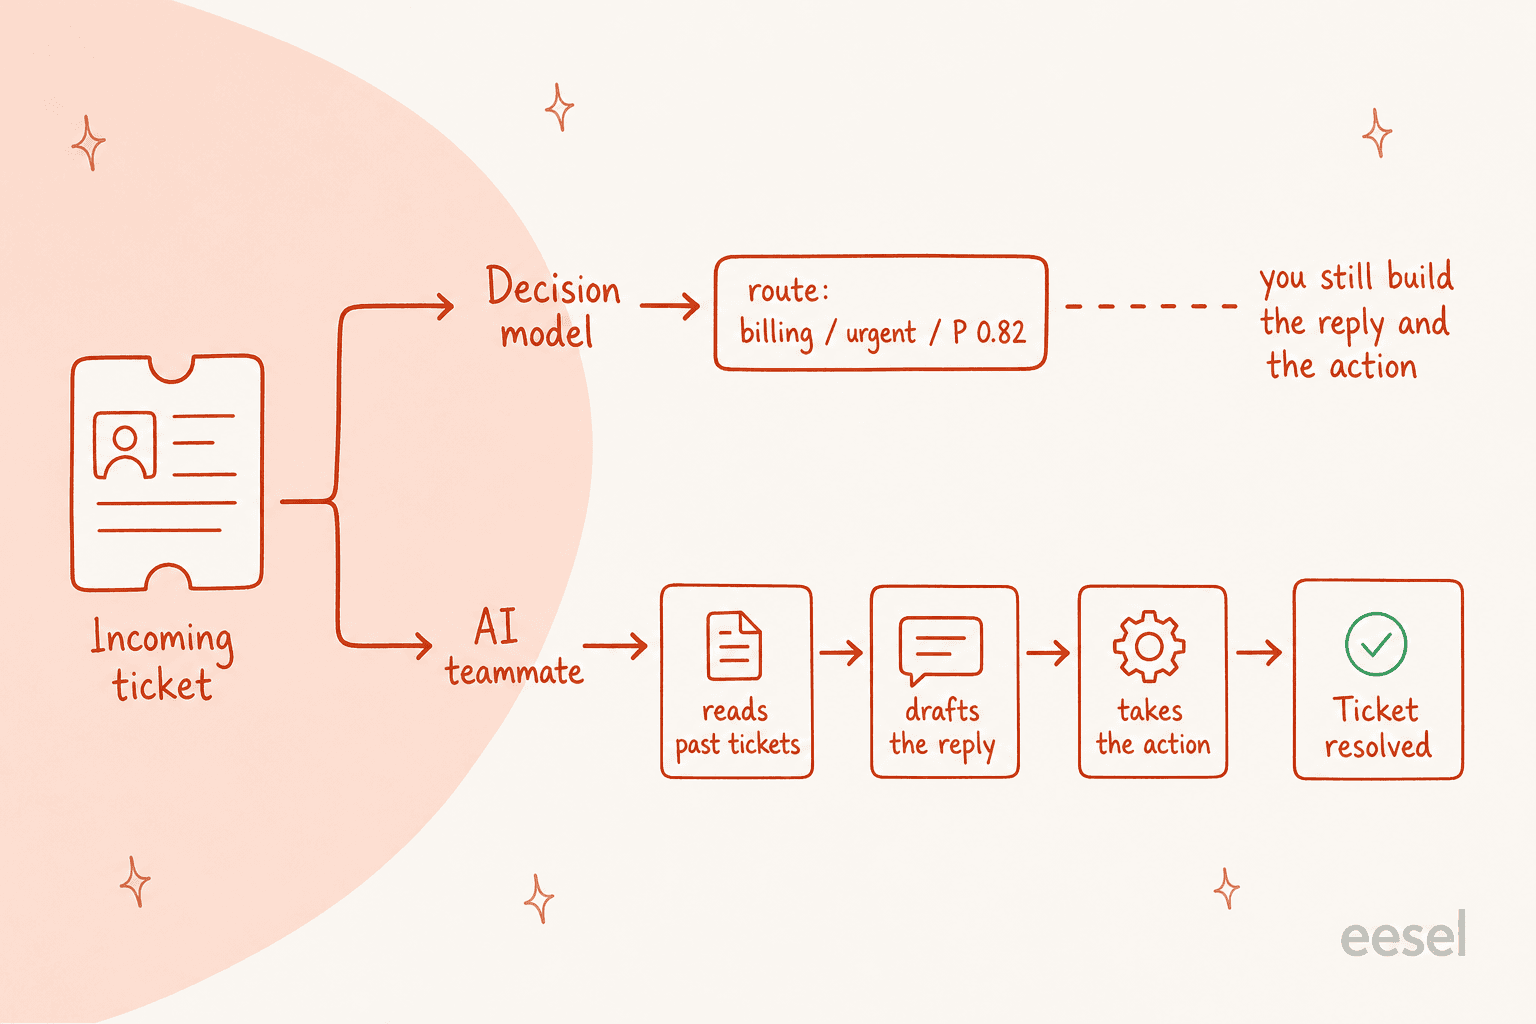
そして、私が最も重視するフレーミングの話です。最良の状態でも、Layaは質問に答えるだけです。*このチケットは請求関連で緊急、P(0.82)*と教えてくれます。返信を書くことも、注文を返金することも、人間にエスカレーションすることもしません。周辺のプロダクトを自分で作るなら問題ありませんが、成果を買うつもりだったなら致命的です。あるコメント投稿者は、このカテゴリ全体の魅力をうまく言い表していました。
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
以下の代替案は、どれもこの緊張関係を別の形で解いています。どこまで自分で運用したいのか、そして判断が欲しいのか、解決が欲しいのかです。
代替案の選び方
各選択肢を5つの観点で評価しました。
- 実際に何をするか - 純粋な分類器、型付き判断API、出力制約ライブラリ、あるいは行動する完全なチームメイト。
- セルフホストかマネージドか - 重みを自分で動かすのか、エンドポイントを呼ぶのか。
- 信頼性の話 - 自動で行動できるほどスコアを信頼できるのか、それともブラックボックスか。Layaの売りは較正なので、代替案にも同じ基準を当てます。
- 実コスト - ライセンス、呼び出し単価、そして見積もりに載らないエンジニアリング時間。
- 多言語対応 - Layaは100以上の言語をカバーするため、グローバルなサポートチームは何を手放すことになるかを知る必要があります。
各ツールに入る前に、全体像を1枚の図で見てみましょう。
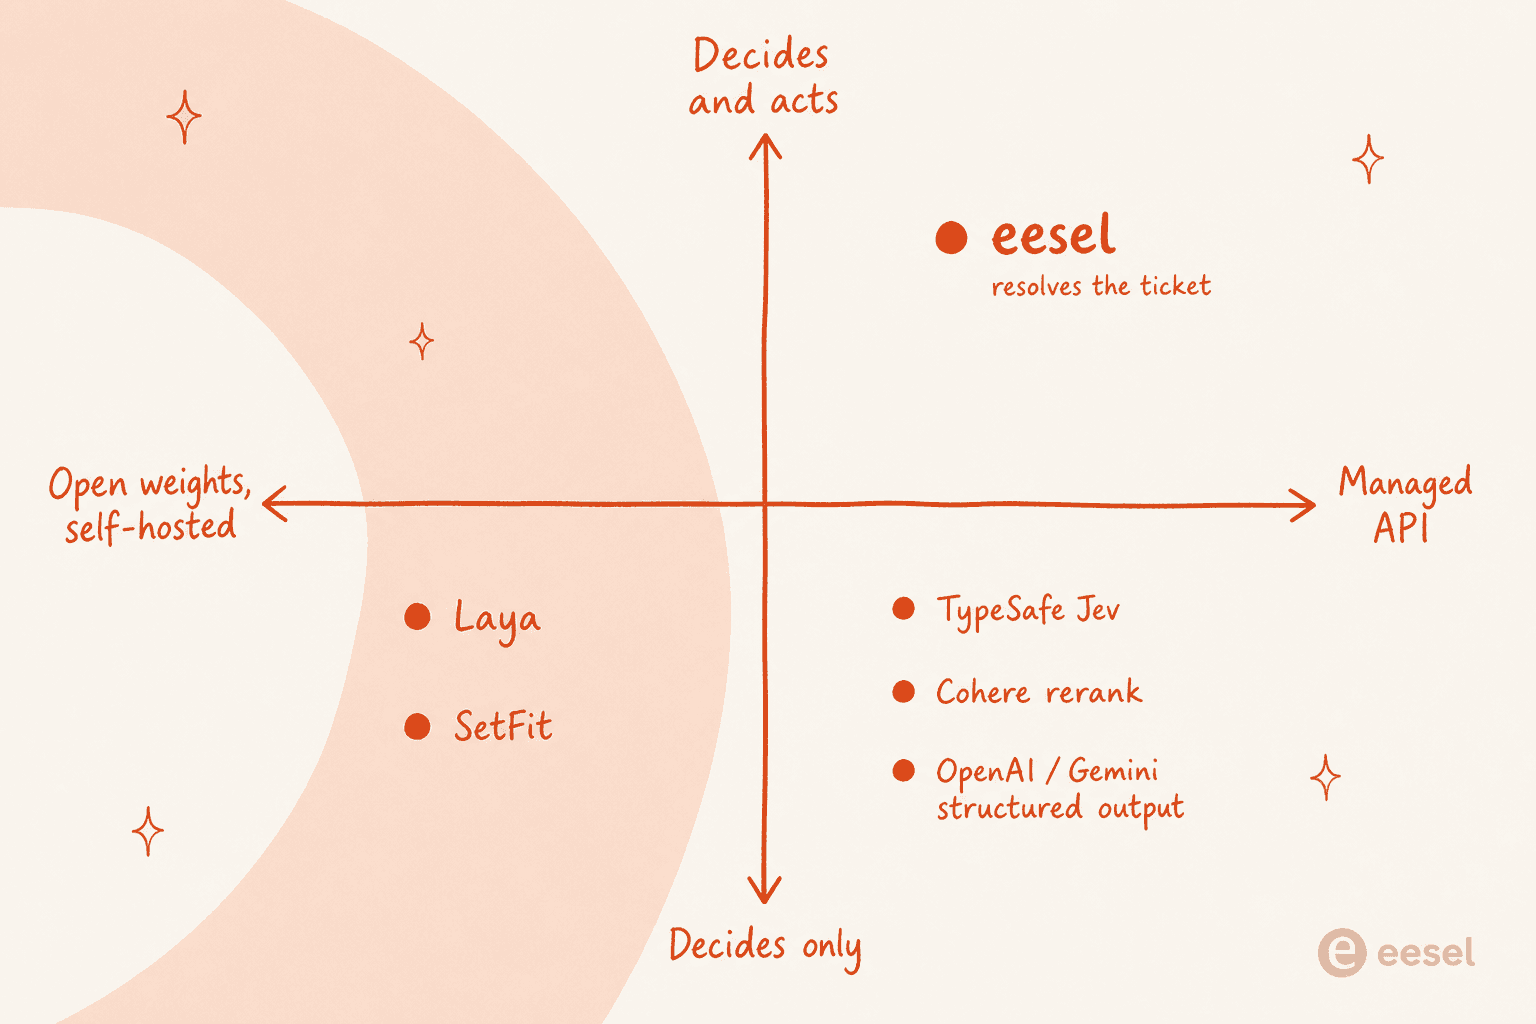
Laya AIの代替案を一覧で比較
| ツール | 最適な用途 | タイプ | セルフホスト | 判断か行動か | 課金単位 | 開始価格 |
|---|---|---|---|---|---|---|
| eesel | サポートチケットを実際に解決する | AIチームメイト | マネージド | 判断して行動する | 月299ドルからのクレジットプラン | 無料プラン(100クレジット) |
| TypeSafe Jev | Layaのマネージド版の双子 | 判断API | マネージド | 判断する | 100万トークンあたり | 入力100万あたり0.042ドル、出力無料 |
| SetFit | 自前で持つ少数ショット分類 | OSS分類器 | 可 | 判断する | なし(計算資源) | 0ドル(Apache 2.0) |
| Cohere | RAGの関連度 + 分類 | マネージドAPI | VPC / オンプレの選択肢あり | 判断する | 検索あたり / 100万あたり | 約2.00ドル / 1,000検索 |
| OpenAI Structured Outputs | すでにGPTを使っているチーム | LLMの機能 | マネージド | 判断する | 100万トークンあたり | モデル料金への上乗せなし |
| Google Gemini | 最安のマネージド構造化分類 | LLMの機能 | マネージド | 判断する | 100万トークンあたり | Flash-Liteが最安 |
| Outlines / Instructor | 自前のLLMにスキーマの安全性を | OSSライブラリ | 可 | 判断する | なし(計算資源) | 0ドル(Apache-2 / MIT) |
| Cloudflare Workers AI | エッジ推論(Jev含む) | マネージドカタログ | マネージド | 判断する | Neurons | 無料枠あり、その後従量課金 |
1. eesel
最適な用途: 判断は第一歩にすぎず、本当に必要なのはサポートチケットの解決だと気づいたチーム。
最初に正直に言っておきます。私が執筆に使っているブログスキルがそう求めているからです。eeselは判断モデルではありません。自社パイプラインに組み込める33msの型付き分類プリミティブがどうしても必要なら、以下のツールの方が文字どおりの置き換えとしては適しています。ただ、サポート用途でLayaを検討する人の多くは、ラベルが欲しいのではなく、そのラベルが導くはずだった成果が欲しいのです。eeselが埋めるのはそのギャップです。

eeselはAIチームメイトのプラットフォームです。特定の仕事にすぐ使えるチームメイトを採用する形で、現在のメンバーはAIヘルプデスクのチームメイトとAIブログライターです。ヘルプデスクのチームメイトは、判断モデルにできない一連の流れをすべてこなします。過去数年分のチケットとヘルプセンターを読み、返信を下書きし、操作を実行し、自信がないときは振り分けやエスカレーションを行います。ルーティングはその機能の1つで、製品の全体ではありません。
実際のサポートキューでAIを運用してきた私たちの経験が、この比較で生きてくるのがここです。Laya自身のデータには、立ち止まる価値のある数字があります。多言語テストで、英語モデルはクメール語で精度0.000だったのに、平均信頼度は0.952と報告していました。モデルは自信満々に、しかも較正されたまま間違えることがあります。私たちは、ボットが自信たっぷりに完全な誤答をするのを見て痛い目に遭いながらそれを学びました。だからこそ、eeselのすべての展開は、実際の会話に触れる前に過去のチケットでシミュレーションされます。ベンチマークの数字ではなく、自社データでの本当の自動解決率を先に確認できます。
Layaのプログラム可能性が気に入っていた開発者のために、eeselは同じチームメイトをeesel CLIとMCPで公開しています。ターミナルやスクリプトから、インストール、ナレッジソースの接続、指示の設定、シミュレーションの実行、アクティビティの確認ができます。Claude Code、Codex、Cursorなどのコーディングエージェントも同じように操作できます。非技術者のサポートリーダーがダッシュボードで設定するのと同じチームメイトを、コードとして運用するだけです。
長所:
- 判断して解決まで行う。Zendesk、Freshdesk、Slack、メールなど100以上のツールに対応。
- 公開前に実際のチケット履歴でシミュレーションするので、信頼性が自社データに裏づけられる。
- 平易な言葉でコーチングでき、プログラマー向けにCLIとMCPも完備。
短所:
- 生の分類プリミティブではない。自社スタックで単発のモデル呼び出しが本当に必要なら、形が合わない。
- マネージドのチームメイトであり、エアギャップ環境で動かせる重みではない。
料金: 無料で開始でき、その後は500クレジット(チケットまたはチャット1件につき1クレジット)で月299ドルからの固定月額です。推測したトークンごとではなく、処理したチケットに対して支払います。
結論: ルーティングの判断が最初からサポートキューを解決するためのものなら、プリミティブは飛ばしてチームメイトを採用しましょう。単独の分類器が本当に必要なら、読み進めてください。
2. TypeSafe Jev
最適な用途: まさにLayaと同じ用途を、ファインチューニングもホスティングも不要なマネージドで。
JevはLayaが対抗して作られたモデルなので、リスト中で最も自然な代替案です。Diogo Almeida(OpenAIでRLHFを共同発明)が創業したTypeSafeは、これを初の公開「System 1モデル」と呼んでいます。非構造化の状態と型付きの質問を送ると、1回の並列パスで型付きの確率的判断を返します。Layaが借用したのと同じ3つのプリミティブ、noul、choice、scoreを備えています。
Layaとのトレードオフははっきりしています。Jevはクローズドで従量課金ですが、学習ステップなしで本当にそのまま使えます。Hacker Newsの人たちがLayaに欠けていると言い続けた点です。Layaのベンチマークは、Jevより7.8倍高速で、較正も優れていると主張しますが、それはLayaの環境でのLayaの数字で、Jevが求めないファインチューニングをした後でしか成り立ちません。77クラスのタスクでは、忘れずに言うと、JevはLayaに0.870対0.425で勝っています。
長所:
- 重みもGPUもファインチューニングも不要。Layaにはないそのまま使える体験。
- Layaが崩れる、選択肢の多い選択タスクに強い。
- 出力トークンは無料なので、読み取りが多い判断は安く済む。
短所:
- クローズドで独自仕様。エアギャップやオンプレの選択肢はない。
- まだアーリーアクセスで、下記の料金以外に公開の料金ページはなく、ウェイトリストがある。
料金: 入力100万トークンあたり0.042ドル、出力は無料で、API経由で課金されます。
結論: Layaのコンセプトは気に入ったが、ファインチューニングの宿題やGPUは嫌だという人には、Jevが同じ発想のマネージド版です。ただし、オープンさを利便性と引き換えにすることは承知しておいてください。マネージド側の詳しい比較は、私のJev代替案まとめをご覧ください。
3. SetFit
最適な用途: 少数の例にラベルを付けて学習することをいとわず、完全に自分のものにできる分類器が欲しいチーム。
LayaのファインチューニングがネックならSetFitは、それを機能として捉え直したものです。SetFitは、Hugging Face(Intel LabsとUKP Labと共同)による少数ショットのテキスト分類フレームワークです。文埋め込みモデルの本体を対照学習でファインチューニングし、その埋め込みの上に小さな分類ヘッドを学習します。プロンプトもバーバライザーも不要です。
目玉の結果が良い点です。1クラスあたりわずか8件のラベル付き例で、3,000件の完全なデータセットでRoBERTa Largeをファインチューニングした場合に匹敵し、パラメータ数は桁違いに少なく、学習もはるかに高速です。CPUや控えめなGPUで動き、Apache-2.0で、多言語の文埋め込みモデルに差し替えれば多言語対応も手に入ります。どのみちLayaをファインチューニングするつもりだったなら、SetFitは「小さくて速い分類器」という同じ目的地へのより成熟した、ドキュメントの整った道と言えるでしょう。
長所:
- 本当に少数ショット。1クラスあたり約8件の例で動き出せる。
- 完全オープン(Apache-2.0)、セルフホスト、推論は0ドルでLayaと同じ。
- 汎用ハードウェアで学習・提供できるほど小さい。
短所:
- 分類器のみ。較正された「判断」APIも、noul/choice/scoreのプリミティブもない。
- 言語ルーターは内蔵されておらず、多言語の本体は自分で選ぶ。
- ラベル付きデータを用意し、2段階のフィットを実行する必要がある。
料金: 無料、Apache-2.0。pip install setfitですぐ始められます。
結論: 分類に関して、Layaに最も近い、真のオープンソースの精神的な兄弟です。較正された信頼度の層や多言語ルーターが致命的でないなら、SetFitは分類器を自分のものにする、より波風の少ない方法です。
4. Cohere
最適な用途: 人々がLayaに任せたがるRAGの関連度判定や分類を、企業向けのマネージドAPIとして。
Layaが紹介しているユースケースの多く、とりわけRAGの文章関連度のフィルタリングは、Cohereが何年も静かに得意としてきた領域です。Rerankモデルは各文章がクエリにどれだけ関連するかを採点し、EmbedとClassifyのエンドポイントは「このテキストはどの分類に入るか」の作業を担います。学習もホスティングも不要です。
実務者が本当に気に入っているのは、Cohereの検索スタックです。チームは、他社のモデルで生成している場合でも、Rerankが使い続ける理由だとよく語ります。関連度ランキングこそ、これが作られた目的だからです。
Layaとの違い:これは重みではなくマネージドAPIですが、Cohereはその点で異例に柔軟で、データを外に出せないチーム向けにVPCやオンプレの「Model Vault」デプロイを提供しています。Laya(完全セルフホスト)とJev(完全クローズド)にはない中間の道です。
長所:
- RerankはRAGの関連度で最高クラス。Layaの目玉ユースケース。
- Embed 4とRerank 4は100以上の言語に対応。
- 規制の厳しいチーム向けのVPC / オンプレの選択肢と、無料の開発者向け枠。
短所:
- デフォルトでマネージド・従量課金。Layaのような0ドルのセルフホストではない。
- 企業向けなので、検索スタックを本番に載せるには1行のインストールではなく本格的なエンジニアリングが必要。
料金: Rerank 4 Fastは1,000検索あたり2.00ドル、Rerank 4 Proは1,000あたり2.50ドル、Embed 4は100万トークン(テキスト)あたり0.12ドル。開発者向けの無料トライアル枠あり。
結論: Layaに求めていたのが関連度ランキングや分類で、GPUを動かしたくないなら、Cohereは大人のマネージドな答えです。特にオンプレの選択肢が必要なら有力です。
5. OpenAI Structured Outputs
最適な用途: すでにGPTを使っていて、新しいモデルを追加せずに型付き・スキーマ保証の判断が欲しいチーム。
型付きの出力を得るのに、専用の判断モデルは必ずしも必要ありません。OpenAIのStructured Outputsは、GPT-5.6モデルに、指定したJSON Schemaを守らせる機能です。応答は型に一致することが保証され(または明示的な拒否が返り)、PydanticやZodにそのまま接続できます。
正直な注意点は、「ハルシネーションしない」という議論全体が行き着いたところです。スキーマに合っていることは、正しいことと同じではありません。モデルは、型は完璧なのに単純に間違った答えを返すことがあり、Layaと違って汎用LLMの信頼度の信号はあいまいです(logprobsは読めますが、Layaが出すように作られた較正済みの分布ではありません)。さらに、呼び出しごとにLLMのレイテンシとトークンコストをまるごと払うことになります。これは、Layaが単純な反射的判断で置き換えようとした、500ms超の過剰さそのものです。
長所:
- すでにOpenAIを使っているなら、新しいモデルを導入する必要がない。
- スキーマ準拠が保証され、安全のための明示的な拒否もある。
- Structured Outputs自体は基本のトークン料金に上乗せがない。
短所:
- Layaが33msでこなす処理に、LLMのコストとレイテンシをまるごと払う。
logprobsによる信頼度は代用品で、較正された判断確率ではない。
料金: 機能の追加料金はなく、基盤モデルのトークン料金を支払います(GPT-5.6の主力モデルは入力100万あたり0.20ドルから5.00ドル)。
結論: すでにGPTがスタックにあり、判断の件数が控えめなら、最も抵抗の少ない道です。大量になると、呼び出しごとのコストがまさに専用の判断モデルへ人を向かわせます。
6. Google Gemini
最適な用途: 構造化分類を最も安くマネージドで実現したい場合。構造化分類を第一級のユースケースとして掲げているモデル。
Geminiの構造化出力はOpenAIと同じ原理で動きます。レスポンススキーマを渡すとGeminiがそれに従い、Googleのドキュメントは「構造化分類」を、裏技ではなくサポートされたユースケースとして明記しています。
GeminiがOpenAIとは別に枠を得る理由は、価格帯の下限です。Flash-Liteは大量・低コストの分類を狙った階層で、これこそ人々をLayaへ向かわせる経済的な圧力です。マネージドの構造化判断が欲しいが、主力モデルのトークン計算が怖いなら、Geminiの小型モデルがここで最も安いマネージドの選択肢です。OpenAIの項目の「型は合うが正しいとは限らない」という注意点はここでも当てはまります。これは汎用LLMであり、較正された判断モデルではありません。
長所:
- 構造化分類が文書化された第一級のユースケース。
- Flash-Liteの価格は、大量で安価な判断向けに作られている。
- 追加設定なしで幅広い多言語対応。
短所:
- LLMのレイテンシと代用の信頼度信号は残り、Layaの較正はない。
- GoogleのAPIに縛られる。
料金: Geminiモデルのトークン料金への機能上乗せはなく、Flash-Liteが最安の階層です。
結論: 判断あたりのコストがすべてで、較正された信頼度が不要なら、最良のマネージドの選択です。実質的には、下限がより安いOpenAIの構造化出力です。
7. OutlinesとInstructor
最適な用途: 自前のLLM(オープンでもホスト型でも)は使い続けつつ、デコード時にスキーマを強制したいチーム。
Layaへの不満が「別のモデルは要らない、今のモデルがゴミを返さなくなればいい」なら、2つのオープンソースライブラリが直接解決します。Outlines(dottxt製)はデコード時に構造を強制し、モデルはスキーマに合うトークンしか出せなくなります。OpenAI、Ollama、vLLMで動作します。Instructorはモデル呼び出しをPydanticと検証で包み、15以上のプロバイダーで型付き出力を得る標準的な方法になっています。
これらは判断モデルではなく、すでに動かしているモデルの周りに付けるガードレールです。それが強み(自前の重みを使え、新しい依存を立てなくてよい)であり限界(ベースモデルのレイテンシ、コスト、較正された信頼度の欠如を引き継ぐ)でもあります。OutlinesはApache-2、InstructorはMITで、どちらも無料です。なお、dottxtはオープンライブラリの上に有料のホスト型APIも販売しているので、自分で動かしたくない場合はそちらも選べます。
長所:
- 既存のモデルをそのまま使い、出力だけを型安全にできる。
- 完全オープン(Apache-2 / MIT)、セルフホスト、活発なプロジェクト。
- Outlinesのデコード時の強制は、本当に破りにくい。
短所:
- モデルではないため、下のLLMに対する速度やコストの利点はない。
- 較正された判断確率も、多言語ルーターもない。
料金: 無料でオープンソース。マネージドにしたい場合、Outlinesには有料のdottxtホスト型APIがあります。
結論: 本当の問題が判断の速度ではなくスキーマの安全性なら、これが正しい道具です。小さなローカルモデルと組み合わせれば、新しいモデルを導入せずに、Layaの「決して壊れない」保証の大半が得られます。
8. Cloudflare Workers AI
最適な用途: 小型モデル(Jev自体を含む)をエッジで動かし、使用量で課金したいチーム。
Cloudflare Workers AIは少し毛色が違い、ユーザーの近くのエッジで動かせる65以上のホスト型モデルのカタログで、自前のインフラは不要です。ここで取り上げる理由は1つ。typesafe/jevをホストしているからです。判断モデルというコンセプトが目当てなら、Cloudflareはそれを実際に呼び出す方法の1つです。
Layaをセルフホストする場合と比べた強みは、レイテンシと運用です。判断がリクエストに近いエッジ拠点で動き、GPUには一切触れません。Layaの0ドルというコストと比べた弱みは、正直さです。使用量に応じて(CloudflareのNeuronsという単位で)支払いますが、始めるための無料枠はあります。Layaのような同等の置き換えというより、このカテゴリ全体のデプロイ先という位置づけです。
長所:
- エッジ推論、低いネットワークレイテンシ、管理するインフラはゼロ。
- Jevをはじめ数十の小型モデルを、1つの課金体系でホスト。
- 無料枠があり、その後は透明なNeuronsベースの従量課金。
短所:
- 従量課金で、Layaのような無料のセルフホストではない。
- Cloudflareのカタログから選ぶ形で、任意のカスタム重みは動かせない。
料金: 無料枠があり、その後はNeuronsで従量課金されます。
結論: 「何を動かすか」より「どこで動かすか」への答えです。エッジのレイテンシと運用ゼロが、最後の1円より重要なら、GPUなしで判断モデルをデプロイするすっきりした方法です。
結局どれを選ぶべきか
冒頭のマップがいちばんよく表しています。本当に問うべきは、どこまで自分で運用したいかと、判断が欲しいのか解決が欲しいのかの2つです。この小さなチューザーで、候補の絞り込みまで案内します。
eeselを試す
サポートキューをもっと賢くしたくてLayaにたどり着いたなら、近道があります。ルーティングの判断は最初から目的ではなく、目的はチケットを閉じることでした。eeselは、振り分けの判断を行い、その上で行動するAIヘルプデスクのチームメイトです。返信を下書きし、操作を実行し、自信がないときはエスカレーションします。Zendesk、Freshdesk、Slackなど100以上のツールの中でそのまま動きます。
Layaの最大の弱点への答えとなるのがこの点です。自信のあるモデルでも間違えうるため、eeselはすべての展開を、実際の顧客に触れる前に過去のチケットでシミュレーションします。ベンチマークではなく、自社データでの本当の解決率が見えます。そしてLayaのプログラム可能性が気に入っていた開発者には、eesel CLIとMCPで、同じチームメイトをターミナル、スクリプト、コーディングエージェントから操作できます。無料で始める。