

Laya AIとは何か
Layaのホームページのタグラインは「decisions, not text」(判断であって、テキストではない)で、製品のすべてがこの数語に収まっています。これまで使ってきたAIの大半は自己回帰型です。次のトークンを予測し、また次を予測して、文章を組み立てていきます。返信を書くには最適ですが、はい・いいえの判断にはまったく不向きです。1ビットの情報を得るために言語モデルを動かし、それを取り出すために自由形式のテキストをパースすることになるからです。
Layaは別の種類のモデルです。入力全体を一度に読む双方向エンコーダーで、選択肢を書き出すのではなく、スコアリングして固定の質問に答えます。ConvaiはこれをSystem 1モデルと呼びます。生成型LLMのゆっくりと熟考するSystem 2の推論に対して、瞬時の反射的な判断にあたるものです。開発者であるConvai InnovationsのNandakishor Mukkunnoth氏は、動機をこう率直に語っています。
"Not every AI problem requires an autoregressive chatbot."
その通りです。「respond only with JSON」で終わるプロンプトに8Bモデルをつないだことがあるなら、彼が言う苦労はよくわかるはずです。
発想:System 2ではなくSystem 1
この主張は、現実の非効率に根ざしています。チケットの振り分けやフィッシングメールの判定に生成モデルを呼ぶと、三重のコストを払うことになります。500〜2,000msのレイテンシ、実際の推論コスト、そして出力側の壊れやすい文字列パースです。さらに悪いことに、LLMが返す確信度の数字は見せかけです。Nandakishor氏はこう述べています。
"When an LLM outputs 'confidence: 0.95', it is just predicting tokens that sound confident. There is zero mathematical calibration behind it."
Layaの答えは、反射的な判断を専用のモデルにすることです。自信ありげな文章ではなく、実際の確率分布を返すモデルです。この対比こそ、このモデルが存在する理由のすべてです。
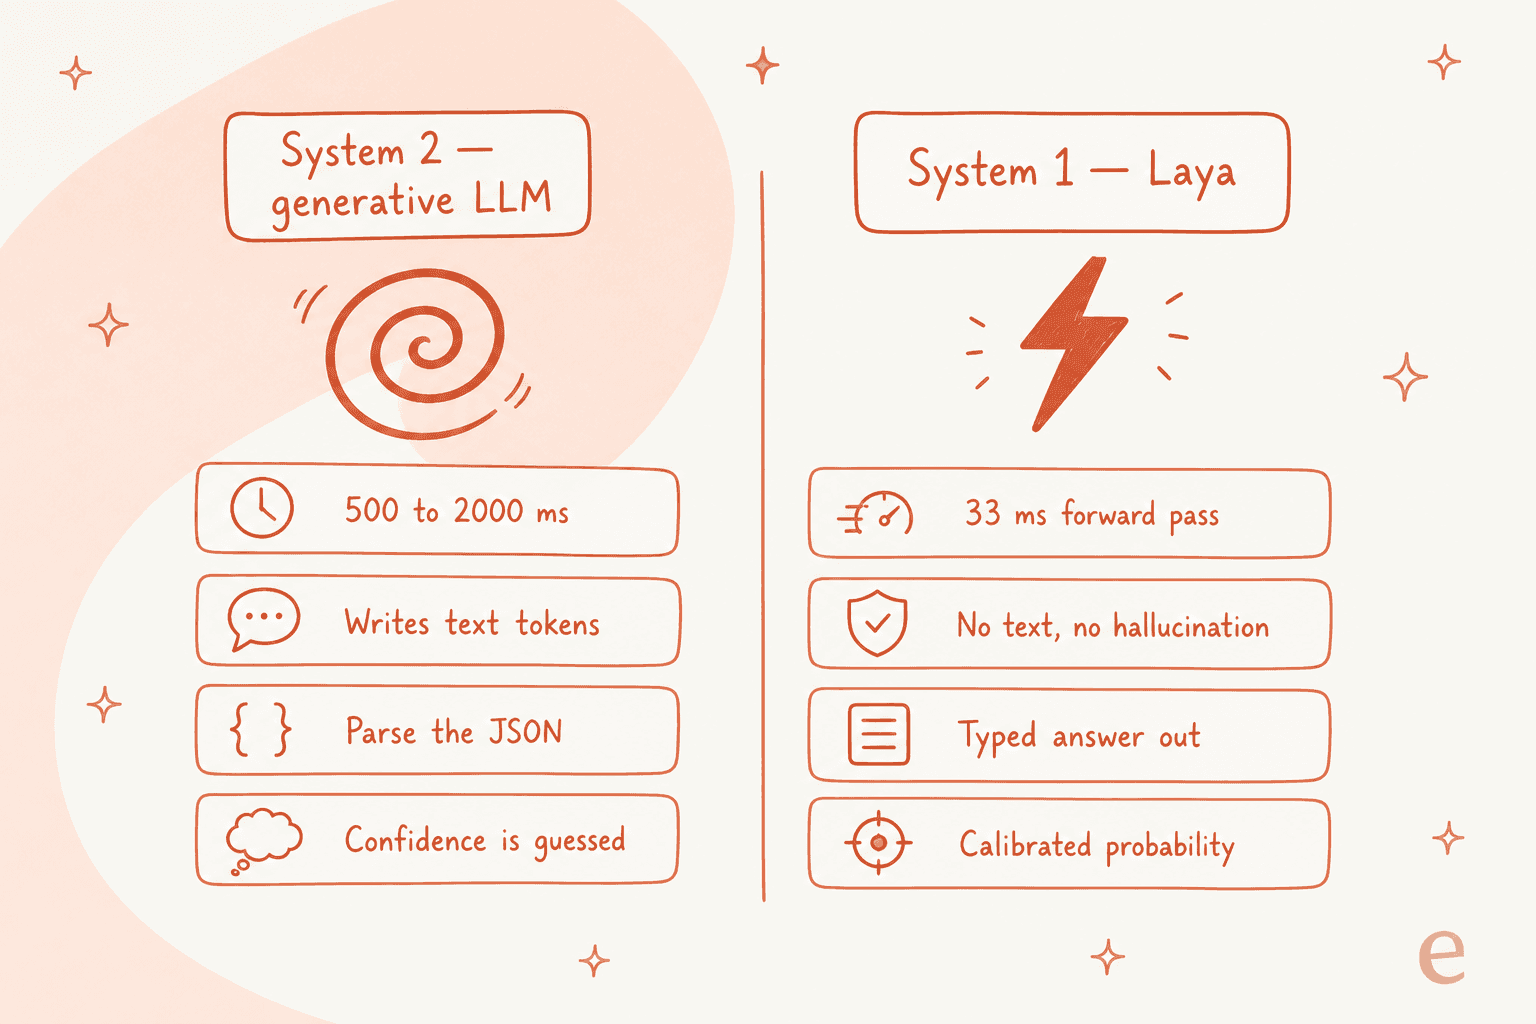
ここが私にとって最も興味深い部分です。痛い目を見て学んだことと重なるからです。サポート自動化で危険なのは、「わかりません」と言うボットではありません。自信満々に間違えるボットです。正直な確率を報告するモデルは、生の精度が1ポイント高いだけのモデルより価値があります。確信度でゲートをかけ、不安なものをエスカレーションできるからです。Layaは最初からこの考え方を軸に作られています。
Layaの内部のしくみ
仕組みとしては、Layaは状態と1つ以上の型付きの質問を受け取り、すべてを1回の並列パスで答えます。質問のプリミティブは3つあり、それを知ると、サポートのパイプラインが下す「判断」の大半をカバーしていることがわかります。
- choiceは、あなたが定義した集合から1つの選択肢を選びます(ルーティング、意図、トピック)。
- scoreは、状態を0〜3のような順序尺度に位置づけます(緊急度、不満度、深刻度)。
- noulは真偽値で、0.0〜1.0の較正されたP(true)を返します(フィッシング、スパム、ジェイルブレイク、解約リスク)。
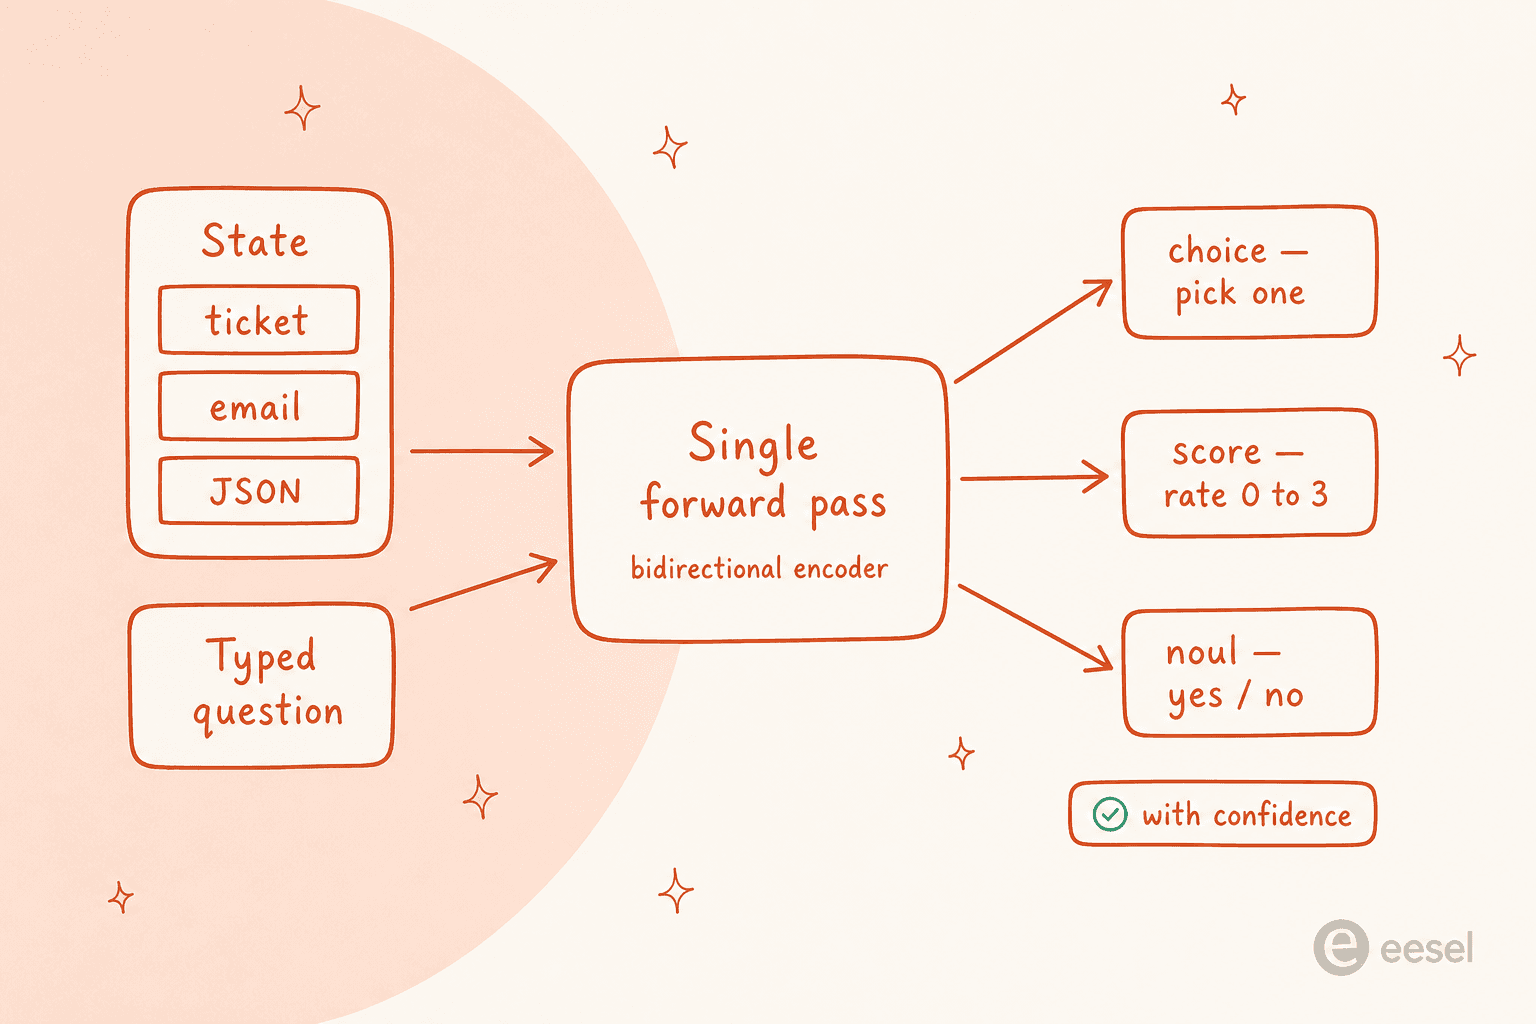
巧妙なのは、選択肢のスコアリング方法です。各選択肢はそれぞれ専用の[MASK]トークンとともに詰め込まれ、モデルはそのマーカー位置の隠れ状態を読んでロジットを作り、質問の選択肢全体にソフトマックスをかけます。回答空間はリクエスト時に定義されるため、新しいスキーマに再学習は不要で、別の選択肢を渡すだけです。英語のチェックポイントは4.21億パラメータのModernBERT-largeで、その上に小さな判断ヘッドが学習されています。
そして較正の源である学習です。LayaはConvaiがRLCDと呼ぶ手法で学習されます。厳密に適切なスコアリングルールに対する強化学習です。要点はこうです。素朴な学習は、モデルを過信に導きます。勝っている確率を1.0に近づけるほうが、単純な精度報酬を最大化できるからです。この点についてのNandakishor氏の言葉は、記事全体で最も鋭いものです。
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
RLCDは逆に、モデルが報告した確率が現実と一致したときだけ報酬を与えるので、正直な確信度が勝ち筋になります。これはキャッチコピーではなく、検証可能な本物の設計上の選択であり、私がLayaに期待するのもまさにこの点です。
3つのチェックポイント
「Laya」は実際には、1つのHugging Faceリポジトリにまとめられた3つのチェックポイントのファミリーで、どれを選ぶかは宣伝が示唆するよりも重要です。
| チェックポイント | バックボーン | パラメータ数 | 得意分野 |
|---|---|---|---|
convaiinnovations/laya | ModernBERT-large | 421M | 英語のガードレール、メールトリアージ |
laya-multilingual | mmBERT-base | 322M | 100以上の言語、約2.2倍高速 |
laya-typed-decisions | ModernBERT-large | 421M | 4つの型付き判断ワークフロー(精度0.766) |
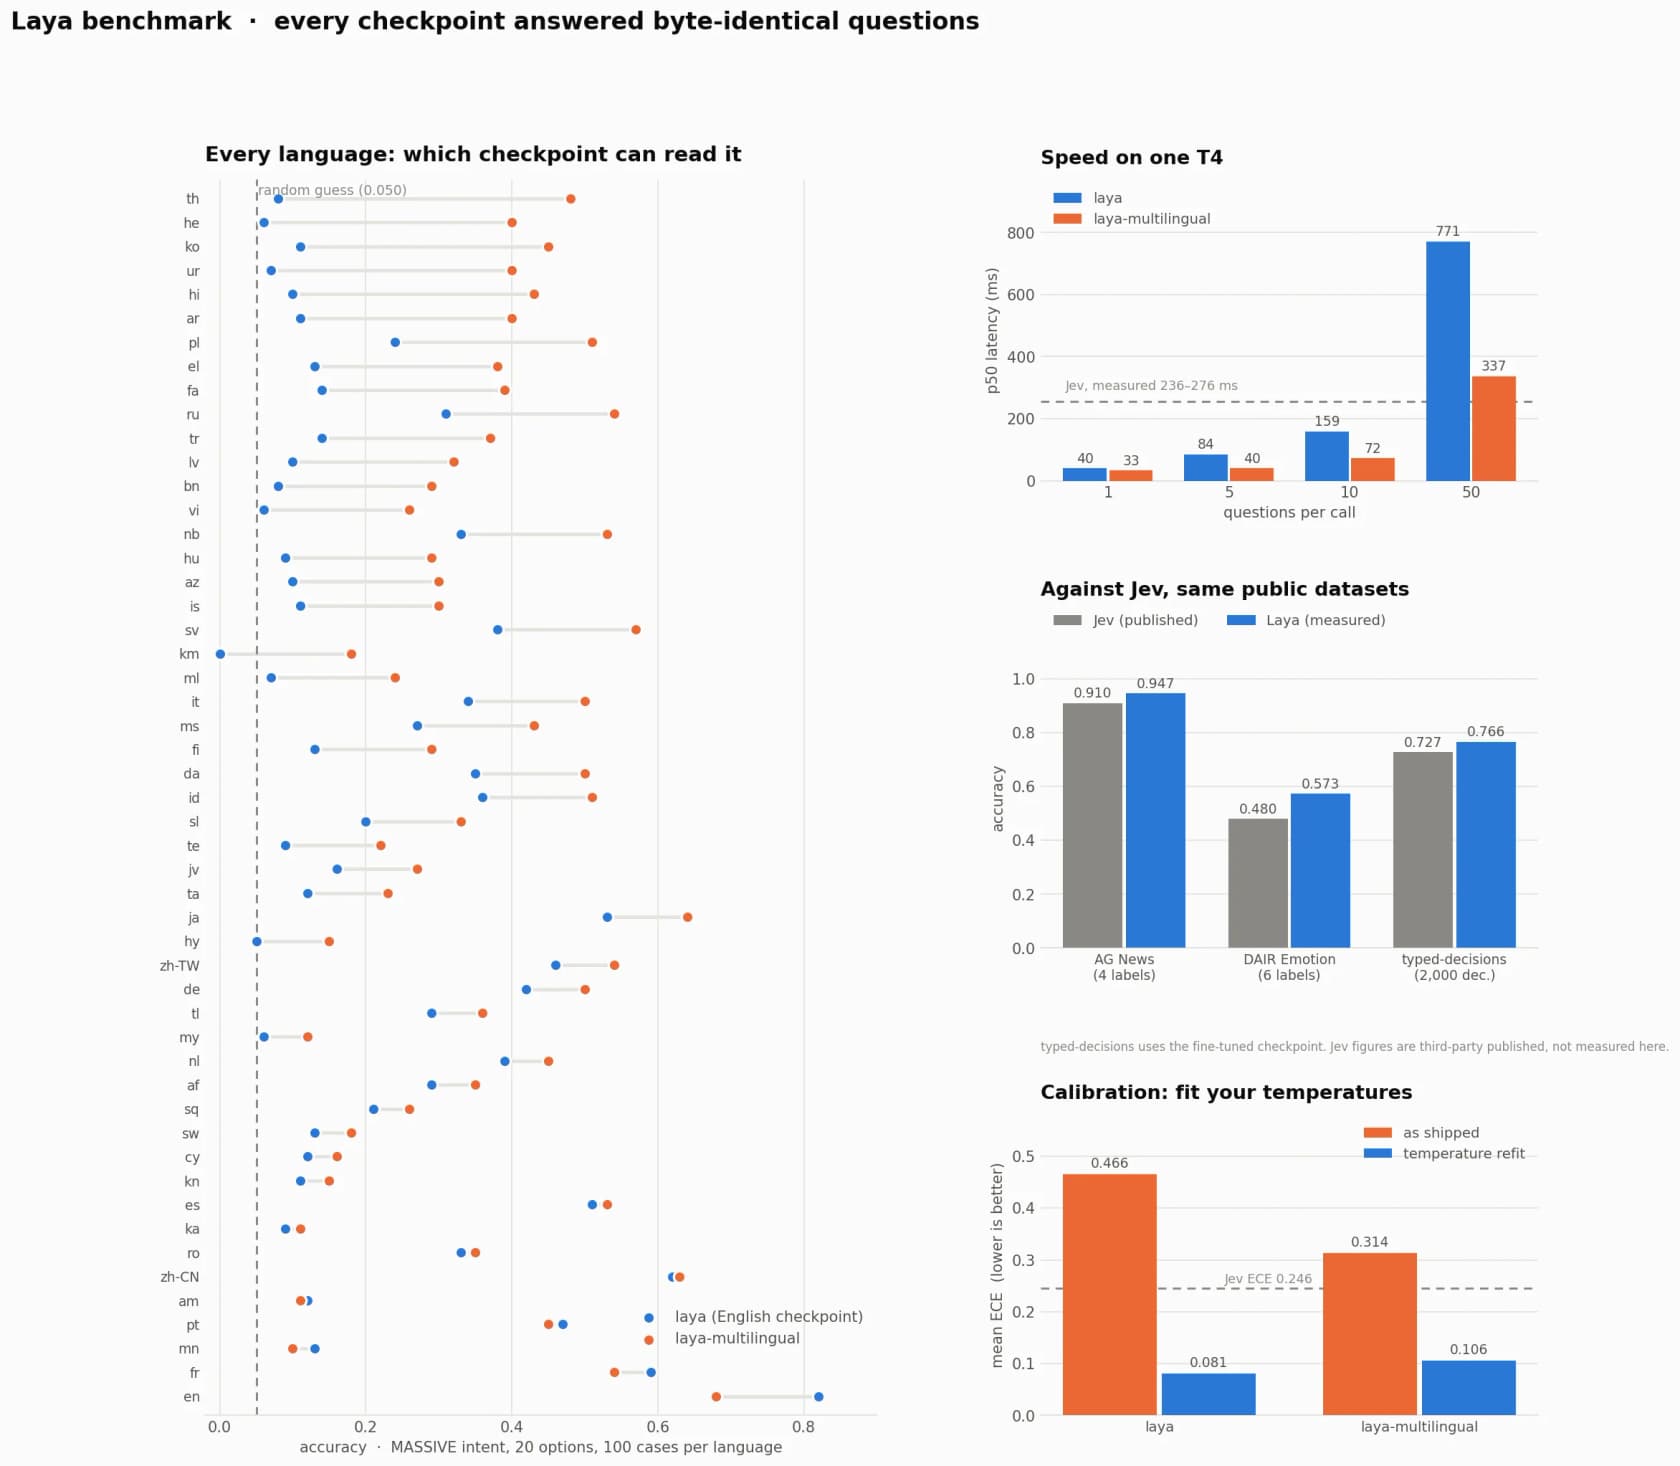
英語のルートモデルはラテン文字以外では崩壊し、しかも潔くありません。51言語のスイープで、クメール語の精度は0.000だったにもかかわらず、確信度は0.952と報告しました。これはまさに、このモデルが避けるはずの「自信満々に間違える」罠です。ここでは確信度によるゲートも役に立たないため、Layaは組み込みのRouterを備えています。0.5ミリ秒未満で文字体系を判別し、フォワードパスが走る前に多言語チェックポイントを選びます。
ベンチマークと、誰もが見落とした注意点
以下は、プロジェクトがJevに対して公開した比較の全体像です。情報量は多いですが、要点は、Laya(ルーティングあり)が共通の公開データセットでJevをわずかに上回りつつ、はるかに高速で較正も良好だということです。
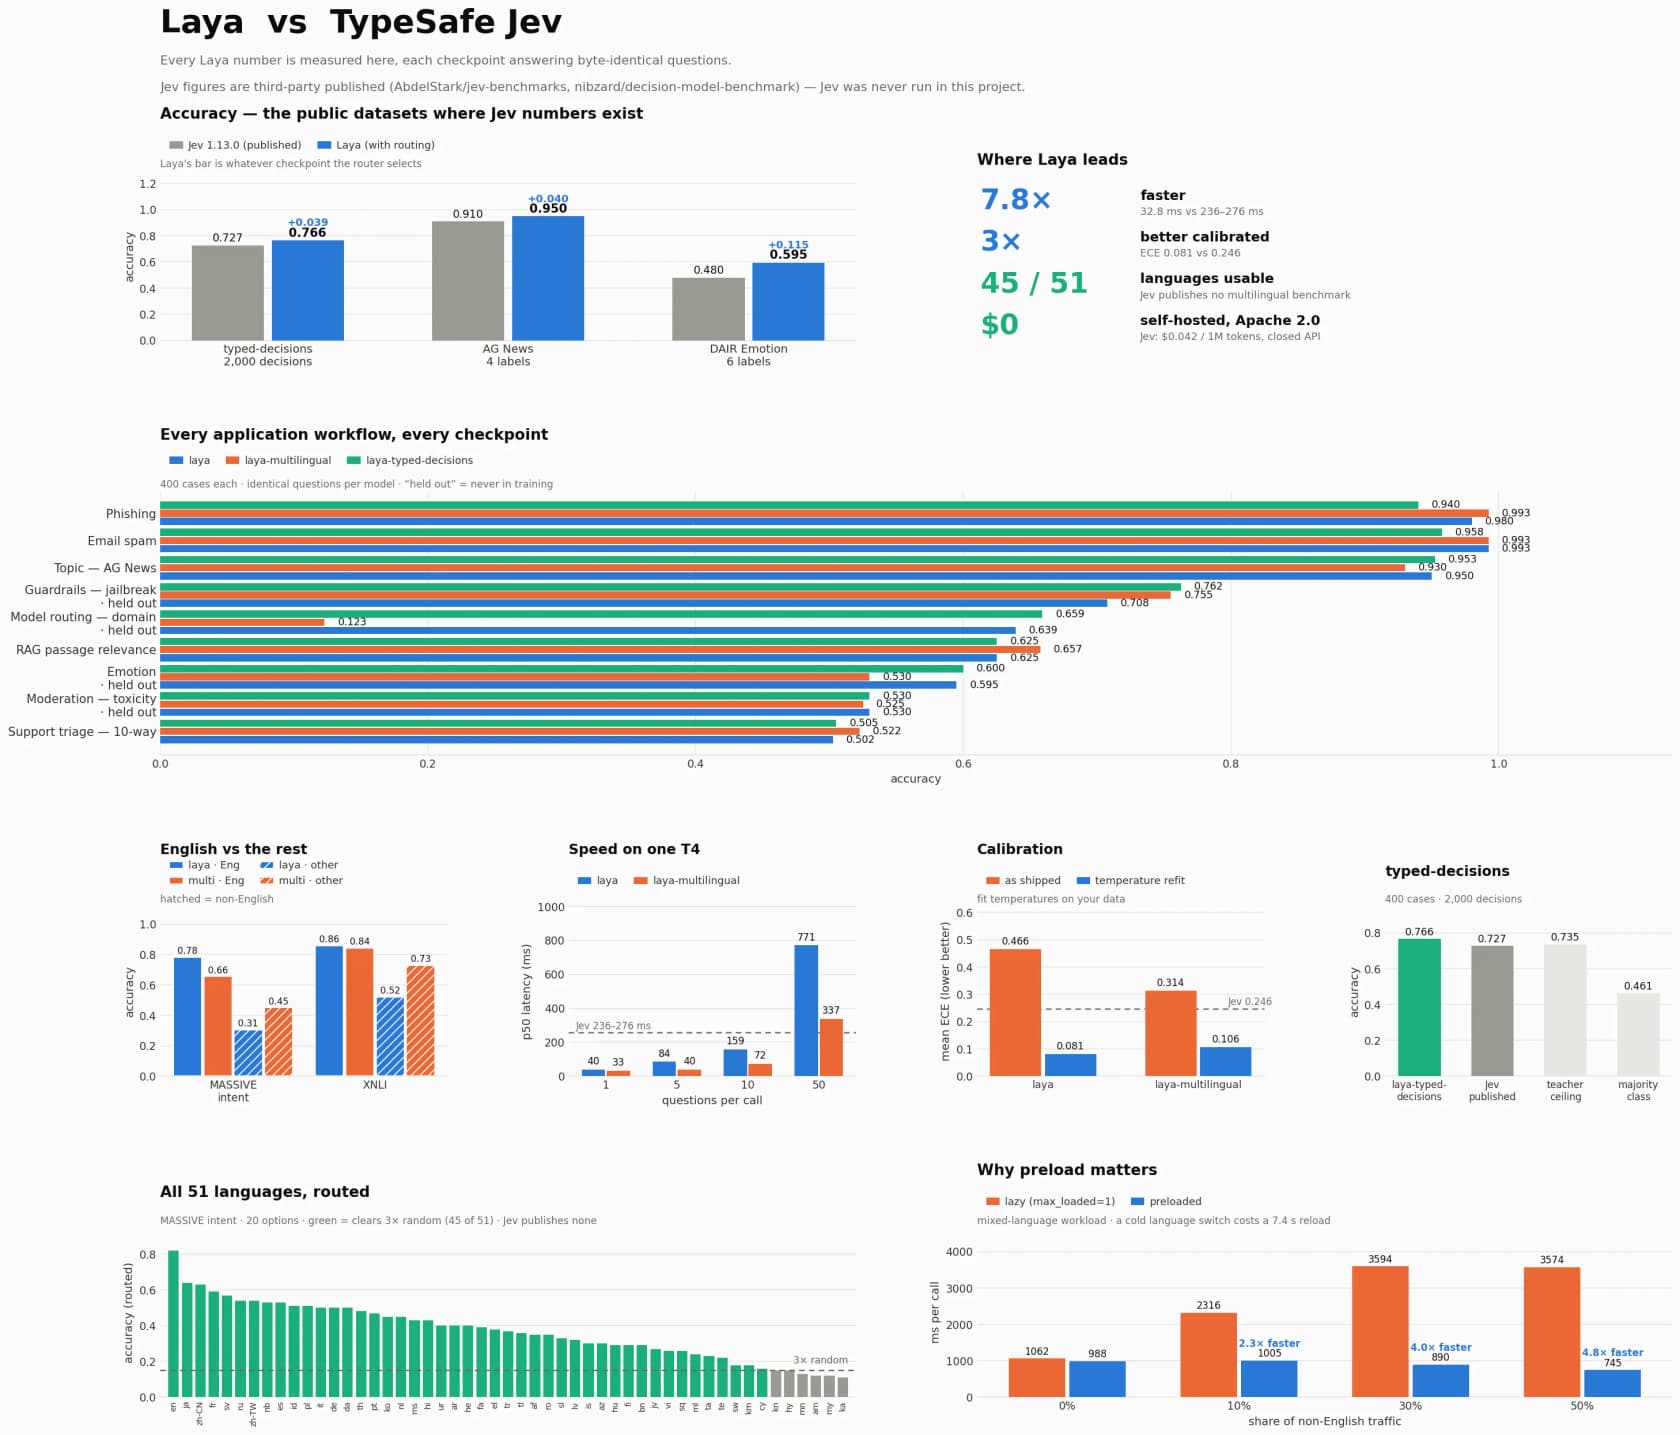
覚えておく価値のある数字は、すべて1枚のTesla T4で測定されたものです(ConvaiにはAPIアクセスがなかったため、Jevの数値は第三者が公開したものです)。
- レイテンシ: ルーティングされた1問で32.8ms(p50)、Jevは236〜276msです。これが7.8倍の根拠です。
- 較正: 温度を再調整した後のECEは0.081、Jevは0.246で、較正は3倍良好です。
- 精度: 2,000件の型付き判断セットで0.766、Jevは0.727で、教師モデルの上限0.735も上回ります。
そして議論を支配したアスタリスクです。その0.766はファインチューニング済みのチェックポイントのものです。ベースモデルをそのまま使うと、同じベンチマークで約0.362にとどまり、ランダムのベースラインの0.318をわずかに上回る程度です。プロジェクト自身の制限事項のセクションにもはっきり書かれています。Layaはゼロショットの神託ではなく、特化させるための高速な土台として扱ってください、と。ローンチが1,300ポイント以上を集めたHacker Newsでは、最も目立った批判的コメントがまさにこれでした。
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

もっともな指摘です。Jevはゼロショットで使えるものとして売られています。Layaは、正直に読めば、特化させて使う土台です。擁護する側にも妥当な反論がありました。1日あれば微調整できる、高速でプロンプト可能で較正されたモデルは、特注の分類器の群れを管理するより大きな前進だ、というものです。
実際に何に使うか
Jevをめぐる騒動を取り除けば、Layaは正直な確信度を持つ高速な分類器です。小さな構造化された判断のために、いま生成モデルへ過剰に支払っているあらゆる場面に当てはまります。プロジェクトはワークフローごとの実際の精度を報告しており、そのばらつきから得意な領域がわかります。
- メールのスパムフィルタリング:0.993
- フィッシング検出:0.980
- LLMガードレールとジェイルブレイク検出:0.755〜0.762(選択的カバレッジ50%で0.931)
- RAGの文章の関連性:0.657
- サポートチケットのルーティング、10クラス:0.522
二値の安全性判断は優秀です。幅広くあいまいな分類では、ファインチューニングが必要になります。このようなモデルを実務の観点から支持する意見がHNでうまく述べられており、単発のルーティングルールに溺れているチームから私が聞く話と一致します。
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
このスレッドには、名指ししておく価値のある実際の緊張関係があります。それが本当の購入判断だからです。一部の開発者は、一度も学習させなくてよいそのまま使えるものを求めています。
"I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
これが、多くのチームにとってのLayaの正直な限界です。自分で動かして特化させる気があるなら優れた部品ですが、箱から出してそのまま動くものがほしい場合には合いません。
速度、言語、コスト
Layaが疑いなく強いのは、地味な運用面です。ルーティングすれば、51言語のうち45言語でランダムの3倍超の精度を出します。Jevは多言語の数値を一切公開していません。
コスト面では、Apache 2.0でセルフホストなので、Jevの$0.042に対して100万トークンあたり$0.00です。自社のハードウェア上でエアギャップ環境でも動くため、HIPAAやGDPRの制約がある場合にも重要です。インストールはpip install layaの1行で、Router(preload=True)を使えば全チェックポイントがメモリに常駐し、言語切り替え時の7〜10秒のコールドリロードを避けられます。GitHubリポジトリは9,000スターを超えており、コードを書く前に試せるライブデモのSpaceもあります。
高カーディナリティの問題には、ひとつ注意点があります。デフォルトのトークン予算では、選択肢が約20を超えるとchoice質問の精度が落ちます。Banking77(77ラベル)では、Layaは0.425、Jevは0.870でした。各選択肢が互いに区別できるトークンが3〜4個しかないためです。対策は、予算を増やすか、粗いものから細かいものへの階層に分割することですが、そのままの状態では、10クラスのルーターは快適で、77クラスは厳しいです。
論争:誰が最初に作ったのか
Layaについて書くなら、誕生の経緯を避けては通れません。この投稿が拡散した理由の半分はそこにあるからです。Nandakishor氏の主張は先行性の主張です。この非自己回帰でRL学習の判断アプローチを、2025年3月のarXiv論文と2025年9月の続報で発表しており、TypeSafeが華々しくJevを発表する丸1年前だった、と述べています。
"It is incredibly frustrating when something you poured your heart into for months as an open-source researcher gets overlooked because it was built for a vertical use case, while a funded lab packages the same core idea horizontally and gets all the glory."
コミュニティの意見は、もっともな形で割れました。きれいなブランディングと使いやすいAPIこそが製品であり、彼の以前の仕事は誰も読まないニッチな「セールス・コンバージョン」ツールとして売られていた、という指摘もありました。一方で同情する声もあり、両モデルの宣伝の過熱ぶりにあきれながらも、オープン版が存在すること自体を歓迎する人も何人かいました。
"I had used versions of bert to achieve the same functionality years ago. But to me it seems like they were able to trick the VCs with 'can't hallucinate' etc. To the above author, kudos for sharing your work and making it open."
私の見方はこうです。先行性の議論は、優れたリリースから目をそらさせます。Layaが最初だったかどうかにかかわらず、オープンで高速、誠実にドキュメント化されており、自ら正直に挙げている用途ではしっかり機能します。それはクレジットをめぐる争いよりも価値があります。
判断モデルとAIチームメイトの位置づけ
ここが私にとって最も大切な部分です。私はこれを仕事として作っているからです。判断モデルとAIチームメイトは競合ではありません。別々のレイヤーに存在します。
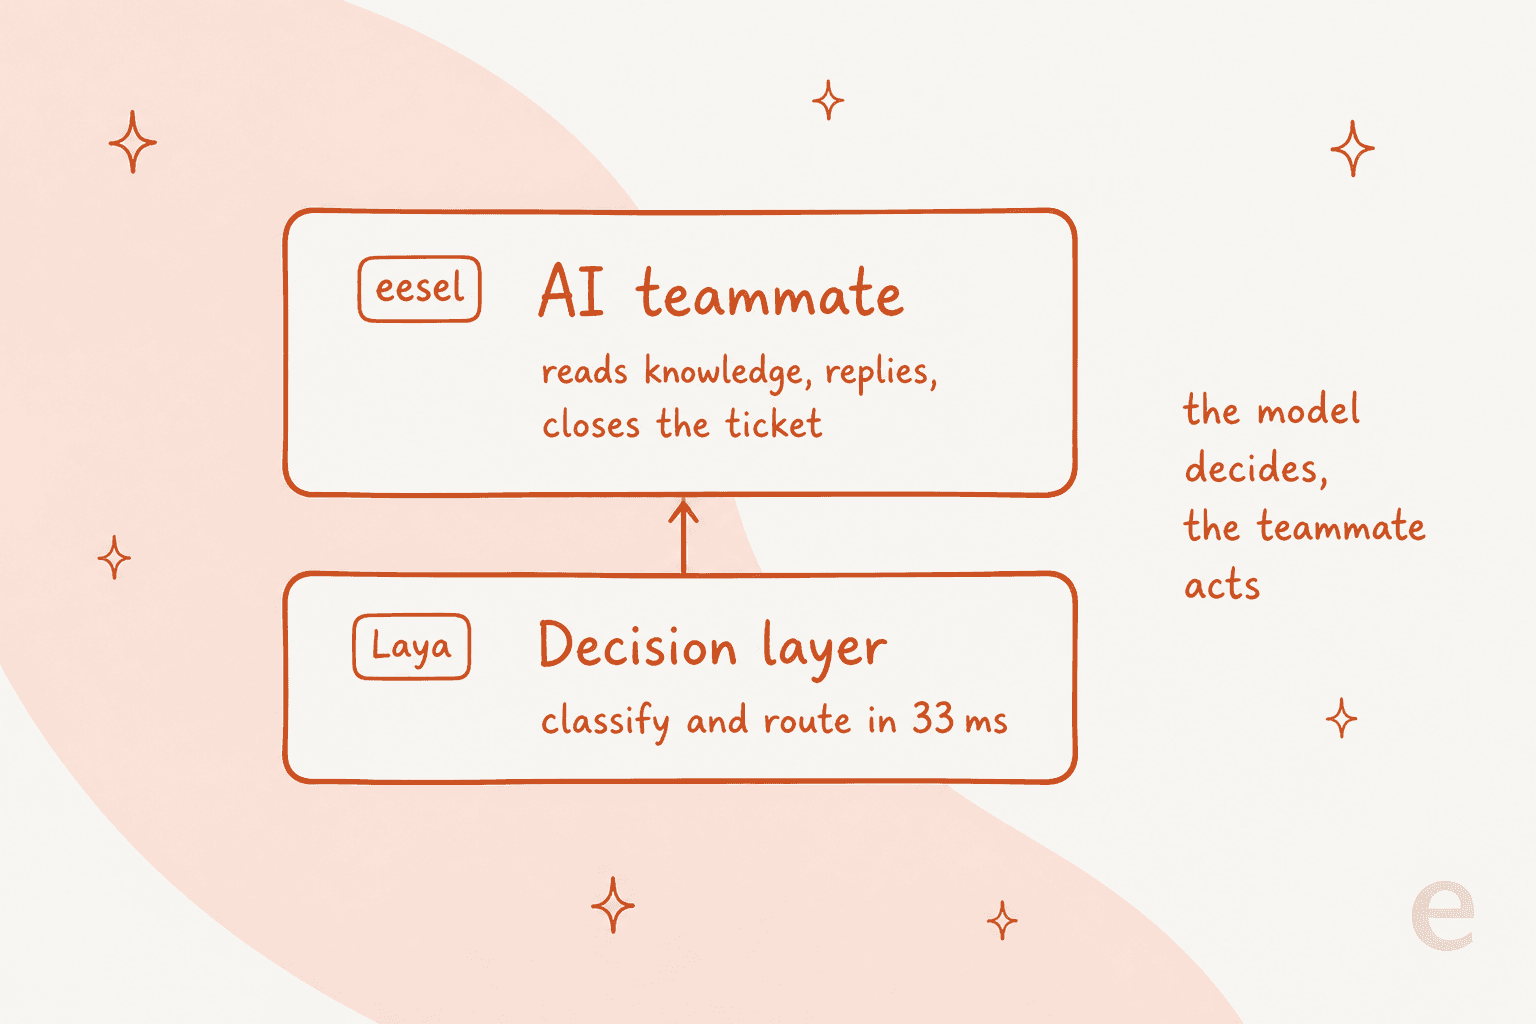
Layaはインフラです。「このチケットはどのキューに入れるべきか」「これは緊急か」に33msで答え、その1つの仕事を見事にこなします。しかし、ヘルプセンターは読みませんし、返信の下書きも作りません。注文状況の確認もしませんし、会話をクローズすることもありません。それらこそがサポートチームに実際に必要な仕事であり、分類するだけでなく行動するモデルが必要です。
これが、部品と従業員の違いです。eeselはAIチームメイトのプラットフォームで、AIヘルプデスクのチームメイトはサポート担当として採用される存在です。Zendesk、Freshdesk、あるいは普段お使いのツールにある既存のキューに加わり、過去のチケットやドキュメントを読み、チケット全体を最初から最後まで解決します。内部では、Layaが得意とするのと同じ種類の、高速で較正されたルーティングと確信度の判断を行いますが、それを読む、下書きする、行動するという流れで包み込むことで、分類を解決済みの会話に変えます。このチームメイトを直接スクリプト化・自動化したい開発者の方は、eesel CLIとMCPサーバーを使えば、人、スクリプト、Claude Codeのようなコーディングエージェントが、ダッシュボードと同じワークスペースを操作できます。
eeselを試す
より賢く速いサポート判断を求めてLayaを見ているなら、何を手に入れようとしているのかをはっきりさせておく価値があります。判断モデルは、組み立てるための部品を与えてくれます。AIサポートのチームメイトは、完成した働き手を与えてくれます。

Layaの較正の主張を私が信頼できるのは、その逆を経験してきたからです。自信ありげなボットが、ライブのキューで静かに誤った回答を返し続ける例を私たちは見てきました。だからeeselの導入ではすべて、最初に過去のチケットでシミュレーションを実行します。顧客に一件も触れる前に、正確な解決率と実際の回答を確認できます。料金は月額固定で、500クレジット(チケットまたはチャット1件につき1クレジット)が月$299からで、ユーザー数による課金はなく、100クレジットの無料プランもあります。判断をラベル付けで終わらせず実行に移したいなら、見るべきレイヤーはこちらです。
友人に伝えるなら
Layaは本物の貢献であり、オープンであることをうれしく思います。分類やルーティングの課題があり、ファインチューニングする意欲のある開発者にとっては、今年最も興味深い新ツールのひとつです。高速で、較正されていて、多言語対応で、しかも無料です。モデルカードもぜひ読んでください。自らの限界について、驚くほど正直です。
ただし、その上に何かを作る前に、制限事項のセクションを読んでください。ゼロショットの数字はほぼランダムで、確信度は自分のデータで再調整が必要で、幅広い分類にはファインチューニングが必要です。自ら名乗る優れた土台として扱ってください。そして、本当に必要なのが、1つの判断を返すことではなくサポート業務全体をこなすことなら、部品ではなくチームメイトを選んでください。
よくある質問
Laya AIとは何ですか?
Laya AIは、Convai Innovationsが公開したオープンソースの4.21億パラメータの判断モデルです。チャットボットのようにテキストを生成するのではなく、状態(チケット、メール、JSON)と型付きの質問を受け取り、約33msの1回のフォワードパスで、較正された確率つきの型付き回答を返します。Apache 2.0で公開されており、TypeSafe AIのクローズドなJevに対するオープンな答えと位置づけられています。
Laya AIの料金はいくらですか?
Layaは無料です。重みはHugging Face上でApache 2.0で公開されているため、セルフホストなら100万トークンあたり$0.00です。クローズドなJev APIの100万トークンあたり$0.042と比べてみてください。かかるのは、実行に使うGPUやCPUの費用だけです。そもそもモデルを動かしたくない場合は、AIヘルプデスクのチームメイトが分類も返信も代わりに処理します。
Laya AIはチケットのルーティングに向いていますか?
そのための強力なベースになります。10クラスのサポートトリアージのベンチマークでは、ベースモデルのスコアは0.522で、ファインチューニング済みチェックポイントは型付き判断セットで教師モデルの上限を上回ります。また、すべての回答にフォールバック判定用の較正された確信度スコアが付きます。実際のサポート環境にどう組み込めるかは、AIチケットトリアージツールのまとめ記事をご覧ください。