

一目でわかる私の評価
1セクションだけ読むなら、この表を読んでください。この種のモデルが手元に来たときに私が本当に気にする6つの観点に、レビューを凝縮しています。
| 観点 | 評価 | 私の発見 |
|---|---|---|
| 速度 | A | ルーティングした質問1件あたり32.8ms(p50)、Jevの236〜276msより約7.8倍高速 |
| 較正 | A | 温度の再調整後のECEは0.081、Jevは0.246で、本物の3倍 |
| ゼロショット精度 | D | ベースは約0.362、ランダム基準の0.318をわずかに上回る程度 |
| ファインチューニング後の精度 | A- | 型付きセットで0.766、教師の上限0.735を超える |
| 多クラスのタスク | C | 約20選択肢を超えると低下、77クラスのBanking77では0.425 |
| コストとライセンス | A+ | Apache 2.0、セルフホストなら$0、エアギャップ環境でも動作 |
この成績表の形がレビューのすべてです。速く、正直で、安いことには見事。ファインチューニングに投資するまでは中程度。幅広い分類には弱い。結論ではなくアーキテクチャの全体像を知りたい方は、別の記事Laya AIの詳細解説にまとめました。
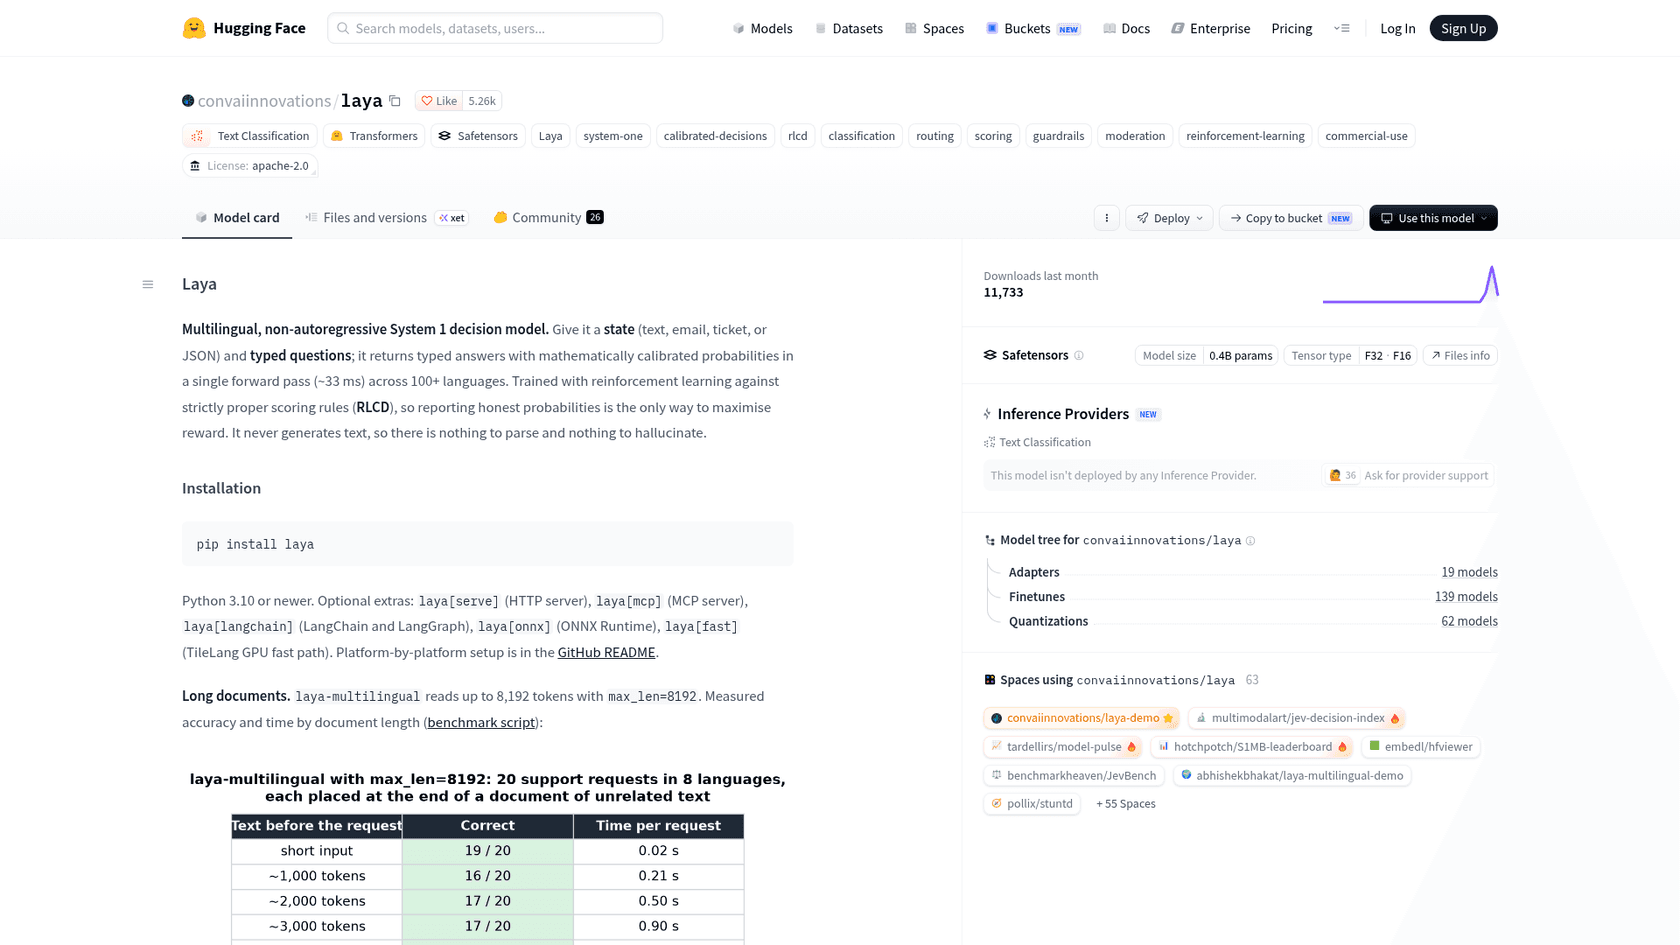
Laya AIとは、一段落で
これまで使ってきたAIの大半は自己回帰型です。次のトークン、その次のトークンと予測して文を組み立てます。返信を書くには最適ですが、はい・いいえの判断には無駄が多く、このギャップが本物の会話型AIプラットフォームと素のモデルを分けます。Layaはもう一方のタイプで、入力全体を一度に読み、選択肢を書き出す代わりにスコアリングして固定の質問に答える双方向エンコーダーです。Convaiはこれをシステム1モデル、つまり瞬時の反射的判断と呼び、生成型LLMのゆっくりしたシステム2の推論と対比しています。開発者のNandakishor Mukkunnothは、動機を一言でこう述べています。
"Not every AI problem requires an autoregressive chatbot."
彼の言うとおりです。「respond only with JSON」で終わるプロンプトに80億パラメータのモデルを付け足してチケットをルーティングしたことがあるなら、彼が解決している痛みを正確に味わっているはずです。このレビューはその前提に同意済みとして、実装が実用に耐えるかに焦点を当てます。
Laya AIを使うべきか?簡単な適合チェック
購入の判断は珍しくすっきりしているので、文章に埋もれさせず、同僚に説明する判断をそのまま示します。自分に合う分岐を選んでください。
ベンチマークが実際に示していること
こちらが、プロジェクトがJevに対して公開した比較の全体です。情報量は多いですが、要点は、Laya(ルーティング使用時)が共通の公開データセットでJevをわずかに上回りつつ、はるかに高速で較正も優れているということです。
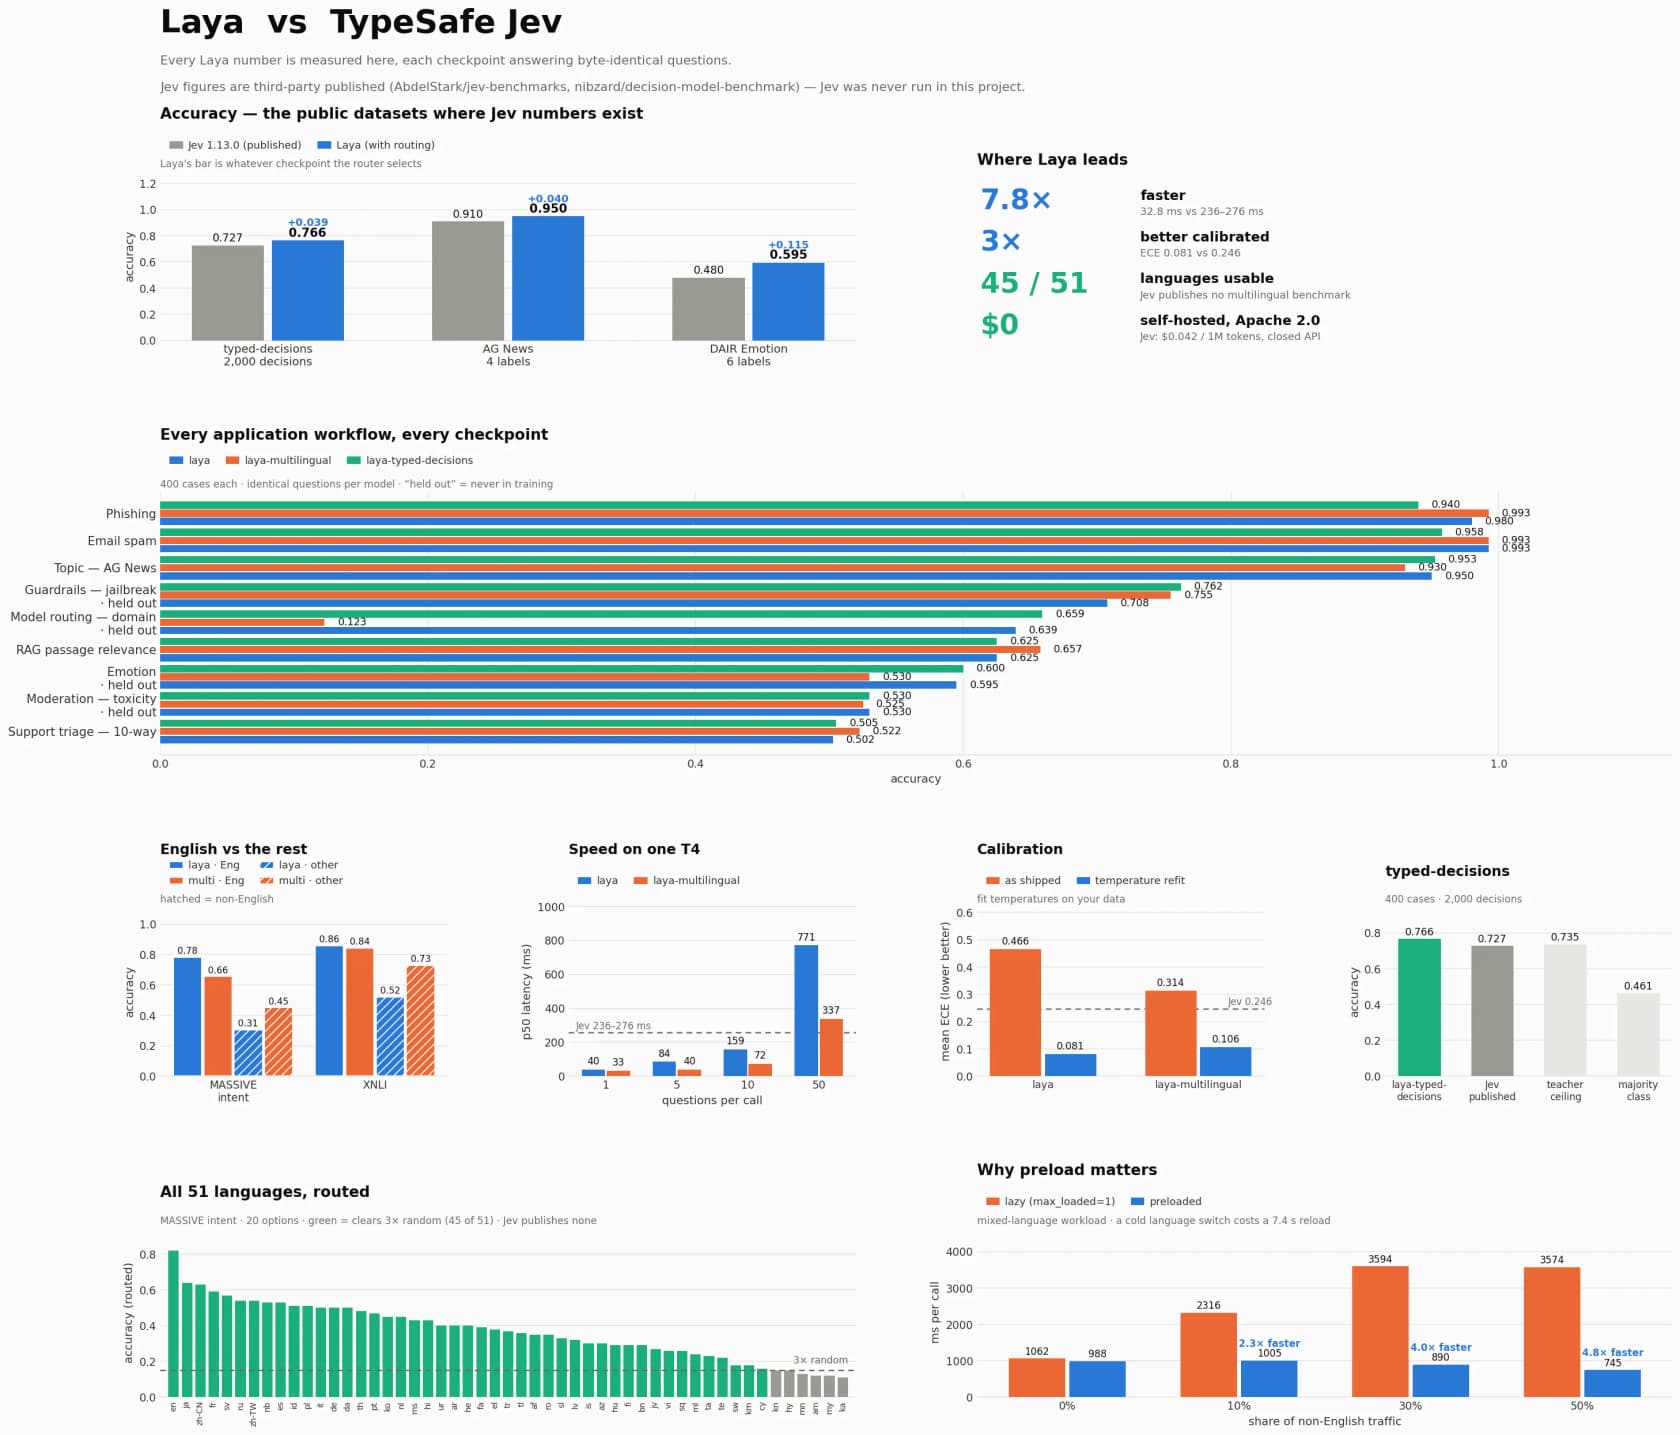
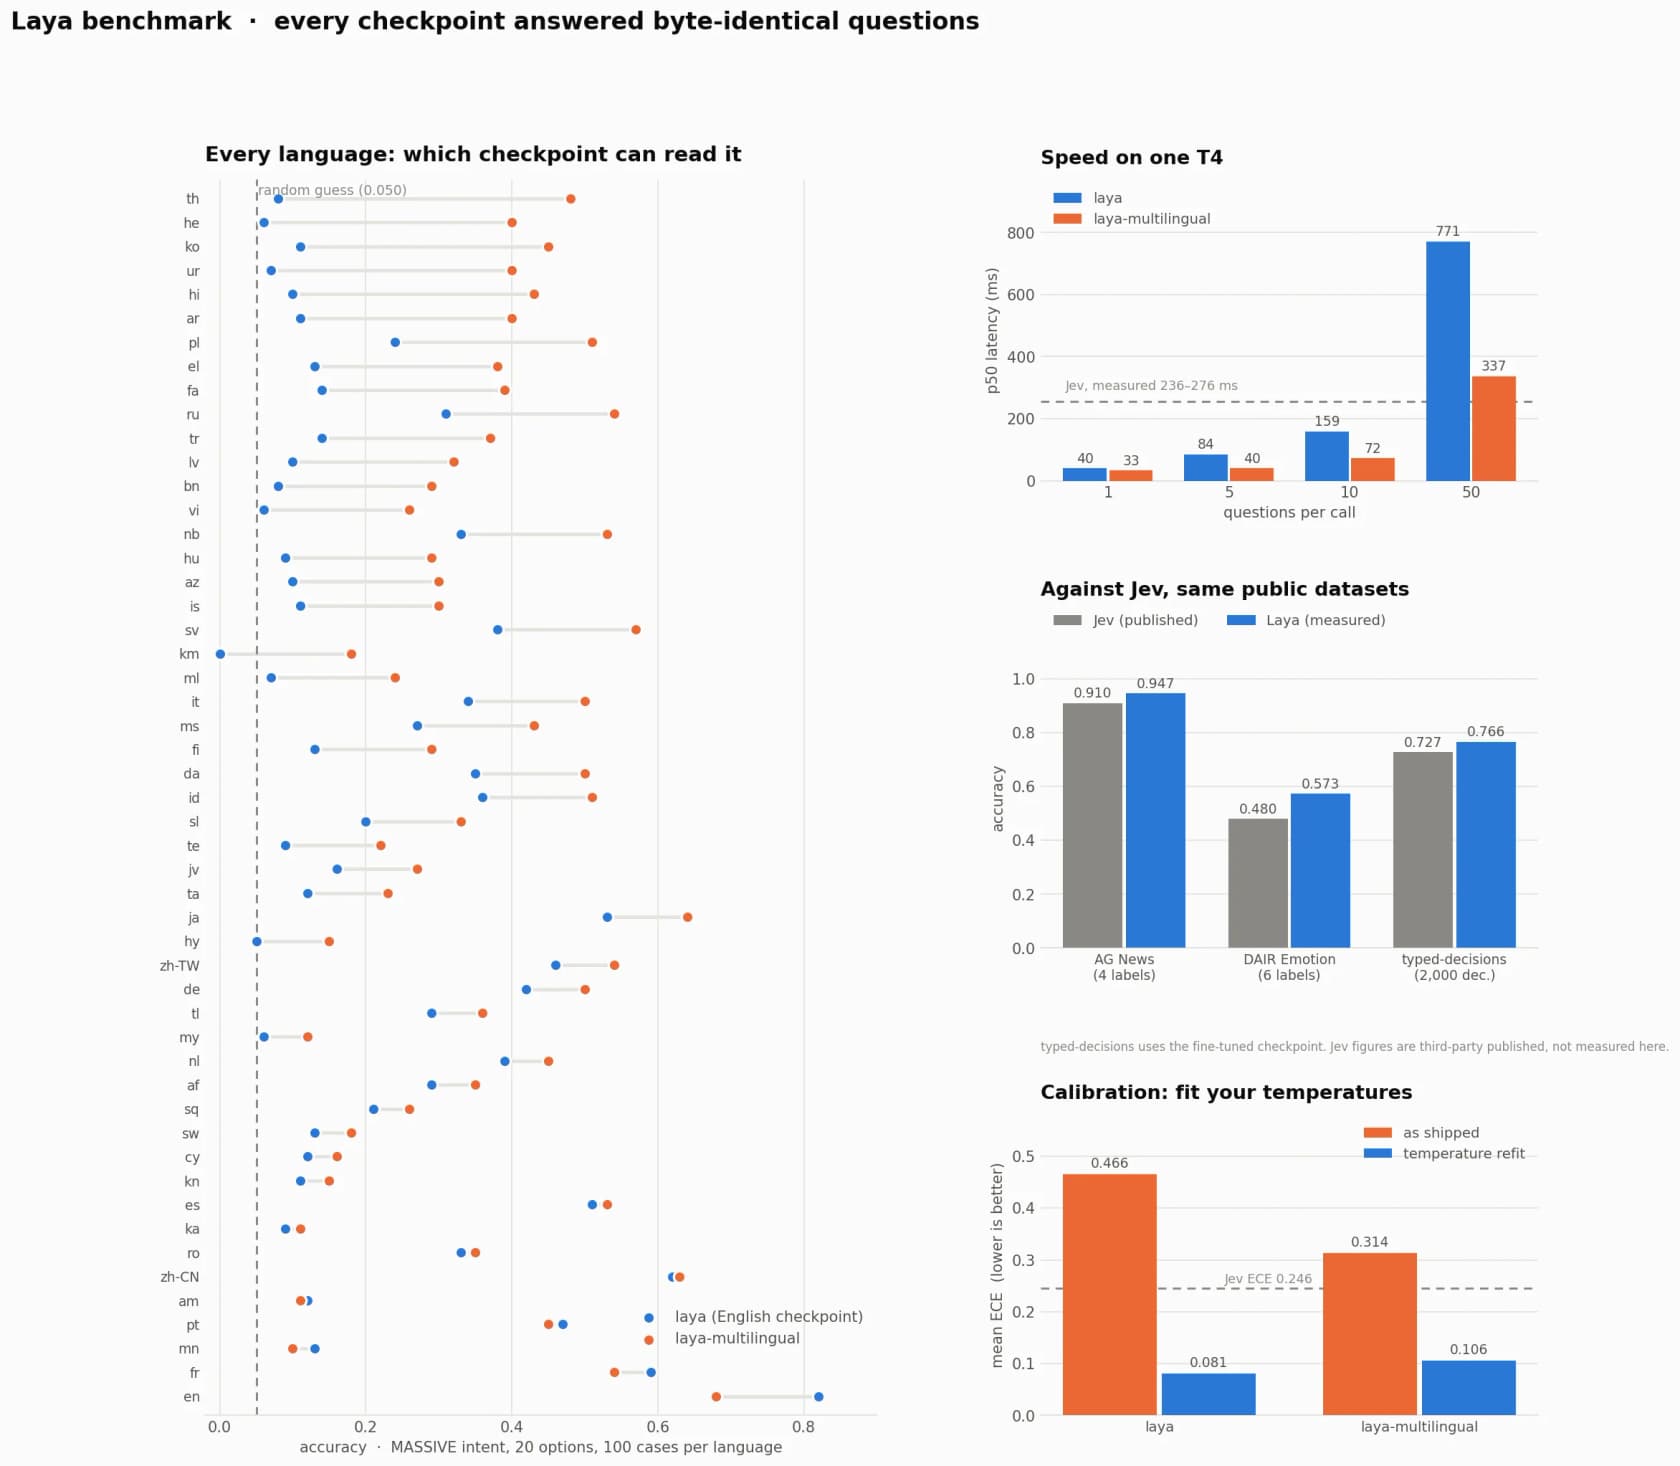
覚えておくべき3つの数字は、すべて1枚のTesla T4で測定されたもので、Jevの数値は第三者が公開したものです(ConvaiはAPIにアクセスできませんでした)。
- レイテンシ: ルーティングした質問1件で32.8ms(p50)、Jevは236〜276ms。これが7.8倍です。
- 較正: 温度の再調整後のECEは0.081、Jevは0.246で、較正スコアは3倍優れています。
- 精度: 2,000件の型付き意思決定セットで0.766、Jevは0.727で、教師の上限0.735も超えています。
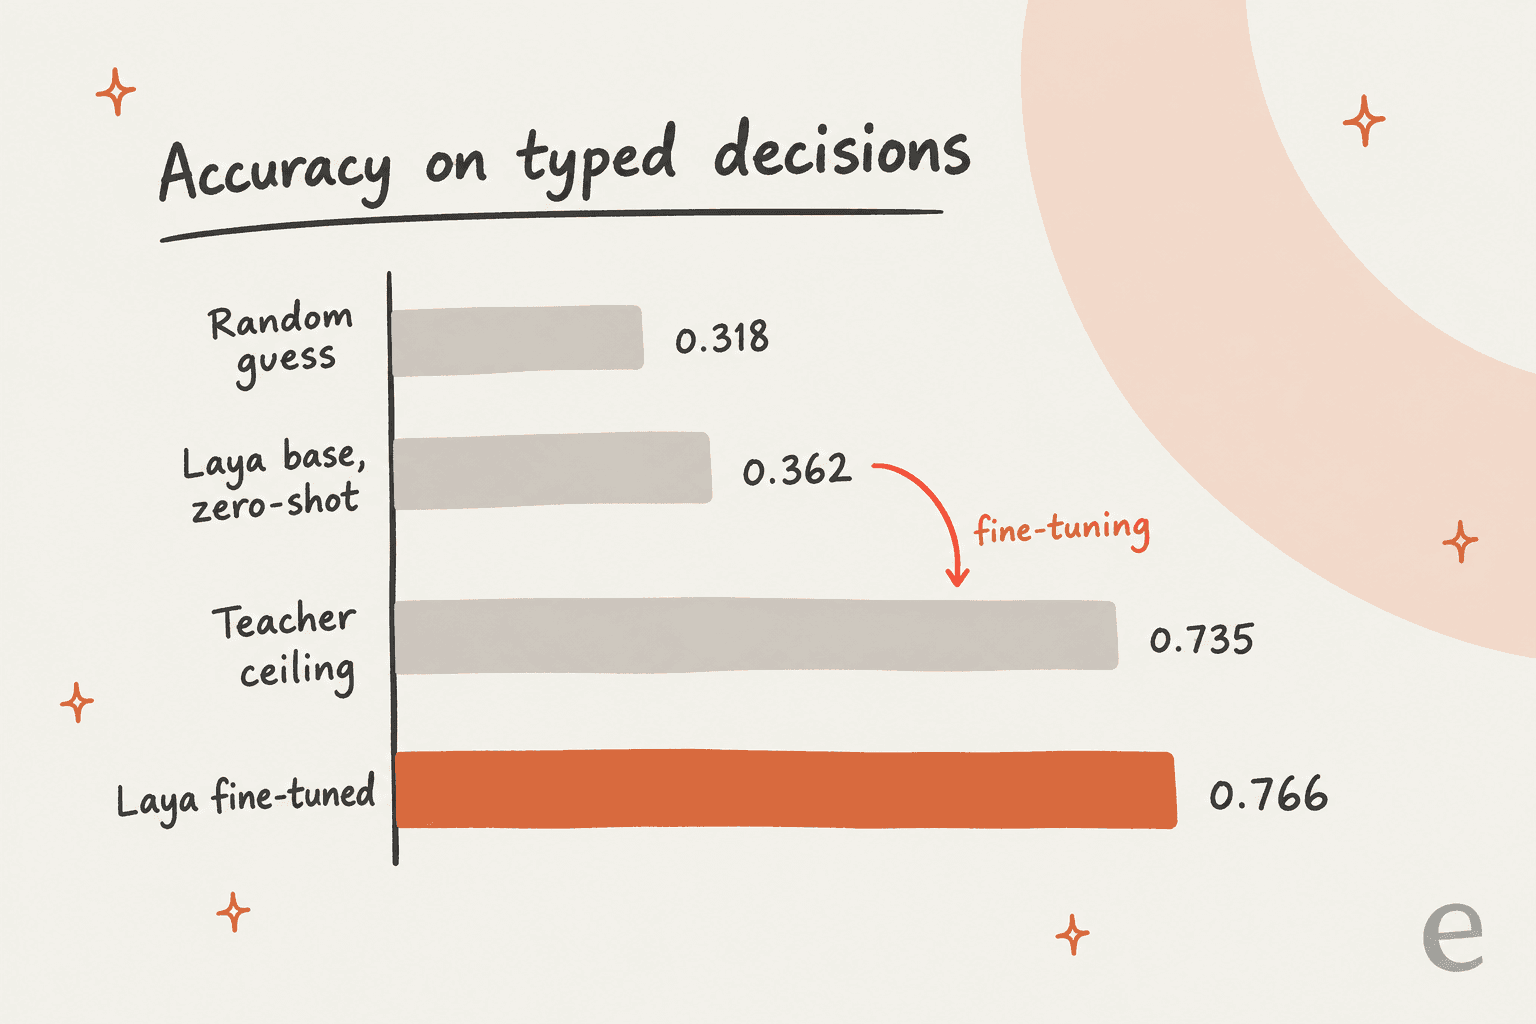
そして、ローンチに関する真剣な議論をすべて支配した但し書きです。その0.766はファインチューニング済みのチェックポイントのものです。手を加えていないベースモデルは同じベンチマークで約0.362、ランダム基準の0.318をわずかに上回るだけです。Convai自身の制限事項セクションがそれをはっきり述べており、私は好感を持っています。ローンチが1,300ポイントを超えたHacker Newsでは、最も目立つ批判的なコメントがまさにこれでした。
"This should be way up in the article. Fine tuning is a pain, requiring it for good results put Laya in a whole different category vs Jev"

これは的を射た指摘であり、このレビュー全体で最も重要な一行です。Jevはゼロショットで使えるものとして売られていますが、Layaは正直に読めば、特化させるためのベースです。
Layaが本当に光る場面
Jevをめぐる騒動を取り除けば、Layaは正直な信頼度を持つ高速な分類器で、それだけで大きな価値があります。私が真っ先に求めるのは較正で、サポート自動化を運用して痛い目に遭いながら学んだことと一致します。危険な失敗は「わかりません」と答えるボットではなく、自信満々に間違えるボットです。正直な確率を返すモデルなら、信頼度でふるいにかけて怪しい判断をエスカレーションでき、私にとっては生の精度が1ポイント上がるより価値があります。ConvaiはRLCD(厳密に適切なスコアリングルールに対する強化学習)という方式で学習しており、単純な学習がなぜ失敗するかについてのNandakishorの一文は、記事中で最も鋭いものです。
"Naive RL maximizes accuracy by destroying calibration. It turns your model into a confidently wrong machine."
ワークフローごとの結果は、強みがどこにあるかを裏付けています。Layaの報告は次のとおりです。
- メールのスパムフィルタリング:0.993
- フィッシング検出:0.980
- LLMガードレールとジェイルブレイク検出:0.755〜0.762(選択的カバレッジ50%で0.931)
- RAGの文章関連度:0.657
- サポートチケットのルーティング、10分類:0.522
二値の安全性判断は優秀で、ルーティングのスコアも、チームが実際に出荷するようなAIエージェントの事例の土台として十分です。運用面も同様に優れています。ルーティング使用時には51言語中45言語でランダムの3倍超を達成しており、Jevは多言語の数値を一切公開していません。
コスト面では、Apache 2.0でセルフホストできるため100万トークンあたり$0.00、Jevは$0.042です。人間のエージェントのコストと比べると、この差はすぐに積み上がります。自前のハードウェア上でエアギャップ環境でも動くため、HIPAAやGDPRの制約がある場合にも重要です。インストールはpip install layaの1行で、Router(preload=True)を使えば全チェックポイントを常駐させ、言語切り替え時の7〜10秒のコールドリロードを避けられます。
モデルカードには、HTTPサーバー、MCPサーバー、LangChain、ONNX向けのオプション拡張が掲載されるようになりました。GitHubリポジトリにはJev互換の/v1/systemoneエンドポイントも記載されているので、プロセス内で呼び出す代わりにLayaをAPIとして提供できます。
物足りない点
公平を期したいと思います。弱点は実在しますが、ネットで言われているほど広くはありません。テストで目立ったのは3点です。
1点目に、精度を求める作業ではファインチューニングは任意ではなく、そのためLayaはエンジニアではない人向けのノーコードチャットボットとしては候補から外れます。ゼロショットの0.362が正直な数字で、HNのある実務者が、そのコストを私よりうまく言い表していました。
"Idk, your limitations section sure makes it seem less drop in and less general than Jev... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores to help me figure out when to fallback."
2点目に、多クラス分類が苦手です。多数のカスタムAIモデルを1つのルーターで置き換えたいと考えていたなら、これは重要です。Banking77(77ラベル)では、Layaは0.425、Jevは0.870でした。デフォルトの予算では各選択肢が区別できるトークンが3〜4個しかないためです。対処法はトークン予算を増やすか、粗い分類から細かい分類への階層に分けることですが、そのままでは10分類のルーターは快適で、77分類のルーターはそうではありません。
3点目に、ルーターを使わない場合の多言語での失敗の仕方が厄介です。英語のルートモデルはラテン文字以外で崩壊します。51言語の検証では、クメール語で精度0.000なのに信頼度0.952を報告しており、このモデルが避けようとしている「自信満々に間違える」罠そのものです。Layaには、0.5ミリ秒未満で文字体系を検出して多言語チェックポイントを選ぶ組み込みのRouterがあるので解決可能ですが、使う必要があります。
どれも致命的ではありません。部品としての境界であり、すべて文書化されています。それは多くのローンチにはできないことです。
コミュニティの本当の見方
反応は大きく、優先権をめぐる騒動を除けば有益でした。最も繰り返された批判は、ゼロショットがほぼランダムという但し書きで、発表の冒頭に書くべきだと考えた複数の人が一字一句そのまま貼り付けていました。熱心な支持派の反論も同じくらい一貫していました。
"In the limitations you say that 'Out-of-the-box base models score ~0.35 on the typed-decisions benchmark (near random)...' - but that's the whole point, you can obviously fine-tune specialized models but having a model follow you instructions and be promotable and fast makes it massively easier to use."
そして、誰かが雑音を切り分けたとき、実用的な価値は明らかでした。
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
オープン版が存在すること自体を広く歓迎する声もあり、姉妹製品Jevのローンチにあった「can't hallucinate」という表現をベンチャー資金集めの餌と受け取った懐疑派でさえそうでした。私もおおよそ同じ結論で、これはサポート向けのAnthropicのClaudeアップデートへのコミュニティの反応にも通じます。声高な主張より、得られた信頼が勝ちます。
論争を手短に
Layaは出自の話抜きにレビューできません。それがバイラルになった理由の半分だからです。Nandakishorの主張は先行性の主張で、この非自己回帰かつRL学習のアプローチを、TypeSafeがJevをローンチするちょうど1年前の2025年3月のarXiv論文で公開したと述べています。
コミュニティの意見は妥当な形で割れ、すっきりしたブランディングと使えるAPIはそれ自体がプロダクトだと指摘する人もいました。私の見方では、功績争いは優れたリリースから目をそらさせる雑音です。Layaが最初だったかどうかにかかわらず、オープンで、高速で、正直に文書化されており、正直に述べている用途ではよく機能します。経緯の全体はLaya AIの概要で詳しく解説しています。
意思決定モデルとAIチームメイトの位置づけ
ここは私が最も気にする部分です。私はこれを仕事として作っているからです。意思決定モデルとAIチームメイトは競合ではなく、別のレイヤーに存在します。
Layaはインフラです。「このチケットはどのキューに属するか」「緊急か」といった問いに33msで答え、その1つのことを見事にこなします。しかし、ヘルプセンターは読まず、返信は作成せず、注文状況は確認せず、会話をクローズもしません。それらこそサポートチームが実際に必要とする仕事で、分類するだけでなく行動するモデルが必要です。これが部品と従業員の違いです。
eeselはAIチームメイトのプラットフォームで、AIヘルプデスクチームメイトはサポート担当として採用される存在です。Zendesk、Freshdesk、またはすでに使っているツールの既存のキューに加わり、過去のチケットとドキュメントを読み、チケット全体をエンドツーエンドで解決します。内部では、Layaが得意とするのと同じ、高速で較正されたルーティングと信頼度の判断を行いますが、そこに読み取り、返信の作成、アクションを加えることで、分類を解決済みの会話に変えます。このチームメイトをクリックで操作するよりスクリプトで操作したい開発者向けには、eesel CLIとMCPサーバーにより、人、スクリプト、Claude Codeのようなコーディングエージェントが、ダッシュボードと同じワークスペースを操作できます。これは、Layaファンが求める、まさにプログラムによる分類の自然な居場所です。
eeselを試す
Layaに注目しているのが、より賢く速いサポート判断を求めてのことなら、何を買うのかを明確にしておく価値があります。意思決定モデルが与えてくれるのは、組み上げるための部品です。AIサポートチームメイトが与えてくれるのは、完成した働き手です。

Layaが主張する較正の議論を私が信頼するのは、その逆を経験してきたからです。自信ありげなボットが、本番のキューで静かに誤った回答を出すのを見てきました。だからこそ、eeselの導入はすべて、まず過去のチケットでシミュレーションを実行し、顧客に1人も触れる前に、正確な解決率と実際の回答を確認できるようにしています。料金は月額固定で、$299/月から500クレジット(チケットまたはチャット1件につき1クレジット)、ユーザーごとの料金はなく、100クレジットの無料プランもあります。判断をラベル付けだけでなく実行までしてほしいなら、見るべきはこのレイヤーです。
友人に伝えること
Layaは本物の貢献であり、オープンであることを嬉しく思います。分類やルーティングの課題があり、ファインチューニングする意欲のある開発者なら、今年最も興味深い新ツールの一つです。高速で、較正されていて、多言語対応で、無料です。まずモデルカードを読んでください。自らの限界について驚くほど正直で、その正直さがこのレビューが好意的である大きな理由です。
ただし、その上に構築する前に制限事項のセクションを読んでください。ゼロショットの数値はほぼランダムで、信頼度は自分のデータで再調整が必要で、幅広い分類にはファインチューニングが要ります。自ら語るとおりの優れた土台として扱ってください。そして、実際に必要なのが1つの判断を返すことではなくサポート業務全体なら、部品ではなくチームメイトを選んでください。
よくある質問
2026年にLaya AIは使う価値がありますか?
適した用途なら、あります。私のLaya AIレビューの結論はこうです。ルーティングや分類の課題があり、ファインチューニングする意欲のある開発者にとって、Layaは今年最も興味深いオープンリリースの一つです。高速で、較正されていて、多言語対応で、無料です。ラベル付けではなくサポートチケット全体を解決したいなら、代わりにAIヘルプデスクチームメイトが必要です。
Laya AIの料金はいくらですか?
Layaは無料です。重みはHugging FaceでApache 2.0として公開されているため、セルフホストなら100万トークンあたり$0.00で、クローズドなJev APIの100万トークンあたり$0.042と比べて大きな差があります。実際にかかる費用は、動かすGPUまたはCPUだけです。モデルを自分で動かしたくない場合、eeselは月額固定で$299/月から500クレジット(チケットまたはチャット1件につき1クレジット)で、ユーザーごとの料金はありません。
Laya AIはサポートチケットのルーティングに向いていますか?
強力なベースにはなりますが、完成したルーターではありません。10分類のサポートトリアージセットでベースモデルのスコアは0.522で、すべての回答に、しきい値を設定できる較正済みの信頼度スコアが付きます。詳しくは、サポートチケットのトリアージに最適なAIのまとめと、チケットトリアージの仕組みをご覧ください。
Laya AIはファインチューニングが必要ですか?
本格的な精度が必要なら、たいていは必要です。そのままのベースチェックポイントは、型付き意思決定ベンチマークでほぼランダム(約0.362)です。見出しの0.766は、そのタスクでファインチューニングした結果です。Layaは特化させるための高速な土台と考え、信頼度の数値を信じる前に自分のデータで温度を再調整してください。eeselのようなツールは、ナレッジベースから直接学習することで、この手順を省けます。
Laya AIは本当にハルシネーションしませんか?
出力空間の中では、しません。Layaはテキストトークンを出力せず、あなたが定義した固定の選択肢に対する確率だけを返すので、存在しないカテゴリや壊れたJSONは構造上あり得ません。それでも間違えることはあります。だからこそ、宣伝文句より較正済みの信頼度スコアの方がはるかに重要で、自信満々の推測より正直な解決率の方が価値があります。
Laya AIとJevはどちらが優れていますか?
想定する購入者が違います。Jevはそのまま使えるゼロショットAPIとして売り出されており、Layaは自分で特化させるオープンなベースです。自社のベンチマークでは、約7.8倍高速で、較正は3倍優れています。私のLaya AIレビューの結論は、セルフホストしてファインチューニングするならLaya、調整なしで動くAPIが欲しいならJevです。より広い視点はLaya AIの完全解説をご覧ください。
Laya AIで実際に何が作れますか?
高速で構造化された判断です。スパムやフィッシングのフィルター、LLMのガードレール、RAGの文章関連度、感情スコアリング、ルーティングなどです。小さな判断のために生成モデルへ払いすぎている場面なら、どこにでも収まります。サポート環境では、AI感情分析やチケットの自動タグ付けと自然に組み合わせられます。