プレスリリースより先に出たモデル
多くのモデル発表は、ブログ記事、ベンチマーク図、モデルカードが同時に出ます。M3.1 Flashはその逆でした。MiniMax Codeのモデルセレクターに、M3やM2.7と並んで現れ、MiniMaxが何も言う前にコミュニティが見つけました。最初に見つけた開発者は、新しい推論メニューにすぐ気づきました。
"🚨重磅!MiniMax M3.1-Flash 预览版疑似已上线 MiniMax Code!推理等级单独成菜单:low / medium / high / xhigh / max。目前还没有官方公告,属于先露在产品里的灰度上线。" (訳:「大ニュース!MiniMax M3.1-Flashのプレビュー版がMiniMax Codeで公開された模様。推論レベルは独立したメニューになっていて、low / medium / high / xhigh / max。公式発表はまだなく、製品内で先に見えるグレー(段階的)リリース。」)
このロールアウトには、少しため息まじりの反応もありました。MiniMaxは動画や音楽のモデルを速いペースで出し続けていて、M(テキスト)シリーズは静かになっていたため、発表投稿への最多いいねの返信は愛情のこもった焦れったさとして読めました。
"You finally remembered the M series"
盛り上がりには前日譚もあります。数日前から、開発者たちは「Space Bunny」という無料のステルスモデルを使い倒して正体を推測していて、答えは発表の数日前に出ました。
"Confirmed, Space Bunny Alpha is Minimax M3.1"
つまり、盛り上がりは本物ですが、この「ローンチ」は製品内で先行する段階的なプレビューです。これに乗って作るか判断するなら、熱狂よりもこの違いのほうが重要です。価格もウェイトもないグレーロールアウトのプレビューは、GAモデルと同じ約束ではありません。
MiniMax M3.1 Flashの実像
ローンチの演出を取り除くと、プラットフォームのドキュメントは中身についてはっきり書いています。対応モデル表では、M3.1 Flashは「frontier multimodal coding model with 1M context window and tunable thinking depth」と説明され、エージェント的な推論、ツール利用、コーディング、構造化されたタスク実行向けとされています。入力はテキスト、画像、動画です。
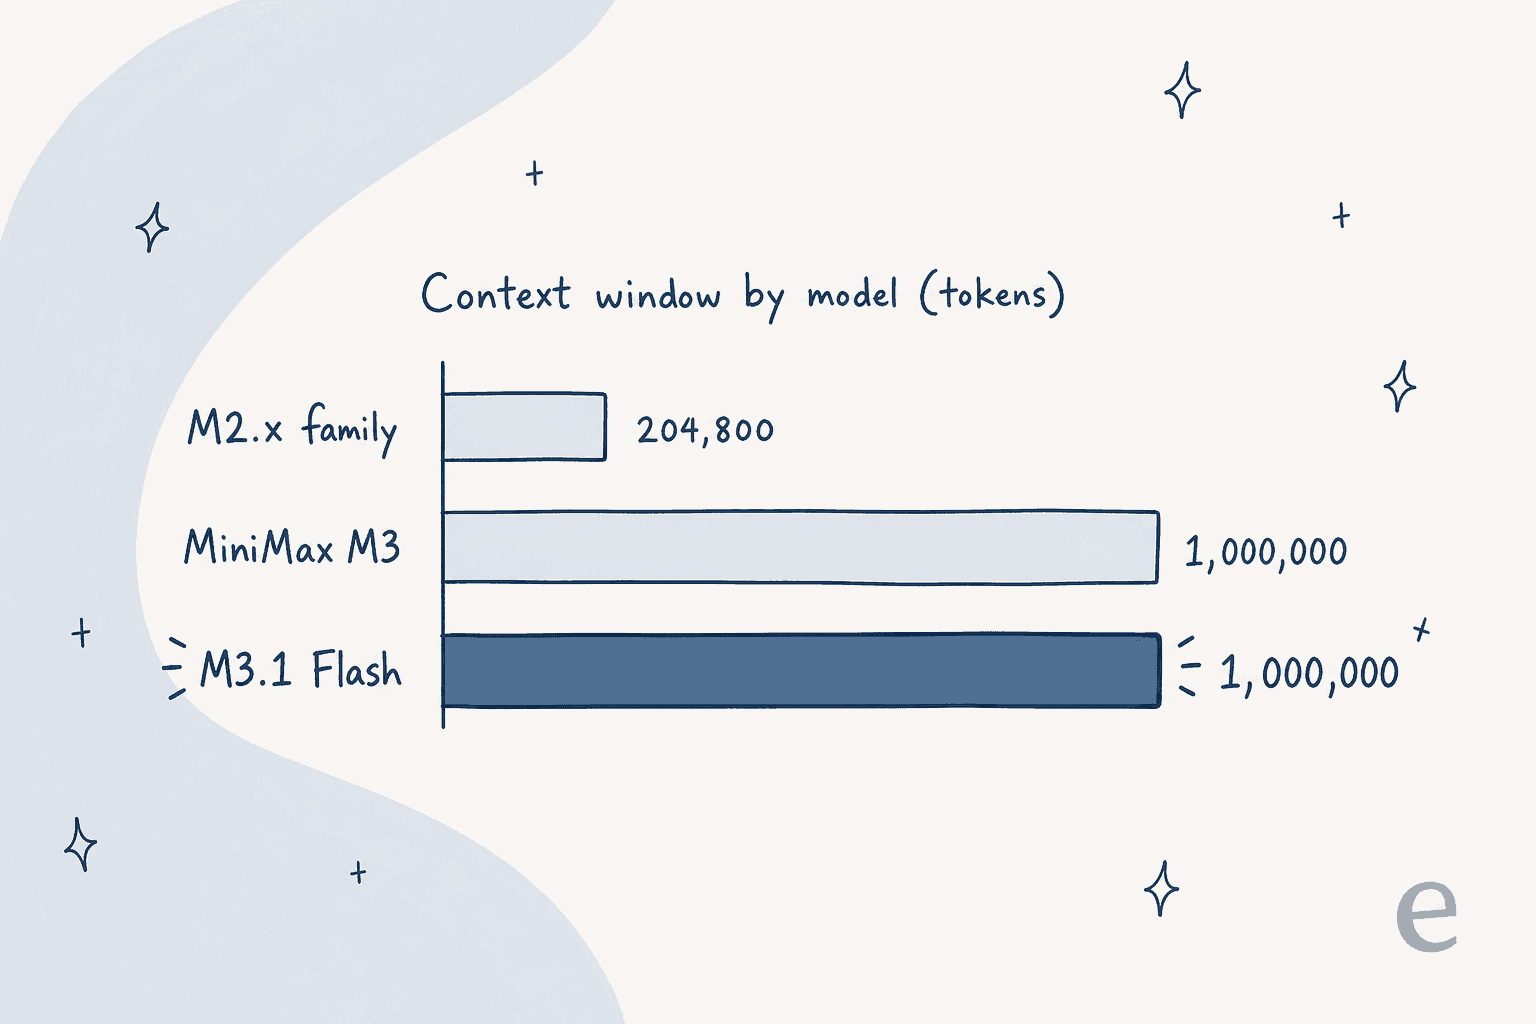
1Mコンテキストが目玉スペックで、Mシリーズの中では誇張ではない本物の飛躍です。M2ファミリー全体が204,800トークンで頭打ちだったのに対し、M3.1 Flashを含むM3世代はきれいに5倍です。
ドキュメントが明言していることと、していないことは次のとおりです。
| 項目 | MiniMax M3.1 Flash |
|---|---|
| モデルID | MiniMax-M3.1-Flash-Preview |
| コンテキストウィンドウ | 1,000,000トークン |
| 入力モダリティ | テキスト、画像、動画 |
| 思考 | デフォルトでオン、effortで調整可能、無効化不可 |
| 提供範囲 | Token Plan + MiniMax Codeのみ |
| オープンウェイト | なし(Hugging Faceカードなし) |
| パラメータ数 | 記載なし |
| スループット(tps) | 記載なし |
| トークン単価 | 未公表 |
この表は空欄について意図的に正直にしています。パラメータ数の記載も、公式のトークン/秒の数値も、M3.1 Flash固有のベンチマークスイートもありません。あるページがこのモデルを「428Bパラメータ」と言ったりベンチマークスコアを挙げたりしていたら、それはM3.1 Flashではなく親モデルM3から借りたものです。穴を取り繕うより、穴があると示すほうがよいと思います。
このモデルを特徴づける1つのつまみ:effort
M3.1 Flashについてドキュメントが強調し、M3には書かれていない唯一の機能が、思考の深さの調整です。モデルは回答の前に必ず推論し、どこまで深く考えるかを、low、medium、high、xhigh、maxを受け付けるeffort設定で制御します。省略するとデフォルトはmaxです。
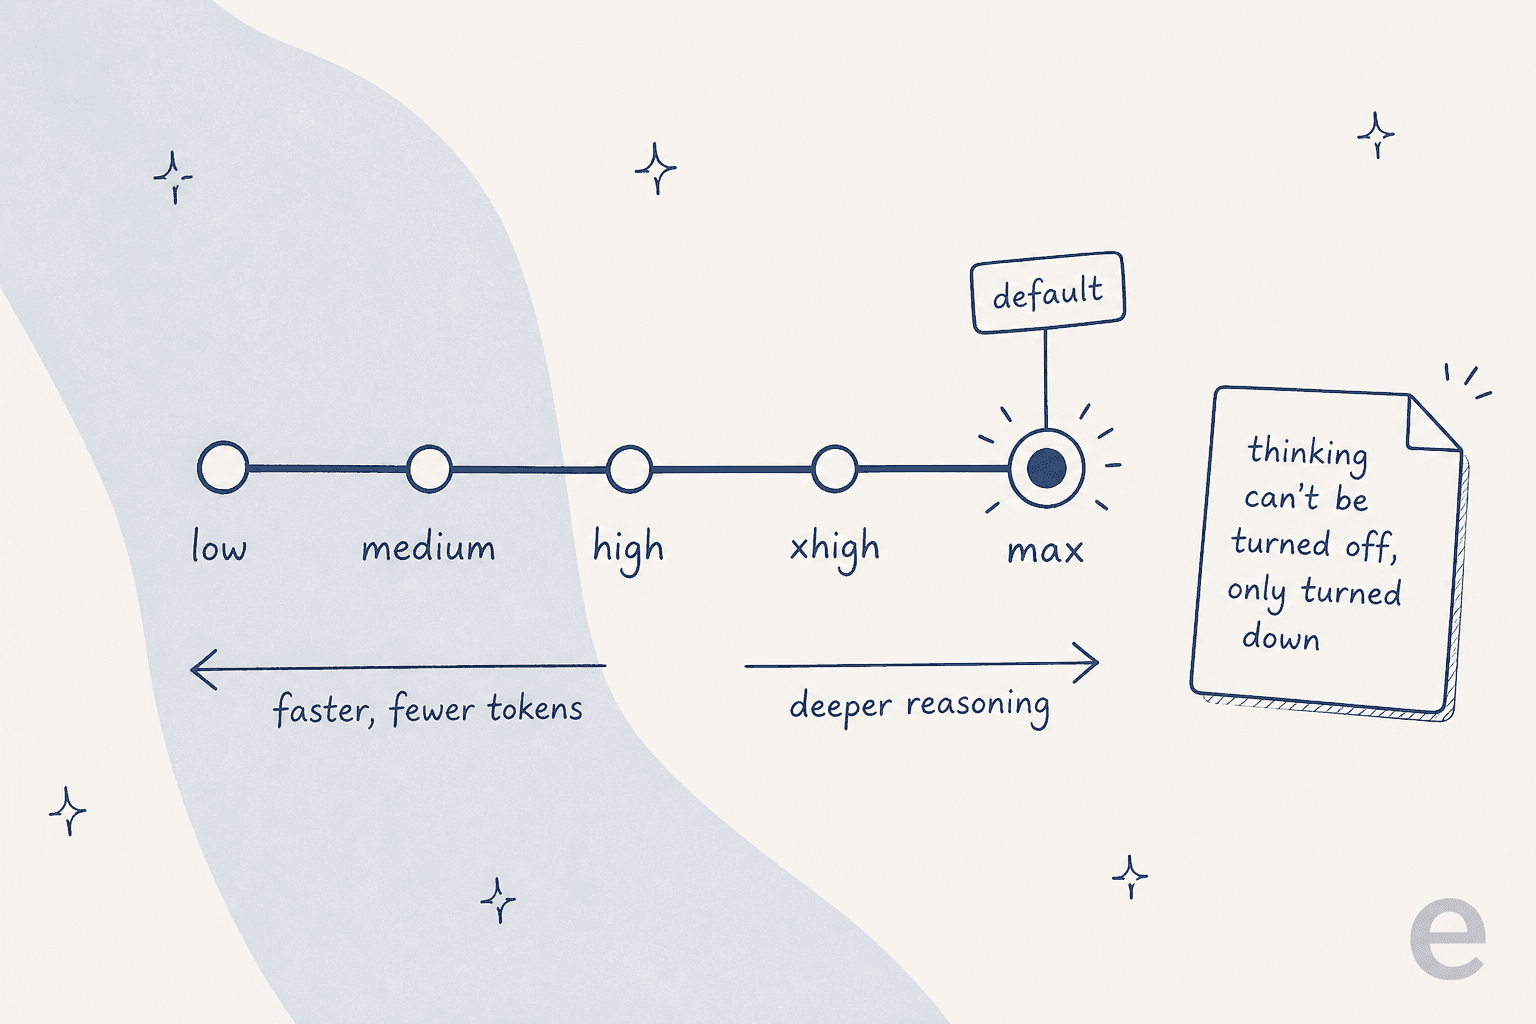
つまずきやすい点はここです。思考はオフにできません。thinking: {"type": "disabled"}やeffort: "none"を送ると、APIはrequires adaptive thinkingというメッセージとともに400を返します(ドキュメント)。レイテンシを下げたい、出力トークンを減らしたい場合はeffortをlowまで下げます。思考なしのモードはありません。これは明確な設計上の意見であり、レイテンシに敏感な経路に組み込む前に知っておくべきです。「Flash」を名乗るモデルで、デフォルトがmax推論というのは少し意外な選択で、名前から期待する安くて速い挙動は、自分から選んで有効にする必要があるということです。
実際に速いのか
MiniMaxはスループットを公表していないため、これまで得られている実測の速度データは、初日に試した開発者からのものだけです。最もよく引用される計測では、デコード速度は堅実だがカテゴリ最速ではない範囲でした。
"MiniMax-M3.1-flash-preview is hanging around 90 - 110 t/s range for decode. It's fast, love seeing it, def faster than MiMo-v2.6-flash but not as fast as deepseek-v4.1-flash"
これが正直な位置づけです。速く、一部のFlash級より上で、他には及ばない。そして、生のデコード速度を称えるべきかどうかについては、全員が納得しているわけではありません。
"Decode speed is not equivalent to fast. The model is slow for the quality in my opinion, numbers dropping soon!"
この懐疑派の指摘には一理あると思います。デフォルトがmax effortで、考えるのをやめられないモデルは、回答の前に大量の推論トークンを生成するため、実際のタスクでは、見出しのトークン/秒の数字が示すより遅く感じられます。本当に知りたいのは「1秒あたり何トークンか」ではなく「出荷できる正しい答えが得られるまでどれだけかかるか」であり、そのベンチマークはM3.1 Flashではまだ誰も実施していません。
その下にあるアーキテクチャ
M3.1 Flashについて、ドキュメントは内部構造を改めて説明していません。そのためアーキテクチャは、確認済みのM3.1 Flashの仕様ではなく、M3世代から引き継いだものとして扱うのが妥当です。M3系列はMiniMax Sparse Attention(MSA)を導入しました。これは100万トークンのコンテキストを、遅すぎて使えないものではなく実用的なものにするスパースアテンション設計です。
この長さのコンテキストでスパースアテンションがなぜ重要かは、標準的なグループドクエリアテンション(GQA)とのMiniMax自身の比較が最も明快に示しています。
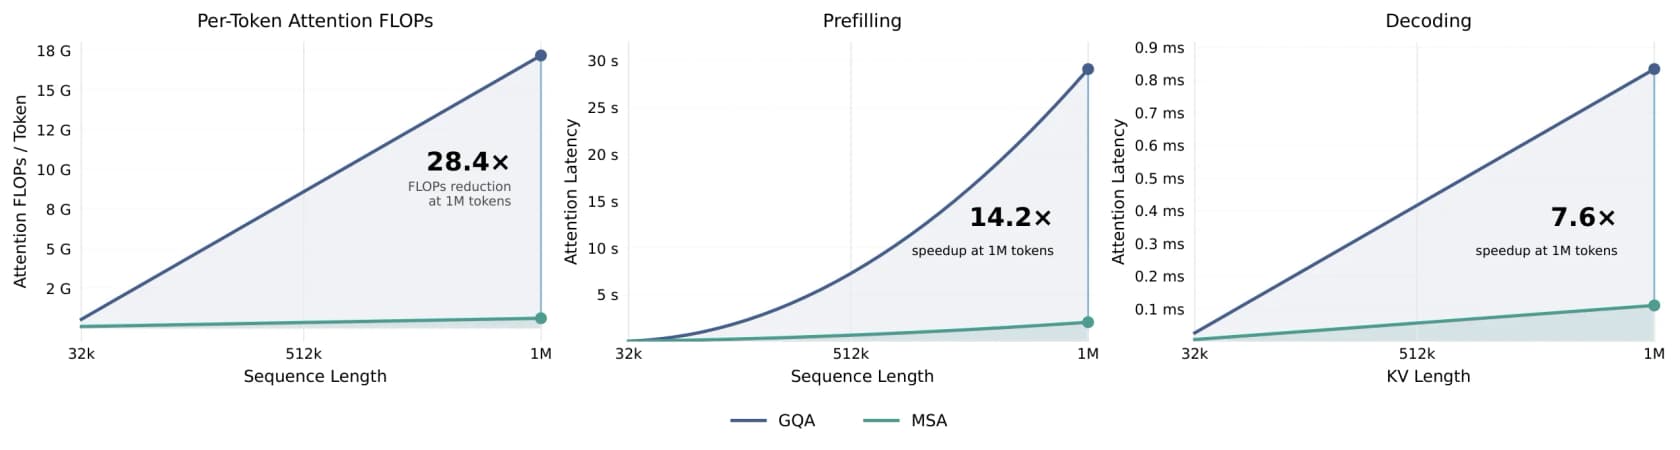
100万トークン時、MiniMaxの図では、標準アテンションに比べてMSAがトークンあたりのアテンション計算を約28倍削減し、デコードを約7.6倍高速化しています。これはM3世代の数値です。M3.1 Flashも同じ1Mウィンドウを持つため、ほぼ確実に同じアーキテクチャに依拠していると思いますが、MiniMaxが公表するまでは、M3.1 Flashの実測スペックとして引用するのは控えます。
料金
ここがM3.1 Flashが本当に異例な点です。どこにもトークン単価がありません。従量課金の表にもなく、MiniMax自身のドキュメントも当面はToken PlanとMiniMax Codeでのみ利用可能と述べています。したがって実際のコストは、サブスクリプション料金を利用量で割ったものです。
こちらがToken Planで、テキスト、画像、音声で共有されるクォータです。
| プラン | 月額 | 年額(2か月分無料) | 月あたりM3トークン(目安) | 動画生成 |
|---|---|---|---|---|
| Plus | $20 | $220 | 約17億 | なし |
| Max | $50 | $550 | 約51億 | 1日3クリップ |
| Ultra | $120 | $1,320 | 約125億 | 1日5クリップ |
前払いのクレジットオプション(5,000は$5、25,000は$25、100,000は$100、有効期間は1年)もあり、無料のLLM枠はありません。クォータは5時間ごとと週ごとのローリングウィンドウでリセットされ、月の未使用分は繰り越されません。
公開APIが最終的にいくらになるかの感触をつかみたいなら、1Mコンテキストの兄弟モデルMiniMax M3が従量課金で提供されています。これはM3の料金でありM3.1 Flashのものではありませんが、この構造が今後の予告になっている可能性が高いです。
| MiniMax M3(スタンダード層) | 入力 | 出力 | キャッシュ読み取り |
|---|---|---|---|
| 入力 ≤ 512K | $0.30 /M | $1.20 /M | $0.06 /M |
| 入力 > 512K | $0.60 /M | $2.40 /M | $0.12 /M |
後で覚えておきたい構造上の点が2つあります。512K入力を境にそれ以上は料金が2倍になること、そしてスタンダード料金の1.5倍のPriorityサービス層があることです。つまりこの階層としては安いものの、長いコンテキストの割増があらかじめ組み込まれています。
実際の動かし方
プレビューにしては、アクセスは意外なほど開発者に優しいです。M3.1 Flashは2つのプロトコルに対応しています。https://api.minimax.io/anthropicのAnthropic互換エンドポイント(MiniMaxの推奨経路で、thinkingブロック付き)と、https://api.minimax.io/v1のOpenAI互換エンドポイントです。effortフィールドは、どちらを使うかで置き場所が変わります。AnthropicのAPIではoutput_config.effort、OpenAIのAPIではreasoning_effortです。
AnthropicとOpenAIの両方に互換性があるため、既存のエージェント型コーディングツールをそのまま向けられます。MiniMaxは、Token PlanでClaude Code、Cursor、Codex CLIなどに対応しているとしており、別のAPIキーは不要です。「Flash + プレビュー」の組み合わせが狙う実際のユースケースはこれで、日常のコーディングやエージェントループ向けの安価で高速なデフォルトモデルを、開発者が普段使っているツールの中で動かすことです。
こうしたモデルの位置づけ
ここで冒頭の見方に戻ります。M3.1 Flashは、大きなコンテキストウィンドウと思考ダイヤルを備えた高速なエンジンです。それはインフラです。エンドポイントとして公開された素の能力であり、その役割では本当に優れています。ただし、エンドポイントはあなたの会社を知らず、ヘルプデスクの中にも座っておらず、仕事を最初から最後まで受け持つこともしません。その周りの部分は、結局自分で作る必要があります。
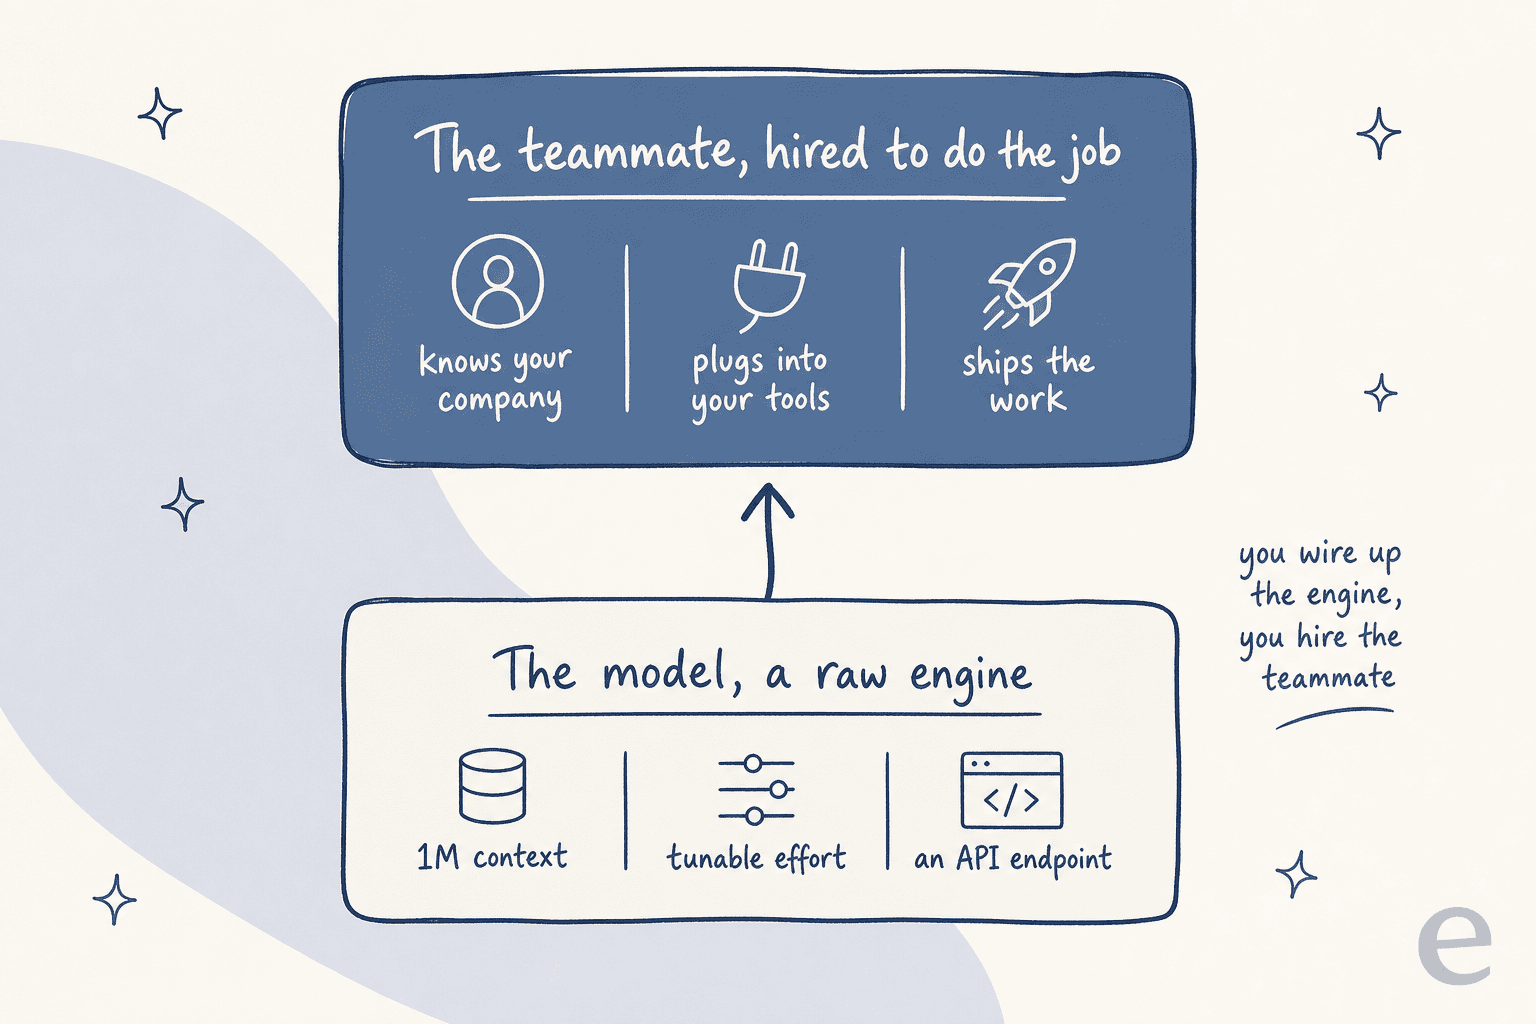
「高性能なモデル」と「実際に仕事が片づくこと」の間のこのギャップこそ、eeselが存在する理由のすべてです。eeselはAIチームメイトのプラットフォームです。モデルと空のエディタを渡すのではなく、特定の仕事に向けてすぐ働けるチームメイトを採用します。現在のラインナップは、既存のサポートキューに参加するAIヘルプデスクチームメイトと、あなたの文体で記事をリサーチして下書きするAIブログライターです。どちらも最初から自分の役割のやり方を心得ていて、すでに使っているツールにつながります。
ターミナルで暮らしているなら、MiniMaxのようなドキュメントページを読んだ後に最もなじみ深く感じるのがeesel CLIでしょう。ダッシュボードと同じチームメイトをコマンドラインから操作するもので、UIを一度も開かずに、ヘルプデスクの接続、ナレッジのアップロード、オートメーションの設定、保留中のアクションの承認ができます。すべてのコマンドはJSONを出力し、エラーは構造化された{error, hint, retryable}オブジェクトで返るため、Claude Code、Cursor、Codexのようなコーディングエージェントがhintフィールドを読んで次に何を実行するか判断し、セットアップ全体を進められます。すべてのワークスペースはMCPサーバーとしても機能するので、M3.1 Flashを呼び出している同じエージェントがeeselも呼び出せます。考え方は単純です。モデルは自分で組み込むエンジン、チームメイトは採用する相手です。
eeselを試す
M3.1 Flashに期待しているのが、APIの呼び出しに答えるだけでなく、AIに実際の仕事をさせたいからなら、その最後の一歩を担うのがeeselです。過去のチケットとヘルプセンターを読み込ませれば、AIヘルプデスクチームメイトが数分で実際の返信の下書きを始めます。あるいはAIブログライターにトピックを渡せば、リサーチから下書き、図版まで、あなたの文体で1本の記事を仕上げます。この記事もそうして作られました。
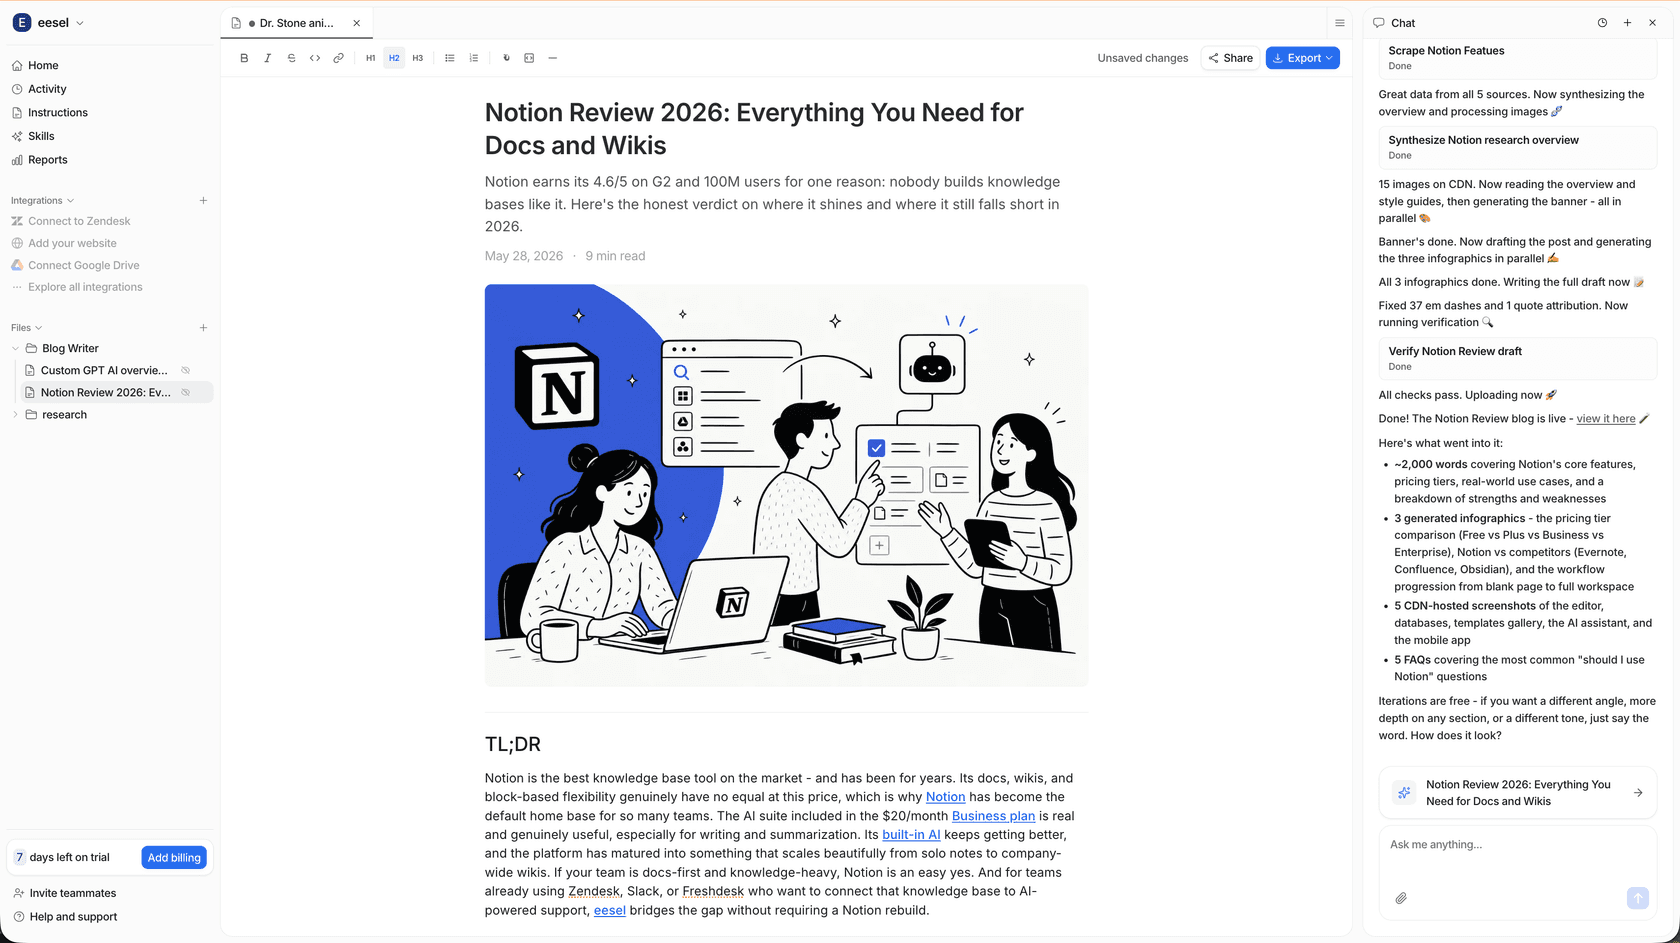
何より、導入を決める前に動くところを確認できます。eeselはまずあなた自身の履歴に対して動くので、デモではなく実際のチケットで品質を確かめられます。無料で始められ、クレジットカードも不要です。モデルを借りることと、チームメイトを採用することの違いを、ご自身で確かめてください。
よくある質問
MiniMax M3.1 Flashとは何ですか?
MiniMax-M3.1-Flash-Preview)は、MiniMaxのMシリーズ最新モデルです。1,000,000トークンのコンテキストウィンドウと調整可能な思考の深さを備えたマルチモーダルのコーディングモデルで、2026年9月27日にMiniMax CodeとToken Plan内でプレビューとして登場しました。高速な日常のコーディングやエージェント作業向けです。こうしたモデルにAPIの向こう側で待機させるのではなく実際の仕事をさせたいなら、eeselのようなAIチームメイトがそれを仕事に変える層になります。MiniMax M3.1 Flashの料金はいくらですか?
MiniMax M3.1 Flashはオープンソースですか?Hugging Faceにありますか?
M3.1 FlashとMiniMax M3の違いは何ですか?
MiniMax M3.1 Flashで思考をオフにできますか?
effort: "none"やthinking: disabledを送ると400エラーが返ります。レイテンシやトークン使用量を減らしたい場合は、思考をオフにするのではなくeffortのレベルを下げてください。

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.