Qwen Image 2.1 はAlibabaの最新のオープンウェイト画像モデルで、注目すべきは小さくなった点です。ビジュアルジェネレーターは約20Bパラメータからわずか7Bに縮小し、コンシューマー向けGPUで動作します。それでいて、テキストから画像への生成、最大10枚の参照画像による編集、ネイティブ2K出力を1つのモデルでこなします。最大の特徴はネイティブ透過で、本物のアルファチャンネルを持つRGBA画像を生成・編集できます。以前はこれに別のQwenモデルが必要でした。
見出しでは誰も触れていない落とし穴があります。2.1はオープンウェイトであって、オープンソースではありません。以前のQwen-ImageはApache 2.0でしたが、今回は研究用途限定のライセンスです。つまりダウンロードして試すことはできても、Alibabaからの別途許諾なしに製品へ組み込むことは法的にできません。趣味で使う人や研究チームにとっては脚注程度の話です。しかし有料の製品をこの上に作る人にとっては、それがすべてです。
コンテンツを作る材料として画像を生成するのであって、画像そのものが最終成果物ではないなら、どのみちモデルは仕事の半分にすぎません。私はeeselでAIチームメイトを作っています。AIブログライターは、素材とリサーチの山を完成した公開記事に仕上げるチームメイトで、画像モデルが担当しない部分を受け持ちます。
Qwen Image 2.1 とは何か
Qwen Image 2.1 は、AlibabaのQwenチームによるQwenの画像モデルシリーズの最新リリースで、2026年9月20日に登場しました。多くのツールが別々に扱う2つの作業、つまりテキストプロンプトからの画像生成と既存画像の編集を統合したオープンウェイトモデルです。どちらも、ダウンロードして自分で動かせる7Bパラメータの単一モデルに収まっています(Qwenブログ)。
ブログはこのリリースを4点で説明しています。コンパクトで効率的であること、統合モデルでネイティブ透過を実現すること、より多彩な編集ができること、よりリアルな質感を描けることです。このうち、できることを実際に変えるのはサイズの縮小と透過の2つなので、そこに最も時間を割きます。
名前についても一言。コミュニティが1日で混乱させてしまったので触れておくと、公式リポジトリ、モデルカード、ブログはいずれもQwen-Image-2.1と呼んでおり、「Qwen-Image-2509」や「2512」ではありません。ウェイトを取得する場合のHugging Face IDは Qwen/Qwen-Image-2.1 です(HFモデルカード)。
本当のニュース:サイズが3分の1になった
従来のQwen-Imageは約20Bパラメータのモデルで、BF16の画像トランスフォーマーが40.9GBありました。Qwen Image 2.1 のビジュアルジェネレーターは7Bで、BF16で14.2GB、INT8版で7.26GBです。これはリリース当日にある開発者が投稿したまとめで、今回の発表全体で最も役に立つ数字です。
"Qwen's Image 2.1 released but it come with lots of improvements but just as many caveats. The old Qwen-Image-2512 was a 20B model with a massive 40.9GB BF16 image transformer. But the new Qwen-Image-2.1 comes with … 7B visual generator, 14.2GB BF16, 7.26GB INT8"
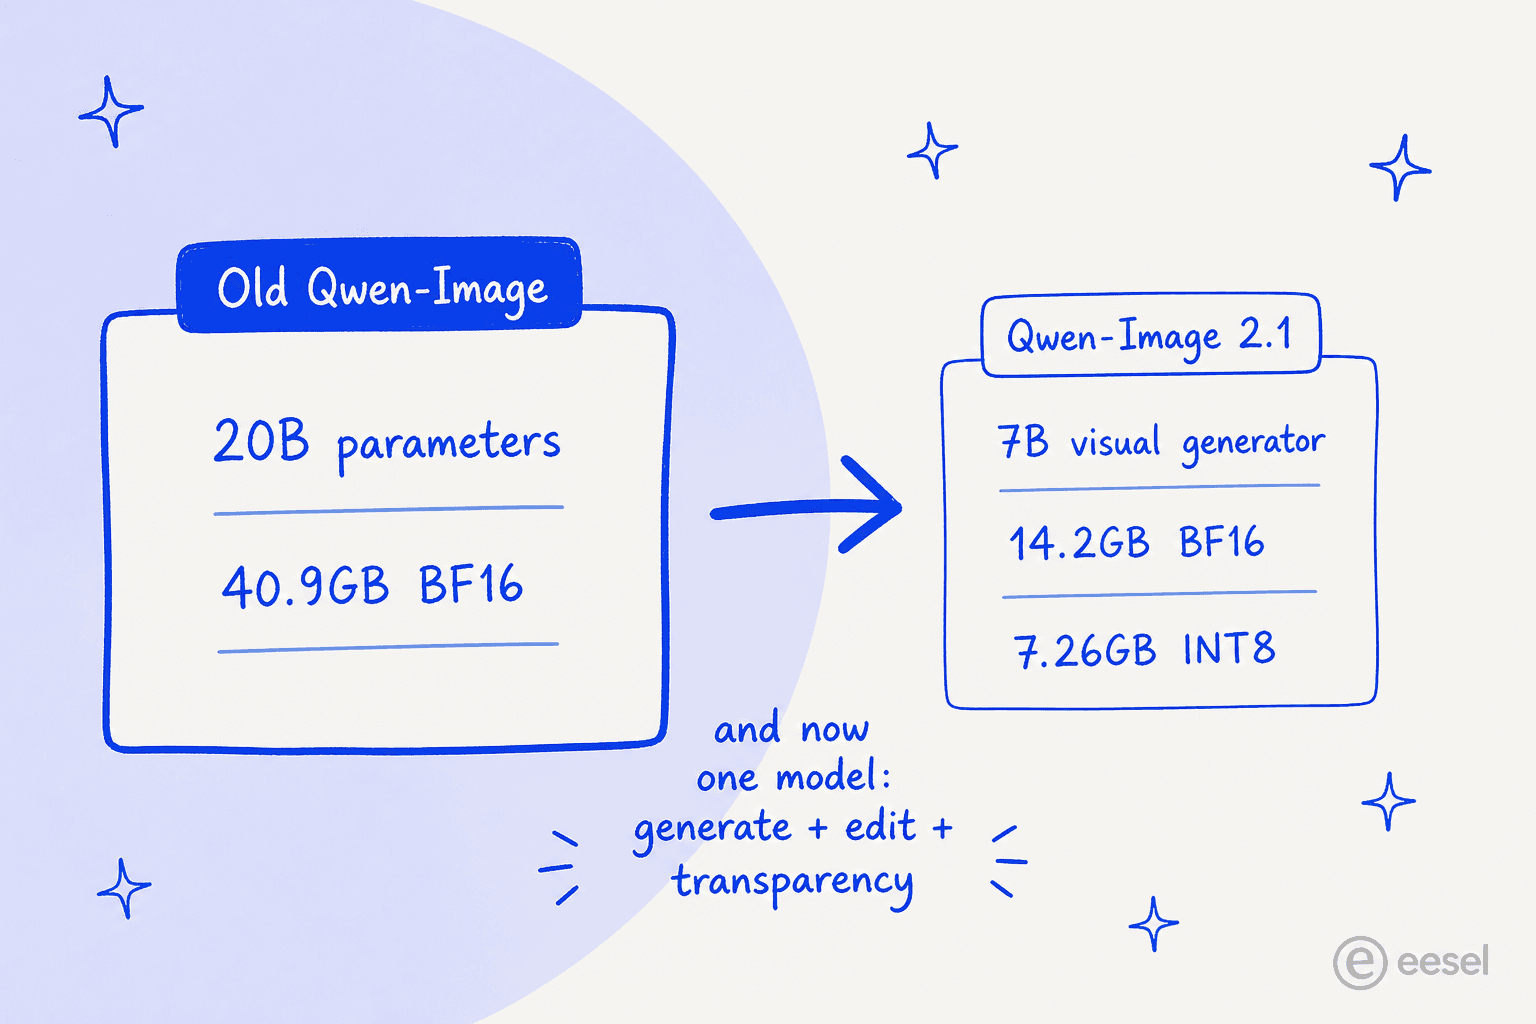
なぜサイズがそこまで重要なのでしょうか。モデルが「クラウドGPUを借りる」領域から「デスクトップに入っているカードで動く」領域へ移るからです。あるテスターは、約3.05 GiBのVRAMで動かす完全なセットアップを公開しました。
"I just published my full Qwen Image 2.1 guide, including a setup that generated images using just 3.05 GiB of VRAM. CPU offload makes a big difference: 512×512 at 3.05 GiB VRAM, using about 15.2 GiB of system RAM. 1024×1024 at 6.14 GiB VRAM with the text encoder on CPU."
参考までに、この品質帯の画像モデルの多くは、快適に動かすのに24GB以上を求めます。空きが4〜6GBのカードで使える出力が得られるかどうかは、「今夜試せる」と「A100をレンタルして立ち上げなければならない」の差になります。
ネイティブ透過こそ、実際に使われる機能
これが目玉の機能で、デモ用の見せ技ではなく本当に役立ちます。Qwen Image 2.1 は透明(RGBA)画像をネイティブに生成・編集し、プロンプトから、通常の画像を出すか本物のアルファチャンネルを持つ画像を出すかを判断します(Qwenブログ)。
2025年12月、Qwenはこれを Qwen-Image-Layered という別モデルとして公開しました。2.1ではメインモデルに統合されたため、2つのチェックポイントを使い分ける必要はありません。具体的には次のことができます。
- テキストから直接透明画像を生成する。複数の透明要素を組み合わせた構図も含みます。
- 透明画像を、背景の透明を保ったまま編集する(被写体の表情を変えても切り抜きは維持)。
- 透明レイヤー内のテキストを編集する。
- 通常のRGB写真から被写体をRGBAの切り抜きとして取り出す。
「透明背景のロゴ」を生成したら、本物のアルファチャンネルではなくチェック柄がピクセルに焼き込まれていた、という経験があれば、これがなぜ大きいかわかるはずです。モデルカードには、そのための推奨プロンプトの型まで載っています。たとえば "This is an RGBA image with transparency … the background is transparent" のような形です(HFモデルカード)。デザイナーの1日からPhotoshopの作業を1つ静かに消してくれる類の機能です。
動かす負荷が軽い理由:アーキテクチャ
ここがサイズ縮小を説明する部分です。Qwen Image 2.1 のビジュアルジェネレーターは32層のシングルストリーム拡散トランスフォーマー(DiT)で、初代Qwen-Imageのより重いデュアルストリームMMDiT設計ではありません(機能の詳細解説)。効率を保つ工夫は2つあり、主に編集時に効果を発揮します。
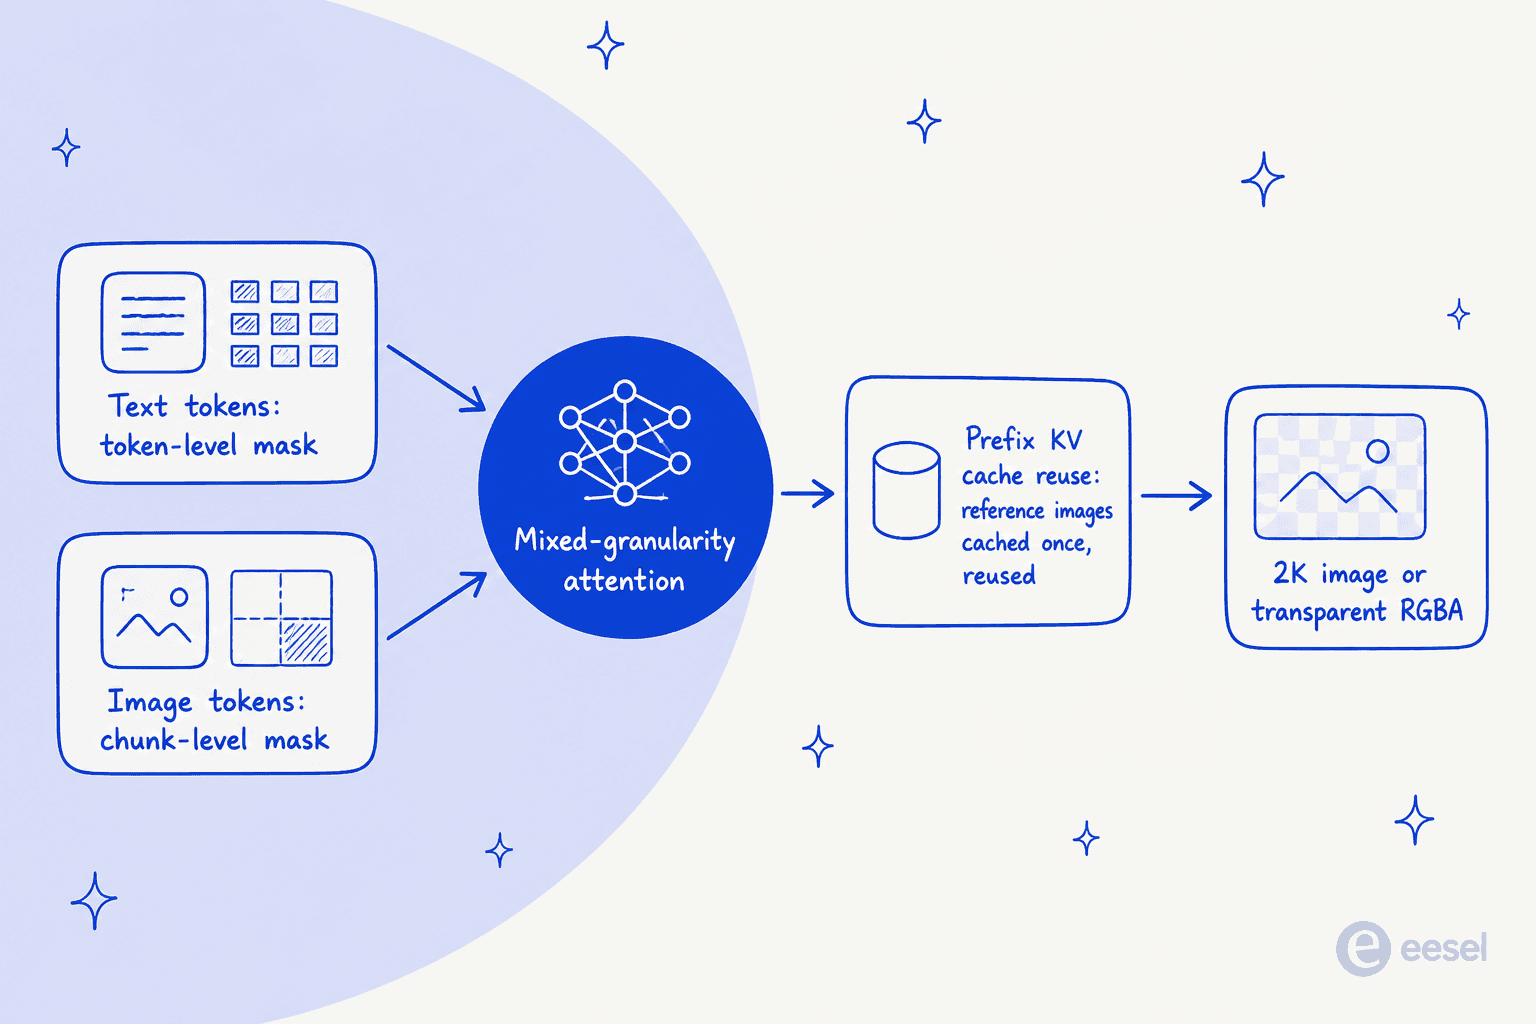
1つ目は混合粒度アテンションです。テキストトークン(システムプレフィックスと編集指示)にはトークン単位の因果マスクを使い、画像生成にはより粗いチャンク単位のマスクを使います。2つ目はプレフィックスKVキャッシュの再利用です。入力画像と編集指示は固定のコンテキストなので、モデルは最初のステップで一度だけ計算し、毎ステップ再計算する代わりにキャッシュを再利用します(Qwenブログ)。これが、小さなモデルで最大10枚の参照画像による編集を現実的にし、GPUを静かに溶かさずに済ませている仕組みです。
モデルを使うだけなら、これを気にする必要はありません。ただ、紙の上では両立しなさそうな「7B」と「10枚の参照で編集」が同時に成り立つ理由がこれです。
編集:最大10枚の参照と柔軟な領域選択
2.1が最も踏み込んでいるのは編集面です。1回の合成で最大10枚の参照画像を受け付けます(Qwenブログ)。Qwen自身の例には、6枚の個別ポートレートから組み立てた集合写真、5つの入力(モデル、服、靴、バッグ、帽子)で作るバーチャル試着、10枚の家具画像から作る部屋全体などがあります。
編集をどこに適用するかの指定には3つの方法があります。色付きの円で複数の領域を同時に示す、注釈を直接描き込む、元画像と別のマスクを2つの入力として渡す、の3つです。マスクを使う方法は元の内容を丸ごと保てるので、フレーム内の他の部分がずれては困るピンポイントの編集に向いています(Qwenブログ)。Qwenはまた、編集をまたいで人物の同一性を保つ精度や、商品のテキスト・質感・形状を保つ精度が向上したと主張しています。地味ですが、ECの画像を扱う人にとっては重要なポイントです。編集ワークフローを特に比較したい場合は、Qwen image editの解説記事でその面をさらに掘り下げています。
テキスト描画は、今もQwenの強み
Qwen-Imageファミリーは、画像内で読みやすい文字を描くのが昔から並外れて得意で、2.1もそれを維持しています。ブログによれば、モデルは文字の内容だけでなく、書体のスタイル、レイアウト、全体構図の中での収まり方も考慮します(Qwenブログ)。
正直な留保を1つ。2.1の発表は、多言語や中国語のテキストについて明確な主張をしていません。ファミリーとして中国語の描画が強いことは知られていますが、例示のプロンプトは英語です。そのため、多言語テキストは、誰かがきちんとベンチマークを取るまでは「このリリースで公式に約束されたもの」ではなく「おそらく引き継がれているもの」と考えるのがよいでしょう。マーケティングページが言っていないことを言ったかのように扱うより、こうした空白は指摘しておきたいと思います。
ライセンス:オープンウェイトであり、オープンソースではない
本格的なものを作る前に必ず読むべき点です。Qwen Image 2.1 はQwen Research License Agreementの下で公開されており、許諾は文字どおり「for non-commercial purposes only」です。商用利用には別途ライセンスが必要で、model-business@notice.qwencloud.com を通じて申請します。
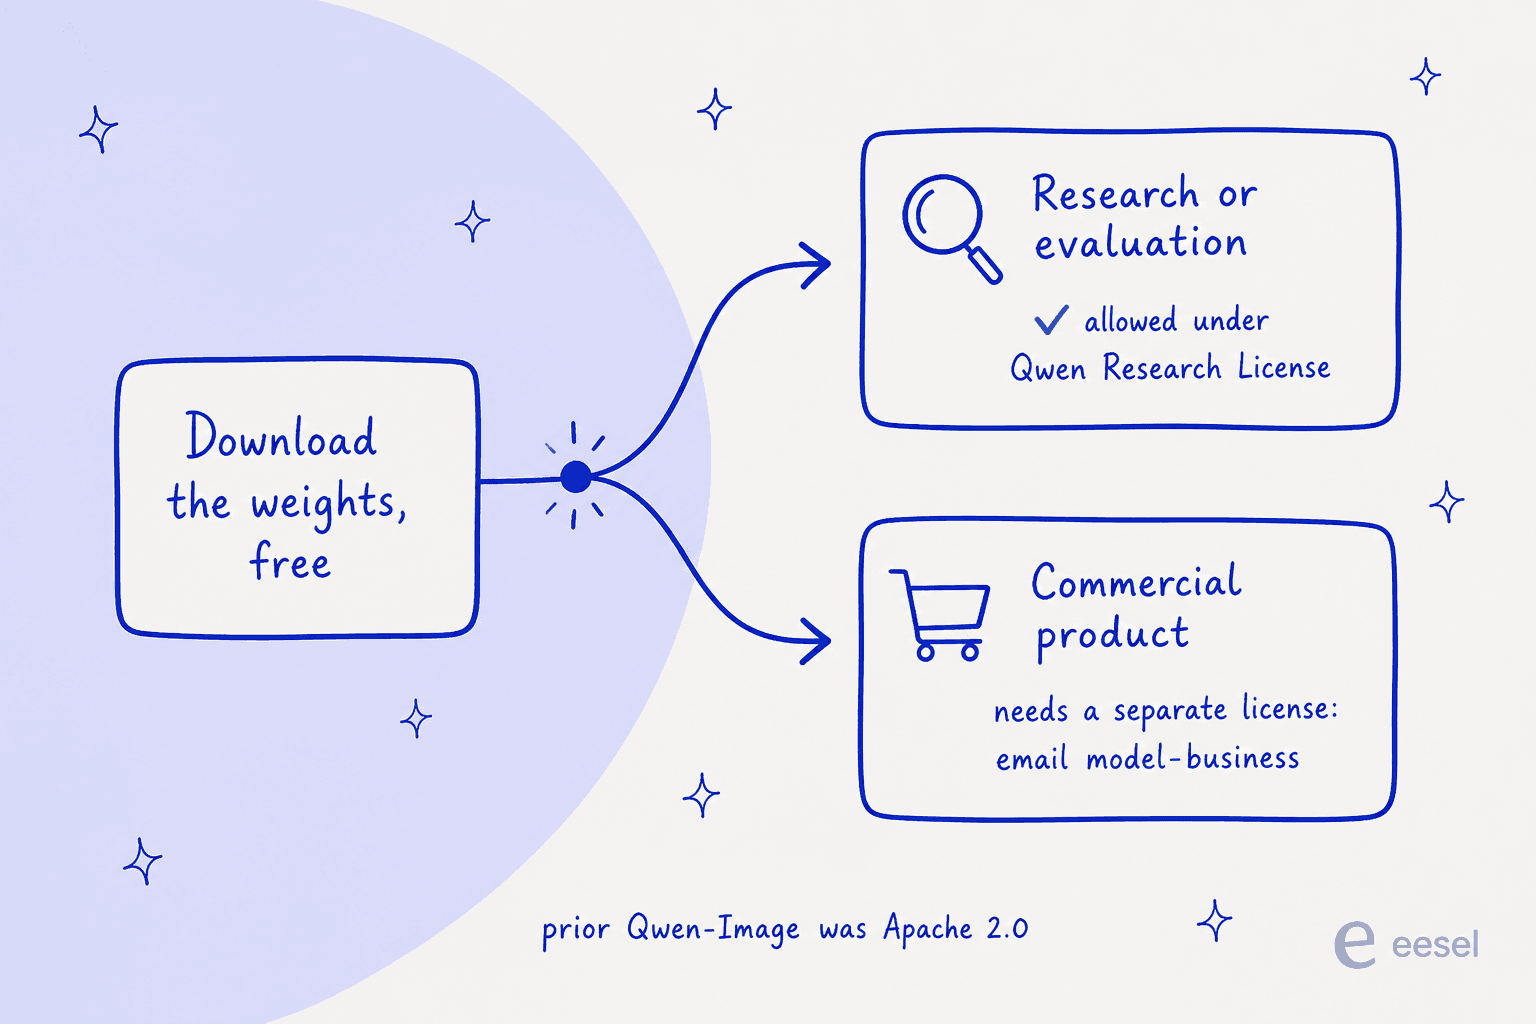
これは細かい話ではなく、実質的な変更です。以前のQwen-ImageはApache 2.0で公開され、事業の土台にすることも含めてほぼ何でもできました。2.1はそれを研究と評価のみに戻しました。セルフホスト、改変、再配布(帰属表示とライセンスの同梱が条件)は可能ですが、出力にお金が絡んだ時点で、無償の許諾の範囲外になります。
これは価格まわりの小さな事情の説明にもなります。この記事の執筆時点で、fal.aiやReplicateなどのサードパーティホストが掲載しているのはQwen Image 2.0で、2.1ではありません。最も可能性が高い理由はまさにこのライセンスで、2.1を提供する商用ホストには別途の許諾が必要になるからです。サードパーティのプラットフォームで安価な2.1のAPIエンドポイントを期待していたなら、その選択肢はまだほぼありません。
実際に使うといくらかかるか
価格には説明が必要なひねりがあります。「Qwen Image 2.1はいくらか」にはすっきりした答えがないからです。モデル自体はダウンロードして動かすのが無料です。有料API向けの qwen-image-2.1 というSKUはありません。Alibaba CloudのModel Studioは商用の画像APIを qwen-image-3.0 のモデルIDで提供しているので、最も近い「公式価格」は別バージョンのものです。
| 経路 | コスト | 備考 |
|---|---|---|
| Hugging Face Spaceデモ | 無料 | 2.1そのもののモデルの公式ホスト型デモ。待ち行列に制限あり |
| Qwen Chat | 無料 | 画像の生成・編集を内蔵。提供バージョンは非公開 |
| HF / ModelScope のウェイト | ダウンロード無料 | Qwen Research License(非商用)。GPUは自前で用意 |
公式 qwen-image-2.1 API | 提供なし | Model Studioは3.0のIDで画像生成を提供 |
qwen-image-3.0 API(最も近い) | 1画像あたり入力 $0.003 / 出力 $0.03 | 参考のみ。2.1ではない。無料枠は10画像、90日間 |
qwen-image-3.0-pro API | 1画像あたり入力 $0.003 / 出力 $0.04-$0.075 | 2k出力は高くなる。無料枠は10画像 |
| fal.ai / Replicate | 2.1の掲載なし(2.0のみ) | 非商用ライセンスで阻まれている可能性が高い |
つまり、Qwen Image 2.1 の実際のコストは「無料、ただし自分のGPU時間はかかる」か、「Alibabaと商用ライセンスを交渉した結果次第」のどちらかです。有料APIラインとの直接の価格比較は、Qwenの料金の記事に完全な表があります。
反応はどうか
初期の反応は、オープンモデルにありがちな留保を伴いつつも好意的です。広く共有されたある反応は、このモデルがコンテンツフィルタリングの緩い状態で出荷されていると指摘しました。それは用途次第で、長所にも弱点にもなります。
"In case you're wondering, Qwen Image 2.1 is quite uncensored. It has decent anatomy understanding and can do various positions."
この投稿は調べた中で最も反響が大きく(3,604いいね)、オープンモデル界隈が何を気にしているかを物語っています。それ以外では、参照画像による編集機能がクリエイターに最も試されたがられているようで、コミュニティのまとめは慎重な楽観に落ち着いています。編集ツールへの需要は強く、競合への圧力として歓迎されていますが、品質についてはベンチマークが出るまで判断を保留する声もあります。
この最後の点については、今のところベンチマークの主張は少し疑ってかかってください。Qwenは、7Bモデルがより大きなオープン・クローズド両方のモデルと並ぶ性能だと述べていますが、その比較はQwen独自のQwen-Image-Benchで行われており、ブログは確認できる数値スコアのないチャートとして公開しています(Qwenブログ)。ベンダーが自社のベンチマークで出した数字が間違っているわけではありませんが、独立した数字でもありません。「大手モデルに並ぶ」を確定事項と見なすのは、第三者による評価を待ってからにしましょう。
どんな人に向いているか
研究者、趣味で使う人、プロトタイプを作るチームなら、Qwen Image 2.1 は試して間違いなしです。無料で、ローカルで動かせるほど小さく、透過は本当に便利で、複数参照による編集はほとんどのオープンモデルより高機能です。ECやデザイン用の画像を作り、背景除去や透過アセットの生成にお金を払ってきたなら、ネイティブRGBA対応だけでも一晩試す価値があります。
商用製品を作るなら、まず立ち止まってライセンスを読んでください。モデルは優秀ですが、制約になるのは条件です。商用許諾の予算を確保するか、実際に出荷できるライセンスのモデルを探しましょう。たとえば、おすすめのAIコンテンツジェネレーターのまとめやNano Banana Proのレビューで紹介している、完全に商用利用できるホスト型の選択肢があります。
そして、モデルは仕事に見合った位置づけで考えましょう。画像モデルが作るのはアセットです。そのアセットがブログ記事、製品ページ、コンテンツパイプラインに使われるなら、生成は多くの工程の1つにすぎず、たいてい1週間を食いつぶす工程ではありません。
画像の周りのコンテンツにeeselを試す
良い画像を生成するのは楽しい10分間です。リサーチ、キーワード、素材の山を、ブランドに沿った完成済みの公開記事にするのは骨の折れる作業で、私が取り組んでいるのはそこです。eeselはAIチームメイトのプラットフォームで、採用できるチームメイトの1人がAIブログライターです。あなた自身の情報源から長文記事を下書きし、画像を差し込み、公開まで行うので、Qwen Image 2.1 のようなモデルは、面倒を見なければならないもう1つのツールではなく、コンテンツへの入力になります。
無料で始められ、ブログ生成が数回分含まれ、クレジットカードは不要です。すでに画像モデルがコンテンツのスタックに入っているなら、ブログライターはそれらを働かせるチームメイトです。