

SeedRealtimeは、ByteDance Seedのネイティブな音声・映像フルデュプレックスモデルで、2026年8月5日に発表されました。音声・映像・テキストが1つのアーキテクチャに入るため、モデルはカメラを見て、あなたの声を聞き、話します。それらはすべて同じループの中で行われ、いつ自分の発言の番が来るかを決める別の音声検出器はありません。実機デモが見せているのはスピードではなく参照解決で、「さっきのあのグラフ」が何を指すかをモデルが突き止めます。
発表時の報道が見落としていた部分がここにあります。ByteDanceがこれについて公開した数字はたった1つだけで、名前のない「カスケード型モデル」と比べて会話のペースに関する問題が半分に減ったという、自社による人間評価です。技術論文はなく、オープンな重みもなく、ベンチマーク表もAPIも価格もありません。Artificial Analysisの音声対音声リーダーボードにも載っておらず、AlibabaのQwenとStepFunはどちらも載っているため、これは中国の欠落ではなく、ByteDanceの提出の欠落です。
そして気まずい点として、SeedRealtimeが最適化している軸は、業界がすでにほぼ解決してしまった軸です。会話のダイナミクスにおける最高スコアは98.4%です。サポート業務を実際に解決する最高スコアは56.5%です。実際のキューに投入するものを探しているなら、私はeeselで3年以上にわたりAIエージェントが実際のサポートチケットを処理する様子を見てきましたが、ロールアウトが生き残るかどうかを決めるのは、ボットがいかに優雅に発言の番を取るかではありません。
SeedRealtimeの実体
SeedRealtimeは、SeedancやSeedream、Seeduplexと並んで、Seedのモデル一覧でGenMediaに分類されています。ByteDanceによる一文での説明は「音声・視覚・時間的情報をまとめて理解できる」ネイティブな音声・映像フルデュプレックスLLMで、部屋の中のどの物について話しているかを特定し、きれいな発言終了のサインを待たずに応答できるとしています。
「フルデュプレックス」という言葉はあいまいに使われがちなので、分解しておく価値があります。ハーフデュプレックスの音声モデルはトランシーバーのように動きます。あなたが話し、モデルが待ち、あなたが話し終えると、モデルが答えます。フルデュプレックスモデルは話しながら聞いているため、話を遮られたり、あなたが無言になったことに気づいたり、あなたが部屋の別の人と話していたから黙っていることにしたりできます。GPT Realtimeを含め、業界の大部分はこの2年で音声のフルデュプレックスに到達しました。SeedRealtimeの主張は、映像ストリームが別チャンネルとして後付けされるのではなく、同じデュプレックスのループの中にあるという点です。
発表の投稿は、その能力を3つの部分に整理しており、それぞれモデルに求めるものが異なります。
- 音声・視覚の統合理解。 画面に映っているものを使って同音異義語を解消し、複数の発言ターンにわたって視覚的な参照対象を追跡し、誰が何を言ったかが分かるように声を人物に結びつける。
- 主体的なインタラクション。 質問だけでなく、場面の変化に対しても行動し、文の途中でツール呼び出しを応答に織り込む。
- 会話のタイミング。 いつ発言し、一時停止し、控えるかを決め、すべての音を入力として扱うのではなく、並行する会話や背景雑音を除外する。
発表には7本のデモ動画が添えられています。食事の席にいる話者を識別する、四川の献立を翻訳する、河北博物館で立ちっぱなしの人に声をかける、エスプレッソの抽出を直す、ResNetの論文の一節を見つける、大興国際空港の雑音の中で誤作動に耐える、背景のざわめきの中で子どもの発音を指導する、といった内容です。良いデモ映像ではあります。しかし、これから説明するように、これが公開された証拠のすべてでもあります。
カスケード型音声スタックとアーキテクチャがどう違うのか
これまで使ったことのある音声アシスタントの多くは、リレー競走のような構造です。音声認識があなたの音声をテキストに変換し、視覚モデルが別途カメラの映像にキャプションを付け、言語モデルが両方の文字起こしを読み、音声合成エンジンが回答を読み上げます。音声検出器はこのチェーン全体の外側に置かれ、あなたの発言がいつ終わったかを判断します。
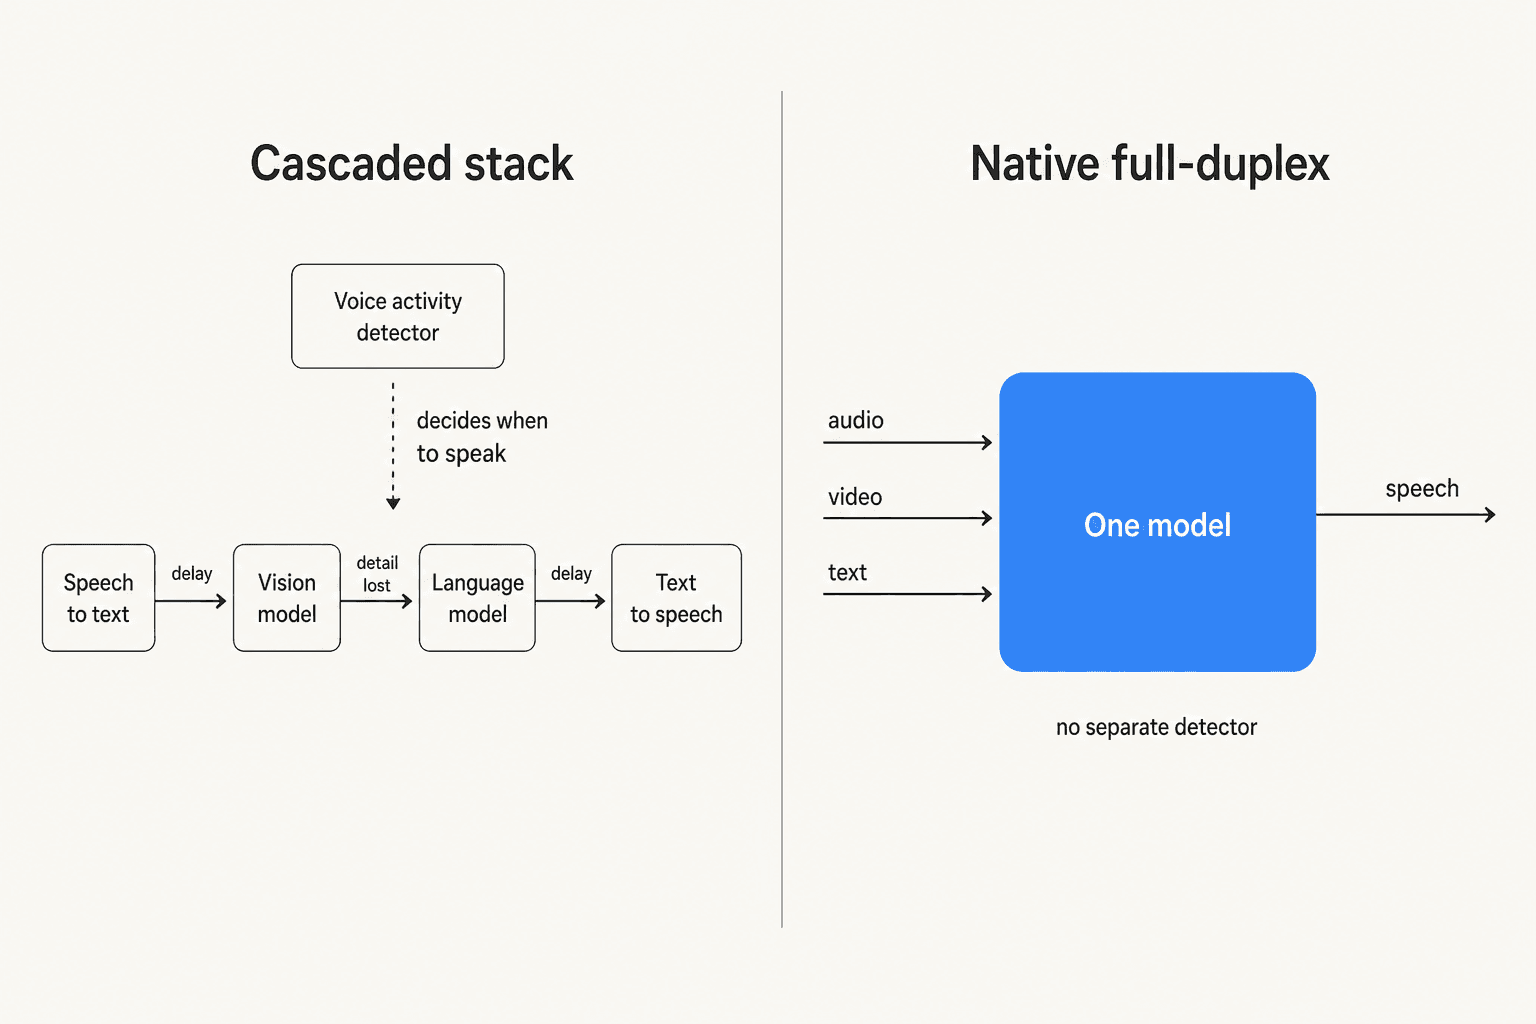
この設計には2つのコストがあり、ByteDanceはその両方を名指ししています。接合点が増えるたびに遅延が増え、情報が失われます。トーン、迷い、話しながら何かを指し示していたという事実、そうしたものは文字起こしを経由する間に一切残りません。SeedRealtimeの主張は、知覚、理解、意思決定、表現のすべてが連続的なストリームの上で1つのモデルの中で行われるため、途中でテキストに平坦化する必要がないというものです。低遅延は、1つの裏技からではなく、チャンク化された音声・映像入力、ストリーミング生成、量子化、推論の最適化から生まれています。
最も注目されていないのに最も鋭いアーキテクチャ上の詳細は、外部の音声検出器が存在しないということです。発言の順番を取るかどうかは、モデルがマルチモーダルな信号そのものから下す判断です。だからこそ博物館のデモはそもそも成立します。「この人はしばらく立ったままだ」というのは、誰かが声に出して言った文ではないからです。だからこそ空港のデモも見た目以上に重要です。自分で発言の順番を決めるモデルは、間違った判断もできてしまい、うるさい部屋での誤作動がまさにその失敗パターンだからです。
Xの要約アカウントは、OpenAIとの対比を英語の報道の多くよりも正確に表現しました。
"除了有视觉能力外,跟GPT-Live的委派推理方式不同的是 SeedRealtime将声音、画面、时序与表达纳入到同一个模型实时决策,听、看、理解、推理、说话全在一个模型里"
大意はこうです。視覚機能を追加したこと以上に、GPT Liveの委任型推論方式との違いは、SeedRealtimeが音・画面・タイミング・表現を1つのモデルに詰め込みリアルタイムで判断させる点にあり、聞く・見る・理解する・推論する・話すのすべてが同じ場所にあるということです。これは設計として公正な説明であり、発表を要約したアカウントによるもので、実際に試したアカウントによるものではありません。
ByteDanceが公開した唯一の数字
ベンチマーク表を探しに行って、見つかったのは1つの文でした。発表全体における唯一の定量的な主張は、エンドツーエンドの人間評価によって、カスケード型モデルと比べて会話のペースに関する問題が半減したことを示した、というもので、割り込み・遅延・誤作動についても質的な改善があったとされています。
この主張を真剣に受け止めても、検証を可能にするあらゆる軸においてまだ薄いままです。評価者の人数はありません。サンプルサイズもありません。名前の付いた評価データセットもありません。プロトコルもありません。そして基準となるのは「カスケード型モデル」という一般的なカテゴリであり、自分で測り直せる名前付きの競合ではありません。間違っていると言っているわけではありません。これはベンダーの主張であり、繰り返されるたびにそう明記されるべきだと言っているのです。
報道には他に2つの数字が出回っており、どちらも落とし穴です。エスプレッソのデモにある「2〜3秒」は、エスプレッソ抽出に関するモデルの助言であって、システムの遅延を示す数字ではありません。そして、SeedRealtimeの論文として広まったarXivのID、2508.02193は、まったく別のもの、つまりSeed Diffusionという離散状態の拡散コードモデルに属しており、音声や映像とは何の関係もありません。
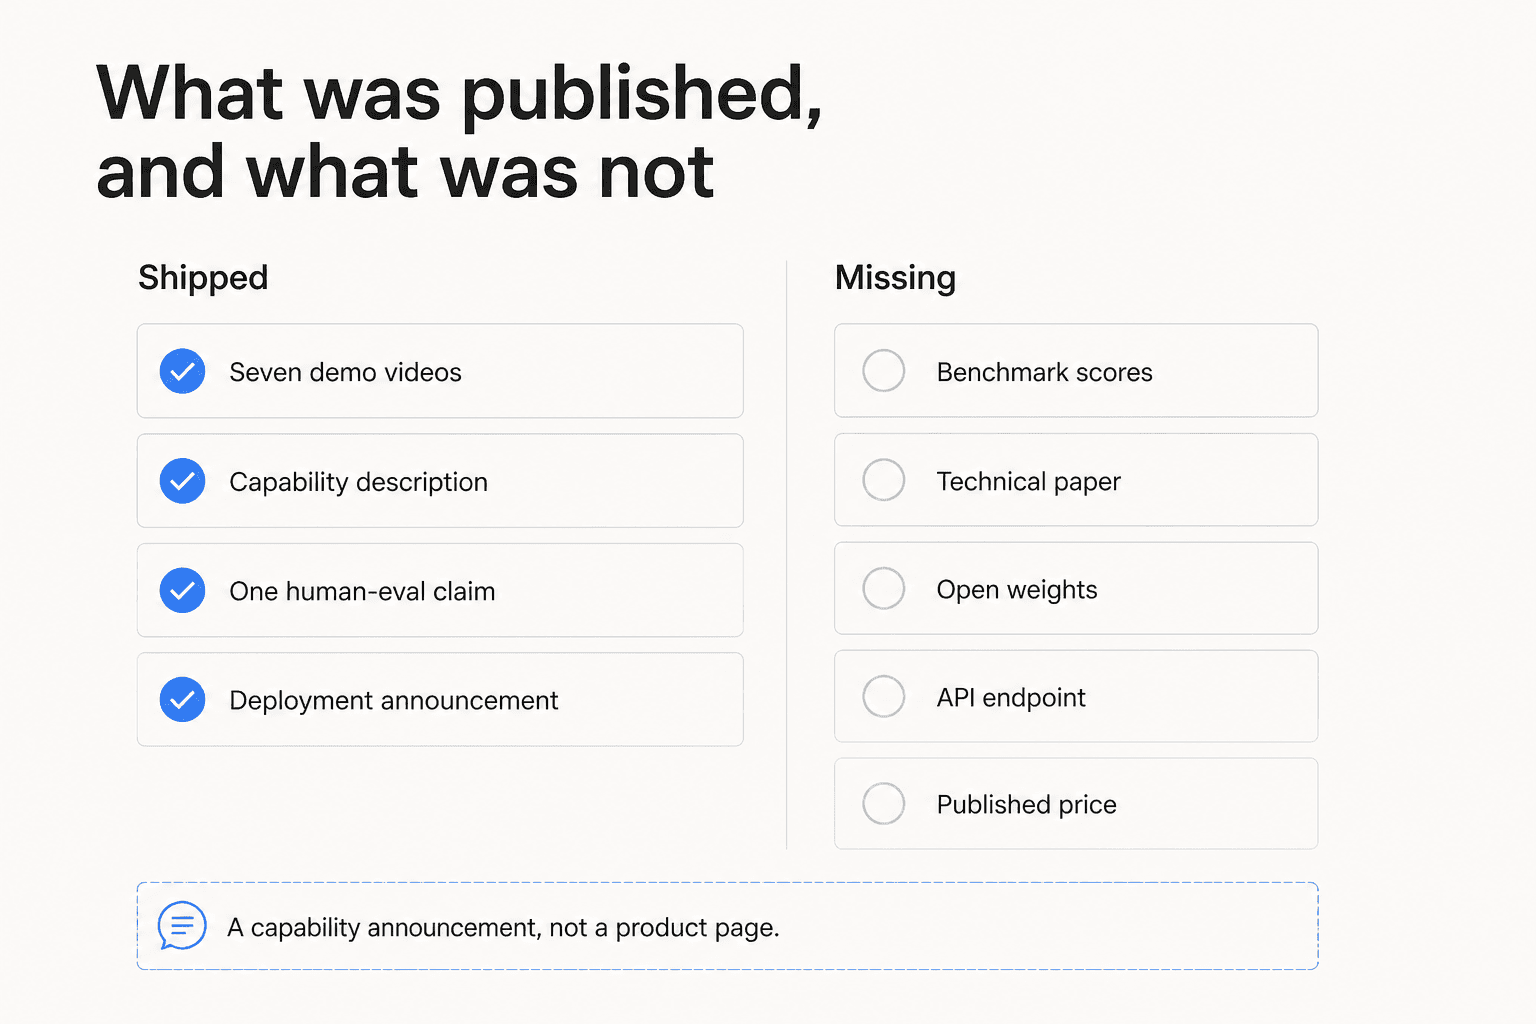
SeedRealtimeの論文は存在しません。arXivの全文検索はゼロ件を返しますが、同じセッションでの対照検索はきちんと機能しています。最も物語るサインはチーム内部からのものです。Seedの研究者Panwang Panは、自身の代表作の一覧にSeedRealtimeを挙げていますが、ProjectやModelCard、Blogへのリンクはあっても論文へのリンクはなく、そのページの他のすべての項目には論文リンクがあります。重みは非公開で、ByteDance-SeedのGitHub組織にもHugging Faceにもリポジトリはありません。
これは選択であって、慣例ではありません。Kimi K3は完全なベンチマーク表とともに登場しました。DeepSeek V4 Flashも同様です。検証可能なスコアを公開する中国の研究所は、2026年においてはもはや特筆すべきことではありません。
誰も実施しなかったベンチマーク
ここで私にとってこの記事全体の見方が変わった発見があります。SeedRealtimeはArtificial Analysisの音声対音声リーダーボードのどこにも登場しません。ByteDance、Doubao、Seed、Volcengineのどのモデルも、5つのチャートと36行の要約表全体を通じて、2026年8月18日取得時点で登場しません。Alibaba CloudとStepFunはどちらも掲載されており、Qwenは現在3つの構成ベンチマークのうち2つで首位にあるため、「中国の研究所だから掲載されない」は説明になりません。
これが重要なのは、2つの主要ベンチマークが測っている内容によります。
Full Duplex Benchは、ライブ会話の仕組みそのものを採点します。つまり、ポーズの間に割り込まないこと、正しく発言の順番を取ること、ユーザーの割り込みに対応すること、「うんうん」を挟んでも会話を続けられることです。これはまさにSeedRealtimeのペースに関する主張が対象としている内容です。上限は98.4%で、Qwen Audio 3.0 Realtime Plusが保持しており、現在のGPT Realtimeファミリーは91〜96%の帯にあります。このチャートの上位は圧縮されており、これは上位勢の間では会話のダイナミクスがもはや誰も差別化できなくなっていることを丁寧に言い換えたものです。Gemini 3.1 Flash Liveの74.3%は、それでも区別できる唯一のフロンティアモデルです。
𝜏-Voiceは別のことを採点します。サポートエージェントとして振る舞いながら解決できた、再現されたカスタマーサービスシナリオの割合です。音声ユーザーシミュレーターが、フライトの変更、争いのある請求、通信障害といった用件でモデルに電話をかけます。各タスクには有効なデータベース上の終了状態が1つあり、採点は最終状態を正解と比較します。これは仕事が実際に終わったかどうかを測るもので、モデルが頼りになりそうに聞こえたかどうかではありません。そこでの上限は56.5%で、Grok Voice Think Fast 2.0 Highが保持しています。
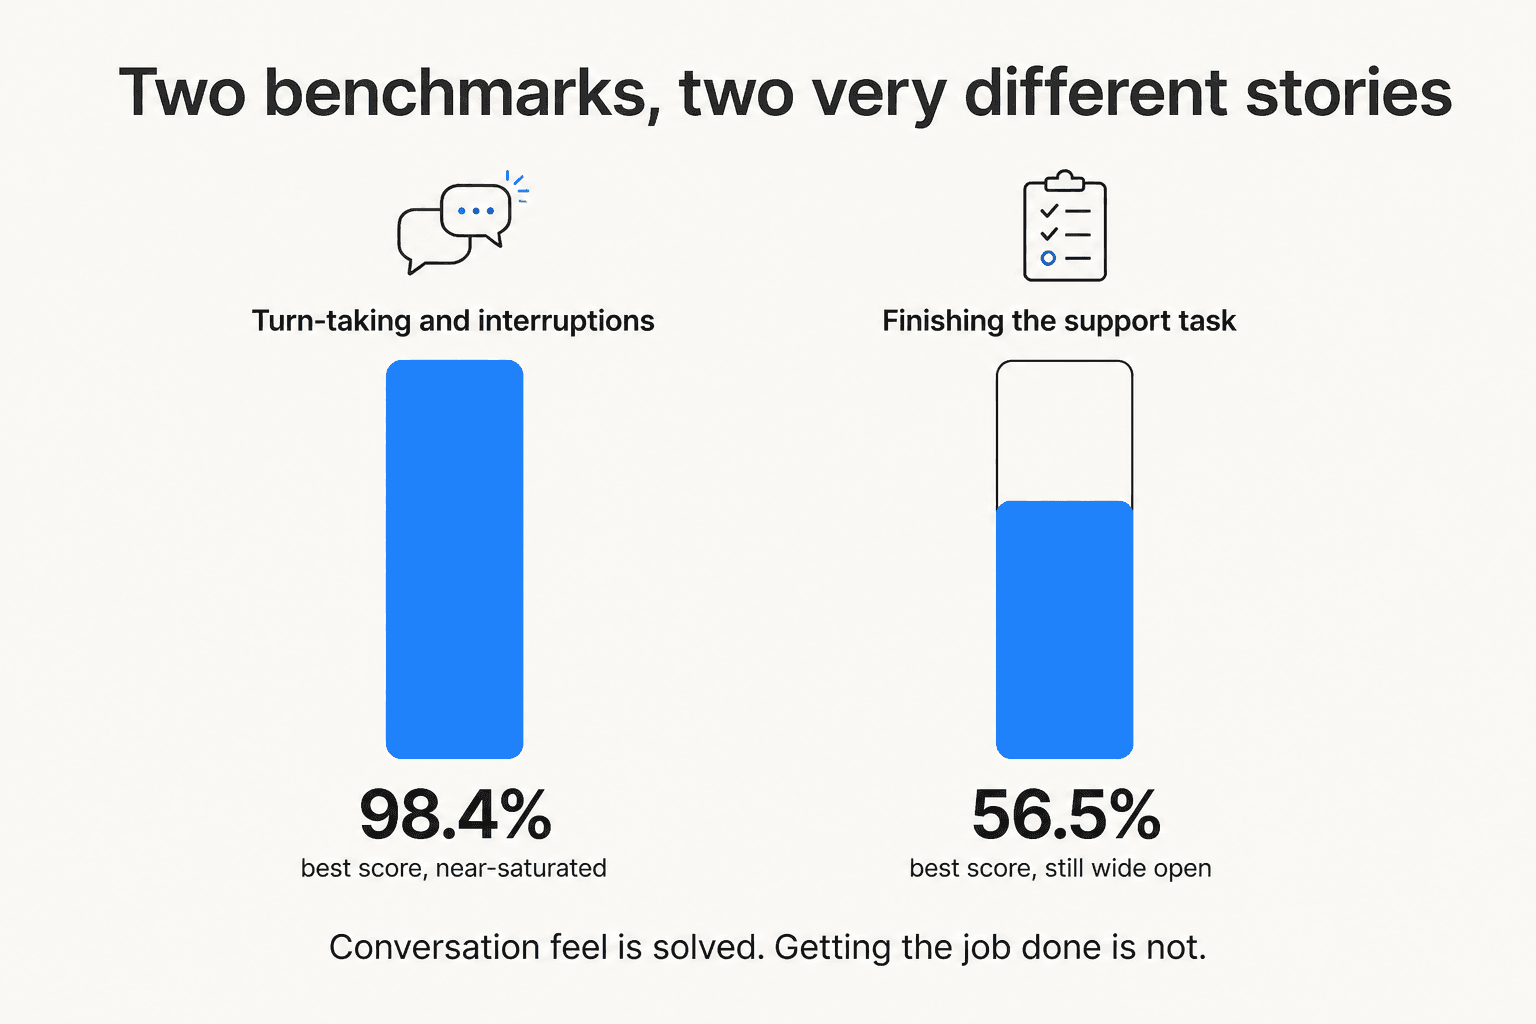
このギャップをじっくり見てください。利用可能な最良の音声エージェントでも、再現されたサポート業務のおよそ43%で失敗しますが、ほぼすべてのフロンティアモデルは会話のリズムをほぼ完璧に処理します。業界は音声AIがどう聞こえるかを解決しましたが、仕事を終えられるかどうかは解決していません。計測されているモデルについての完全なリーダーボードは次のとおりです。
| モデル | S2Sインデックス | 音声推論 | 会話のダイナミクス | 𝜏-Voice(タスク完了率) | 最初の音声までの時間 |
|---|---|---|---|---|---|
| Qwen Audio 3.0 Realtime Plus | 84.1% | 99% | 98.4% | 54.6% | 1.54s |
| Grok Voice Think Fast 2.0 High | 82.9% | 97% | 95.1% | 56.5% | 0.70s |
| GPT-Realtime-2.1 High | 79.1% | 96% | 95.7% | 45.7% | 1.21s |
| Qwen Audio 3.0 Realtime Flash | 76.3% | 96% | 96.9% | 35.9% | 1.55s |
| Gemini 3.1 Flash Live High | 69.5% | 97% | 74.3% | 37.7% | 2.99s |
| Deepslate Opal | 62.8% | 85% | 85.7% | 17.5% | 0.44s |
| SeedRealtime | 未計測 | 未計測 | 未計測 | 未計測 | 未公開 |
最速のモデルがどこに位置しているかに注目してください。Deepslate Opalは0.44秒で応答し、タスクの17.5%を解決します。遅延がボトルネックでなくなったのはもう少し前の話で、これは私がサポートチケット向けモデルの比較で別の角度から到達した結論と同じです。
実際に使った人たちの声
この発表に対するコミュニティの反応は薄く、かつ偏っており、それ自体が物語っています。Redditには何もありません。r/LocalLLaMAは同じ時期にフルデュプレックスの選択肢について活発に議論していましたが、SeedRealtimeには一度も触れていません。ダウンロードできる重みがないときに予想される通りの反応です。Hacker Newsには1点・コメント0件の投稿が1件あります。LinkedInは同じ要約の見出しのリポストが10件ほどです。実際の反応はXにあります。
最も肩書きの信頼できる声は、音声モデルを本業として扱っている人物のものであり、それはアクセスに対する不満にもなっています。
"why aren't more people talking about this?? audio-visual native FDX model is impressive, especially its ability to proactively detect and interact with the user based on visual cues.
GPT Live 1 is pure audio-only and doesn't have this capability.
has anyone tried it on Doubao? i don't have a Chinese phone number but really want to try 🥹"
英語でこのニュースを最初に伝えたアカウントも、より少ない言葉で同じことを言っています。「I wish it would be testable globally 😬」。
私が見つけた唯一の実質的なハンズオンの報告は中国語によるもので、そこで評価されているのは見出しが売り込んでいる内容とは違います。
"测试让豆包陪我一起看一个Youtube视频,画面出现个人,直接问这人是谁,竟然答对了!画面有个一闪而过的图表,问:"刚才有个图表,你能给我解读下吗?"。它竟然知道我指的是哪个图,并完整解释。"
この人はDoubaoに一緒にYouTube動画を見させ、画面に映った人物が誰かを尋ねたところ正解し、その後、ちらっと映っただけのグラフについて尋ねたところ、モデルはどのグラフを指しているかを理解し、完全に説明しました。これは速さではなく参照解決であり、このモデルについて誰かが行った最も具体的で検証済みの主張です。続報では、実物のアンプのボタンを指で指し示して、適切な返答を得たという内容も取り上げられています。
2つの懸念点も浮かび上がりましたが、どちらもエンゲージメントの低い単独のアカウントによるもので、大きな潮流ではなく個人の見解として読むべきです。ThursdAIのAlex Volkovは、Doubaoで無料という位置づけについて「Free or charge... holy surveilance」(誤字は原文のまま)と述べています。そして、ディナーパーティーのデモについての、より鋭い方法論上の指摘があります。
"holding onto four names through overlapping crosstalk is a harder party trick than watching and listening at the same time, most "multimodal" demos never actually test the crosstalk part."
これは正しい直感です。重なり合う会話のケースこそが興味深いのであって、デモ映像は敵対的テストではありません。
これを使って開発できるのか?3つのモデル名の罠
ここでほとんどの記事が間違えるので、正確に説明する価値があります。ByteDanceには紛らわしいほど似た名前を持つ3つのリアルタイムモデルがあり、そのうち購入できるのは2つだけです。
| モデル | 概要 | 今日呼び出せるか? |
|---|---|---|
| SeedRealtime | ネイティブな音声・映像フルデュプレックス:音声、映像、テキストを1つのモデルで | いいえ。 Doubaoアプリのみ。APIも価格もありません。 |
Seeduplex(豆包实时语音模型 3.0、モデル1.2.6.1) | ネイティブな音声専用フルデュプレックス、話しながら聞く、適応的な発言終了検知 | はい、WebSocket経由 |
| Doubao-Seed-RealtimeVoice(O2.0 / SC2.0) | 古いハーフデュプレックス、音声専用のスピーチ・トゥ・スピーチ | はい、ただしドキュメントは現在レガシー扱いです |
率直に言えば:購入できるのは音声専用のものだけです。SeedRealtimeを興味深くしている視覚機能は販売されていません。購入可能な音声SKUをすべて列挙したVolcengineの音声課金仕様、Arkモデルの価格表、Doubaoのプロダクト価格表を確認しましたが、どれにもSeedRealtimeの項目はなく、プリペイドもポストペイドもありません。提供に関する言及はすべてアプリ側のものです。
Volcengineのドキュメントは、旧モデルのOおよびSCバージョンが独立したイテレーションを停止し、機能が2.0系列に統合されていることも述べています。つまり今日から始めるなら、Seeduplexを基盤にすべきということです。
Seeduplexの実際の料金
購入可能なリアルタイムモデルは分単位ではなくトークン単位で課金され、ポストペイドのみです。Volcengineの割引段階全体の中で、プリペイドのリソースパックが一切用意されていない唯一の音声SKUであり、つまり利用量にかかわらず定価を支払うことになります。以下は¥6.74=1ドル(USD/CNY 6.7411、2026年8月17日)で換算したレートです。Volcengineは人民元のみで課金します。
| 項目 | 価格(CNY) | 概算USD |
|---|---|---|
| 入力、テキスト | ¥10 / 100万トークン | $1.48 / 100万 |
| 入力、音声 | ¥80 / 100万トークン | $11.87 / 100万 |
| 入力、キャッシュ(テキストまたは音声) | ¥5 / 100万トークン | $0.74 / 100万 |
| 出力、テキスト | ¥80 / 100万トークン | $11.87 / 100万 |
| 出力、音声 | ¥300 / 100万トークン | $44.51 / 100万 |
Volcengineは音声とトークンの変換率も公開しており、これによって分単位のレートと比較できるようになります。入力音声は1秒あたりおよそ6.25トークン、出力音声は1秒あたりおよそ25トークンです。計算してみると、請求の形がはっきり見えてきます。
| 導出された単位 | CNY | USD |
|---|---|---|
| ユーザーの発話1分(入力) | ¥0.030 | $0.0045 |
| モデルの発話1分(出力) | ¥0.450 | $0.067 |
| 対話1時間、発話を半々、音声のみ | ¥14.40 | $2.14 |
| モデルが連続して話す1時間 | ¥27.00 | $4.01 |
これらの導出行は、ByteDance自身が示した変換率から私が計算したもので、公開されている分単位の価格ではありません。実際の請求は、各ターンにテキストトークンと積み重なるコンテキストも加わるため、もっと高くなります。Volcengine自身の計算例では、40秒の1回のやり取りに¥0.0974、約$0.014という価格が付けられています。
これが高いかどうかを判断する材料として:OpenAIはGPT Realtimeの音声を入力100万トークンあたり$32、出力100万トークンあたり$64としており、GoogleのGemini 3.1 Flash Liveは100万あたり入力$3.00、出力$12.00で、分あたりおよそ$0.005と$0.018に相当します。ByteDanceは入力では両者の中間、出力ではGoogleより高い位置にあります。私のGemini料金の記事にGoogleの料金表の全体があります。GPT Realtime Miniの料金はOpenAIの安価な層を取り上げています。
レバーはまさに表の中にあります。出力音声は入力音声より1秒あたり15倍高いため、あなたが制御できる最大のものはモデルがどれだけ話すかです。料金表自体についての1つの注意点として、表は出力テキストを100万トークンあたり¥80としていますが、同じページの計算例では¥30で計算されており、合計額と整合するのは¥30だけです。実際の請求書を見るまで、この行は未解決として扱ってください。
アクセスに関する詳細が、これが自分にとって現実的かどうかを決める
コストは簡単な部分です。摩擦はそれ以外のあらゆる場所にあり、発表には何も書かれていないため、率直に列挙しておく価値があります。
- WebSocketのみで、
wss://openspeech.bytedance.com/api/v3/duplex/realtime/dialogueにアクセスし、単一のX-Api-Keyヘッダーを使い、modelは1.2.6.1に固定されています。 - OpenAI-Realtime風だが、OpenAI互換ではありません。 イベント名は借用されています(
session.create、conversation.item.create、response.cancel)が、実体はVolcengineの認証を使うVolcengineのエンドポイントです。読んで馴染みはあっても、そのまま差し替えられるものではなく、私のRealtime APIとWebRTCの解説で説明した状況とは異なります。 - お金では超えられない上限があります。 1分あたり60セッション、1分あたり100,000トークンで、リアルタイムモデルはテキスト音声合成や音声認識をカバーする同時実行アドオン表には含まれていません。上限を上げるには営業窓口を通す必要があります。
- 中国語が主で、ドキュメントにもそう書かれています。 あるページでは中国語と英語をサポートすると記載されていますが、同じページの制約事項のセクションには、エンドツーエンドモデルは中国語のサポートが良好なだけで、他言語の品質は保証しないと書かれています。プレミアムな中国語の声は4種類、米国英語の声は3種類で、古いモデルバージョン1つにしか用意されていません。
- 実質的には中国本土のアカウントです。 人民元のみの価格設定、cn-beijingリージョン固定、明示的なサービス有効化、デフォルトで有効なコンテンツモデレーションです。
- コンテキストは合計12Kで、システムプロンプトと会話履歴の両方を含みます。
中国国外のサポートチームにとって、このリストが答えです。これはまだプラットフォームとしての選択肢ではありません。
AIをサポートキューに載せる場合、これが意味すること
私はヘルプデスク向けのAIエージェントを作っているので、上記のどれも私の1週間を変えない理由を率直に述べます。
サポートのロールアウトが失敗する理由は、AIの発言交代がぎこちなく感じられたからであることは、ほとんどありません。実際には、AIが自信を持って間違った回答をした、あるいは人間に引き渡すべきチケットに答えてしまった、というエスカレーションの設計の問題です。ある顧客、Zendeskを使い月間およそ200件のチケットを処理し2,000件に向けて拡大しているデンマークの車両テレマティクス企業は、まさにこれに遭遇しました。ナレッジベースには「すべてのモデルに対応している」と書かれていたため、ボットはデータベースに存在しない自動車ブランドについても、陽気に対応を確認してしまいました。会話のリズムが滑らかになったところで、この問題は何も解決しません。より良い検索と根拠付けが解決します。
2つ目の理由は制御であり、私が耳にする中で圧倒的に多い異論です。GorgiasとShopifyを使い、月間およそ7,000件のチケットを30,000件の注文に対して処理しているDTCサプリメントブランドのCXリードは、私にこう語ってくれました。
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
これは日常の服を着た𝜏-Voiceの問題です。彼が尋ねているのはあの43%のことです。会話のダイナミクスで98.4%、タスク完了率で56.5%を記録するモデルは、彼の立場から見れば、10件中4件を間違えてもそれを一切口にしない、とても礼儀正しい同僚です。だからこそ有効なレバーは、もっと速いモデルではなく、信頼度のしきい値と明確なエスカレーション経路なのです。
というわけで、サポートの仕事をしているならSeedRealtimeについて実用的に読み解くと:
- 待たないこと。 APIも価格もベンチマークもなく、中国向けアプリのみです。これは購入できる選択肢ではありません。
- デュプレックスの軸ではなく、視覚の軸を見ること。 画面に映っているものから「さっきのあのグラフ」を解決する能力は本物の新しい機能であり、最初に現れるのは電話キューではなく、画面共有によるサポートや視覚的なトラブルシューティングです。
- すべての音声モデルをタスク完了率で判断すること。 どのベンダーにも𝜏-Voiceのスコアを尋ねてみてください。スコアがなければ、それが答えです。私の音声サポート向けAIまとめでは実際に計測されているモデルを取り上げ、サポート電話に応答するAIでは運用面を取り上げています。
- ボリュームがある場所から始めること。 ほとんどのキューは今でも圧倒的にテキストが中心であり、チケットのトリアージだけでも、リスクのほんの一部で音声パイロットより大きな成果が返ってきます。チケットのデフレクションが、最初に取り組む価値のあるもう一つの施策です。
より広い分野については、最高のAIヘルプデスクソフトウェアのまとめが、今年実際に登場しているものを取り上げています。
もしそれより前の段階で、これらのエージェントが何をするのかをまだ理解している途中であれば、AIカスタマーサービスソフトウェアがカテゴリの入門として役立ちます。
eeselを試す
これを実際のサポートキューのために評価しているなら、結果を本当に左右する問いは、どのモデルがあなたのカメラを見るかではありません。顧客がそれに出会う前に、あなたのヘルプセンターと過去の会話を使って、あなたのチケットに対して正しい答えを出せるかどうかです。
それこそがeeselが作られている理由です。eeselはすでに使っているヘルプデスクに接続し、新しいナレッジベースを必要とする代わりに既存のマクロとチケット履歴から学習し、実際の過去のチケットをシミュレーションで再生することで、何かが本番に出る前に解決率と正確な返信内容を確認できるようにします。どのチケットタイプに触れ、どこでハンドオフするかはあなたが設定するので、上で述べた「残りは触らないでおく」という問題は、希望ではなく設定の話になります。無料で試せるので、その日の午後には自分の過去データでシミュレーション結果を見ることができます。

フルデュプレックス音声はいずれサポートの現場に到達するでしょうが、そのときに勝つモデルは、タスク完了率の数字を示せるモデルです。それまでは、AIサポートエージェントを自分たちの知識に根付かせるという地味な作業こそが、解決率の源泉です。