

コーディングやエージェント作業の大半で最適なQwen 4 Maxの代替はClaude Sonnet 5.5で、100万トークンあたり2ドル/10ドルです。難しいタスクにはClaude Opus 5.5、大量処理にはDeepSeek V4.1 Flash(オフピーク0.15ドル/0.60ドル)が向いています。ただし乗り換え前に1つ確認してください。AlibabaはGA版qwen4-maxを11月16日に1.50ドル/4.50ドルで提供開始しました。プレビューが気に入っていたなら、モデルIDを1つ変えるだけのほうが、どの乗り換えより安く済みます。
プレビューがサポートボットを動かしていたなら、eeselはモデルを選ぶ必要なくその仕事を引き継ぎ、eesel CLIはコーディングエージェントにヘルプ文書を読み込ませ、公開前に回答をテストさせます。
11月25日にQwen 4 Maxはどうなりますか?
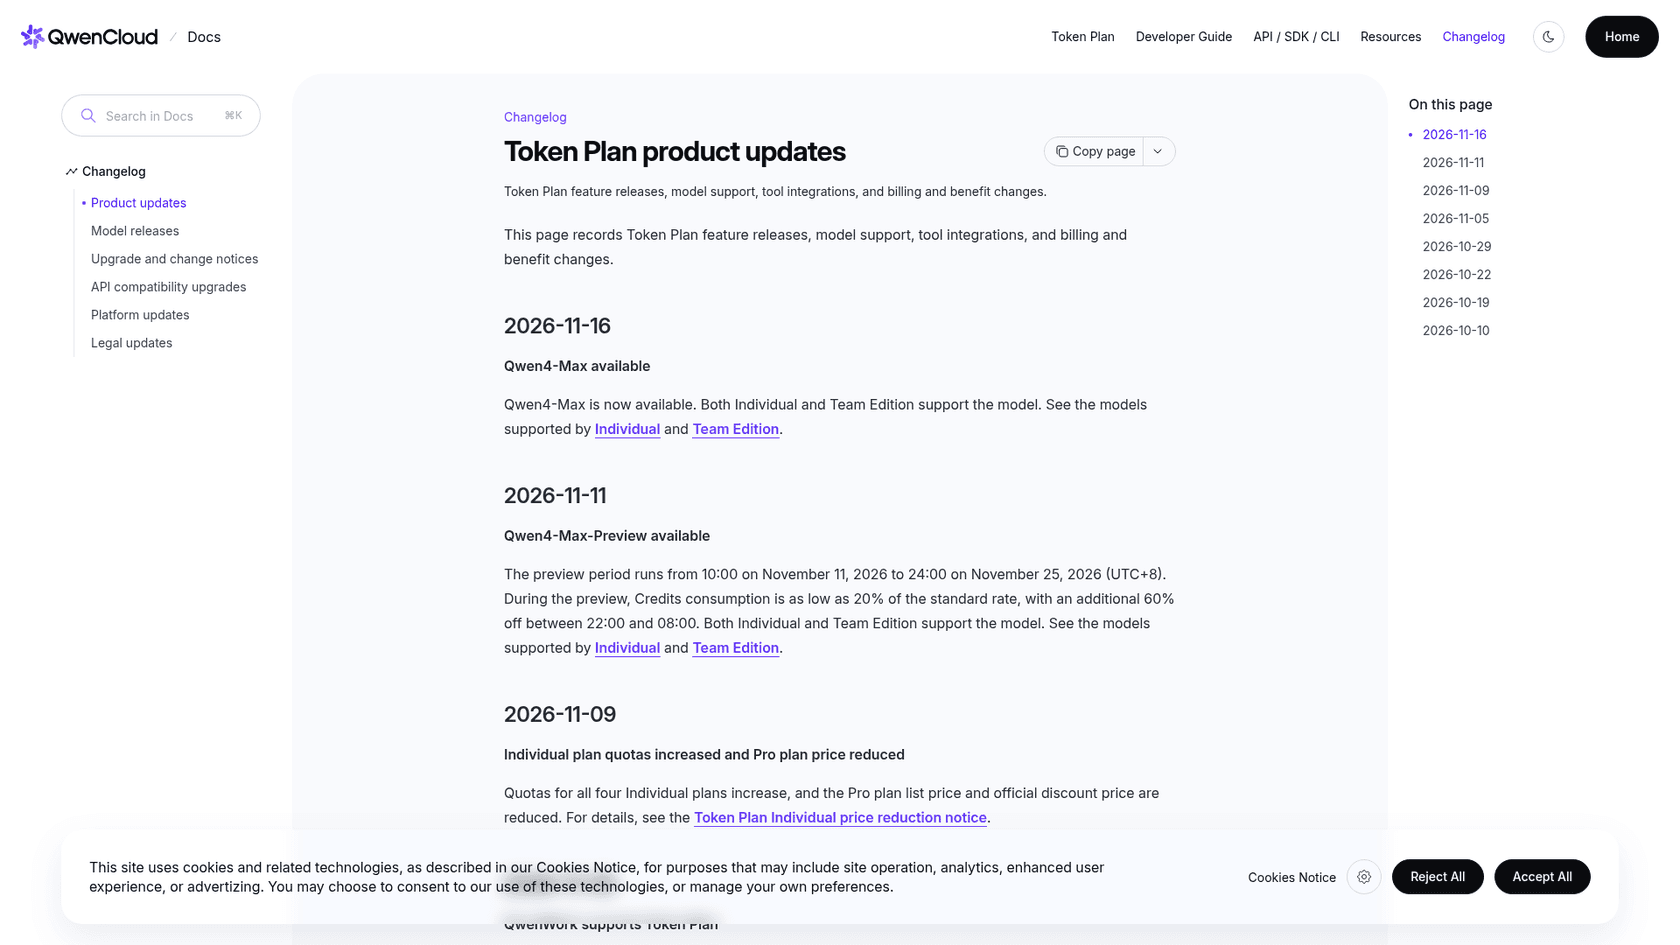
プレビューは終了します。AlibabaのToken Planの変更履歴によると、qwen4-max-previewは11月11日10時から2026年11月25日24時(UTC+8)まで動作し、Token Planのドキュメントにはプレビュー終了後にこのモデルは廃止されると書かれています。このIDを指し続けるエージェント、スクリプト、Claude Codeの設定は、26日に動かなくなります。
多くの報道が見落としているのは、同じ変更履歴の次の項目です。11月16日、Alibabaはqwen4-maxをTokun Plan Personal、Token Plan Team、従量課金APIで一般提供(GA)にしました。つまり問題はもう「Qwenか他のモデルか」ではなく、「GA版のQwenか、自分のワークロードに合うもっと良いモデルか」です。
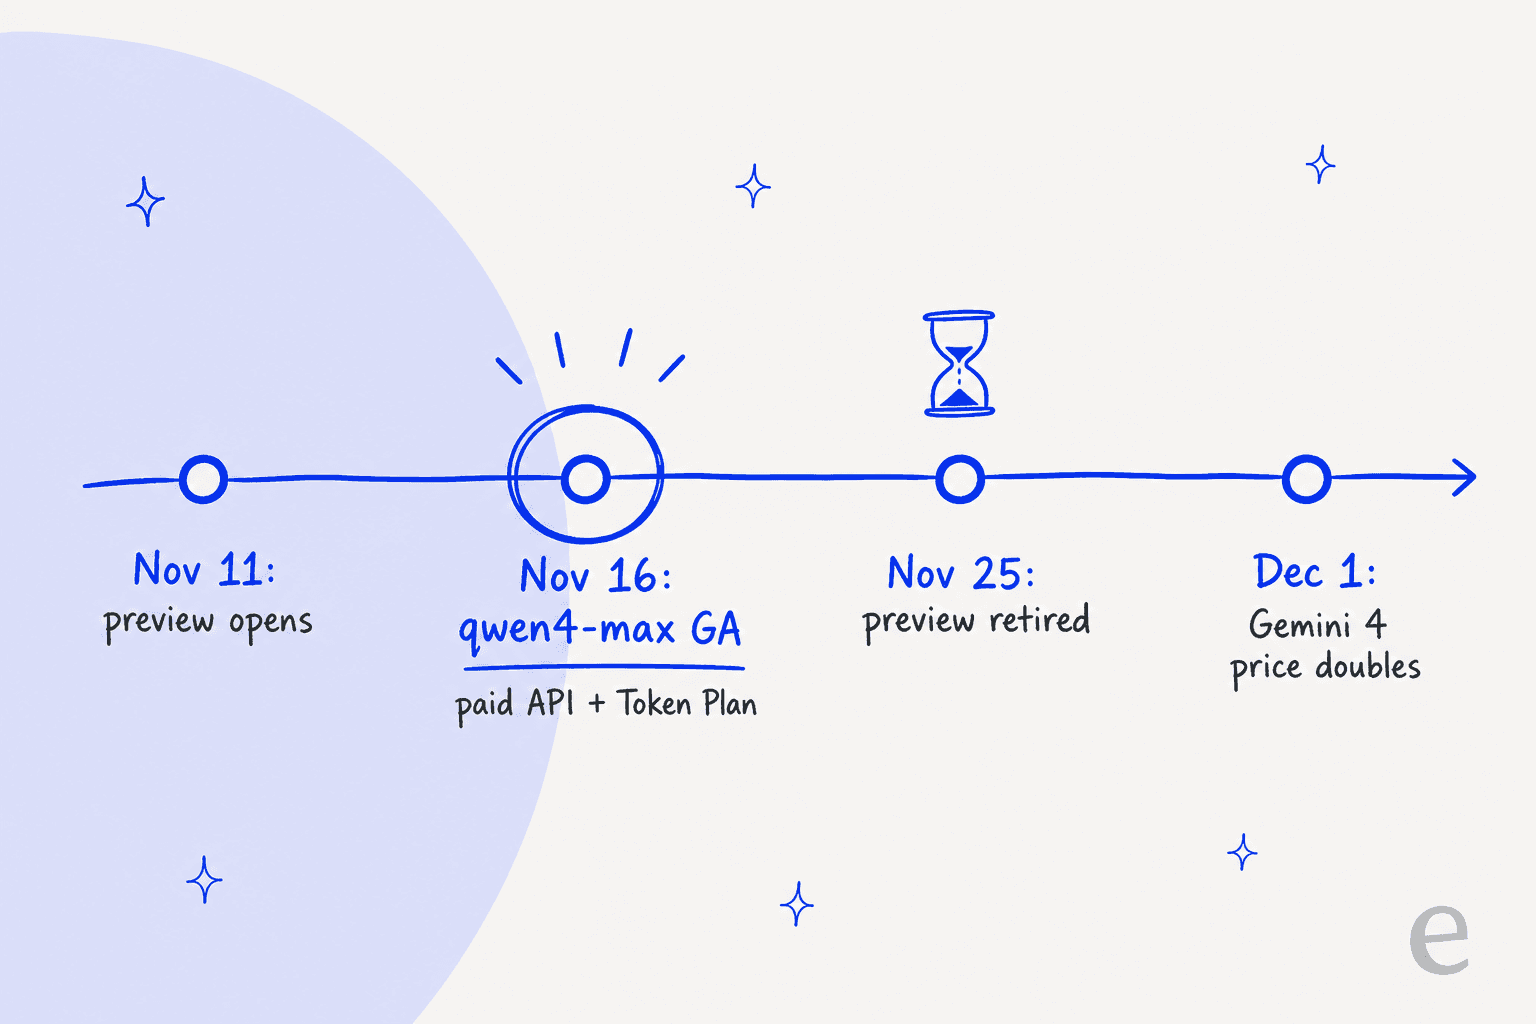
この最後の期限も重要です。以下で紹介する代替のうち2つ、Gemini 4 ArgonとGemini 4 Carbonは、12月1日に2倍になる導入価格を使っています。つまり今週の料金表に基づいた判断が、2週間のうちに2回変わる可能性があります。
私はAliciaで、eeselで機能とAIエージェントを開発しています。私たちは長年、実際のサポートキューの裏でモデルを動かしてきましたが、強制的な移行のたびに学ぶ教訓は同じです。どのモデルに乗り換えるかより、自分の作業で先にテストしたかどうかのほうが重要です。以下の各候補には想定する1人の購入者向けの料金を付けているので、テストする前に1つの数字で比較できます。
GA版qwen4-maxに単純に乗り換えるべきですか?
プレビューが気に入っていた大半の人にとっては、はいです。2つのモデルの違いは次のとおりで、すべてAlibabaのQwen4-Maxのドキュメントによるものです。
| qwen4-max-preview | qwen4-max(GA) | |
|---|---|---|
| ステータス | 11月25日以降は廃止 | 11月16日から一般提供 |
| 利用できる場所 | Token Planのみ | Token Plan Personal、Token Plan Team、従量課金API |
| 料金 | 標準料率の20%のクレジット(深夜は8%) | シンガポールで100万トークンあたり入力1.50ドル/出力4.50ドル |
| コンテキストウィンドウ | 100万トークン | 100万トークン |
| 最大思考+回答 | 393,216トークン | 262,144トークン |
| 推論の強さ | low、medium、xhigh | low、high(デフォルト)、xhigh |
| コーディングツール | Token Plan経由のClaude Code | Claude Code、Codex、OpenCode |
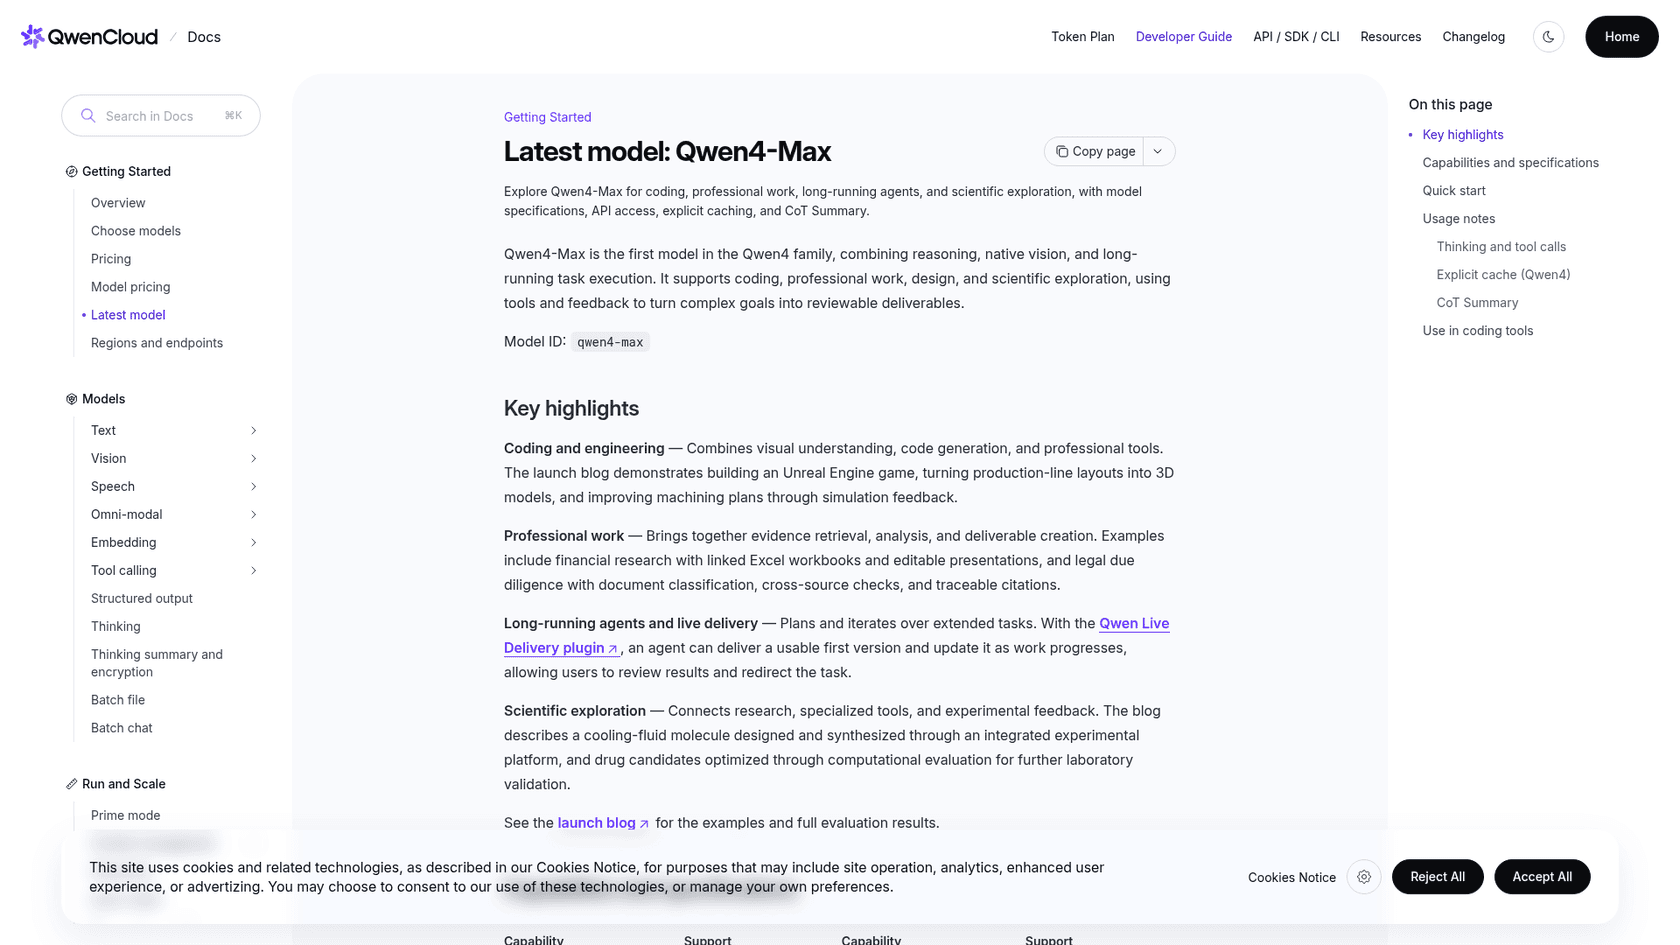
目立つ点は3つあります。まず、GA版はQwen3.8-Maxより安いことです。Alibabaはqwen3.8-maxをシンガポールで2ドル/6ドルとしており、qwen4-maxの1.50ドル/4.50ドルより高いため、新しい旗艦モデルのほうが安くなっています。次に、GA版はTTL5分または1時間の明示的なキャッシュを追加し、キャッシュ読み取りは0.075ドルです。3つ目は、プレビューの割引がなくなることです。Token Planの利用者はプレビュー中、標準クレジット料率の20%、深夜は8%しか払っていませんでした(Token Planの概要より)。この優待は続かないため、同じ作業でもクレジットの消費速度が数倍速くなると見込んでください。
移行自体は1行で済みます。先週紹介したClaude Codeのセットアップでは、Opusのスロットがqwen4-max-previewを指していました。これをqwen4-maxに置き換え、同じToken Planのキーとエンドポイントをそのまま使ってください。出力が途中で切れる場合はmax_completion_tokensを確認してください。GA版は思考と回答の合計を262,144トークンに制限しています。
では、代わりに離れるべきタイミングはいつでしょうか。プレビューがその立場に値しなかった場合です。Alibabaは発表ブログ以外に、独立したベンチマーク結果をいまだドキュメントで公開していません。プレビュー期間中のコミュニティの評価も賛否が分かれていました。
"No benchmarks yet. The smaller Qwen models are extremely popular for people running things locally, yet I don't know absolutely anyone running Qwen Max."

"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
プレビューを使っていた主な理由が80%の割引で、あるいはAlibaba Cloud以外のプロバイダーが必要なら、この先を読んでください。
これらの代替をどのように選び、料金を調べたか
Qwen 4 Maxのプレビューが使われていた3つの用途、つまりClaude Codeのようなツールでのエージェント的コーディング、100万トークンのウィンドウを使うロングコンテキストの作業、そして多段階エージェントでのツール呼び出しをカバーするモデルを選びました。各料金はベンダー自身の料金ページから取得し、2026年11月17日に確認しています。
トークンあたりの料金を比較しやすくするため、各モデルに1人の購入者、つまり月に入力1,000万トークン、出力100万トークンを使う開発者を想定し、標準の定価で、キャッシュやバッチの割引なしで料金を計算しました。これはソロでのエージェント作業が多い月に近い量です。キャッシュはエージェントのループで結果を大きく変えるため、下の計算ツールで自分のキャッシュヒット率を入力できます。
Qwen 4 Max代替のまとめ
| モデル | 最適な用途 | 入力/出力(100万あたり) | キャッシュ読み取り(100万あたり) | 月額(入力1,000万、出力100万) | コンテキスト | オープンウェイト | サブスクリプション | 近日中の価格変更 |
|---|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 | 日常のコーディング | 2ドル / 10ドル | 0.10ドル | 30ドル | 100万 | なし | Claudeプラン | なし |
| Claude Opus 5.5 | 難しいエージェントタスク | 4ドル / 20ドル | 0.20ドル | 60ドル | 100万 | なし | Claudeプラン | なし |
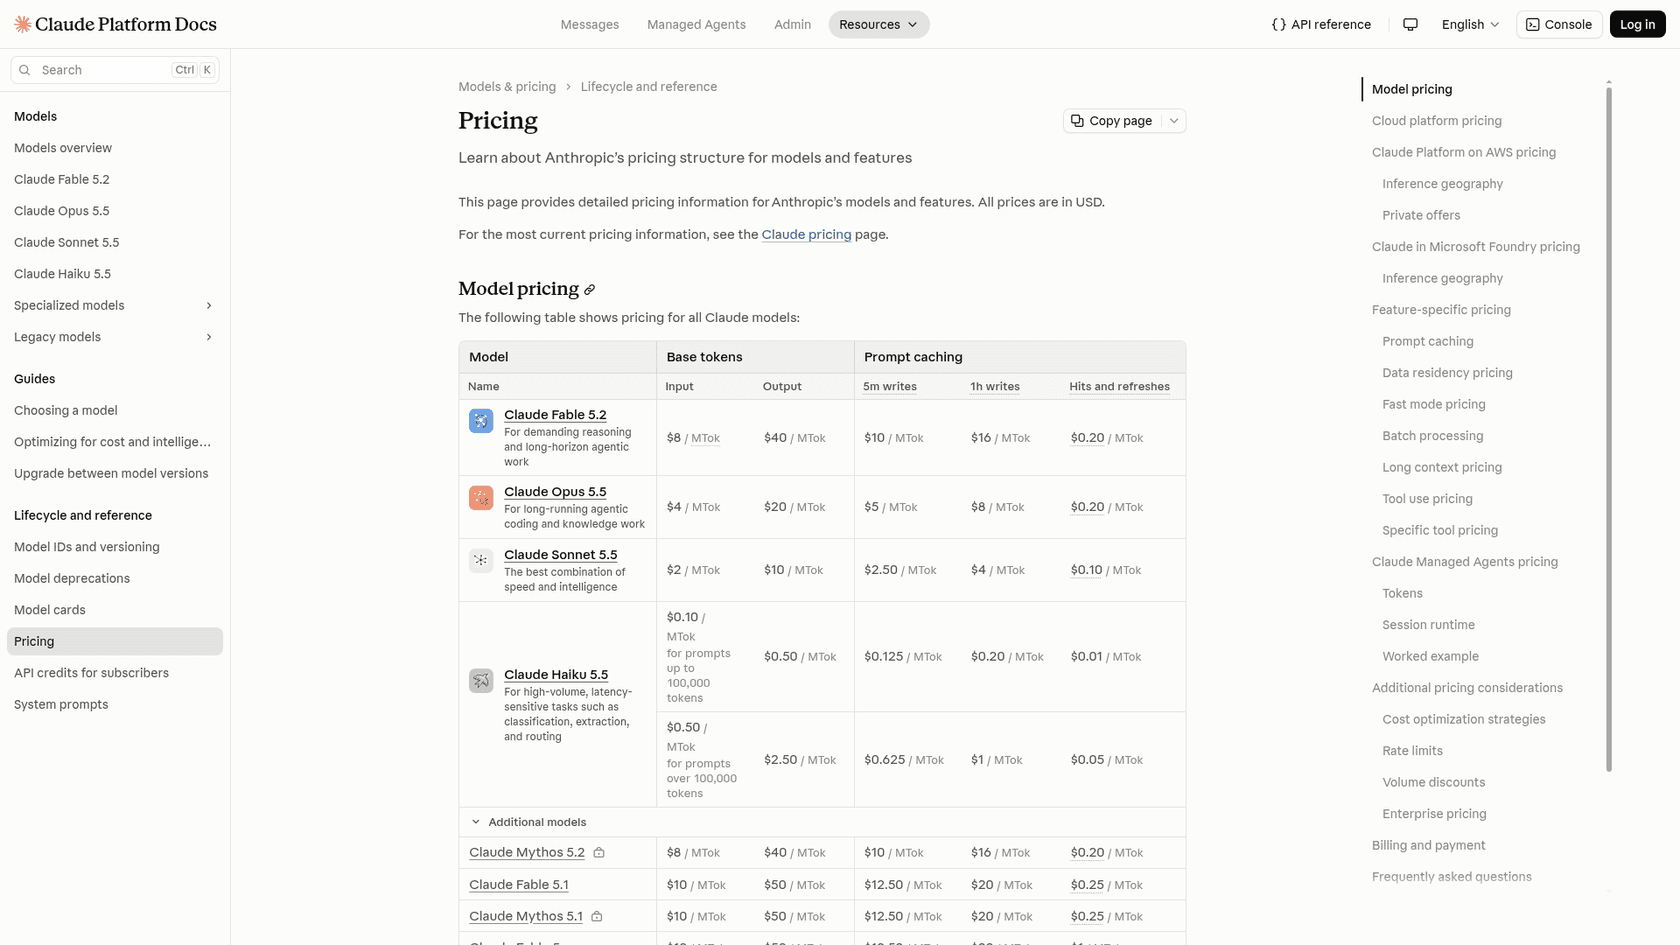
| Claude Fable 5.2 | 最も難しいタスク | 8ドル / 40ドル | 0.20ドル | 120ドル | 100万 | なし | Proの使用量クレジット | なし |
| GPT-6.1 Terra | 安価なフロンティア級の作業 | 1ドル / 5ドル | 0.05ドル | 15ドル | 272Kを超えると入力が2倍 | なし | ChatGPTプラン | なし |
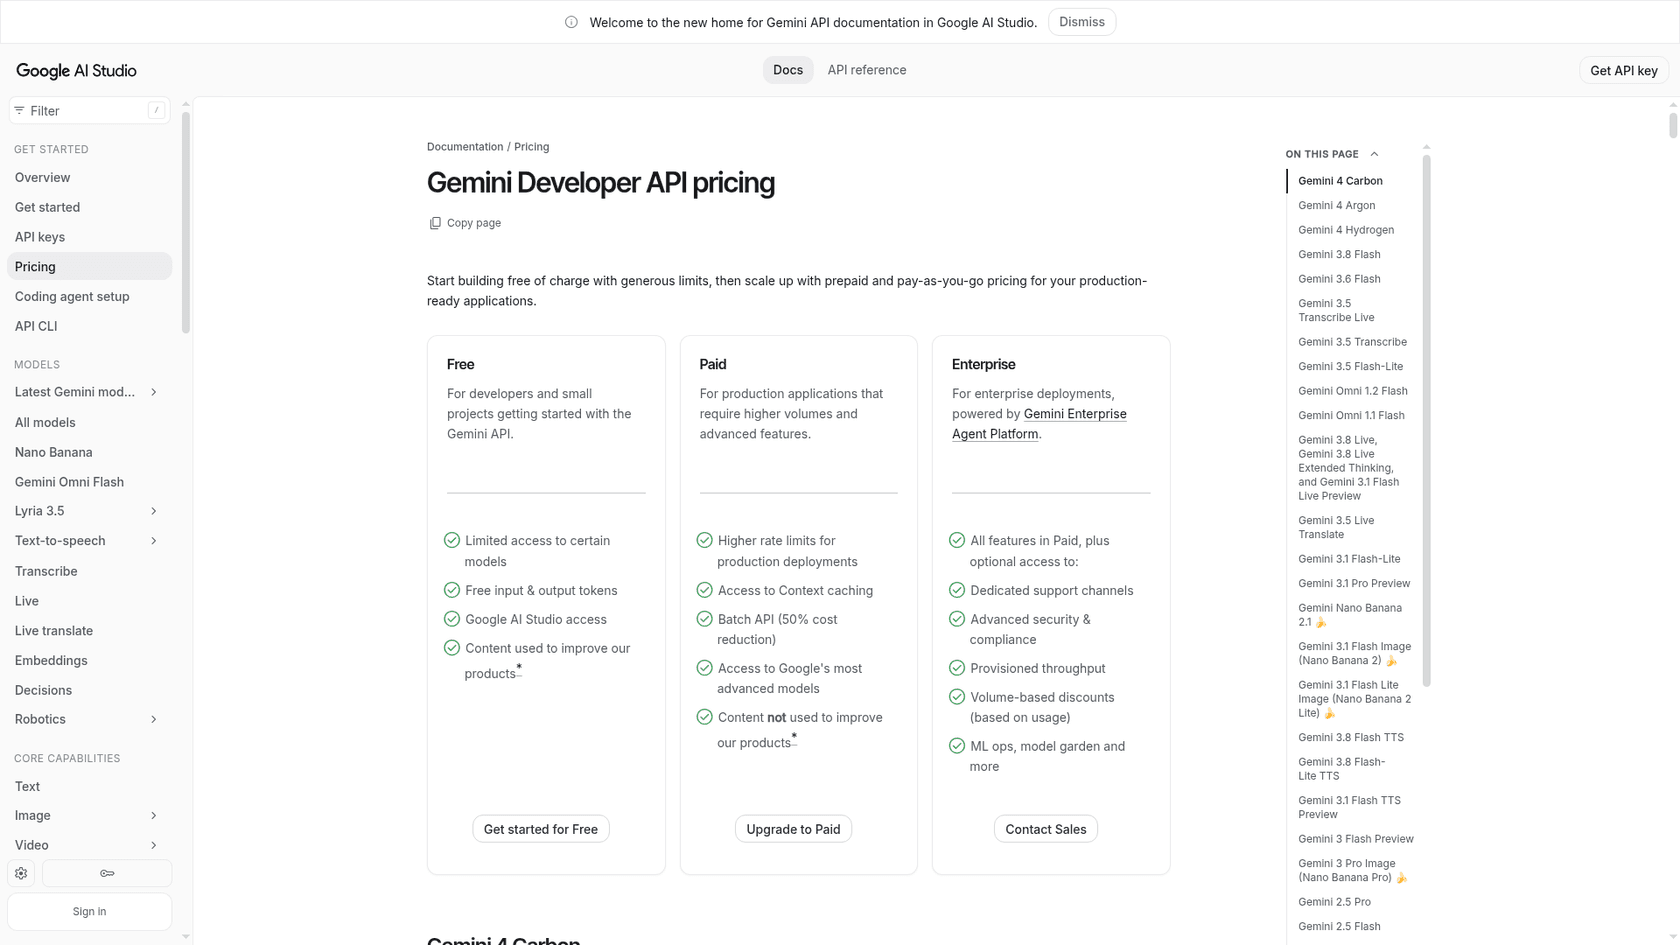
| Gemini 4 Argon | 高速なGemini 4作業 | 2ドル / 10ドル | 0.10ドル | 30ドル(12月1日から60ドル) | 100万 | なし | なし | 12月1日に2倍 |
| Gemini 4 Carbon | 長時間動くエージェント | 2ドル / 10ドル | 0.10ドル | 30ドル(12月1日から60ドル) | 100万 | なし | なし | 12月1日に2倍 |
| DeepSeek V4.1 Flash | 大量処理・低予算の作業 | オフピーク0.15ドル / 0.60ドル | 0.003ドル | 2.10ドル(ピーク時4.20ドル) | 100万 | あり | Token Planでも利用可 | なし |
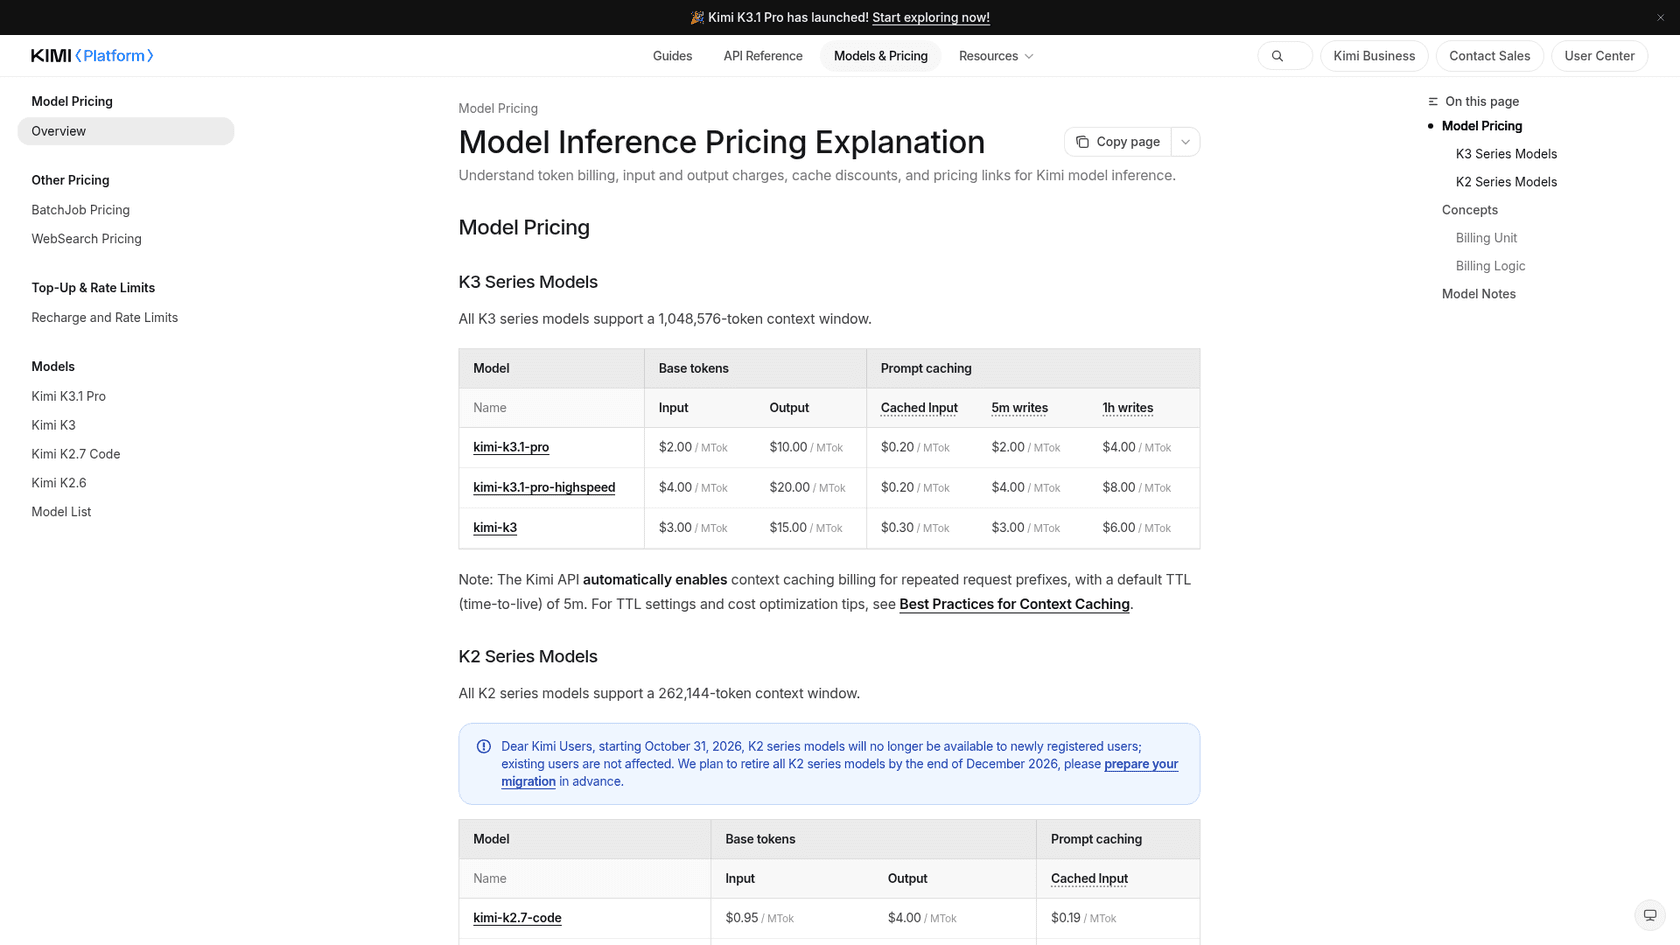
| Kimi K3.1 Pro | 米国外のフロンティアモデル | 2ドル / 10ドル | 0.20ドル | 30ドル | 100万 | なし | 19ドル〜199ドル/月 | なし |
| Qwen3.8-Max | Token Planを継続 | 2ドル / 6ドル | 0.25ドル | 26ドル | 100万 | なし | Token Plan | なし |
| qwen4-max(GA、参考) | 同じモデルを継続 | 1.50ドル / 4.50ドル | 0.075ドル | 19.50ドル | 100万 | なし | Token Plan | なし |
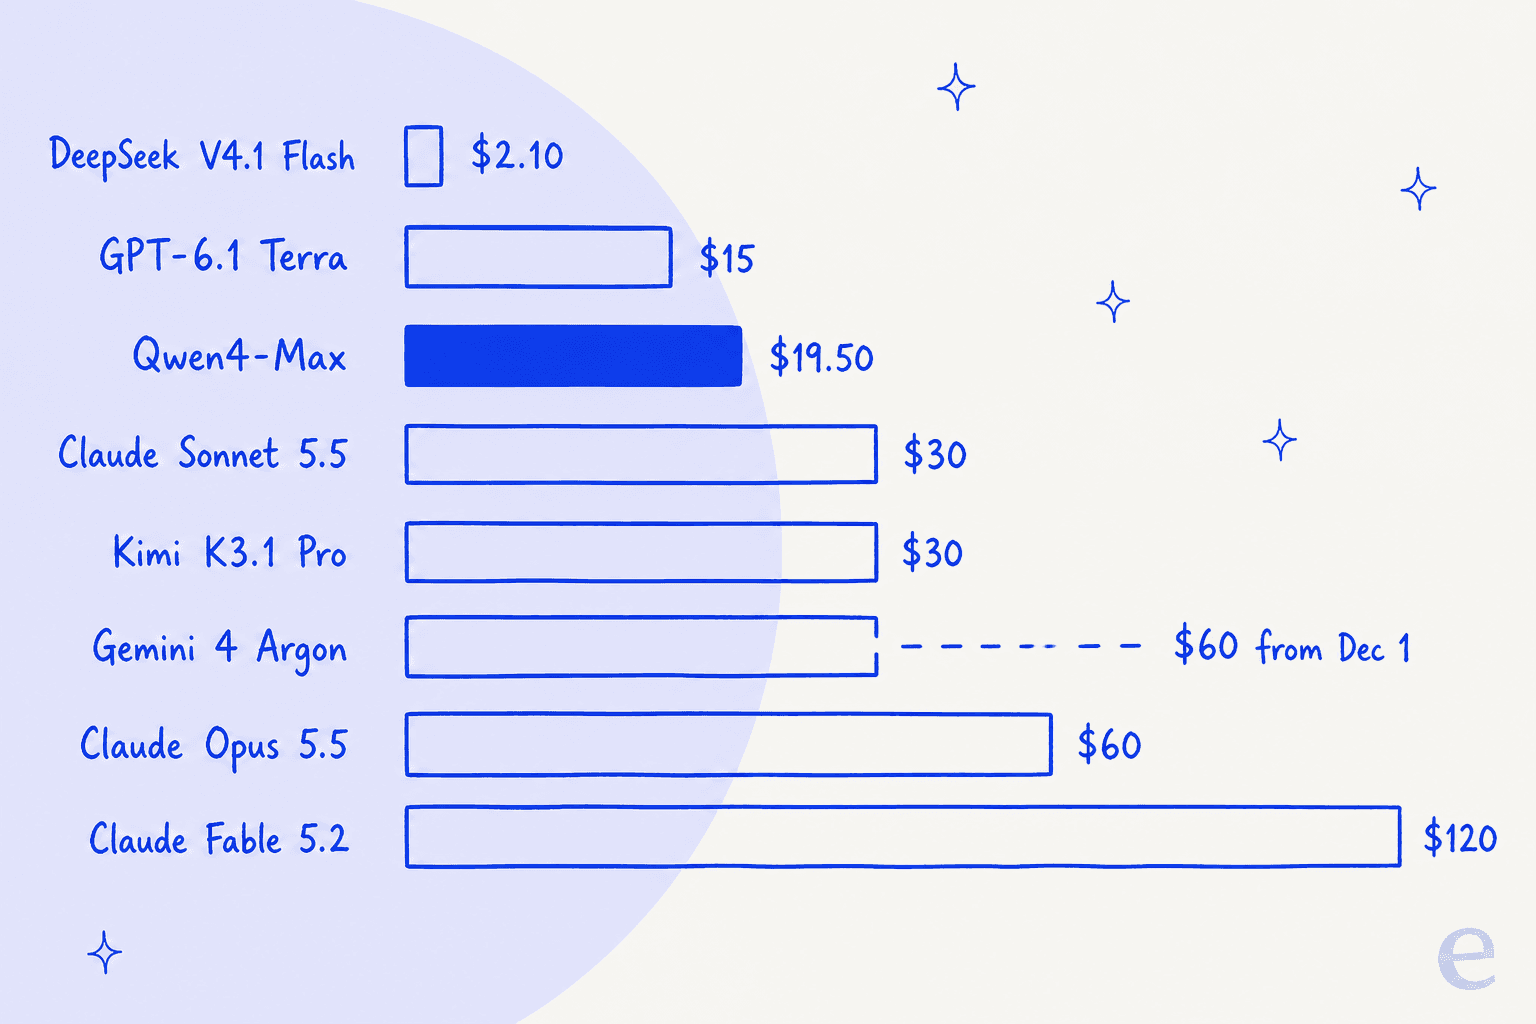
このグラフには、乗り換えを考える人の多くが予想しない意外な点があります。定価でGA版Qwen 4 Maxより安い代替は2つしかありません。他はすべて月額が高くなるため、乗り換えの理由は品質、ベンダーリスク、ツールの使いやすさであるべきで、節約ではありません。
自分の月額コストを計算する
1,000万/100万の購入者はあくまで代用の指標です。下に自分の利用量とキャッシュヒット率を入力してください。キャッシュされた入力は各ベンダーのキャッシュ読み取り価格で課金され、キャッシュ書き込みとバッチの割引は比較を単純にするため含めていません。
70%のキャッシュヒット率を試してみてください。ターンごとに同じシステムプロンプトとリポジトリのコンテキストを再送するエージェントでは一般的な値です。Claude Sonnet 5.5は30ドルから約16.70ドルに下がり、qwen4-maxは約9.53ドルに下がるため、差は約7ドルまで縮まります。
そもそもQwen 4 Maxから乗り換える理由は何ですか?
Alibabaを公平に見ると、GA版はプレビューの問題の大半を解決しています。実際のトークンあたり料金、従量課金API、Claude Code・Codex・OpenCodeでのサポートがあります。それでも人々が離れる理由は、より絞られたものです。
- **割引こそが魅力でした。**標準料率の20%なら、大量に使う人にとってプレビューはほぼ無料でした。あるHNのコメント投稿者はこの魅力を次のようにまとめています。"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"(linzhangrun, Hacker News)。GAの料率では、他のモデルが再び価格で競争できます。
- **公開された根拠が薄いことです。**私が確認した時点で
qwen4-maxの独立したリーダーボードへの登録はなく、本番導入前に数値を必要とするチームには頼れる材料が少ないです。 - **プロバイダーの集中です。**Token Plan Personalはシンガポールから提供され、料金についての記事によれば対話的な利用向けで、バックエンドの自動化向けではありません。どうせ2つ目のプロバイダーが必要なら、今が選ぶ良いタイミングです。
- **出力の上限が短くなったことです。**GA版の思考+回答の上限は262,144トークンで、プレビューの393,216トークンより低く、非常に長い単発生成では影響が出ます。
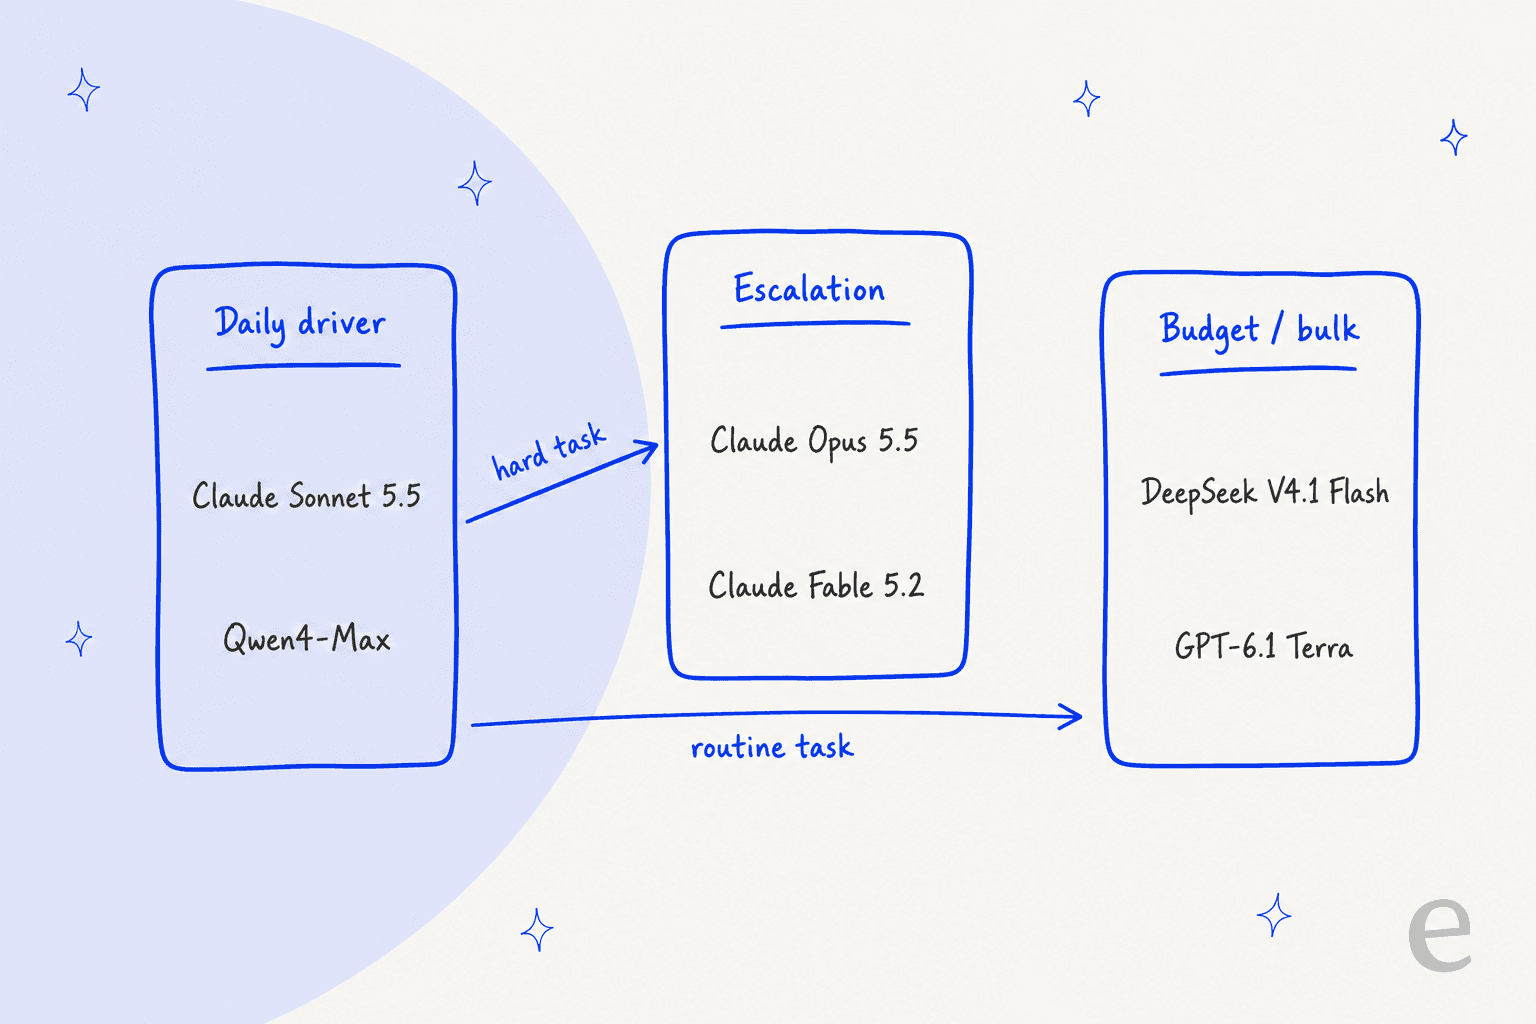
ほとんどの人はこれを1つの置き換えではなく、3つの枠として考えるべきです。ChatGPTにまさにこの質問をしたときも、同じ助言が返ってきました。日常用モデル、エスカレーション用モデル、低予算用モデルです。
1. Claude Sonnet 5.5
**最適な用途:**特にClaude Code内での、日常のコーディングとエージェント用モデルとして。
良いところ
Sonnet 5.5は、多くの人がQwen 4 Maxのプレビューを使っていた方法に最も近い代替です。100万トークンのコンテキストウィンドウを持つ、強力なエージェント的コーダーです。AnthropicのSonnetのページは、Sonnet 5より30%速く動作し、多くの作業で最大30%コストが安いとしています。AlibabaのエンドポイントにClaude Codeを向けて使っていた環境なら、これはClaude Codeがもともと想定しているモデルなので、ツール呼び出しやファイル編集はハーネスが期待する通りに動きます。
メリット
- 100万トークンのウィンドウ全体で
2ドル/10ドルの同一料金、ロングコンテキストの追加料金なし - キャッシュ読み取りが100万あたり
0.10ドルで、Opus 5.5やFable 5.2より安い - 無料のClaudeプランでもチャット用途に含まれている
デメリット
- 最大の強さで動かすと、Artificial AnalysisはタスクあたりOpus 5.5の
5.98ドルより高い7.60ドルと計測しており、Sonnet 5.5の料金分析で解説している - 入力1,000万・出力100万の購入者で月
30ドル、GA版qwen4-maxより約50%高い
料金
Anthropicの料金ページによると、100万トークンあたり入力2ドル、出力10ドル、キャッシュ読み取り0.10ドルです。入力1,000万・出力100万の購入者の場合:10 x 2ドル + 1 x 10ドル = 月30ドル。
**私たちの見解:**Claude Codeでそのまま動くモデルが欲しいなら、Sonnet 5.5を既定にしましょう。LowまたはMediumの強さで使い、SonnetをMaxに上げるのではなくOpus 5.5にエスカレーションしてください。
2. Claude Opus 5.5
**最適な用途:**最も難しい10%のタスク、つまりリポジトリ全体のリファクタリング、厄介なデバッグ、長時間の自律実行。
良いところ
Opus 5.5はエスカレーション用の枠です。AnthropicはOpusのページで、多くの作業でClaude Fable 5.1と同等の性能を発揮しながら、Opus 5より40%安く動かせるとしています。これは一部、より少ないトークンとターン数で完了することによるものです。この最後の点がエージェントにとって重要です。トークンあたりの料金は請求額の半分でしかなく、Opus 5.5のレビューでステップ数がどれだけ減るかを解説しています。
メリット
- タスクあたりのステップ数が少なく、実際の請求額は料金表から想像するより低い
- バッチAPIで両方の料率が半分になり
2ドル/10ドル - レイテンシが重要な場合に使えるFastモードがある
デメリット
4ドル/20ドルはGA版Qwen 4 Maxの入力価格の2.7倍、出力価格の4.4倍- すべてをこのモデルで動かすと、入力1,000万・出力100万の購入者で月
60ドル
料金
Anthropicの料金ページによると、100万トークンあたり入力4ドル、出力20ドル、キャッシュ読み取り0.20ドルです。入力1,000万・出力100万の購入者の場合:40ドル + 20ドル = 60ドル。詳細はOpus 5.5の料金ガイドにあります。
**私たちの見解:**Opusを既定にしないでください。SonnetやQwenが詰まるタスクをMedium強度のOpus 5.5に回すことで、全てをOpusで動かす場合の請求額の一部で、品質の大部分を得られます。
3. Claude Fable 5.2
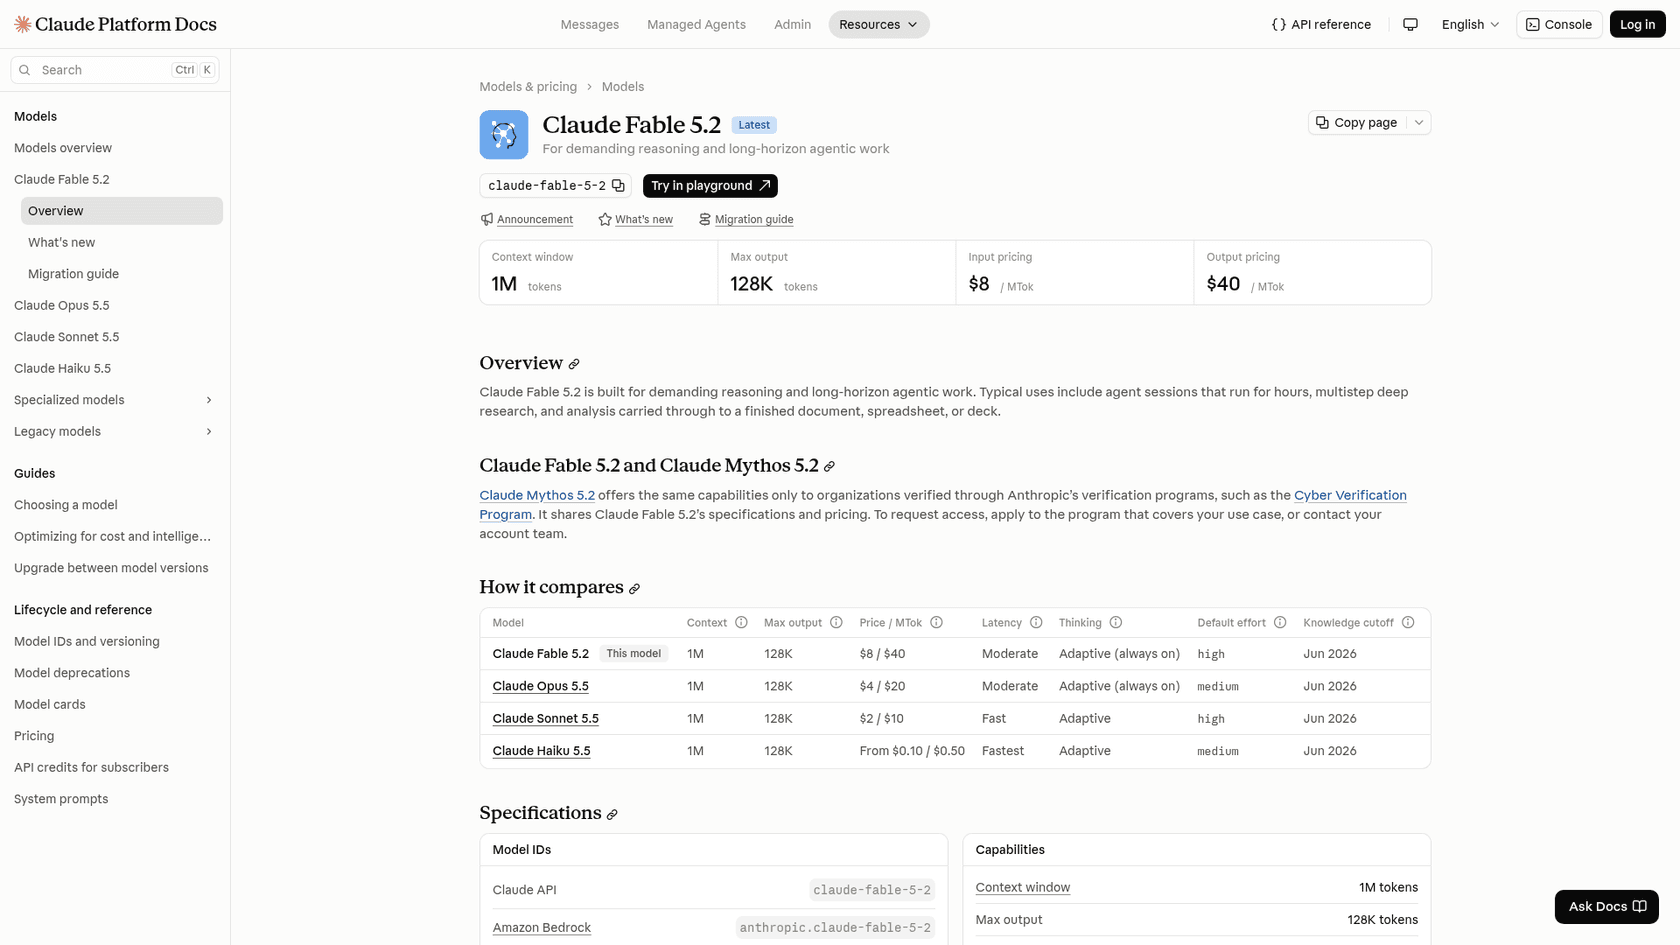
**最適な用途:**失敗した実行がトークン代以上のコストになる、最も難しく長いエージェントタスク。
良いところ
Fable 5.2はOpus 5.5の上に位置し、私の質問に対するChatGPTの回答は、確認したコーディングのリーダーボードでFable 5.2が首位だと指摘しました。有用な事実はランクではなくコストです。Anthropicは、High強度で動かしたFable 5.2が、Max強度のOpus 5.5とタスクあたり約半分のコストで同等になると計測しており、Fable 5.2の料金分析で解説しています。つまりOpusをMaxに上げたくなるようなタスクでは、High強度のFableのほうが安い選択になり得ます。
メリット
- このリストで長時間作業に最も強いモデル
- キャッシュ読み取りが
0.20ドルで、Opus 5.5と同じ - 同等の品質ならタスクあたりのコストでOpusを上回ることがある
デメリット
8ドル/40ドルの定価は、ここでは1トークンあたり最も高い- OpusやSonnetとは別の、より低いレート制限
- Proプランでは通常の利用枠ではなく使用量クレジットで動く
料金
Anthropicの料金ページによると、100万トークンあたり入力8ドル、出力40ドルです。入力1,000万・出力100万の購入者の場合:80ドル + 40ドル = 120ドル。
**私たちの見解:**日常用ではなく専門用のモデルです。他ならOpusをMaxで動かすような場面で使い、無人の実行を任せる前にFable 5.2のレビューを読んでください。
4. GPT-6.1 Terra
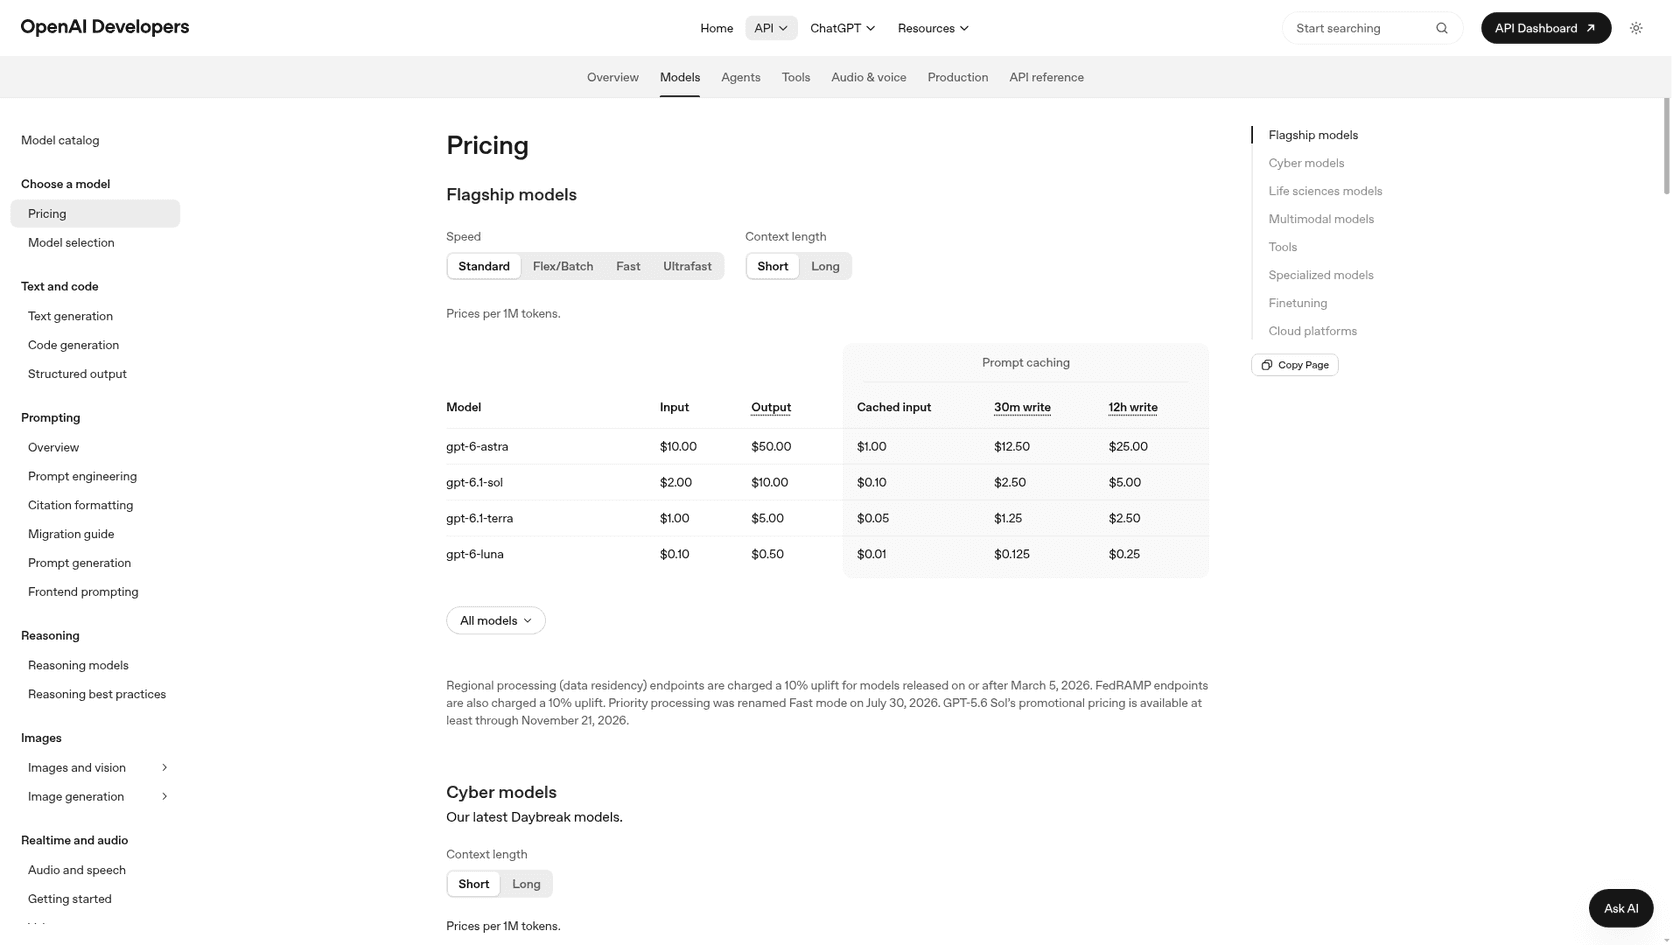
**最適な用途:**2つ目のプロバイダーから安価なフロンティア級モデルを使いたいチーム。
良いところ
Terraは、Flash級モデルに落とさずにGA版Qwen 4 Maxより料金で勝る唯一の代替です。1ドル/5ドルはGPT-6.1 Solのトークンあたり料金の半分で、Artificial Analysisはタスクあたり低強度で0.05ドル、最大強度で0.40ドルと計測しており、Terraの料金についての記事で解説しています。ローテーションにOpenAIのモデルを入れたいなら、まず試すべきはこのモデルです。
メリット
- 入力1,000万・出力100万の購入者で月
15ドル、qwen4-maxより安い - キャッシュ入力が
0.05ドルで、95%の割引 - BatchとFlexで価格が半分になり
0.50ドル/2.50ドル
デメリット
- 272Kトークンを超えるプロンプトは、リクエスト全体が入力
2ドル、出力7.50ドルで課金される - 100万トークンのウィンドウ全体をフラット料金で使いたい場合には向かない
料金
OpenAIの料金ページによると、100万トークンあたり入力1ドル、出力5ドル、キャッシュ入力0.05ドルです。入力1,000万・出力100万の購入者の場合:10ドル + 5ドル = 15ドル。
**私たちの見解:**プロンプトが272K未満に収まるなら、最もコストパフォーマンスの良い選択です。リポジトリ全体のコンテキストには、Sonnet 5.5かqwen4-maxが100万トークン全体でフラット料金を保ちます。
5. Gemini 4 Argon
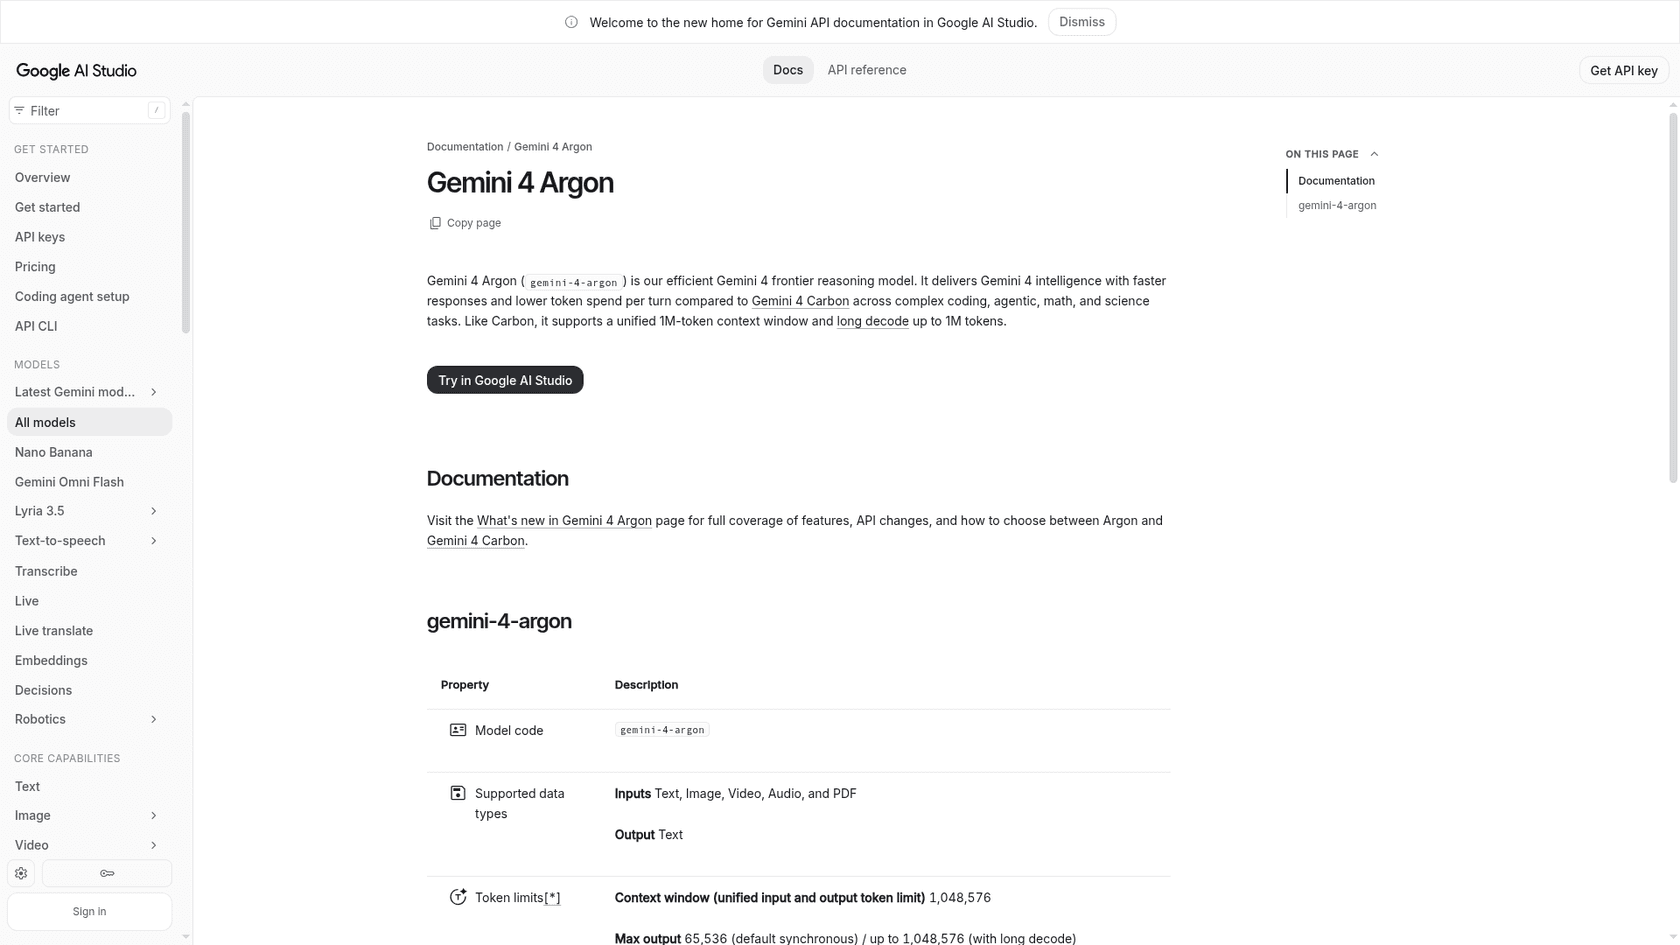
**最適な用途:**12月の価格変更を受け入れられるなら、高速なGemini 4での作業。
良いところ
Googleの料金ページは、Argonを効率重視のGemini 4モデルとし、コーディング、エージェント、数学、科学のタスクでCarbonよりも応答が速く、ターンあたりのトークン消費も少ないとしています。コンテキストウィンドウは1,048,576トークンで、Qwen 4 Maxと同じクラスです。ChatGPT自身の候補リストも、通常の作業にはArgon、難しい自律タスクにはCarbonを勧めており、Googleの位置づけと一致しています。
メリット
- 11月30日まで
2ドル/10ドル、キャッシュ入力は0.10ドル - 100万トークンのコンテキスト、ドキュメントによれば出力も最大100万トークンまでの長い復号に対応
- 他のGeminiモデルと同じGoogleアカウント・APIキーを使える
デメリット
- 2026年12月1日に価格が
4ドル/20ドルに倍増する - このモデルには無料枠がない
- 暗黙のキャッシュのみで、明示的キャッシュは非対応
料金
Googleの料金ページによると、11月30日までは入力2ドル、出力10ドル、12月1日からは4ドルと20ドルです。入力1,000万・出力100万の購入者の場合:現在は30ドル、12月以降は60ドル。タスクあたりのコスト計算はArgonの料金ガイドにあります。
**私たちの見解:**キャンペーン価格ではなく4ドル/20ドルで予算を組んでください。その価格ではOpus 5.5と同じコストになるため、決める前に両方を自分のワークロードでテストしてください。
6. Gemini 4 Carbon
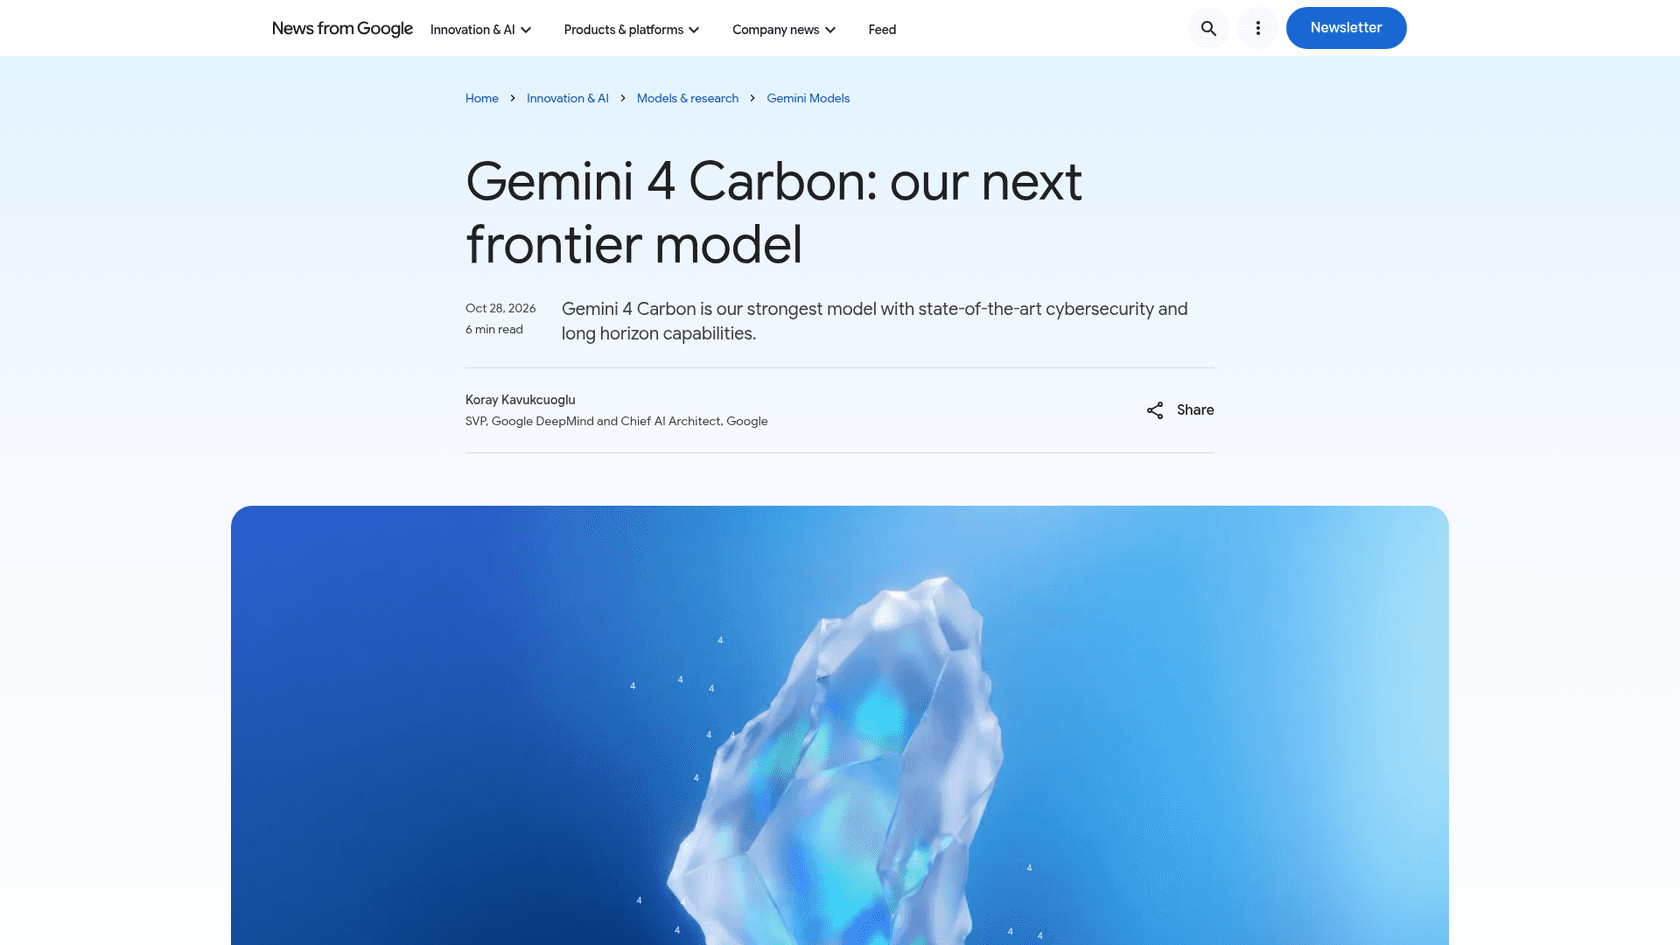
**最適な用途:**長時間動くエージェントと、Googleのスタック上で最も難しい推論。
良いところ
Carbonは料金ページによれば、複雑なソフトウェアエンジニアリング、自律的な多段階エージェント、最大100万トークンの長い復号向けに作られた、Googleで最も高性能な推論モデルです。興味深い数字があります。Artificial Analysisによると、Carbonは定価でタスクあたり7.76ドル、Argonの7.68ドルに対してほぼ同額でしたが、スコアは50に対して59でした。同じ請求額で9ポイント高いのです。
メリット
- Argonと同じ価格なので、より強力なモデルに追加料金がかからない
- 100万トークンのコンテキストと、出力も最大100万トークン
デメリット
- Argonと同じ12月1日の価格倍増
- タスクあたり多くのトークンを書き出すため、タスクあたりのコストは高くなる
料金
Googleの料金ページによると、11月30日までは2ドル/10ドル、12月1日からは4ドル/20ドルです。入力1,000万・出力100万の購入者の場合:30ドル、その後60ドル。詳細はCarbonの料金についての記事にあります。
**私たちの見解:**Geminiに移るなら、エージェント作業にはArgonではなくCarbonにしてください。ベンチマークの詳細はCarbonのレビューにあります。
7. DeepSeek V4.1 Flash
**最適な用途:**ピーク時の品質よりも料金が重要な、大量かつルーチンのエージェントステップ。
良いところ
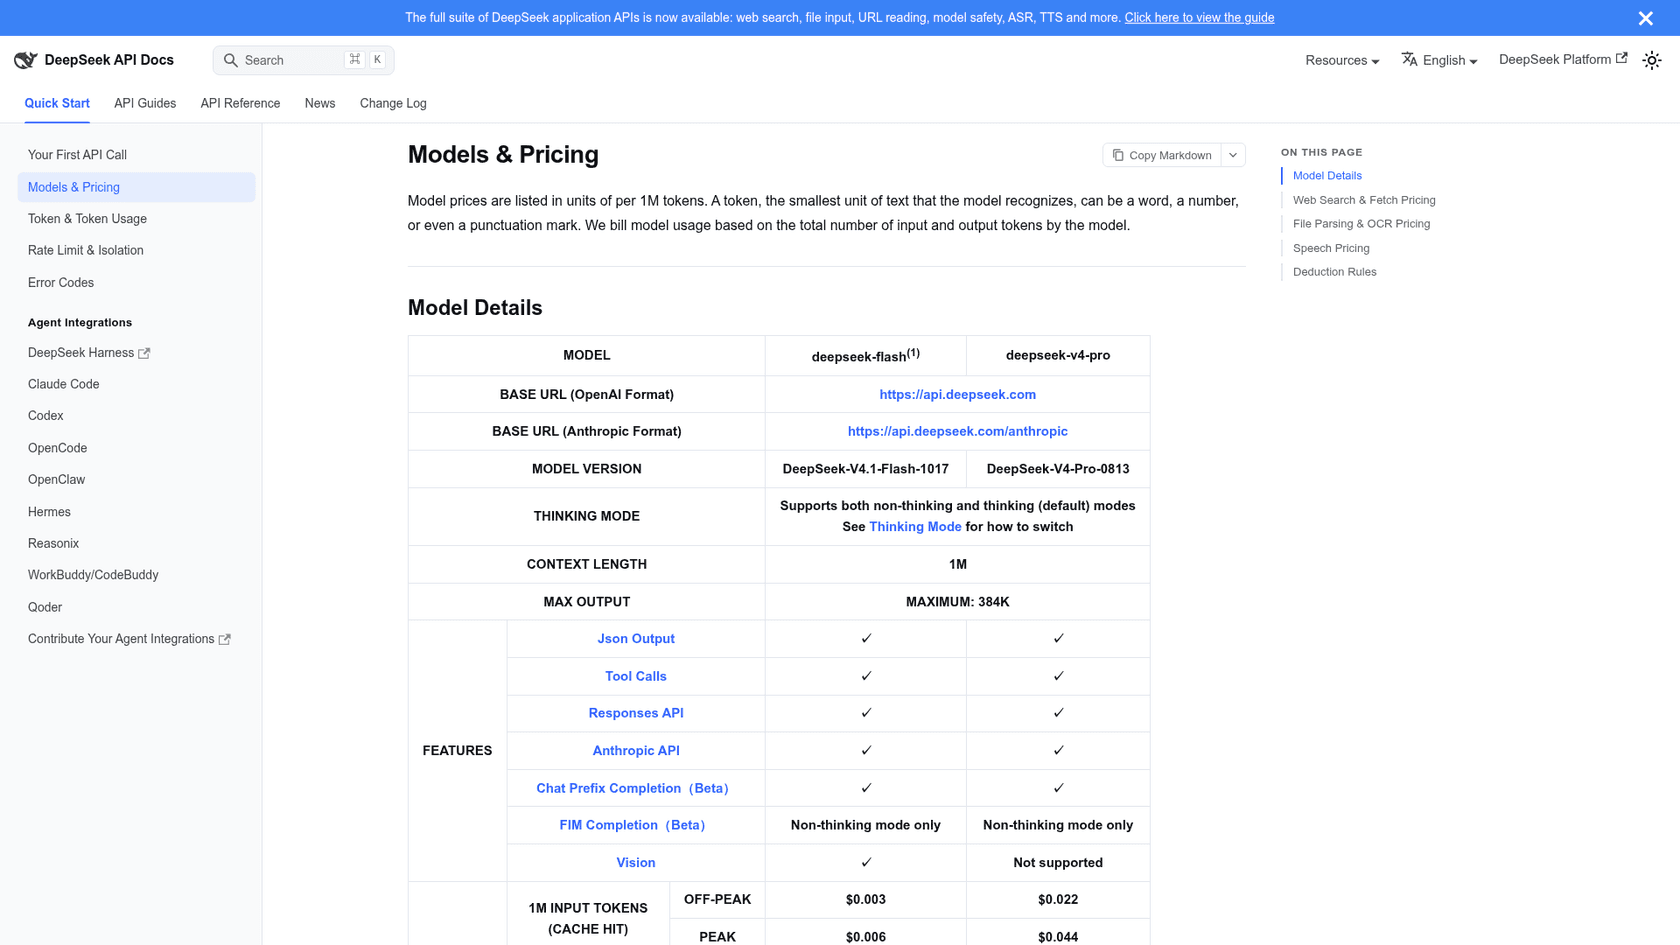
DeepSeek V4.1 Flashは、このリストの中で本格的に使えるモデルとしては、かなりの差で最も安いです。DeepSeekの料金ページによると、deepseek-flashモデル(DeepSeek-V4.1-Flash-1017)はオフピーク時に入力0.15ドル、出力0.60ドルで、100万トークンのコンテキストウィンドウと最大384Kの出力を持ちます。ツール呼び出し、JSON出力、ビジョン、OpenAIとAnthropicの両方のAPI形式に対応しているため、Claude Code風の環境にもそのまま組み込めます。Alibabaの請求にまとめたい場合、Token Planのドキュメントにもdeepseek-v4.1-flashが掲載されており、深夜は50%引きです。
メリット
- オフピーク時、入力1,000万・出力100万の購入者で月
2.10ドル - キャッシュヒットが100万あたり
0.003ドル - DeepSeek自身のAPIに加え、Token Planでも利用可能
デメリット
- ピーク時間帯(平日のUTC01:00〜04:00と06:00〜10:00)はすべての料率が2倍になる
- Flash級のモデルなので、難しいタスクには別の強力なモデルを残しておくべき
料金
DeepSeekによると、オフピーク時は100万トークンあたり入力0.15ドル(キャッシュミス)、0.003ドル(キャッシュヒット)、出力0.60ドルで、ピーク時は2倍になります。入力1,000万・出力100万の購入者の場合:オフピークで1.50ドル + 0.60ドル = 2.10ドル、ピーク時は4.20ドル。詳細はV4.1 Flashの料金ガイドにあります。
**私たちの見解:**低予算用の枠です。ログの要約、テストの作成、簡単な編集といった大量処理の作業はこちらに回し、判断力が必要な作業にはSonnet 5.5かqwen4-maxを残しておきましょう。
8. Kimi K3.1 Pro
**最適な用途:**フラット料金の選択肢がある、強力な米国外フロンティアモデルを求める開発者。
良いところ
Qwenで気に入っていた点が大手の米国系ラボ以外で有能なモデルを使えることなら、Kimi K3.1 Proは明快な選択です。Moonshotのクイックスタートは、これを100万トークンのコンテキストウィンドウを持つ3T級モデルと説明しており、APIはOpenAIとAnthropicの両方の形式に対応しているため、Claude Codeでも動きます。K3.1 Proの料金分析によると、Artificial Analysisではタスクあたり平均2.11ドルで、最大強度のSonnet 5.5やOpus 5.5のタスクあたりコストの半分未満でした。
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
メリット
- 1トークンあたり
2ドル/10ドル、またはフラット料金プランが月19ドル〜199ドル - Highspeed版は約2〜3倍速い
- Moonshotはコーディング、3D生成、金融調査で大きな成果を挙げていると述べている
デメリット
- 多くのトークンを書き出すため、タスクあたりの節約額は定価から想像するより小さい
- サブスクリプションプランには5時間のローリング制限があり、早期の購入者はすぐに到達する
料金
Kimiの料金ページによると、100万トークンあたり入力2ドル、出力10ドル、キャッシュ入力0.20ドルです。Highspeedは4ドル/20ドル。入力1,000万・出力100万の購入者の場合:30ドル。
**私たちの見解:**AlibabaとUS系ラボの両方を避けたいなら、良い2つ目のプロバイダーです。大量のエージェント利用でサブスクリプションプランを買う前に、K3.1 Proのレビューを読んでください。
9. Qwen3.8-Max
**最適な用途:**深夜割引付きの、より古くドキュメントも充実したQwenの旗艦モデルを求めるToken Planの利用者。
良いところ
Qwen3.8-Maxはファミリー内の控えの選択肢です。Alibabaはこれを長時間自律的にコーディングできる2.4兆パラメータのMoE旗艦モデルと説明しており、Qwen 4 Maxと同じToken Plan上で動くため、キーやエンドポイントは変わりません。Token Planでは、米国の勤務時間に相当するUTC+8の22:00〜08:00に60%の割引が今も続いています。Qwen3.8-Maxのレビューで、発売後の評価を解説しています。
メリット
- すでにToken Planを使っているなら、モデルID以外の設定変更は不要
- 深夜割引はToken Planで継続中
- 数か月分のコミュニティでの利用実績がある
デメリット
- 従量課金APIではGA版
qwen4-maxより高い(2ドル/6ドルに対し1.50ドル/4.50ドル) - 置き換え先のモデルより古い世代
料金
Alibabaのqwen3.8-maxのページによると、シンガポールで100万トークンあたり入力2ドル、出力6ドル、北京では1.65ドルと4.951ドルです。入力1,000万・出力100万の購入者の場合:26ドル。
**私たちの見解:**深夜割引のためだけに、Token Planでのみ価値があります。APIではGA版qwen4-maxのほうが新しく安いため、一歩後退する理由はほとんどありません。
自分の環境にはどのQwen 4 Max代替が合いますか?
答えは主に、プレビューをどこで動かしていたかによります。
- **Token PlanでのClaude Code:**まずモデルIDを
qwen4-maxに変更してください。結果が物足りない場合は、OpusのスロットをClaude Opus 5.5に、SonnetのスロットをClaude Sonnet 5.5に移してください。 - **APIを使う自前のエージェント:**2つ目のプロバイダーを追加してください。日常用モデルにはSonnet 5.5かGPT-6.1 Terra、大量呼び出しにはDeepSeek V4.1 Flashを使います。
- **主に割引目的だった場合:**オフピーク時のDeepSeek V4.1 Flashが、プレビューの価格に最も近いです。
- **長時間動く自律実行:**Claude Fable 5.2かGemini 4 Carbonを、12月1日より前に並べてテストしてください。
- **サポートや顧客対応のボット:**プレビューモデルを顧客の前に出さないでください。これはマネージドエージェントが当てはまるケースで、次に詳しく説明します。
| 必要なもの | 選択 | 月額(入力1,000万、出力100万) |
|---|---|---|
| 最小限の変更 | qwen4-max(GA) | 19.50ドル |
| 最高の日常用コーディングモデル | Claude Sonnet 5.5 | 30ドル |
| 最も難しいタスク | Claude Opus 5.5またはFable 5.2 | 60ドルまたは120ドル |
| 最安の価格 | DeepSeek V4.1 Flash | オフピーク2.10ドル |
| 低予算の2つ目のプロバイダー | GPT-6.1 Terra | 15ドル |
| 米国外のフロンティアモデル | Kimi K3.1 Pro | 30ドル |
プレビューがサポートキューを動かしていた場合はどうなりますか?
その場合、モデルIDは本当の問題ではなかったことになります。固定の期日で終了する2週間のプレビューは、サポートチームが生のモデルを直接ヘルプデスクに組み込むべきではない理由を最もはっきり示す例です。ベンダー側のあらゆる変更が、自分たちの移行作業、再テスト、そしてリスクになってしまいます。
eeselが埋めるのはまさにその隙間です。上記のようなモデルはインフラであり、eeselは従業員です。eeselのAIヘルプデスクのチームメイトはZendeskやFreshdeskに接続し、過去のチケットとヘルプセンターから学習し、実際の顧客に回答する前に過去の会話でテストされます。より良いモデルが登場したときの切り替えは、eesel側で行われます。
2つの顧客の実例を紹介します。
- SE Rankingは1つのZendeskチームから3つのプロダクトを運用しており、プロダクトごとに1つのeeselエージェントが約16,800ページのヘルプコンテンツを検索しています。1か月で約4,650件の会話を処理しましたが、その裏でどのモデルが動いていたかには一切依存していません。
- OroSoftは貴金属取引ソフトウェアを作っており、Freshdeskで顧客をサポートしています。eeselは過去の6,100件のチケットと20件のヘルプセンター・参考資料から回答を作成し、どのチケットや記事を使ったかを示し、回答の根拠が見つからない場合は担当者にフラグを立てます。
eeselを試す
顧客への回答のためにQwen 4 Maxのプレビューを試していたなら、eeselはモデルの入れ替えなしで同等のエージェントを提供します。数分でヘルプデスクに参加し、自社のヘルプコンテンツから回答を作成または送信し、公開前に過去のチケットにどう回答していたかを確認できます。プランはeeselの料金ページで月299ドルから始まり、試すための無料クレジット100個付きです。コーディングエージェントはeesel CLI経由でセットアップを進め、承認済みのヘルプ記事をアップロードしてテスト用の質問を投げることができますが、ヘルプデスク自体の接続には管理者の承認が今も必要です。
eeselを無料で試すか、先にZendesk向けAIの仕組みを読んでみてください。