

Qwen 4 Maxはアリババの次期フラッグシップモデルで、今のところqwen4-max-previewとしてToken Planのサブスクリプションでのみ利用できる。新規ユーザーは月3ドルから、2026年11月25日までだ。これは100万トークンのコンテキストを持つマルチモーダル推論モデルで、最大出力は393,216トークンだ。設定で引っかかる人が多い。Alibaba自身のClaude Code設定はQwen 4 MaxをOpusスロットに置き、ルーターのautoをメインスロットに置くため、Opusを選ばない限りQwen 4 Maxを呼び出していないかもしれない。サポートチケット向けのAIなら、eeselは代わりに安定したモデルで動き、eesel CLIを使えばコーディングエージェントがまずヘルプ記事を読み込み、回答をテストできる。
Qwen 4 Maxとは何か?
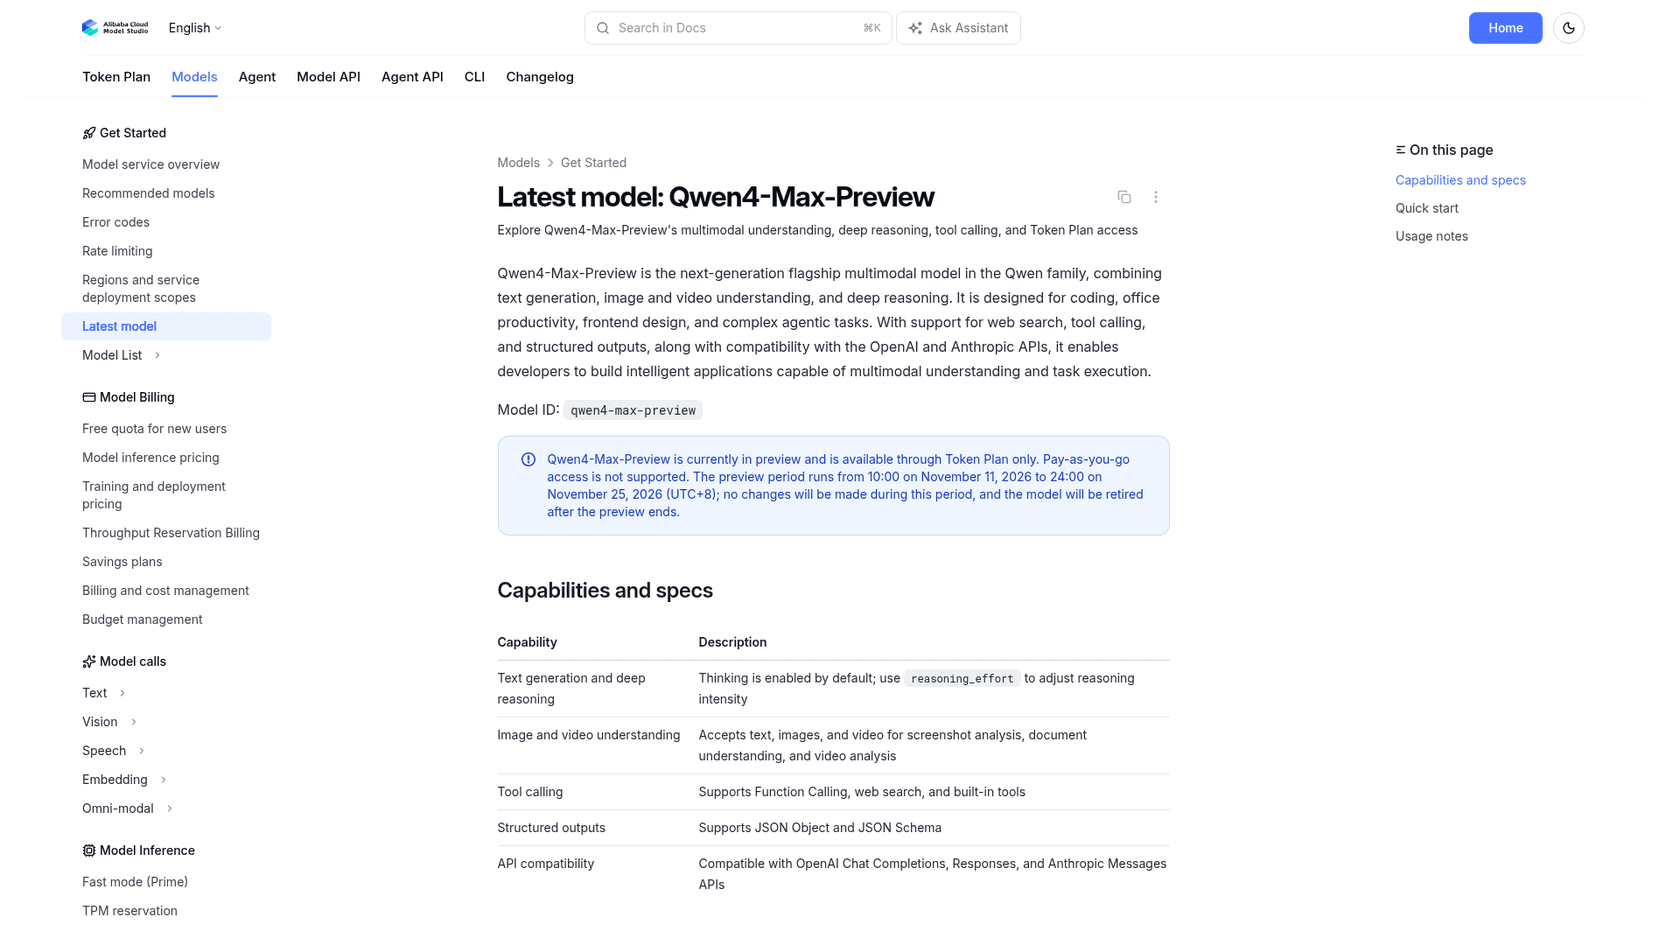
Qwen 4 Maxはアリババのqwen 4世代の最初のモデルで、2026年11月11日にqwen4-max-previewという名前のプレビューとして公開された。Alibabaのモデルドキュメントは、これをコーディング、オフィス業務、フロントエンドデザイン、エージェントタスクを対象とした、Qwenファミリーの次世代フラッグシップ・マルチモーダルモデルだと説明している。
私はeeselでインテグレーションを作るのが仕事なので、新しいモデルが出るたびに最初に気になるのは地味な質問だ。設定に何を書けばいいのか、そしてそれをすると何が壊れるのか。この記事はそれに答える。モデルの出来そのものについての意見は、同僚によるQwen 4 Maxレビューにある。
Alibabaが現時点で確認している内容は次の通りだ:
| 仕様 | Qwen 4 Max preview |
|---|---|
| モデルID | qwen4-max-preview(エイリアスqwen4.0-max-preview、請求書にはエイリアスが表示される) |
| 入力 | テキスト、画像、動画 |
| コンテキスト長 | 100万トークン |
| 最大出力 | 393,216トークン、思考と回答で共有 |
| 思考(Thinking) | デフォルトでオン。low、medium、xhigh(デフォルト) |
| ツール | Function calling、ウェブ検索、組み込みツール |
| 構造化出力 | JSON ObjectとJSON Schema |
| APIフォーマット | OpenAI Chat Completions、Responses、Anthropic Messages |
| アクセス | Token Planのみ、従量課金なし |
| 利用可能期間 | 11月11日10:00から11月25日24:00まで、2026年(UTC+8)、その後廃止 |
パラメータ数も、オープンウェイトも、モデルカードも、ベンチマーク表もない。2週間のプレビューとしてはそれが普通だが、これは計画の対象にするモデルではなく、試すためのモデルだということを意味する。
Qwen 4 MaxはQwenのラインアップのどこに位置するか?
Qwen 4 Maxはアリババのホスト型ラインアップの頂点に立ち、Qwen 3.8 Maxの一段上にある。Token Planのモデル一覧では両者が並んでおり、今日実際に呼び出せるものが何かを最もはっきり示している:
| Token Plan上のモデルID | Alibabaが挙げている用途 | ステータス |
|---|---|---|
qwen4-max-preview | 推論、視覚理解、テキスト | プレビュー、11月25日に廃止 |
qwen3.8-max | 推論、視覚理解、テキスト | リリース済み |
qwen3.8-flash | 推論、視覚理解、テキスト | リリース済み |
qwen3.7-max | 推論、テキスト | リリース済み |
qwen3.7-plus | 推論、視覚理解、テキスト | リリース済み |
qwen3.6-flash | 推論、視覚理解、テキスト | リリース済み |
auto | リクエストごとにモデルを選択 | プラットフォームのルーター |
同じプランにはDeepSeek V4.1 Flash、DeepSeek V4 Pro、GLM 5.3、GLM 5.2、さらに画像・動画・音声モデルも含まれる。つまり1つのサブスクリプションで、同じタスクで比較できる一握りのモデルと並んでQwen 4 Maxが手に入るわけで、これがプレビューの最良の使い方だ。
欠けているのは、多くの人がQwenで最も気に入っている部分、つまりローカルで動かせる小型モデルだ。Maxティアはホスト型のみで、プレビューはオープンウェイトなしで出荷される。自分のハードウェアでQwenを動かしているなら、注目すべきは小型のQwen 4モデルで、それまでのつなぎとしてはQwen 3.8 Flash Nextが現時点の選択肢だ。
Qwen 4 Maxの料金はいくらか?
Qwen 4 Maxには1トークンあたりの価格はない。Token Planのサブスクリプションをクレジットで支払う仕組みで、Alibabaは1回のQwen 4 Max呼び出しに対する標準クレジットレートを公開しておらず、そこにかかるプレビュー割引だけを公開している。Personal Editionの各ティアはToken Planのドキュメントによるものだ:
| プラン | 定価 | 新規ユーザー価格 | 月間クレジット | 同時エージェント数 |
|---|---|---|---|---|
| Lite | 月6ドル | 月3ドル | 20,000 | 1-2 |
| Essential | 月10ドル | 月5ドル | 45,000 | 2-3 |
| Standard | 月18ドル | - | 80,000 | 3-4 |
| Pro | 月43ドル | - | 200,000 | 6-8 |
新規ユーザー価格は、Personalサブスクリプションを一度も購入していないアカウントを対象に、2026年11月30日23:59(UTC+8)まで続く。追加バンドルは20,000クレジットで15ドル、一度に5つまで購入できる。プレビュー中、Qwen 4 Maxは標準レートの20%、北京時間22:00から8:00の間は8%でクレジットを消費する。これは米国の勤務時間帯にあたる。
支払う前に読んでおく価値がある条件が2つある。Personal Editionは解約できないので、最短の期間を選ぶこと。そして使い切らなかったクレジットは翌月に持ち越されない。2週間の試用なら、3ドルのLiteプランでほとんどの人には十分だ。予算を計画できる料金表のあるモデルが欲しいなら、Qwen 3.8 Max料金は100万トークンあたり入力2ドル・出力6ドルだ。
Qwen 4 Maxへのアクセスはどうやって手に入れるか?
AlibabaのToken Planクイックスタートによれば、アクセスは3ステップで手に入る。登録し、キーを発行し、ツールを正しいエンドポイントに向ける。
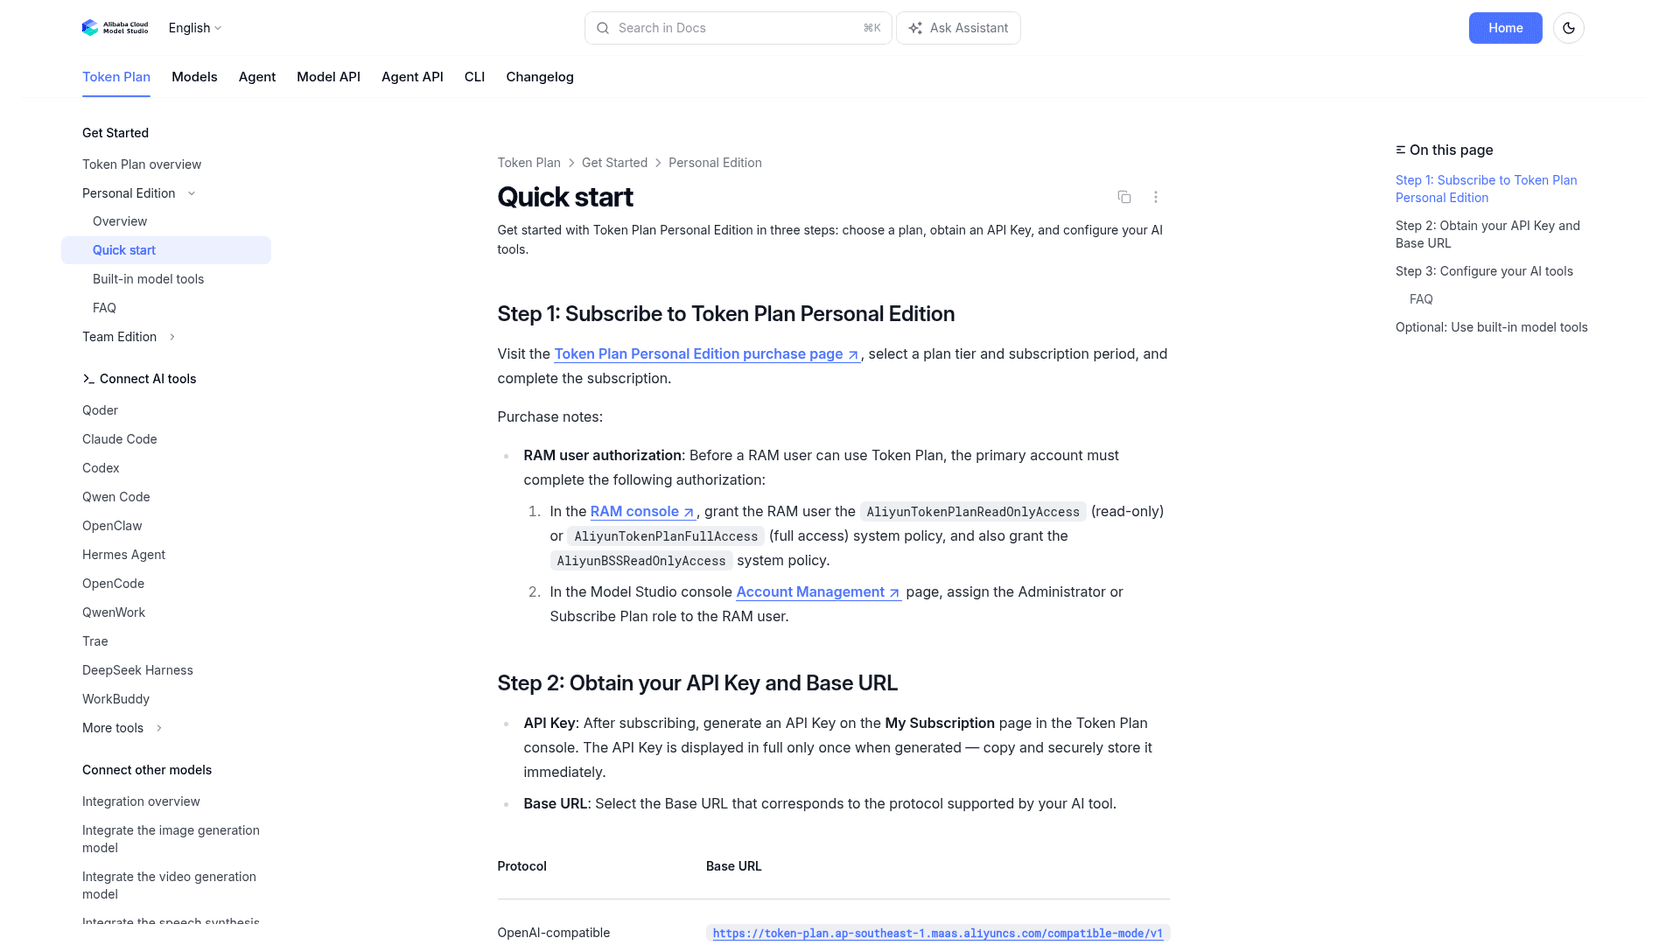
- 登録する:Token Plan Personal(シンガポールリージョンのみ)に登録し、ティアを選ぶ。
- APIキーを発行する:My Subscriptionページで発行する。全体が表示されるのは一度だけなので、すぐにコピーすること。Token Planのキーは
sk-sp-で始まる。 - Token PlanのベースURLを使う:ツールのプロトコルに応じて使う:
| プロトコル | ベースURL |
|---|---|
| OpenAI互換 | https://token-plan.ap-southeast-1.maas.aliyuncs.com/compatible-mode/v1 |
| Anthropic互換 | https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic |
そのうえでモデルIDをqwen4-max-previewに設定する。
キーとエンドポイントは一致させる必要がある
これは実際にお金がかかる間違いだ。AlibabaはToken Plan、Coding Plan、従量課金という3つの別々の請求チャネルを運用しており、それぞれに専用のキーとベースURLがある。Token PlanのFAQによれば、汎用のdashscope-intl.aliyuncs.comエンドポイントやCoding Planのキーを使うと、呼び出しは代わりに従量課金として処理され、その料金はクレジットで相殺することも返金することもできない。
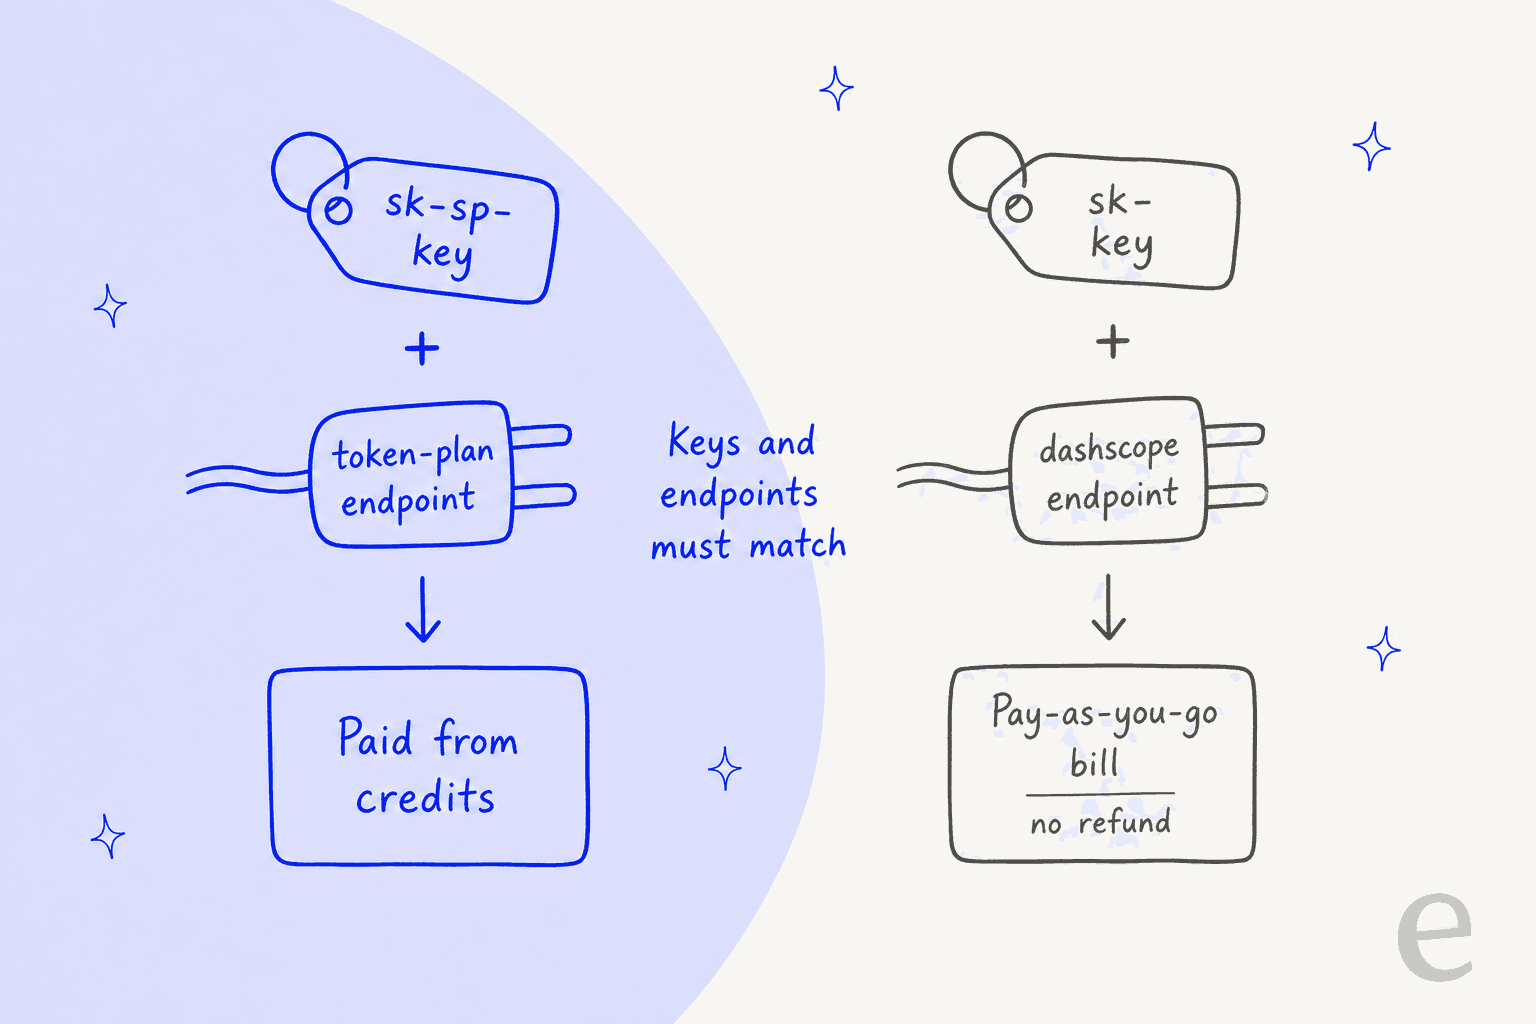
以前にAlibaba経由でQwenを使っていたなら、ツールの設定にはおそらく古いsk-キーとDashScopeのURLがまだ残っている。キー、URL、モデル名をすべて入れ替えること。
Claude CodeでQwen 4 Maxを動かすにはどうすればいいか?
Claude CodeをToken PlanのAnthropicエンドポイントに向け、モデルスロットをqwen4-max-previewに割り当てることで動かす。AlibabaのClaude Codeガイドは、CLI向けにこの設定を示している:
export ANTHROPIC_AUTH_TOKEN="YOUR_API_KEY"
export ANTHROPIC_BASE_URL="https://token-plan.ap-southeast-1.maas.aliyuncs.com/apps/anthropic"
export ANTHROPIC_MODEL="auto"
export ANTHROPIC_DEFAULT_HAIKU_MODEL="qwen3.6-flash"
export ANTHROPIC_DEFAULT_SONNET_MODEL="qwen3.8-flash"
export ANTHROPIC_DEFAULT_OPUS_MODEL="qwen4-max-preview"
export CLAUDE_CODE_SUBAGENT_MODEL="auto"
export CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"
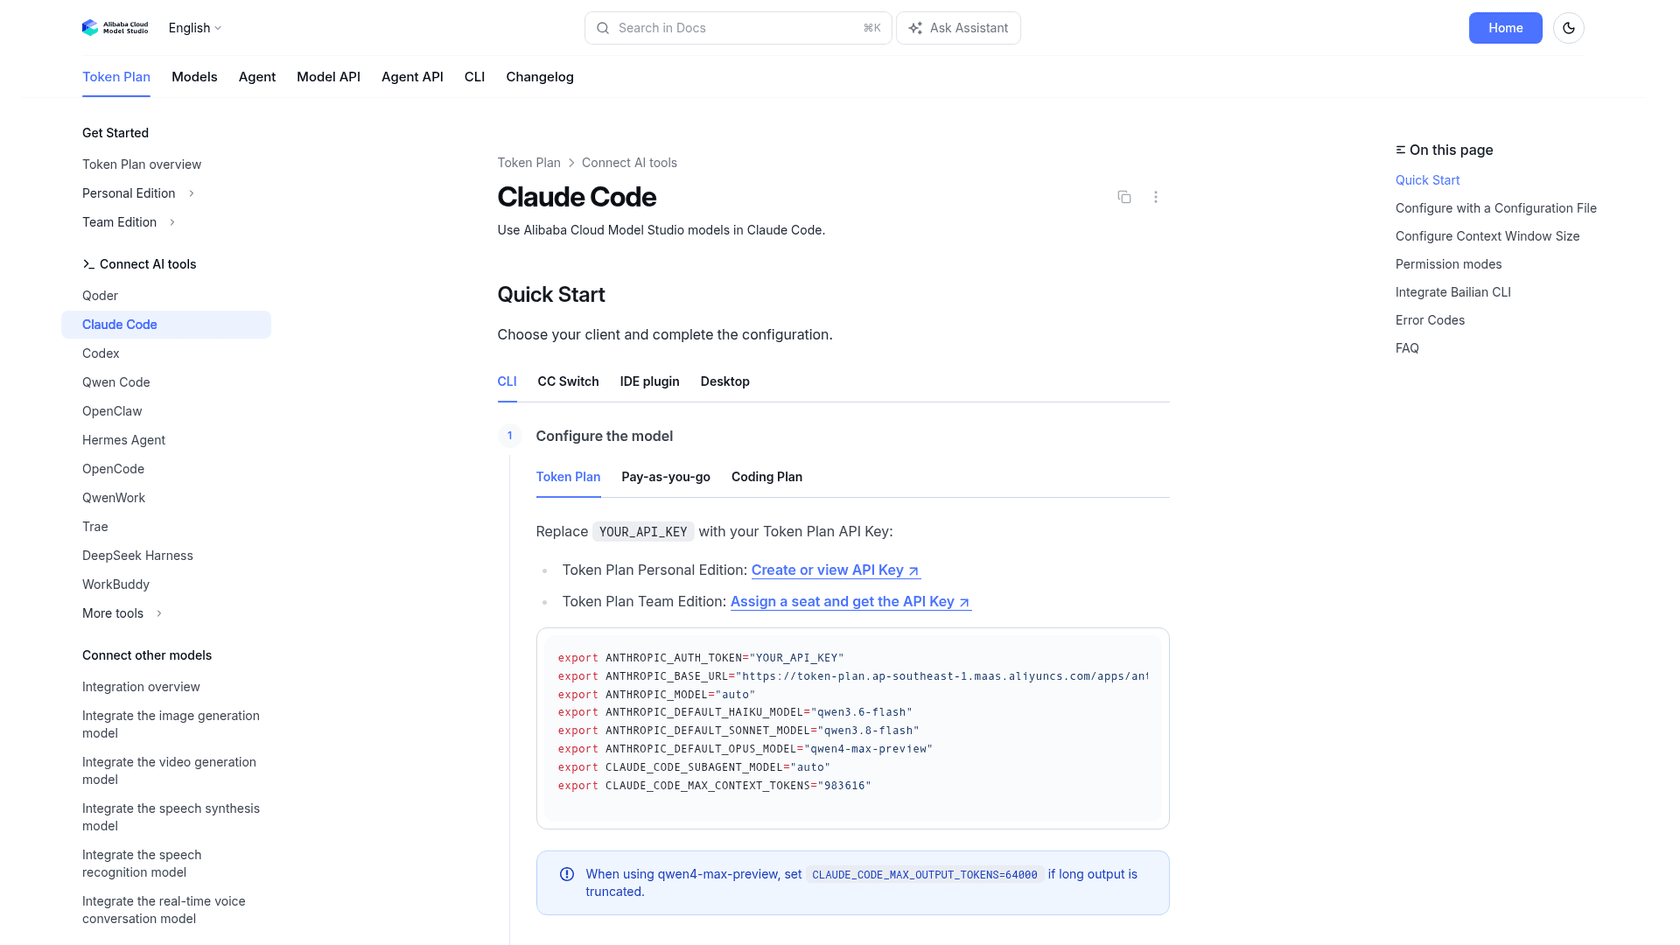
このブロックはよく読んでほしい。ほとんどの人が期待する動きをしないからだ。メインモデルはAlibabaのルーターであるautoで、サブエージェントも同様だ。Qwen 4 MaxはOpusスロットにしか入っていない。
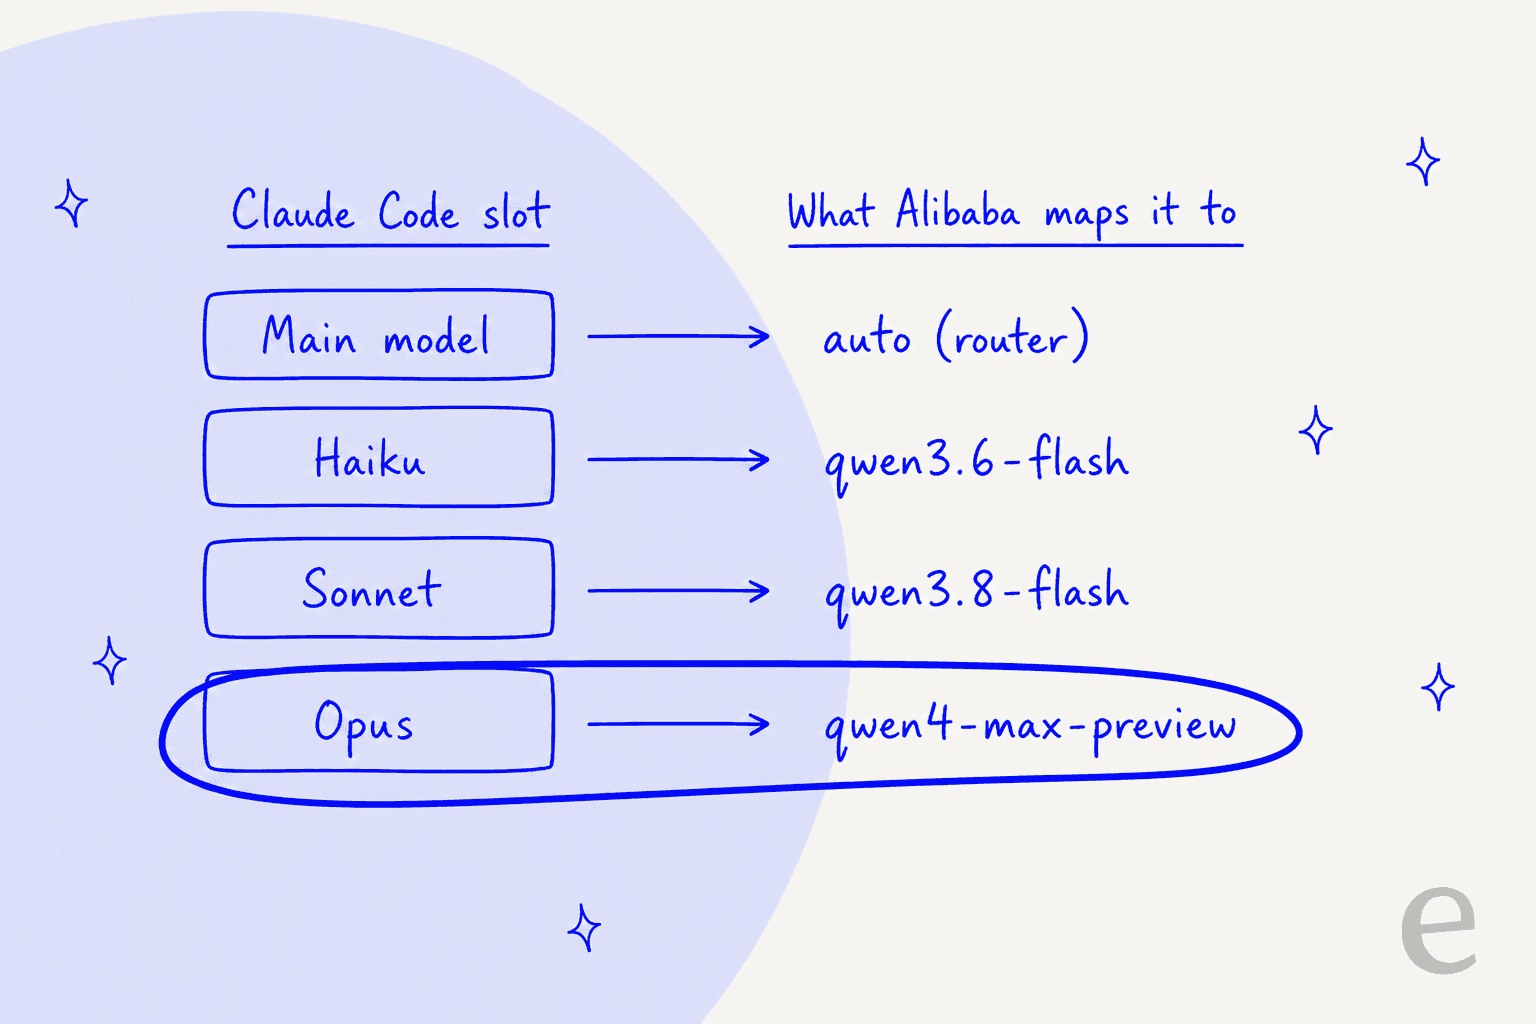
つまりこれをそのまま貼ってセッションを始めると、あなたのプロンプトはautoが選んだ先に送られ、Qwen 4 Maxには送られない。新モデルを実際にテストするには、セッション内で/model opusに切り替えるか、自分でANTHROPIC_MODEL="qwen4-max-preview"を設定する。モデルを比較しているなら後者を選ぶこと。そうすればテストのすべてのターンが同じモデルで動く。Claude Codeのモデル選択ガイドでスロットの仕組みを解説している。
さらに重要な設定が3つある:
- 出力の長さ。 ドキュメントによれば、
qwen4-max-previewで長い出力が途切れる場合はCLAUDE_CODE_MAX_OUTPUT_TOKENS=64000を設定すること。 - コンテキスト。
CLAUDE_CODE_MAX_CONTEXT_TOKENS="983616"を設定すると、Claude Codeが100万トークンのウィンドウの大部分を使えるようになる。それが何を変えるかはClaude Codeのコンテキストウィンドウガイドを参照。 - 永続化。 これらのexportは現在のターミナルでしか効かない。設定を永続させるには、同じキーを
~/.claude/settings.jsonのenv以下に書く。詳しくはClaude Codeの設定ガイドを参照。
claude -p "Hello"を実行して接続を確認する。Claude Code Desktopの場合、Alibabaのガイドは環境変数ではなくCC Switchと呼ばれるローカルゲートウェイ経由でこれを行う。
Qwen Code、Cursor、その他のツール
Qwen CodeはOpenAI互換エンドポイントを使う。Alibabaのサンプル~/.qwen/settings.jsonはqwen4-max-previewを「Qwen4.0 Max Preview」という独自のプロバイダーエントリとして記載しているので、スロットの割り当てではなく名前で選ぶ。Cursor、OpenAI Codex、OpenCode、OpenClaw、Cline、Qoder、Hermes AgentにもToken Planのガイドがある。それぞれで確認すべき点は2つだ。ベースURLがtoken-plan系であること、そしてモデルIDが正確にqwen4-max-previewであることだ。
直接呼び出す開発者にとって何が変わるか?
この機種で新しくなった動きが2つあり、どちらも古いQwenモデルで動いていた設定を壊しかねない。
max_tokensは今では思考も含むようになった。 Alibabaの互換性に関する通知によれば、qwen4-max-preview以降、Chat Completionsではmax_tokensはmax_completion_tokensと同じ意味になり、思考と最終回答をまとめて制限する。思考はデフォルトでxhighになっている。回答のためだけにmax_tokensを設定していた場合、推論が予算を食い尽くし、回答が途中で切れて返ってくる。古いQwenモデルは以前の動きのままなので、モデルIDを切り替えたときにこれにはまる人が多い。
思考は送り返す必要がある。 Chat Completionsはデフォルトでpreserve_thinkingをオンにする。モデルのドキュメントは、以前の思考を各assistantメッセージのreasoning_contentフィールドに送り返すよう求めており、contentの中には入れない。また、reasoning_effortとthinking_budgetを同時に設定してはいけない。
もう一つ。組み込みツール(ウェブ検索、画像検索、ウェブスクレイピング、コードインタープリタ)はクイックスタートによれば、Chat CompletionsではなくResponses APIを通してのみ動く。ツールがChat Completionsしか話さないなら、これらは使えない。
Qwen 4 Maxの設定チェック
自分の設定に当てはまるものにチェックを入れよう。チェックが入らなかった項目が、動かない理由である可能性が高い。
Qwen 4 Maxでできないことは何か?
Qwen 4 Maxの上に製品を構築することはできない。理由はモデルの出来の良さとは関係のない2つだ。
第一に、これは一時的なものだ。ドキュメントには、プレビュー期間中は変更を行わず、終了時にモデルを廃止すると書かれている。qwen4-max-previewを呼び出すものは、11月25日以降すべて動かなくなる。
第二に、Token Planがそれを禁止している。サブスクリプション規約には、このプランはコーディングツールやエージェントツール内での対話的な利用だけを想定しており、「自動化スクリプト、独自のアプリケーションバックエンド、または非対話的なバッチ呼び出しのシナリオ」には使ってはならないと書かれている。FAQはさらに、スケジュールされたバックグラウンドタスクも対象に含まれ、キーの共有はサスペンドの対象になりうると加えている。つまりサポートチャットボット、チケット分類器、あるいはこのキーにつながれたAIカスタマーサービスAPIは、最初の呼び出しからすでにルール違反になる。
初期ユーザーはすでにこれを試乗として捉えている。あるHacker Newsのコメント投稿者は、この条件を一行でまとめた:
"By November 25th, Beijing time daytime (8am-22pm) -80%, and at night (Western daytime) even -92%!"

品質については、まだ合意ができていない。広く共有されたXの投稿は、投稿者自身が噂だと認めている内容を根拠に「disappointing(残念)」と評したが、実際にテストしている人からの返信はそれに反論した:
"It's preview; Qwen4-max-preview. It's not disappointing at all, at least so far in my one-shots, but more testing is going on and i'll have a clear answer."
私のアドバイスは、Claude Fable 5.2やGPT-6.1 Terraのような、すでに普段使っているモデルで解決済みのタスクでこれを試し、それをもとに判断することだ。2週間で固定されるモデルは、試すには公平だが、その上に構築するには心もとない。
Qwen 4 Maxはサポートチームにとって何を意味するか?
サポートチームにとって、Qwen 4 Maxは自分のデスクで試すモデルであり、自分のキューに載せるモデルではない。規約と廃止日がそれを決めている。
より大きな教訓は、ローンチの週ごとに繰り返される。モデルはエンジンであり、エージェントではない。チケット上でAIを実際に役立たせるのは、その周りのレイヤーだ。ヘルプセンター、過去のチケット、人に引き渡すタイミングのルール、そして何かが顧客に届く前に実際の会話に対してテストすることだ。そのために作られているのがeeselのヘルプデスク向けAIチームメイトだ。すでに運用しているZendeskやFreshdeskのキューに加わり、履歴から学習し、まず過去のチケットに対してシミュレーションされる。
OroSoftはグラウンディングの部分の良い例だ。貴金属取引ソフトウェアを作っており、Freshdeskで顧客をサポートしている。エージェントがチケット上でeeselにメンションすると、6,100件の過去チケットと20件のヘルプセンター・参照ファイルから返信を作成し、どのチケットや記事を使ったかを示し、回答の裏付けが見つからないときは人を求めるメモを残す。ドイツのローン比較サイトであるsmavaは、2つのZendeskブランドでeeselを運用し、1か月に27,000件のチケットを処理した。
どちらの運用も、新しいモデルがローンチしても変わらない。それがポイントだ。モデルが自社のサポートコンテンツをどう扱うか気になるなら、ヘルプデスクにClaudeを接続する、AIエージェントのハンドオフ、ハルシネーションを防ぐといったガイドのほうが、プレビューのキーよりもよい出発点になる。
Qwen 4 Maxは今週設定すべきか?
コーディングエージェントで生活していて、100万コンテキストのQwenを2週間安く使いたいなら、イエスだ。3ドルのLiteプラン、20%のクレジットレート、8%のナイトレートのおかげで、モデルスロットを正しく設定し、キーをToken Planのエンドポイントに正しく対応させれば、ほぼ無料で試せる。
アプリやボット、予算のためのモデルが必要なら、ノーだ。そのためには従量課金のQwen 3.8 Maxを使い、Alibabaが価格とベンチマーク付きの完全版Qwen 4 Maxを出荷したら、また確認すればいい。ファミリー全体を広く見るなら、Qwenの概要とQwenの代替が残りをカバーしている。
サポートキューのAIにeeselを試す
本当に欲しいものが顧客に答えるAIなら、eeselはすでに使っているヘルプデスクに接続し、過去のチケットとヘルプセンターから学習し、本番の会話に触れる前に過去の会話でテストされる、ヘルプデスク向けのAIチームメイトだ。OroSoftはこれを使って、出どころのチケットを引用した根拠のあるFreshdesk返信を作成している。料金を見るか、eeselを無料で試すことができる。
よくある質問
Qwen 4 Maxとは何ですか?
qwen4-max-previewとしてのみ存在し、100万トークンのコンテキストと最大393,216トークンの出力を持つマルチモーダル推論モデルだ。2026年11月11日に公開され、11月25日以降に廃止される。Qwen 4 Maxレビューでは、このプレビューでわかること・わからないことを扱っている。Qwen 4 Maxはどうやって使いますか?
sk-sp-で始まるキーを発行し、ツールをToken PlanのベースURLに向け、モデルIDをqwen4-max-previewに設定する。対応ツールにはClaude Code、Cursor、Qwen Code、OpenClawなどがある。Qwen 4 Maxは無料ですか?
Qwen 4 MaxのAPIは利用できますか?
Qwen 4 Maxはいつまで利用できますか?
qwen4-max-previewというIDに依存するものはその時点で動かなくなる。LLMトラッキングツールのまとめが、フルリリースを見逃さないために役立つ。Claude CodeでQwen 4 Maxを設定するにはどうすればいいですか?
ANTHROPIC_BASE_URLをToken PlanのAnthropicエンドポイントに設定し、sk-sp-キーをANTHROPIC_AUTH_TOKENに入れ、ANTHROPIC_DEFAULT_OPUS_MODELをqwen4-max-previewに割り当てる。Alibaba自身の設定ではメインモデルはautoのままなので、Qwen 4 Maxを使っていることを確実にするには/modelでOpusを選ぶ。Claude Codeの環境変数ガイドで各変数を解説している。Qwen 4 MaxとQwen 3.8 Maxの違いは何ですか?
max_tokensは思考と回答を合わせてカウントするようになった。Qwen 3.8 Maxは正式リリース済みで、独立したベンチマークがあり、従量課金では100万トークンあたり入力2ドル・出力6ドルだ。詳細はQwen 3.8 Max料金の内訳を見てほしい。