

Cactus Whistleとは?
Whistleは、Cactus Computeが開発した音声認識モデルです。Cactus Computeは、Y Combinatorの2025年夏バッチ出身のサンフランシスコのスタートアップで、チームは8人です。CEOのRoman ShemetとCTOのHenry Ndubuakuが率いており、GPUを持たないデバイス、つまり低価格のスマートフォン、腕時計、メガネ、ロボット、車、マイコン級のボードのためのAIを掲げています。
Whistleはその構想の音声側を担うもので、小規模言語モデルがどこまで進化したかを示す好例です。2026年10月2日に公開され、10月8日にはHacker Newsのローンチスレッドが549ポイント、121コメントに達し、急に至るところで話題になりました。Hugging Faceのモデルカードでは、公開後1か月で2,594ダウンロード、ライセンスはApache 2.0と表示されています。
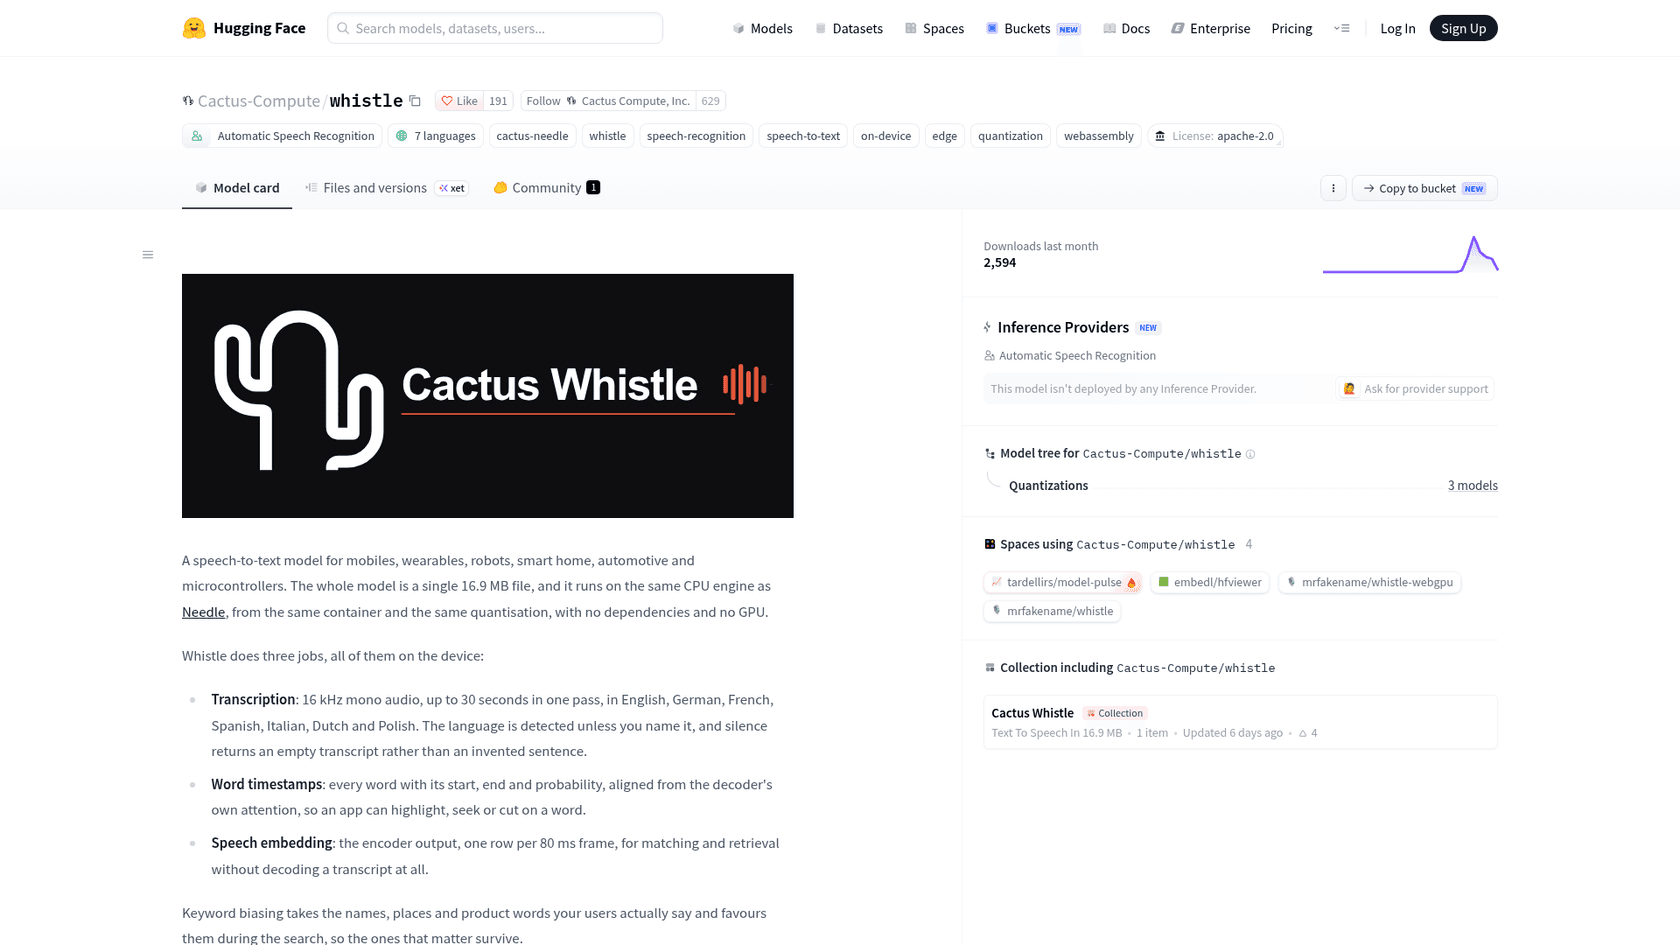
私はeeselでインテグレーションとAPIを担当しているので、新しいモデルの発表を見ると最初に気になるのは、呼び出したときに開発者が実際に何を受け取れるのか、という点です。Whistleの場合、その答えは驚くほど具体的なので、そこから始めましょう。
Whistleは実際に何をするのか?
Cactusは3つの機能を挙げており、すべてデバイス上で完結します。
- 文字起こし。 16 kHzモノラル音声を、最大30秒まで1回で処理します。対応言語は英語、ドイツ語、フランス語、スペイン語、イタリア語、オランダ語、ポーランド語です。言語を指定しなければ自動検出します。
- 単語タイムスタンプ。 すべての単語について開始位置、終了位置、確率を返すので、アプリ側で単語単位のハイライト、シーク、カットができます。
- 音声埋め込み。 エンコーダーの出力そのもので、音声80 msごとに1行です。文字起こしを作らずに、照合や検索に使えます。
小さく見えて重要な機能が2つあります。キーワードバイアスを使うと、ユーザーが実際に口にする名前(「Siobhan」「Krzysztof」、自社の製品名など)を渡して、探索をそちらに寄せられます。そして、無音のときは、でっち上げた文章ではなく空の文字起こしを返します。これは、Whisper系モデルにありがちな癖を直接狙ったものです。
この主張は公開の場で検証されました。あるHacker Newsユーザーが、テレビドラマの1話にWhistleをかけて、次のように報告しています。
“Tried it on a random TV episode and it seems to get stuck sometimes where it just outputs "Thank you." as a default - at one point emitting that for 60s of dialogue”

つまり無音には対処できていても、Whistleの30秒の枠に収まらない長くて雑多な音声では、まだ埋め草のような出力が出る可能性があります。ベンチマークを見るときはこの点を頭に置いてください。
Whistleは内部でどう動いているのか?
簡単に言うと、WhistleはCactusの既存のテキストモデルNeedleに音声のフロントエンドを取り付けたもので、ほとんどの部分をNeedleと共有しています。Needleは、Cactusの名を広めた小型のツール呼び出しモデルです(5月のHacker Newsでのローンチのタイトルは「We Distilled Gemini Tool Calling into a 26M Model」でした)。Needle 3は、深さに応じて8〜29 MBで動作します。
ローンチ記事によると、処理の流れは次のとおりです。
- 音声を、10 msホップの80個の対数メルビンに変換します。30秒で3,000フレームです。
- 畳み込み層で375フレーム、つまり80 msごとに1フレームまで縮めます。
- 8ブロックのエンコーダーが全フレームを一度に読みます(因果的ではないため、12秒地点の単語が3秒地点の単語の判断材料になります)。
- Needle型のデコーダーが、すべての層でゲート付きクロスアテンションを通してエンコーダーを読み、5本のビームで文字起こしを選びます。
私が一番気に入っている工夫はここです。エンコーダーのキーとバリューはクリップごとに1回だけ計算され、すべてのビームで共有されるので、5本のビームのコストは、音声を5回処理する分ではなく、短いテキストキャッシュ5個分で済みます。さらにデコーダーは「ラダー型」で、2層から上のすべての深さがそれぞれ独立したモデルとして学習されており、読み込み時に--audio-depthで選べます。
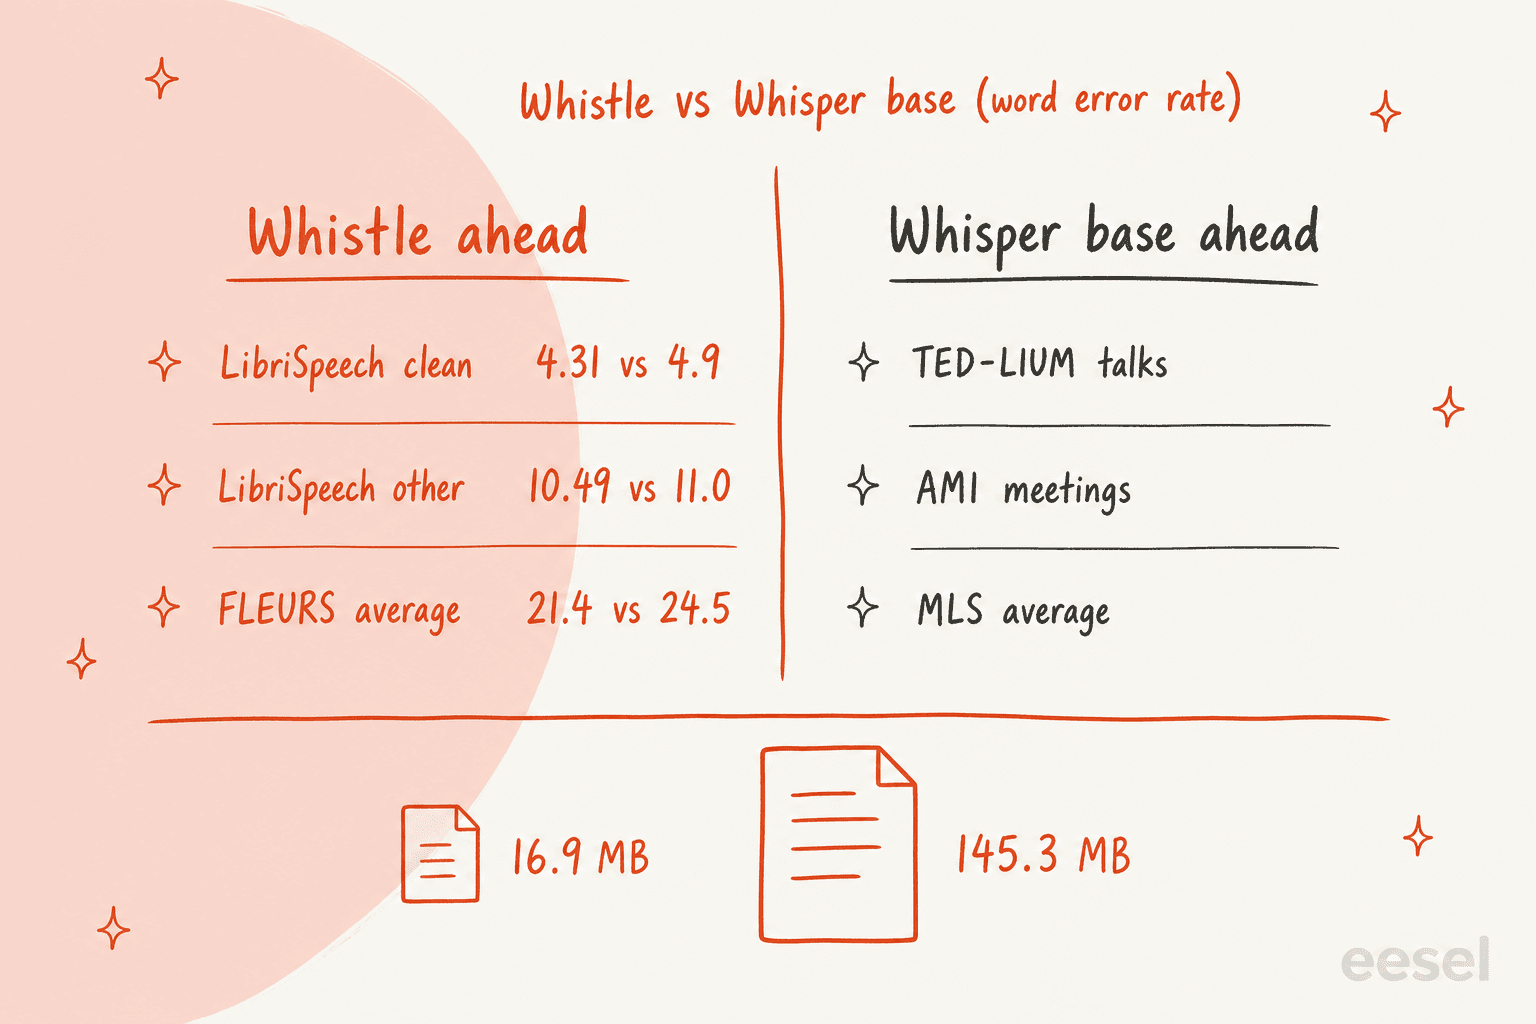
この共有エンジンこそが、実際のプロダクトです。両方のモデルを同じバイナリに読み込めば、1回の呼び出しで音声を入れて関数呼び出しが返ってきます。以下はCactusの記事にあるそのままの例です。
needle --model needle3.cact --model whistle.cact --tools tools.json --audio clip.wav
{"function_calls":[{"name":"set_lights","arguments":{"room":"kitchen","on":false}}],
 "confidence":0.94,
 "audio_text":"turn off the kitchen lights",
 "audio_language":"en"}
文字起こしがアプリのコードに触れることは一切ありません。クラウドAPIに対してリアルタイムのツール呼び出しを組んだことがあれば、ここで何がなくなっているか気づくはずです。ネットワークの往復、APIキー、そして請求です。
Whisper base・Moonshineとのベンチマーク比較
Cactusは、WhistleをOpenAIのWhisper base(多言語チェックポイント、145.3 MB)とMoonshine tiny v2(41.9 MB)の2つと比較しています。単語誤り率は、モデルが間違えた単語の割合なので、低いほど良い値です。
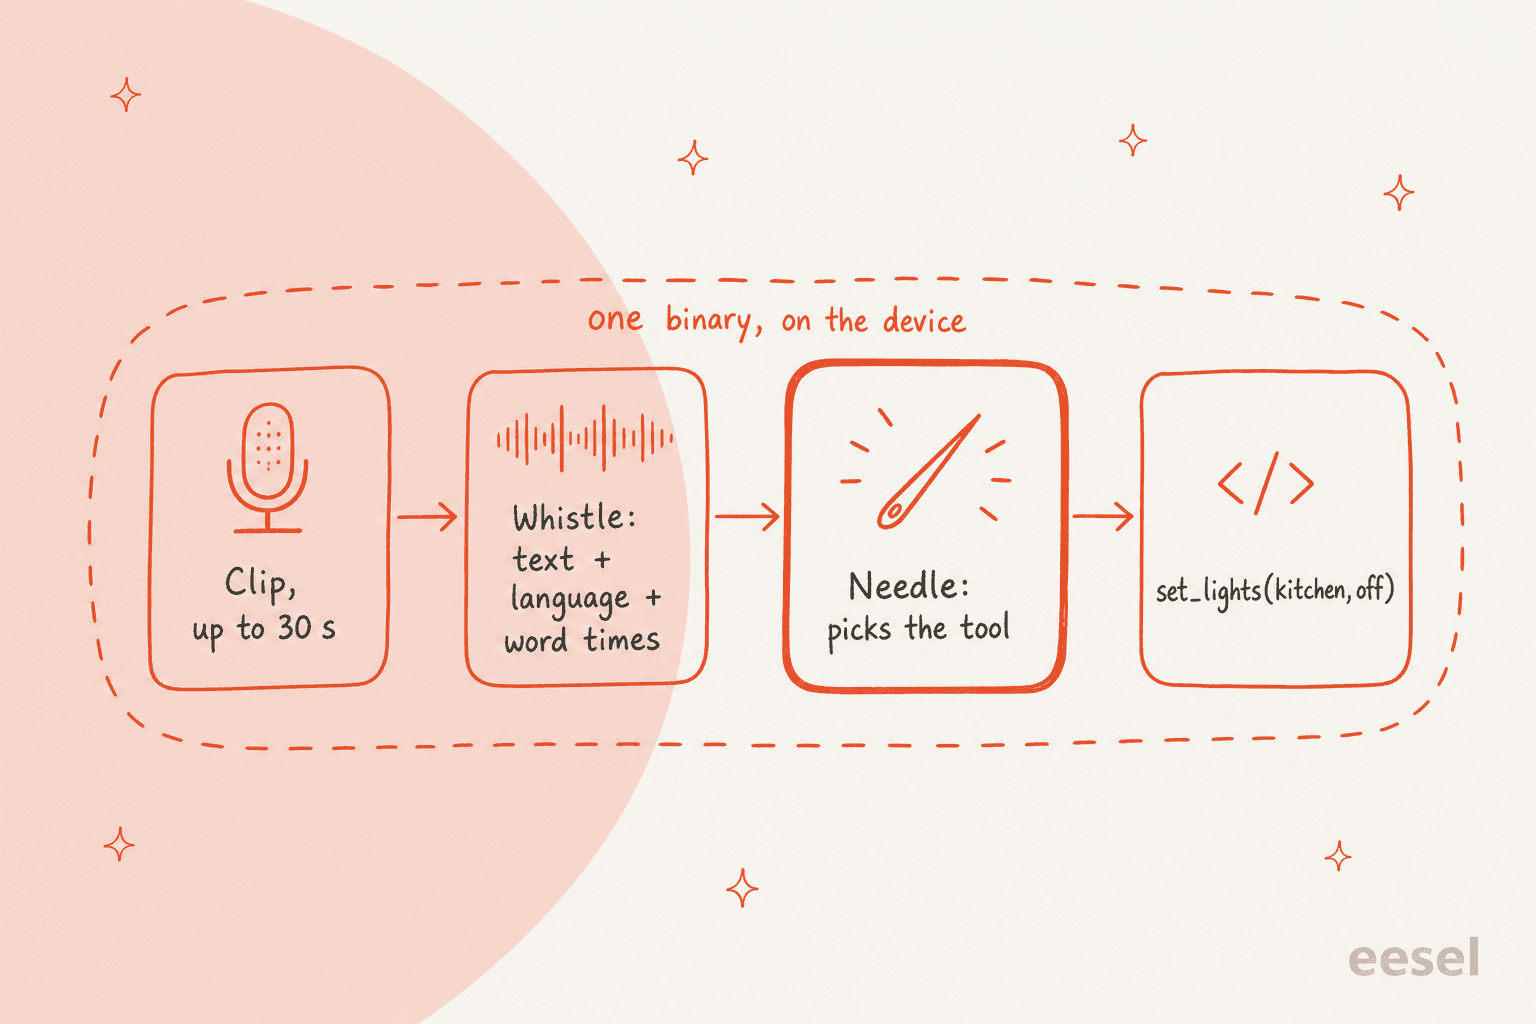
単語誤り率の全体像は次のとおりです。Whistleの数値はモデルカードから、Whisper baseの数値はCactusがXのローンチスレッドで引用したものです。
| ベンチマーク | 音声の種類 | Whistle WER | Whisper base WER | 優位なのは |
|---|---|---|---|---|
| LibriSpeech test-clean | クリーンな audiobook 朗読 | 4.31% | 4.9% | Whistle |
| LibriSpeech test-other | 難しめの audiobook 朗読 | 10.49% | 11.0% | Whistle |
| SPGISpeech | 金融系の通話 | 7.65% | 未公表 | Whistle(Moonshine比) |
| Earnings-22 | 決算説明会、さまざまなアクセント | 19.01% | 未公表 | Whistle(Moonshine比) |
| FLEURS(7言語平均) | 朗読文、多言語 | 21.4% | 24.5% | Whistle |
| TED-LIUM | 収録されたトーク | 7.61% | より低い | Whisper base |
| AMI | 会議の録音 | 26.07% | より低い | Whisper base |
| MLS(6言語平均) | audiobook、英語以外 | 24.9% | より低い | Whisper base |
ローンチ記事はこの勝ち負けをはっきり書いており、その姿勢は評価できます。表を音声の種類ごとに読むとパターンが見えてきます。Whistleが最も得意なのはクリーンな1人の朗読音声で、最も苦手なのは会議、つまり人が重なって話す場面です。AMIでの誤り率26%は、おおよそ4語に1語が間違っていることを意味します。
速度とサイズは別の話で、ここではWhistleが圧倒します。Apple M4 ProのCPUで10秒の音声を処理した結果です。
| Whistle | Whisper base | Moonshine tiny v2 | |
|---|---|---|---|
| ファイルサイズ | 16.9 MB | 145.3 MB | 41.9 MB |
| 最初のトークンまでの時間 | 11.1 ms | 73.2 ms | 22.8 ms |
| デコード速度 | 1,319 トークン/秒 | 266 トークン/秒 | 262 トークン/秒 |
| 精度 | 2〜4ビット | fp32 | int8 |
Cactusの見出しは「ファイルサイズ9分の1、速度6倍」です。計算を確認してみました。サイズ差は8.6倍、最初のトークンまでの時間は6.6倍、デコードは約5倍です。妥当な丸め方です。また、Whistleの最初のトークンまでの時間はクリップの長さに応じて、5秒で5.9 msから30秒で36.3 msまで変わります。一方Whisperはすべてを30秒にパディングするので、Whistleが想定する短いクリップほど差が開きます。
Cactusが比較していないものがひとつあります。人々が実際にノートPCで動かしている、もっと大きなオープンモデルです。Hacker Newsではユーザーが繰り返しNVIDIAのParakeetについて尋ねており、最も役に立つ答えは、このトレードオフをうまく言い表していました。
“It might not be as good as parakeet, but it gets you 80% of the way there.”
試した人たちはどう言っているか?
Hacker Newsのスレッドは、これまでで最良の実環境テストです。Cactusがローンチページにブラウザのサンドボックスを置いたため、何百人もの人が実際に話しかけたからです。反応は、ベンチマークの予測どおりにきれいに分かれました。
明瞭な英語、短い文、専門用語では、好印象でした。ある開発者は、専門用語ではスマートフォン標準の音声入力より優れていると感じたそうです。
“This works much better than the speech recognition in iOS when you use technical terms.”
ほかの6言語での自然な話し方は、評価が厳しくなりました。マドリード在住のスペイン語話者は、ゆっくり口述したときしかうまくいかなかったと書いています。
“If I use a more natural/conversational rhythm (no slang, no abbreviations...) it easily confuses words.”
ポーランド語のテスターもほぼ同じ感想で、別のコメント投稿者は、デモに表れていない点を指摘しました。多くのライブ口述アプリが頼りにしている、話している最中のストリーミング出力です。また、競合チームもRedditで反撃し、自社のベンチマークでは、WhistleとNeedleの組み合わせは生の音声からツール精度20.7%にとどまると主張しました。これはライバルによるテストなので割り引いて考える必要がありますが、ここで挙げたほかの情報と同じ方向を向いています。
開発者側では、ある開発者がローンチから数日のうちに、WhistleをDeepSeek Harness向けの音声認識プラグインに組み込んでいました。
本当の教訓:語彙を絞る
スレッド全体で最も役に立ったコメントは、すでにWhistleを実際に出荷した人からのものでした。その人はWhistleを使って、Amazon Echo ShowをAmazonのクラウドから切り離し、標準の音声アシスタントをローカルで動くホームオートメーションに置き換え、数字も共有しています。
自由形式の文字起こしでは、Whistleは話された170コマンド中70しか正解できず、RTX 5080 GPUで動かしたQwenの1.7B音声モデルは168でした。そこで、人が言いそうなことを何でも文字起こしさせるのをやめ、Whistleの出力を固定のコマンドテンプレート群に対応づける小さなネットワークを学習させました。その結果は、Echo自身のCPUで動くように作った構成で、170中164です。
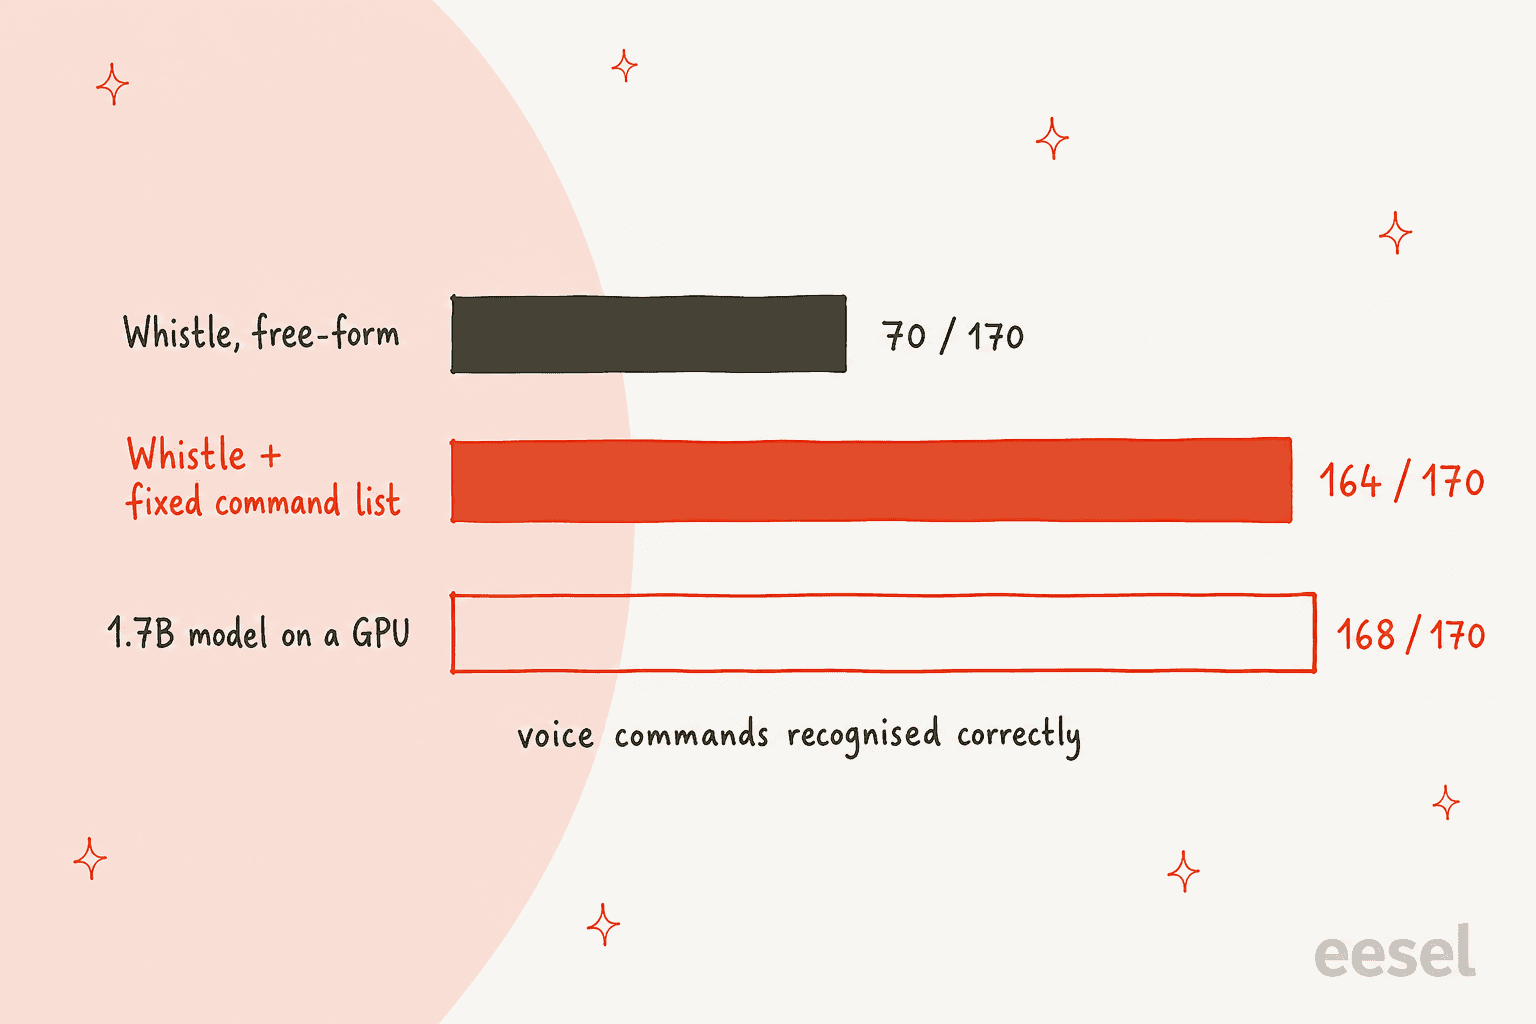
私が持ち帰る教訓はここです。16.9 MBのモデルには、7言語のすべての単語を知っておく余裕はありません。だから何が来るかを伝えれば伝えるほど、はるかに大きなモデルに近づきます。Cactusは、まさにそのためのツールを用意しています。名前や製品用語のためのキーワードバイアスと、それ自体が固定された行動の語彙であるNeedleのツール一覧です。同じテスターは後に208フレーズを試し、206個を正解して、同じセットでVoskやKaldiの構成を上回りました。
ですから、サンドボックスに向かって週末の過ごし方を話してWhistleを評価しているなら、見るべきものを間違えています。デバイスが実際に理解すべき20個のコマンドで評価してください。
Whistleを出荷すべきか?
ベンチマークと上記の現場報告をもとに、私ならこう判断します。想定している用途を選んでください。
Whistleに何をさせたいですか?
5分でWhistleを試す方法
最も手早いのは、ローンチ記事にあるブラウザサンドボックスです。最初に押すと16.9 MBのモデルがタブにダウンロードされ、データがマシンの外に出ることはありません。本格的に試すなら、Pythonパッケージが1行で入ります。
pip install cactus-needle
import needle

print(needle.transcribe("clip.wav")["text"])
ここから先は、モデルカードによると次のとおりです。
word_timestamps=Trueで、各単語の開始、終了、確率が追加されます。keywords=[...]で、ユーザーが口にする名前に探索を寄せられます。language="de"で、検出せずに言語を固定できます。needle whistle compareは、同じクリップをWhistle、Whisper、Moonshineに通して時間も表示します。判断するうえで最も役に立つ単一のコマンドです。
エンジンは17のターゲット向けにビルド済みで提供されており、macOS、Windows、Linux(RISC-VやMIPSを含む)から、Android、iOS、watchOS、tvOS、WebAssemblyとしてのブラウザまでをカバーします。各ネイティブプラットフォームのフォルダには、needleバイナリ、静的ライブラリ、ヘッダーが入っています。ソースはGitHubにあります。完全にローカルなスタックを組むなら、人々がすでに自分のハードウェアで動かしているオープンソースのAIエージェントの隣に組み込めます。
コストは単純です。重みとエンジンはApache 2.0で、Hugging Faceには、Whistleに対応するホスト型の推論プロバイダーは掲載されていないので、自分で動かすことになります。これを、Gemini 3.5 TranscribeやMAI-Transcribe 2の分単位の料金と比べてみてください。サイズよりも、長くて雑多な音声での精度が重要なときは、そちらが正しい選択です。
Whistleが適さない場面
Cactusの肩を持つなら、彼らはWhistleがWhisper largeやクラウドの文字起こしサービスの代わりになるとは一度も主張していません。それでも、これを土台にして作る前に、私なら次の制限を指摘します。
| 制限 | 実際の意味 |
|---|---|
| 30秒のクリップ上限 | それより長い音声は、アプリ側で分割する必要があります(あるHNユーザーは「audio limit is 30 s」にすぐ当たりました) |
| ストリーミング出力なし | テキストは、話している最中ではなくクリップが終わってから出ます |
| 7言語 | 日本語、ノルウェー語、ヒンディー語、ポルトガル語などは非対応です |
| 会議の音声 | AMIでWER 26.07%、Whisper baseに劣ります |
| 話者ラベル | ドキュメントに、話者の分離(ダイアライゼーション)は記載されていません |
どれもバグではありません。音声モデルを16.9 MBに収めるための代償であり、Cactusは出荷前にそれが分かるだけの詳細を公開しています。長尺の作業の多くでは、Otterや、私のOtter代替ツールの一覧にあるツールが、いまも現実的な選択です。
Whistleはカスタマーサポートチームにとって何を意味するか?
ここで、自分の仕事の話に引き寄せます。サポートにおける音声は、ほとんどが電話、留守番電話、録画された操作説明であり、どれも長く、話者が2人いて、台本から外れていきます。それはWhistleのベンチマーク表で言えばAMI側であり、LibriSpeech側ではありません。電話サポートの自動化やAIコールセンターエージェントでは、今日の時点で私が選ぶ文字起こしレイヤーはWhistleではありません。通話向けに作られたAI音声エージェントが、より大きなストリーミング対応モデルを使うのには理由があります。
もっと大きな論点は、文字起こしがどんどん安く小さくなっていて、もともと難しい部分ではなかったということです。あるeeselの営業通話で、GorgiasとShopifyを使い月に約7,000件のチケットを扱うDTCサプリメントブランドが、注文状況、定期購入、商品に関する問い合わせの半分をAIに自動解決させたいと話していました。障害は、音声をテキストにすることではありませんでした。回答がSOPツール、古いマクロ、誰も文書化していないLoomの操作説明に散らばっていたのです。Loom動画の文字起こしは、単なるテキストがもう1つ増えるだけで、チケットを読み、正しい答えを見つけ、ブランドの言葉で返信する役割は、やはり誰かが担う必要があります。
私が引きたい線はここです。Whistleはインフラで、eeselは従業員です。Whistleのようなモデルは言葉を聞き取ります。AIヘルプデスクチームメイトはキューを処理します。ナレッジベースと過去のチケットから学び、ZendeskやGorgiasの中で返信を下書きまたは送信し、触れるべきでないチケットは人に引き継ぎます。
すでに通話の文字起こしがヘルプデスクに届いているなら、音声モデルの次のステップは、私のガイド通話文字起こしの要約と文字起こしからの個人情報の削除で扱っています。
そしてWhistleの魅力が、ターミナルから操作できることにあるなら、eeselも同じです。eesel CLI(npm i -g @eesel/cli)を使うと、ヘルプデスクの接続、チームメイトの常設指示の編集、保留中のアクションの承認や拒否、アクティビティログの閲覧ができます。すべてのコマンドはJSONを出力し、--dry-runフラグで書き込みが実際に行う呼び出しを正確に確認できます。Claude Code、Codex、Cursorなどのコーディングエージェントも、人と同じようにこれを操作できるため、ダッシュボードで見ているのと同じチームメイトをCIからスクリプトで動かせます。
eeselを試す
未回答のチケットを減らしたくて音声がロードマップに載っているなら、まず回答する部分から始めてください。eeselのAIヘルプデスクチームメイトは、Zendesk、Gorgias、Freshdeskに数分で接続し、ヘルプセンターと過去のチケットから学び、実際のお客様に返信する前に、あなた自身の過去チケットでテストされます。eeselを試すのはカード不要で無料です。先にほかのAIチームメイトと比較することもできます。
