

GPT-6.2 Solは、現時点でOpenAIが販売するモデルの中で最もコストパフォーマンスが良いモデルです。100万トークンあたり$2/$10、Artificial Analysisで57、古いGPT-6 Astraと同水準で、GPT-6.1 Solよりタスクあたり約3倍速いです。批判は実在しますが範囲は狭く、開発者は依然としてコードを過剰に作り込むと言い、Artificial Analysisはコーディングで3ポイントの低下を測定しました。
77回のテストでは、企業の事実を捏造したことは一度もありませんでした。その癖は、データに存在しないことを付け加える点です。FedExの追跡リンクや日数などです。これは下書きでは無害ですが、顧客への返信では危険です。サポート業務では、下に動くモデルよりも、eeselのような根拠のあるAIヘルプデスクのチームメイトの方が重要です。
GPT-6.2 Solとは何で、どうテストしたか?
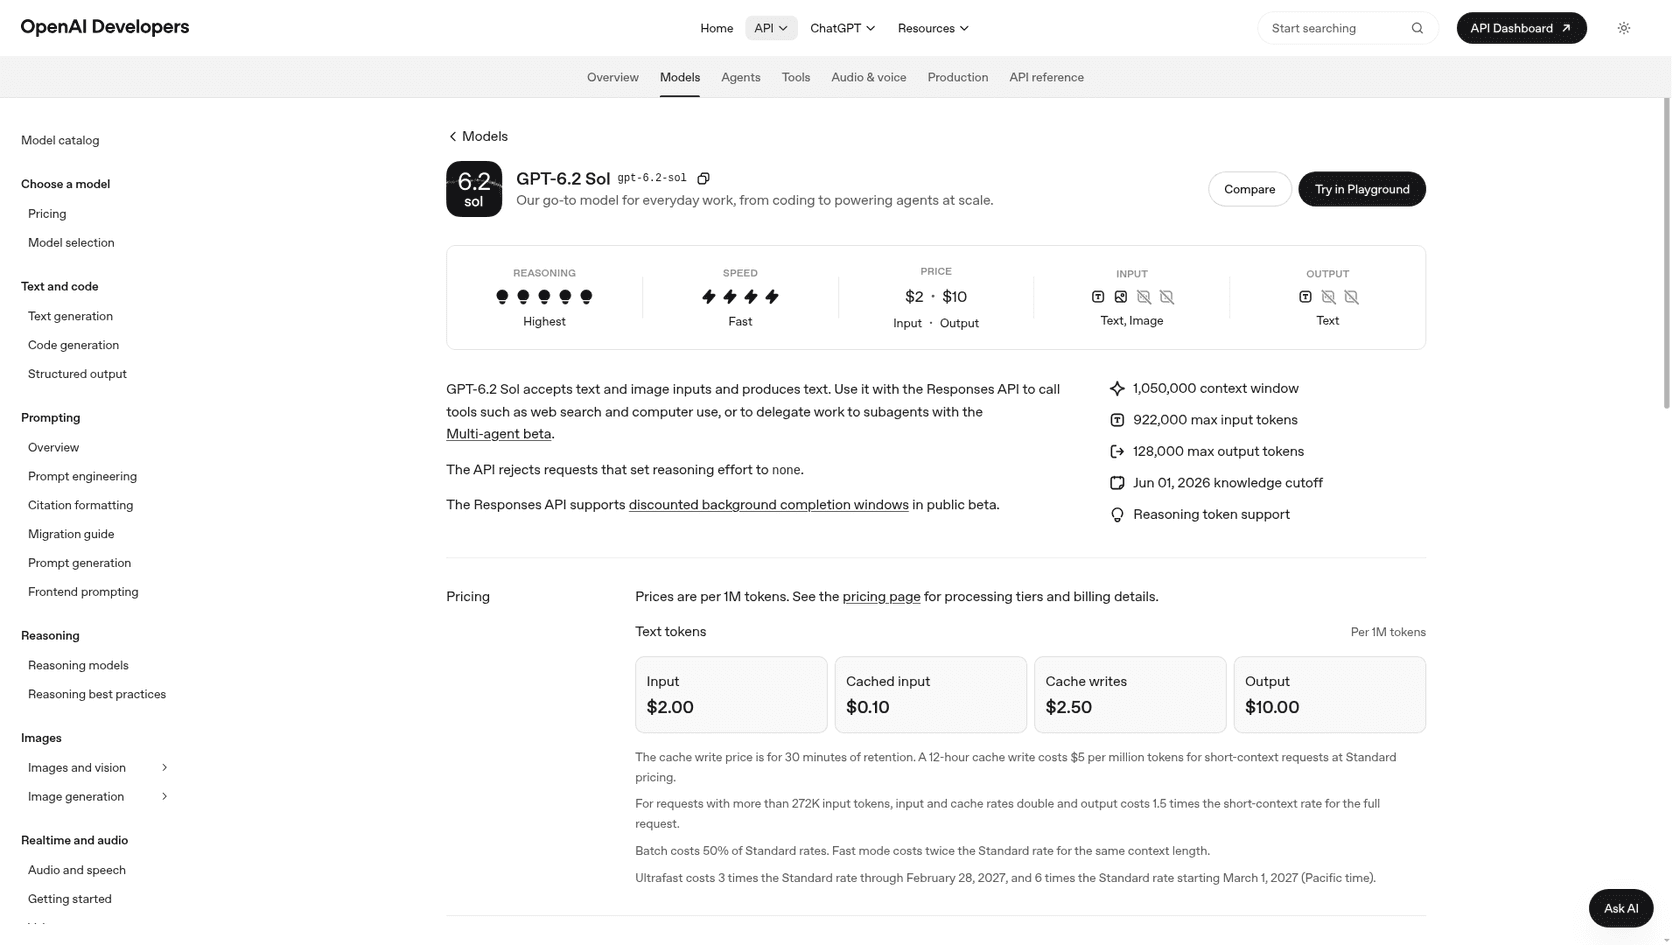
GPT-6.2 Solは、2026年11月17日にGPT-6.2 Astraと共にリリースされた、OpenAIの日常業務向けモデルです。OpenAIのローンチ記事は、これを「our efficient, versatile model for everyday work」と呼んでいます。GPT-6.1 Solを同じ価格で置き換え、GPT-6.2 Sol概要にローンチの全詳細があります。
私はeeselでインテグレーションとAPIの基盤を構築しているので、モデルのレビューをAPIの変更履歴のように読みます。自分のコードから呼び出したとき、実際には何をするのか、ということです。ローンチ時のグラフはそれに答えてくれないので、今週はResponses API経由でGPT-6.2 Solを77回呼び出し、3つの小さなテストを行いました。特に注記がない限りすべてmedium強度です。
- 15件のサポートチケット、lowとmedium強度で、返金ポリシーに照らして手作業で採点(30回の実行)。結果はGPT-6.2 Sol概要に掲載しています。
- Astraに対して挙がった不満に関する19回の実行:短い文章、ツールの静かな失敗、企業の事実の捏造。これらはGPT-6.2 AstraレビューでAstraと並行して実行しました。
- このレビュー用の28回の新規実行、GPT-6.1 Solでの28回との比較:それぞれ完全な回答に2つか3つの事実を必要とする6つのポリシー質問を3回ずつ繰り返し、さらに2件の注文追跡チケットを5回ずつ繰り返しました。
これは手作業の小さなテストであり、ベンチマークではありません。自分の環境で再現したい場合、eesel CLIを使えば、コーディングエージェントがeeselのヘルプデスクエージェントに同種のテスト質問をさせ、何かが本番に出る前に回答を確認できます。各実行は、架空のSaaS企業のポリシー文書と、関数呼び出しで作った定型のlookup_orderツールを使っています。これは、整った日常的なサポート業務、つまりサポートの大半で、モデルがどう振る舞うかを示しています。
GPT-6.2 Solへの私の評価は?
GPT-6.2 Solは、同クラスで並ぶものがない価格で定型業務に使える非常に良い既定モデルですが、管理すべき2つの癖があります。コードを過剰に作り込むことと、事実の周りに詳細を付け加えることです。スコアカードは次のとおりです。
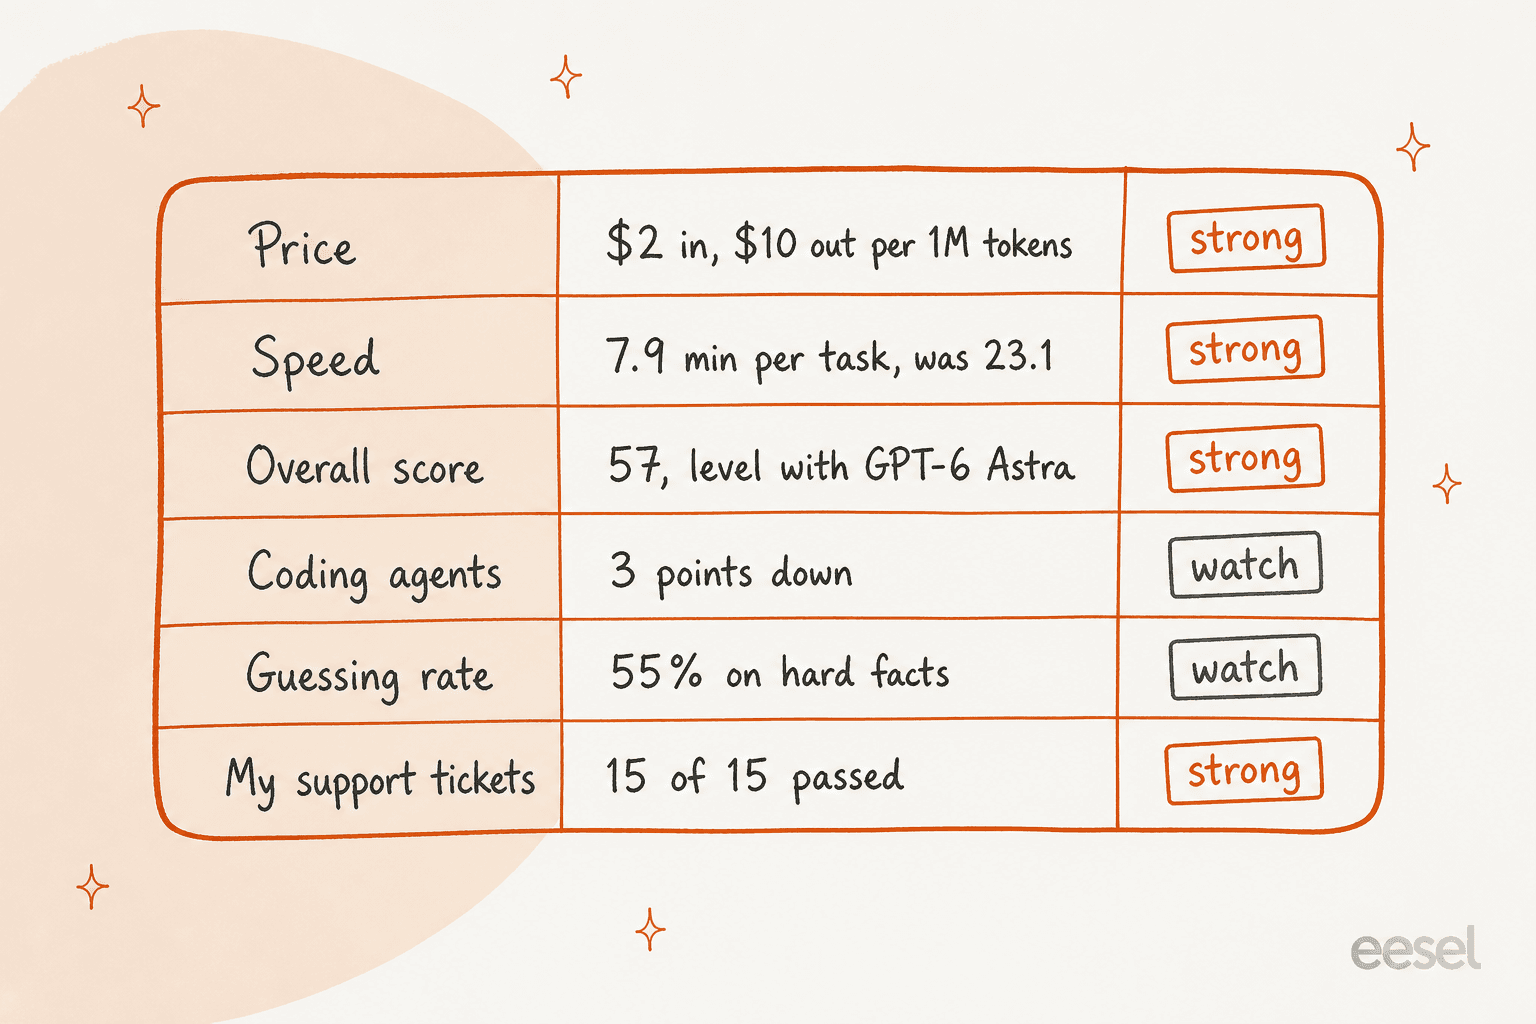
| 確認した項目 | GPT-6.2 Sol | 出典 |
|---|---|---|
| 100万トークンあたりの価格 | 入力$2、キャッシュ$0.10、出力$10 | OpenAIの料金 |
| Intelligence Index(最大強度) | 57、55から上昇 | Artificial Analysis |
| ベンチマークタスクあたりのコスト(最大) | $1.01、$1.27から低下 | Artificial Analysis |
| ベンチマークタスクあたりの時間(最大) | 7.9分、23.1分から短縮 | Artificial Analysis |
| Coding Agent Index | GPT-6.1 Solより3ポイント低い | Artificial Analysis |
| ハルシネーション率(AA-Omniscience) | 55% | Artificial Analysis |
| 私の15件のサポートチケット | lowとmediumで15/15 | 私のテスト |
| 複数事実を要するポリシー回答 | 18/18が完全 | 私のテスト |
| 企業の事実の捏造 | 10回中0回 | 私のテスト |
| ツールが送っていないリンクの追加 | 注文返信14件中7件 | 私のテスト |
6.1からのアップグレードは勧めやすいです。価格は同じ、スコアはわずかに高く、以前は23分かかっていた最大強度の実行が今は8分です。すでにGPT-6.1 Solに料金を払っているなら、留まる理由はほとんどありません。
GPT-6.2 Solについて人々が気に入っている点は?
価格とスコアの比率です。600コメントを超えたHacker Newsのローンチスレッドでは、このリリースを擁護する人の多くが主にSolを擁護しており、ほとんどがコストを理由にしていました。
"Whatever you’re doing, it’s unlikely to be what most users are doing. Fable and Astra aren’t in my price range so I’m paying attention to Sol."

もう一つ繰り返し出てくる点は、最も高い強度レベルでは、大きくて古いモデルとの差がほとんど縮まるということです。
"6.2 Sol xhigh and max show the results comparable to Astra 6 max, and Astra 6.2 only shows any improvement on 'max' reasoning effort level."
これはArtificial Analysisとも一致しており、SolはGPT-6 Astraの57に対して57で、タスクあたりのコストは約15%です。一部の開発者は、私も採用したい分担を描いていました。強いモデルが計画し、Solが量をこなすというものです。
"I have hilariously started to just have an opus thread maintain Sol subagents to get the best of both worlds."
人々は何に不満を持っているか?
主に過剰な作り込みで、ほぼすべてがコードに関するものです。この不満は今回のリリースに限った話ではなく、それがより痛いところです。
"It's still overengineering especially Sol. This was the biggest complaint by everybody who has been using Sol since GPT 5.6. OpenAI is not listening to us."
大規模なコードベースでは、ある開発者がAstraとの手直し作業の差を測定しています。
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
数値は、規模はともかく方向性を裏付けています。Artificial Analysisは、SolはCoding Agent Indexで「loses 3 points relative to GPT-6.1 Sol」だとしており、これはSWE-Atlas-QnA-AAでの14ポイントの低下によるもので、そこでモデルは「more likely than its predecessor to omit key facts in its responses」だとされています。スレッドからの実用的なヒントとして、別の開発者は、強度を上げるほど過剰な作り込みが悪化することを発見しました。コーディングエージェントが誰も頼んでいない骨組みを作り続けるなら、モデルを変える前に強度を下げてみるとよいでしょう。
さらに、早期アクセスを持つ人々からのより大きな反応もあります。Matt ShumerはX上で、この2モデルを「essentially unusable」だと述べ、レビューしないとしました。文章が簡潔すぎることやコーディングの実行が早期に止まることに関する詳細な早期批判の大半は、Astraについてのものでした。私はAstraレビューでそれらの主張をテストしましたが、Solでは文章は問題なく、カスタマーヘルプ記事は168から170語でポリシーをすべて網羅していました。
GPT-6.2 Solは事実を省略するか?
私のテストでは省略しませんでした。Artificial Analysisが省略を指摘していたため、それぞれ完全な回答に2つか3つのポリシー事実を必要とする6つの質問を書きました。削除されたワークスペースを管理者は復元できるか?(はい、14日以内なら。ただしオーナーのみ。)削除された席は返金されるか?(いいえ、次回請求のクレジットになります。)
両方のSolが18回の実行すべてに完全に回答しました。手作業で一つずつ読んだ後のことです。私が最初にスクリプト化したキーワードチェックは6.2で11件、6.1で9件を見逃しとして報告しましたが、そのすべてが「14-day window」や曲線アポストロフィなどの言い回しによる誤検知でした。これは自動評価全般に対する公正な警告です。文字列一致の評価者なら、6.2 Solが事実をより多く省略していると伝えたはずですが、実際はそうではありません。小さなサンプルで私が信頼する唯一のチェックは、依然として手作業でのAIサポート会話のレビューです。
静かな失敗のテストも同様でした。3件の注文照会のうち1件がエラーなしで空の{}を返したとき、Solは5回中5回、その注文にフラグを立ててエスカレーションしました。OpenAIのシステムカードは、両方の新モデルが「were more likely to omit known obstacles when reporting their work」だと警告しているので、これを実行するエージェントには引き続きオブザーバビリティを持たせたいところです。短いサポート業務では、一度も見逃させることができませんでした。
GPT-6.2 Solは物事を作り上げるか?
事実を捏造してはいませんでした。しかし、物事を付け加えました。これが、このモデルについて私が学んだ最も有益な点です。
Artificial AnalysisはSolのハルシネーション率を55%としています。これは、分からないと言う代わりに間違って答える、難しい事実の質問の割合です。私のテストでは、どの質問もカバーしていないポリシーを使い、SOC 2の監査、EUのデータ常駐、電話対応時間、APIのレート制限、HIPAA契約について尋ねました。Solは、厳格なプロンプトでも緩い「役に立つように」というプロンプトでも、10回の実行で何も捏造しませんでした。緩いプロンプトでは、「検証済みの情報がない」と述べ、一般的なアドバイスを提示しました。
余計な要素は事実の周りに現れました。
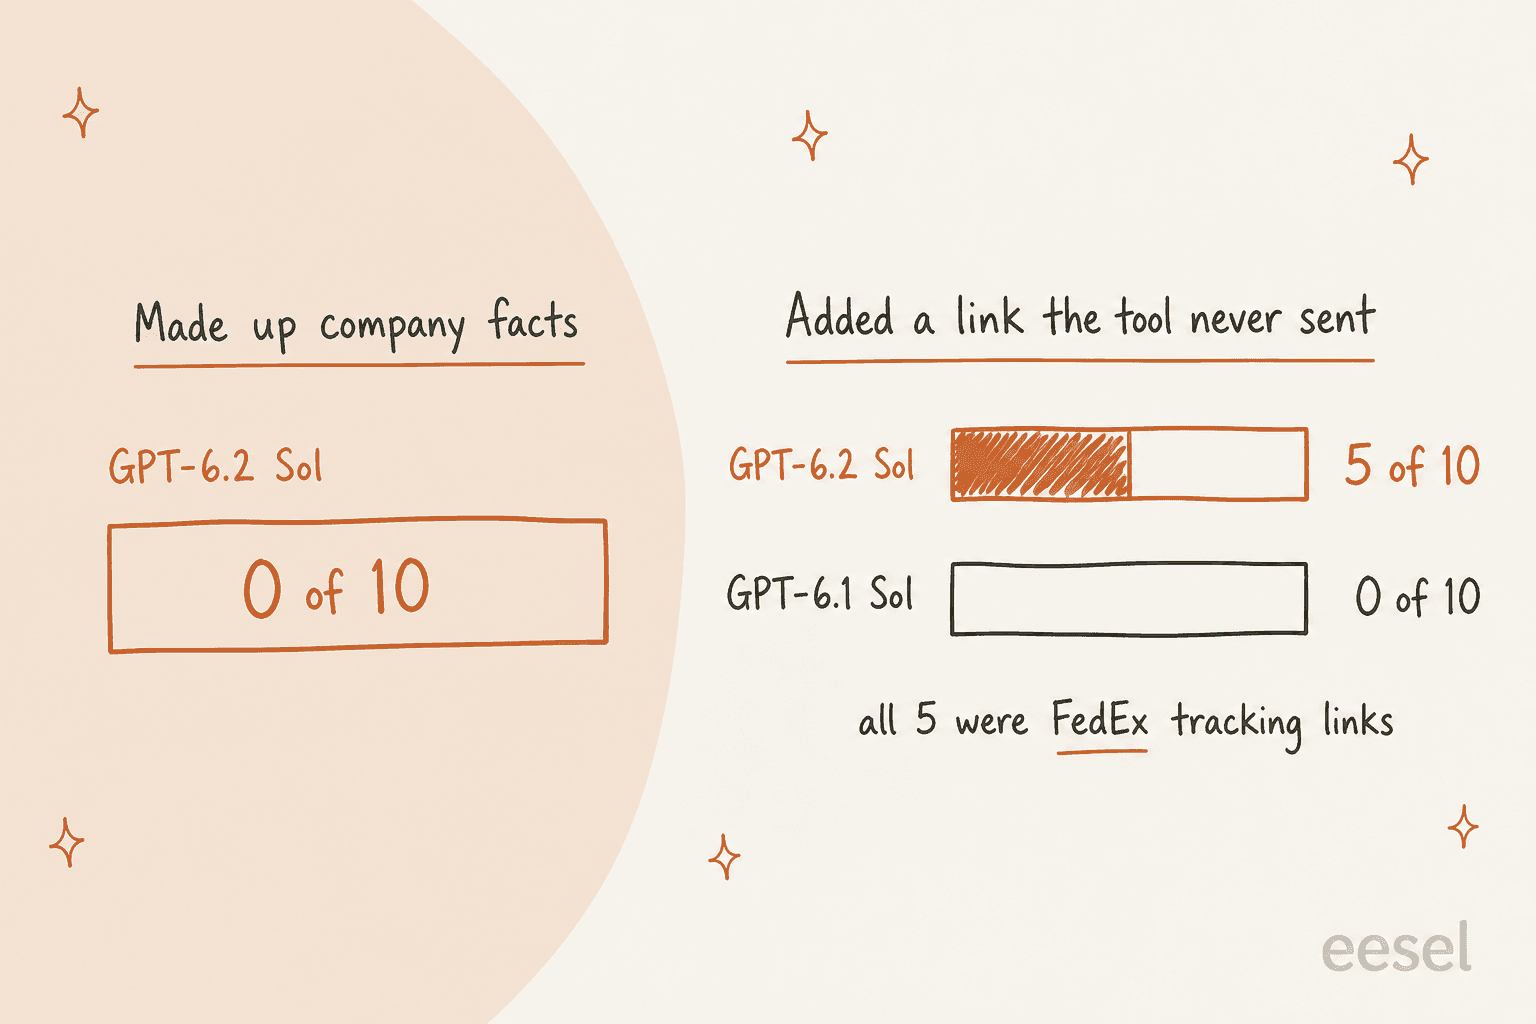
- 追跡リンク。 私の
lookup_orderツールは配送業者と追跡番号を返しますが、URLは返しません。顧客がFedExの注文を追跡する方法を尋ねたとき、GPT-6.2 Solは5回中5回、fedex.comの追跡リンクを作成しました。GPT-6.1 Solは毎回、番号だけをそのまま印字していました。単純な「注文はどこですか」というUPSのチケットでは、6.2はリンクなしでUPSの追跡ページに言及しました。以前のチケットテストでは、medium強度では両方の注文チケットでups.comのリンクを作成し、low強度では作成しませんでした。両方のテストを合わせると、注文返信14件中7件にリンクがあり、6.1は0件でした。 - 頼まれていない計算。 削除されたワークスペースの質問では、6.2 Solは3回の実行すべてで「残り約5日」と付け加えました。これは正しく(14引く9)、有用です。最初のテストでは、ポリシーが部分月をどう数えるかを確認せずに、返金を「支払った額の10/12」と述べたこともあり、これは事実に見せかけた推測でした。
私が確認したリンクに誤りはありませんでした。問題はそのパターンです。追跡番号から配送業者のURLを組み立てるモデルは、いつか別の何かから返品ポータルや決済のリンクを組み立てるようになります。顧客への返信において、ツールが返していないリンクは、裏付けのない主張です。解決策は、リンクをツールの結果や自社ヘルプセンターから得たものに限定する指示の一行と、それを確認するテストです。AIサポートエージェントの権限が、アクションについて同じ考え方を扱っています。お金については、返金のガードレールを参照してください。
GPT-6.2 Solは価格に見合うか?
はい、OpenAIのラインナップの中では、それも大差でそうです。標準レートでの私のサポート業務のコストは次のとおりです。
| テスト(medium強度) | GPT-6.2 Sol | GPT-6.1 Sol | GPT-6.2 Astra |
|---|---|---|---|
| サポートチケット15件、1,000件あたり | $1.42 | $1.35 | $5.79 |
| ポリシーと追跡の質問、1,000件あたり | $1.55 | $1.49 | 未実施 |
| 平均返信の長さ(ポリシー質問) | 44語 | 40語 | 未実施 |
| 平均推論トークン(ポリシー質問) | 4 | 9 | 未実施 |
6.2 Solは、これらのテストでは1チケットあたり6.1より約4〜5%高くなっています。これは返信がわずかに長くなるためです。簡単な質問での推論は減り、文章はやや増え、お金がかかるのは出力トークンの部分です。GPT-6.2 Astraと比べると、定型チケットで同じ合格率に対して約4分の1のコストです。
モデルの選択よりも料金を動かす要素が2つあります。まずは強度です。Artificial Analysisは、medium強度で1,460万の出力トークン、max強度で6,090万の出力トークンを数えており、スコアは53対57です。次に割引経路です。Batchは価格を半分にしますが、このモデルにはまだFlex階層がありません。GPT-6.2 Sol概要には、272,000入力トークンを超える長文プロンプトの追加料金を含む、完全な価格表があります。
GPT-6.2 Solは誰が使うべきで、誰が見送るべきか?
ほとんどのチームはこれを既定モデルにし、例外を切り分けるべきです。
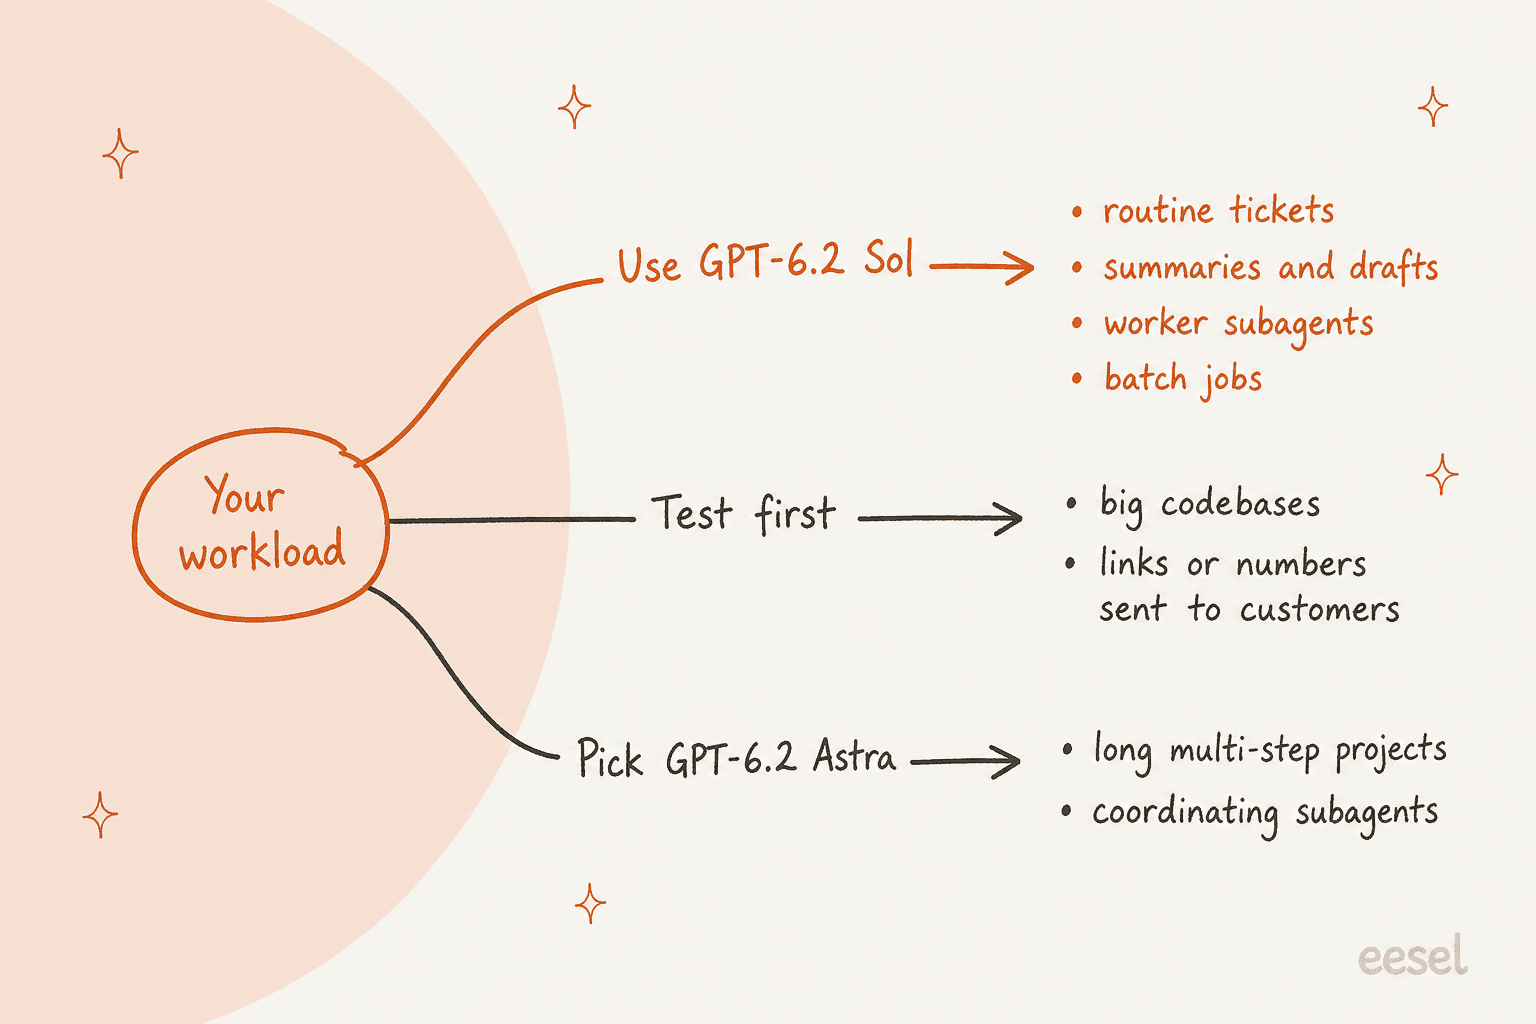
| あなたが... | 私の見解 |
|---|---|
| GPT-6.1 SolまたはGPT-6 Solを使っている | 乗り換えましょう。価格は同じで、速く、少し賢いです。まずコーディング評価を再実行してください。 |
| 大規模リポジトリでコーディングエージェントを動かしている | 乗り換え前にテストしてください。コーディング指標は下がり、過剰な作り込みへの不満は一貫しています。難しいタスクにはCodexをAstraのままにしてください。 |
| サポート返信や下書きを動かしている | 使ってください。ただしリンクと数字についてのルールと、自社チケットからのテストセットを用意してください。 |
| オーケストレーターとワーカーを構築している | Solをワーカーに、強いモデルをプランナーにしてください。 |
| Claude Sonnet 5.5やClaude Opus 5.5と比較している | 自社のチケットを両方に通してください。ベンチマークはトーンやポリシー順守については何も教えてくれません。 |
| 価格優先で他社にも開かれている | GPT-6.1 Solの代替案のまとめとDeepSeek V4 Flashを参照してください。 |
Solが合わない場合、カスタマーサポートに最適なLLMの記事がより広い選択肢を比較しています。
サポートチームにとって、これは何を意味するか?
安くて速いモデルは、より良いインフラであって、より良いサポートエージェントではありません。私のテストはその差を明確に示しています。SolはSOC 2の状況を捏造してはならないと分かっていますが、それでも自社のシステムが一度も作っていないリンクを顧客に渡してしまいます。その差を埋めるのは、モデルを取り囲む層です。何を調べてよいか、何を言ってよいか、何を人に渡すかです。
プランナーと文房具のブランドで、GorgiasとShopifyを使うSTIL Classicsは、そのルールを組み込んだ状態でeeselを運用しています。下書きの前に、eeselはShopifyの注文、その処理状況、ライブの在庫を調べ、調べていない発送日、配送予定、製品仕様を一度も述べません。注文が見つからない場合は、顧客に伝える代わりにチームにフラグを立てます。1か月で約320件のGorgiasチケットを準備し、約230件のShopify注文を調べ、すべての下書きは人がチェックして送信します。
これがeeselの作っているものです。特定の仕事のために雇うAIチームメイトで、キュー向けのAIヘルプデスクのチームメイトやコンテンツ向けのAIブログライターです。下にあるモデルは6.1から6.2に変わっても、ルールを変える必要はありません。ターミナルから、Claude CodeやCodexのようなコーディングエージェントがCLIを通じて承認済みのマクロやヘルプ記事をアップロードし、エージェントの指示を厳しくできます(例えば「照会が返したリンクのみ共有する」など)。ヘルプデスク自体を接続するには、依然として管理者アクセスを持つ人の承認が必要です。
サポート向けにモデルを選ぶなら、本番のチケットに触れる前に自社の過去チケットでテストしてください。サポートチケット向けモデル比較が数字を文脈に置いています。チケットあたりコストのベンチマークはモデルの費用が完全なチケットのどこに収まるかを示し、最高のAIヘルプデスクソフトウェアのまとめは、そのテストを実行できるツールを比較しています。
eeselを試す
GPT-6.2 Solをきっかけに自社のキューでのAI活用を考えているなら、その余計な一言が顧客に届くかどうかを決めるのは、それを取り囲むチームメイトです。eeselはヘルプデスクに接続し、過去のチケットとヘルプセンターから学習し、過去のチケットに対して実行させることで、本番に出る前にリンクを含めた回答を読めます。プランは500クレジットで299ドルからの固定クレジットパッケージなので、料金はトークンの価格や返信の長さで動きません。

キューの一部でeeselを試すことも、まだ自作を検討しているならChatGPTを直接使う場合との比較を読むこともできます。