
要点(TL;DR)
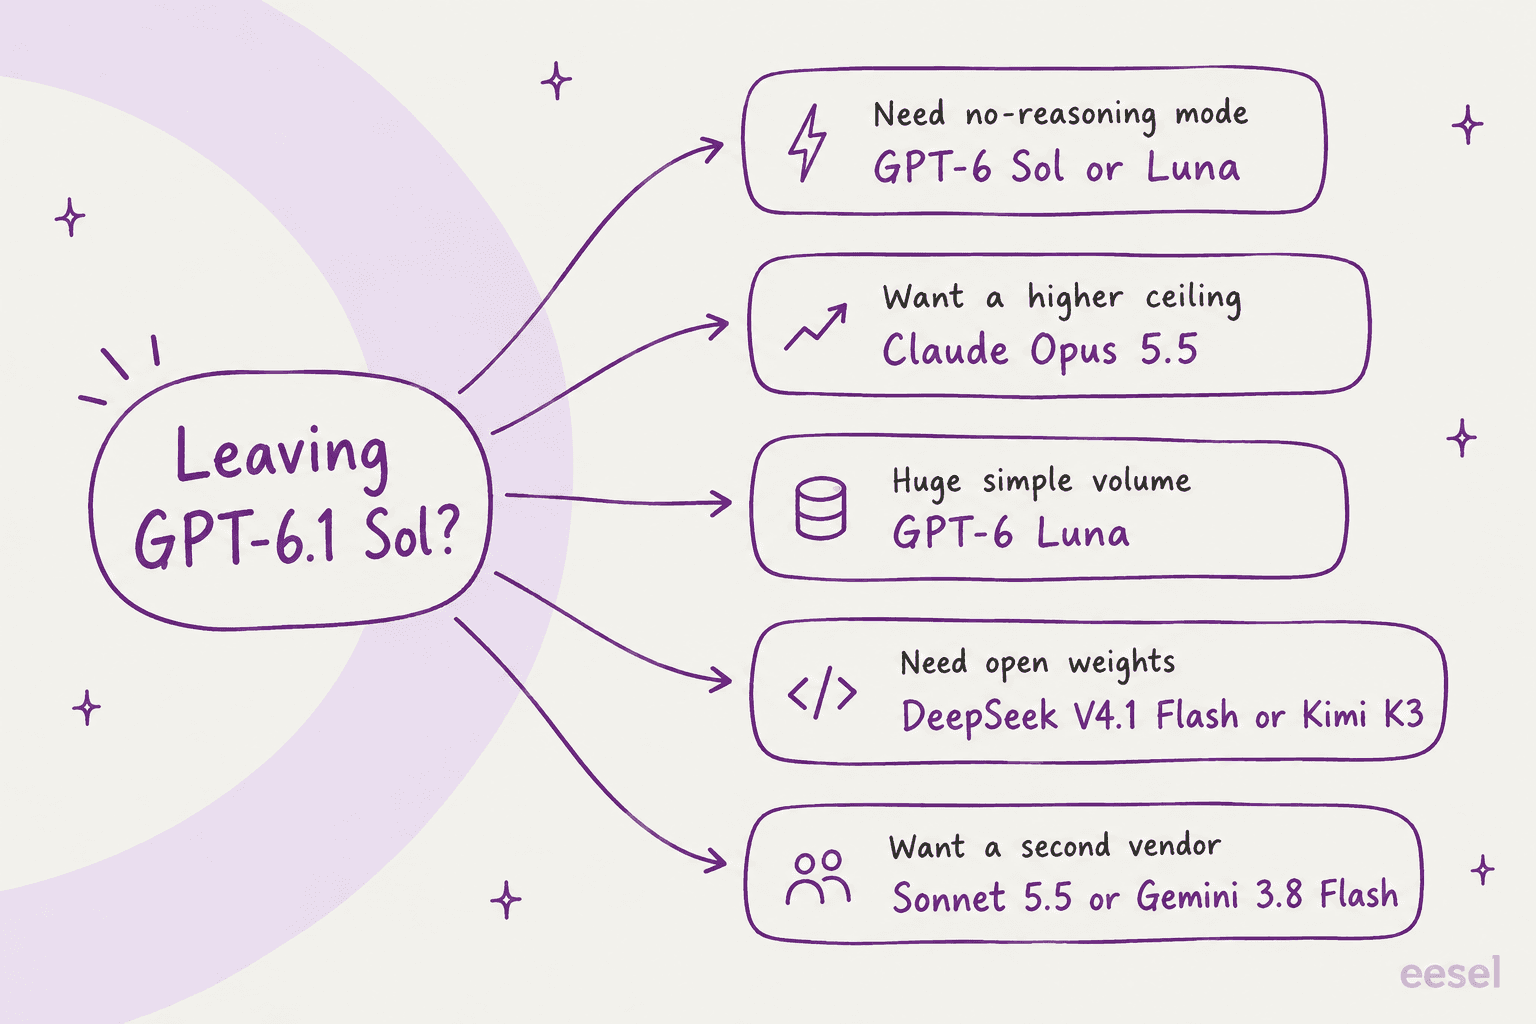
GPT-6.1 Solは価格面で打ち負かすのが難しいモデルです。100万トークンあたり$2/$10で、Artificial Analysisでは近いスコアのモデルでタスク単価がこれより安いものは存在しません(medium effortで$0.21)。ですから乗り換えるのは特定の理由がある場合に限るべきで、その理由は5つあります。推論なしモードが必要、上限の高さが欲しい、シンプルな作業を大量に処理する、オープンウェイトが必要、または第2のベンダーが欲しい、です。
私の推し、手短に。シンプルなサポート系の作業なら、GPT-6 Lunaが私のテストチケット15件すべてに合格し、1,000チケットあたり$0.11、GPT-6.1 Solの約16分の1でした。コードがnone effortやChat Completionsのツール呼び出しに依存しているなら、旧モデルのGPT-6 Solがまだ稼働していて、両方をサポートしています。上限の高さならClaude Opus 5.5。オープンウェイトならDeepSeek V4.1 FlashかKimi K3です。
私は毎日eeselでサポートキューをさばいているので、これらの代替のうち4つを、GPT-6.1 Solレビューで使ったのと同じ15チケットのテストにかけました。正直な結論は、モデル選びは請求額を大きく動かしたものの、回答そのものはほとんど変えなかった、ということです。ミスは指示と引き継ぎの問題であり、それはあなたが選んだどのモデルの上でもeeselのようなAIヘルプデスクの担当が扱う部分です。
そもそもなぜGPT-6.1 Solの先を探すのか
まず6.1 Solに公平でありたいと思います。それだけの価値を稼いできたモデルです。OpenAIは2026年9月29日のDevDayで、GPT-6 Solのわずか7日後に投入し、OpenAIのメイン料金表で旧モデルを置き換えました。表示価格は$2/$10のまま。ただしキャッシュ入力は100万あたり$0.10まで下がり、これはGPT-6 Solの半額です。Artificial Analysisはmax effortで51.8、タスクあたり$0.72と評価しており、これはGPT-6 Astraより約1ポイント下で、Astraのコストの22%です。
これは強いポジションであり、Artificial Analysisもローンチ当日にかなり率直にそう述べています。
「GPT-6.1 Solのすべてのeffortレベルが、コスト効率のパレートフロンティアを押し広げています。あるインテリジェンスの水準に対して、これより安いモデルは存在しません。」
では、なぜわざわざ他を探すのか。ローンチのスレッドを読み、自分でテストを走らせると、3つの理由が繰り返し出てきました。
APIが勝手に変わった。 6.1 Solはlow、medium、high、xhigh、maxのeffortしか受け付けません。10月1日にnoneを送ってみたところ、「Unsupported value: 'none' is not supported with the 'gpt-6.1-sol' model.」が返ってきました。Chat Completionsでの関数呼び出しはnone effortでのみ動作するため、Chat Completionsのツール呼び出しの上に作られたボットには選択肢が2つしか残りません。Responses APIに移行するか、旧モデルにとどまるかです。
遅い。 Artificial Analysisは1秒あたり67トークンと測定しており、GPT-6 Solの76に対して遅いです。私自身のテストでも、medium effortで1チケットあたり4.1sかかり、旧モデルの3.5sより遅くなりました。その差は小さく聞こえます。でも顧客が返信を待って座っていると、小さく感じられなくなります。
依然として単一ベンダー、クローズドウェイト、無料枠なし。 コンプライアンス上セルフホストが必須だったり、帳簿に第2のサプライヤーが欲しいだけだったりすると、6.1 Solはそこでは助けになりません。
Hacker Newsの誰かが初日にこのAPIの変更に気づいていました。
「ありそうな話だ。APIではGPT-6.1 SolはAstraと同じく推論を必須にしているが、GPT-6 Sol(とLuna)は"none"を許可している」

タスク単価は実際どう見えるか
リストに入る前に、一つ見ておく価値のあるチャートがあります。これは以下のすべての表示価格の読み方を変えるからです。私は2026年10月1日に、すべての代替モデルについてArtificial Analysisのモデルページを引いてきました。つまりここのスコアはすべて、1つのインデックスの、1つの日付のものです。人々はしょっちゅう異なる週のインデックスのスナップショットを混ぜてしまい、結果としてナンセンスを公開しがちです。私はそれをやりたくありませんでした。
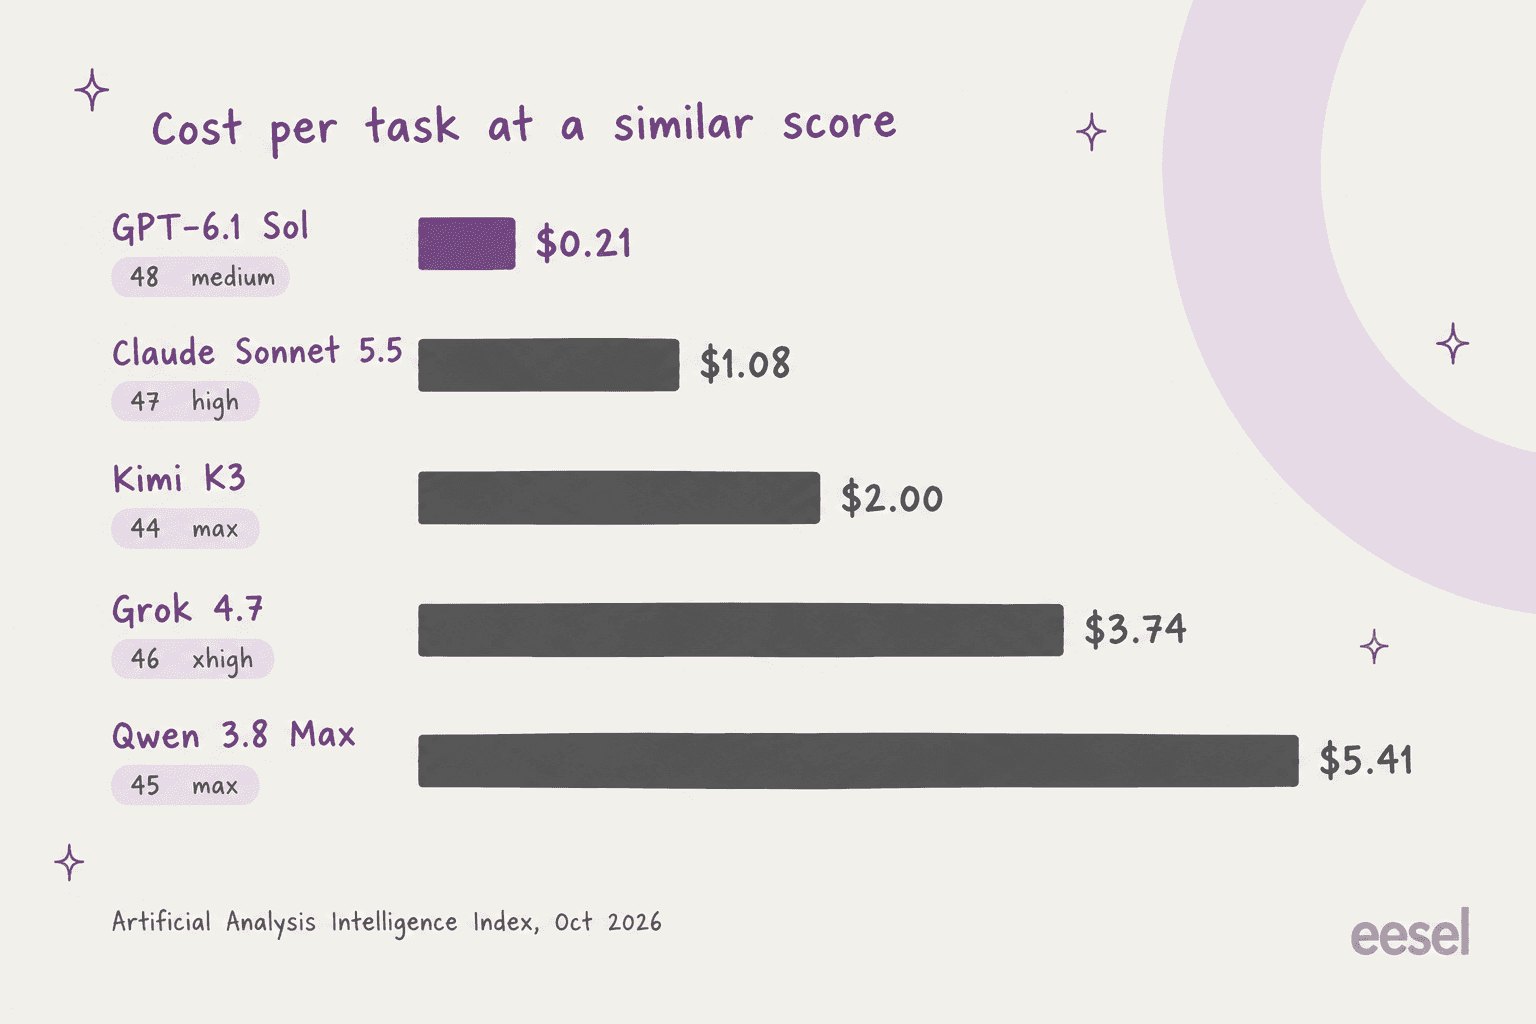
そのチャートのどのモデルも、medium effortで6.1 Solの約4ポイント以内のスコアです。そのいずれもが、タスクあたり5倍から26倍のコストがかかります。Grok 4.7を見てください。出力価格はSolより安い($10に対し$6)のに、それでもタスクあたり$3.74かかります。そこに至るまでにはるかに多くのトークンを書くからです。あるHacker Newsのコメンターが、安価な中国製モデルについて同じ点を、私より色鮮やかに指摘しています。
「中国製モデルはトークン単価で安く速いが、GPT-6.1-Solが比較的わずか2滴の思考トークンで達成するのと同じ結果を出すために、思考トークンの海を生成する」
ですから、有用な問いは「どのモデルがSolより安いか」ではありません。タスク単価では、ほとんど存在しないのです。より良い問いは「私の5つの理由のどれが自分に当てはまるか」です。
どう選び、どうテストしたか
ここで挙げるモデルはすべて、今日公開APIで一般提供されています。そこから私は4つの点を比較しました。各ベンダー自身の料金ページからの実際のトークン単価、それに加えて同じArtificial Analysisのスナップショットからのタスク単価とスコアです。また、ウェイトがオープンかどうか、そして各モデルが6.1 Solを離れる特定の理由にどれだけ合うかも見ました。
その後、最も安いか最も関連性の高い4つの選択肢を、私のサポートテストにかけました。これはGPT-6.1 Solレビューと同じハーネスです。架空のSaaS企業向けの短い返金・配送ポリシーに対する15チケットで、わざと時々失敗する注文照会ツール付きです。チケットは混成です。返金期限と日割り計算、プロンプトインジェクション、怒った二重請求、スペイン語とドイツ語での問い合わせ、壊れたツール、そしてタイポの入った注文IDが1件です。
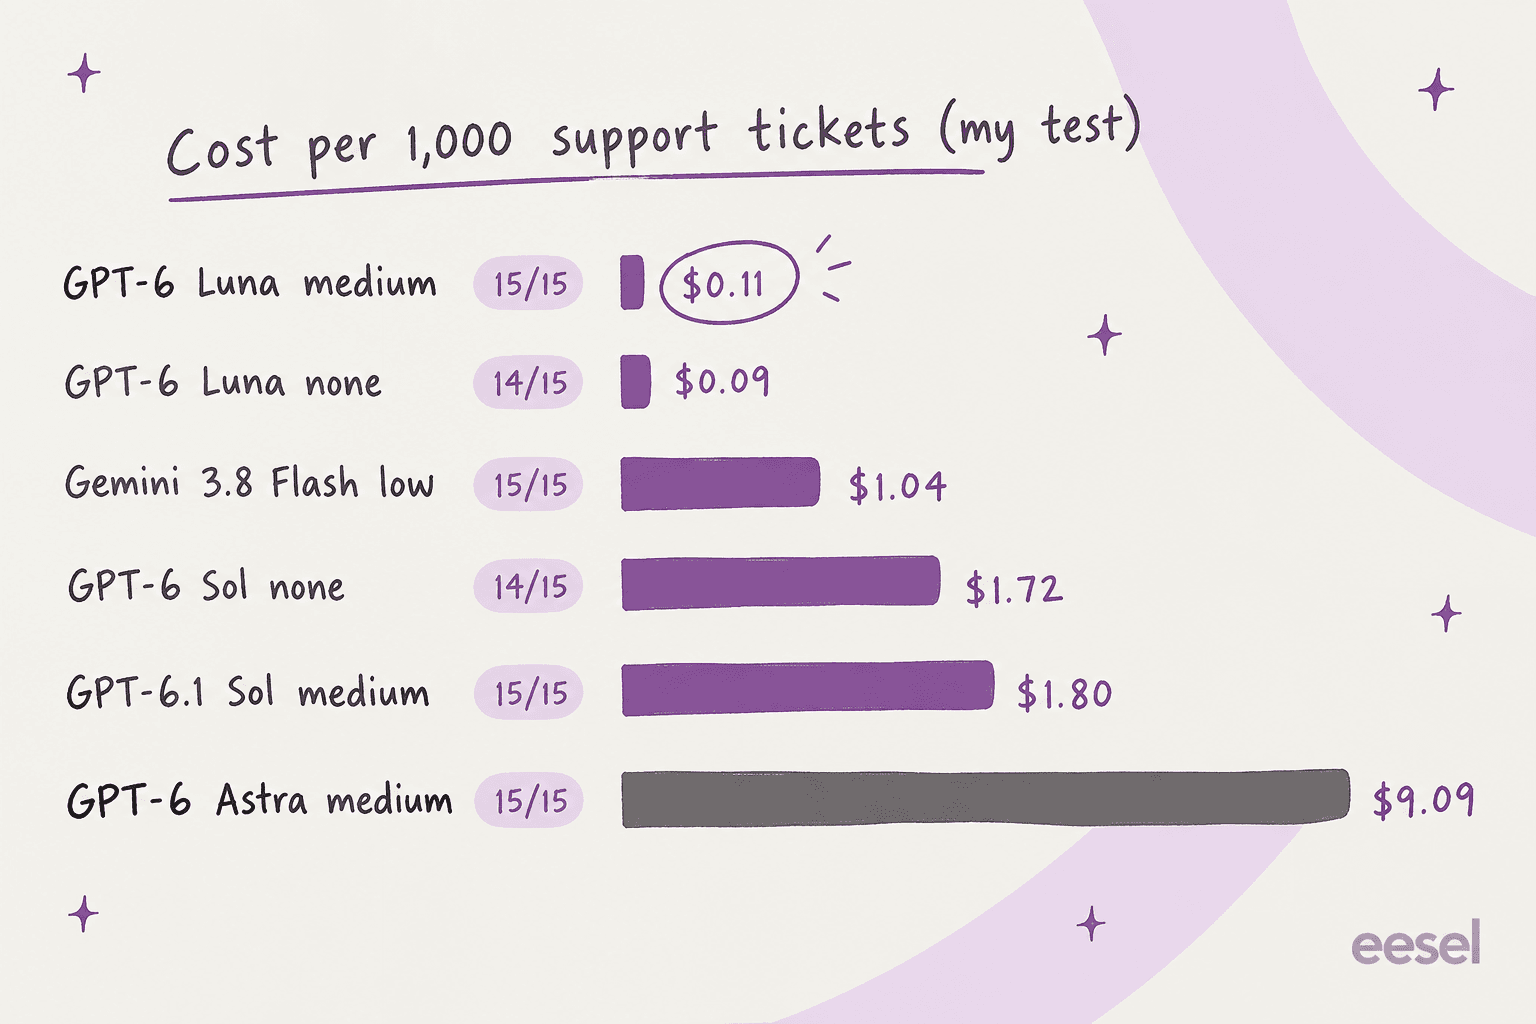
いくつか驚いたことがあります。まず、OpenAIのラインナップで最も安いモデルが6.1 Solの15/15と互角でした。次に、唯一の2件のミスはnone effortの実行から来ており、どちらも同じチケット、日割り返金の計算でした。推論なしだと、GPT-6 SolもGPT-6 Lunaも金額を算出できないと述べ、人間に引き継ぎました。ただしLunaをmedium effortに上げると、正解である$990にたどり着きました。
一つ注意点を。自分が読む側だったら欲しいと思うので書きます。きれいなポリシーに対する15チケットは、小さく、かなり好意的なテストです。これが示すのは、これらのモデルがルールに従いツールを使えるということです。示せないのは、あなたの雑多なマクロ、400記事のヘルプセンター、あるいは最初に別の話を3段落書く顧客にどう対処するか、です。
以下が全選手を並べたものです。
| モデル | 乗り換える最良の理由 | API価格(入力 / キャッシュ / 出力、100万あたり) | AAスコア / タスク単価 | コンテキスト | ウェイト | 私のテスト |
|---|---|---|---|---|---|---|
| GPT-6.1 Sol(基準) | - | $2 / $0.10 / $10 | 47.8 / $0.21 (medium) | 1.05M | クローズド | 15/15, 1kあたり$1.80 |
| GPT-6 Luna | 大量のシンプルな処理 | $0.10 / $0.01 / $0.50 | 29.5 / $0.018 (medium) | 1.05M | クローズド | 15/15, 1kあたり$0.11 |
| GPT-6 Sol | none effortが必要 | $2 / $0.20 / $10 | 39.8 / $0.25 (medium) | 1.05M | クローズド | 14/15, 1kあたり$1.72 |
| Claude Opus 5.5 | より高い上限 | $4 / $0.20 / $20 | 57.6 / $5.98 (max) | 1M | クローズド | - |
| Claude Sonnet 5.5 | 同価格の第2ベンダー | $2 / $0.20 / $10 | 46.7 / $1.08 (high) | 1M | クローズド | - |
| GPT-6 Astra | 今日使えるUltrafast | $10 / $1 / $50 | 52.7 / $3.26 (max) | 1.05M | クローズド | 15/15, 1kあたり$9.09 |
| Gemini 3.8 Flash | 無料枠、Googleスタック | $0.75 / $0.075 / $3.75 | 40.9 / $1.24 (high) | 1M | クローズド | 15/15, 1kあたり$1.04 |
| Grok 4.7 | 安い出力レート | $2 / $0.50 / $6 | 46.4 / $3.74 (xhigh) | 500K | クローズド | - |
| DeepSeek V4.1 Flash | オープンウェイト、MIT | $0.15 / $0.003 / $0.60(オフピーク) | 39.5 / $0.27 (max) | 1M | オープン | - |
| Kimi K3 | オープンなフロンティアウェイト | $3 / $0.30 / $15 | 43.6 / $2.00 (max) | 1M | オープン | - |
GPT-6.1 Solを離れる理由は何ですか?
自分に最も合う理由を選んでください。
none effortを受け付け、Chat Completionsで関数呼び出しを許可します。6.1 Solは両方を拒否します。いずれにせよResponses APIへの移行を計画してください。GPT-6 Solはすでにメイン料金表で置き換えられています。1. GPT-6 Luna: サポート量なら私が最初に試すもの
最適な用途: チケット返信、タグ付け、ルーティングのような、ピーク時の推論よりも速度とコストが重要な、大量でルールに従う作業。
これは私自身のデフォルトを変えました。GPT-6 LunaはOpenAIで最も安いGPT-6モデルで、100万トークンあたり入力$0.10、出力$0.50、medium effortでは私のサポートチケットで15戦15勝でした。注文ツールを確認し、プロンプトインジェクションを拒否しました。二重請求では「本日中」と約束する代わりに営業日5日ルールを引用しました。スペイン語とドイツ語でも回答し、日割り返金の$990も算出しました。全実行は1,000チケットあたり$0.11で済み、medium effortの6.1 Solは$1.80でした。
私がテストした中でこれより速いものはありませんでした。medium effortで1チケットあたり3.0s、noneで2.3sです。そのモデルページには、Solと同じ1,050,000トークンのコンテキストウィンドウ、2026年5月のナレッジカットオフ、そしてnoneからmaxまでの全effort範囲が記載されています。
Lunaが見劣りするのは、私のテストではなくArtificial Analysisのインデックスです。Lunaはmediumで29.5、maxで37.3で、6.1 Solのmediumの47.8に対して低い。私のチケットは短く、ポリシーも整っていたので、その差が現れる機会はありませんでした。Lunaをより雑多なナレッジベースや複数ステップのエージェントタスクに乗せれば、その差は現れます。
長所: 私のテストでチケットあたり6.1 Solの約16分の1、最速の返信、none effortとChat Completionsのツール呼び出しを維持、同じコンテキストウィンドウ。
短所: 難しい推論でスコアがはるかに低い、none effortでは日割り計算をスキップ、クローズドウェイト、単一ベンダー。
料金: 100万トークンあたり入力$0.10、キャッシュ$0.01、出力$0.50。BatchとFlexは50%オフ。全内訳はGPT-6 Lunaの料金に。
私の見解: サポートキューなら、medium effortのLunaから始めて、エスカレーションされたものを6.1 Solに送りましょう。そうすればほとんどの量がほぼ無料のモデルに乗り、本当に必要なチケットにだけSol料金を払うことになります。
2. GPT-6 Sol: いまだにnoneができるもの
最適な用途: 本番コードがnone effortまたはChat Completionsでの関数呼び出しに依存していて、移行中に同等のモデルが必要なチーム。
一部のチームにとって、6.1 Solの最良の代替は、単にそれが置き換えたモデルそのものです。GPT-6 Solはメイン料金表から消えましたが、そのモデルページはまだ生きていて、いまだに$2/$10で、「reasoning.effort supports none」と記載されています。また「Chat Completions supports function calling only with reasoning_effort set to none」とも書かれており、これはまさに6.1 Solが捨てた組み合わせです。10月1日にOpenAIの非推奨ページを見たとき、GPT-6 Solに停止日は記載されていませんでした。
私のテストではnone effortで14/15、1,000チケットあたり$1.72、1チケットあたり3.6sと、6.1 Solより少し速かったです。唯一のミスは日割り計算でした。「ポリシーでは未使用の満月数の数え方が指定されていない」と述べてエスカレーションしました。間違った回答ではなく安全なミスです。それでも、人間が触らなければならないチケットが1件増えます。
品質では6.1 Solが勝ちます。Artificial AnalysisはGPT-6 Solをmediumでタスクあたり$0.25の39.8としており、6.1 Solの$0.21での47.8に対して低い。キャッシュ入力も$0.20と2倍かかります。より深く知りたければ、同僚のGPT-6 Solレビューが扱っています。
長所: none effortを維持、Chat Completionsのツール呼び出しができる唯一の$2/$10のGPT-6モデル、コード変更不要。
短所: あらゆるeffortで6.1 Solよりスコアが低い、キャッシュ入力が2倍、すでに料金表で置き換え済みなので橋渡しとして扱うべき。
料金: 100万トークンあたり入力$2、キャッシュ$0.20、出力$10。入力272Kトークンを超えるプロンプトは、リクエスト全体が入力2倍・出力1.5倍で課金されます。詳細はGPT-6 Solの料金に。
私の見解: GPT-6 Solにとどまるのは、ツール呼び出しをResponses APIに移すのにかかる期間だけにしましょう。長期的にnoneを使うなら、Lunaの方が安全な賭けです。置き換えられた方ではなく、今の安価なモデルです。
3. Claude Opus 5.5: 上限が本当に一段上がる
最適な用途: 6.1 Solの回答は良いが今ひとつ足りない、難しいコーディングや長いエージェントタスク。
より賢いモデルが欲しくて6.1 Solを離れるなら、Claude Opus 5.5が私の見るところです。Artificial Analysisでmax effortで57.6をマークし、6.1 Solのベストより約6ポイント上で、Anthropicのローンチ投稿によればTerminal-Bench 4.0で66.4%を記録しています。また、前世代より安くなった初のOpusでもあり、100万あたり$4/$20です。
いつも通り、落とし穴はタスク単価です。max effortではタスクあたり$5.98で、6.1 Solのmaxの$0.72の8倍です。medium effortの方がお得で、$1.34で51.2、これは6.1 Solのmaxスコアを約2倍のお金で得られます。GPT-6 Sol vs Opus 5.5の比較が、そのeffortの計算を詳しく説明しています。
私が見つけたHN上のハンズオンレポートのほとんどは、コードが難しくなるとOpusの側に立ちます。
「Opus 5.5と6 Solで複数の機能を並行して実装したが、Opus 5.5の結果は常に重大度の高いバグが少なく、仕上げるのに必要な修正ラウンドも少ない。」
このコメントはOpusを6.1ではなくGPT-6 Solと比較しており、同じスレッドでは6.1がその差をいくらか縮めているとも述べています。それでも、ここのエンジニアから聞く話と一致します。
長所: このリストで最高スコア、ターミナルとコーディングのベンチマークに強い、キャッシュ読み取り$0.20、長文コンテキスト追加料金なしの1Mコンテキスト。
短所: maxでタスク単価が最も高い、シンプルなチャットや抽出にはオーバースペック、管理すべきベンダーが1つ増える。
料金: 100万トークンあたり入力$4、キャッシュ読み取り$0.20、出力$20。Batchは50%オフ、Anthropicの料金ドキュメントより。Claude Opus 5.5の料金を参照。
私の見解: 6.1 Solが最も難しいタスクで外し続けるなら、medium effortのOpus 5.5を選びましょう。ただしデフォルトでmaxにしたままにしないこと。必要のなかったトークンにお金を払うことになります。
4. Claude Sonnet 5.5: 同じ表示価格、別のベンダー
最適な用途: 主にコーディングとエージェント作業向けに、第2のラボから$2/$10のモデルが欲しいチーム。
Claude Sonnet 5.5は2026年9月28日、6.1 Solの前日に、同じ入力$2・出力$10でローンチしました。Anthropic自身の数字では、Terminal-Bench 4.0でOpus 5.5にすら勝っています(70.6%対66.4%)。Artificial Analysisではmax effortで56.0に達し、6.1 Solの51.8を大きく上回ります。
注意が必要なのはタスク単価です。max effortでは、Sonnet 5.5はタスクあたり$7.60で、Opus 5.5より高い。high effortでは$1.08で46.7をマークし、これはmediumの6.1 Solとほぼ同じスコアを5倍のコストで得ることになります。Anthropic自身、節約はlow effortにあると述べています。同僚のSonnet 5.5レビューも同じ結論に達しました。
サポートボットにはここに追加の罠があります。Sonnet 5.5は強制的なtool_choice(anyや名前付きツール)で400を返すので、すべてのチケットで注文照会を強制するボットは書き直しが必要です。6.1 Solから人々を押し出しているのと同じ種類の破壊的変更が、別の場所にあるだけです。
6.1 Solのスレッドでは、今回はAnthropicが先行していると考える開発者もいます。
「ベンチマークやテスト結果を見せなかったのは、自社のフラッグシップモデルがSonnet 5.5の能力に対抗できないと明かすのが恥ずかしかったからだと思う。」
長所: 第2ベンダーから同じ$2/$10の価格、6.1 Solより高い最高スコア、ターミナルコーディングに非常に強い、1Mコンテキスト。
短所: 同スコアでタスク単価がはるかに高い、強制ツール選択がエラーを返すようになった、max effortは膨大なトークン数を消費しうる。
料金: 100万トークンあたり入力$2、キャッシュ読み取り$0.20、出力$10。Batchは$1/$5。Claude Sonnet 5.5の料金を参照。
私の見解: コーディング用に第2ベンダーが欲しく、effortをlowかmediumに保つなら、Sonnet 5.5は正しい選択です。やっているのが大量のサポート返信なら、6.1 SolかLunaの方がチケット単価は安くなります。
5. GPT-6 Astra: 今すぐUltrafastが必要な場合だけ
最適な用途: すでにOpenAIを使っていて、今日最速の生成モードが必要なチーム、あるいは最後の1ポイントのスコアが欲しいチーム。
GPT-6 AstraはOpenAIのフラッグシップです。問題は、6.1 Solがそれを正当化しにくくしたことです。Artificial AnalysisはAstraをタスクあたり$3.26の52.7としており、6.1 Solの$0.72での51.8に対しての数字です。私のサポートテストでは、Astraは5倍のコストで6.1 Solの15/15と互角、1,000チケットあたり$1.80に対し$9.09でした。1チケットあたり5.2sと遅くもありました。
今月、これを選ぶ理由は実質1つだけで、それがUltrafastです。OpenAIの料金ページはUltrafastレートをAstraのみ、100万あたり入力$60・出力$300で記載しており、6.1 Solは「coming soon」です。今すぐその速度ティアが必要ですか?Astraはそれを持つ唯一のGPT-6モデルです。
長所: OpenAI最高スコア、Ultrafastが今すぐ利用可能、AA上でGPT-6ファミリー最低のハルシネーション率。
短所: 1ポイント多いだけでタスク単価が6.1 Solの約4.5倍、私のテストでは遅い、Ultrafastは非常に高価。
料金: 100万トークンあたり入力$10、キャッシュ$1、出力$50。BatchとFlexは50%オフ。GPT-6 Astraの料金を参照。
私の見解: ほとんどのチームにとって、6.1 Solはその逆ではなくAstraを置き換えました。私はAstraを、1ポイント多いことが重要になる稀なジョブや、UltrafastがSolに来るのを待てない場合のために残しておきます。
6. Gemini 3.8 Flash: 無料枠付きのGoogleの選択肢
最適な用途: Google Cloudスタックのチーム、無料枠のプロトタイプ、トークン単価が重要なバッチジョブ。
Gemini 3.8 Flashは私のテストをlow effortで15/15、1,000チケットあたり$1.04で通過し、日割りの$990も計算過程を示して正解しました。返信は平均3.0s。テストした中で最も多くの書式も使いました。2行で済む注文状況の返信が、箇条書きと太字ラベル付きで返ってきました。
価格は細字を読んでください。Geminiの料金ページは「2026年12月31日まで」入力$0.75・出力$3.75、その後2027年1月1日から$1.50・$7.50と記載しています。買い手はその種の倍増を覚えています。eeselの営業電話で、予算に敏感な買い手が、以前のベンダーの価格が「2倍以上になった」と言い、何よりも先に契約上の価格ロックを求めました。
Artificial Analysisでは、Gemini 3.8 Flashはhigh effortでタスクあたり$1.24の40.9で、6.1 Solより下、タスク単価は6倍です。また新しいベースモデルではありません。Googleのモデルカードは、Gemini 3.7 Flashをベースにしていると述べています。
長所: 無料枠、正しい計算で私のテストに合格、高いスループット、BatchとFlexは50%オフ。
短所: 2027年1月1日に価格倍増、AA上でタスク単価が6.1 Solより高い、冗長な返信。
料金: 2026年12月31日まで100万トークンあたり入力$0.75、キャッシュ読み取り$0.075、出力$3.75、その後$1.50/$0.15/$7.50。Gemini 3.8 Flashの料金を参照。
私の見解: すでにGoogle Cloudで動かしているなら、妥当な第2ベンダーです。請求が1月に驚きにならないよう、現在のレートではなく2027年のレートで見積もりましょう。
7. Grok 4.7: 出力レートは安いが、タスクは安くない
最適な用途: リクエストあたり200Kトークン未満に収まるエージェントループや、すでにxAIで構築しているチーム。
Grok 4.7は、一見するとSolキラーのように見える表示価格を持っています。xAIのモデルページによれば、100万あたり入力$2・出力$6で、Solの出力レートより40%低い。Grok 4.6より大きなベースモデルの上に、数時間に及ぶエージェントタスクを狙ったより長い訓練で構築され、ナレッジカットオフは2026年5月です。
タスク単価のチャートは別のことを語ります。Artificial AnalysisはGrok 4.7をxhigh effortでタスクあたり$3.74の46.4としており、mediumの6.1 Solよりわずかに低いスコアを約18倍のコストで得ることになります。理由は単純で、多くのトークンを書くからです。長文コンテキストの料金にも注意してください。200Kプロンプトトークンを超えると、レートがオーバーフロー分だけでなくリクエスト内のすべてのトークンに対して$4/$12に跳ね上がります。
長所: Solより低い出力レート、Grok 4.6からのエージェント面の大幅な向上、500Kコンテキスト、コーディング用の無料Grok Buildツール。
短所: AA上でタスク単価が6.1 Solよりはるかに高い、200Kでの長文コンテキストの崖、Grok 4.7 FastはCursorとGrok Buildのみで公開APIにはない。
料金: 200K未満で100万トークンあたり入力$2、キャッシュ$0.50、出力$6。200K超は$4/$1/$12。ハンズオンのメモはGrok 4.7レビューを参照。
私の見解: すでにxAIのツールに住んでいるなら、Grok 4.7は意味があります。でも低い出力価格が唯一の理由なら、まず自分のタスク単価テストを走らせてください。インデックス上では逆の結果になります。
8. DeepSeek V4.1 Flash: オープンウェイトと極小の請求額
最適な用途: セルフホスト用にMITライセンスのウェイトが必要なチーム、またはバックグラウンド作業に最安のAPI価格が欲しいチーム。
DeepSeek V4.1 Flashはこのリストで最も安い有能なモデルであり、完全に自分のものにするのが最も簡単です。ウェイトはHugging Face上でMITライセンスで提供されています。APIはモデル名deepseek-flashを使い、旧来のdeepseek-v4-flashという名前は今やV4.1にルーティングされます。DeepSeekの料金ページによれば、ビジョン、ツール呼び出し、1Mコンテキストウィンドウ、最大384Kの出力トークンをサポートします。
料金にはタイムゾーンの癖があります。オフピークは100万あたり入力$0.15・出力$0.60、ピークはちょうど2倍です。ピーク時間はUTCの平日01:00〜04:00と06:00〜10:00なので、米国のサポートキューはほぼオフピークレートで課金され、アジア時間のキューはそうなりません。
タスク単価では、表示価格が示唆するよりも6.1 Solに近いです。Artificial AnalysisはV4.1 Flashをmax effortでタスクあたり$0.27の39.5としており、mediumの6.1 Solの$0.21での47.8に対しての数字です。顧客データが関わるなら、どこで動くかも確認してください。DeepSeekのファーストパーティAPIは中国でホストされ、そのAPI規約は訓練利用について沈黙しているので、多くのチームはセルフホストするか、データ契約を結んだサードパーティホストを使います。
長所: MITオープンウェイト、ここで最安のトークン単価API、画像も扱えるようになった、1Mコンテキスト。
短所: 6.1 Solよりスコアが低くタスク単価がわずかに高い、ピーク時間の料金、ファーストパーティホスティングは顧客データには売り込みにくい。
料金: オフピークで100万トークンあたりキャッシュヒット$0.003、入力$0.15、出力$0.60、ピークは2倍。DeepSeek V4.1 Flashの料金を参照。
私の見解: セルフホストや夜間のバッチ作業にはV4.1 Flashを選びましょう。ただしインタラクティブなボットで6.1 Solをそのまま置き換えるものとしては、タスク単価でお金を節約できません。
9. Kimi K3: オープンなフロンティアウェイト
最適な用途: ダウンロードして実行できる最強のオープンウェイトモデルが必要なチーム。
Moonshot AIのKimi K3は、2.8兆パラメータのMixture-of-Expertsモデルで、104Bがアクティブ、1Mコンテキストウィンドウ、ネイティブビジョンを備えます。全ウェイトはHugging Face上でカスタムライセンスで提供されているので、ハードウェアがあれば自分で実行できます。
ホスト型APIでは、Kimiの料金ページによれば100万あたり入力$3、キャッシュ$0.30、出力$15です。入力でも出力でもSolより高い。Artificial Analysisはmax effortでタスクあたり$2.00の43.6と評価しています。推論はどのレベルでもオフにできず、その最低設定は安いティアというより速度調整に近いものになっています。
長所: このリストで最強のオープンにダウンロード可能なウェイト、1Mコンテキスト、画像と動画の入力。
短所: ホスト型APIはトークン単価でもタスク単価でも6.1 Solより高い、MITやApacheではないカスタムライセンス、推論が常にオン。
料金: 100万トークンあたり入力$3、キャッシュヒット$0.30、出力$15。Kimi K3の料金を参照。
私の見解: Kimi K3はセルフホスト向けの選択肢です。ホスト型APIだけが欲しいなら、6.1 Solの方が安くスコアも高いです。
サポートのためのモデル乗り換えについて、私のテストが語ること
ここが私が何度も立ち返る部分です。135回の実行と9つの構成を通じて、1,000チケットあたり$0.09から$9.09まで、ミスは毎回同じ種類でした。すべての構成が、Astraも含めて、タイポの入った注文ID(「A1O43」)を顧客に確認を求める代わりにエスカレーションしました。noneの実行は、できたはずの計算を諦めました。ティアを上げてもそのどれも直りませんでした。それを直す(あるいは直せたはずの)ものは、指示の中の1行と、実際のチケットでのテストです。
これは買い手から聞く話とも一致します。月約7,000チケットを扱うあるCXリードが、eeselチームに営業電話で、AIは自信のあるチケットだけに答え、残りは静かに人間に任せるべきだと言いました。それはモデルの機能ではなく引き継ぎのルールです。そのルールはモデルの周りのレイヤーで設定し、そして顧客が目にする前に自分の履歴で確認するのです。
ですから、サポートキューでお金を節約するために6.1 SolをLunaに乗り換えるなら、それは賢い判断だと思います。ただし、まず過去のチケットでテストし、確信が持てないものについては人間への明確な経路を保ってください。AIエスカレーションガイドが、その設定方法を扱っています。
eeselを試す

サポートを自動化したくてGPT-6.1 Solの代替を比較しているなら、モデルはエンジンであり、eeselはそれを運転するために雇う担当です。AIヘルプデスクエージェントはZendesk、Freshdesk、Gorgiasの既存のキューに加わり、あなたのヘルプセンターと過去チケットから学び、チケット履歴に対してシミュレーションを走らせるので、誰かに返信する前にその回答と解決率を確認できます。私のテストのあのタイポIDのミス?まさにシミュレーションが捕まえる種類のギャップです。
ターミナルから作業するなら、eesel CLIがダッシュボードと同じ担当・同じワークスペースを操作します。古いチケットのバッチでテスト実行をスクリプト化したり、結果を自分のツールに取り込んだり、Claude Code、Codex、Cursorのようなコーディングエージェントにセットアップを任せたりできます。どちらの場合も同じ担当で、ただヘッドレスなだけです。eeselを無料で試して、モデルやプランを選ぶ前に自分のチケットで走らせることができます。
よくある質問
2026年で最良のGPT-6.1 Solの代替モデルは何ですか?
GPT-6.1 Solより安い代替モデルはありますか?
GPT-6.1 Solはなぜnone推論レベルを廃止したのですか?
noneを指定した呼び出しはエラーを返します。GPT-6 SolとGPT-6 Lunaは引き続きnoneをサポートしており、Chat Completionsで関数呼び出しを許可する唯一のGPT-6モデルです。私のGPT-6.1 SolレビューでAPIの変更点を解説しています。GPT-6.1 SolはClaude Sonnet 5.5より優れていますか?
GPT-6.1 Solの良いオープンウェイトの代替は何ですか?
GPT-6.1 SolからGPT-6 Astraに乗り換えるべきですか?
GPT-6.1 Solの代替モデルはカスタマーサポートに使えますか?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.