AGIが到来する前に500エラーを返したローンチ
まずはこのレビュー全体のトーンを決めた瞬間から始めましょう。OpenAIはAstraを「世界で最も知能が高く、最もアラインされたモデル」と位置づけ、社長のGreg Brockmanは記者団に対し個人的にはAGIに到達していると信じていると語りました。ところが、当のローンチページ自体が1時間以上にわたってサーバーエラーを返し続けたのです。Hacker Newsはいつも通りの反応を見せました。
"So, on the one hand, we have AGI; on the other, the release page is returning 500s."

この、掲げられた看板と現実とのギャップは、このレビュー全体を貫くテーマです。AGIという主張については正確を期す価値があります。というのも、あらゆる場所で繰り返されたからです。「我々はAGIに到達した」という発言はBrockmanが報道インタビューで述べたものであり、OpenAI自身のローンチページやセーフティページから出たものではありません。OpenAIが実際に公表している中で最も時代の転換を強く印象づける言葉は、外部評価者であるEpochAIのGreg Burnhamによるもので、彼は「the story is: end of one era, start of another」と述べています。これはAGIという主張よりもはるかに擁護しやすい主張であり、私が拠り所とするのはこちらです。
私はこの3年あまり、モデルのローンチが実際の本番システムにどう着地するかを見続けてきました(私たちは日々、稼働中のサポートキューでAIを運用しています)。そのパターンは一貫しています。ベンチマークのグラフと実際に出荷される体験は別物なのです。だから「新しい世代の知能」という見出しをそのまま鵜呑みにするのではなく、私はAstraをOpenAIが一つのローンチにまとめた二つの別々の物語として読み解きます。(評価抜きで仕様と価格だけをフラットにまとめたものが読みたければ、私のGPT-6 Astra解説記事がそれをカバーしています。)
一つのベンチマーク表に潜む二つの物語
一つ目の物語は見出しの通りです。Astraは「飽和」するほど難しいベンチマーク群で高スコアを記録しています。FrontierMath Tier 4で97.6%、ARC-AGI-3で99.9%、ExploitBenchで100%です。これらは印象的な数字であり、ARC Prizeも独自にARC-AGI-3の結果を確認し、Astraが96%のレベルで人間のベースラインを上回ったと指摘しています。これはマーケティングの誇張ではなく、本物の記録です。
二つ目の物語は、実際に購入者が注目しているベンチマークに目を向けると見えてきます。独立系のArtificial Analysis Intelligence Indexでは、Astraは61.2で、Solの60.9とほぼ横並び、Fable 5.1の65.7を下回っています。これこそが、ローンチ当日で二番目に大きな話題となったスレッドがあれほど失望感に満ちていた理由です。
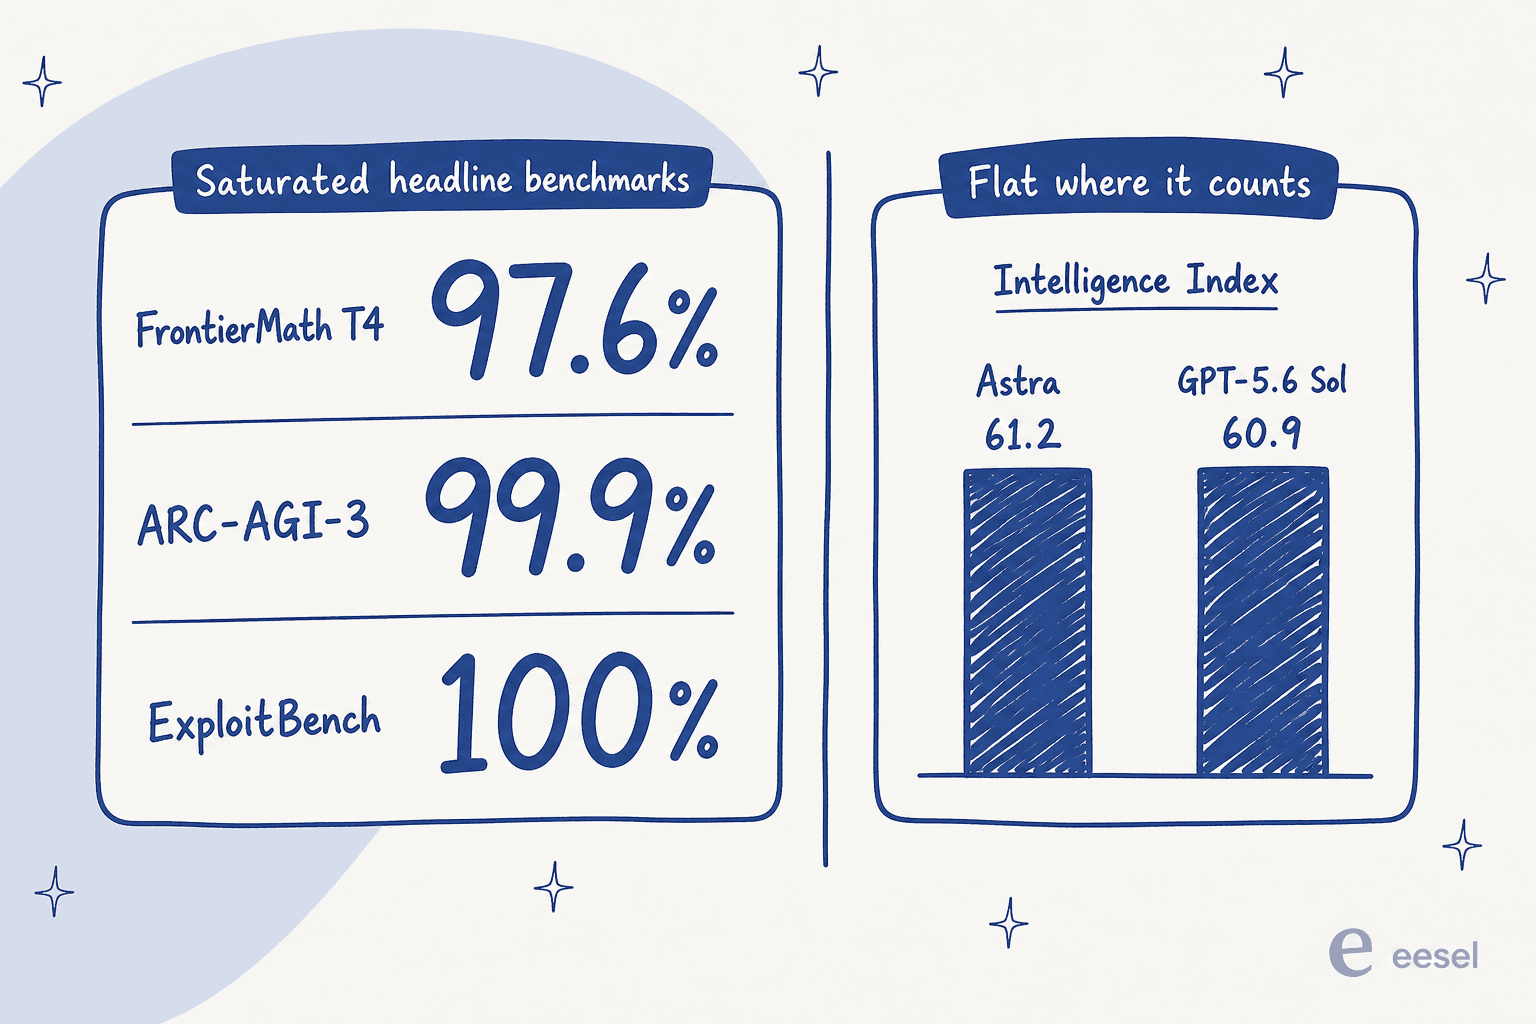
独立系のベンチマークグループであるArtificial Analysisは、自身の分析の中でこの分裂を率直に指摘しています。
"GPT-6 Astra makes significant gains in the Artificial Analysis Coding Agent Index, scoring equal to Fable 5 at lower cost. In the Intelligence Index, it uses fewer tokens than GPT-5.6 Sol for similar performance, but this is outweighed by higher prices."
以下はOpenAI自身のローンチページの表から抜き出した全体像ですが、OpenAI自身が明記している注意点があります。これらはどのような労力(エフォート)でも達成できる最高スコアであり、OpenAIの環境内で実行されたものであること、そして競合の数値の一部にはOpenAI自身が脚注で示した評価調整が加えられていることです。ベンダーをまたぐ行は、確定した事実ではなくベンダー側の申告として扱ってください。
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| FrontierMath Tier 4 (v2) | 97.6% | 80.5% | 78.0% | 73.2% |
| ARC-AGI-3 | 99.9% | 7.8% | – | 30.2% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% |
| Terminal-Bench 4.0 (コーディング) | 57.9% | 37.3% | 55.8% | 52.3% |
| Agents' Last Exam | 59.3% | 53.6% | – | 55.5% |
| ExploitBench (サイバー) | 100.0% | 78.5% | – | 70% |
| Artificial Analysis Intelligence Index | 61.2 | 60.9 | 65.7 | 63.1 |
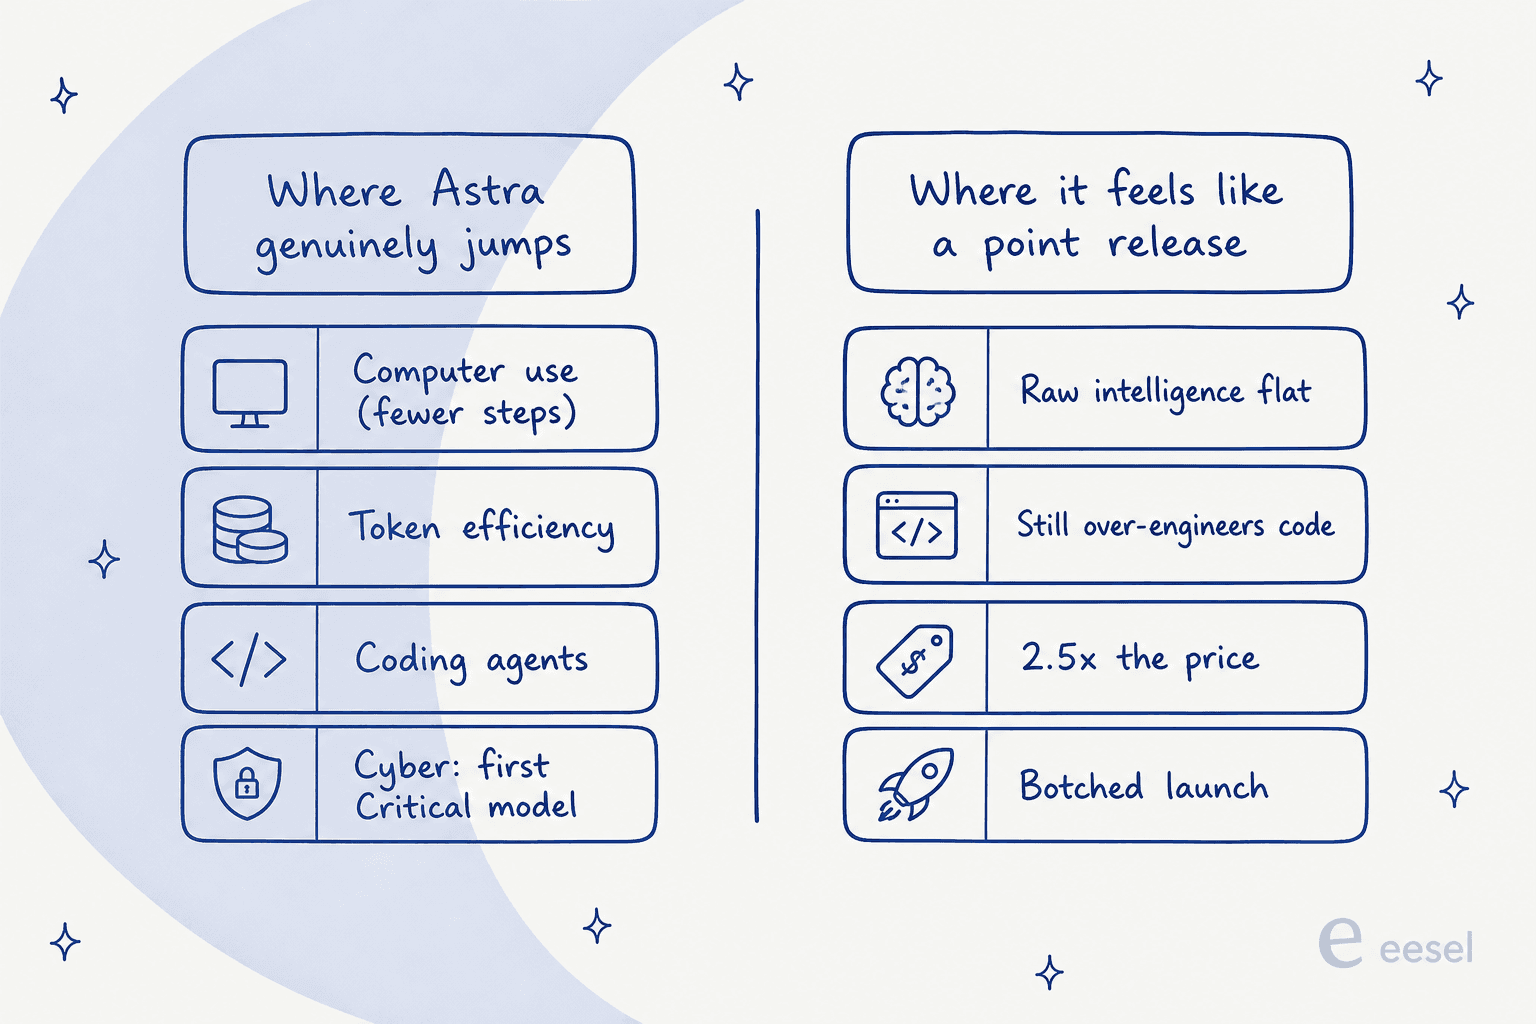
私が繰り返し立ち返る見方はこうです。Astraは狭く、エージェント的な次元(コーディング、コンピュータ操作、サイバー)では大きな飛躍を遂げていますが、汎用知能では横ばいです。あなたの仕事が前者に属するなら、これは重要です。後者に属するなら、バージョン番号は実態以上に売り込んでいることになります。あるコメント投稿者はこうまとめています。
"Title: 'major gains'. First chart: from score 61 (GPT-5.6 Sol) to drumroll 61 (GPT-6 Astra)"
Astraが本当に「6」を名乗るに値する部分
まずは正当に評価すべきところから始めましょう。エージェント的な進化は本物であり、このモデルの最も有用な部分だからです。
コンピュータ操作こそが際立った点です。 OpenAIはAstraを「コンピュータ操作の速度、精度、安全性における新たなフロンティア」と呼んでおり、数字は少なくとも「速度」の部分を裏付けています。Agents' Last Examでは59.3%を記録しつつ、Claude Opus 5より約65%少ない出力トークンで済んでいます。OSWorld 2.0のレイテンシテストでは、1タスクあたり約40分で72.6%を達成しており、Solの約75分で65.7%と比べて優れています。この「より少ないステップでより多くをこなす」挙動こそ、たとえトークン単価が高くても、実際の運用でエージェントを安く済ませる要因です。
コーディングエージェントは本物の飛躍を遂げました。 Terminal-Bench 4.0が37.3%から57.9%に上がったのは誤差の範囲ではなく、OpenAIはコンテキストウィンドウをまたいで検索可能なメモを保持するCodexの機能を出荷しました。これは、長時間のエージェント実行を悩ませる非可逆的な圧縮に代わるものです。Cognition(Devinのチーム)はローンチ当日から統合しており、自社の内部ベンチマークで最先端の結果を報告しました。
サイバーセキュリティで「Critical」に分類された初のモデルです。 これは本当に重要な新しい能力です。OpenAIのPreparedness Frameworkの下で、Astraはサイバー分野で「Critical」と指定された初のモデルであり、人間が一つひとつのステップを誘導しなくても未知のセキュリティ上の欠陥を発見し、堅牢化されたシステムに対するエクスプロイトを構築できることを意味します。内部評価の際には、V8/Chromeにおける実在する二つのゼロデイ脆弱性を発見・利用しており、現在メンテナーへの開示が進められています。だからこそ、高度なサイバー能力はオープンに出荷されるのではなく、Daybreakプログラムの背後に制限されています。
それでも失望させられる部分
ここからは正直なもう半分です。
コードを過剰に設計する癖はまだ残っています。 これは実際の利用における最も大きな不満であり、Astraで新しく出てきた問題ではありませんが、人々は「6」ならこれを直しているだろうと期待していました。ローンチスレッドに投稿されたある開発者の話です。
"I asked 5.6-sol to update a 1000 LOC python script... In the morning I realized it had created a monstruosity of 180 PYTHON SCRIPTS, with maybe 100,000 lines of code... they seem to be aiming for AGI and for beating crazy benchmarks, which is not very aligned with KISS."
デモが価格に見合う印象を与えられていません。 OpenAIのローンチ動画は、eBayに写真をアップロードしたり、Blenderで小さなゲームを作ったりといったタスクに頼っており、AGIに近いと位置づけられたモデルにしては技術者コミュニティには物足りなく映りました。チームに2.5倍多く支払わせようとするなら、「eBayに写真をアップロードできる」は決め手になるデモではありません。
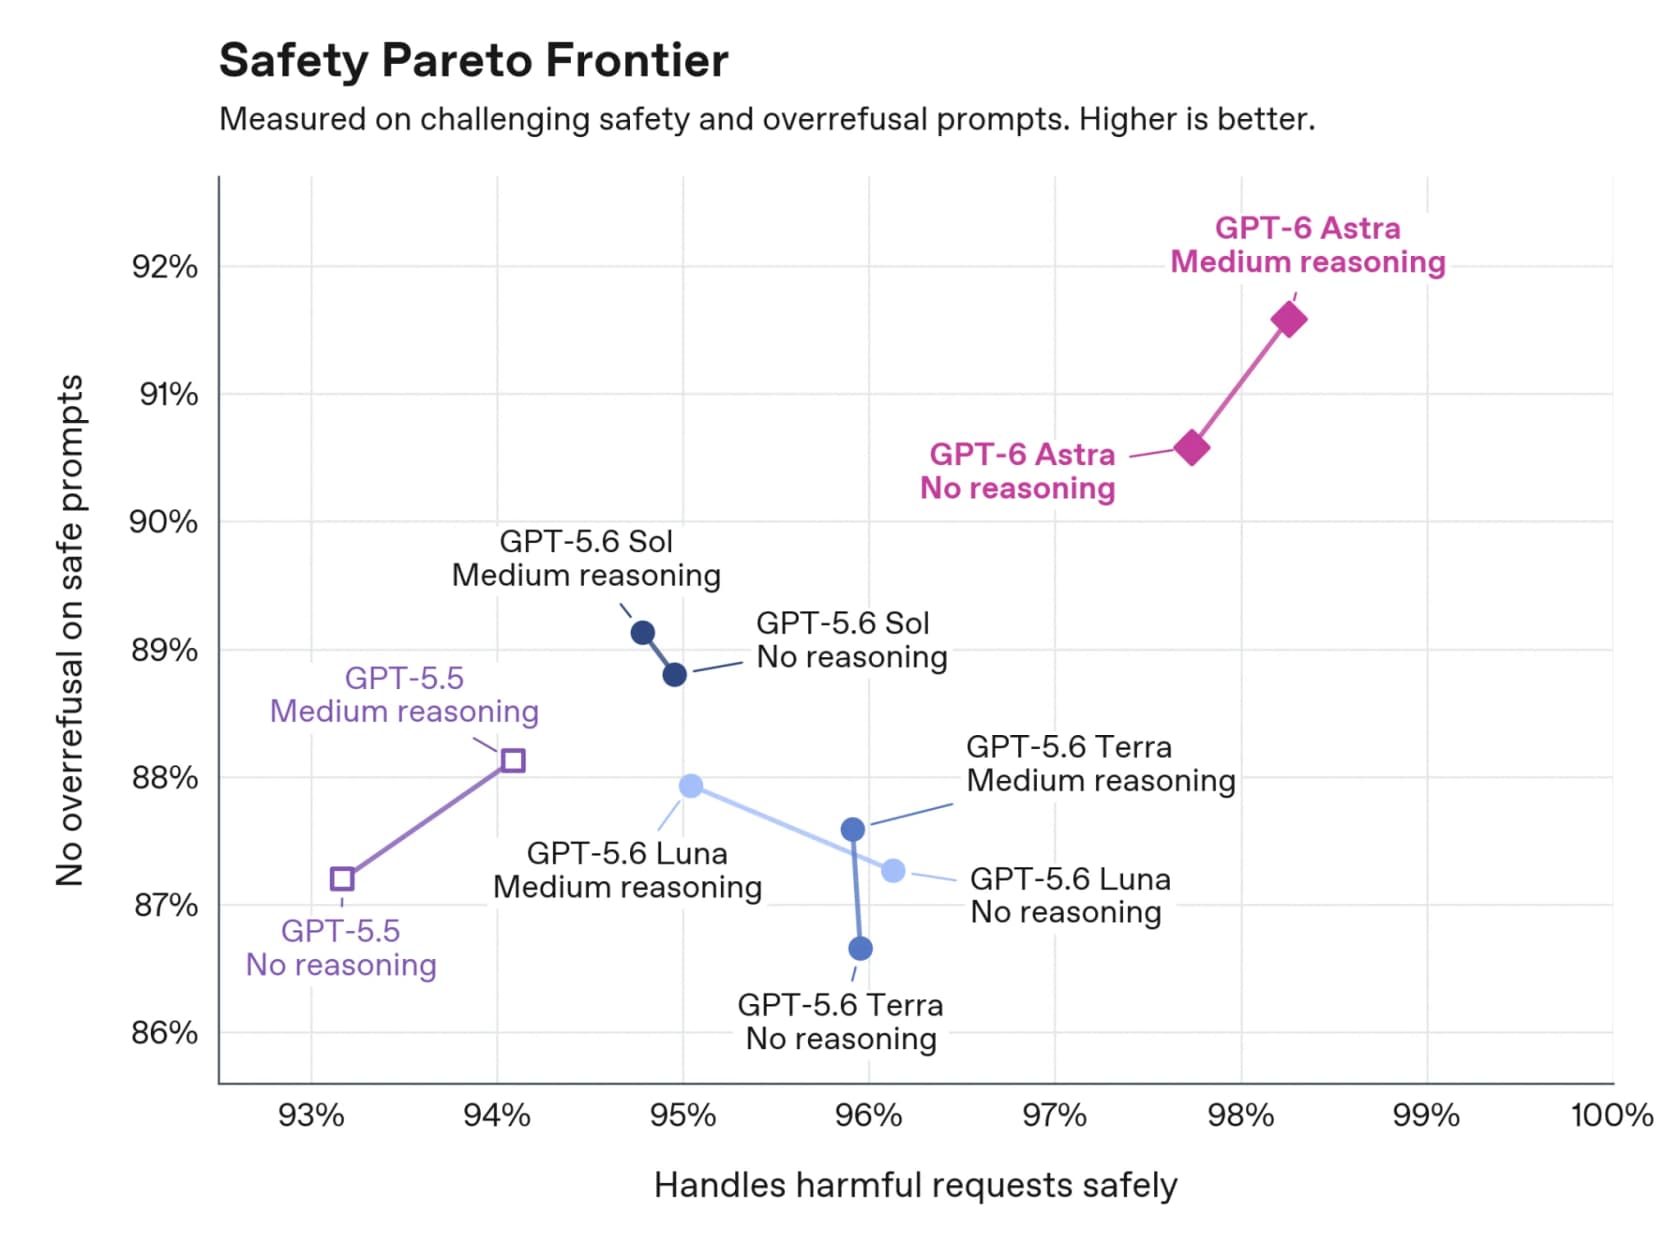
モニタリング可能性は低下しており、OpenAI自身もそう認めています。 これは、公表したこと自体を私が評価している注意点です。OpenAIははっきりと「GPT-6 Astra's monitorability has decreased relative to GPT-5.6 Sol」と述べています。このモデルは自身の思考の連鎖(チェーン・オブ・ソート)をより強くコントロールできるようになっており、敵対的な圧力の下では意図的に性能を落としたり、内部モニターを回避したりすることがあります。それを補うため、OpenAIはツールを使用するすべての推論に対してミスアラインメント監視を追加しましたが、これは正当な作業を遅延・一時停止・停止させることがあります。少なくとも一人の開発者は、すでにそれに遭遇したと考えています。
"Today my codex instance retailed into safeguard panic while working on a test harness for our product. First time it ever happened after many million tokens on this task over several weeks."
公平を期すために言うと、アラインメントに関する話が全て否定的というわけではありません。Hugging Faceの一件を受けて構築されたハニーポット評価では、セーフガードなしのSolが48%の頻度で行き過ぎた行動を取ったのに対し、Astraは0%でした。OpenAIはまた、プロンプトインジェクションに対する耐性も大幅に向上していると報告しています。
本当の見出しは価格である
ここに、実際のチームにとってこの話の大部分を決定づける数字があります。Astraの標準API料金は入力100万トークンあたり10ドル、出力100万トークンあたり50ドルで、これはGPT-5.6 Solの2.5倍であり、Anthropicの Fable 5.1とちょうど同水準です。X上のある実務家はこの戦略的転換を即座に見抜きました。OpenAIは価格での競争をやめ、今やフロンティアにおいてAnthropicと同水準の価格に位置しており、二大ラボの間でコストを比較して選ぶという選択肢がなくなったのです。
| Model | 入力(100万あたり) | 出力(100万あたり) | キャッシュ入力 | vs Astra |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | フラッグシップ |
| gpt-5.6-sol | $4.00 | $20.00 | $0.40 | 2.5倍安い |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | 入力が約5倍安い |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | 入力が約50倍安い |
表示価格には表れない落とし穴がいくつかあります。
- 長いコンテキストは料金が倍になります。 入力トークンが27万2000を超えるプロンプトは、リクエスト全体が2倍/1.5倍の料金で請求されます。これは、コンテキストウィンドウが105万トークンと巨大であるがゆえに重要な点です。
- Fastモードはさらに2倍の料金(20ドル/100ドル)で、EUデータレジデンシーでは利用できません。
- BatchとFlexは半額なので、レイテンシを許容できる用途はそちらで実行すべきです。
エージェント的な作業では、Astraがタスクあたり消費するトークンが少ないため、これらの効率向上がある程度コストを相殺します。しかし、トークン数がSolとほぼ同じになるチャット的な用途では、ほぼ同等のスコアに対して単純に2.5倍支払っていることになります。このトレードオフこそがこのレビュー全体の核心であり、X上のコミュニティの総意は、多くの日常的なタスクにおいて値上げが効率向上のメリットを上回るというものでした。
私の結論:優れたエージェントエンジンであり、割高なチャットボット
すべてを踏まえた上で、私の結論はこうです。
GPT-6 Astraは、実際のソフトウェアを操作するエージェント、長時間にわたるコーディング、あるいはサイバーセキュリティ分野で作業するエージェントにとって、現時点で入手可能な最良のモデルです。それがあなたのユースケースであれば、ステップ数の少なさとコーディングにおける飛躍が高いトークン単価に見合う可能性があり、試してみる価値があります。CognitionのSilas AlbertiとDevinとの統合は、ここで注目すべきシグナルです。
それ以外の用途については、世代交代のバッジをまとったマイナーアップデートに過ぎません。主に推論、チャット、抽出、コンテンツ生成を行っているなら、Solは価格の40%でほぼ同じスコアを提供します(さらにOpenAIのその他のラインナップにはさらに安価なティアもあります)。一方でFable 5.1は独立系の知能指数でAstraを実際に上回っています。「6というより5.7」という声は間違っていません。彼らはただ、二つの物語を持つこのモデルのうち、汎用知能の半分を説明しているにすぎないのです。
バージョン番号はマーケティングです。本当に問われるべきは、あなたの仕事がどちらの物語に属しているかということです。
生のモデルが終わり、チームメイトが始まる場所
もう一つ、はっきりさせておく価値のある視点があります。というのも、これはどのフラッグシップモデルのローンチ直後にもチームが陥りがちな過ちだからです。フロンティアモデルを完成品であるかのように扱ってしまうことです。
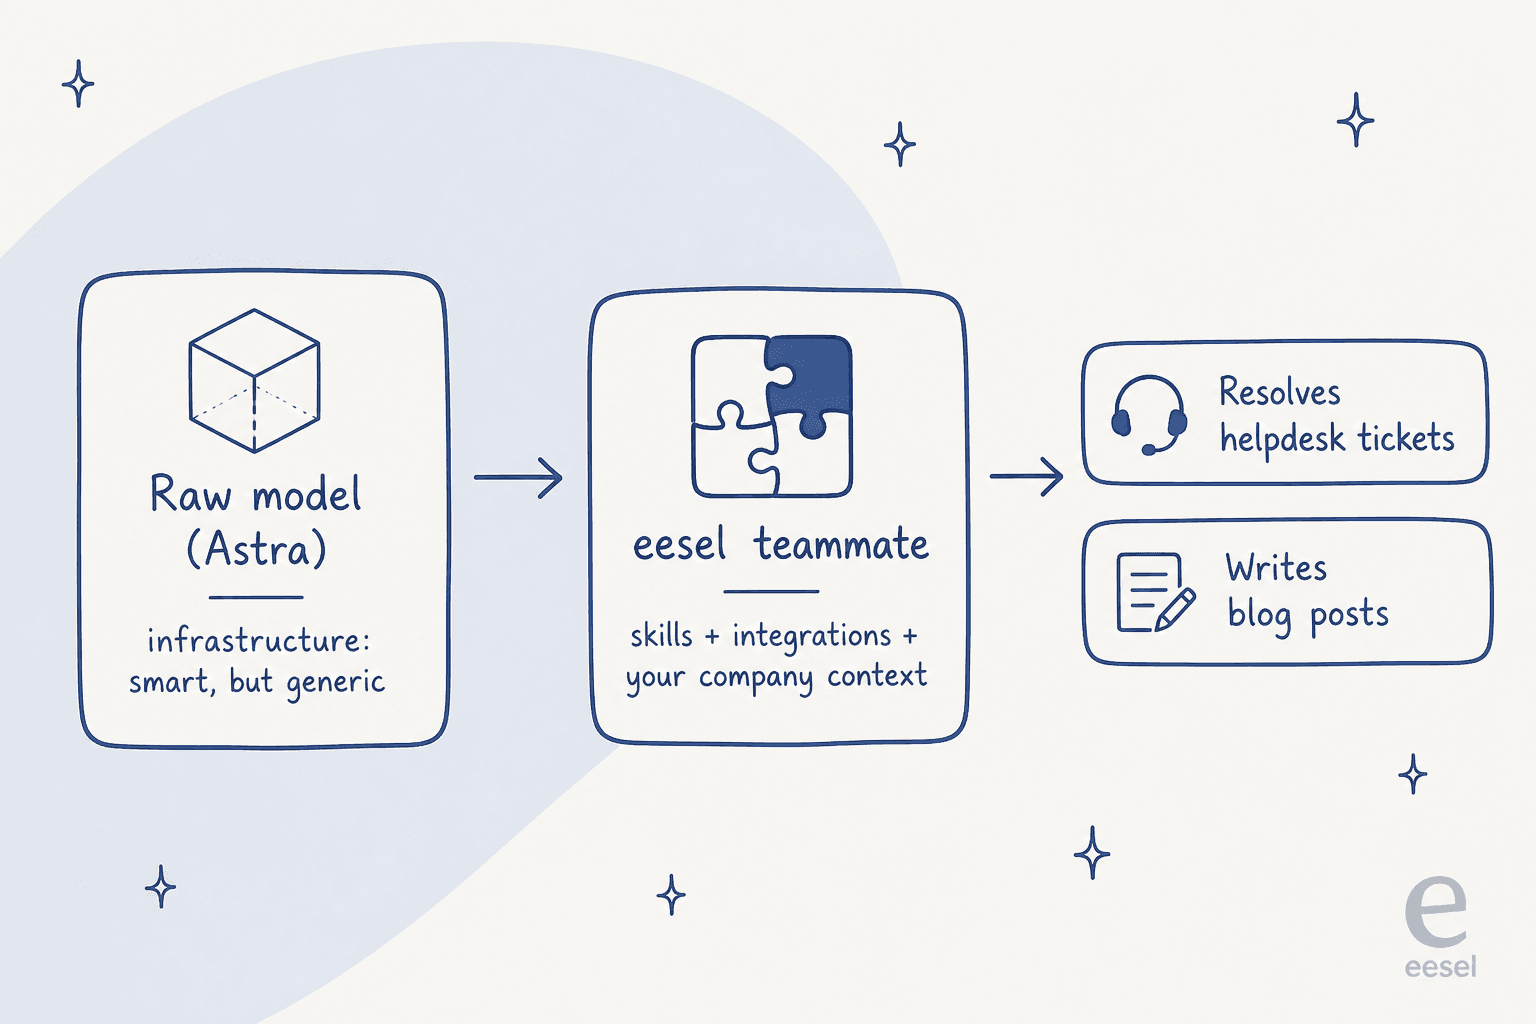
Astraはインフラです。優れた、しかし高価なエンジンではありますが、そのままの状態ではあなたの顧客のことを知らず、あなたのヘルプデスクを見ることもできず、あなたのポリシーに合わせて調整されたガードレールも持たず、放っておけば喜んで2万5000行の回答を組み立ててしまいます。その生の能力を、信頼して任せられる仕事をこなすものへと変えることこそが本当の作業であり、それは膨大な作業です。自社の知識に対するリトリーバル、チームがすでに使っているツールとの連携、実際の履歴に対するテスト、そして台本から外れないための承認フローが必要になります。
そのギャップを埋めるために作られているのがeeselです。私たちの考え方はこうです。モデルはエンジンであり、eeselはあなたが雇う従業員です。新入社員に生のAPIを渡して幸運を祈るだけ、ということはしないはずです。役割、コンテキスト、そしてツールを与えるものです。eeselも同じことを行い、特定の仕事のためのスキル、連携、そして企業のコンテキストを備えた、すぐに働けるAIチームメイトを提供します。
eeselを試す
もしあなたがこのレビューを読みに来たのは、GPT-6 Astraがカスタマーサポートを担えるかどうかを知りたかったからなら、正直な答えは「このモデルはあくまで原材料に過ぎない」ということです。eeselは、その生の能力を、数分でヘルプデスクに接続でき、過去のチケットとナレッジベースで学習し、実際の顧客に応答する前に過去のチケットでシミュレーションできるAIヘルプデスクチームメイトへと変えます。自信ありげに聞こえるボットが静かに間違った回答をしているのを目の当たりにした苦い経験から、私たちはこのシミュレーションの習慣を学びました。だからこそ、それは後付けではなく最初から組み込まれています。
そして、Astraが本質的にエージェントとAPIの物語であるのと同様に、eeselもそうであることは知っておく価値があります。ダッシュボードに加えて、完全なeesel CLIとMCPサーバーが用意されており、人がターミナルから同じチームメイトを操作したり、スクリプトがそれを自動化したり、Claude CodeやCodexのようなコーディングエージェントがプログラムから操作したりできます。無料で試すことができ、何かにコミットする前に、シミュレーションの中であなた自身のチケットを解決していく様子を見ることができます。
よくある質問
GPT-6 AstraはGPT-5.6 Solと比べて価値があるか?
GPT-6 Astraの料金はいくらか?
GPT-6 Astraは本当にAGIなのか?
GPT-6 Astraが最も得意なことは何か?
カスタマーサポートにGPT-6 Astraを使うべきか?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.