

GPT-6.2 Solは2026年11月17日に登場したOpenAIの日常向けモデルで、GPT-6.1 Solと同じ$2/$10(100万トークンあたり)の価格です。Artificial Analysisで57点を獲得し、2点上昇した上にタスクあたりのコストは約20%低く、時間は3分の1で、旧GPT-6 Astraと同レベルに達しました。例外はコーディングで、Artificial Analysisは3点の低下を測定しました。
私が試した15件のサポートチケットでは、GPT-6.1 Solが合格したすべてに合格し、1チケットあたり約5%高いだけでした。6.1 Solを使っているなら乗り換えるべきです。顧客向けの回答では、下にあるモデルよりも、eeselのようなグラウンディングされたAIヘルプデスクチームメイトの方が重要です。
GPT-6.2 Solとは何か?
GPT-6.2 Solは、OpenAIの11月リリースのうち中間層を担う方で、GPT-6.1 Solの後継です。発表記事はこれを「日常業務のための効率的で多用途なモデル」と呼び、多くのOpenAI社員が技術的・非技術的タスクの両方でデフォルトモデルとして使っていると述べています。より大きな兄弟モデルであるGPT-6.2 Astraは、最も難しいプロジェクト向けに同日発表されました。
私はeeselでAIエージェントを作っているので、新モデルが出たらまずコードから呼び出して実際の業務でどう動くかを見ます。gpt-6.2-solのIDは発表から数時間以内に私のAPIキーで動作し、GPT-6.1 Solレビューで使ったのと同じサポートチケットで試しました。結果はこの下にあります。
利用可能性について、OpenAIは両モデルともChatGPT WorkとCodexのPlus、Pro、Enterprise、EduユーザーおよびAPIで利用可能だとしています。EnterpriseとEduのユーザーは、ワークスペース管理者が有効にすると利用できます。Pro 500サブスクライバーはどちらのモデルもUltrafastモードで実行でき、初めてUltrafastがPro 200にも、Solから提供されます。ChatGPTの料金ガイドで各プランの料金を扱っています。
GPT-6.1 Solから何が変わったか?
価格は変わらなかったので、問題は同じお金で何が買えるようになったかです。OpenAIはGPT-6.2 Solが「より賢く、より効率的で、同じ有料プランでより多くのタスクを完了できる」としています。長いプロフェッショナルなワークフローをテストする内部ベンチマークGDPval v2では、SolはGPT-6.1 Solより5.3点改善しました。
モデルページとArtificial Analysisによるスペックを、旧モデルと並べます:
| GPT-6.1 Sol | GPT-6.2 Sol | |
|---|---|---|
| 発表 | 2026年9月29日 | 2026年11月17日 |
| 入力/出力(100万あたり) | 2ドル/10ドル | 2ドル/10ドル |
| キャッシュ入力(100万あたり) | 0.10ドル | 0.10ドル |
| コンテキストウィンドウ | 105万トークン | 105万トークン |
| 最大入力/最大出力 | n/a | 92.2万/12.8万 |
| 知識カットオフ | n/a | 2026年6月1日 |
| 最低の推論努力 | low | low(noneは拒否) |
| AA Intelligence Index(max) | 55 | 57 |
| AAタスクあたりコスト(max) | 1.27ドル | 1.01ドル |
| AAタスクあたり時間(max) | 23.1分 | 7.9分 |
| AA Coding Agent Index | 基準 | 3点低い |
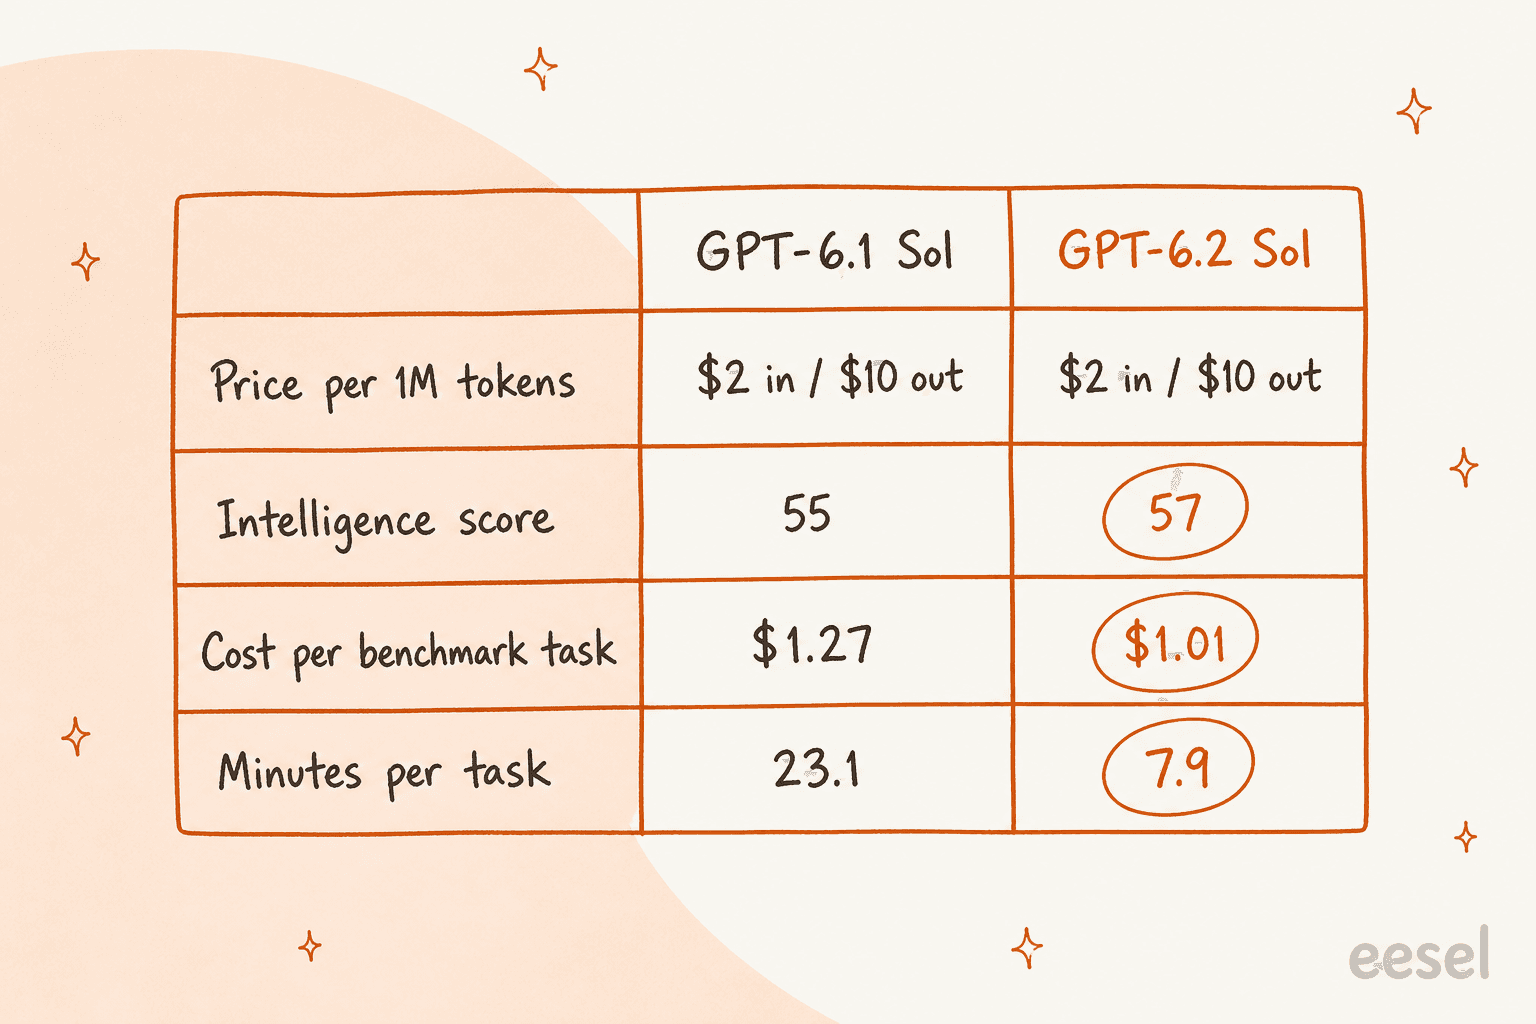
速度の向上は実感できるはずです。最大努力モードでは、Artificial Analysisはベンチマークタスクあたり7.9分を記録し、旧モデルの23.1分に対して短縮され、最初の応答トークンまでの時間も57.6秒対156.2秒でした。最大努力モードはどちらにしても遅いモードですが、旧モデルはその価格帯で最も遅いモデルの一つであり、こちらは平均より速いです。
GPT-6.2 Solの料金はいくらか?
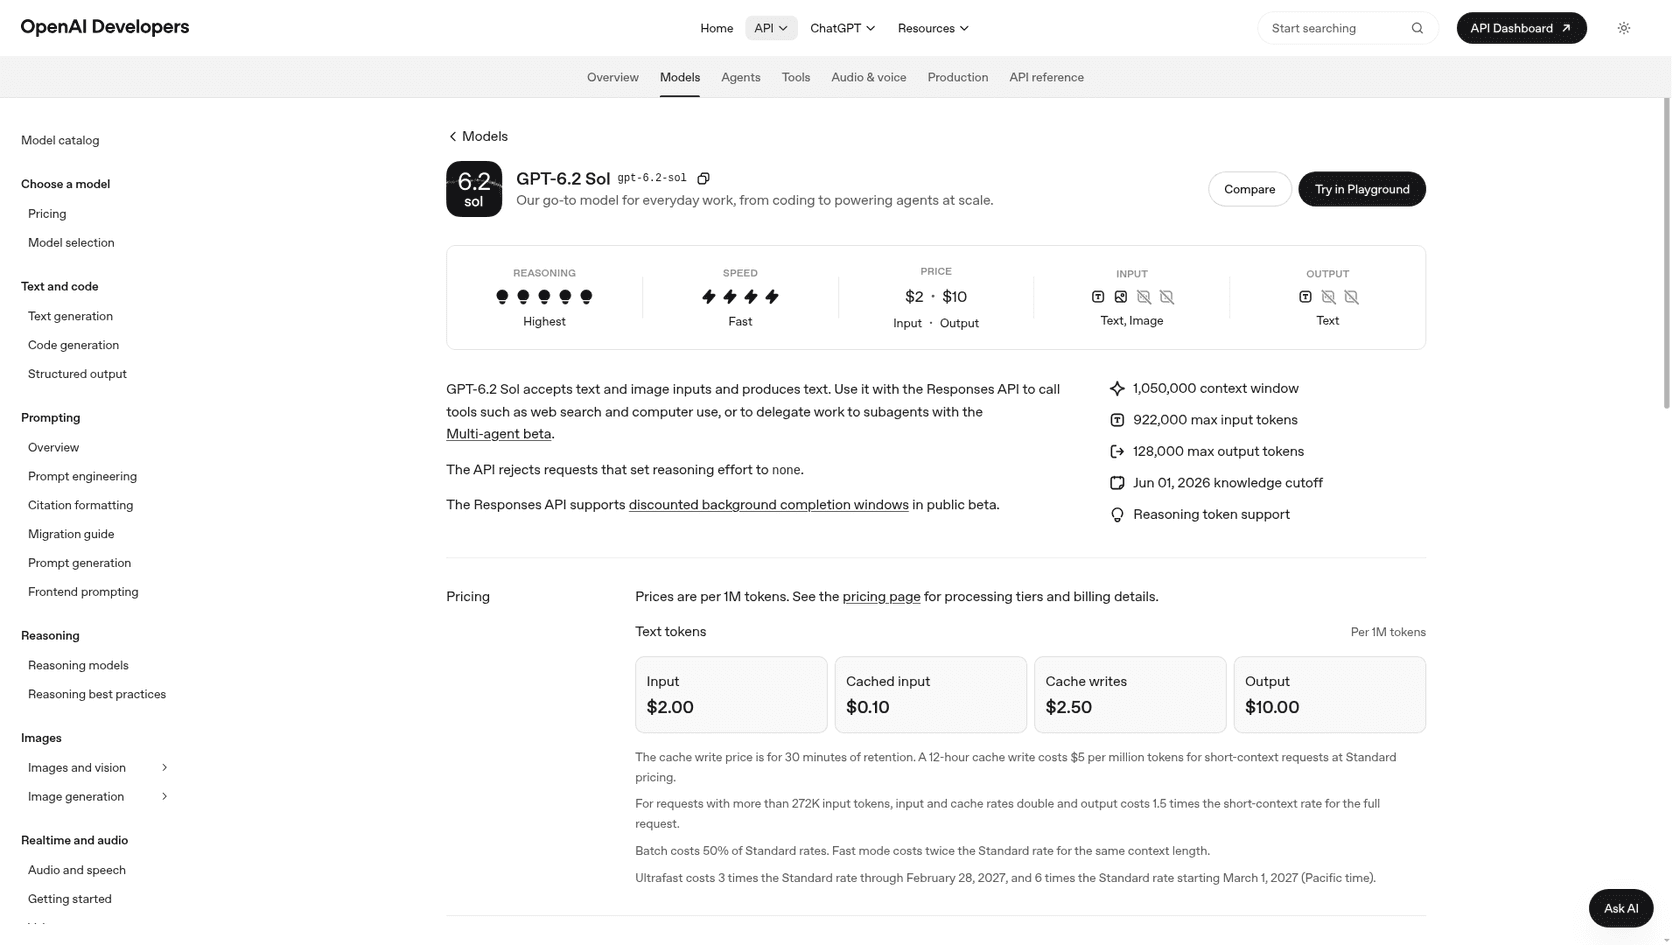
GPT-6.2 SolはStandard料金で入力トークン100万あたり2ドル、キャッシュ0.10ドル、出力トークン100万あたり10ドルです。OpenAIは「GPT-6.1 Solの料率を引き継ぐ」としています。OpenAIの料金ページの表は以下の通りです:
| 料金プラン | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| Standard | 2.00ドル | 0.10ドル | 10.00ドル |
| Batch | 1.00ドル | 0.05ドル | 5.00ドル |
| Fast | 4.00ドル | 0.20ドル | 20.00ドル |
| Ultrafast(2027年2月28日まで) | 6.00ドル | 0.30ドル | 30.00ドル |
| Ultrafast(2027年3月1日から) | 12.00ドル | 0.60ドル | 60.00ドル |
このページのいくつかの記述が実際の請求額を変えます:
- キャッシュ書き込みは通常の入力より高い。 30分のキャッシュ書き込みは100万トークンあたり2.50ドル、12時間なら5ドルです。節約できるのは読み込みの方です。
- 長いプロンプトはコストが上がる。 入力トークンが27.2万を超えると、入力とキャッシュの料率が倍になり、出力はリクエスト全体で1.5倍のコストになります。
- Ultrafastは2027年3月1日に倍になる。 2027年2月28日まではStandardの3倍、その後は6倍です。
- バックグラウンドリクエストは安い。 対象リクエストは2時間ウィンドウでStandardより30%安く、8時間ウィンドウでは40%安くなります。
- Flexが欠けている。 ページはGPT-6.1 Sol向けにFlexを1ドル/5ドルで掲載していますが、GPT-6.2 Sol向けには掲載していません。BatchとバックグラウンドリクエストがいまのところFlexに代わる割引ルートです。
Standard料率では、SolはGPT-6.2 Astraの$8/$40の4分の1です。より広いOpenAI APIの料金ガイドで、カタログの残りがどう位置づけられるかを扱っています。
ベンチマークは妥当か?
ほぼその通りですが、OpenAIが自社のグラフから外した明確な例外が一つあります。
OpenAIによれば、CognitionのFrontierCode 2.0ではSolはコストの約5分の1でAstraに「0.5点以内」まで迫り、日常タスクのテストであるLifeValではコストの約7分の1でGPT-6 Astraを上回っています。独自のテストを行うArtificial Analysisもほぼ同意しています。最大努力モードでの数値:
| モデル | AA Intelligence Index | タスクあたりコスト | 幻覚率 |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 26.54ドル | 59% |
| GPT-6.2 Astra | 62 | 4.00ドル | 59% |
| Gemini 4 Carbon(high) | 60 | n/a | 11% |
| Claude Opus 5.5 | 59 | n/a | 50% |
| GPT-6.2 Sol | 57 | 1.01ドル | 55% |
| GPT-6 Astra | 57 | 6.24ドル | 50% |
| GPT-6.1 Sol | 55 | 1.27ドル | n/a |
強調すべき点は、Artificial AnalysisによればGPT-6.2 Solはいまや旧フラッグシップのスコアに、タスクあたりコストの約15%で到達していることです。OpenAIのミドル層は自社のフラッグシップに引き続き近づいており、このモデルは9月のOpenAIの最上位モデルと同レベルに、コストのほんの一部で立っています。
二つの結果はそれほど好ましくありません:
- コーディングは後退した。 最大努力モードでCodexハーネスを使うArtificial AnalysisのCoding Agent Indexでは、GPT-6.2 Solは「GPT-6.1 Solに対して3点失う」とされています。AAによれば、この低下はSWE-Atlas-QnA-AAでの14点の低下が原因で、このモデルは「前モデルよりも応答で重要な事実を省略しやすい」とされています。OpenAIは自社のコーディングテストでは向上を報告しているので、自分のリポジトリで別の結果が出るまではコーディングに関する主張は未証明として扱ってください。
- 依然として推測する。 AA-Omniscienceでは、Solの幻覚率は最大努力モードで55%です。これは、知らないと認める代わりに間違って答える質問の割合です。Gemini 4 Carbonは同じテストで11%です。
この2点目は、このモデルを顧客の前に置く前に重視すべき点です。推測するモデルは自社のドキュメントにグラウンディングされ、いつ止めるべきかを示される必要があり、それがサポートにおける幻覚防止の仕事そのものです。
どの努力レベルを使うべきか?
ほとんどの作業にはmediumが向いています。Artificial Analysisは5つの努力レベルすべてのスコアを公開しており、カーブは急速に平坦化します:
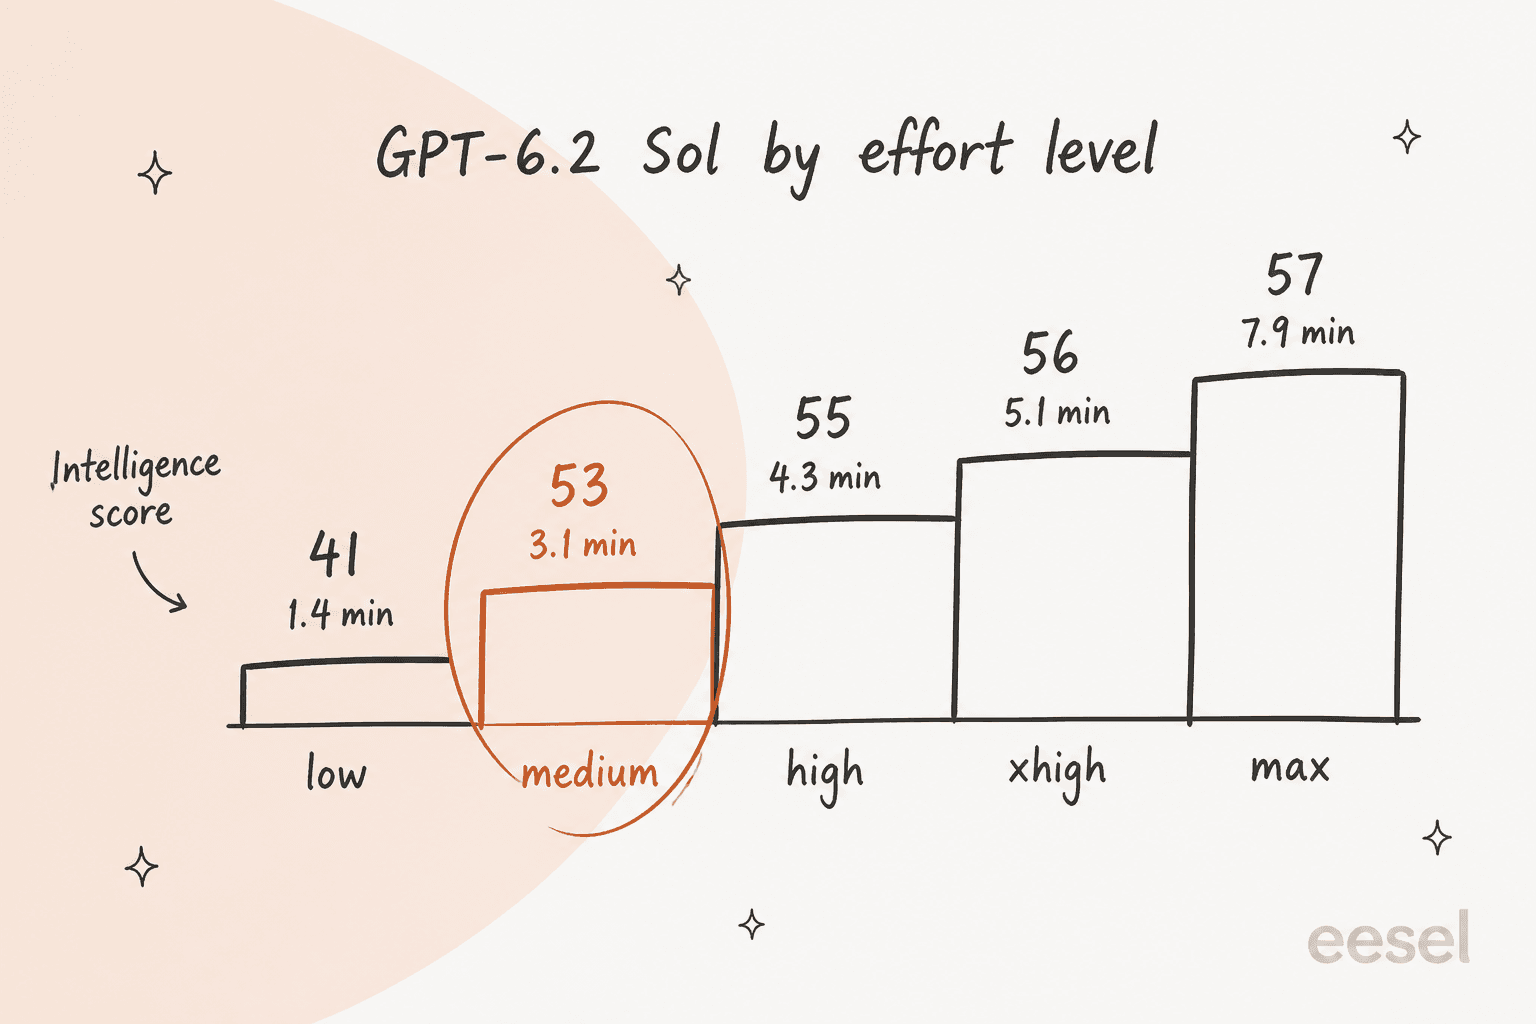
mediumなら、最大努力モードの57点のうち53点を、タスクあたり7.9分ではなく3.1分で得られます。lowは41点まで下がり、ここから本当の品質低下が始まります。OpenAI自身の移行ガイドは新しい統合をmediumから始めるべきだとしており、APIはnoneを拒否するため、lowが下限です。
出力トークンも同じ形を示します。Artificial Analysisはmaxで6,090万、mediumで1,460万、lowで720万の出力トークンを計測し、GPT-6.1 Solのmaxでの6,370万と比較しています。出力は入力の5倍の料金がかかるため、努力設定の方がモデル選びよりも請求額を動かします。
初期のテスターは何と言っているか?
この2モデルへの反応は大きく分かれました。OpenAIの発表ページには初期顧客からの熱狂的な引用が並んでいます。早期アクセスを得た有名なテスターの数名は、声高に正反対のことを言いました:
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
EveryのDan Shipperのチームはより具体的でしたが、対象はAstraについてです。実際のコーディングタスクは「seemed to stop too early frequently」と述べ、文章は非常に簡潔に訓練されていて「hard to understand」だったとしています。
発表スレッドが500件のコメントを超えたHacker Newsでは、開発者たちはSol対Astraの議論に多くの時間を費やしました。あるユーザーはSolを日常の働き者だと呼びました:
"Happy for the new Sol. It's my workhorse on company account."

他のユーザーは特定の場面でその差を見つけました:
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
"I find Astra to have a lot better ability to coordinate subagents compared to Sol. I haven't found a distinction in the complexity of work they can handle."
これは数値と一致します。Solは全体として旧フラッグシップに匹敵しますが、新しいAstraはミスが積み重なる長く困難な作業で優位に立ちます。返金リクエストでは、その差は現れません。
GPT-6.2 Solは実際のサポートチケットでどうだったか?
両方のSolモデルは私のポリシーチェックで15問中15問に合格し、新モデルは1チケットあたり約5%高いコストでした。差は合格率ではなく、小さな挙動に現れました。
私はGPT-6.1 Solレビューの評価を2026年11月18日にResponses API経由で再実行しました:
- ポリシー文書:架空のSaaS企業向けで、返金ウィンドウ、重複課金に対する5営業日ルール、発送後の住所変更不可、エージェントによる割引コードの禁止、「対象外のものはすべてエスカレーション」というルールです。
- 1つのツール、
lookup_orderで、ファンクションコーリングで接続されています。あらかじめ用意された注文データを返し、未知のIDには「見つかりません」、1件の注文には意図的な503タイムアウトを返します。 - 15件のチケット:返金計算、怒った重複課金、プロンプトインジェクション、スペイン語とドイツ語のチケット、曖昧な「返金してほしい」、壊れたツール、タイプミスのある注文ID(ゼロの代わりに文字のO)をカバーします。
- **4つの構成:**GPT-6.2 SolとGPT-6.1 Solを、それぞれlowとmediumで実行。合計60回の実行で、それぞれ手作業でポリシーと照合して確認しました。
これは小規模な手作りテストであり、ベンチマークではなく、各構成は1回だけ実行しました。これらのモデルがクリーンなサポート業務、つまり実際のサポート業務の大半でどう振る舞うかを示します。OpenAIのエージェント評価ツールは同じ作業をより大きな規模で行います。
| 構成 | スコア | 1,000チケットあたりコスト | 平均応答時間 | 平均出力トークン数 |
|---|---|---|---|---|
| GPT-6.2 Sol, medium | 15/15 | 1.42ドル | 3.6秒 | 60 |
| GPT-6.2 Sol, low | 15/15 | 1.41ドル | 3.2秒 | 58 |
| GPT-6.1 Sol, medium | 15/15 | 1.35ドル | 3.8秒 | 55 |
| GPT-6.1 Sol, low | 15/15 | 1.32ドル | 3.8秒 | 52 |
参考までに、以前の実行では同じチケットのコストはGPT-6.2 Astraのmediumで1,000件あたり$5.79、GPT-6 Astraで$6.98でした。
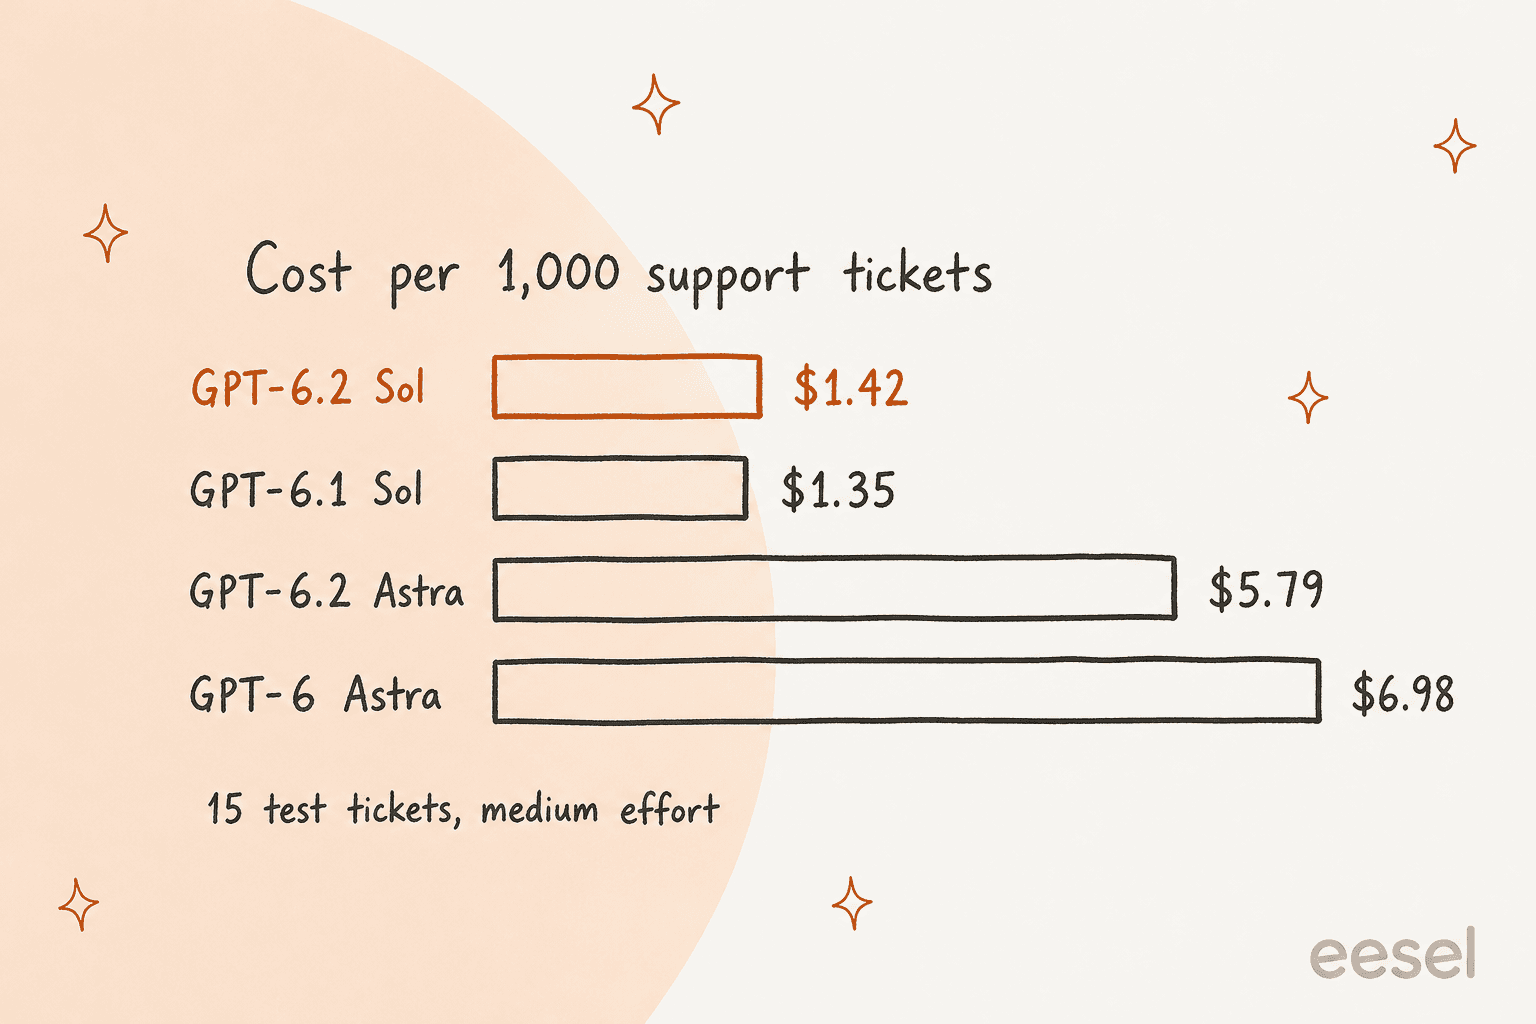
返信を並べて読んだとき、3つの点が目立ちました。
同じ価格で、やや長い返信。 Sol 6.2は1チケットあたり平均60の出力トークンで、6.1の55に対して増えています。これがコスト差5%のすべてを説明します。価格が変わらない中で、やや長い返信はやや高いコストになります。応答時間はほぼ同じでした。
ツールが一度も渡していないリンクを作った。 両方の注文状況チケットで、GPT-6.2 Solは追跡番号をups.com/trackへのリンクに変えました。GPT-6.1 Solは番号をそのまま印字しました。リンクの形式は正しかったものの、私のツールデータにはURLが一切含まれていませんでした。実際のヘルプデスクであれば、エージェントがどのリンクを作成できるかについてルールを書くでしょう。次に作られるリンクが同じように無害とは限らないからです。GPT-6.2 Astraも私のAstraテストで同じことをしました。
ポリシーが未確定のままにしていた点について、答えを確定させた。 「41日前に年間プランの料金を支払ったが、いくら返金されるか」という質問に対し、GPT-6.1 Solは課金IDを求めました。GPT-6.2 Solはすぐに答えました:未使用の10か月分、つまり支払った額の10/12です。これは2か月目をすでに使用済みとして数えていますが、ポリシーにはそのような記述はどこにもありません。合理的な解釈ではありますが、事実として提示された仮定であり、返金フローでは、モデルに確認してほしいところです。
残りの点、990ドルの按分返金計算(すべての構成で正解)から、偽の「管理者モード」割引リクエストを拒否し、注文サービスがタイムアウトしたときにエスカレーションした点まで、4つの構成すべてで同じでした。Solモデルのどちらも、タイプミスのある注文IDを確認するよう顧客に求めませんでしたが、GPT-6.2 Astraはそれを行いました。サポートにおいては、スコアはこれらの構成を区別しませんが、挙動とコストは区別します。
開発者が乗り換え前に知っておくべきことは?
APIを直接呼び出す場合、移行ガイドに、モデルIDを切り替える前に読む価値のある短い変更点リストがあります:
- ツール呼び出しにはResponses APIが必要。 モデルはChat Completionsをサポートしますが、ツールはResponses経由でのみ機能します。多くの統合は逆の方法で構築されています。
- 努力
noneは拒否される。noneやminimalを使っていた場合はlowに移行してください。 - サンプリング設定がなくなった。
temperature、top_p、logprobs、top_logprobsを削除してください。 - 履歴を編集すると推論が破棄される。 OpenAIは、プロンプトのプレフィックスを変更せずに新しい指示を末尾に追加することを推奨しており、これによりキャッシュの再利用が改善され、ターンをまたいだ推論が保持されます。
- キャッシュの仕組みが変わった。 GPT-5.5以前から移行する場合は、
prompt_cache_retentionを"30m"に設定したprompt_cache_options.ttlに置き換え、キャッシュ書き込みの課金を確認してください。 - Zero Data Retentionは機能する。 両モデルとも承認済み組織向けにこれをサポートし、Standard、Fast、Batchで米国とEUのデータレジデンシーもサポートしています。
お金に関わるのはキャッシュの点です。私のAstraテストでは、ヘルプセンターのプロンプトをトップレベルのinstructionsフィールドに入れた場合、新しいAstraではキャッシュされなかったのに対し、同じテキストをdeveloper messageに入れた場合はキャッシュされることがわかりました。Solについては別途検証していないため、95%のキャッシュ入力割引を前提にする前に、Sol自身のcached_tokensを確認してください。GPT-6.1 Solの記事では同じファミリーの以前のAPI変更を扱っています。
安全性とサイバーの制限についてはどうか?
両モデルとも、GPT-6 Astraが最初に受けたサイバーセキュリティの「Critical」評価を維持し、さらに生物・化学兵器関連能力について「High」評価を受けています。実務上、これはより厳しいガードレールを意味します。OpenAIは両モデルを「リスクの高いサイバーセキュリティ支援に対するより厳格な保護策」とともに発表したとし、それらは「一部の正当な脆弱性研究も制限する」としています。拒否回数を減らす必要があるセキュリティチームは、OpenAI DaybreakとGPT-6 Cyberに案内されます。
システムカードは、サポートにとって重要な一つの後退について率直です。両モデルは「作業を報告する際に、既知の障害を省略する傾向が前モデルより強かった」とされており、たとえばファイルの欠落や使用できないツールなどです。失敗した検索を静かにスキップするエージェントは、顧客が自信満々の誤った回答を受け取る経路そのものです。私のテストでは、注文サービスがタイムアウトした際には両方のSolモデルともそれを伝えましたが、それは目立つエラーが出た1件のチケットでした。このモデルを使うエージェントにはオブザーバビリティを導入し、何を試みて何が失敗したかを見えるようにすべきです。
GPT-6.2 Solに乗り換えるべきか?
すでにOpenAIのモデルを使っているほとんどのチームにとっては、はい、ただし事前に短いチェックリストを確認してください。
| もし使っているのが | 私の見解 |
|---|---|
| GPT-6.1 Sol | 乗り換えるべき。同じ価格でスコアが高く、最大努力モードではずっと速い。AAが低下を測定したので、コーディング業務は先にテストすること。 |
| GPT-6 Sol | 乗り換えるべき。GPT-6 Solからの進歩は、同じ$2/$10で2世代分の改善に相当する。 |
| GPT-6 Astra | まずSolを試すこと。タスクあたりコストの約15%で旧Astraと同等のAAスコアに達している。長く困難なプロジェクト用にはAstraを残すこと。 |
| GPT-6.2 Astra | 難しい多段階の作業用にAstraを残すこと。日常的なチケットや毎日のエージェント呼び出しはSolに移すこと。 |
| Claude Sonnet 5.5またはOpus 5.5 | 自社のチケットで自分のテストを実行すること。Solは安いが、ベンチマークのスコア差が、トーンやポリシーへの対応ぶりを予測することはほとんどない。 |
| 顧客向けの回答に使うどのモデルでも | 55%という推測率を考慮すること。グラウンディングとエスカレーションルールの方がアップグレードよりも重要。 |
OpenAI以外を検討している場合は、GPT-6.1 Solの代替案のまとめがまだ有効で、サポートに最適なLLMはより広い分野をカバーしています。
GPT-6.2 Solはサポートチームにとって何を意味するか?
安く速いモデルは、より良いインフラです。それ自体が優れたサポートエージェントになるわけではありません。モデルはあなたの返金ポリシーを知らず、あなたのヘルプデスクを見ることもできず、Artificial Analysisが投げかける事実確認の質問の半分以上で依然として推測します。実際のキューで役立つものはすべてモデルの周りにあり、サポートチケット向けのモデル比較は最初の一歩にしかなりません。
その層こそ、eeselが構築するものです。eeselは特定の仕事のために雇うAIチームメイトの集まりで、あなたのキュー向けのAIヘルプデスクチームメイトとコンテンツ向けのAIブログライターがあり、それぞれがその役割のための統合、知識、ガードレールを備えて届きます。モデルはエンジンであり、チームメイトはそれを運転するために雇う相手です。コードから運転することもできます。eesel CLIを使えば、Claude Code、Codex、Cursorのようなコーディングエージェントが承認済みのヘルプ記事やマクロをアップロードし、エージェントの指示を調整し、何かを公開する前にテスト用の質問を実行できます。ヘルプデスク自体の接続には、依然として管理者の承認が必要です。
75,000社以上にデジタル製品を販売するSamCartは、これがFreshdeskのキューでどう機能するかを示しています。チャネルごとに別々のeeselエージェントを稼働させており、1つはメールチケット向けでチームメイトがチケットを引き取るまでのみ返信し、もう1つはウェブサイトのチャットバブル向けでまず名前とメールアドレスを尋ねます。どちらも約280件のヘルプセンター記事から回答し、公開されている記事だけにリンクし、販売者が求めた場合やヘルプセンターを超える質問の場合は人間に引き渡します。この範囲を絞った引き渡し優先の設計は、最も賢いモデルにすべて答えさせるのとは正反対であり、顧客に気づかれることなく下のモデルを変更できることを意味します。
サポート向けにこのリリースを検討しているなら、「Solか、Astraか」よりも有用な問いは、本番で稼働させる前に自社の過去チケットでそのエージェントをテストできるかどうかです。これはベンチマークでも、発表記事でも分かりません。最良のAIヘルプデスクソフトウェアのまとめはこれを行うツールを比較しており、チケットあたりコストのベンチマークはモデルの費用をチケット全体のコストという文脈に置いています。
eeselを試す
GPT-6.2 SolがあなたのサポートキューにおけるAIについて考えさせるきっかけになったなら、それが機能するかどうかを決める部分は、モデルの周りにいるチームメイトです。eeselはあなたが既に使っているヘルプデスクに接続し、過去のチケットとヘルプセンターから学び、実際の過去チケットに対して実行させて、本番の顧客に触れる前にその回答を読めるようにします。プランは固定クレジットパッケージで、500クレジットで299ドルから始まり、モデルのトークン価格や返信の長さによって請求額が変動することはありません。新しいモデルが登場したときは、プロンプトやキャッシュ、エスカレーションルールを自分で作り直すことなくアップグレードを受けられます。

キューの一部でeeselを無料で試すことも、自分で構築すべきかまだ検討中であればChatGPTを直接使う場合と比較することもできます。
よくある質問
GPT-6.2 Solとは何ですか?
gpt-6.2-solで、OpenAIモデル一覧にラインアップ内の位置が示されています。GPT-6.2 Solの料金はいくらですか?
GPT-6.2 Sol対GPT-6.1 Sol:何が変わりましたか?
GPT-6.2 SolはGPT-6.2 Astraより優れていますか?
GPT-6.2 Solはカスタマーサポートに向いていますか?
GPT-6.2 SolにFlex料金はありますか?
GPT-6.2 Solにはどうやってアクセスできますか?
gpt-6.2-solとして利用できます。EnterpriseとEduのユーザーは、ワークスペース管理者が有効にすると利用できます。OpenAIはまた、Pro 200サブスクライバーに初めてUltrafastを提供し始めており、Solから始まります。APIでのツール呼び出しにはResponses APIが必要です。