

MAI Code 2は、GitHub Copilot内のMicrosoftの新しいコーディングモデルで、2027年5月17日までは100万トークンあたり$0.50/$2.50です。Microsoft自身のテストではGPT-6.1 Solのスコアの98%をタスクあたりコストの40%で達成していますが、このコストはプロモーション価格を使った数字です。定価の$1/$5では、同じタスクのコストはSolの約81%になります。
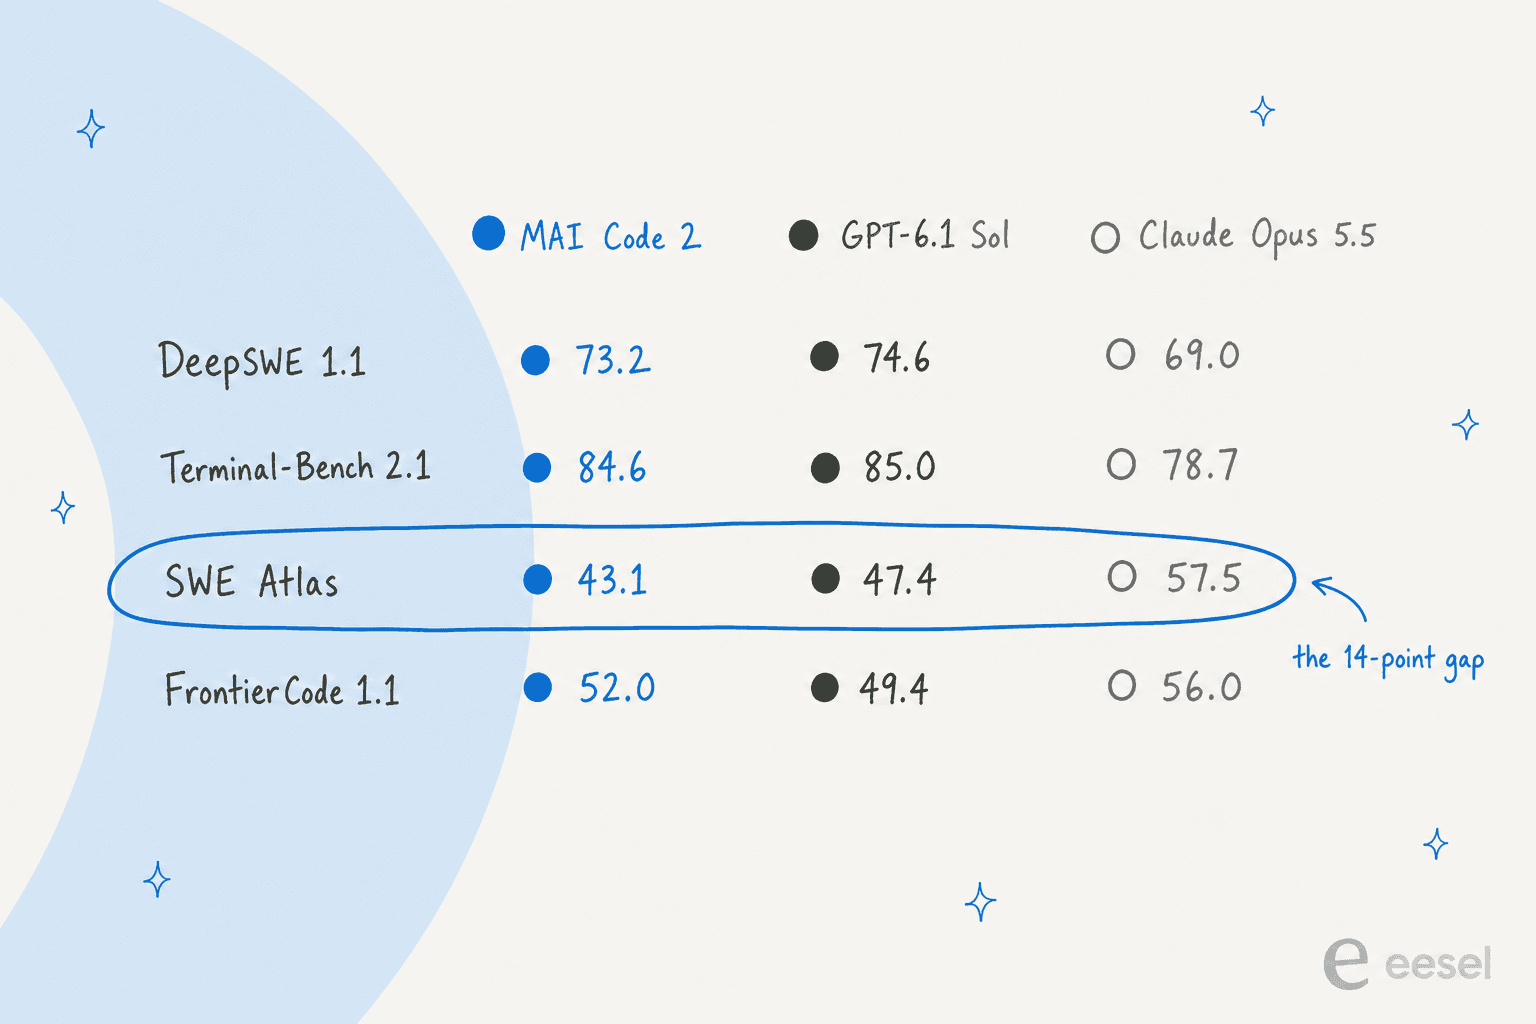
つまり、今日のCopilotでの日常的な複数ファイル作業には良い既定の選択肢です。長く難しいリポジトリ作業にはより大きなモデルを残しておいてください。SWE AtlasではClaude Opus 5.5に14ポイント劣っています。
MAI Code 2とは何ですか?
MAI Code 2は、Microsoft AIがゼロからトレーニングし、2026年11月17日のIgniteで発表したコーディングモデルです。ローンチ記事は「日常的な企業向けコーディングタスク」向けと位置づけ、「本番へのコード展開、深いデバッグ、複数ファイルの実装、リポジトリ全体の推論、UIに優れている」としています。より小型の兄弟モデルMAI Code 2 Flashも同日に、日常的で大量の編集向けとして登場しました。
これはMicrosoft独自のコーディングモデル系列の第2世代です。MAI-Code-1-Flashは6月にGitHub Copilotに登場し、MAI Code 1.1 Flashが8月に続きました。今回の進化はサイズと範囲です。モデルカードによると、新しい2つのモデルは両方とも1,050,000トークンのコンテキストウィンドウ(入力922,000、出力128,000)と、低から最大までの5段階の推論努力レベルを備えています。
私はeeselのプロダクトのエンジニアで、日々の大半はインテグレーションとAPIの作業なので、サイドパネルにAIモデルを置いたエディタの中で生活しています。また、実際のサポートキューで動くeeselのAIエージェントの開発にも関わっており、eesel CLIを使えば、同じエディタ内のコーディングエージェントが承認済みのヘルプ記事をeeselエージェントにアップロードし、指示を調整し、何かを本番に出す前にテストの質問を実行できます。だから新しいコーディングモデルが出るたびに、気になる質問はシンプルです。通常のタスクで何がかかり、どこで破綻するのか。
MAI Code 2とMAI Code 2 Flashの違いは何ですか?
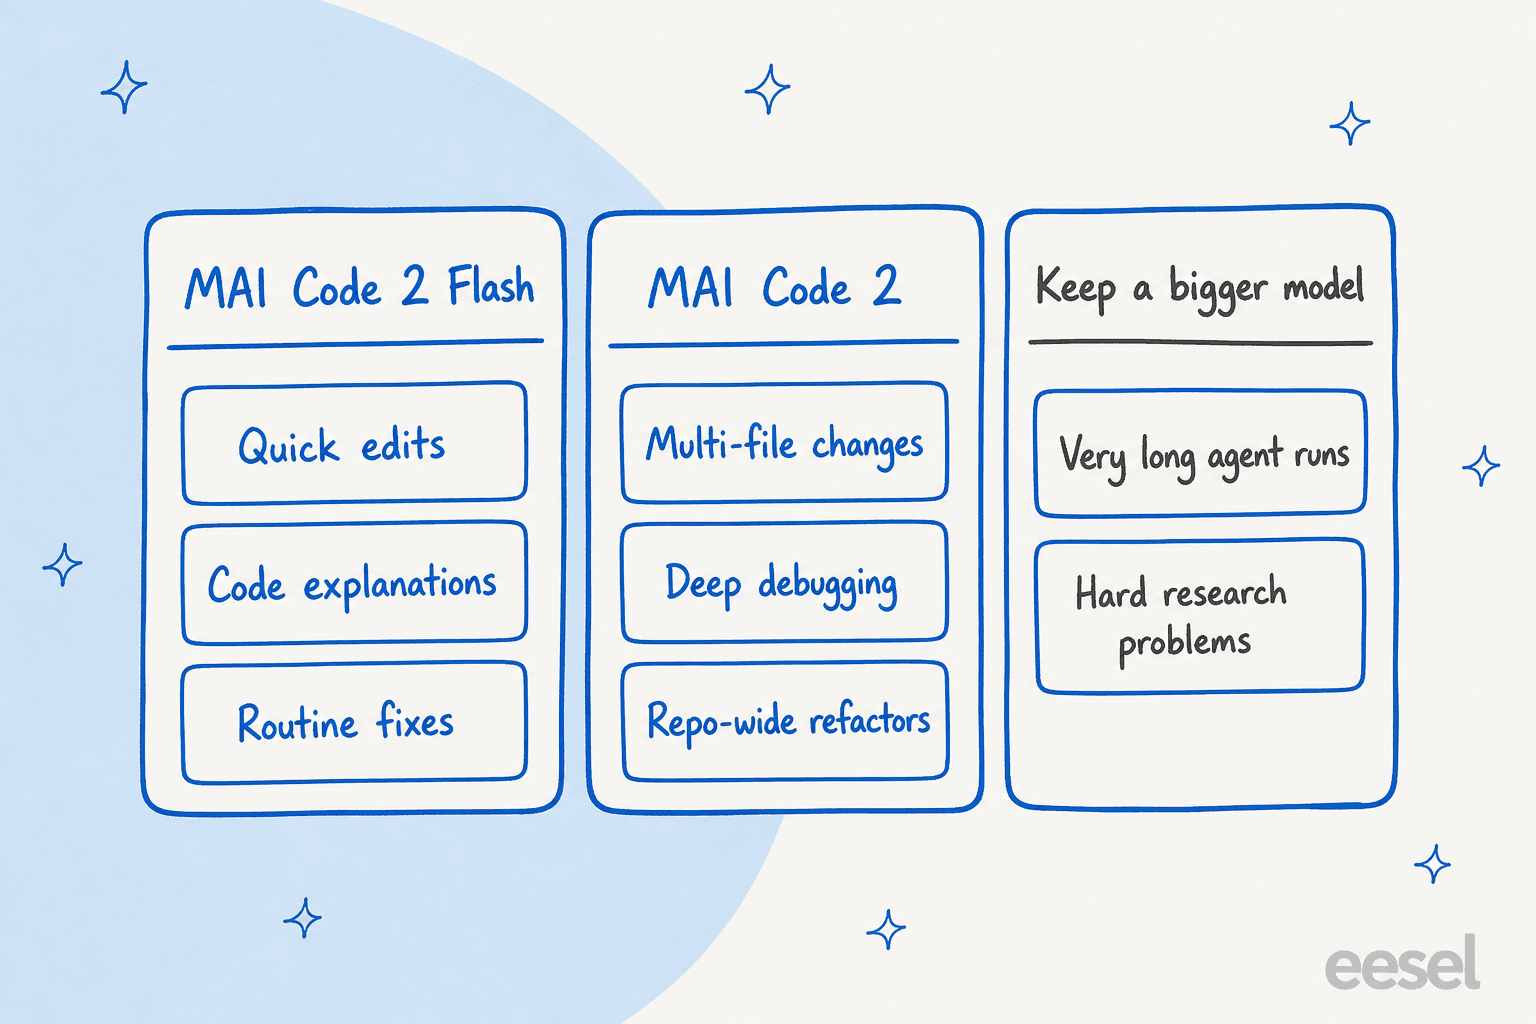
2つのモデルは難易度で作業を分けています。MicrosoftのGitHubの変更履歴は、MAI Code 2を「深いデバッグ、複数ファイルの実装、リファクタリング、リポジトリ全体の推論といった複雑なタスクに理想的」な汎用モデルと説明しています。Flashは「日常的な開発ワークフローに最適化された、軽量でコスト効率の良いコーディングモデル」です。
| MAI Code 2 | MAI Code 2 Flash | |
|---|---|---|
| 対象 | 複数ファイルの変更、深いデバッグ、リポジトリ全体の推論 | 素早い編集、コードの説明、日常的な修正 |
| アクティブパラメータ | 770億(合計約2.8兆) | 120億(合計約3,980億) |
| コンテキストウィンドウ | 1,050,000トークン | 1,050,000トークン |
| プロモーション価格、100万トークンあたり(入力/出力) | $0.50 / $2.50 | $0.05 / $0.25 |
| Copilotプラン | Pro、Pro+、Max、Business、Enterprise | 同上、さらにFreeとStudent |
| Microsoft Foundry | まだなし | アクセス限定のプレビュー |
| Microsoftの比較対象 | GPT-6.1 Sol、Claude Opus 5.5 | GPT-6 Luna、Claude Haiku 5.5 |
パラメータ数はモデルカードのセクション1からのものです。カード自身の要約表ではMAI Code 2について「800億アクティブ」とされているため、正確な数字はおおよそのものとして扱ってください。いずれにしても両方ともスパースなMixture-of-Expertsモデルで、各トークンでネットワークの一部だけが動作します。この設計が価格を抑える助けになっています。
意外だった点が1つあります。FlashはあるベンチマークでMAI Code 2を上回ります。SWE Atlasでは、Flashが44.8%、MAI Code 2が43.1%と、ローンチ記事にあります。小さな差ですが、大型モデルの優位性が一様ではないことを示しています。
MAI Code 2の料金はいくらですか?
GitHub Copilotでは、MAI Code 2は2027年5月17日まで、入力100万トークンあたり$0.50、出力100万トークンあたり$2.50です。それ以降はGitHubの料金ドキュメントによると価格が$1.00と$5.00に2倍になります。Copilotはこれを1クレジット1セントとしてAIクレジットで課金します。
| モデル | 入力(100万あたり) | キャッシュ入力(100万あたり) | 出力(100万あたり) |
|---|---|---|---|
| MAI Code 2、2027年5月17日までのプロモーション | $0.50 | $0.025 | $2.50 |
| MAI Code 2、2027年5月17日以降 | $1.00 | $0.05 | $5.00 |
| MAI Code 2 Flash、プロモーション | $0.05 | $0.005 | $0.25 |
| MAI Code 2 Flash、2027年5月17日以降 | $0.10 | $0.01 | $0.50 |
| GPT-6.1 Sol(272Kまで) | $2.00 | $0.10 | $10.00 |
| GPT-6.2 Sol(272Kまで) | $2.00 | $0.10 | $10.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6 Luna(272Kまで) | $0.10 | $0.01 | $0.50 |
| Claude Haiku 5.5(100Kまで) | $0.10 | $0.01 | $0.50 |
すべての行は同じGitHubのページからのものです。古いリクエスト課金のままの年間Copilot ProまたはPro+プランの場合、レガシーの乗数はMAI Code 2が1x、Flashが0.33xです。プラン全体の一覧はGitHub Copilotの料金ガイドにあります。
コーディングタスクの実際のコストはどれくらいですか?
トークンあたりの価格は請求額の半分にすぎません。もう半分は、1つのタスクを終えるのにモデルが何トークン使うかで、Microsoftはそれも公開しています。最大の推論努力で、4つのベンチマークの平均として、ローンチ記事はタスクあたりのコストを次のように挙げています。
| モデル | 平均合格率 | タスクあたりのコスト(Microsoft) | 定価でのタスクあたりのコスト(筆者の計算) |
|---|---|---|---|
| MAI Code 2 | 63.2% | $0.309(プロモーション価格) | $0.618 |
| GPT-6.1 Sol | 64.1% | $0.761 | $0.761 |
| Claude Opus 5.5 | 65.3% | $6.306 | $6.306 |
| MAI Code 2 Flash | 61.0% | $0.052(プロモーション価格) | $0.104 |
| GPT-6 Luna | 55.1% | $0.080 | $0.080 |
| Claude Haiku 5.5 | 53.9% | $0.319 | $0.319 |
Flashの行は3つのベンチマークの平均で、4つではありません。Microsoftの小型モデル向けの表ではFrontierCodeが省かれているためです。定価の列は単純にMicrosoftの数字を2倍にしたものです。2027年5月17日にすべてのMAIの料率が2倍になり、タスクあたりのトークン数は変わらないためです。
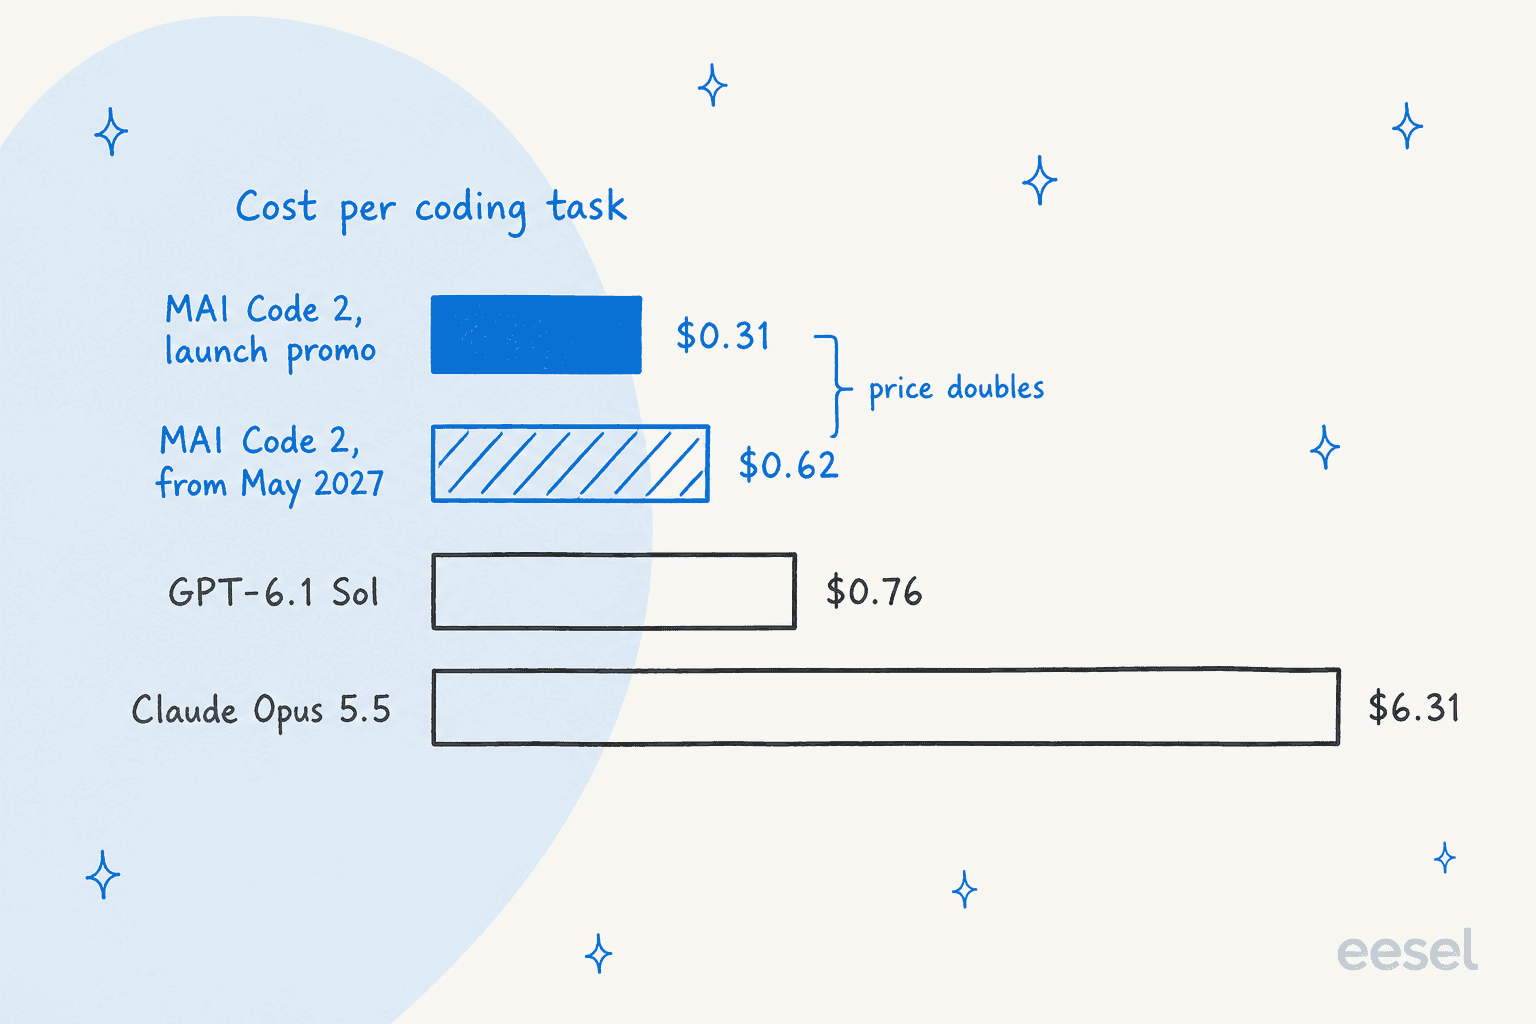
ここが、ほとんどのローンチ報道が見落としている部分です。MAI Code 2のトークンあたりの価格はプロモーション中GPT-6.1 Solの4分の1ですが、タスクあたりのコストはSolの40%です。このギャップは、MAI Code 2がMicrosoft自身の実行でSolの約1.6倍のトークンをタスクあたりに使ったことを意味します。プロモーションが終わると、このトークンの消費量が割引分の大半を食いつぶし、「コストの40%」という見出しは約81%になります。
Hacker Newsのあるコメント者がプロモーションについて当然の疑問を投げかけました。
"The promotional period lasts until May 2027. Why not just make the price lower if they'll be irrelevant by the time the "real" price kicks in?"

もっともな指摘です。6か月はこの市場では長い時間であり、2027年5月に比較対象となるモデルは、おそらくすでにGPT-6.1 Solではなくなっているでしょう。
MAI Code 2のベンチマークは信頼できますか?
概ね信頼できますが、98%という見出しを信じる前に知っておくべき3つの注意点があります。以下は、すべて最大の推論努力でのMicrosoftの完全な表で、ローンチ記事からのものです。
| ベンチマーク | MAI Code 2 | GPT-6.1 Sol | Claude Opus 5.5 | 実施者 |
|---|---|---|---|---|
| DeepSWE 1.1 | 73.2% | 74.6% | 69.0% | Microsoft |
| Terminal-Bench 2.1 | 84.6% | 85.0% | 78.7% | Microsoft |
| SWE Atlas | 43.1% | 47.4% | 57.5% | Microsoft |
| FrontierCode v1.1 | 52.0% | 49.4% | 56.0% | Artificial Analysis |
| 平均 | 63.2% | 64.1% | 65.3% |
注意点1:Microsoftが4つのテストのうち3つを自社で実施しています。 DeepSWE、Terminal-Bench、SWE Atlasは、Microsoftの内部評価プラットフォームMSBench上で、サブエージェントなしのCopilot CLIを使って実行されました。外部の第三者によるものはFrontierCodeのみです。これだけで数字が誤りになるわけではありませんが、独立した第三者による再検証はまだ行われていません。11月18日に確認した時点で、Artificial AnalysisにはまだMAI Code 2のモデルページがありませんでした。
注意点2:平均は実際のギャップを隠しています。 MAI Code 2はDeepSWEとTerminal-BenchでOpus 5.5に勝っています。SWE AtlasではOpusの57.5%に対して43.1%で、14.4ポイントのギャップがあります。作業内容が長く広範なリポジトリ変更に近いなら、この行の方が平均より重要です。
注意点3:比較対象がやや古いものです。 MicrosoftがGPT-6.1 Solと比較したのは、OpenAIがGPT-6.2 Solを発表したのと同じ日でした。GPT-6.2 Solのガイドでこのリリースを扱っています。Hacker Newsはこれに気づいていました。
"They are comparing to Sol 6.1's API prices. With Sol 6.2, and especially if you consider subsidization from Codex subscriptions, it's probably no longer on the Pareto frontier."
他の人たちはベンチマークのバージョンを指摘しました。あるコメント者は、Terminal-Benchが「現在はバージョン4(はるかに難しい)」であり、FrontierCodeも「2.0」であるのに対し、Microsoftは2.1と1.1を報告したと指摘しました。3つのモデルはすべて同じバージョンで評価されているため順位自体は成り立ちますが、絶対値は新しいテストではより低く見えるはずです。
額面どおりに受け取れる結果が1つあります。フロントエンド作業では、258人の評価者によるブラインド評価で、MAI Code 2の出力がGPT-6 Solより64%の割合で好まれました。UIの品質はベンチマークの選び方では偽装しにくく、まさにMicrosoftが構築の目的としている日常的なタスクの種類です。
MAI Code 2へのアクセス方法は?
現時点ではGitHub Copilot経由のみで、それ以外にはありません。GitHubの変更履歴によると、両モデルともプレビューではなく一般公開です。
- プラン: MAI Code 2はCopilot Pro、Pro+、Max、Business、Enterpriseで利用できます。FlashはさらにFreeとStudentにも対応していますが、これらのプランは自動モデル選択を通じてのみ到達します。
- 場所: VS Code、Visual Studio、JetBrains、Xcode、Eclipse、Copilot CLI、クラウドエージェント、Copilotアプリ、github.com、GitHub Mobileのモデルピッカーです。
- 管理者向け: BusinessとEnterpriseでは、管理者がグローバルな既定値を無効化していない限り、新しいモデルはデフォルトで有効になります。これは、8月にデフォルトで無効だったMAI Code 1.1 Flashからの変更点です。
- API: Microsoft FoundryにあるのはFlashのみで、アクセス限定のプレビューとして、価格はまだ公開されていません。MAI Code 2自体はそこにありません。
- 近日対応予定: Microsoftは期日を示さずOpenRouter、Vercel、Hermes、Open Code、Kiloを挙げています。
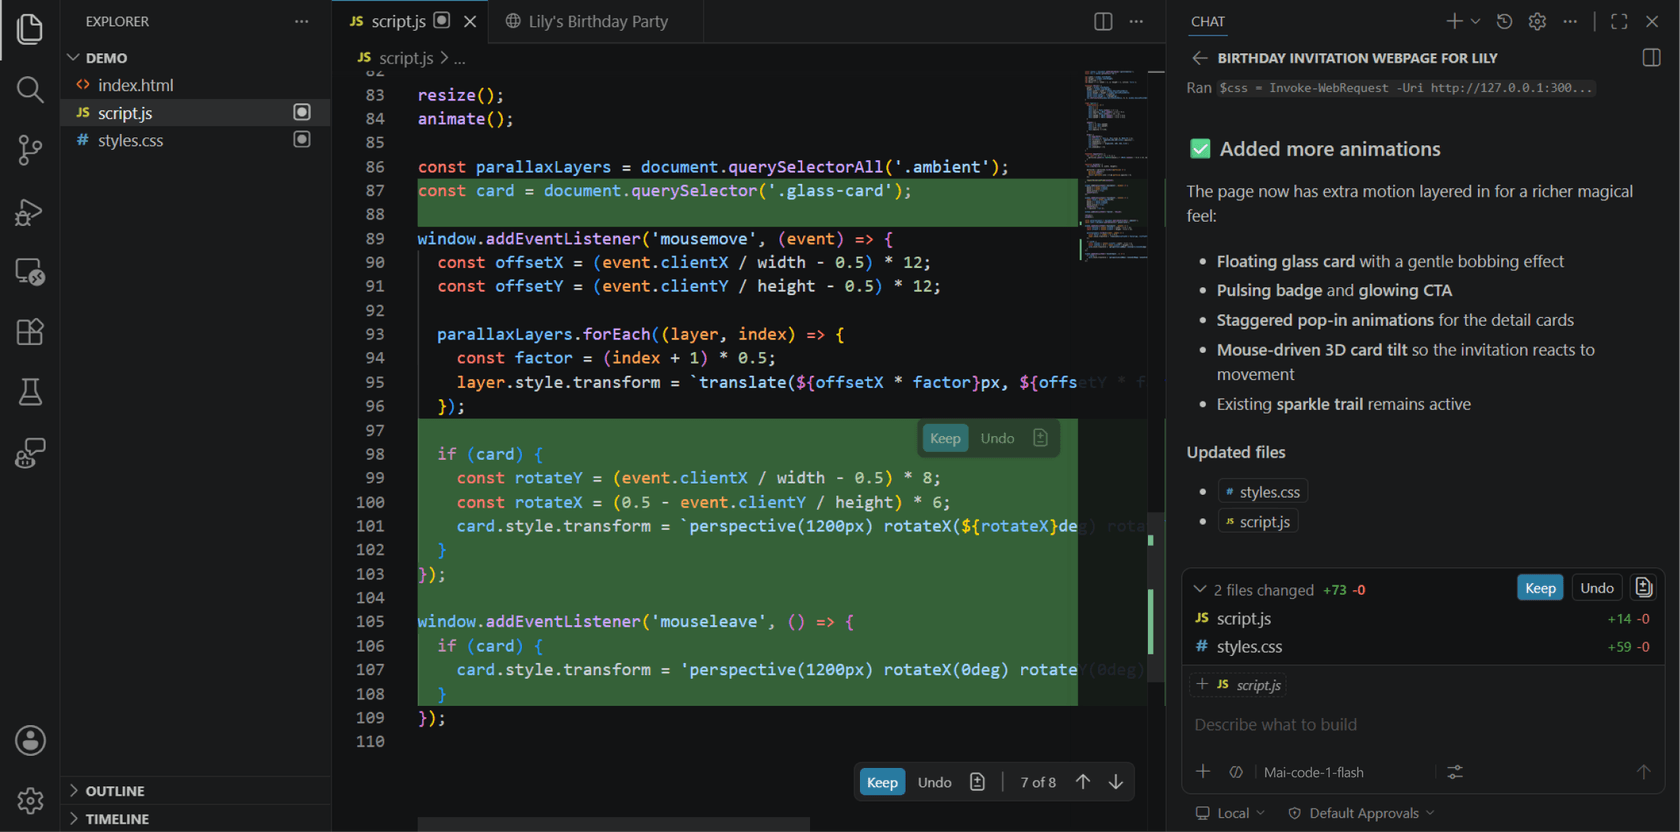
このスクリーンショットは以前のMAI-Code-1-Flashのローンチ時のものですが、MAI Code 2でも流れは同じです。Copilotチャットを開き、下部でモデルを選び、いつものように作業するだけです。管理者であれば、今すぐモデルポリシーを確認してください。チームが検証していないモデルがデフォルトで現れるのは、5分かけて見ておく価値があります。
Copilotの外にいる人にとって、アクセスが弱点です。生のAPIの上に構築している場合や、Claude CodeやOpenAI Codexで暮らしている場合、まだMAI Code 2を組み込めません。あるHacker Newsユーザーはそのいら立ちを率直に表現しました。
"What annoys me a lot about MSFT releases are, that is not possible to find how to use these models and where to try them. I didn't hear anyone in my circle using MAI models, none."
MAI Code 2はオープンソースですか?
いいえ。モデルカードには「モデルの重みは配布されず、モデルはMicrosoft AzureのGPUインフラ上で提供される」と書かれています。初期の一部の記事ではMITライセンスの小型オープンウェイトモデルと呼ばれていました。これはmicrosoft/MAI-Codeのリポジトリから来ているようですが、MITライセンスではあるものの、READMEとフィードバック用のissueテンプレートしか入っていません。
重みを管理したい企業向けに、Microsoftは同日にMAI Licensed Weightsを発表しました。これにより企業は自社のAzure環境でMAIモデルを実行・微調整でき、Microsoftのアカウントチーム経由で「近日公開予定」とされています。モデルページのパートナーからの引用もこの経路からのものです。AT&Tは、標準的な5Gネットワーク分析でカスタマイズ版のFlashがGPT-6.1 Solを「50倍安いコストで」上回ったと、モデルページで述べています。ただしこれらは微調整されたモデルであり、Copilotで選べるものとは異なります。
開発者たちはMAI Code 2についてどう言っていますか?
Hacker Newsのローンチスレッドは、1日で278ポイント、131コメントに達しました。盛り上がりの大半はベンチマークと課金についてで、モデル自体についてではありませんでした。実際に使う時間を持てた人がほとんどいなかったためです。
最も多かった不満は比較の組み方についてでした。
"While showing MAI Code 2 at a 50% promotional discount, and comparing to Max reasoning effort for Opus 5.5 and 6.1 Sol..."
2番目はCopilotの課金についてでした。GitHubが6月に使用量ベースの課金に移行してから、安いモデルはクレジットが足りる場合にしか役立ちません。
"I think they won't help if they're billed at the announced rate on your Copilot quota. Microsoft would need to do something like Devin does and offer its own models with separate limits."
とはいえ関心は本物で、特にモデル選択をすでにコストのレバーとして扱っている人々からのものでした。
"Price and performance look good based on benchmarks. Am definitely interested in trying this to see given a lot of my workload of actual coding is handed over to Haiku/Luna right now."
最後のコメントは私の見方と一致します。最も得をするのは、すでにモデル選択をコストのレバーとして扱っている人たちです。Copilot、Cursor、ターミナル型のコーディングツールのどれを使うか迷っているなら、MAI Code 2はCopilotをもう一度見直す理由になりますが、それだけで乗り換える理由にはなりません。
何に注意すべきですか?
Microsoftは限界について珍しく率直で、その点は評価しています。ローンチ記事には、両モデルとも「基礎科学研究や非常に長期的なエージェント作業といった、より難しい問題にはまだ明示的に調整されていない」と書かれています。モデルカードはさらに次のような点を挙げています。
- 長いセッションはずれていきます。 「長いエージェント的セッションでは、モデルがツール呼び出しを繰り返したり、既存のコードベースを十分に活用しなかったり、指示から外れたり、作業を完全に検証する前に停止したりする可能性がある」とされています。コーディングCLIから長時間の自律エージェントを動かす場合は、出力を確認してください。
- 英語のみです。 「リリース時点では、モデルは英語のコード生成のみに最適化されている」とされています。他の言語でのコメントやドキュメントは弱くなる可能性があります。
- 努力を増やすことが常に良いわけではありません。 カードによると、推論努力を高めても「結果が常に改善するわけではない」とされています。中程度から始め、タスクが失敗したときだけ上げてください。
- アライメント。 Microsoftは両モデルを「GPT-5.6 Solと同程度のアライメントだが、GPT-6よりは劣る」と評価しています。コミットされるものには、いつもどおりのレビューゲートを維持してください。
- あなたのプロンプトがトレーニングに使われた可能性があります。 データカードによると、ポストトレーニングにはオプトアウトしていないCopilot Free、Pro、Pro+ユーザーの会話コンテキストが使われました。これが気になる場合は、Copilotのデータ設定を確認してください。
カードはまた、両モデルを攻撃的なサイバー利用、ならびに化学・生物・放射性物質・核の悪用に対するリスクで「高」と評価し、こうした要求を検出する分類器が付属しているとしています。これはフロンティアに近いモデルとしては今では標準的であり、通常のコーディング作業には影響しません。
MAI Code 2を使うべきですか?
Copilotを使っていて、作業の大半が範囲の定まった変更であれば、はい、少なくともプロモーションが続いている間は使う価値があります。私なら作業をこう振り分けます。
| 使っているもの | 筆者の見解 |
|---|---|
| CopilotでGPT-6.1 SolまたはGPT-6.2 Sol | 日常的な複数ファイル作業にはMAI Code 2を試してください。2027年5月までタスクあたりのコストが約40%で同程度のスコアです。価格が2倍になった後は再確認してください。 |
| Claude Opus 5.5 | 長く難しいリポジトリ作業にはOpusを残してください。SWE Atlasで14ポイント先行しています。範囲の定まった修正はMAI Code 2に移し、約95%節約してください。 |
| GPT-6 LunaまたはClaude Haiku 5.5 | Flashを試してください。6~7ポイント高いスコアで、プロモーション中はタスクあたりのコストも低くなります。定価ではLunaよりタスクあたりのコストが高くなります。 |
| Claude Code、Codex、または生のAPI | 待ってください。MAI Code 2はCopilotの外ではまだ使えず、FlashはFoundryではプレビューのみです。 |
| 長時間の自律エージェント | より大きなモデルを使い続けてください。Microsoftは非常に長いエージェント作業向けには調整されていないとしています。 |
コーディングツールをより広く比較しているなら、最高のAIコーディングアシスタントのまとめとCopilotの代替ツールのガイドは1つのモデルより範囲が広いです。音声向けのMAI-Transcribe-2やDecision 1といったMicrosoftの他の独自モデルも、同じ戦略、つまり狭い用途を低価格で、という方針に従っています。
MAI Code 2はサポートチームにとって何を意味しますか?
安いコーディングモデルは、安いインフラです。サポート担当者ではありません。MAI Code 2はあなたの返金ポリシーを知らず、ヘルプデスクを見ることもできず、Microsoftは英語のコードを書くために調整しており、顧客に答えるためではありません。サポートの自動化を構築しているなら、モデルは作業の一部分にすぎません。残りは知識、トーン、ガードレール、引き渡しルールであり、これらはサポート向けモデル比較だけでは解決できません。
それがeeselが構築している層です。MAI Code 2はインフラであり、eeselは従業員です。あなたはキューのためにAIヘルプデスクチームメイトを、またはコンテンツのためにAIブログライターを雇い、それぞれがその役割に応じたインテグレーション、企業の知識、制約を備えて届きます。コーディングモデルが実際に役立つのは、その周りを構築することです。開発者はCopilotやClaude Codeをeesel CLIに向けて、承認済みの知識を読み込ませたり回答をテストしたりできますが、ヘルプデスク自体の接続には依然として管理者の承認が必要です。
SE Rankingは、それが規模を持ってどう見えるかを示しています。このSEOソフトウェア企業は1つのサポートチームで3つのプロダクトを運用しているため、プロダクトごとに1つ、3つのZendesk接続上で3つのeeselエージェントを動かしています。2026年8月8日から9月8日の間、これらのエージェントは4,650件の会話を処理し、2,100件のライブチャットに最初に応答し、約16,800ページの知識を参照しました。これはどのモデルが今週流行っているかに依存しません。そしてそれこそが要点です。裏側のモデルは、顧客に気づかれることなく変わることができます。
この用途のツールを比較しているなら、最高のAIヘルプデスクソフトウェアのまとめがその分野を広く扱っており、チケットあたりのコストのベンチマークでは、モデルの価格をチケット1件の全コストと並べて示しています。
eeselを試す
MAI Code 2をきっかけに、安いモデルがサポートキューに何をもたらせるか考えているなら、まずそれが機能するかどうかを決める部分、つまりモデルの周りにいるチームメイトから始めてください。eeselは、すでに使っているヘルプデスクに接続し、過去のチケットやヘルプセンターから学習し、実際の過去のチケットに対して動かして、顧客がその回答を目にする前に自分で読めるようにします。プランは500クレジットで299ドルからの固定クレジットパッケージなので、5月にモデルのトークン価格が2倍になっても請求額は変動しません。

キューの一部でeeselを無料で試すことも、自分で構築すべきか迷っているならChatGPTを直接使う場合と比較することもできます。