

MAI-Transcribe-2は、Microsoft AIの新しい音声認識モデルで、2026年9月3日に発表され、「世界で最も高速、高精度、低価格の音声認識モデル」と銘打たれています。Microsoft自身の数値によれば、この主張はおおむね裏付けられています。60言語平均の単語誤り率は5.2%、長い音声ではGPT-Transcribeの約10倍の速度(Microsoftの自社ベンチマークによる)、そしてローンチ価格は音声1時間あたり$0.10です。
ただし、このモデルの上に構築する前に知っておくべき注意点があります。$0.10は2026年末までの期間限定オファーで、通常価格は公表されていません。バッチ型モデルでパブリックプレビュー(SLAなし)、ファイルは300MBまで、リアルタイム用途には別途Voice Liveの設定が必要です。ベンチマーク表もMicrosoft自身のもので、総合ではリーダーボード2位です。
APIで音声をきれいな多言語テキストにしたいだけなら、現時点で最も強力かつ安価な選択肢のひとつです。しかしサポート業務が目的なら、文字起こしは終点ではなく起点だと覚えておいてください。誰かがそれを読み、答えを見つけ、チケットを解決する必要があります。それがeeselのようなAIチームメイトの仕事であり、今は本当の価値がそこにあります。
私はeeselで連携やAPIを開発しているため、このようなローンチは開発者の目で読みます。見出しの先で、APIは実際に何をするのか。MAI-Transcribe-2のモデルページ、Azure Speechのドキュメント、プレイグラウンド、そして初期の開発者の反応を確認しました。以下がその結果です。
MAI-Transcribe-2とは何か
MAI-Transcribe-2は、MAI-VoiceやMAI-1モデルを手がけるのと同じグループであるMicrosoft AIが社内で開発した音声認識モデルです。コンセプトは潔いほど絞られています。やることは音声をテキストに変換することだけで、言語ごとにエンジンを選ばせるのではなく、単一のモデルで多言語に対応します。
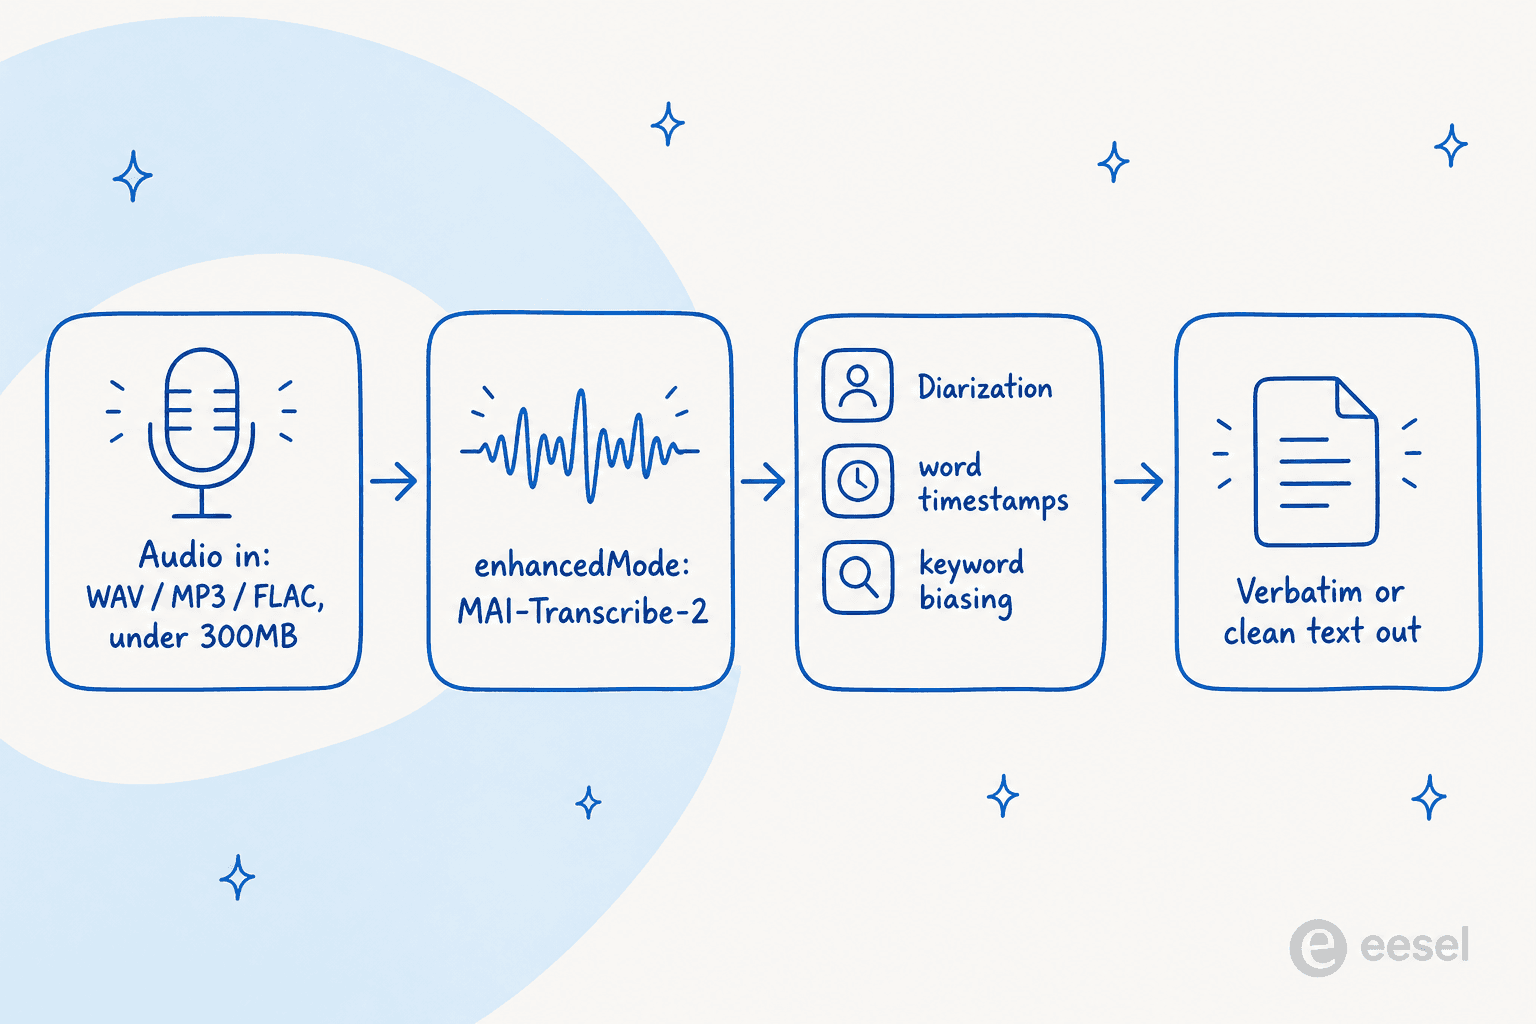
得られるのは生の文字列だけではありません。このモデルは、話者分離(誰がいつ話したかのラベル付け)、単語単位のタイムスタンプ、製品名や専門用語を優先するキーワードバイアスに対応し、コンプライアンス用途でフィラーや言い直しをすべて残す「verbatim」スタイルと、読みやすい字幕に整える「clean」スタイルを選べます。MAI-Transcribe-1.5とMAI-Transcribe-1の後継で、これらはAzure Speechのドキュメントで2026年8月20日から非推奨とされています。
正直に言えば、これはMicrosoft AIのモデルであり、単体のコンシューマー向けアプリではなくAzure Speechエコシステムの一部です。API、開発者向けプレイグラウンド、またはサードパーティのルーター経由で利用するもので、洗練されたエンドユーザー向け製品ではありません。Otterのような会議アプリを期待していたなら、これはその下にある層であり、アプリそのものではありません。
見出し:最速、最高精度、最安価
Microsoftは曖昧にしませんでした。ローンチ記事はMAI-Transcribe-2を「世界で最も高速、高精度、低価格の音声認識モデル」と呼んでいますが、この種の三拍子の主張は、たいてい二つ目で崩れます。今回は、いくつか注釈付きでおおむね成立しています。
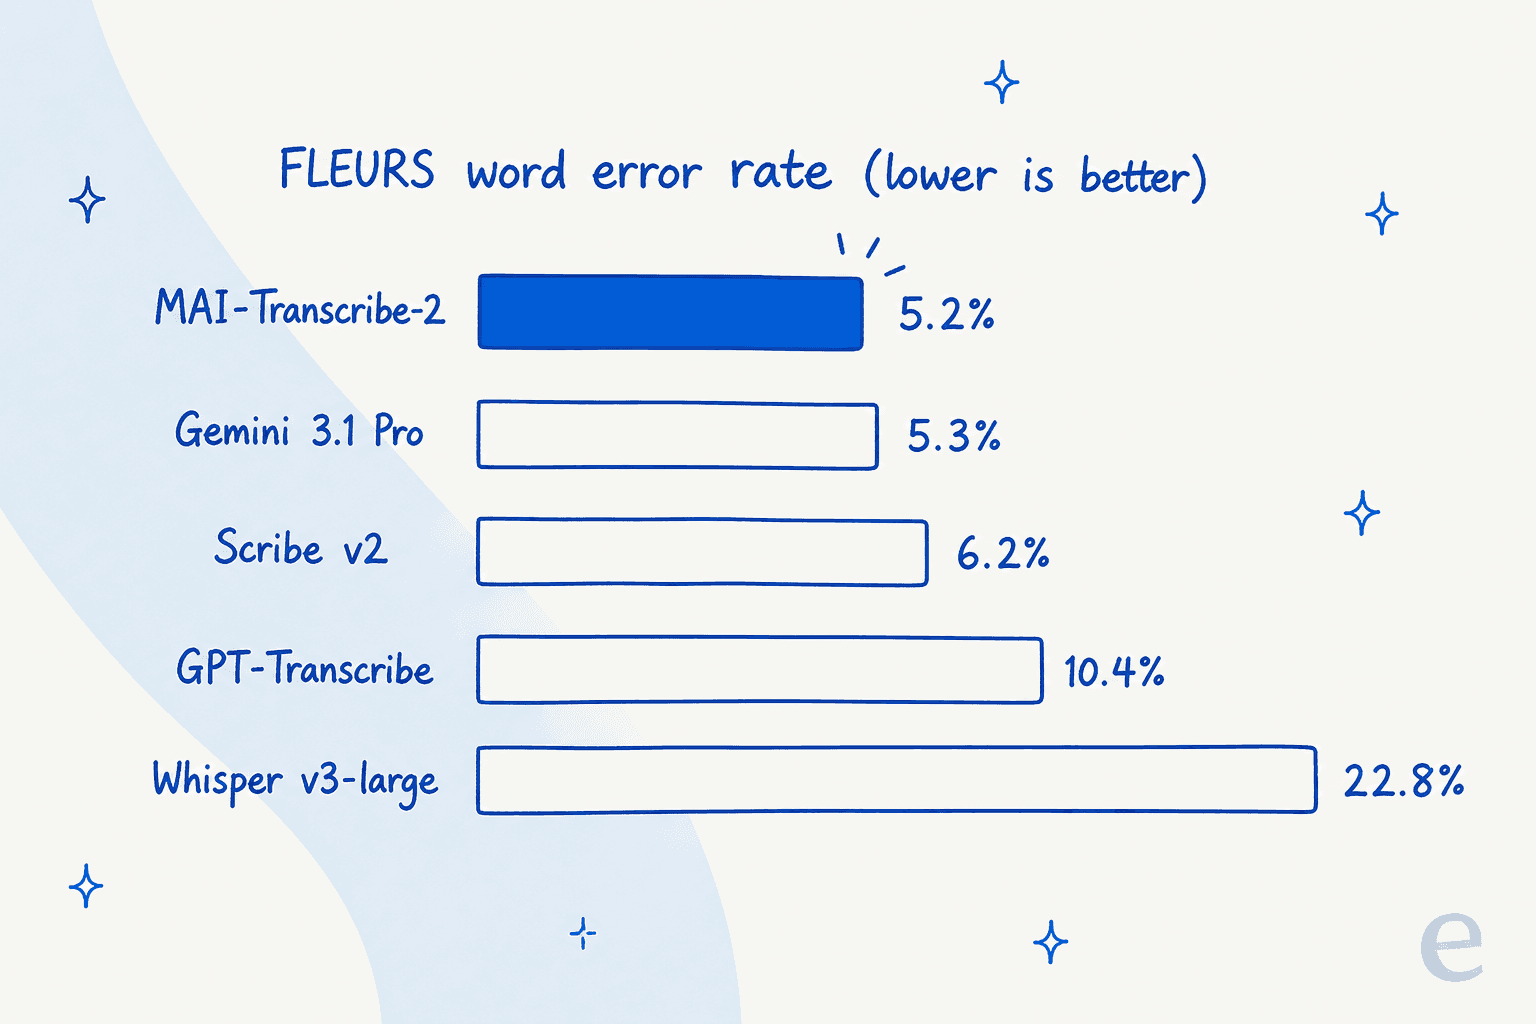
精度では、このモデルはFLEURSベンチマークの60言語平均で単語誤り率5.2%を記録し、MicrosoftによればFLEURSで1位、Artificial Analysisの単語誤り率リーダーボードでは2位です。FLEURS上位25言語では3.4%まで下がります。モデルページが他と並べた比較は次のとおりです(低いほど良い)。
| モデル | FLEURS 60言語WER(forced) |
|---|---|
| MAI-Transcribe-2 | 5.2% |
| Gemini 3.1 Pro | 5.3% |
| Scribe v2 (ElevenLabs) | 6.2% |
| Gemini 3.5 Transcribe | 5.9% |
| GPT-Transcribe (OpenAI) | 10.4% |
| Whisper v3-large (OpenAI) | 22.8% |
旧世代のオープンなWhisper v3-largeとの差は非常に大きく、Gemini 3.5 TranscribeやGPT-Transcribeに対する優位も本物です。ただしGemini 3.1 Proとの差は0.1ポイントで、「最高精度」は事実ですが、表の上位ではわずかな差にとどまります。
速度の数値は本当に印象的です。Microsoftは1時間の音声を約10秒のモデル推論で処理すると計測しており、ローンチ時のベンチマークではGPT-Transcribeの10倍、ElevenLabs Scribe v2の7倍、Gemini 3.5 Transcribeの5倍の速さで、しかも精度とレイテンシーのパレートフロンティア上に位置しています。試したHNのコメント投稿者は、この位置づけを端的にまとめています。
"According to Artificial Analysis it is on the pareto frontier."

これらすべてを読む際に頭に置いておくべき点は、これがMicrosoft自身のベンチマーク数値であり、比較対象もMicrosoftが選んだものだということです。だからといって間違いとは限らず、これまでの独立した初期テストも同じ方向を示しています。ただ、「世界最高」はベンダーの表現であり、Artificial Analysisの総合ボードで2位というのがより控えめな見方です。
実際の使い方
ここで私の開発者としての血が騒ぎました。そしてここが、リーダーボードよりもモデルが面白くなるところです。MAI-Transcribe-2はAzure SpeechのFast Transcription APIで動作し、新しいエンドポイントではなくenhancedModeフラグで有効化します。最小限の呼び出しは次のようになります。
curl --location 'https://YourResourceName.cognitiveservices.azure.com/speechtotext/transcriptions:transcribe?api-version=2025-10-15' \
--header 'Content-Type: multipart/form-data' \
--header 'Ocp-Apim-Subscription-Key: <YourSpeechResourceKey>' \
--form 'audio=@"YourAudioFile.wav"' \
--form 'definition={
  "enhancedMode": {
    "enabled": true,
    "model": "MAI-Transcribe-2"
  }
}'
そこから先のパラメーターはすっきりしています。話者ラベルにはdiarization.enabled、キーワードバイアスにはphraseList.phrases、逐語かクリーンかの選択にはmodelOptions.transcribeStyle、自動検出を省きたい場合はlocalesを使います。ファイルはWAV、MP3、FLACでアップロードし、上限は300MBです。シンプルなバッチアップロードで、何を作るかによって長所にも短所にもなります。
curlよりクリックで試したいなら、もっと簡単な入口が二つあります。MAI PlaygroundではMP3をドロップするか、ブラウザから直接録音でき、臨床の口述やサポート通話風のサンプルが用意されています。このモデルはOpenRouterやAzure AI Foundryカタログにも掲載されています。
本当に優れている点と、注意すべき点
まず、MAI-Transcribe-2の長所を認めておきます。私が見つけた中で最も強力な独立した反応は、スペック表の転載ではありませんでした。Whisper Memosアプリを手がける個人開発者のVojtech Rinikが、難しい実際のクリップを通してみたのです。
"I tried running a church homily with lots of echo in Slovak language through this... It did much better than ElevenLabs at 45% of the price."
ノイズやエコーが多い英語以外の音声は、性能の低いモデルが崩れる典型例です。すでに自分で本番運用しているツールよりこちらを選ぶ開発者の判断は、ベンチマーク表では分からないことを教えてくれます。
次に注意点です。本番に組み込むなら重要になります。1時間$0.10という価格はローンチプロモーションで「年末まで」とされており、その後どうなるかMicrosoftは公表していません。参考までに、モデルページではMAI-Transcribe-1.5が今も1時間$0.36とされているため、v2の通常価格がその範囲に落ち着いても不思議ではありません。Hacker Newsのコメント投稿者は、Microsoftがローンチ時に答えなかった二つの疑問を投げかけました。
"is this usable for streaming or only batch? do they give the price after the launch-discount (till end of year) goes away?"
ストリーミングについては答えがありますが、少し面倒です。Fast Transcription APIはバッチ専用で、ライブ音声では、別のVoice Live APIに入力文字起こしモデルとして組み込む必要があります。可能ですが同じ呼び出しではないので、計画に入れてください。また、まだパブリックプレビューでSLAなしで提供されており、Microsoftは本番向けではないと明示しています。
もう一つ確認すべきは統合の形です。純粋な文字起こしモデルなので、汎用LLMのようにチャット補完のツールにはそのまま収まりません。Redditの開発者も早い段階でこの点に当たっています。
"OpenRouter requires a dedicated endpoint (
/api/v1/audio/transcriptions) for pure transcription models like MAI-Transcribe-2."

どれも致命的ではありません。公開から1週間のプレビューモデルにはよくあることで、驚かないよう明記しておく価値があります。
ベンチマークの図が示さないこと
私が何度も立ち返った捉え直しがこれです。かつて文字起こしは難しくて高価な部分でした。MAI-Transcribe-2は、Gemini 3.5 TranscribeやElevenLabs Scribeとともに、それを静かに、高速で安価な、ほぼ解決済みのコモディティ層に変えました。それは素晴らしいニュースですが、価値が移動したことも意味します。正確な文字起こしは、誰もが本当に欲しかったものではありません。欲しかったものの原材料です。
それが最も明確なのがカスタマーサポートです。文字起こしモデルは、サポート通話やボイスメールを、約10秒で話者分離とタイムスタンプ付きの完璧なテキストに変えられます。では、その後は? テキストは読まなければならず、答えをドキュメントや過去のチケットから見つけなければならず、返信を書いてチケットを解決しなければなりません。モデルが与えてくれるのは耳です。チームメイトではありません。
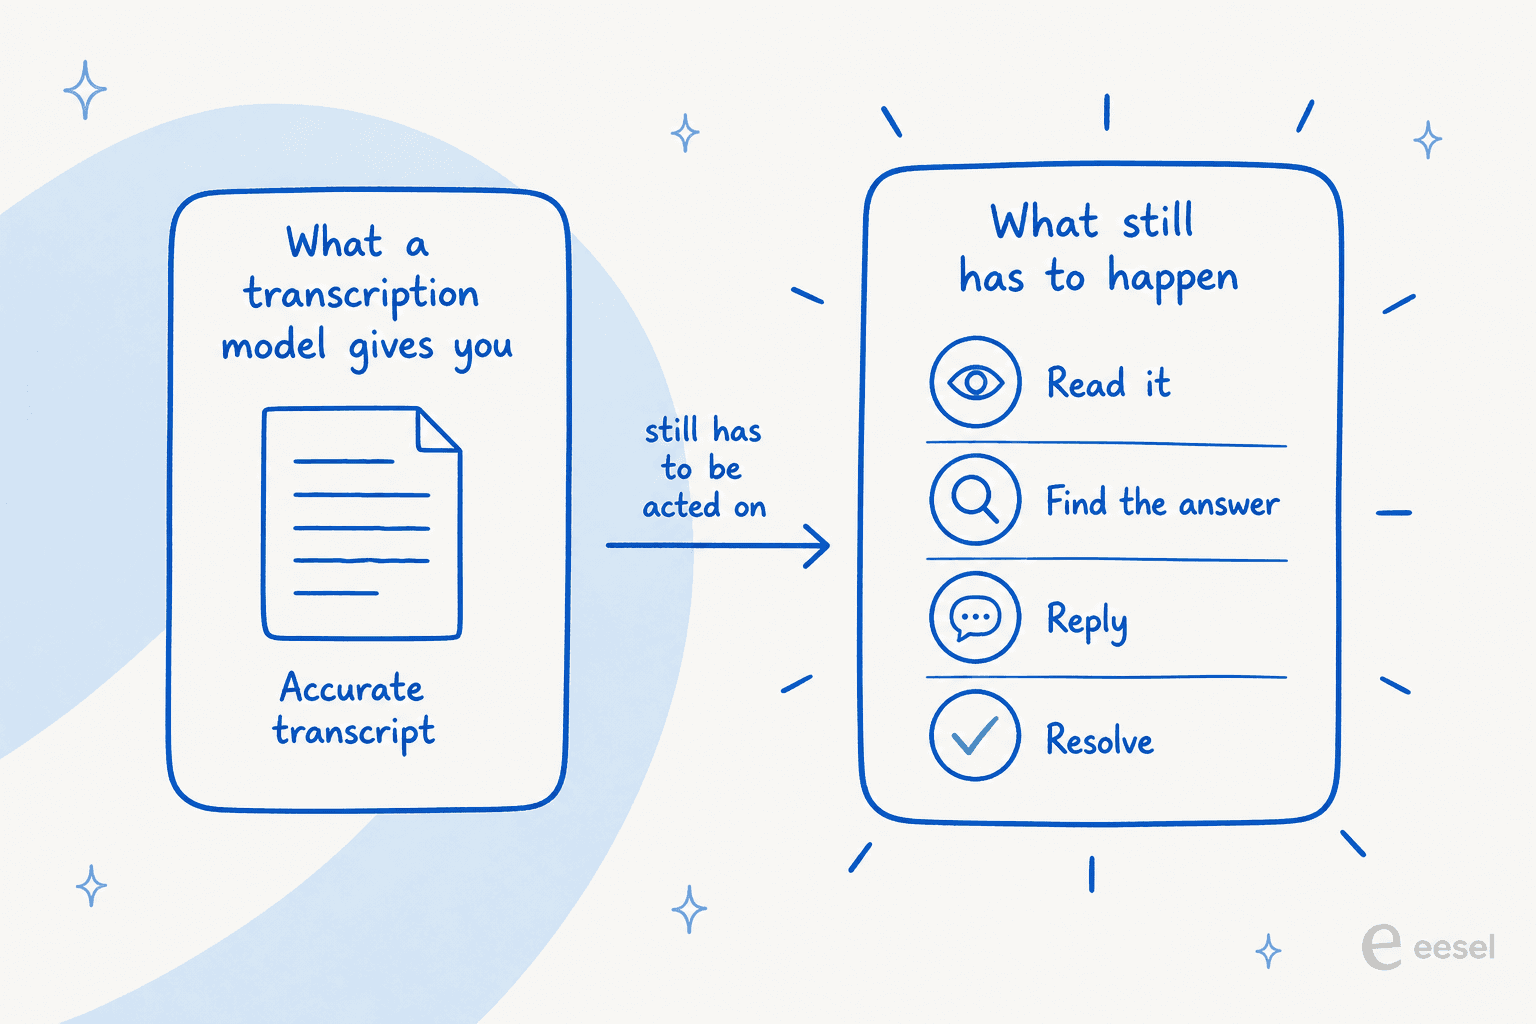
これはMAI-Transcribe-2のようなモデルの正直な境界であり、批判ではありません。自分の仕事を非常にうまくこなしています。ただ、会話を解決する仕事とは別の仕事であり、サポートチームにとって数字を動かすのは後者です。
eeselはどこに位置するのか
MAI-Transcribe-2はインフラです。eeselは、その上で働く従業員です。私たちは特定の仕事のために採用するAIチームメイトを作っており、AIヘルプデスクチームメイトは文字起こしモデルが終わるところから引き継ぎます。テキストを読み、ヘルプセンターや過去のチケットから答えを引き出し、Zendesk、Freshdesk、Slack内で返信を下書きまたは送信します。両者を組み合わせれば、文字起こしされた音声チケットは、整った段落で終わらず、解決済みのチケットになります。

また、MAI-Transcribe-2はAPIファーストのモデルなので、これを選ぶ開発者はサポート自動化にも同じ制御を求める傾向があります。eeselにはそのための公開CLIがあり、同じチームメイトとワークスペースをターミナルから操作できます。人が手で実行することも、スクリプトで自動化することも、Claude CodeやCursorのようなコーディングエージェントがヘッドレスで操作することもでき、ダッシュボードは不要です。パイプラインの入口に文字起こしを、解決の出口にeeselをつなげられます。無料で試せ、数分でヘルプデスクに接続でき、顧客に返信する前に実際の過去チケットでシミュレーションするので、解き放つ前にキューをどう処理したかを確認できます。