

要点
Subvocalは、Y Combinatorのスタートアップが開発するメガネ型デバイスです。声を出さずに口を動かした言葉をテキストに変換します。AIツールに音声入力をしたいものの、職場では声を出せない人向けの製品です。返金可能な$199のデポジットで、$499のメガネを予約できます。出荷予定は2027年第1四半期です。提案には実体がありますが、裏付けはまだ足りません。精度の数値も仕様も未公開で、クラウド必須、英語のみ対応です。最前線で見届けたいと思い、待つことができるなら、予約してもよいでしょう。本当のボトルネックがサポート返信の作成なら、返信を下書きしてくれるeeselのようなAIチームメイトのほうが、大きな時間短縮につながります。
Subvocalとは?
Subvocalは、無声発話を入力に使うウェアラブルデバイスで、新しい種類のマルチモーダルAI入力手段です。開発元のThe Subvocal Companyは、Y Combinatorの2026年秋バッチに参加する、サンフランシスコの3人のスタートアップです。メガネをかけ、声を出さずに言葉を口の動きで表すと、コンピューターにテキストが表示されます。YCの企業ページに掲載されているキャッチコピーは"Talk to your computer without talking."です。
ローンチは大きな話題になりました。CEOのAarush Yadavが10月30日に行ったXでの発表は、26,277件のいいねと約12 million回の閲覧を獲得しました。数日後のShow HNのスレッドも、約497ポイントと270件のコメントに達しました。同じ投稿でYadavは、同社がYCとAfore Capitalから$1.3Mを調達したと述べています。
創業者はAarush Yadav(CEO)とArnav Kumar(CTO)の2人で、どちらもGeorgia Techでコンピューターサイエンスを学ぶ学生です。Georgia Techの優等生プログラムの紹介記事によると、Yadavは2026年2月にStanfordで開催されたハッカソンTreeHacksの後に開発を始め、数週間以内にAforeから最初の$500kを調達しました。
私はeeselでプロダクトを開発しているので、ローンチページも仕様書と同じように読みます。何が確約され、何が目標で、何がデモなのかを見るわけです。細かい記載まで読めば、Subvocalはその区別について率直です。YCのローンチ投稿では、"the hardware currently looks a lot worse than the product we intend to ship."と明言しています。
知っておきたい点が1つあります。この製品は短期間で形を変えてきました。2026年4月のGeorgia Techの記事では、"a wearable that sits behind your ear"と紹介され、文字単位で認識する試作機の速度は毎分30語でした。その6か月後にはメガネ型になり、200+をうたっています。これほど初期のハードウェアスタートアップでは普通のことですが、最終製品がまた変わる可能性がある理由でもあります。
Subvocalはどのように動くのか?
Subvocalが読み取るのは、話すときに使う筋肉です。声でも、カメラに映った顔でもありません。YCのローンチ投稿では、"We send low-power radio waves through the face and measure how they change as your muscles move. Our models then decode those signals directly into text."と説明されています。
創業者はHacker Newsで、さらに詳しく説明しています。
"They emit radio waves, similar to Bluetooth, that pass through your face. As they cross the tongue, lips and soft palate, they're modulated by silent mouthing. We train foundation models on this data to decode these perturbations to text."

Subvocal自身のページにあるいくつかの情報から、実際にどう使うことになるかが見えてきます。
- カメラは使いません。 ホームページのFAQには、"There's no video or camera-based lip reading."とあります。
- 意図的に口を動かす必要があります。 "only decodes words you intentionally articulate"という仕組みなので、思考を読み取るものではなく、常時動作するわけでもありません。
- 最初にキャリブレーションが必要です。 セットアップには"a short personal calibration process."が含まれます。YCのDaveが登場するデモ動画では、20文を読む作業でした。
- クラウドが必須です。 オフラインで動くかという質問に、創業者はHacker Newsで、"Yes, it requires internet access."と回答しています。
- 英語のみ対応です。 創業者の別の返信によると、他言語への対応は"after shipping"に予定されています。
なぜカメラではなく電波なのでしょうか。創業者の回答は、今回のローンチ全体で最も参考になる技術的な説明です。"Speech has 40 phonemes, but only about 12 to 15 visemes,"ということで、多くの音は外から見ると同じに見えます。たとえばPとBです。創業者の言葉では、カメラによる読唇の誤り率は"too high to be product ready but just low enough to make for a good demo."という水準にとどまります。内側から舌と軟口蓋を読み取ることで、その限界を超えようとしているのです。
ハードウェアの詳細は公開されていません。SubvocalのHead of Sensingの求人では、設計の検討範囲としてRFセンシング、EMG、EEG、mmWaveを挙げ、"For competitive and IP reasons, we are not publicly disclosing the exact architecture of our current system yet."と説明しています。Subvocal自身のページには、レーダーという言葉は一度も出てきません。使われているのは"RF sensing"と"radio waves"です。
Subvocalは実際、どれくらい速いのか?
Subvocalは毎分200+語をうたっています。ホームページには、"decodes almost-invisible subtle, silent mouthing into text at 200+ WPM,"とあり、どの見出しでもこの数字が繰り返されました。
比較のため、創業者はHacker Newsでタイピングと発話を並べて説明しています。"Most people type at 40-50 WPM. Developers can often type at 70-100 WPM. Meanwhile, most people can talk at 120-200 WPM."
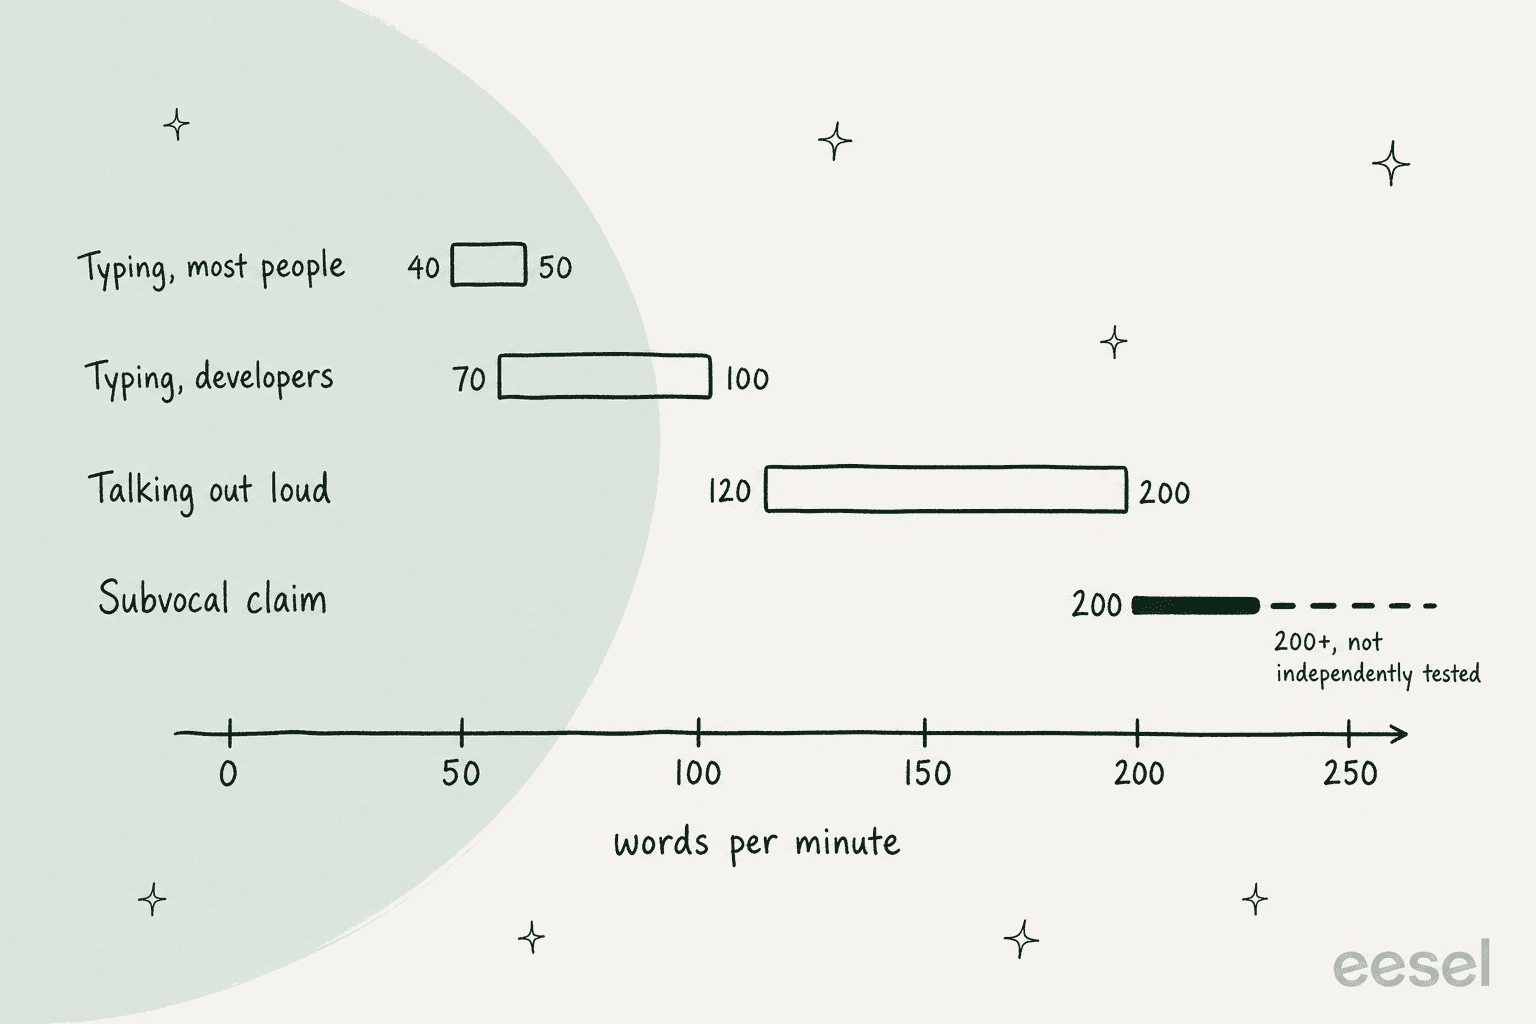
こう見ると、声を出さずに口を動かす速度が通常の発話速度の上限に達するという主張です。試作機としては大胆な水準です。また、精度が伴わなければ速度に意味はありません。そこが欠けています。Subvocalは誤り率を公開していません。ホームページには"it can occasionally get something wrong,"とあり、ローンチ投稿では"a reasonably low error rate even at a small dataset scale."と説明されています。出回っている唯一の数値は、デモ動画の視聴者によるものでした。
"I am so glad to see an unpolished early look and an honest evaluation of about five percent error rate in the YouTube video."
これは1人が1本のデモを見て出した推定なので、ベンチマークではなく、大まかな見立てとして受け止めてください。Nemotron 3.5 TranscribeやVoxtral 3などの音声文字起こしモデルと比べてみてください。これらには、確認できる公開の単語誤り率があります。
Hacker Newsで最も大きくなったサブスレッドは、精度の話ではありませんでした。そもそも話すほうが速いというのは、誰にでも当てはまるのかという議論です。
"Do most people talk faster than they can type? It's the opposite for me - I also read aloud slower than I can read in my head."
私の見方では、すでにWispr FlowやChatGPTの音声機能で頻繁に音声入力しているなら、自分にとって話すほうが速いかどうかはわかっているはずです。そうでなければ、Subvocalで考えが変わる可能性は低いでしょう。
Subvocalの価格は?
SubvocalのEarly Bird価格は1個あたり$499で、返金可能な$199のデポジットで予約できます。予約注文ページでは、取り消し線の付いた$699と並べて$499が表示されています。YCのローンチ投稿では、"a special $200 early bird discount on the final price."と説明されています。
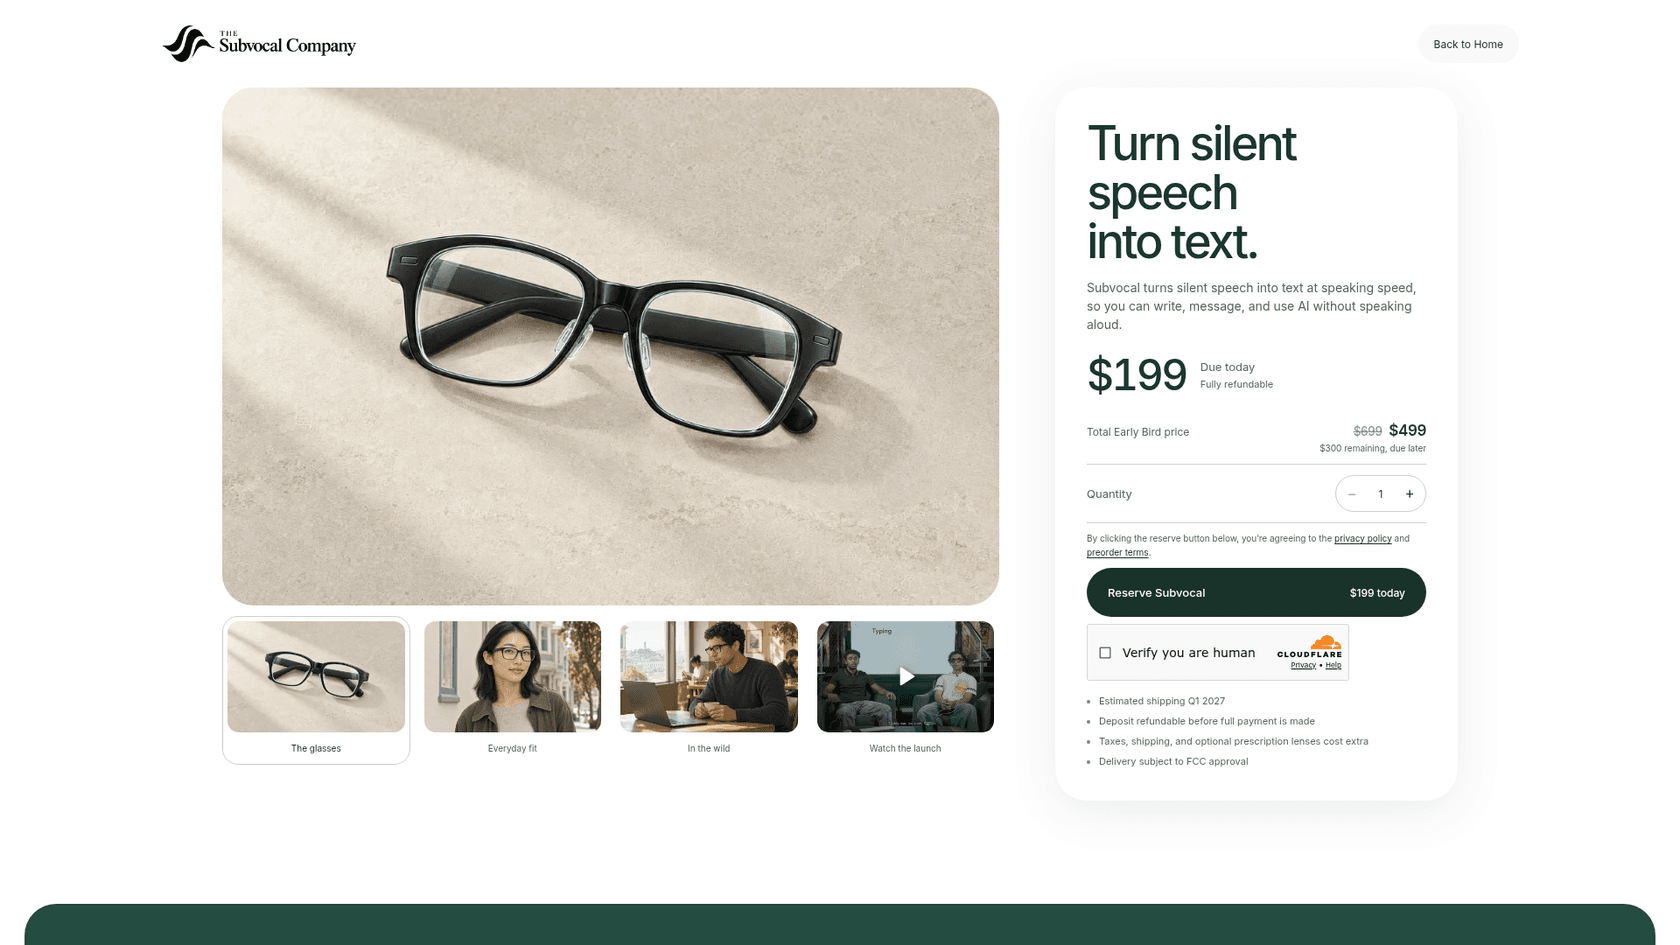
予約注文規約で確約されている内容は、次のとおりです。
| 項目 | Subvocalの説明 |
|---|---|
| 本日支払うデポジット | 1個あたり$199、最終支払い前なら全額返金可能 |
| Early Bird価格 | 1個あたり$499($699には取り消し線を表示) |
| 後日支払う残額 | 1個あたり$300 |
| 残額の請求方法 | 自動請求は一切なし。メールが届き、支払い期限は30日 |
| 含まれないもの | 税金、送料、度付きレンズ、オプションのアクセサリー |
| 返金 | 最終支払い前ならいつでも可能、キャンセル料なし、7営業日以内に手続きを開始 |
| 紹介クレジット | 自分のリンクから3人が予約すると残額から$100割引 |
| 出荷予定 | 2027年第1四半期、"not a guaranteed delivery date"、FCCの承認が条件 |
| 注文できる人 | 配送先は米国内のみ、購入者は18歳以上 |
| 仕様 | 未公開。"Final specifications are still being developed" |
| 返品ポリシーと保証 | 現時点では未公開、最終支払い前に開示 |
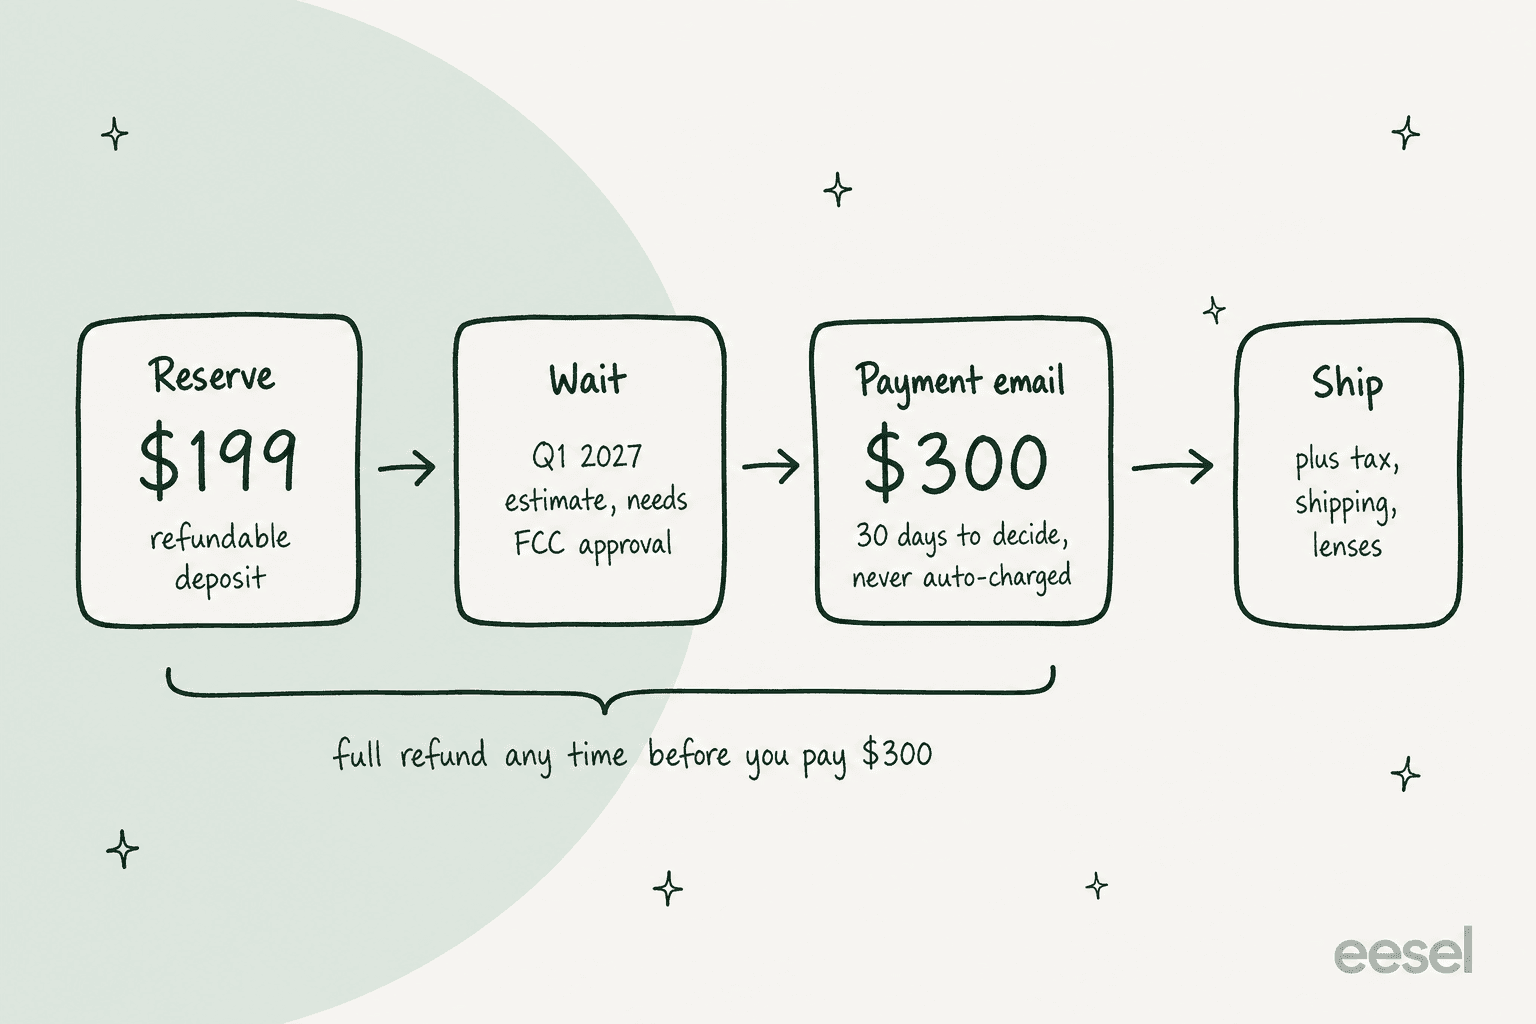
この規約は、私が読んできた大半のハードウェア予約注文よりも購入者に配慮されています。自分で支払うと決めない限り、請求されることはありません。また、Subvocalが製品に重大な変更を加えた場合は、キャンセルしてデポジットの返金を受けられます。予約の実質的なコストは、数か月間$199をスタートアップに預けることです。そして、最終製品がデモどおりになるかに賭けることになります。
ページに載っていない情報も、同じくらい重要です。バッテリー持続時間、重量、対応環境の一覧はありません。FAQには、"ChatGPT, Claude, Cursor, Slack, email, documents, messaging, and anywhere else you'd normally type,"向けに開発しているとありますが、これは目標であって、動作確認済みの一覧ではありません。
SubvocalはAlterEgo、EchoSpeech、MetaのNeural Bandとどう違うのか?
Subvocalは初の無声入力デバイスではなく、"this already exists"という反応はすぐに寄せられました。違いは、普通の見た目のメガネで自由なテキスト入力を目指している点です。現在、ほかの製品でそれを販売しているものはありません。
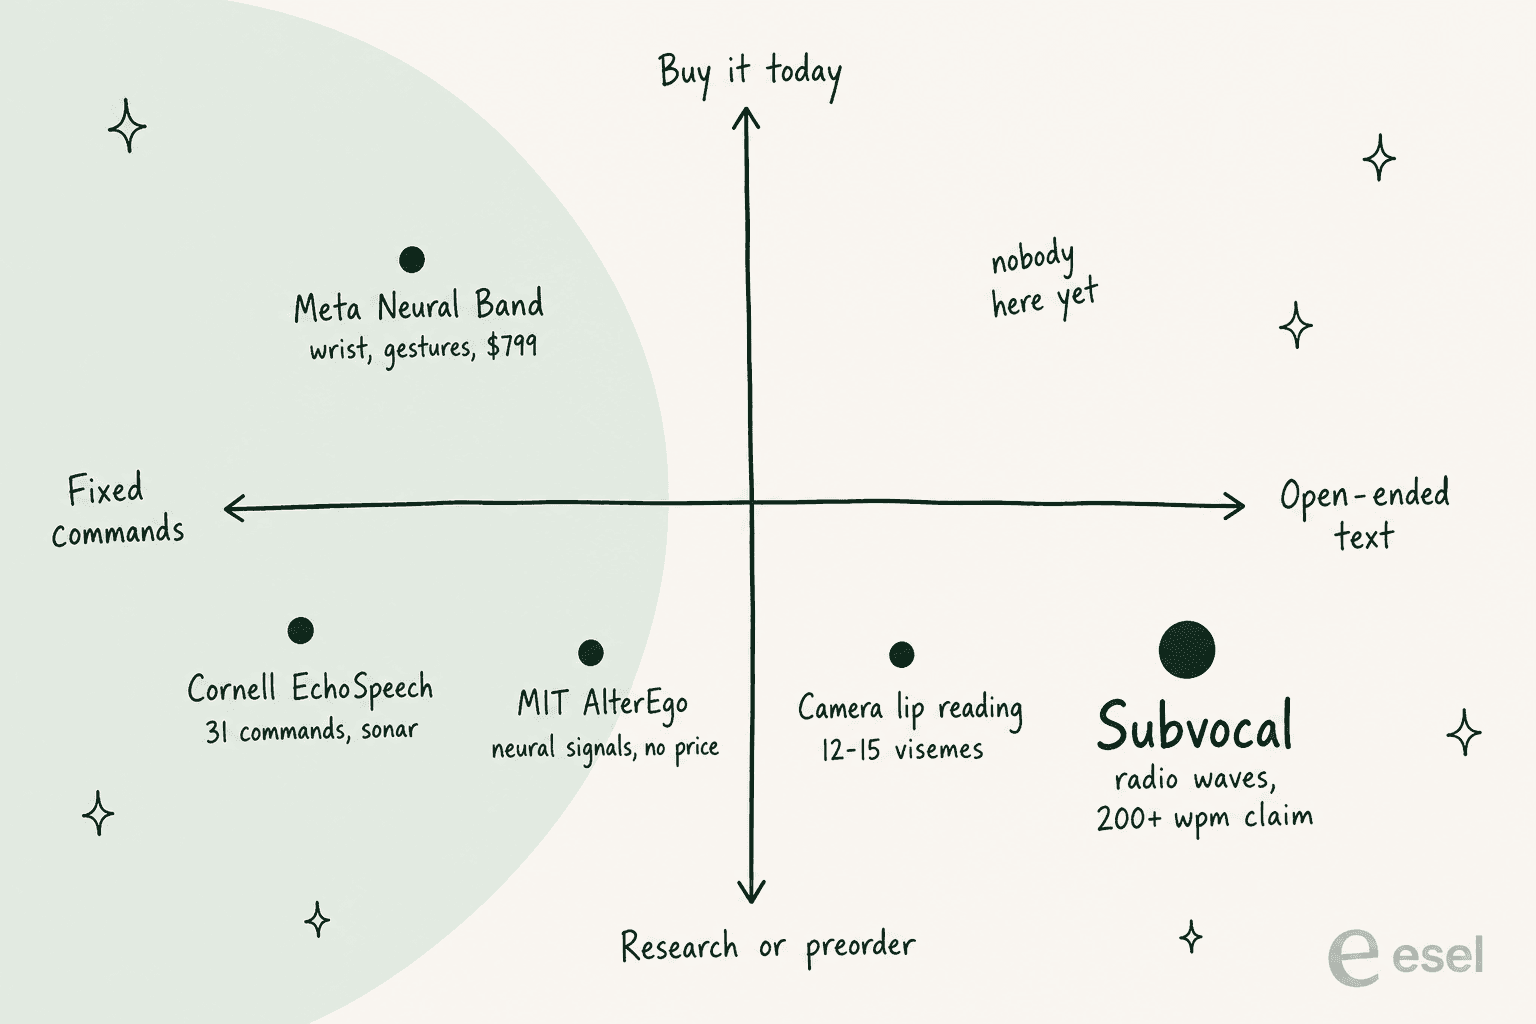
| 製品 | 検知方法 | 出力するもの | 購入できるか? |
|---|---|---|---|
| Subvocal | メガネから顔を通過する電波 | 自由なテキスト、公称毎分200+語 | 予約注文、$499、2027年第1四半期予定 |
| MIT AlterEgo | 内的な発話動作による神経信号 | 無声発話、目に見える動きはないと説明 | いいえ。2025年初頭にスピンアウトし、alterego.ioでは登録のみ受付 |
| Cornell EchoSpeech | メガネに搭載した小型スピーカーとマイクによるソナー | 最大31のコマンド、精度は約95% | いいえ。2023年の研究用試作機 |
| Meta Ray-Ban Display + Neural Band | 指の筋肉を読み取るEMGリストバンド | ジェスチャー、手書き入力は後日対応予定と発表 | はい、発売時は$799から |
最も近いのはCornellのEchoSpeechです。こちらもメガネのフレームに収まり、カメラを使いません。比較のポイントになるのは、その制約です。認識できるのは固定された31のコマンドでしたが、クラウドなしでスマートフォン上で動作し、1回の充電で約10時間使えました。
目立ちにくさではAlterEgoがさらに踏み込み、外から見える動きは一切ないとうたっています。一方、Subvocal自身のFAQでは、近くにいる人は"may notice slight movement."と説明しています。Metaのバンドは唯一購入できるものですが、読み取るのは口ではなく指です。これは、MetaのAI製品全体で進むウェアラブルへの展開の一部です。つまり、現在のSubvocalの実質的な競合は、別の無声発話デバイスではありません。音声入力ソフトウェアとキーボードです。
Subvocalに対してどんな声が上がっているのか?
反応は3つに分かれました。一日中AIに音声入力している人の期待、製品が本当に存在するのかという疑念、そして人前で装着することへの抵抗感です。
期待しているのは主に、すでにClaude CodeやCodexのようなコーディングエージェントに話しかけている人たちです。Subvocalのホームページにある"control your coding agents without annoying your coworker"という言葉が表すのと同じ壁にぶつかっています。
"I already dictate a lot of my agent instructions. The problem is that you can't do that in an office or on a plane. This could fix it."
懐疑的な人たちの主張は2つありました。1つは、製品写真が生成画像に見えるというものです。モデレーターが入り、2つの問題を切り分けました。
"They're taking pre-orders. Obviously the product doesn't exist yet. The tech is real."
もう1つは、簡単に模倣できるという主張です。"I recreated subvocal in 9 minutes with one prompt for AirPods Pro 3"というJoe Blauの投稿には、10,199件のいいねが付きました。Hacker Newsでの創業者の返信でYadavは、そのような方法で実現できるのは"a 5 word classifier"程度にとどまると述べています。これは、EchoSpeechの定型コマンド研究もおおむね位置する水準です。
そして、人間側の事情もあります。声を出さずに口を動かすのは、試してみるまでは簡単に聞こえます。
"For the ones thinking this is great, have you actually tried to talk without making sounds? I don't think it is an intuitive action at all and I became self-conscious about not making a sound rather than talking like I normally would."
プライバシーも話題になりました。主な理由は、デコード処理がクラウドで行われることです。
"Can this be made to work offline, without a cloud server? I wouldn't want my words to be passed through an API"
最も希望を感じさせるスレッドは、タイピングや発話に負担を感じる人たちによる、アクセシビリティについてのものでした。
"This is also neat thing to have with people struggling with typing (RSI, injuries, disabilities)... people find they're hurting their vocal chords pretty quickly."
私は、この最後のグループにとってこそSubvocalが最も大きな意味を持つ可能性があると思います。同時に、$499を支払う前に公開された精度の数値を最も必要としているのも、この人たちです。
Subvocalを予約注文すべきか?
毎日AIツールに音声入力し、声を出せない場所で働いていて、少なくとも2027年第1四半期まで待つことに抵抗がないなら、Subvocalを予約注文してもよいでしょう。残額を支払うと決めるまでは$199が返金可能なので、失う可能性があるのはお金ではなく時間です。
次に当てはまるなら、今は見送りましょう。
- 初日から確実に使える必要がある場合。 仕様、保証条件、精度の数値は、まだいずれも公開されていません。
- 米国外に住んでいる場合。 支払いを伴う予約注文は米国限定です。
- 機密性の高いテキストを扱う場合。 クラウドが必須で、センサーデータのプライバシーに関する通知はまだ公開されていません。現在のプライバシーポリシーが対象としているのは、ウェブサイトと予約注文のみです。
- 今は音声入力を使っていない場合。 まず無料の音声入力かWispr Flowを試してみてください。声に出しても速くならないなら、声を出さずに話しても速くはなりません。
以前のAIガジェットであるRabbit R1などが示してきたように、3人のチームが作るハードウェアには、デモから店頭に並ぶまで長い道のりがあります。少なくともSubvocalの規約は、その道のりが長引いた場合に、デポジットを取り戻して離れられるように書かれています。
サポートチームにとってタイピング速度は重要か?
思うほど重要ではありません。Subvocalは言葉をコンピューターに入力する速度を上げる手段であり、創業者たちはこれをAIエージェントへの移行の中に位置付けています。その中では、"our job moves upstream, to structured and detailed prompting."としています。別の言い方をすれば、プロンプトエンジニアリングです。知識労働が向かう方向について、妥当な見方です。ただし、サポート担当者にとって返信で時間がかかるのはタイピングではありません。注文、ポリシー、前回の会話を探す作業であり、それが平均処理時間を押し上げています。
その隙間を埋めるのが、AIヘルプデスクチームメイトです。エージェントアシストを一歩進めたように働き、人がチケットを開く前に情報を調べ、下書きを作成します。Zendeskを使う個人レッスンブランドのグループであるLesson Proは、この形でeeselを運用しています。1か月で約1,900件のチケットを処理し、背景情報と次の手順を記した社内メモを約1,700件残し、人が承認して送信するための返信を約560件下書きしました。このチームでは、誰も毎分200語で入力する必要がありません。最初の下書きはすでにできているからです。
同じパターンは、サポート以外でも見られます。SamCartは、Freshdeskのチケットに1つ、ウェブサイトのチャットにもう1つのeeselエージェントを配置し、それぞれが280件のヘルプセンター記事をもとに回答しています。この考え方をもっと広く知りたいなら、AIチームメイトが自分で操作する必要のあるツールとどう違うのか、そしてAI従業員が日々実際に何をするのかを、こちらで紹介しています。
そして、コーディングエージェントに話しかけるというSubvocalのビジョンに共感するなら、eeselにはまさにそのようなユーザー向けに作られたCLIがあります。同じeeselチームメイトをターミナルで使えるようにするものです。ダッシュボードを開かずに、チャットし、ヘルプデスクを接続し、ナレッジをアップロードし、自動化を組み込み、保留中のアクションを承認できます。すべてのコマンドがJSONを出力するので、Claude Code、Cursor、Codexのようなコーディングエージェントが設定全体を代わりに実行できます。そこで設定した内容は、ダッシュボードにも表示されます。指示を入力しても、声で伝えても、いつか口の動きで伝えるようになっても、作業を受け取るのは、すでにヘルプセンターの内容を知っているチームメイトです。
eeselを試す
Subvocalは書く速度を上げます。eeselは、チームが書かなければならない量を減らします。AIヘルプデスクチームメイトがZendesk、Freshdesk、その他のヘルプデスクに加わり、過去のチケットとヘルプセンターから学習します。そして、どこまで信頼して任せるかに応じて、返信を下書きしたり送信したりします。実際の顧客に対応させる前に、自社の過去のチケットでシミュレーションできます。無料でeeselを試して、どれだけの返信を代わりに書けたか確かめてみてください。
