

要点
私のKimi K3.1 Proの評価は5点満点中3.5点です。Claude Opus 5.5にほぼ匹敵する思考力を持ち、Artificial Analysis Intelligence Indexでは55.1を記録しています(215モデル中4位)。料金は100万トークンあたり入力$2、出力$10です。 実行したまま放置できる長時間の無人エージェント作業なら、現時点でランキング上位の中では最もコストパフォーマンスに優れています。
減点の理由は賢さではなく、動作の仕方です。毎秒約50トークンと遅く、長い回答を書くため低価格のメリットが薄れます。オープンウェイトは"by Nov 4"と約束されているものの未公開で、Kimi Codeの利用者からは5時間枠の上限を1時間足らずで使い切ったという報告もあります。時間をかけられる作業にはAPI経由で利用し、人を待たせる用途には使わないことをおすすめします。
サポートエージェント用のモデル選びでこの記事にたどり着いたなら、モデル自体は判断のうち重要度の低い部分です。私はeeselの連携機能とAPIを開発していますが、実際のヘルプデスクのチケットキューでAIを何年も運用してきた経験では、品質を決めるのはモデルの周りの仕組みです。SamCartはFreshdeskのチケットとウェブサイトのチャットでeeselを運用し、ヘルプセンターの280件の記事に基づいて回答しています。その週にどのモデルがランキングの首位になったかを気にすることはありません。
Kimi K3.1 Proとは?
Kimi K3.1 ProはMoonshot AIのフラッグシップモデルで、2026年10月23日に公開されました。Moonshotは公開時のブログで、これを"a post-trained version of Kimi K3, with substantially larger post-training compute"と呼んでいます。つまり、Kimi K3と同じ2.8Tパラメータのベース(アクティブパラメータ104B、混合エキスパート)に、はるかに多くの追加学習を施したもので、1Mトークンのコンテキストウィンドウも備えています。
Kimiアプリ、Kimi Work、Kimi Code、Kimi APIで利用でき、現在はkimi.comのチャットボックスのデフォルトモデルになっています。公開内容の全体像(ベンチマーク、K3との比較、利用方法)を知りたい方は、私のKimi K3.1 Pro概要記事をご覧ください。この記事では、以前のKimi K3レビューと同じ形式で評価をまとめます。
Kimi K3.1 Proをどのように検証・採点したか?
Moonshotの公開時のブログ、APIクイックスタート、料金ページを読み、Artificial Analysisの独立した評価結果と、674件のコメントが付いたHacker Newsのスレッドを含む初期の実機テストに目を通しました。公開から4日しか経っていないモデルなので、何か月も本番運用したかのように装うつもりはありません。私にできるのは、これを使って構築する価値があるかどうかを左右する項目で採点することです。
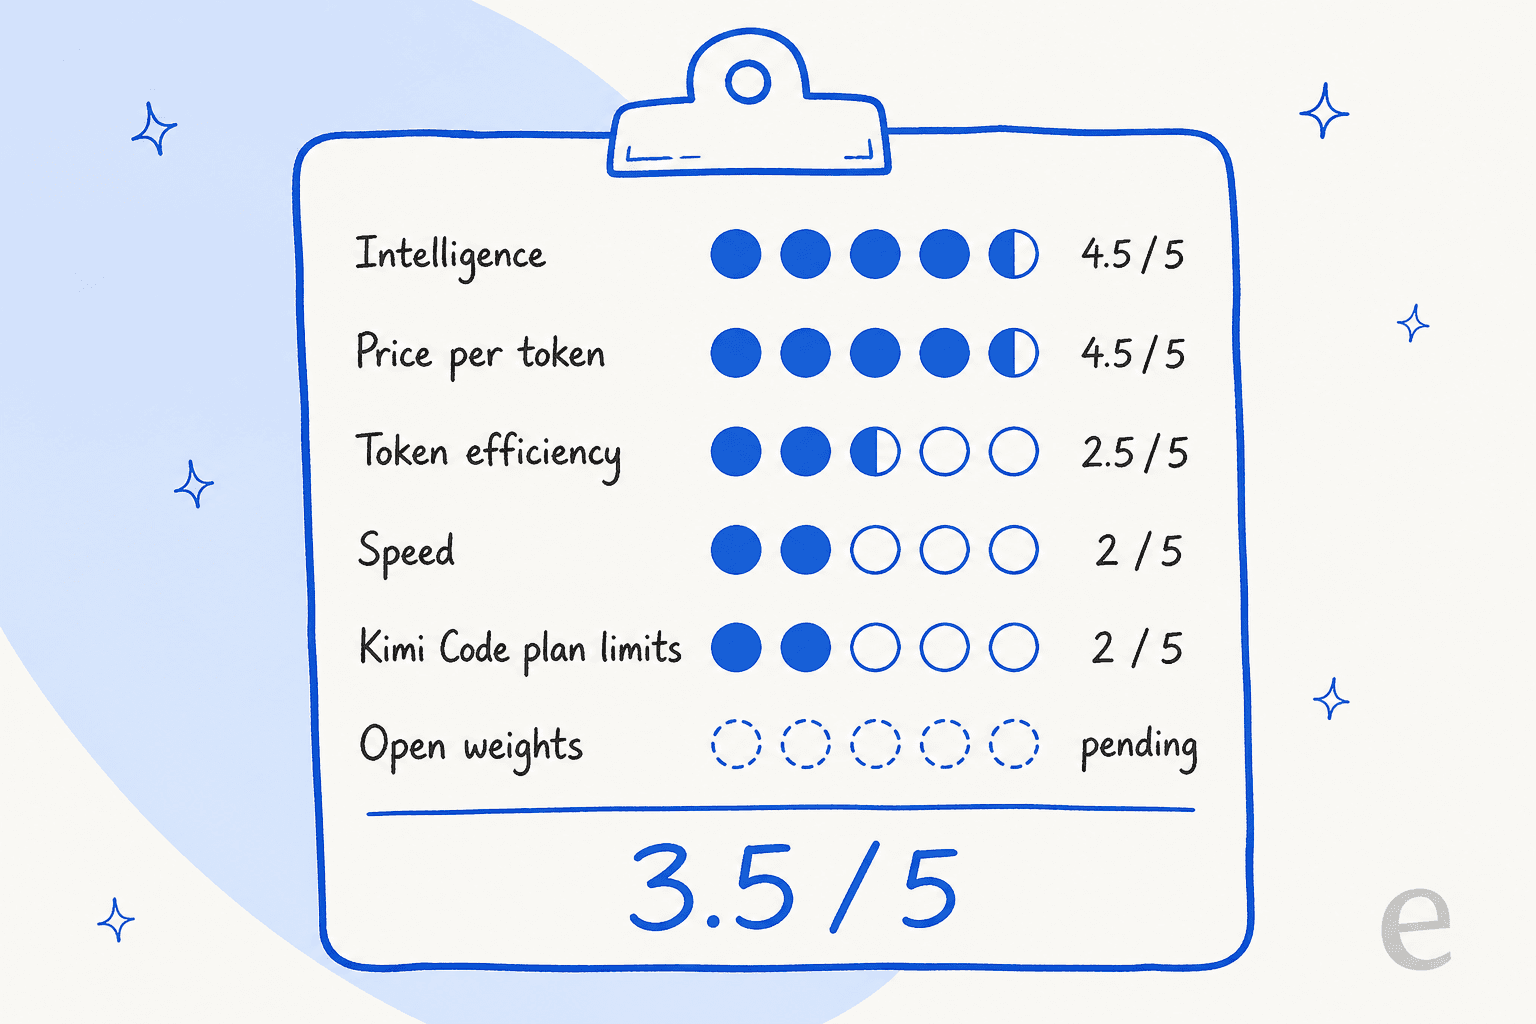
| 項目 | 評価 | 理由 |
|---|---|---|
| 知能 | 4.5/5 | AA指数で55.1、Opus 5.5 (Max)との差は2.5ポイント |
| トークン単価 | 4.5/5 | $2 / $10、K3より3分の1安く、長いコンテキストへの追加料金なし |
| トークン効率 | 2.5/5 | AA指数の実行に出力トークン150Mを使用、他モデルの中央値は87M |
| 速度 | 2/5 | 毎秒49.7トークン、182モデル中165位 |
| Kimi Codeのプラン上限 | 2/5 | 複数の利用者が、5時間枠の上限に1時間未満で達したと報告 |
| オープンウェイト | 保留 | 11月4日までの公開を約束、10月27日時点では未公開 |
| 総合 | 3.5/5 | エンジンは強力ですが、利用面には粗さが残ります |
Kimi K3.1 Proの強みは?
一言で言えば、米国以外の研究機関がランキングの首位に最も近づいたモデルでありながら、価格は中位クラスです。その強みが表れる点を見ていきます。
$2と$10で最先端に迫る推論能力
Artificial Analysisでは、K3.1 Proのスコアは55.1で、Claude Opus 5.5 (Max)は57.6、Claude Sonnet 5.5 (Max)は56.0です。52.7のGPT-6 Astra (Max)と、52.6のGemini 4 Argon (High)を上回っています。同じバージョンの指数でKimi K3は43.6なので、今回は同じベースモデルから11ポイント以上伸びたことになります。
注目すべきなのは価格です。Kimi APIでのK3.1 Proの通常料金は100万トークンあたり入力$2、キャッシュ済み入力$0.20、出力$10です。Kimi K3の料金より3分の1安く、Sonnet 5.5と同じ通常料金です。Artificial Analysis指数全体の実行コストは$3,117で、Opus 5.5 (Max)の$8,708を下回りました。
長時間のエージェント作業とオフィス業務
追加学習の効果が表れるのはここです。Artificial Analysisが測定したTerminal-Bench 4.0のスコアは67.2%で、同社のK3.1 Proページに掲載された全モデルの中で最高でした。K3の12.6%から大きく伸びています。Moonshot独自のテストでは、SWE Marathon(51.7、Opus 5.5は46.3)と、金融・オフィス文書のベンチマークであるOfficeQA Pro v2(64.4、比較対象は62.2)でリードしています。
K3よりも事実をでっち上げることも減りました。Moonshot社内のHallu Benchでは、ツールを使う難しい質問での主張単位のハルシネーション率が23.4%から8.3%に低下しました。これはMoonshot自身のテストなので重くは見ていませんが、独立した評価の数値も同じ方向を示しています。AAのハルシネーション率はK3.1 Proが43.9%、K3が53.2%、Opus 5.5 (Max)が58.6%です。
初期の実機レポートもこれと一致しています。ある開発者はK3からすぐに乗り換えました。
"Using it now via API (3.1 Pro on Open Router) in a HITL setup (Cline in VSCode). Off-hand it's quite good. I've been using K3 for the past few months almost exclusively for coding work and have been stunned by how good it is. Excited to see how far 3.1 Pro can be pushed."

単価が変わらない1Mコンテキストウィンドウ
クイックスタートによると、K3.1 Proはコンテキスト長による段階料金のない、単価一律の従量課金です。そのため、900,000トークンのプロンプトでも、トークンあたりの料金は短いプロンプトと同じです。キャッシュ済み入力は100万トークンあたり$0.20で、90%引きになります。キャッシュの保持時間はデフォルトで5分、オプションで1時間の区分もあります。毎ターン大規模なコードベースや長い契約書を読み直すエージェントでは、積み重なると大きな節約になります。
Kimi K3.1 Proの弱点は?
減点につながったものはすべてモデルの内部ではなく、その周りにあります。今このモデルを使って構築するかどうかを左右するのは、次の5つの問題です。
速度が遅い
Artificial AnalysisはMoonshot自身のAPIで毎秒49.7出力トークンと測定し、182モデル中165位で、"notably slow"と評しました。同社のベンチマーク指数では、1タスクの平均所要時間は1,011秒、約17分でした。Moonshotの対策はKimi K3.1 Pro Highspeedで、料金がちょうど2倍($4 / $20)になる代わりに、"2-3× the speed"で動作するとしています。
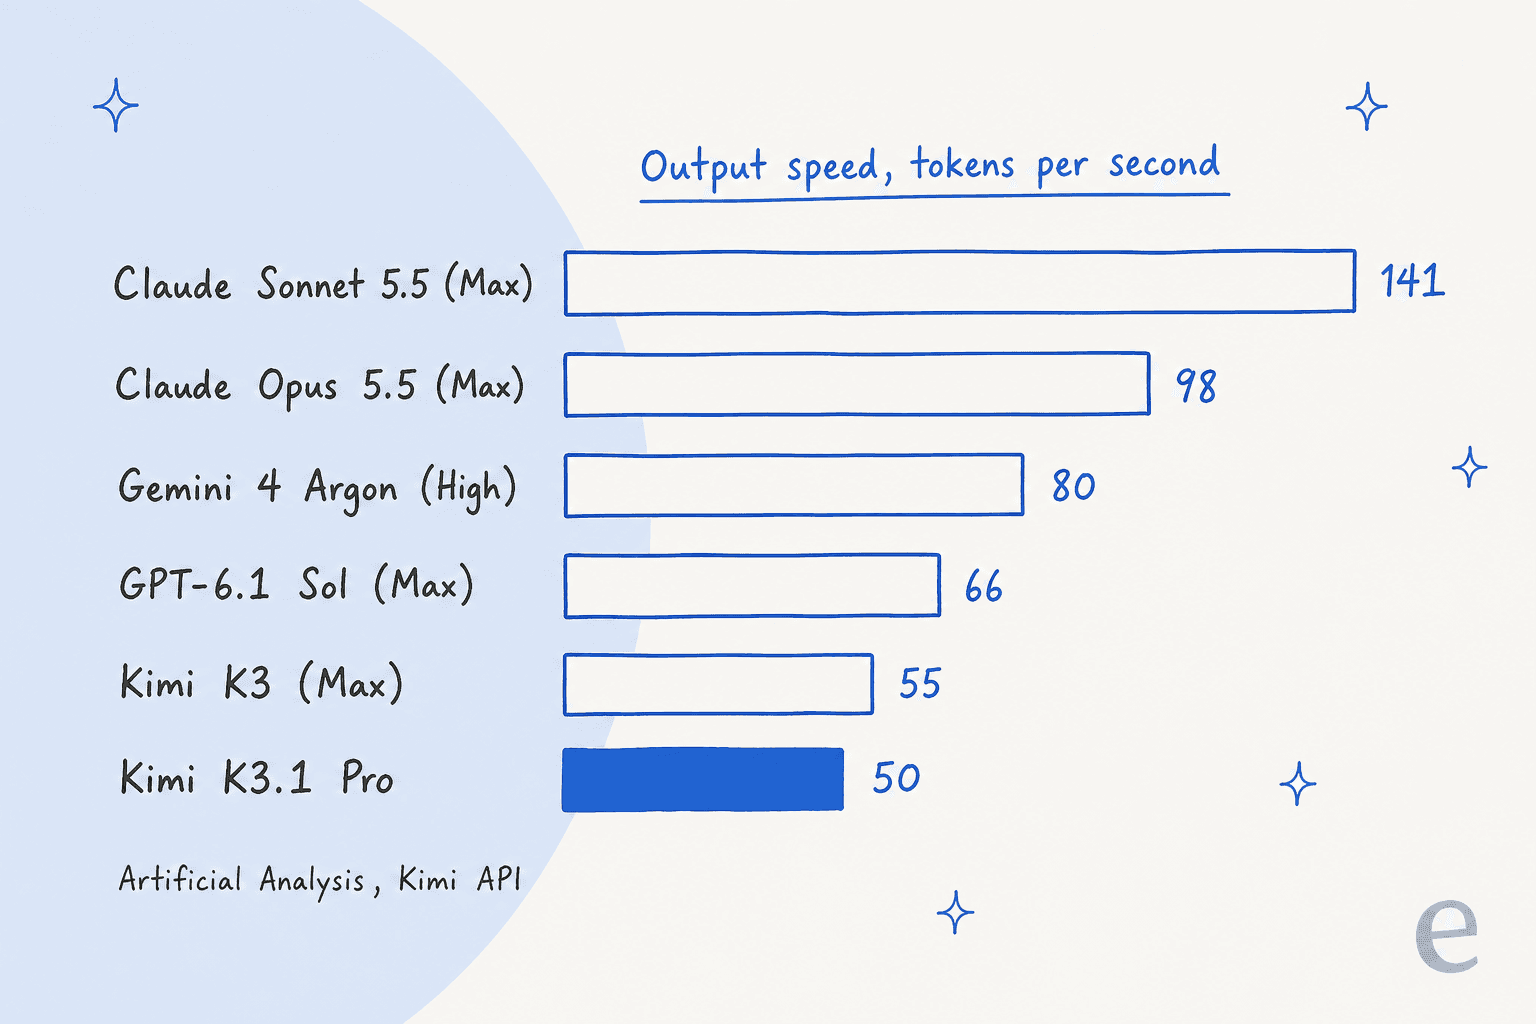
Sonnet 5.5はトークン単価が同じで、ストリーミング出力はほぼ3倍速いです。 夜間に実行するバッチ処理なら、毎秒50トークンでも問題ありません。人が画面を見つめて待つチャットでは、そうはいきません。
出力が長い
K3.1 ProはArtificial Analysis指数の実行に出力トークン150Mを使い、他モデルの中央値は87Mでした。その大部分は推論で、1タスクあたりの推論トークンは平均34,883です。そのため、トークン単価の割安さがそのまま請求額に反映されるわけではありません。1タスクあたりの平均は$2.11で、通常料金が$3 / $15のK3は$2.00でした。この計算の詳細はKimi K3.1 Proの料金の記事で解説しています。
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
調整できるのはreasoning_effortです。APIはlow、high、maxに対応しており、APIキーページにはデフォルトがmaxと記載されています。上記のベンチマーク数値はすべてmaxで測定されたものなので、推論の強度を下げれば、スコアと引き換えにトークンを節約することになります。
Kimi Codeはすぐに上限に達する
公開時のスレッドで最も目立つ不満は、品質ではなく利用枠です。KimiのKimi Codeページでは、月額料金はPlusが$19、Proが$39、Maxが$99、Ultraが$199と記載されています。HighspeedにはPro以上が必要で、クレジット消費は2倍です。新しいプランにもローリング方式の5時間枠があり、さらにKimiアプリと共有する月間クレジット枠があります。
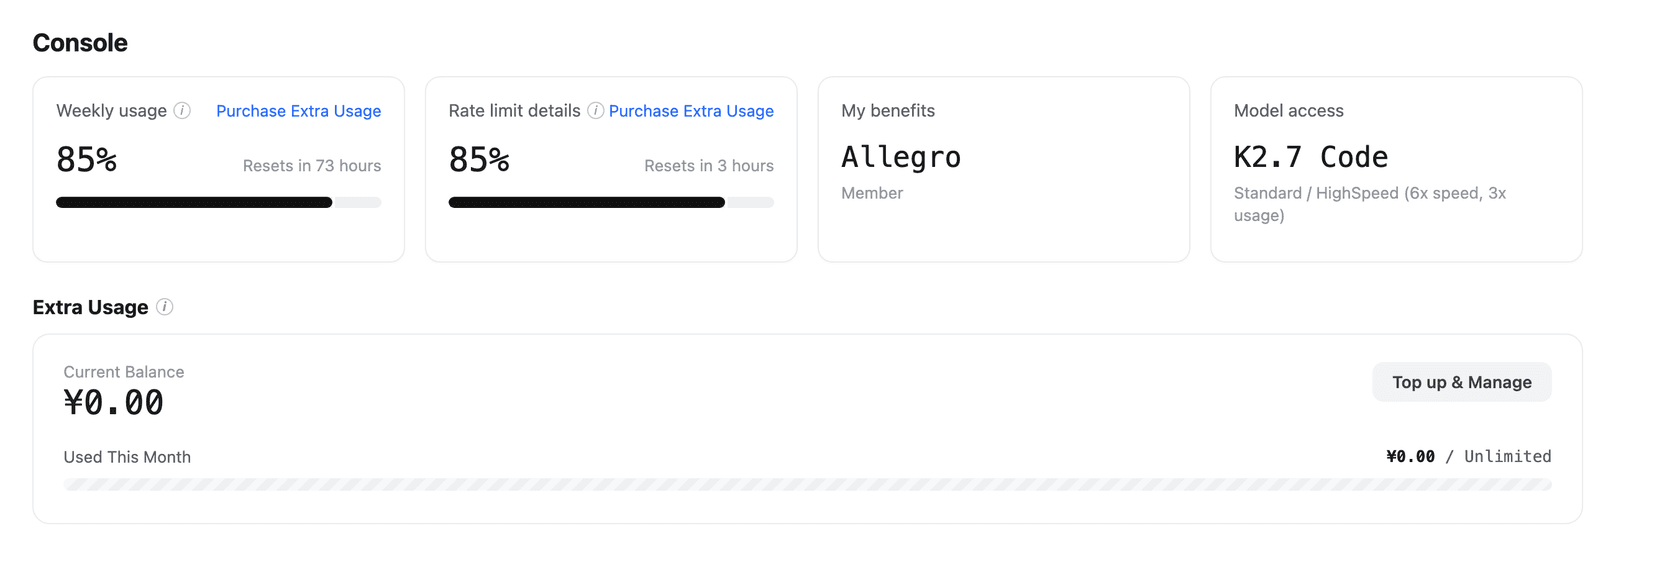
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
全員が上限にぶつかったわけではありませんし、デフォルトの推論強度がmaxでトークンの消費が速いことも要因の1つです。それでも、Claude Codeから移行し、同じ金額で同じ程度の余裕を期待するなら、年払いにする前に月額プランで1週間試してください。
ウェイトはまだ公開されていない
MoonshotはK3.1 Proを"most capable 3T-class open-weight model"と呼び、ブログとクイックスタートの両方で、完全なウェイトを11月4日までに公開するとしています。10月27日時点で、Hugging FaceのモデルAPIはMoonshotのアカウントにK3.1のリポジトリを返さず、Artificial Analysisも現時点ではライセンスをプロプライエタリと記載しています。
これが重要なのには2つの理由があります。まだセルフホストもファインチューニングもできず、実際に提供しているのはMoonshotだけです。OpenRouterの掲載ページには2つのエンドポイントが表示されていますが、どちらもMoonshot自身のものです。Artificial Analysisが数えているAPIプロバイダー数はK3.1 Proが5、K3が20です。ウェイトが公開されても、2.8Tパラメータのモデルに必要なのはワークステーションではなくサーバークラスターです。
注目されるベンチマークの一部は社内テスト
Moonshotの最も強い主張のいくつかは、Kimi Code Bench、Hallu Bench、金融ベンチマーク、サイバー評価といった社内テストに基づいています。コーディングベンチマークはClaude Codeのハーネスで実行されており、フォロワーの多いXアカウントの1つが公開当日に疑問を呈しました。独立したArtificial Analysisの数値も依然として優秀なので、ベンチマークに中身がないとは思いません。ただ、私なら独立した評価を先に信頼します。
Kimi K3.1 ProはClaude、GPT、Geminiと比べてどうか?
以下の数値はすべてArtificial AnalysisのK3.1 Proページから引用したもので、各メーカー自身のAPIで測定されているため、同じ条件で比較できます。
| モデル | AA指数 | 入力 / 出力料金(1Mあたり) | 速度(トークン/秒) | タスクあたりのコスト | 指数の実行コスト | Terminal-Bench 4.0 |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | 57.6 | $4 / $20 | 98.1 | $5.98 | $8,708 | 59.6% |
| Claude Sonnet 5.5 (Max) | 56.0 | $2 / $10 | 141.3 | $5.46 | $7,260 | 63.6% |
| Kimi K3.1 Pro | 55.1 | $2 / $10 | 49.7 | $2.11 | $3,117 | 67.2% |
| Claude Fable 5.1 (Max) | 53.4 | $10 / $50 | 69.8 | $7.63 | $13,129 | 52.0% |
| GPT-6 Astra (Max) | 52.7 | $10 / $50 | 66.7 | $3.26 | $5,324 | 59.1% |
| Gemini 4 Argon (High) | 52.6 | $2 / $10 | 79.7 | $1.62 | $2,101 | 57.1% |
| GPT-6.1 Sol (Max) | 51.8 | $2 / $10 | 65.9 | $0.72 | $1,082 | 56.1% |
| DeepSeek V4.1 Flash 1017 (Max) | 45.1 | $0.30 / $1.20 | 169.3 | $0.26 | $445 | 33.8% |
| Kimi K3 (Max) | 43.6 | $3 / $15 | 54.5 | $2.00 | $3,658 | 12.6% |
目を引く点が2つあります。まず、スコアが55以上のモデルの中では、K3.1 Proの実行コストが圧倒的に低いことです。次に、賢いモデル全体で見れば最安ではないことです。GPT-6.1 SolとGemini 4 Argonは、タスクあたりのコストを大幅に抑えながら、スコアは3〜4ポイント差に収まっています。K3.1 Proの得意な立ち位置は「Claudeに近い水準を、Claudeの請求額の3分の1で」であって、「使いものになる中で最安」ではありません。
使用感については、実際に試した人たちの多くが、ベンチマークでは捉えきれない優位性がまだOpusにあるという点で一致しています。
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
"TLDR: Kimi is a good model, especially for visual work, but I still find Opus 5.5 more useful for general-purpose tasks and white-collar work."
特にほかのオープンモデルと比較しているなら、私のQwen 3.8 MaxとK3の比較とDeepSeek V4 FlashとK3の比較は、今でも周辺の選択肢を把握するのに役立ちます。Kimi K3の代替モデルのリストも、候補を絞り始めるのに適しています。
Kimi K3.1 ProのAPIは開発で使いやすいか?
私が日々取り組んでいる連携開発の観点では、すっきりしたAPIですが、いくつか注意点があります。モデルIDはkimi-k3.1-proとkimi-k3.1-pro-highspeedで、ドキュメントにはストリーミング、画像入力、ツール呼び出し、構造化出力、そして"Dynamic tool loading"機能が記載されています。
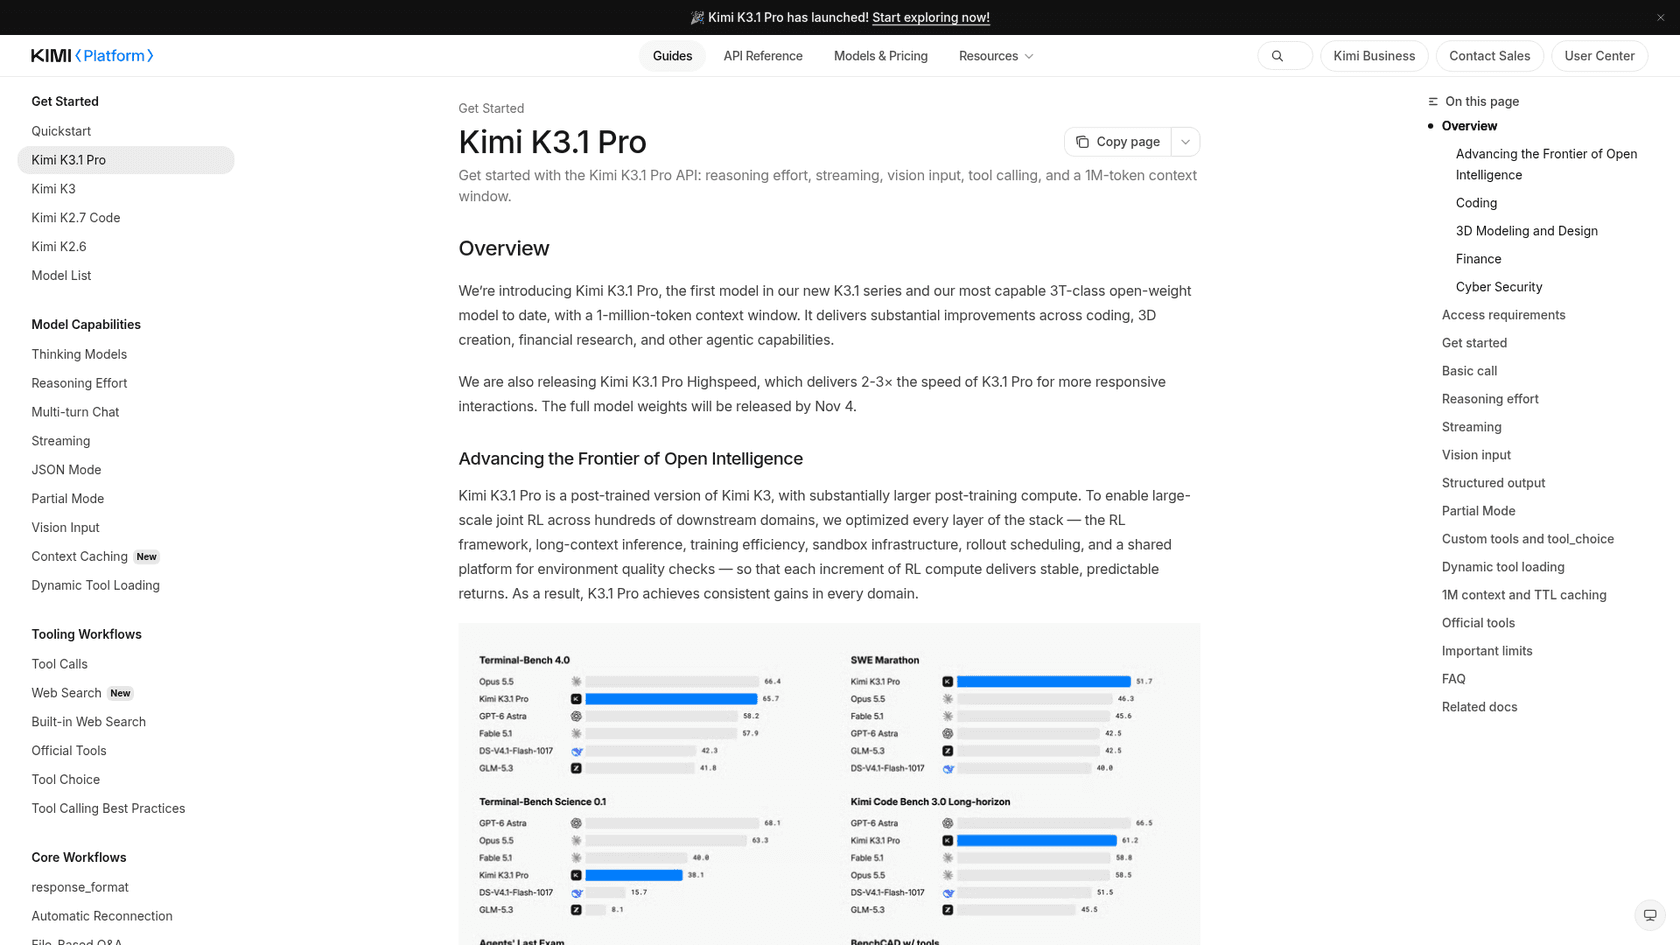
コードを1行でも書く前に知っておきたいのは、次の点です。
- $1のチャージでアクセスが有効になり、レート制限は累計チャージ額によって決まります。$1の区分では1分あたり
3リクエストです。レート制限のページによると、100RPMに達するには累計$10が必要です。 - K3.1 Proにバッチ割引はありません。 KimiのバッチAPIは通常料金の60%ですが、対象はK2シリーズのモデルだけです。
- 推論は常に有効で、
max_completion_tokensのデフォルトは131,072です。長い回答を前提に予算を組んでください。 - 公開時のブログによると、API顧客はZero Data Retentionを利用できます。
- K2モデルは提供終了に向かっています。 新規ユーザーは2026年10月31日からK2にアクセスできなくなり、すべてのK2モデルは12月末までに停止する予定です。そのため、Kimi K2.7 Codeを使っているなら、いずれにしても移行することになります。
少ない費用で試作に使える高性能モデルが主な目的なら、どこかにチャージする前に、私の無料AI APIのまとめも一読する価値があります。
Kimi K3.1 Proはどんな人に向いているか?
選ぶべきなのは、品質が重要で、誰も待っていない長時間の無人作業を実行する場合です。エージェントによるコーディング作業、調査レポート、スプレッドシートを多用する金融業務、膨大なコンテキストにまたがる文書処理などが該当します。長いコンテキストへの追加料金なしで、Opusに近い品質を約3分の1の実行コストで得られます。
見送るべきなのは、毎回の応答を人が待つ場合です。毎秒50トークンでは、ライブチャットや素早いやり取りを伴うコーディングはもたついて感じられ、それを解消するHighspeedは料金が2倍になります。コスト最優先の場合も見送ってください。GPT-6.1 SolとGemini 4 Argonは、同じベンチマークのタスクをより低コストで完了します。また、今すぐ自分で実行できるウェイトが必要なら、11月4日にMoonshotが約束を守ることを確認できるまではK3を使い続けてください。
決め手は、待てるかどうかです。K3.1 Proは、開始したらその場を離れられる仕事のために作られています。
サポートチームはKimi K3.1 ProでAIエージェントを動かすべきか?
新しいモデルがランキングの上位に立つたびにこの質問が出ますが、私は最初に問うべきことではないと思っています。Kimi K3.1 Proはインフラです。これで1件のチケットに回答するだけでも、ヘルプデスクに接続し、ヘルプセンターと過去のチケットを同期し、何を単独で行い、何を人に引き継ぐかを決め、顧客が回答を見る前にテストする必要があります。eeselは、こうしたモデルの上で働く従業員です。
速度の問題も、ほとんどの用途よりサポートに強く響きます。チャットの顧客は、モデルが35,000の推論トークンを書き出す間、待ってはくれません。サポートでは、通常、優れた検索機能を備えた高速なモデルのほうが、より賢くても遅いモデルより役立ちます。
そして、サポートでの誤回答の多くは、モデルに原因があるわけではありません。eesel自身の営業面談から1つ例を挙げます。Zendeskを使う車両テレマティクスのサポートチームでは、ボットが非対応ブランドの顧客に"yes, we support your car model"と伝えていました。ナレッジベースに"we support all models"と書かれていたからです。ランキングがどれだけ上がっても、これは直りません。解決するのは、ナレッジの層でハルシネーションを防ぎ、公開前に実際の過去チケットでエージェントをシミュレーションすることです。だからこそeeselは、どの導入でもまずチームの過去チケットに対して実行します。
その層を担うのが、eeselのAIヘルプデスクチームメイトです。SamCartは、実際の運用がどうなるかを示しています。同社はFreshdeskのチケットとウェブサイトのチャットでeeselを使い、チャネルごとに別のエージェントを配置しています。どちらもヘルプセンターの同じ280件の記事に基づいて回答します。Freshdeskでは、人の担当者が割り当てられていない間だけエージェントが最初の返信を送り、チームメンバーがチケットを引き受けた瞬間に手を引きます。また、販売者が人との対応を求めたら、引き継ぎ用のタグをチケットに付けます。現在そのワークスペースでは、SamCartが2026年にリリースした2つ目の製品向けのものを含め、4つのエージェントが稼働しています。
Kimi Codeのようなツールの、エージェント中心・ターミナル中心のスタイルに魅力を感じるなら、eesel CLIがそれをサポート業務にもたらします。同じチームメイトをターミナルから操作できます。eesel activityで実行内容を確認し、eesel approvalsで保留中のアクションを承認または却下し、eesel instructionsで常時適用するルールを編集します。コマンドはJSONを出力し、書き込みコマンドは--dry-runに対応するため、スクリプトやコーディングエージェントから安全に操作できます。MCPサーバーもあります。AIエージェントCLIのガイドで、さらに詳しく解説しています。
eeselを試す
ヘルプデスクでAIに回答してほしくてモデルを探しているなら、その手順を1つ省きましょう。eeselのAIヘルプデスクチームメイトはFreshdesk、Zendesk、Gorgiasに接続し、ヘルプセンターと過去のチケットから学習します。そして、実際のチケットに対応する前に、先月のチケットにどう回答していたかを見せてくれます。
自分のチケットキューで無料でeeselを試すか、まずはほかのおすすめAIチームメイトと比較してみてください。AIを雇うか、自分で作るかをまだ迷っているなら、私のAI従業員の解説記事で違いを整理しています。
よくある質問
Kimi K3.1 Proは優秀ですか?
はい、適した仕事であれば優秀です。私のKimi K3.1 Proレビューでの評価は5点満点中3.5です。100万トークンあたり$2/$10で、Artificial Analysis Intelligence IndexではClaude Opus 5.5に近い55.1を記録しています。出力の遅さ、回答の長さ、Kimi Codeのプラン制限が減点要因です。Kimi K3.1 Proの概要では、リリースの全容を紹介しています。
Kimi K3.1 ProはClaude Opus 5.5より優れていますか?
総合的には、そうではありません。Artificial Analysisでは、Kimi K3.1 Proの55.1に対してOpus 5.5 (Max)は57.6を記録し、速度も約2倍です。コストではKimi K3.1 Proが勝っています。ベンチマーク指標全体の実行費用は、Opus 5.5 (Max)の$8,708に対して$3,117でした。私のClaude Opus 5.5レビューでは、この比較をもう一方の側から取り上げています。
Kimi K3.1 Proの料金はいくらですか?
Kimi APIでは、入力100万トークンあたり$2、キャッシュ済み入力は$0.20、出力100万トークンあたり$10です。Highspeed版は$4と$20です。Kimiアプリのプランは月額$19から$199です。詳しい内訳は、私のKimi K3.1 Proの料金ガイドで紹介しています。
Kimi K3.1 Proはなぜこれほど遅いのですか?
Artificial AnalysisがKimi APIで測定した出力速度は毎秒49.7トークンで、182件中165位でした。また、回答の前に長い推論を書き出します。ベンチマークのタスクには平均で約17分かかりました。Kimi K3.1 Pro Highspeedは、料金が2倍で速度は2-3倍です。速度を最も重視するなら、Claude Sonnet 5.5は同じ定価で毎秒141トークンの速度で動作します。
Kimi K3.1 Proはオープンソースですか?
まだ違います。Moonshotは2026年11月4日までにすべての重みを公開するとしていますが、10月27日時点ではHugging Faceのリポジトリもライセンスもありませんでした。Kimi K3は今すぐダウンロードできるオープンモデルです。私のオープンソースAIエージェント一覧では、ほかの選択肢も紹介しています。
Kimi K3.1 Proはコーディングに使う価値がありますか?
人が付き添わずに任せる長時間のコーディング作業なら、あります。Artificial AnalysisのTerminal-Bench 4.0では67.2%、MoonshotのテストではSWE Marathonで51.7を記録しました。リアルタイムのペアプログラミングでは出力の遅さが妨げになり、Kimi Codeのユーザーからは5時間枠の上限にすぐ達するという報告もあります。契約前にClaude Codeと比較してみてください。
Kimi K3.1 Proをカスタマーサポート用のAIエージェントに使えますか?
使えますが、モデルは必要な作業のほんの一部です。ヘルプデスクとの接続、引き継ぎルール、過去のチケットでのテストが別途必要ですし、毎秒50トークンではライブチャットの返信は遅く感じられるでしょう。eeselのような既製のAIヘルプデスクエージェントなら、その部分を任せられます。SamCartもこの方法でFreshdeskの初回返信を運用しています。