
Kimi K2.7 Codeの実体
Kimi K2.7 Codeは、公式のクイックスタートドキュメントによれば、Moonshot AIが「現時点で最も能力の高いコーディングモデル」と位置づけるものだ。同社の従来のフラッグシップだったKimi K2.6をベースに構築され、一般的な会話ではなく、長時間にわたるソフトウェアエンジニアリング、つまり単一セッション内での多くのステップにわたる計画立案、複数ファイルにまたがる編集、ツールの実行、デバッグに特化している。
内部的にはMixture-of-Expertsモデルであり、総パラメータ数は1兆、トークンあたり320億が活性化、384のエキスパートに分散(トークンあたり8個選択、1個は共有)し、256KトークンのコンテキストウィンドウとネイティブINT4量子化を備える。kimi-k2.7-codeと、約180トークン/秒(短いコンテキストでは最大260トークン/秒)に調整されたkimi-k2.7-code-highspeedの2種類が提供される。いずれも改変MITライセンスの下でリリースされており、ラッパーコードだけでなくウェイト自体も対象となっているため、これはオープンソースのラベルを貼っただけのAPI専用製品ではなく、真に開かれたモデルだと言える。
あらかじめ指摘しておくべき設計上の選択が一つある。思考モードを無効化できないという点だ。要求するかどうかにかかわらず、すべてのリクエストでモデルの完全な思考連鎖(チェーン・オブ・ソート)が実行され、temperature、top_p、ペナルティパラメータを固定のデフォルト値から変更しようとするとAPIはエラーを返す。Moonshotはこれを、複数ステップにわたるツール呼び出しの信頼性を高めるための意図的な設計判断だと説明している。だがこれは同時に、競合する多くのコーディングモデルと比べて、コストと遅延のバランスを調整する自由度が少ないことも意味する。
ベンチマーク、そしてその実際の位置づけ
Moonshotは、K2.6、GPT-5.5、Claude Opus 4.8との6つのベンチマーク比較を公開しており、それぞれ各モデル自身のエージェントハーネス(Kimi Code CLI、Codex xhigh、Claude Code xhigh)で実行されている。
| ベンチマーク | Kimi K2.6 | Kimi K2.7 Code | GPT-5.5 | Claude Opus 4.8 |
|---|---|---|---|---|
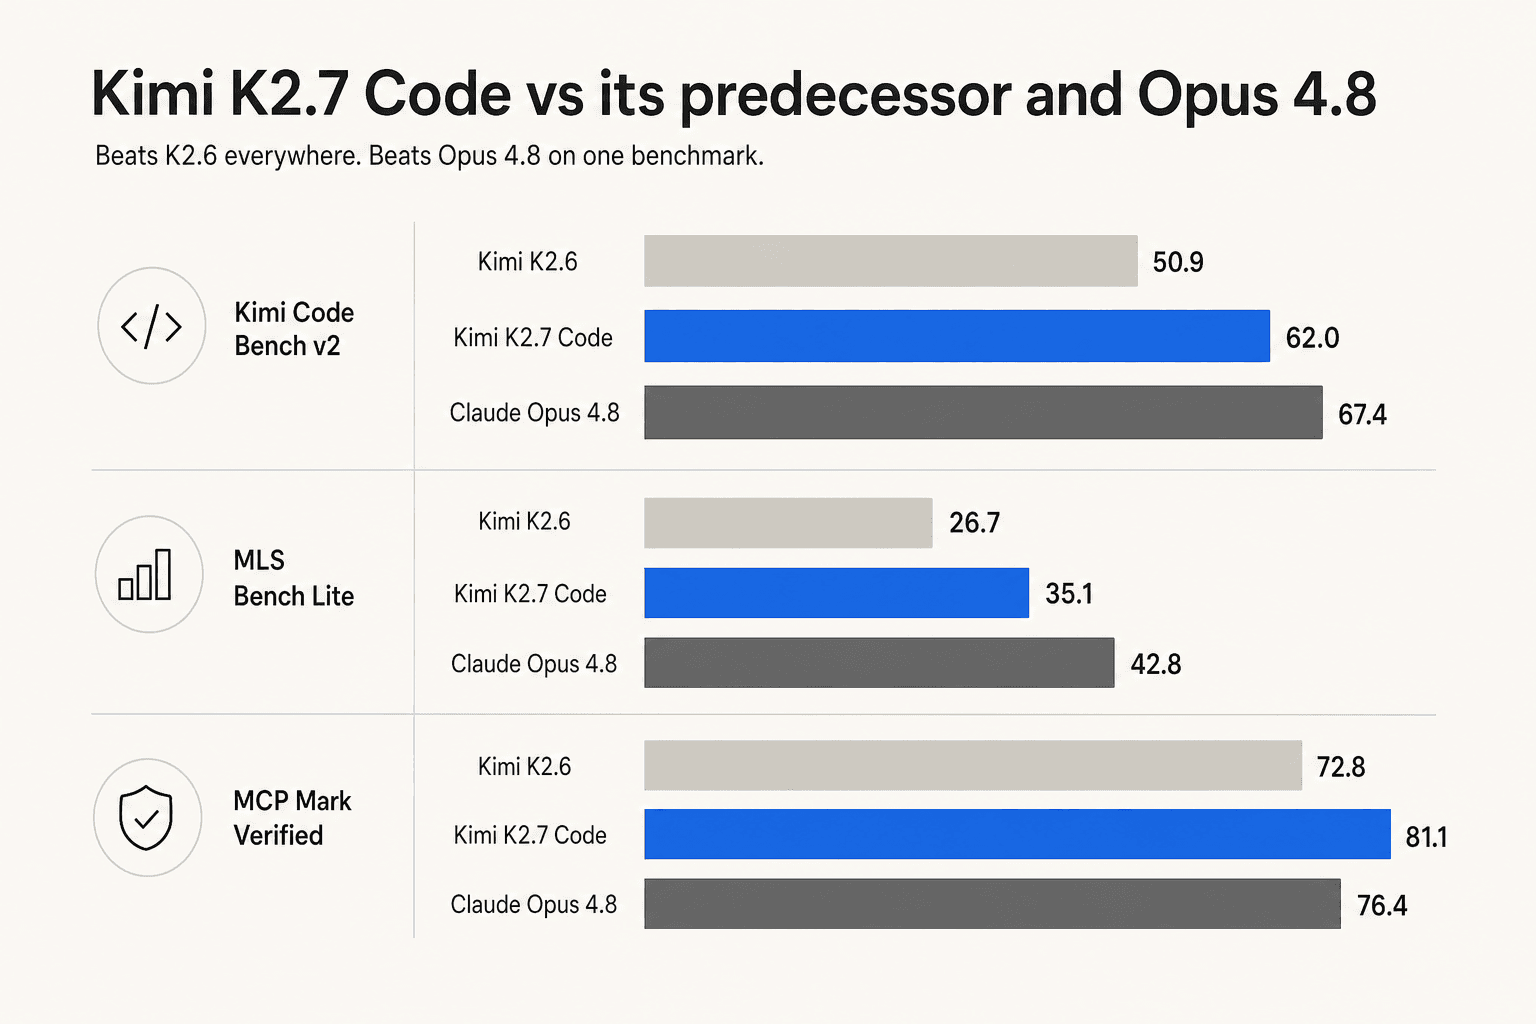
| Kimi Code Bench v2 | 50.9 | 62.0 | 69.0 | 67.4 |
| Program Bench | 48.3 | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 26.7 | 35.1 | 35.5 | 42.8 |
| Kimi Claw 24/7 Bench | 42.9 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 69.4 | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 72.8 | 81.1 | 92.9 | 76.4 |
K2.7 Codeはすべての項目でK2.6を上回っており、特に注目すべきはKimi Code Bench v2での+21.8%(最大の絶対的な伸び)とMLS Bench Liteでの+31.5%(最大の割合での伸び)で、MarkTechPostによるリリース報道による。しかし、興奮する前に残り2列にも目を通す必要がある。GPT-5.5は6項目中5項目で首位であり、Opus 4.8は6項目中4項目で首位である。Opus 4.8に対する唯一正真正銘の勝利は、Model Context Protocolを通じた正しい呼び出しを測定するツール使用ベンチマークであるMCP Mark Verifiedで、K2.7 Codeの81.1がOpus 4.8の76.4を明確に上回っている。
MarkTechPost自身の記事も強調している正直な見立ては、ここに挙げた数値はすべて自社発表のものだということだ。Moonshotは自社のハーネス上でこれらのテストを実行しており、独立したリーダーボードによる検証はまだ行われていない。だからといって無効というわけではないが、Grok 4.5を含むあらゆるベンダーのベンチマーク表に当てはまる同じ注意点であり、社外の誰かが再現するまでは、ローンチ時の数値を「方向性としては信頼できる」ものとして扱うべきで、絶対的な真実として扱うべきではない。
Kimi K2.7 Codeの料金
モデル向けのMoonshotの料金ページで確認され、OpenRouterのプロバイダー一覧とも照合済みの公式レートは以下の通りだ。
| モデル | 入力(キャッシュヒット) | 入力(キャッシュミス) | 出力 | コンテキスト |
|---|---|---|---|---|
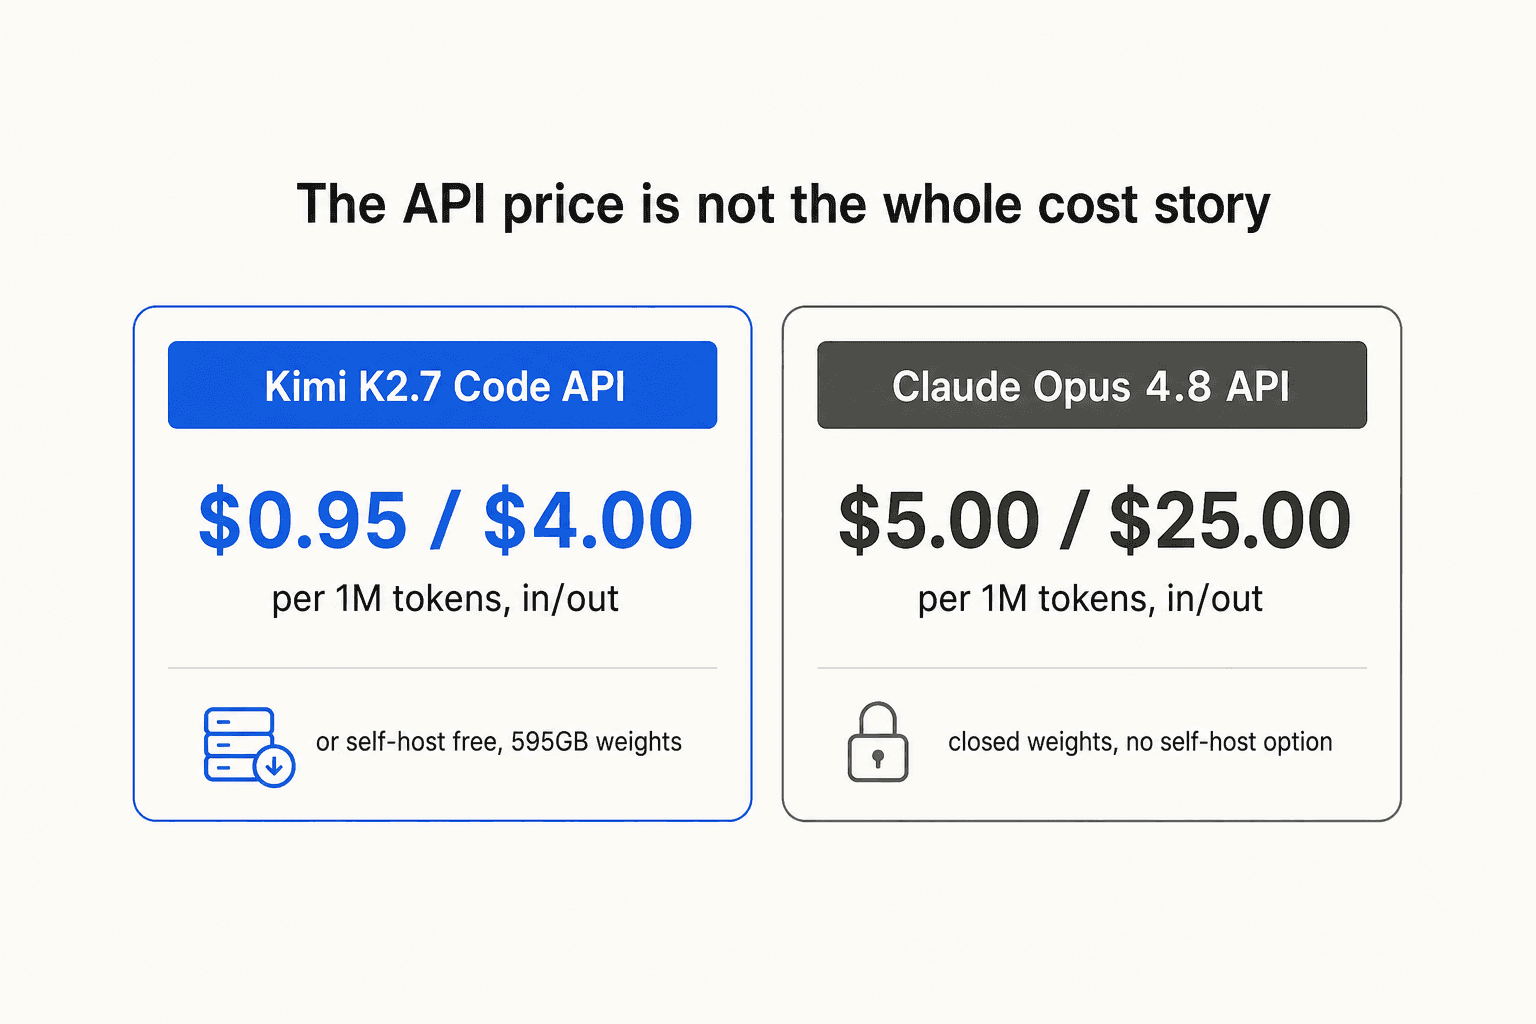
| kimi-k2.7-code | 0.19ドル /1M | 0.95ドル /1M | 4.00ドル /1M | 262,144トークン |
| kimi-k2.7-code-highspeed | 0.38ドル /1M | 1.90ドル /1M | 8.00ドル /1M | 262,144トークン |
| Claude Opus 4.8(参考) | - | 5.00ドル /1M | 25.00ドル /1M | 1Mトークン |
厳密には無料のAPI階層は存在しない。最低1ドルのチャージで最下層のレート制限(3リクエスト/分、50万トークン/分)が解放され、累計支出に応じて5段階のティアを通じて制限が拡大し、3,000ドルを投入すると10,000RPM、500万トークン/分まで到達する。OpenRouter上のサードパーティホスト(DeepInfra、Inceptronなど)は、入力トークンでMoonshot自身のレートより約20〜25%安い価格を提示しているが、概してMoonshot自身のエンドポイント(それ自体99.59%という立派な稼働率を誇る)よりもスループットと稼働率は劣る。
もう一つの道、そして真にオープンウェイトなモデルにとって最も重要な道は、自分のハードウェア費用だけで済むセルフホスティングである。フルサイズのBF16ウェイトは約595GBで、複数のH200クラスGPUを必要とする本格的なサーバー級の領域だ。コミュニティによる量子化はこのギャップを急速に埋めている。UnslothのDynamic 2-bit量子化はモデルを約325GBまで縮小し、十分な仕様のローカルハードウェアで40トークン/秒以上の速度で動作する。ノートパソコンでの導入とは言えないが、すでにGPUインフラを持ち、トークンあたりの限界費用をゼロにしたいチームにとっては現実的な選択肢である。
推論トークンのパラドックス:Moonshotの主張と実際のユーザー報告
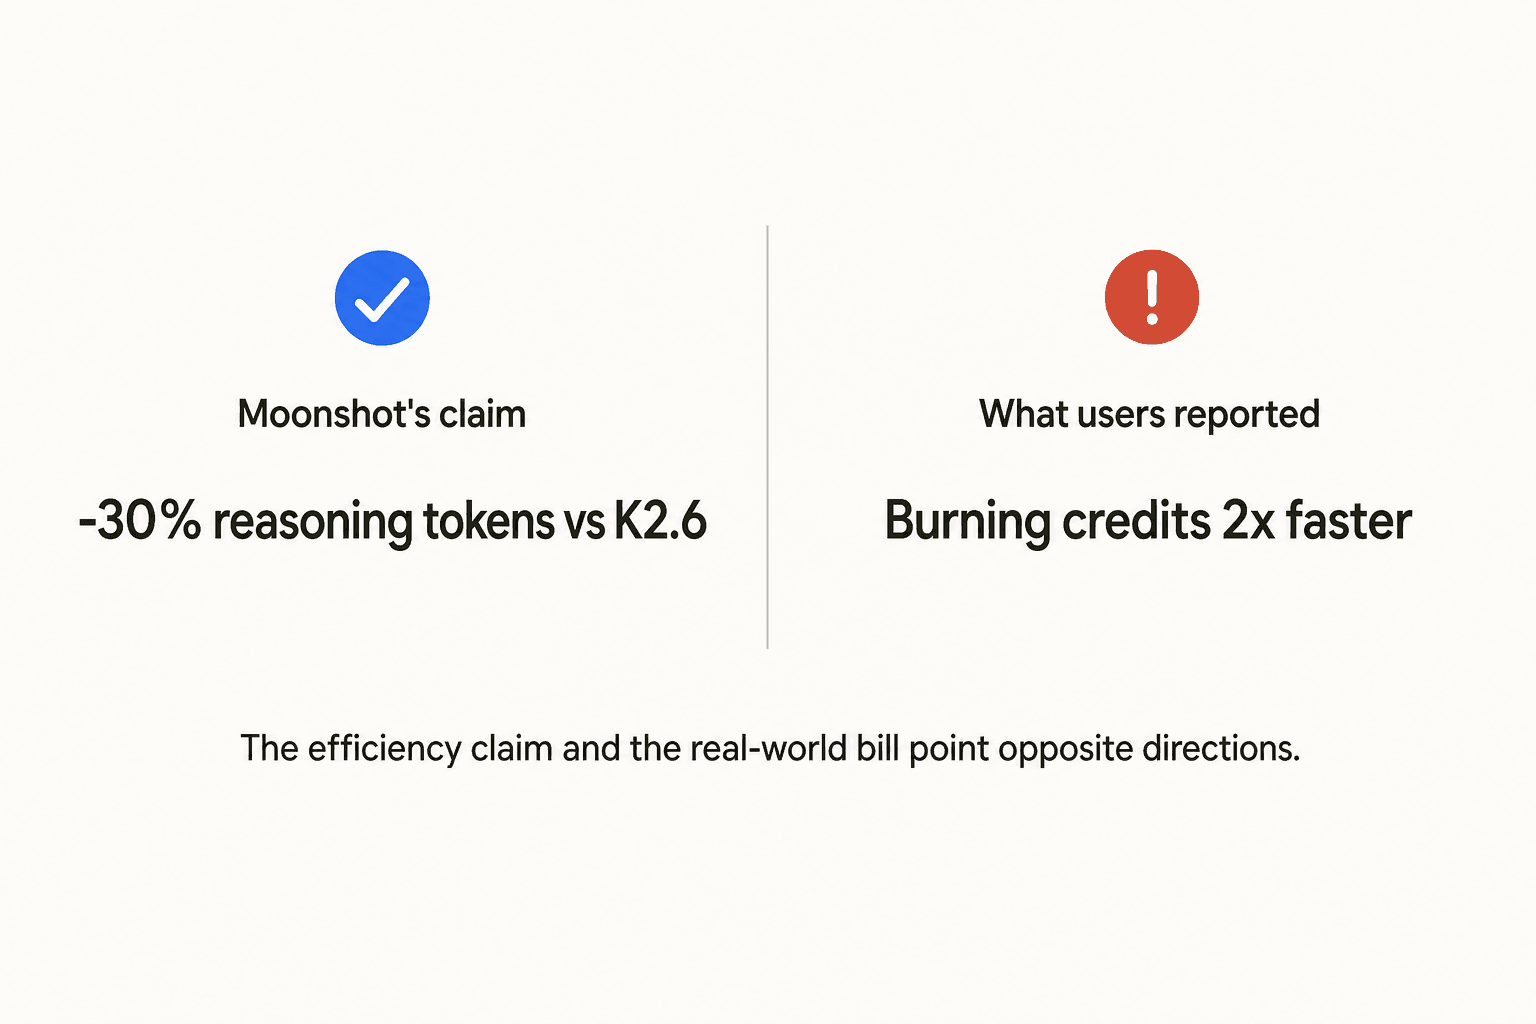
ここでレビューは仕様書から本当のニュースへと変わる。Moonshotの公式ローンチ資料は効率性の訴求を前面に押し出しており、K2.7 Codeは同じ作業に対してK2.6より推論トークンの使用量が約30%少ないとされ、同社の言葉を借りれば「最適化された推論効率」であり、それを正当化しない問題に対する過剰思考の削減として位置づけられている。
r/kimi、r/LLMDevs、r/AI_Agentsといった、このリリースを議論するより広範なスレッド群から集められたコミュニティの見方は(公式のReddit発表スレッド自体は直接の取得がブロックされていたため、これはそこから派生した周辺の議論に基づいている)、ほぼ正反対の物語を語っている。
"Kimi 2.7 Code is good, but it thinks forever and consumes way too much limit."

"Same for me: I'm spending tokens twice as fast."
"Is anyone else losing their mind with Kimi 2.7 lately? I explicitly tell it to stop, check-in, and ask for permission before moving to the next step, and it just keeps going."
すべてのスレッドが否定的というわけではなく、この分裂こそが重要な点だ。特に自前で量子化されたコピーをセルフホストしているユーザーの中には、本当にしっかりしたコーディングモデルだと報告する人もいる。あるr/kimiの評価スレッドには「Kimi is like slight worse than Claude, but with 5X the usage limits at maybe half the speed」とあり、r/AI_Agentsの別のコメント投稿者は、派手な飛躍ではなく「a better default for long coding jobs that need to keep going」と呼んだ。しかしコスト消費に関する不満は具体的かつ繰り返し現れており、看板となる主張と直接矛盾している。これは、あらゆるコーディングモデルが受ける「Claudeほど賢くない」という定番の不満とは異なる種類の批判だ。
コストに関する不満と並行して、本物の、別種の品質に関する不満も存在する。複数のスレッドが、モデルが問題なくこなせるはずのまさに単純なタスクにおいて、K2.6と比較したハルシネーションや後退を報告している。あるr/kimiのスレッドは率直にこう述べている。「Anyone else notice that K2.7 is making up a lot of shit versus what K2.6 used to do?」私はAIサポートの導入現場で、まさにこの形の失敗をすでに見てきた。デモでは見事なパフォーマンスを見せるモデルが、デモでは一度もカバーされなかった実際の、より雑然とした入力に対しては自信満々に何かをでっち上げてしまう。だからこそ私は、ベンダーが選んだベンチマークスイートだけでなく、まず実際の過去データに対して実行してみるまで、ベンダーの効率性や精度の数値を決して信頼しない。
Kimi K2.7 Codeの長所と短所
本当に優れている点:
- 安価で信頼できるオープンウェイトのコーディング。 1Mトークンあたり0.95ドル/4.00ドルはあらゆるクローズドなフロンティアモデルを価格面で下回り、改変MITライセンスによってセルフホスティングはマーケティング上の謳い文句ではなく現実的な選択肢となっている。
- ツール使用における本物の勝利。 MCP Mark Verifiedの81.1はOpus 4.8を明確に上回っており、生の推論の深さよりも構造化されたツール呼び出し(CIチェック、チケット更新、1つのループ内でのファイル編集)に依存するワークロードには有用だ。
- K2.6に対する全面的な改善。 公開された6つのベンチマークすべてが向上し、256Kのコンテキストウィンドウは大きな差分とそのテスト、関連ファイルを1つのプロンプト内に余裕をもって収められる。
- 真に開かれたセルフホストの道。 コミュニティによる量子化はすでに1兆パラメータのモデルを約325GBまで縮小しており、本格的だが手の届くローカルハードウェアで実用的な速度で動作する。
不足している点:
- 看板となる効率性の主張がコミュニティの実際の請求と一致しない。 推論トークン30%削減という主張の後に、「クレジットを2倍速く消費している」という一連のスレッドが続いたことは、このローンチにおける最大の問題であり、予算をコミットする前に自分自身のワークロードで確認する価値がある。
- 利用可能な最も賢いコーディングモデルではない。 GPT-5.5は6項目中5項目で、Opus 4.8は6項目中4項目で首位に立っており、その中には純粋なコーディング品質で最も重視されるであろう2項目(Program Bench、MLS Bench Lite)も含まれる。
- 思考モードが必須である。 他の多くの競合モデルのように、推論の深さを速度やコストと引き換えにすることができない。サンプリングパラメータも固定されている。
- 単純なタスクにおけるハルシネーション報告。 複数のユーザーが、そもそも重い推論をまったく必要としないはずのタスクにおいて、K2.6と比較した後退を指摘している。
Kimi K2.7 Codeはコーディング以外でも良いのか
Kimi K2.7 Codeの適用範囲は狭く絞られており、それは概ね強みだと言える。Moonshot自身が、一般的なタスクにはK2.6の方が依然として優れた選択だと述べており、これはほとんどのベンダーが持ち得ないほど誠実な位置づけだ。しかし、その根底にある教訓はコーディングを超えて及び、私がカスタマーサポート向けのAIを構築する中で常に直面しているものでもある。ベンダーの効率性の数値は、あなたの実際の請求額とは同じものではない。 Moonshot自身のベンチマークは推論トークン-30%と言っている。だが自社の相当数のユーザーが、本番環境では正反対の結果を報告している。ラボの数値と実際のアカウントの間にあるこのギャップこそが、「このモデルはトークンあたり安い」ことと「このモデルはあなたのチームにとって安い」ことがまったく別の主張である理由であり、自分自身のワークロードでテストするまでは、そのどちらか一方だけが正しい。
私はサポート自動化においても、まったく同一のパターンが展開されるのを見てきた。ベンダーが営業資料上では素晴らしく見える解決率や1件あたりの解決コストを提示するが、実際のチケット量は、それが測定されたベンチマークセットとはまるで違う振る舞いを見せる。だからこそeeselは、顧客の実際の過去のチケットに対して事前に実行していない数値を決して世に出さない。実際のライブキューに触れる前にシミュレーションを行うことで、ベンダーのベンチマークを信じるのではなく、自分自身のデータに基づく実際の解決率と実際のコストを確認できる。これはコーディングモデルであれサポートAIであれ、まったく同じ規律だ。
結論
フロンティア価格のごく一部で真にオープンウェイトなコーディングモデルが欲しく、APIの利用ティア構造を受け入れるか、あるいは1兆パラメータモデルのセルフホスティングを引き受ける覚悟があるなら、Kimi K2.7 Codeは本物で信頼に足る選択肢であり、特にMCP Mark Verifiedでの勝利が実際に意味を持つツール中心のエージェント型ワークフローにおいてそうだ。難しいコーディング問題向けの単一で最も賢いモデルが必要なら、GPT-5.5とClaude Opus 4.8がMoonshot自身のベンチマークの大半で依然として首位を保っているが、それ相応の価格プレミアムが伴う。そして、単一のベンチマークスコアよりもコストの予測可能性がチームにとって重要であるなら、Moonshotの推論トークン-30%という主張と、コミュニティの「クレジットを2倍速く消費している」という報告との間のギャップこそが、ローンチ記事を鵜呑みにするのではなく、コミットする前に自分自身のアカウントでテストすべきものだ。オープンウェイトの競合分野をより広く見渡すなら、Qwen3-CoderとKimi K2.6の両方が同じ評価のラウンドで検討する価値がある。
eeselを試す
私はeesel AIで働いており、Kimi K2.7 Codeのローンチが浮き彫りにしたまさにその問題、つまりベンダーの効率性の主張が実際のアカウントの支出と一致しないという問題は、私が長年AIサポートツールの現場で見てきたのとまったく同じ問題だ。あなたのサポート自動化を最終的にどのモデルが動かすことになっても、Kimi、GPT、Claude、あるいは次に登場する何であれ、重要な数値はベンチマークスコアではなく、実際のチケットを解決する上であなたのアカウントが本当に支出する金額だ。eeselは、Zendesk、Freshdesk、Frontなど既存のヘルプデスクと連携し、実際のチケット履歴から学習し、あなた自身の過去のチケットに対する完全なシミュレーションを実行することで、何かが本番稼働する前に実際の解決率とコストを確認できるようにする。料金は使用量ベースで解決済みチケット1件あたり0.40ドル、席数に応じた料金はなく、提示された数値がそのまま支払う数値になる。セルフホスティング不要で、eeselを無料で試すことができる。
よくある質問
Kimi K2.7 Codeとは何ですか?
Kimi K2.7 Codeの料金はいくらですか?
コーディングにおいて、Kimi K2.7 CodeはClaude Opus 4.8やGPT-5.5より優れていますか?
Kimi K2.7 Codeをセルフホストして無料で実行できますか?
Kimi K2.7 Codeは本当にK2.6より少ないトークンで済むのですか?

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.